
Este mes se lanzaron dos modelos de video en tiempo real con una semana de diferencia. Vidu S2, de ShengShu, se lanzó el 15 de septiembre, y PixVerse anunció PixVerse R2 el 22 de septiembre. S2 está pensado para personajes digitales en vivo y para cambiar el estilo de un flujo de video mientras se reproduce. R2 se presenta como un modelo de mundo en tiempo real: una escena que recorres con WASD mientras textos, referencias y audio cambian lo que ocurre a continuación.
Ambos equipos publicaron cómo lo hicieron: S2 en un artículo en arXiv y R2 en un informe técnico en el sitio de PixVerse. Los leímos en paralelo. Coinciden en el estructura de base, difieren en cinco decisiones de diseño y divulgan cantidades de información muy distintas. Este artículo aborda los tres aspectos y, a propósito, no declara un ganador: nunca se han medido en la misma prueba.
Qué cambia el tiempo real
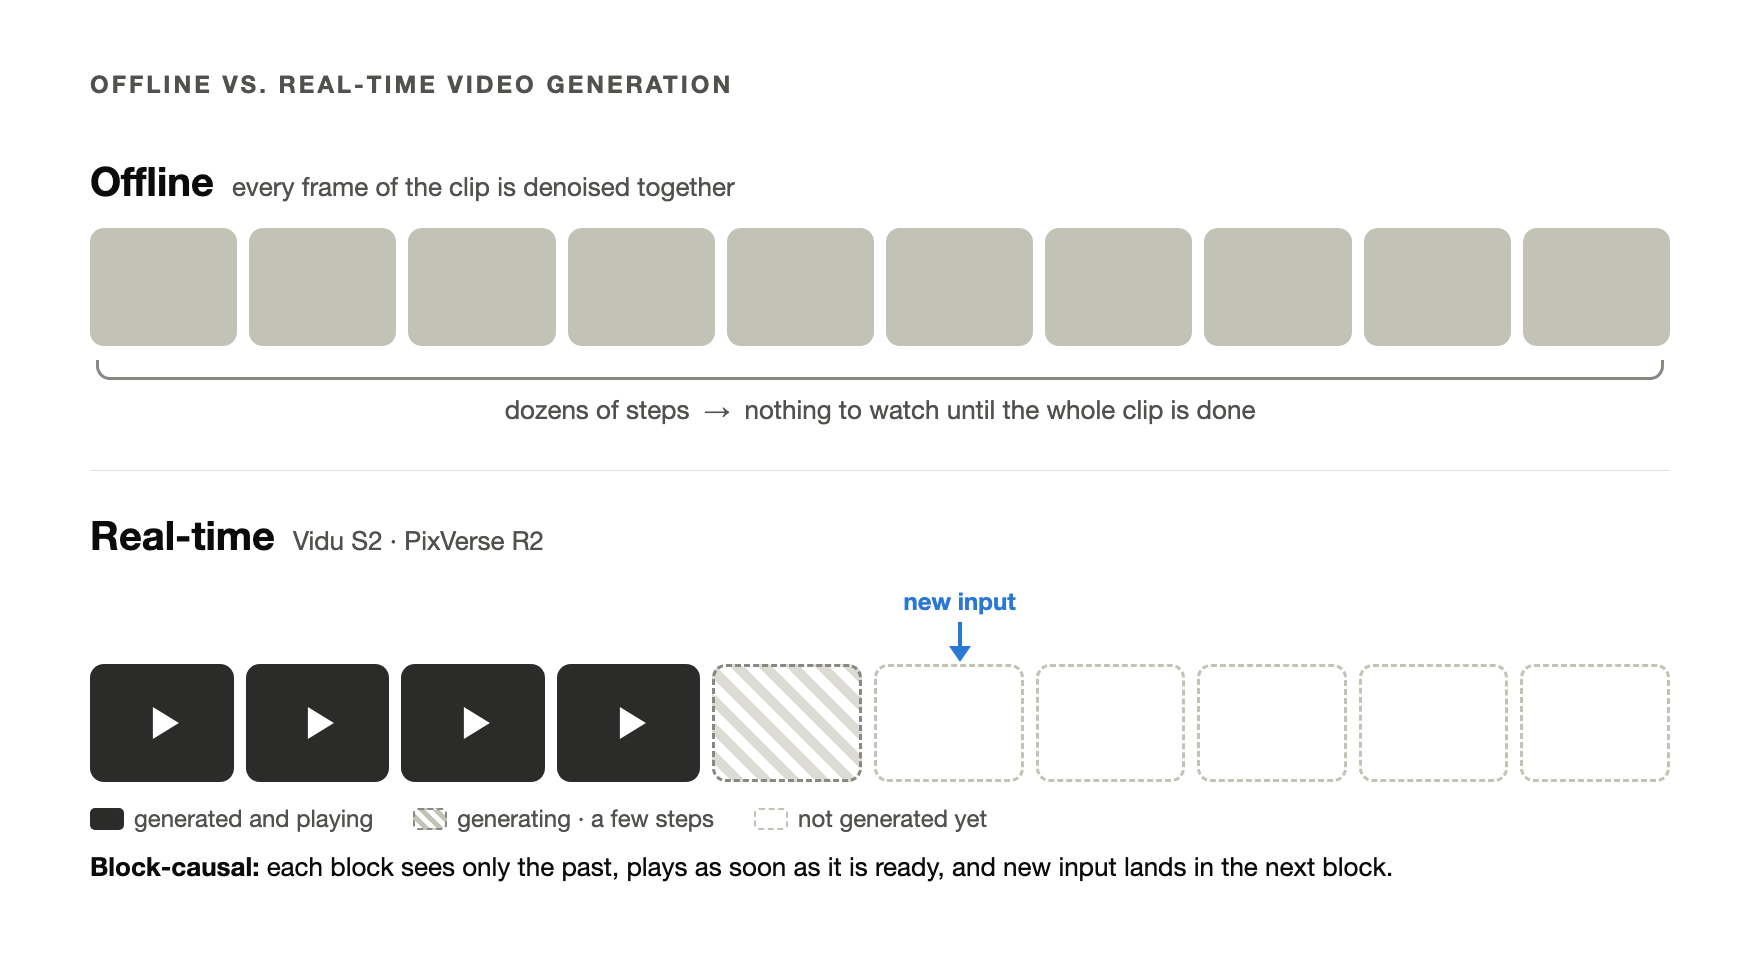
La mayoría de los modelos de video generan el clip completo antes de mostrarlo. Eliminan el ruido de todos sus fotogramas en conjunto durante decenas de pasos, y no se ve nada hasta que el clip entero está listo. Todo lo que quieres tiene que estar en el prompt antes de que empiece la generación.
Un modelo en tiempo real invierte ese proceso. Divide el video en bloques —unos cuantos fotogramas más el tramo de audio correspondiente— y los genera en orden. Cada bloque recibe solo unos pocos pasos de eliminación de ruido y se reproduce apenas está listo. Un bloque puede ver lo que vino antes, pero nunca lo que viene después; eso es lo que significa causal por bloques. Una instrucción nueva entra en el siguiente bloque.
Esta estructura crea tres problemas, y casi todas las decisiones siguientes responden a uno de ellos:
- Los errores se acumulan. Cada bloque se condiciona a bloques que generó el propio modelo, así que un pequeño error lo hereda todo lo que viene después.
- El historial debe tener un límite. Un flujo puede durar indefinidamente; guardar todos los bloques pasados encarecería cada bloque nuevo.
- El tiempo disponible es mínimo. A 25 fotogramas por segundo, cada fotograma dispone de 40 milisegundos.
S2 y R2 llegan al mismo estructura de base: un modelo de difusión autorregresivo y causal por bloques que genera video y audio a la vez. Las diferencias están en cómo lo entrenan, lo mantienen estable, le dan memoria, lo aceleran y permiten que las personas lo controlen.
Los dos sistemas
Vidu S2 (ShengShu Technology con la Universidad Tsinghua) son dos modelos. S2-Avatar es un personaje digital en vivo a 720p y 25–42 FPS, en comparación con los 540p de S1. Puedes darle una nueva imagen de referencia a mitad de la transmisión —una taza, una chaqueta, una playa— y el personaje toma la taza, se pone la chaqueta o entra en la escena; también puede bailar. S2-Editing cambia el estilo en tiempo real de un flujo de video de entrada —más de 50 estilos, prueba virtual de ropa, reemplazo de persona y de fondo— mientras mantiene intacto el movimiento original. El artículo también explora una salida estereoscópica para visores de realidad virtual.
PixVerse R2 es un único modelo orientado a mundos interactivos. Mientras se ejecuta pueden llegar cuatro tipos de entrada —texto, referencias multimodales, audio y acciones como WASD— y cada una actualiza el estado del mundo, no solo el fotograma actual. El motor de juegos de PixVerse ya funciona sobre R2; la demostración pública se centra en el movimiento y los prompts.
Decisión 1: cómo se entrena el modelo
Los modelos en tiempo real no se entrenan desde cero. El punto de partida habitual es un modelo generativo previo y sólido, entrenado para producir clips completos, que luego se convierte para funcionar de forma causal y en pocos pasos. Aquí es donde los dos informes discrepan más abiertamente.
S2 sigue una secuencia de etapas. Se preentrena un modelo bidireccional de audio y video y luego se ajusta con Diffusion-DPO para mejorar fidelidad, expresión, movimiento y sincronía audiovisual. Su atención pasa a ser causal por bloques y se entrena con una mezcla de historial limpio y con ruido (decisión 2). Después, Self-Replay Forcing lo destila a pocos pasos mientras entrena sobre sus propias salidas, y una última fase de preferencias para streaming (Streaming NFT) ajusta el modelo causal. El avatar y la edición se entrenan como modelos separados.
R2 conserva una única base. Omni Causal AR es un modelo causal preentrenado de forma continua con clips cortos, videos largos, datos multimodales y trayectorias de interacción. Luego, Real-Time Acceleration destila ese mismo modelo para su uso en vivo: el alumno se inicializa a partir de él y el profesor se construye sobre él. La frase del informe es «acelerar, no reaprender».
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| Punto de partida | Modelo bidireccional ajustado con Diffusion-DPO | Modelo causal preentrenado de forma continua |
| Camino al tiempo real | Adaptación causal por bloques → Self-Replay Forcing → ajuste de preferencias para streaming | Destilar directamente el mismo modelo |
| Modelos | Modelos separados de avatar y de edición | Un modelo para todos los tipos de entrada |
El informe de R2 dibuja el enfoque habitual como una secuencia de cinco etapas y sostiene que cada transición pierde parte de la capacidad. En términos sencillos, el proceso de S2 tiene esa forma de varias etapas, con su principal mejora en la última. Ninguno de los dos equipos ha publicado un experimento que compare ambos caminos, así que sigue abierto cuál escala mejor.
Decisión 2: evitar que el flujo se desvíe
La deriva es la falla característica del video en streaming: el color se desplaza, una cara se convierte poco a poco en otra persona y al final la imagen se descompone. Ocurre porque el entrenamiento muestra al modelo un historial limpio, mientras que en la inferencia solo ve su propia salida imperfecta.
Ambos equipos parten de la misma solución. Mezclan Teacher Forcing, que condiciona al historial real y limpio y protege la calidad, con Diffusion Forcing, que condiciona a un historial con ruido de nivel aleatorio. El ruido borra los detalles finos pero conserva la composición y el movimiento, así que el modelo aprende a apoyarse en la estructura en lugar de confiar en cada píxel del pasado.
Un historial real con ruido sigue sin ser igual a los errores del propio modelo, así que cada equipo añade una segunda capa.
S2: Self-Replay Forcing. Primero el modelo genera un tramo largo exactamente como lo haría en la inferencia, sin guardar gradientes. Una ventana de esa trayectoria recibe ruido de nuevo bloque a bloque y se reproduce en una sola pasada causal con gradientes, entrenada con una pérdida de destilación DMD más una pérdida perceptual. Como los bloques reproducidos están en un mismo grafo de cómputo, los gradientes cruzan los límites entre bloques —el modelo aprende cómo un bloque condiciona el siguiente— sin retropropagar por la generación original.
R2: Error Bank. Se guardan estados de falla representativos de la generación y se reproducen durante el entrenamiento junto al historial normal, para que el modelo aprenda a recuperarse cuando la desviación ya ha entrado en el mundo. En la evaluación interna por etapas de PixVerse, una métrica de deriva de brillo a largo plazo bajó de 0,201 a 0,129, una reducción del 35,8 %; mejoraron 20 de 29 secuencias largas y el movimiento espurio disminuyó en las cinco muestras sin movimiento.
Ambos métodos se complementan en lugar de competir. Self-Replay Forcing entrena con lo que el modelo actual hace mal; Error Bank practica una y otra vez las fallas que vale la pena recordar.
Decisión 3: una memoria con límite
Los dos conservan unos pocos bloques iniciales de forma permanente como ancla (un sink), mantienen una ventana deslizante de bloques recientes y descartan el resto, de modo que el costo de un bloque nuevo no crece con la longitud del flujo. Los dos también mantienen las coordenadas de posición dentro del rango visto en el entrenamiento —S1 lo llama reposicionamiento de RoPE; R2, RoPE temporal relativo—, así que una sesión larga nunca saca las posiciones de la distribución.
S2 se basa en el TwinCache de S1, donde cada bloque pasado se guarda dos veces: una con ruido y otra limpia. Los pasos intermedios de eliminación de ruido leen la copia con ruido, que transmite el movimiento general y actúa como un filtro paso bajo frente a la acumulación de artefactos; el último paso lee la copia limpia para recuperar el detalle. S2 reparte esto entre sus dos etapas: el backbone lee una caché con mucho ruido y el Refiner, una caché de alta resolución con poco ruido.
R2 separa la memoria por escala temporal: Sink Memory para la identidad, el entorno, el estilo y las reglas del mundo; Rolling History para el movimiento, la pose y la cámara recientes; y una Object KV Cache que comprime el estado de los objetos que seguirá importando más adelante.
La división refleja los productos. Un personaje digital tiene que seguir siendo la misma persona. Un mundo también tiene que recordar lo que ocurrió en él: el objeto que dejaste, la decisión que tomaste.
Decisión 4: de dónde sale la velocidad
Los dos usan atención dispersa y destilación en pocos pasos, pero concentran el esfuerzo en áreas distintas.
S2 se apoya en la ingeniería de sistemas y la documenta. La atención se elige capa por capa entre SageAttention, SpargeAttention y atención dispersa-lineal, con las aproximaciones más agresivas en las capas menos sensibles. Las capas lineales funcionan como multiplicaciones de matrices W8A8 por bloques. Los operadores contiguos se fusionan en kernels de Triton/CUDA y se reproducen con CUDA Graphs. En varias GPU se usa paralelismo de contexto tipo Ulysses con comunicación cuantizada, y en el flujo de edición el codificador VAE, el backbone, el Refiner y el decodificador comparten las GPU en una línea de tiempo común. La resolución sale de un backbone de baja resolución más un Refiner latente de un paso hasta 720p.
R2 se apoya en el modelo. La atención dispersa por bloques se aprende durante el entrenamiento y supera el 90 % de dispersión. La destilación sigue Decoupled DMD —seguir la señal de control y ajustarse al profesor se optimizan como objetivos separados— más un término adversarial tomado de DMD2 para mantener el realismo. La resolución sigue una pirámide: una o dos etapas de baja resolución fijan composición, movimiento y cámara, y una etapa final de alta resolución añade la textura. El informe no indica la resolución ni la tasa de fotogramas de salida de R2.
Decisión 5: cómo lo controlan las personas
S2 envuelve el modelo en un agente VLM. El agente clasifica cada imagen de referencia como objeto en la mano, fondo o ropa, y escribe un prompt para cada segmento que cubre identidad, expresión, mirada, pose, acción y objetos sostenidos, conservando todo lo que el usuario no pidió cambiar. Tras la generación revisa los fotogramas en orden, juzga si la acción terminó, quedó a medias o falló, y escribe el siguiente prompt en consecuencia. Para ponerse o quitarse accesorios, los prompts describen tanto el movimiento como el estado final, así que un sombrero que se pone otra vez se queda puesto. En el modo de edición, la atención alineada por fotograma hace que cada fotograma de salida lea solo el fotograma de origen del mismo instante, de modo que el movimiento y el ritmo coinciden exactamente con la entrada.
R2 integra una única interfaz de entrada en el modelo. Texto, referencias, audio, acciones y controles generados por agentes entran en el mismo mundo en ejecución. La longitud de cada bloque sigue al control activo, hasta un límite: una pulsación de tecla recibe bloques cortos para responder rápido, y un evento completo o un tramo de audio recibe bloques más largos para mantener la coherencia. Sobre el modelo, el motor de juegos de PixVerse añade una capa de agentes que mantiene sincronizados el estado de las reglas del juego y la escena generada.
Qué revela cada informe
Antes de comparar datos, compara lo que se publicó.
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| Formato | Artículo en arXiv | Artículo técnico en el sitio de PixVerse |
| Resolución y tasa de fotogramas | 720p, 25–42 FPS | No se reporta |
| Parámetros y latencia de extremo a extremo | No se reporta | No se reporta |
| Pruebas de referencia públicas | Uno de avatar y cuatro de edición | Ninguno; solo evaluación interna |
| Pesos | No disponibles; API disponible | No disponibles |
En StreamAV-Bench, S2 queda primero en las nueve métricas publicadas entre 14 sistemas en su propia evaluación: alineación audiovisual de 0,353 frente a 0,272 de la mejor alternativa, y error de sincronía de 0,617 frente a 0,648. Algunas diferencias están en el tercer decimal: la consistencia del sujeto es 0,998 frente a 0,997. Los datos publicados de R2 son la reducción del 35,8 % en la deriva y una dispersión de atención superior al 90 %, que según el informe preserva cuatro dimensiones internas de calidad, sin dar las puntuaciones.
No hay una comparación directa. El artículo de S2 se compara con PixVerse R1, la versión anterior, y R2 salió después.
Qué significa si haces video con agentes
Desarrollamos una aplicación de escritorio en la que los agentes hacen el trabajo, y el video es una de las tareas que la gente les encarga. De estos informes nos quedamos con dos cosas.
La primera: la línea entre el video en vivo y el video terminado es cada vez más nítida. Los modelos en tiempo real están hechos para experiencias que siguen respondiendo: personajes, juegos, un flujo que reestilizas mientras se reproduce. La mayor parte del trabajo de los creadores sigue terminando en un archivo. En Orkas, VideoStudio convierte metraje y una solicitud en una edición que puedes revisar y, cuando hace falta generar una toma, usa modelos que generan el video completo: la generación de video administrada por Orkas o tu propia clave para Seedance 2.0, Hailuo 2.3, Vidu Q3 Pro, Kling 3.0 Turbo, Veo 3.1 o Runway Gen-4.5. Ni S2 ni R2 funcionan hoy dentro de Orkas.
La segunda: la capa de control de S2 es un bucle de agente: escribir el prompt, generar, mirar los fotogramas y decidir el siguiente paso. Es la misma forma que tiene cualquier agente que trabaja con un modelo generativo, sea en tiempo real o no, y buena parte del resultado depende de ese bucle, no solo de los pesos.
Lo que aprendimos
La estructura de base se ha asentado: difusión autorregresiva causal por bloques, video y audio generados juntos, historial limpio más historial con ruido, un sink y una ventana, destilación de la familia DMD, atención dispersa y primero baja resolución. Lo que separa a S2 y R2 es dónde ponen el esfuerzo: una secuencia de ajustes concretos frente a una base destilada una sola vez, reproducción on-policy frente a un banco de fallas, ingeniería de sistemas frente a dispersión aprendida.
Vale la pena leer ambos completos: el artículo de Vidu S2, por sus detalles de entrenamiento e implementación, y el informe de PixVerse R2, por su argumento sobre cómo escalar un modelo en tiempo real sin reaprenderlo.