
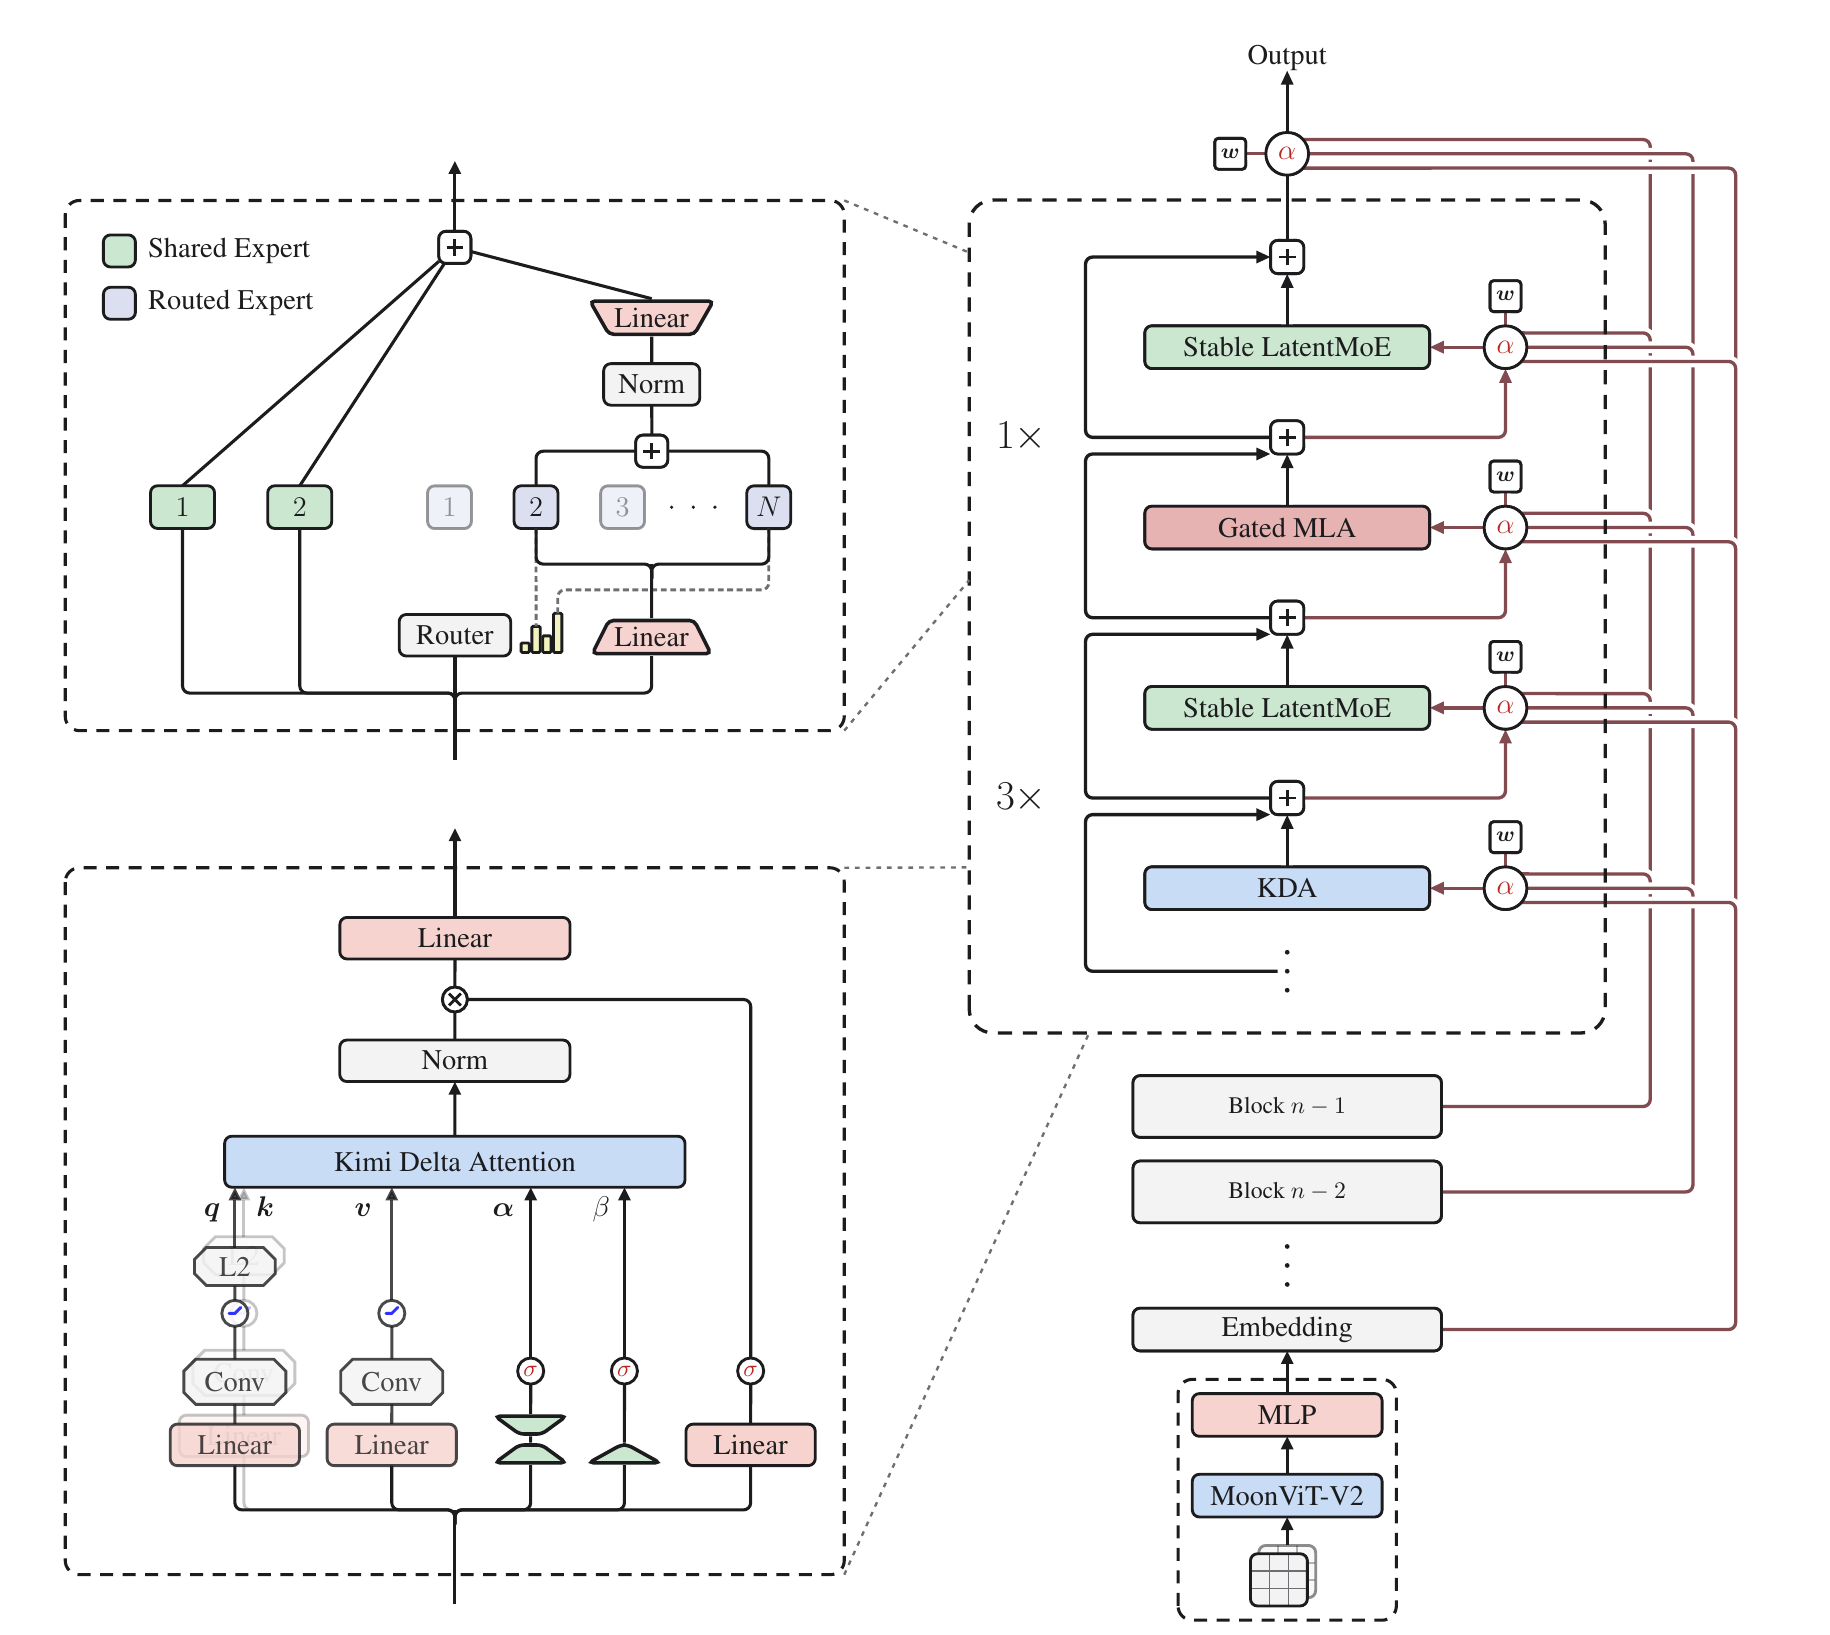
Die Schlagzeilenzahl von Kimi K3 lautet 2.8 Billionen Parameter. Sie ist die am wenigsten interessante Zahl im Bericht.
Interessant ist, dass die Architektur um eine Frage herum organisiert ist, die nichts mit Größe zu tun hat: Wo kommt der Informationsfluss ins Stocken? Die Antwort hat drei Teile — entlang der Sequenz, entlang der Tiefe, entlang der Breite — und jeder erhält einen eigenen Mechanismus.
Bei gleichem Rechenaufwand ungefähr die 2.5-fache Skalierungseffizienz von Kimi K2. Diese Zahl stammt aus den vom Team selbst angepassten Skalierungsgesetz-Kurven, nicht aus einer unabhängigen Reproduktion; verstehen Sie sie daher als Aussage des Teams. Die Mechanismen dahinter sind jedoch konkret genug, um sie zu diskutieren — deshalb lohnt sich der Bericht.
Dies ist eine genaue Lektüre des technischen Berichts zu Kimi K3 (Moonshot AI), mit Schwerpunkt auf dem Architekturabschnitt. Wir haben bereits über die Gestaltung von Agenten für langwierige Aufgaben geschrieben; dieser Beitrag setzt tiefer im technischen Aufbau an.
Drei Richtungen, nicht eine Zahl
Jede Schicht eines Transformers mischt Informationen auf drei Arten. Über Tokens hinweg, sodass Position 900,000 Position 1 beeinflussen kann. Über die Tiefe hinweg, sodass Schicht 90 nutzen kann, was Schicht 3 erkannt hat. Über Kanäle hinweg, sodass Merkmale neu kombiniert werden können.
Die meisten Skalierungsansätze verändern alle drei zugleich, indem sie alles vergrößern. K3 trennt sie und gibt jeder einen eigenen Mechanismus:
- Sequenz — hybride Attention: drei Kimi-Delta-Attention-Schichten für jede Gated-MLA-Schicht.
- Tiefe — Attention Residuals: Jede Schicht richtet ihre Attention auf die Ausgaben aller vorhergehenden Schichten, statt einen einzigen akkumulierten Zustand zu übernehmen.
- Breite — Stable LatentMoE: 896 geroutete Experten, 16 pro Token aktiv.
Die verborgene Dimension änderte sich überhaupt nicht. 7168 in K2, 7168 in K3. Was auch immer größer wurde — die Breite einer Schicht war es nicht.
Sequenz: Drei Viertel der Schichten lesen nicht mehr alles
Standard-Attention liest für jedes neue Token das gesamte Präfix erneut. Bei einer Million Tokens wird diese Rechnung zum Problem.
K3 teilt die Aufgabe. Drei KDA-Schichten halten einen laufenden Zustand fester Größe — eher Notizen machen als die Quelle erneut lesen — gefolgt von einer Gated-MLA-Schicht mit vollständiger globaler Attention. Das Muster wiederholt sich, mit einer zusätzlichen MLA-Schicht ganz am Ende, sodass die letzte Schicht immer alles sieht. Über 93 Schichten hinweg: 69 KDA, 24 MLA.
Die feste Größe ist der entscheidende Punkt. Der Zustand wächst nicht mit der Sequenz und kann daher nicht ausufern. Er ist allerdings verlustbehaftet, weshalb jede vierte Schicht vollständige Attention nutzt, um wiederzufinden, was die Notizen verloren haben.
Dazu kommt ein Folgeeffekt. Weil der rekurrente Zustand eine Abklingkomponente hat — neuere Tokens sind natürlicherweise präsenter als ältere — entsteht Positionsinformation ohne Zusatzaufwand. Deshalb verwendet K3 überhaupt keine Positionskodierung in seinen globalen Attention-Schichten. Kein RoPE, nichts neu zu skalieren.
Die Erweiterung auf eine Million Tokens erforderte daher keinen Eingriff in die Positionskodierung. Keiner der Interpolationstricks, die das Fachgebiet zur Kontexterweiterung gesammelt hat, ist hier anwendbar, denn es gibt keine Kodierung zu interpolieren.
Eine Untergrenze, die einen GPU-Codepfad beseitigte
Das ist unser Lieblingsteil des Berichts, und er ist klein genug, um überlesen zu werden.
Der rekurrente Zustand vergisst fortlaufend. Um das effizient in Blöcken zu berechnen, muss durch die akkumulierte Abklingkomponente dividiert werden, und diese ist ein Produkt von Zahlen kleiner als eins. Ohne Begrenzung dividiert man irgendwann durch etwas, das beliebig nahe bei null liegt.
Die vorherige Generation löste das, indem sie jeden Block in Kacheln aus 16 Tokens aufteilte und im logarithmischen Raum arbeitete. Das funktionierte, doch die Kacheln auf der Diagonale mussten weiterhin Positionspaar für Positionspaar ausgewertet werden — ein langsamer Sonderpfad, der keine Tensor Cores nutzen konnte.
Die Lösung von K3 ist eine Zeile Parametrisierung. Die logarithmische Abklingkomponente nach unten begrenzen: Jeder Schritt darf den behaltenen Inhalt bis auf 0.67% reduzieren, aber nicht weiter.
Folgen Sie der Rechnung. Mit dieser Grenze bleibt die akkumulierte logarithmische Abklingkomponente über eine Kachel aus 16 Tokens innerhalb von (−80, 0). Der Kehrwert liegt daher unter e80 ≈ 5.5 × 1034, bequem innerhalb des BF16-Bereichs von ungefähr 3.4 × 1038. Nichts läuft über. Die diagonalen Kacheln können somit dieselbe dichte Matrixmultiplikation verwenden wie alle anderen.
Der Sonderpfad wird nicht optimiert. Er entfällt.
Rückwärts betrachtet wird die Kausalkette noch interessanter: Der Dynamikbereich der Hardware bestimmte das zulässige Intervall, dieses die Konstante und diese wiederum, dass die Aktivierung nach unten begrenzt sein musste. Die Numerik bestimmte die Mathematik, nicht umgekehrt.
Tiefe: vom Staffellauf zum Gruppenchat
Bei dreiundneunzig Schichten Tiefe ist der übliche Residualstrom ein Staffellauf. Schicht 50 erhält einen akkumulierten Zustand von Schicht 49. Was die Schichten 1 bis 48 einzeln erkannt haben, ist darin aufsummiert und nicht mehr trennbar.
Der Bericht beschreibt dies als denselben Engpass, den ein RNN über die Zeit hat — und den das Fachgebiet bereits mit Attention gelöst hat. Attention Residuals übertragen diese Lösung auf die Tiefe: Jede Schicht besitzt eine lernbare Pseudoabfrage und richtet ihre Attention auf die Ausgaben aller vorherigen Schichten, wobei sie auswählt, was sie liest.
Wörtlich umgesetzt verursacht das quadratischen Rechenaufwand in der Tiefe und hält, schlimmer noch, bei Pipeline-Parallelität die Ausgabe jeder Schicht im Speicher und auf den Übertragungswegen vor. Deshalb nutzt K3 die Blockvariante: 93 Schichten, in Zwölfergruppen unterteilt, innerhalb einer Gruppe aufsummiert, vollständige Attention zwischen den Gruppen. Der Zusatzaufwand fällt pro Gruppe statt pro Schicht an, und der Zustand zur Inferenzzeit bleibt begrenzt.
Breite: 896 Experten, 16 aktiv
Mixture-of-Experts hält einen großen Pool vor und aktiviert pro Token nur wenige Experten. K2 wählte 8 von 384. K3 wählt 16 von 896 — eine Sparsität von 56.
Den Pool so stark zu vergrößern bringt zwei Dinge aus dem Gleichgewicht, und der Bericht spricht beide ungewöhnlich direkt an.
Kommunikation. Bei einem herkömmlichen MoE erhält jeder ausgewählte Experte das Token in voller Breite; der Datenverkehr wächst daher mit der Zahl der ausgewählten Experten. LatentMoE entkoppelt beides: Geroutete Experten arbeiten in einem kompakten latenten Raum mit halber Modellbreite, während zwei gemeinsame Experten in voller Breite übernehmen, was jedes Token benötigt. Der Pool kann wachsen, ohne dass die Übertragungskosten mitwachsen.
Stabilität. Bei dieser Sparsität wird der geroutete Zweig zu einer Kette von nahezu vier aufeinanderfolgenden Matrixmultiplikationen, und Aktivierungen explodieren. Zwei Gegenmaßnahmen: eine RMSNorm zwischen Expertenaggregation und Aufwärtsprojektion sowie eine neue Aktivierung, SiTU-GLU, die beide Faktoren einer SwiGLU mit einer skalierten tanh-Funktion begrenzt, damit keiner bei niedriger Präzision ausufert.
Ausgleich. Die dritte Lösung ist diejenige, die man übernehmen sollte. Ungefähr 900 Experten gleichmäßig auszulasten erfordert in jedem Schritt die Anpassung eines Bias pro Experte. Das Standardverfahren verändert jeden Bias um einen festen Schritt in Richtung des Fehlers, was entweder schwingt oder hinterherhinkt. K3 berechnet ihn stattdessen direkt: top-(k+1) statt top-k ausführen, und der zusätzliche Eintrag ist die Punktzahl, die ein Token für die Aufnahme verlangt. Mit diesen Grenzwerten ist die Last eines Experten unter einem möglichen Bias monoton, sodass der Bias für die Ziellast einfach ein Quantil der Abstände ist. Ein Vorwärtsdurchlauf, keine abzustimmende Schrittweite.
Im großen Maßstab umfasst dieses Quantil Millionen Werte über alle Ranks, daher wird es anhand eines Histogramms geschätzt: Jeder Rank zählt seine Klassen, ein All-Reduce summiert sie, und das Quantil wird aus den gemeinsamen Häufigkeiten abgelesen. Häufigkeiten sind additiv, daher bildet die Schätzung den gesamten Batch ab, unabhängig von der Verteilung der Tokens, zu Kosten von einigen hundert Klassen pro Experte.
Die Rechnung landet in der Bereitstellungsinfrastruktur
Nichts davon ist kostenlos. Der ehrliche Teil des Berichts ist der Infrastrukturabschnitt, in dem die Kosten sichtbar werden.
Ein rekurrenter Zustand fester Größe lässt sich günstig speichern und übertragen, wird aber seriell aktualisiert und lässt sich nicht einfach addieren. Beide Eigenschaften verursachen Arbeit:
- Eine Sequenz auf Geräte aufteilen. Gewöhnliche lineare Attention lässt jedes Gerät seinen lokalen Zustand bei null beginnend berechnen und die Ergebnisse summieren. KDA wendet einen tokenabhängigen Übergang auf den eingehenden Zustand an, sodass die Summierung falsch ist. Die Lösung zerlegt jedes Segment in einen kumulativen Übergang und einen bei null beginnenden Zustand — zwei Größen, die sich zusammensetzen lassen — und rekonstruiert den Eingangszustand jedes Geräts mit einem Präfix-Scan und einem All-Gather fester Größe.
- Ein Präfix über Anfragen hinweg wiederverwenden. Die Hälfte der Caches besteht aus Seiten pro Token, die andere Hälfte aus einem festen Zustand pro Anfrage. Bei einem Cache-Treffer müssen beide an derselben Grenze wiederherstellbar sein. Die Lösung entkoppelt die Granularitäten: Hashes bei 512 Tokens, Zuweisung bei 1024–6144 und Sicherung des rekurrenten Zustands nur an einer dünn besetzten Teilmenge der Hash-Endpunkte.
- Spekulative Dekodierung. Der Zustand wird direkt aktualisiert, sodass ein verworfener Entwurf nicht zurückgesetzt werden kann. Stattdessen werden die projizierten Eingaben zwischengespeichert — deutlich kleiner als der Zustand selbst — und auf dem Chip rekonstruiert.
Das Muster aller drei Fälle entspricht dem der Abklinguntergrenze, nur in umgekehrter Richtung: Die Architektur bestimmte eine Darstellung, und diese Darstellung bestimmte die Systemarbeit.
Eine Gewohnheit, die der Bericht stillschweigend aufgibt
K3 ist nativ multimodal, und sein Vision-Encoder wird von Grund auf mit der Vorhersage des nächsten Tokens trainiert. Keine SigLIP-Initialisierung, kein kontrastives Vortraining — obwohl dies das Standardrezept ist, auch beim eigenen vorherigen Modell des Teams.
Der genannte Grund ist nicht Qualität, sondern Stabilität: Der kontrastiv initialisierte Encoder zeigte bei gemeinsamer Optimierung dauerhaft höhere Gradientennormen mit häufigen Spitzen, während der von Grund auf trainierte stabil blieb. Die Bildauswertungen fielen gleich aus.
Das macht den Befund deutlicher als ein Sieg es getan hätte. Wäre das Training von Grund auf besser gewesen, würde man von einem besseren Rezept sprechen. Es war gleichwertig — die Aussage lautet also, dass in diesem Maßstab ein als verpflichtend betrachteter Schritt lediglich optional ist.
Was das bedeutet, wenn Sie Agenten mit diesen Modellen betreiben
Wir entwickeln einen Desktop-Client mit mehreren Agenten. Deshalb achten wir darauf, ob eine langwierige Ausführung bezahlbar bleibt, nicht darauf, wer eine Rangliste anführt.
Entscheidend ist nicht die Größe des Kontextfensters, sondern was die Bereitstellung einer Million Tokens kostet. Drei Viertel der Schichten halten einen Zustand fester Größe. Der Cache, der mit dem Gespräch wächst, ist daher nur ein Viertel so groß wie in einem reinen Attention-Modell gleicher Tiefe. Für BrowseComp nennt der Bericht 91.2% für K3 bei ungefähr $2 pro Aufgabe — etwa halb so teuer wie das nächstgelegene proprietäre Ergebnis und eine Größenordnung günstiger als die Claude-Modelle bei maximalem Aufwand.
Bei einem Agenten mit Hunderten Tool-Aufrufen entscheidet dieses Verhältnis, ob sich eine Aufgabe überhaupt lohnt. Architekturarbeit, die früher wie reine Forschung wirkte, bestimmt heute direkt, ob eine lange Ausführung wirtschaftlich sinnvoll ist.
Was wir daraus mitnehmen
Zwei Dinge, beide übertragbar.
Erstens die Fragestellung. Wo kommt der Informationsfluss ins Stocken? führt zu anderer Arbeit als Wie viel größer können wir werden? — und die Frage lässt sich zerlegen, weshalb drei Mechanismen getrennt entwickelt und gemessen werden konnten.
Zweitens die Abklinguntergrenze. Eine Einschränkung, die fast keine Ausdrucksfähigkeit kostet, entfernte einen ganzen Sonderpfad aus dem Kernel. Kein schnellerer Pfad — gar kein Pfad. Diese Möglichkeit gibt es viel öfter, als sie genutzt wird, und sie ist nur für diejenigen sichtbar, die Mathematik und Hardware zugleich im Blick haben.
Der Bericht und die Modellgewichte sind auf GitHub offen zugänglich. Der Architekturabschnitt umfasst acht Seiten und lohnt eine sorgfältige Lektüre.