
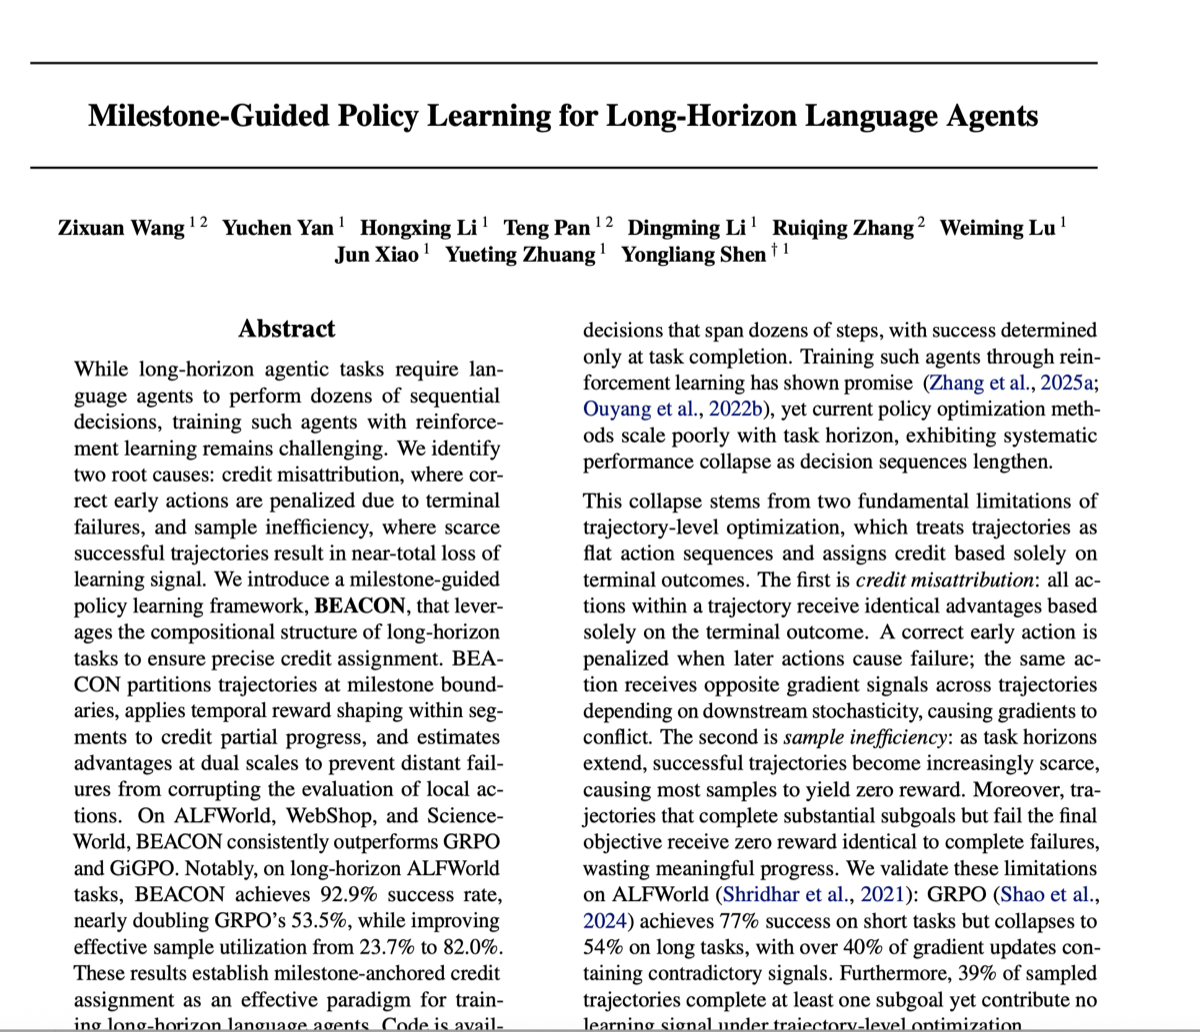
Агенты для длительных задач — те, что выполняют десятки шагов, прежде чем что-либо можно достоверно считать завершённым, — ошибаются иначе, чем агенты для коротких задач. По мере удлинения задач качество не снижается плавно. Оно обрушивается.
Недавняя работа лаборатории ZJU-REAL Чжэцзянского университета, Обучение политик языковых агентов для длительных задач с опорой на контрольные этапы, достаточно точно объясняет этот обвал, чтобы быть полезной, даже если вы никогда не обучаете политики самостоятельно. Метод называется BEACON; код открыт.
Мы внимательно прочитали работу, потому что описанная проблема — та же, с которой мы постоянно сталкиваемся в продукте. Далее — аргументация авторов, один результат, для объяснения которого нам пришлось разобрать математику, и то, что, на наш взгляд, переносится в архитектуру агентов.
Два измеримых типа сбоев
Больше всего нам нравится, что статья начинается не с метода, а с разбора провала: Qwen2.5-1.5B обучают с GRPO на ALFWorld, а обвал раскладывают на две количественно оценённые причины.
Неверное приписывание вклада действиям
Обучение с подкреплением на уровне траектории рассматривает запуск как плоскую последовательность действий. Всем действиям достаётся одна итоговая оценка. Поэтому одно и то же верное действие получает положительный градиент в успешном запуске и отрицательный в неудачном: его «правильность» зависит от того, что произошло потом.
Авторы измеряют это через долю действий с противоречивыми оценками: долю действий, которые получают преимущества противоположного знака в разных траекториях, хотя выполняются в идентичных состояниях. Она достигает более 40%. После взаимного погашения этих градиентов эффективный обучающий сигнал падает ниже 20%.
Неэффективное использование примеров
Разделим траектории на три группы: полный успех, частичный успех (хотя бы одна подцель достигнута, но задача провалена) и полный провал:
- Частичные успехи стабильно составляют 39–47% примеров на протяжении всего обучения.
- Полные успехи остаются ниже 27%.
При GRPO и частичный успех, и полный провал получают ноль. Более 73% примеров вообще не дают обучающего сигнала.
Обе проблемы усиливаются с увеличением горизонта: длительные задачи реже завершаются успешно (больше частичных успехов), а случайность последующих шагов получает больше возможностей исказить оценку вклада. Конкретно на ALFWorld: 76,7% на коротких задачах и 53,5% на длинных.
Ключевая мысль: у длительных задач уже есть структура
Длительные задачи распадаются на фазы, ограниченные контрольными этапами — проверяемыми переходами состояния, отмечающими достижение подцели. Плоская оптимизация просто отбрасывает эту структуру.
Авторы формализуют это как марковское свойство контрольных этапов: после достижения состояния контрольного этапа распределение оставшейся траектории зависит в основном от оставшихся подцелей, а не от всей истории пути к нему.
Когда ключ уже у вас, дальнейшее зависит от того, что вы с ним сделаете, а не от того, как вы его нашли.
Именно это приближённое марковское свойство позволяет разделить оценку вклада по сегментам.
Метод в три шага
1. Разделение по контрольным этапам
Детектор Φ отмечает моменты контрольных этапов и режет траекторию на сегменты. На наш взгляд, недооценённое проектное решение: Φ не требует ни обученной модели, ни ручной разметки. Он считывает наблюдаемые изменения состояния прямо из обратной связи среды: изменения состояния объектов в ALFWorld, переходы страниц в WebShop, явные сигналы подцелей в ScienceWorld.
Никаких дополнительных моделей и прогонов. В этом всё преимущество по затратам перед моделями вознаграждения за процесс и оценкой ценности методом Монте-Карло.
2. Временное формирование вознаграждения внутри каждого сегмента
r_t = R_ms * γ^(t_k − t)   if segment k ends in a completed milestone
    = 0                    otherwise
Вознаграждение получают только сегменты, которые заканчиваются контрольным этапом, а внутри такого сегмента действия ближе к нему получают больше. Теперь каждое действие завершённого сегмента несёт сигнал, поэтому частичные успехи больше не отбрасываются.
3. Преимущество на двух масштабах
Уровень траектории — стандартная нормализация GRPO по итоговым вознаграждениям. Суть идеи — на уровне сегмента, в определении группы сравнения:
G_k = { i : K_i ≥ k }          # only trajectories that ALSO reached milestone k

A_seg(i,t) = r_t − (1/|G_k|) · Σ_{j∈G_k}  R_k(j) / |Seg_k(j)|
                               └── group-average PER-STEP return ──┘
Действия в сегменте k сравниваются только с траекториями, которые тоже достигли контрольного этапа k. Отсюда авторы выводят свойство изоляции дисперсии: успех или провал последующих сегментов математически не может исказить оценку вклада текущего.
Итоговое преимущество равно A_traj + λ · A_seg и оптимизируется стандартной суррогатной целевой функцией PPO с отсечением. Гиперпараметры γ=0.95, λ=1.0 фиксированы для всех тестов — без настройки под задачу.
Результаты
ALFWorld, Qwen2.5-1.5B:
| Метод | Короткие | Средние | Длинные | Среднее |
|---|---|---|---|---|
| GRPO | 76,7 | 73,9 | 53,5 | 72,8 |
| GiGPO | 90,7 | 84,3 | 79,5 | 86,1 |
| BEACON | 96,8 | 87,0 | 92,9 | 91,4 |
Доля успешных выполнений в двух других средах:
| Метод | ScienceWorld | WebShop |
|---|---|---|
| GRPO | 21,1 | 56,8 |
| GiGPO | 25,8 | 65,0 |
| BEACON | 45,3 | 75,6 |
Модель с 1,5 млрд параметров превосходит GPT-4o на ALFWorld (91,4 против 48,0) и WebShop (75,6 против 23,7) и показывает равный результат на ScienceWorld (45,3 против 45,4). Важная оговорка: закрытые модели получают запросы с ReAct, а не проходят обучение. Использование примеров растёт с 23,7% до 82,0%, сходимость ускоряется: 60% успеха к итерации 50, тогда как GRPO достигает этого на итерации 120.
Самый убедительный результат — рост выигрыша с увеличением горизонта. На модели 7B относительное улучшение против GRPO растёт с +13% на коротких задачах до +39% на длинных; у GiGPO — лишь с +11% до +22%. Причина важна: GiGPO строит пошаговые группы сравнения по повторяющимся состояниям, а по мере улучшения политики и разнообразия её траекторий состояния повторяются реже — источник собственного сигнала истощается. Опоры на контрольные этапы не ослабевают по мере усиления политики.
Метод, чья польза растёт с усложнением задачи, — гораздо более сильное утверждение, чем просто более высокая средняя оценка.
Метрика, похожая на противоречие
В статье определяется коэффициент концентрации вклада — средний модуль преимущества для действий на контрольных этапах, делённый на тот же показатель для остальных действий. Значение выше 1 означает концентрацию вклада на контрольных этапах.
| Метод | CCR |
|---|---|
| GiGPO | 2,36 |
| GRPO | 1,37 |
| BEACON | 0,84 |
Получается, лучший метод концентрирует вклад на ключевых шагах меньше всего — что выглядит прямым противоречием тезису «действия ближе к контрольному этапу получают больше вознаграждения». Но противоречия нет. Два утверждения измеряют разные величины, между которыми находятся два преобразования.
Преобразование 1 — сформированное вознаграждение. Внутри сегмента вознаграждение действительно монотонно растёт к контрольному этапу. При γ=0.95 и длине сегмента 5 пять действий получают 0.8145, 0.857, 0.9025, 0.95, 1.0. Но это вознаграждение, а не вклад, который доходит до градиента.
Преобразование 2 — вычитание группового базового уровня. Базовый уровень — средняя по группе доходность на шаг (доходность сегмента ÷ длина сегмента). Для сегмента длины L доходность на шаг равна (1−γ^L) / (L(1−γ)):
| Длина сегмента | 3 | 5 | 8 | 10 |
|---|---|---|---|---|
| Доходность на шаг | 0,951 | 0,905 | 0,842 | 0,803 |
Если ваш сегмент занял 8 шагов при среднем по группе 5, доходность на шаг оказывается ниже базового уровня, и преимущество всего сегмента смещается в отрицательную сторону. Обратите внимание: штраф за блуждание возникает не из самого затухания, а из его действия через пошаговый базовый уровень. Само затухание лишь упорядочивает действия внутри сегмента. На этом этапе CCR внутри завершённого сегмента всё ещё больше 1.
Преобразование 3 — добавление слагаемого уровня траектории. Именно здесь CCR падает ниже 1 из-за двух асимметричных эффектов. Во-первых, хвостовой сегмент неудачной траектории вообще не входит в группу сравнения: поскольку G_k = {i : K_i ≥ k}, а незавершённый хвост имеет индекс K_i + 1 > K_i, эта траектория исключается. Хвост не получает преимущества уровня сегмента — только слагаемое уровня траектории в полном размере; при этом все его действия не относятся к контрольным этапам, что увеличивает знаменатель. Во-вторых, в неудачных траекториях отрицательное слагаемое уровня траектории гасит положительный вклад уровня сегмента на действиях контрольных этапов, сжимая их модуль к нулю.
Это подтверждает рисунок 8 самой статьи. В неудачной траектории, завершившей контрольные этапы S3 и S4:
| идти к унитазу | положить мыло (S3✓) | идти к стойке (S4✓) | идти к стойке | идти к держателю | |
|---|---|---|---|---|---|
| GRPO | −2,50 | −2,50 | −2,50 | −2,50 | −2,50 |
| BEACON | −0,92 | +0,51 | +0,32 | −2,20 | −2,20 |
Последние два значения одинаковы — характерный след того, что «хвостовой сегмент получает только слагаемое уровня траектории», позволяющий непосредственно определить A_traj ≈ −2.20. Два действия контрольных этапов положительны, но их модуль составляет лишь ~0,5, потому что отрицательное слагаемое траектории поглотило большую часть вклада уровня сегмента. CCR этой траектории равен 0,23; успешной — 2,95. Общее значение 0,84 получается из их смеси.
Таким образом, CCR измеряет концентрацию модуля градиента, а не то, кто получил вознаграждение. Низкий CCR — не цель проектирования, а побочный эффект плотного распределения внутри сегмента и сложения на двух масштабах. Вывод авторов остаётся верным и полезным: не направляйте всю энергию градиента на ключевые шаги. Значение 2,36 у GiGPO означает, что подготовительные действия между ними почти не получают сигнала, хотя именно они делают достижение контрольного этапа возможным.
То, чего статья не объясняет прямо
В таблице абляций есть странная ячейка. При γ=1 — равномерном распределении вклада внутри каждого сегмента — результат равен 71,8, хуже, чем вовсе без формирования вознаграждения (γ=0, 81,2), и даже ниже 72,8 у GRPO. Статья объясняет это «вводящими в заблуждение градиентами».
Если разобрать математику, ответ точнее. При γ=1 каждое действие завершённого сегмента получает одинаковое вознаграждение, поэтому у любого завершённого сегмента независимо от длины доходность на шаг в точности равна R_ms. Базовый уровень совпадает с ней, и:
A_seg(i,t) ≡ R_ms − R_ms = 0 for every actionКанал уровня сегмента не вводит в заблуждение. Он тождественно исчезает, и метод в точности сводится к GRPO. Сверьте с таблицей: 71,8 против 72,8 у GRPO — разница в один пункт, то есть шум между запусками.
Это меняет понимание роли затухания. Оно не только различает действия внутри сегмента, но и является необходимым условием самого существования сигнала уровня сегмента. Без него пошаговый базовый уровень сразу обнуляет сигнал.
Три эксперимента, снимающие очевидные возражения
Надо отдать авторам должное: они заранее отвечают на три вопроса скептического читателя:
- Не сводится ли это к клонированию поведения? SFT на эталонных траекториях даёт 43%; BEACON — 91,4%. Политика находит стратегии выполнения лучше эталона, значит, она не просто подражает.
- Не даёт ли выигрыш само разбиение? Случайное разбиение даёт 74,2%, всего на 1,4 пункта выше GRPO. Настоящие контрольные этапы дают 91,4% — разница 17,2 пункта. Пользу приносит внутренняя структура задачи.
- Что, если детектор ненадёжен? Случайный пропуск 50% контрольных этапов всё ещё даёт 82,8%, на десять пунктов выше GRPO. Ухудшение происходит плавно.
Что переносится в проектирование агентов
BEACON — метод обучения, а большинство продуктов, включая наш, оркестрируют модели, а не обучают их. Формулы не переносятся. Диагноз переносится и на удивление прямо соотносится с архитектурой.
Частичный прогресс должен быть полноценным сохраняемым состоянием. Самая показательная цифра статьи: 39–47% запусков достигают реальных подцелей, а затем оцениваются так же, как запуски, не сделавшие ничего. У длительной сессии агента, достигшей трёх подцелей и затем застрявшей, та же проблема: если система записывает только «выполняется» и «готово», прогресс теряется и повторная попытка начинается с нуля. Контрольные этапы дают понятия для его фиксации.
Контрольные этапы должны опираться на наблюдаемые последствия, а не на самоотчёт. Причина дешевизны Φ в том, что он читает проверяемые переходы состояния, а не спрашивает политику, продвинулась ли она. Средам выполнения агентов доступен тот же ресурс, которым они часто пренебрегают: записанный файл, тест с кодом завершения ноль, успешный вызов коннектора, документ, сохранённый в базе знаний. Это достоверные факты. Заявление модели «шаг один завершён» — нет.
Границы контрольных этапов — обоснованные точки сжатия контекста и возобновления. Марковское свойство контрольных этапов говорит, что после достижения этапа предыстория значит гораздо меньше. Это намного лучшее обоснование сжатия контекста, чем «достигнут порог токенов», и та же граница служит естественной контрольной точкой для возобновления после сбоя.
Проверяйте на двух масштабах, а не на одном. Эту абляцию мы бы особо выделили всем, кто строит рабочие процессы агентов: удаление сигнала уровня траектории снижает результат ALFWorld с 91,4% до 23,4%. При обратной связи только уровня сегмента политика закрепляет поведение, которое достигает промежуточных этапов, но уходит от реальной цели: каждая подзадача выполнена прекрасно, а конечный результат неверен. Приёмка подзадач и приёмка конечного результата не заменяют друг друга. Примечательно, что необходимый вес зависит от задачи: WebShop без уровня траектории всё ещё даёт 67,9%, поскольку его этапы тесно связаны с итоговым успехом; ALFWorld рушится.
Ограничения без прикрас
Главное ограничение — можно ли вообще получить Φ. Во всех трёх тестах контрольные этапы определяются правилами: сопоставлением шаблонов ответов среды, переходами страниц, явными сигналами подцелей. В открытых задачах вроде автоматизации браузера, рефакторинга кодовой базы и глубокого исследования таких готовых проверяемых переходов нет, и авторы называют автоматическое выявление этапов открытой проблемой. Это подход, проверенный в структурированных средах, а не инженерный рецепт, который можно перенести без изменений.
Чувствительна и детализация этапов: слишком редкие приближают метод к GRPO, слишком частые зашумляют преимущества сегментов. Марковское свойство лишь приближённое, а изоляция дисперсии на него опирается. Эксперименты ограничены моделями до 7B и дискретными пространствами текстовых действий; непрерывное управление и многоагентные среды не проверялись.
И всё же с главным тезисом нам трудно спорить: у длительных задач есть полезная составная структура, и явная работа с ней лучше надежды на то, что модель удержит её в контексте. Мы применяем этот подход к поддержке длительных задач в Orkas и расскажем больше о проектных решениях по мере их внедрения.