
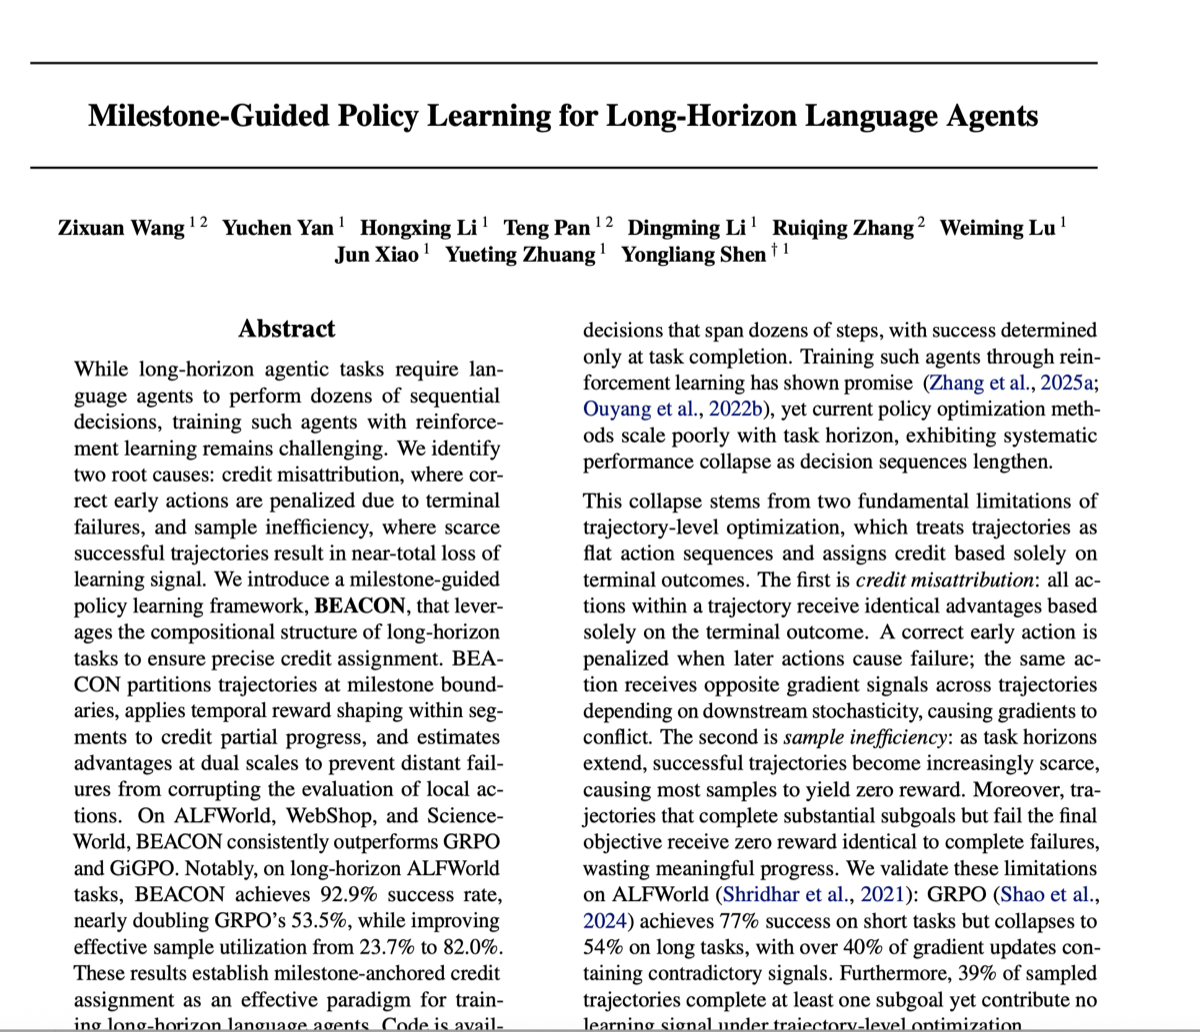
Herhangi bir şey doğrulanabilir biçimde tamamlanmadan önce onlarca adım çalışan uzun ufuklu ajanlar, kısa ufuklu ajanlarda görülmeyen bir şekilde başarısız oluyor. Görevler uzadıkça performans yavaşça düşmüyor. Uçurumdan aşağı yuvarlanıyor.
Zhejiang Üniversitesi ZJU-REAL laboratuvarının yakın tarihli makalesi, Uzun Ufuklu Dil Ajanları için Kilometre Taşı Rehberliğinde Politika Öğrenimi, kendiniz hiç politika eğitmeseniz bile işe yarayacak kadar kesin biçimde bu uçurumu teşhis ediyor. Yöntemin adı BEACON; kodu açık kaynak.
Makaleyi dikkatle okuduk; çünkü anlattığı sorun, ürün tarafında tekrar tekrar karşılaştığımız sorunla aynı. Aşağıda makalenin savını, bir sonucu anlamlandırmak için matematiğini çözmemiz gereken noktayı ve ajan mimarisine aktarılabileceğini düşündüğümüz çıkarımları bulacaksınız.
İkisi de ölçülebilen iki başarısızlık biçimi
En çok takdir ettiğimiz şey, makalenin bir yöntemle başlamaması. Bir otopsiyle başlıyor: ALFWorld üzerinde GRPO ile eğitilen Qwen2.5-1.5B ve çöküşün iki nicel olarak ölçülmüş nedene ayrılması.
Katkının yanlış atanması
Yörünge düzeyindeki pekiştirmeli öğrenme, bir çalıştırmayı düz bir eylem dizisi olarak ele alır. Her eylem aynı son puanı paylaşır. Böylece aynı doğru eylem, başarılı bir çalıştırmada pozitif, başarısız bir çalıştırmada negatif gradyan alır; “doğru” olup olmadığı, sonrasında.
Yazarlar bunu Çelişkili Eylem Oranıolarak nicelleştiriyor: aynı durumlarda gerçekleştirilmelerine rağmen farklı yörüngelerde zıt işaretli avantajlar alan eylemlerin oranı. En yüksek değeri %40'ın üzerine çıkıyor. Bu gradyanlar birbirini götürdükten sonra etkin öğrenme sinyali %20'nin altına düşüyor.
Örneklem verimsizliği
Yörüngeleri üç gruba ayırın: tam başarı, kısmi başarı (en az bir alt hedef tamamlanmış, görev yine de başarısız) ve tam başarısızlık:
- Kısmi başarılar, eğitim boyunca örneklemlerin 39–47% oranında sabit kalıyor.
- Tam başarılar %27'nin altında kalıyor.
GRPO'da kısmi başarı da tam başarısızlık da sıfır puan alıyor. Örneklemlerin %73'ünden fazlası hiçbir öğrenme sinyali üretmiyor.
Ufuk uzadıkça iki sorun da büyüyor: uzun görevler daha seyrek başarıya ulaşıyor (daha fazla kısmi başarı) ve sonraki adımlardaki rastlantısallığın katkı atamasını bozması için daha fazla fırsat doğuyor. Somut olarak ALFWorld'de: kısa görevlerde %76.7, uzun görevlerde %53.5.
Temel fikir: uzun görevlerin zaten bir yapısı var
Uzun ufuklu görevler, sınırlarını belirleyen kilometre taşlarıyla aşamalara ayrılır; bunlar, alt hedeflerin tamamlandığını gösteren doğrulanabilir durum geçişleridir. Düz optimizasyon bu yapıyı basitçe göz ardı eder.
Yazarlar bunu Kilometre Taşı Markov Özelliğiolarak biçimselleştiriyor: bir kilometre taşı durumuna ulaştığınızda, yörüngenin geri kalanının dağılımı büyük ölçüde oraya nasıl geldiğinizin tüm geçmişine değil, hangi alt hedeflerin kaldığına bağlıdır.
Anahtarı ele geçirdikten sonra olacaklar, onu nasıl bulduğunuza değil, onunla ne yaptığınıza bağlıdır.
Katkı atamasının segmentler arasında ayrıştırılabilmesini sağlayan, bu yaklaşık Markov özelliğidir.
Üç adımda yöntem
1. Kilometre taşlarında bölün
Bir algılayıcı Φ kilometre taşlarına ait zaman adımlarını işaretler ve yörüngeyi segmentlere böler. Yeterince önemsenmediğini düşündüğümüz tasarım kararı şu: Φ öğrenilmiş bir modele de insan etiketlemesine de ihtiyaç duymaz. Gözlemlenebilir durum değişikliklerini doğrudan ortam geri bildiriminden okur: ALFWorld'de nesne durumu geçişleri, WebShop'ta sayfa geçişleri, ScienceWorld'de açık alt hedef sinyalleri.
Sıfır ek model, sıfır ek yörünge üretimi. Süreç ödül modelleri ve Monte Carlo değer tahmini karşısındaki maliyet avantajının tamamı budur.
2. Her segment içinde zamansal ödül şekillendirme
r_t = R_ms * γ^(t_k − t)   if segment k ends in a completed milestone
    = 0                    otherwise
Yalnızca bir kilometre taşında sonlanan segmentler ödül kazanır; böyle bir segment içinde kilometre taşına daha yakın eylemler daha fazla ödül alır. Tamamlanmış bir segmentteki her eylem artık sinyal taşır; böylece kısmi başarılar gözden çıkarılmaz.
3. Çift ölçekli avantaj
Yörünge düzeyi, son ödüller üzerinde standart GRPO normalizasyonudur. Fikrin özü segment düzeyinde, karşılaştırma grubunun nasıl tanımlandığında yatar:
G_k = { i : K_i ≥ k }          # only trajectories that ALSO reached milestone k

A_seg(i,t) = r_t − (1/|G_k|) · Σ_{j∈G_k}  R_k(j) / |Seg_k(j)|
                               └── group-average PER-STEP return ──┘
Segmentteki eylemler, k karşılaştırılır yalnızca aynı kilometre taşına ulaşmış yörüngelerle k. Yazarlar buradan bir varyans yalıtımı özelliği türetiyor: sonraki segmentlerin başarılı ya da başarısız olması, mevcut segmentin katkı atamasını matematiksel olarak kirletemez.
Nihai avantaj A_traj + λ · A_segolup standart PPO kırpılmış vekil amaç fonksiyonuyla optimize edilir. Hiperparametreler γ=0.95, λ=1.0 tüm kıyaslamalarda sabittir; göreve özel ayar yapılmaz.
Sonuçlar
ALFWorld, Qwen2.5-1.5B:
| Yöntem | Kısa | Orta | Uzun | Ort. |
|---|---|---|---|---|
| GRPO | 76.7 | 73.9 | 53.5 | 72.8 |
| GiGPO | 90.7 | 84.3 | 79.5 | 86.1 |
| BEACON | 96.8 | 87.0 | 92.9 | 91.4 |
Diğer iki ortamda başarı oranı:
| Yöntem | ScienceWorld | WebShop |
|---|---|---|
| GRPO | 21.1 | 56.8 |
| GiGPO | 25.8 | 65.0 |
| BEACON | 45.3 | 75.6 |
1.5B model, ALFWorld'de (91.4'e karşı 48.0) ve WebShop'ta (75.6'ya karşı 23.7) GPT-4o'yu geride bırakıyor; ScienceWorld'de ise onunla başa baş (45.3'e karşı 45.4). Adil bir not: kapalı modeller eğitilmiyor, ReAct ile istemlendiriliyor. Örneklem kullanımı %23.7'den %82.0'ye yükseliyor ve yakınsama hızlanıyor: GRPO'nun 120. iterasyonda ulaştığı %60 başarıya 50. iterasyonda ulaşılıyor.
En ikna edici sonuç, kazanımların ufukla birlikte büyümesi. 7B'de GRPO'ya göre göreli iyileşme, kısa görevlerde +%13 iken uzun görevlerde +39% oluyor; GiGPO ise yalnızca +%11'den +%22'ye çıkıyor. Nedeni önemli: GiGPO, adım düzeyindeki karşılaştırma gruplarını tekrarlanan durumlardanoluşturuyor; politika iyileşip yörüngeleri çeşitlendikçe durumların tekrarı seyrekleşiyor ve kendi sinyal kaynağı aşınıyor. Kilometre taşı dayanakları, politika güçlendikçe zayıflamıyor.
Sorun zorlaştıkça faydası artan bir yöntem, daha yüksek bir ortalama puandan çok daha güçlü bir iddiadır.
Çelişki gibi görünen metrik
Makale bir Katkı Yoğunlaşma Oranı tanımlıyor: kilometre taşı eylemlerindeki ortalama avantaj büyüklüğünün kilometre taşı olmayan eylemlerdeki değere bölümü. 1'in üzeri, katkının kilometre taşlarında yoğunlaştığı anlamına geliyor.
| Yöntem | CCR |
|---|---|
| GiGPO | 2.36 |
| GRPO | 1.37 |
| BEACON | 0.84 |
Dolayısıyla en iyi performansı gösteren yöntem, katkıyı kilit adımlarda en az yoğunlaştıran yöntem; bu da “kilometre taşına daha yakın eylemler daha fazla ödül alır” ifadesiyle doğrudan çelişiyor gibi görünüyor. Öyle değil. İki ifade, aralarında iki dönüşüm bulunan farklı nicelikleri ölçüyor.
Dönüşüm 1 — şekillendirilmiş ödül. Bir segment içinde ödül, kilometre taşına doğru gerçekten monoton biçimde artar. Şu değerle: γ=0.95 ve 5 uzunluğunda bir segmentte, beş eylem şu ödülleri alır: 0.8145, 0.857, 0.9025, 0.95, 1.0. Ama bu ödüldür, gradyana ulaşan katkı değildir.
Dönüşüm 2 — grup taban değerini çıkarın. Taban değer, grubun ortalama adım başına getirisidir (segment getirisi ÷ segment uzunluğu). Uzunluğu şu olan bir segment için: L, adım başına getiri (1−γ^L) / (L(1−γ)):
| Segment uzunluğu | 3 | 5 | 8 | 10 |
|---|---|---|---|---|
| Adım başına getiri | 0.951 | 0.905 | 0.842 | 0.803 |
Grup ortalaması 5 iken segmentiniz 8 adım sürdüyse adım başına getiriniz taban değerin altında kalır ve tüm segmentin avantajı negatife kayar. Bunun anlamına dikkat edin: amaçsız dolaşmanın cezası azalmanın kendisinden değil, azalmanın adım başına taban değer üzerinden etkili olmasından gelir. Azalma tek başına yalnızca eylemleri sıralar, segmentin içinde . Bu noktada tamamlanmış bir segmentin içindeki CCR hâlâ 1'den büyüktür.
Dönüşüm 3 — yörünge düzeyindeki terimi ekleyin. CCR burada iki asimetrik etkiyle 1'in altına düşer. İlk olarak, başarısız bir yörüngenin son segmenti hiçbir karşılaştırma grubuna girmez: çünkü G_k = {i : K_i ≥ k} ve tamamlanmamış son segmentin indeksi K_i + 1 > K_iolduğundan bu yörünge dışarıda kalır. Son segment, segment düzeyinde avantaj almaz; yalnızca yörünge düzeyindeki terimi tam büyüklüğüyle alır ve buradaki eylemlerin hepsi kilometre taşı olmayan eylemlerdir, dolayısıyla paydayı büyütürler. İkinci olarak, başarısız yörüngelerde negatif yörünge düzeyi terimi, kilometre taşı eylemlerindeki pozitif segment düzeyi katkısını götürerek bunların büyüklüğünü sıfıra doğru sıkıştırır.
Makalenin kendi Şekil 8'i bunu doğruluyor. S3 ve S4 kilometre taşlarını tamamlayan başarısız bir yörüngede:
| tuvalete git | kalıp sabunu koy (S3✓) | tezgâha git (S4✓) | tezgâha git | tutucuya git | |
|---|---|---|---|---|---|
| GRPO | −2.50 | −2.50 | −2.50 | −2.50 | −2.50 |
| BEACON | −0.92 | +0.51 | +0.32 | −2.20 | −2.20 |
Son iki değer aynıdır ; bu, “son segment yalnızca yörünge düzeyindeki terimi alır” durumunun ayırt edici izidir ve buradan A_traj ≈ −2.20değerini okuyabilirsiniz. İki kilometre taşı eylemi pozitiftir ancak büyüklükleri yalnızca ~0.5'tir; çünkü negatif yörünge terimi segment düzeyindeki katkının çoğunu tüketmiştir. Bu yörünge için CCR 0.23, başarılı bir yörünge için 2.95'tir. Genel 0.84 değeri bu ikisinin karışımıdır.
Dolayısıyla CCR, gradyan büyüklüğünün yoğunlaşmasınıölçer; kimin ödül aldığını değil. Düşük CCR bir tasarım hedefi değildir; segment içindeki yoğun dağıtım ile çift ölçekli üst üste eklemenin yan ürünüdür. Yazarların sonucu hâlâ geçerlidir ve iyi bir sonuçtur: tüm gradyan enerjinizi kilit adımlara yığmayın. GiGPO'nun 2.36 değeri, aradaki hazırlayıcı eylemlerin neredeyse hiç sinyal almadığı anlamına gelir; oysa kilometre taşına ulaşmayı mümkün kılan tam da bu eylemlerdir.
Makalenin açıkça söylemediği bir şey
Ablasyon tablosunda tuhaf bir hücre var. Şu ayar: γ=1 — her segment içinde eşit katkı ataması — şu puanı alıyor: 71.8; bu, hiç şekillendirme yapılmamasından (γ=0, 81.2) daha kötü ve hatta GRPO'nun 72.8 değerinin altında. Makale bunu “yanıltıcı gradyanlara” bağlıyor.
Matematiği çözdüğünüzde yanıt daha net. Şu durumda: γ=1 tamamlanmış bir segmentteki her eylem aynı ödülü alır; dolayısıyla uzunluğu ne olursa olsun her tamamlanmış segmentin adım başına getirisi tam olarak R_msolur. Taban değer de buna eşittir ve:
A_seg(i,t) ≡ R_ms − R_ms = 0 for every actionSegment düzeyindeki kanal yanıltmaz. Özdeş olarak sıfırlanırve yöntem tam olarak GRPO'ya indirgenir. Tablodan kontrol edin: GRPO'nun 72.8'ine karşı 71.8; aradaki bir puan, çalıştırmalar arasındaki gürültüdür.
Bu da azalmanın ne işe yaradığını yeniden çerçeveliyor. Yalnızca segment içindeki eylemleri farklılaştırmakla ilgili değildir; segment düzeyindeki sinyalin var olabilmesi için gerekli bir koşuldur. O olmadan adım başına taban değer, sinyali anında götürür.
Bariz itirazları yanıtlayan üç deney
Hakkını teslim edelim: yazarlar, şüpheci bir okurun soracağı üç soruyu peşinen yanıtlıyor:
- Bu yalnızca davranış klonlama mı? Kusursuz referans yörüngeleri üzerinde SFT %43'e ulaşırken BEACON %91.4'e ulaşıyor. Politika, referanstan daha iyi yürütme stratejileri buluyor; dolayısıyla taklit etmiyor.
- Kazanımlar yalnızca parçalara ayırmaktan mı geliyor? Rastgele bölümlendirme %74.2 alıyor; GRPO'nun yalnızca 1.4 puan üzerinde. Gerçek kilometre taşları %91.4 alıyor; fark 17.2 puan. Fayda, görevin özündeki yapıdan geliyor.
- Algılayıcı güvenilir değilse ne olur? Kilometre taşlarının %50'sini rastgele çıkarmak bile %82.8 getiriyor; GRPO'nun on puan üzerinde. Performans kademeli olarak düşüyor.
Ajan tasarımına neler aktarılabilir?
BEACON bir eğitim yöntemi; bizimki de dâhil çoğu ürün ise modelleri eğitmek yerine koordine ediyor. Formüller aktarılmıyor. Teşhis aktarılıyor ve şaşırtıcı derecede doğrudan mimariye karşılık geliyor.
Kısmi ilerleme, temel ve kalıcı olarak saklanan bir durum olmalıdır. Makalenin en çarpıcı rakamı şu: çalıştırmaların %39–47'si gerçek alt hedefleri tamamlıyor, ardından hiçbir şey yapmayan çalıştırmalarla aynı puanı alıyor. Üç alt hedefi tamamlayıp sonra takılan uzun süreli bir ajan oturumu da aynı sorunu yaşar: sistem yalnızca “çalışıyor” ve “bitti” durumlarını kaydediyorsa ilerleme çöpe gider, yeniden deneme sıfırdan başlar. Kilometre taşları bunu kaydetmek için gereken söz dağarcığını sağlar.
Kilometre taşları öz bildirime değil, gözlemlenebilir yan etkilere dayanmalıdır. Şunun: Φ düşük maliyetli olmasının nedeni, politikaya ilerleme kaydedip kaydetmediğini sormak yerine doğrulanabilir durum geçişlerini okumasıdır. Ajan çalışma ortamları aynı imkâna sahiptir ama bunu sık sık göz ardı eder: yazılmış bir dosya, sıfır çıkış koduyla bitmiş bir test, başarı döndürmüş bir bağlayıcı çağrısı, bilgi tabanına kaydedilmiş bir belge. Bunlar doğrulanmış gerçeklerdir. Bir modelin “birinci adım tamamlandı” demesi öyle değildir.
Kilometre taşı sınırları, ilkeye dayalı bağlam sıkıştırma ve devam etme noktalarıdır. Kilometre Taşı Markov Özelliği, bir kilometre taşına ulaşıldıktan sonra öncesinde olanların çok daha az önem taşıdığını söyler. Bu, bağlamı sıkıştırmak için “token eşiğine ulaştık” gerekçesinden çok daha iyidir; aynı sınır, başarısızlık sonrasında devam etmek için de doğal kontrol noktasıdır.
Tek değil, iki ölçekte doğrulayın. Ajan iş akışları kuran herkes için altını çizeceğimiz ablasyon şu: yörünge düzeyindeki sinyali kaldırmak, ALFWorld'ü %91.4'ten 23.4%düşürüyor. Yalnızca segment düzeyindeki geri bildirimle politika, asıl hedeften uzaklaşırken ara kilometre taşlarına ulaşan davranışı pekiştiriyor: her alt görev kusursuz yürütülmüş, teslimat yanlış. Alt görev kabulü ile nihai teslimat kabulü birbirinin yerine geçmez. Özellikle, gereken ağırlık göreve göre değişir: WebShop, kilometre taşları nihai başarıyla yakından örtüştüğü için yörünge düzeyi olmadan da %67.9'a ulaşırken ALFWorld çöküyor.
Dürüstçe belirtilen sınırlamalar
En büyük kısıt, Φ elde edilmesinin mümkün olup olmadığıdır. Üç kıyaslamanın tamamı kilometre taşlarını kurallardan türetiyor: ortam yanıtlarında örüntü eşleme, sayfa geçişleri, açık alt hedef sinyalleri. Tarayıcı otomasyonu, kod tabanı yeniden düzenleme ve derinlemesine araştırma gibi ucu açık ortamlarda bu tür hazır, doğrulanabilir geçişler yok; yazarlar otomatik kilometre taşı keşfini açık bir sorun olarak listeliyor. Bu, olduğu gibi alınacak bir mühendislik tarifi değil, yapılandırılmış ortamlarda doğrulanmış bir paradigma olarak okunmalı.
Kilometre taşlarının ayrıntı düzeyi de hassastır: fazla seyrek olurlarsa yöntem GRPO'ya doğru geriler, fazla sık olurlarsa segment avantajları gürültülü hâle gelir. Markov özelliği yalnızca yaklaşıktır ve varyans yalıtımı buna dayanır. Deneyler, ayrık metin eylem uzaylarıyla 7B'de son buluyor; sürekli kontrol ve çok ajanlı ortamlar test edilmemiş.
Yine de temel iddiaya karşı çıkmak bize zor geliyor: uzun görevlerin yararlanılabilir bileşimsel bir yapısı vardır ve bu yapıyı temel bir nesne olarak ele almak, modelin onu bağlam içinde takip etmesini ummaktan daha iyidir. Bu düşünceyi Orkas'taki uzun ufuklu görev desteğine uyguluyoruz; tasarım hayata geçtikçe daha fazlasını paylaşacağız.