
In diesem Monat sind zwei Echtzeit-Videomodelle im Abstand von einer Woche erschienen. Vidu S2 von ShengShu ging am 15. September online, und PixVerse kündigte PixVerse R2 am 22. September an. S2 ist auf digitale Live-Figuren ausgelegt und darauf, einen Videostream umzugestalten, während er läuft. R2 versteht sich als Echtzeit-Weltmodell: eine Szene, durch die man sich mit WASD bewegt, während Texte, Referenzen und Audio verändern, was als Nächstes passiert.
Beide Teams haben veröffentlicht, wie sie es gebaut haben – S2 als Paper auf arXiv, R2 als technischen Bericht auf der PixVerse-Website. Wir haben beide nebeneinander gelesen. Sie stimmen im Grundgerüst überein, trennen sich bei fünf Designentscheidungen und legen sehr unterschiedlich viel offen. Dieser Beitrag behandelt alle drei Punkte und verzichtet bewusst darauf, einen Sieger zu küren: Die beiden wurden nie im selben Test gemessen.
Was Echtzeit verändert
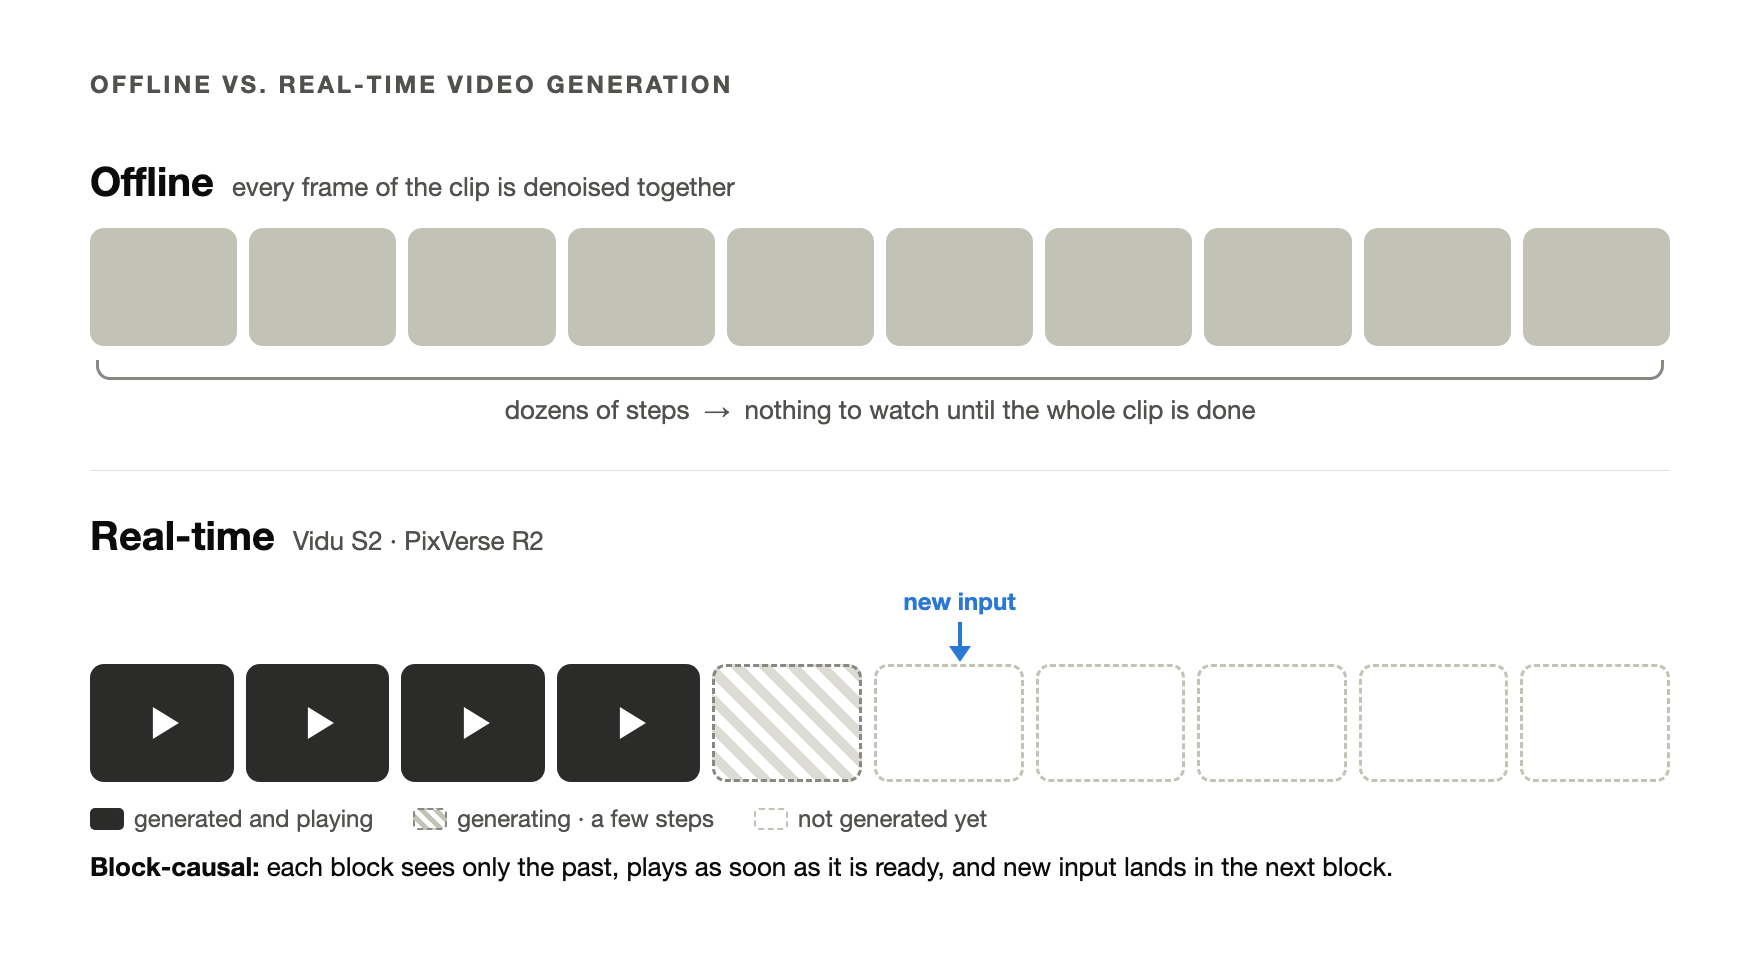
Die meisten Videomodelle arbeiten offline. Alle Frames eines Clips werden gemeinsam über Dutzende Schritte entrauscht, und zu sehen ist nichts, bevor der ganze Clip fertig ist. Alles, was man möchte, muss vor dem Start der Generierung im Prompt stehen.
Ein Echtzeitmodell dreht das um. Es zerlegt das Video in Blöcke – einige Frames plus den passenden Audioabschnitt – und erzeugt sie der Reihe nach. Jeder Block bekommt nur wenige Entrauschungsschritte und wird abgespielt, sobald er fertig ist. Ein Block sieht, was vor ihm kam, aber nie, was danach kommt; genau das bedeutet blockkausal. Eine neue Anweisung wirkt sich auf den nächsten Block aus.
Diese Form schafft drei Probleme, und fast jede der folgenden Entscheidungen beantwortet eines davon:
- Fehler häufen sich an. Jeder Block ist an Blöcke gebunden, die das Modell selbst erzeugt hat; ein kleiner Fehler wird also an alles Nachfolgende vererbt.
- Der Verlauf muss begrenzt bleiben. Ein Stream kann beliebig lange laufen; würde man jeden vergangenen Block behalten, würde jeder neue Block teurer.
- Das Zeitbudget ist gnadenlos. Bei 25 Bildern pro Sekunde hat jedes Bild 40 Millisekunden.
S2 und R2 landen beim selben Grundgerüst: einem blockkausalen, autoregressiven Diffusionsmodell, das Video und Audio gemeinsam erzeugt. Die Unterschiede liegen darin, wie sie es trainieren, stabil halten, mit Gedächtnis ausstatten, beschleunigen und von Menschen steuern lassen.
Die beiden Systeme
Vidu S2 (ShengShu Technology mit der Tsinghua-Universität) besteht aus zwei Modellen. S2-Avatar ist eine digitale Live-Figur in 720p mit 25–42 FPS, nach 540p bei S1. Man kann ihr mitten im Stream ein neues Referenzbild geben – eine Tasse, eine Jacke, einen Strand –, und die Figur greift danach, zieht die Jacke an oder geht in die Szene hinein; tanzen kann sie auch. S2-Editing gestaltet einen eingehenden Videostream in Echtzeit um – mehr als 50 Stile, virtuelle Anprobe, Austausch von Person und Hintergrund –, während die Bewegung des Originals erhalten bleibt. Das Paper erprobt außerdem eine Stereo-Ausgabe für VR-Headsets.
PixVerse R2 ist ein einzelnes Modell für interaktive Welten. Während es läuft, können vier Arten von Eingaben eintreffen – Text, multimodale Referenzen, Audio und Aktionen wie WASD –, und jede verändert den Zustand der Welt, nicht nur das aktuelle Bild. Die Spiele-Engine von PixVerse läuft inzwischen auf R2; die öffentliche Demo konzentriert sich auf Bewegung und Prompts.
Entscheidung 1: Wie das Modell trainiert wird
Echtzeitmodelle werden nicht von null an trainiert. Üblicher Ausgangspunkt ist ein starkes generatives Offline-Vorwissen, das anschließend so umgebaut wird, dass es kausal und mit wenigen Schritten läuft. Hier gehen die beiden Berichte am deutlichsten auseinander.
S2 arbeitet als Staffel. Ein bidirektionales Audio-Video-Modell wird vortrainiert und dann mit Diffusion-DPO auf Bildtreue, Ausdruck, Bewegung und Audio-Video-Synchronität abgestimmt. Seine Attention wird auf blockkausal umgestellt und mit einer Mischung aus sauberem und verrauschtem Verlauf trainiert (Entscheidung 2). Danach destilliert Self-Replay Forcing es auf wenige Schritte, während es an seinen eigenen Ausgaben trainiert, und ein abschließender Präferenzdurchgang für Streaming (Streaming NFT) stimmt das kausale Modell ab. Avatar und Editing werden als getrennte Modelle trainiert.
R2 behält ein einziges Fundament. Omni Causal AR ist ein kausales Modell, das fortlaufend mit kurzen Clips, langen Videos, multimodalen Daten und Interaktionsverläufen vortrainiert wird. Real-Time Acceleration destilliert anschließend dasselbe Modell für den Live-Einsatz: Der Schüler wird daraus initialisiert, und der Lehrer baut darauf auf. Die Formel des Berichts lautet „beschleunigen, nicht neu lernen“.
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| Ausgangspunkt | Bidirektionales Modell, mit Diffusion-DPO abgestimmt | Fortlaufend vortrainiertes kausales Modell |
| Weg zur Echtzeit | Blockkausale Anpassung → Self-Replay Forcing → Präferenzabstimmung für Streaming | Dasselbe Modell direkt destillieren |
| Modelle | Getrennte Modelle für Avatar und Editing | Ein Modell für alle Eingabearten |
Der R2-Bericht zeichnet den üblichen Ansatz als fünfstufige Staffel und argumentiert, dass bei jeder Übergabe ein Teil der Fähigkeiten verloren geht. Nüchtern gelesen hat die Pipeline von S2 genau diese mehrstufige Form, mit ihrer wichtigsten Verbesserung in der letzten Stufe. Keines der beiden Teams hat ein Experiment veröffentlicht, das die beiden Wege vergleicht; welcher besser skaliert, ist noch offen.
Entscheidung 2: Den Stream am Abdriften hindern
Drift ist der typische Fehler von Streaming-Video: Die Farbe verschiebt sich, ein Gesicht wird allmählich zu dem eines anderen Menschen, und schließlich zerfällt das Bild. Das liegt daran, dass das Training dem Modell einen sauberen Verlauf zeigt, während es bei der Inferenz nur seine eigene, unvollkommene Ausgabe sieht.
Beide Teams beginnen mit derselben Korrektur. Sie mischen Teacher Forcing, das auf den sauberen, echten Verlauf konditioniert und die Qualität schützt, mit Diffusion Forcing, das auf einen Verlauf mit zufällig starkem Rauschen konditioniert. Rauschen löscht feine Details, erhält aber Bildaufbau und Bewegung; das Modell lernt so, sich auf die Struktur zu stützen, statt jedem Pixel der Vergangenheit zu trauen.
Ein verrauschter echter Verlauf ist trotzdem nicht dasselbe wie die eigenen Fehler des Modells, deshalb fügt jedes Team eine zweite Ebene hinzu.
S2: Self-Replay Forcing. Zuerst erzeugt das Modell einen langen Abschnitt genau so, wie es das bei der Inferenz tun würde, ohne Gradienten zu speichern. Ein Fenster dieses Verlaufs wird Block für Block neu verrauscht und in einem einzigen kausalen Durchlauf mit Gradienten erneut abgespielt, trainiert mit einem DMD-Destillationsverlust plus einem perzeptuellen Verlust. Weil die erneut abgespielten Blöcke in einem Rechengraphen liegen, fließen die Gradienten über Blockgrenzen hinweg – das Modell lernt, wie ein Block den nächsten prägt –, ohne durch die ursprüngliche Generierung zurückzupropagieren.
R2: Error Bank. Typische Fehlerzustände aus der Generierung werden gespeichert und im Training zusammen mit dem normalen Verlauf erneut abgespielt, damit das Modell lernt, sich zu erholen, nachdem eine Abweichung bereits in die Welt geraten ist. In der internen Stufenbewertung von PixVerse sank eine Kennzahl für die langfristige Helligkeitsdrift von 0,201 auf 0,129, ein Rückgang um 35,8 %; 20 von 29 langen Sequenzen verbesserten sich, und in allen fünf Proben ohne Bewegung ging die Scheinbewegung zurück.
Die beiden ergänzen sich, statt zu konkurrieren. Self-Replay Forcing trainiert an dem, was das aktuelle Modell falsch macht; Error Bank übt die Fehler, die es wert sind, im Gedächtnis zu bleiben.
Entscheidung 3: Ein begrenztes Gedächtnis
Beide behalten einige Anfangsblöcke dauerhaft als Anker (einen Sink), halten ein gleitendes Fenster aus aktuellen Blöcken vor und verwerfen den Rest; so steigen die Kosten eines neuen Blocks nicht mit der Länge des Streams. Beide halten außerdem die Positionskoordinaten in dem Bereich, der im Training vorkam – S1 nennt das RoPE-Repositionierung, R2 relatives zeitliches RoPE –, sodass eine lange Sitzung die Positionen nie aus der Verteilung schiebt.
S2 baut auf dem TwinCache aus S1 auf, bei dem jeder vergangene Block zweimal zwischengespeichert wird: einmal verrauscht, einmal sauber. Die mittleren Entrauschungsschritte lesen die verrauschte Kopie, die die grobe Bewegung transportiert und wie ein Tiefpassfilter gegen sich häufende Artefakte wirkt; der letzte Schritt liest die saubere Kopie, um Details wiederherzustellen. S2 verteilt das auf seine zwei Stufen: Das Backbone liest einen stark verrauschten Cache, der Refiner einen schwach verrauschten in hoher Auflösung.
R2 trennt das Gedächtnis nach Zeitskala: Sink Memory für Identität, Umgebung, Stil und Weltregeln; Rolling History für jüngste Bewegung, Pose und Kamera; und einen Object KV Cache, der den Zustand von Objekten komprimiert, die später noch eine Rolle spielen.
Die Aufteilung spiegelt die Produkte. Eine digitale Figur muss dieselbe Person bleiben. Eine Welt muss sich zusätzlich daran erinnern, was in ihr geschehen ist – an den Gegenstand, den man abgelegt hat, an die Entscheidung, die man getroffen hat.
Entscheidung 4: Woher die Geschwindigkeit kommt
Beide nutzen Sparse Attention und Destillation auf wenige Schritte, setzen ihren Aufwand aber an unterschiedlichen Stellen ein.
S2 setzt auf Systemtechnik und dokumentiert sie. Die Attention wird pro Schicht aus SageAttention, SpargeAttention und Sparse-Linear-Attention gewählt, mit den aggressivsten Näherungen in den am wenigsten empfindlichen Schichten. Lineare Schichten laufen als blockweise W8A8-Matrixmultiplikationen. Benachbarte Operatoren werden zu Triton/CUDA-Kernels verschmolzen und mit CUDA Graphs wiedergegeben. Auf mehreren GPUs kommt Kontextparallelität im Ulysses-Stil mit quantisierter Kommunikation zum Einsatz, und in der Editing-Pipeline teilen sich VAE-Encoder, Backbone, Refiner und Decoder die GPUs auf einer gemeinsamen Zeitachse. Die Auflösung entsteht aus einem Backbone mit niedriger Auflösung plus einem einstufigen latenten Refiner bis 720p.
R2 setzt auf das Modell. Blockweise Sparse Attention wird im Training gelernt und erreicht mehr als 90 % Sparsität. Die Destillation folgt Decoupled DMD – dem Steuersignal folgen und dem Lehrer entsprechen werden als getrennte Ziele optimiert – plus einem adversarialen Term aus DMD2, der den Realismus absichert. Die Auflösung folgt einer Pyramide: Eine oder zwei Stufen mit niedriger Auflösung legen Bildaufbau, Bewegung und Kamera fest, eine letzte Stufe in hoher Auflösung ergänzt die Textur. Ausgabeauflösung und Bildrate von R2 nennt der Bericht nicht.
Entscheidung 5: Wie Menschen es steuern
S2 legt einen VLM-Agenten um das Modell. Der Agent ordnet jedes Referenzbild als gehaltenen Gegenstand, Hintergrund oder Kleidung ein und schreibt für jedes Segment einen Prompt zu Identität, Ausdruck, Blick, Pose, Handlung und gehaltenen Gegenständen; alles, was der Nutzer nicht ändern wollte, bleibt erhalten. Nach der Generierung prüft er die Frames der Reihe nach, beurteilt, ob die Handlung abgeschlossen, halb erledigt oder misslungen ist, und schreibt danach den nächsten Prompt. Beim An- und Ablegen von Accessoires beschreiben die Prompts sowohl die Bewegung als auch den Endzustand, sodass ein wieder aufgesetzter Hut auch aufbleibt. Im Editing-Modus sorgt bildgenaue Attention dafür, dass jeder Ausgabeframe nur den Quellframe desselben Moments liest; Bewegung und Timing stimmen so exakt mit der Eingabe überein.
R2 baut eine einzige Eingabeschnittstelle in das Modell ein. Text, Referenzen, Audio, Aktionen und von Agenten erzeugte Steuerungen landen alle in derselben laufenden Welt. Die Blocklänge folgt der aktiven Steuerung, bis zu einer Obergrenze: Ein Tastendruck bekommt kurze Blöcke für schnelle Reaktion, ein ganzes Ereignis oder ein Audioabschnitt längere, damit sie zusammenhängend bleiben. Oberhalb des Modells ergänzt die Spiele-Engine von PixVerse eine Agentenschicht, die den Zustand der Spielregeln und die generierte Szene synchron hält.
Was jeder Bericht offenlegt
Bevor man Zahlen vergleicht, sollte man vergleichen, was überhaupt veröffentlicht wurde.
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| Format | Paper auf arXiv | Technischer Beitrag auf der PixVerse-Website |
| Auflösung und Bildrate | 720p, 25–42 FPS | Nicht angegeben |
| Parameter und End-to-End-Latenz | Nicht angegeben | Nicht angegeben |
| Öffentliche Benchmarks | Einer für Avatare, vier für Editing | Keine; nur interne Bewertung |
| Gewichte | Nicht veröffentlicht; API verfügbar | Nicht veröffentlicht |
Auf StreamAV-Bench liegt S2 in der eigenen Bewertung bei allen neun berichteten Kennzahlen unter 14 Systemen vorn: Audio-Video-Abgleich von 0,353 gegenüber 0,272 bei der besten Alternative und ein Synchronisationsfehler von 0,617 gegenüber 0,648. Manche Abstände liegen in der dritten Nachkommastelle – die Konsistenz des Motivs beträgt 0,998 gegenüber 0,997. Die veröffentlichten Zahlen von R2 sind die um 35,8 % verringerte Drift und eine Attention-Sparsität von über 90 %, die laut Bericht vier interne Qualitätsdimensionen erhält, ohne Werte zu nennen.
Einen direkten Vergleich gibt es nicht. Das S2-Paper vergleicht mit der Vorgängergeneration PixVerse R1, und R2 erschien erst danach.
Was das bedeutet, wenn Sie mit Agenten Videos machen
Wir entwickeln eine Desktop-App, in der Agenten die Arbeit erledigen, und Video ist eine der Aufgaben, die Menschen ihnen übergeben. Zwei Punkte aus diesen Berichten lassen sich übertragen.
Erstens wird die Grenze zwischen Live-Video und fertigem Video schärfer. Echtzeitmodelle sind für Erlebnisse gebaut, die weiter reagieren – Figuren, Spiele, ein Stream, den man während der Wiedergabe umgestaltet. Die meiste Arbeit von Kreativen endet trotzdem in einer Datei. In Orkas macht VideoStudio aus Rohmaterial und einem Briefing einen prüfbaren Schnitt, und wenn eine Einstellung generiert werden muss, nutzt es Offline-Modelle: die von Orkas bereitgestellte Videogenerierung oder Ihren eigenen Schlüssel für Seedance 2.0, Hailuo 2.3, Vidu Q3 Pro, Kling 3.0 Turbo, Veo 3.1 oder Runway Gen-4.5. Weder S2 noch R2 laufen derzeit in Orkas.
Zweitens ist die Steuerungsschicht von S2 eine Agentenschleife: Prompt schreiben, generieren, die Frames ansehen, den nächsten Schritt entscheiden. Das ist dieselbe Form wie bei jedem Agenten, der mit einem generativen Modell arbeitet, ob in Echtzeit oder nicht – und vieles am Ergebnis hängt an dieser Schleife, nicht nur an den Gewichten.
Was wir mitnehmen
Das Grundgerüst steht: blockkausale autoregressive Diffusion, Video und Audio gemeinsam erzeugt, sauberer plus verrauschter Verlauf, ein Sink und ein Fenster, Destillation aus der DMD-Familie, Sparse Attention, zuerst niedrige Auflösung. Was S2 und R2 unterscheidet, ist, wo sie ihren Aufwand investieren – eine Staffel gezielter Korrekturen gegenüber einem einmal destillierten Fundament, On-Policy-Wiederholung gegenüber einer Fehlerbank, Systemtechnik gegenüber gelernter Sparsität.
Beide lohnen sich in voller Länge: das Vidu-S2-Paper wegen seiner Details zu Training und Betrieb, und der PixVerse-R2-Bericht wegen seines Arguments, wie man ein Echtzeitmodell skaliert, ohne es neu zu lernen.