
В этом месяце с разницей в неделю вышли две модели видео в реальном времени. Vidu S2 от ShengShu заработала 15 сентября, а PixVerse анонсировала PixVerse R2 22 сентября. S2 создана для цифровых персонажей в прямом эфире и для смены стиля видеопотока прямо во время воспроизведения. R2 называет себя моделью мира в реальном времени: по сцене можно двигаться клавишами WASD, а текст, референсы и звук меняют то, что произойдёт дальше.
Обе команды опубликовали, как они это сделали: S2 — в статье на arXiv, R2 — в техническом отчёте на сайте PixVerse. Мы прочитали их параллельно. Они сходятся в каркасе, расходятся в пяти проектных решениях и раскрывают очень разный объём информации. В этой статье разобраны все три пункта, но победителя мы сознательно не называем: эти модели ни разу не сравнивали в одном и том же тесте.
Что меняет реальное время
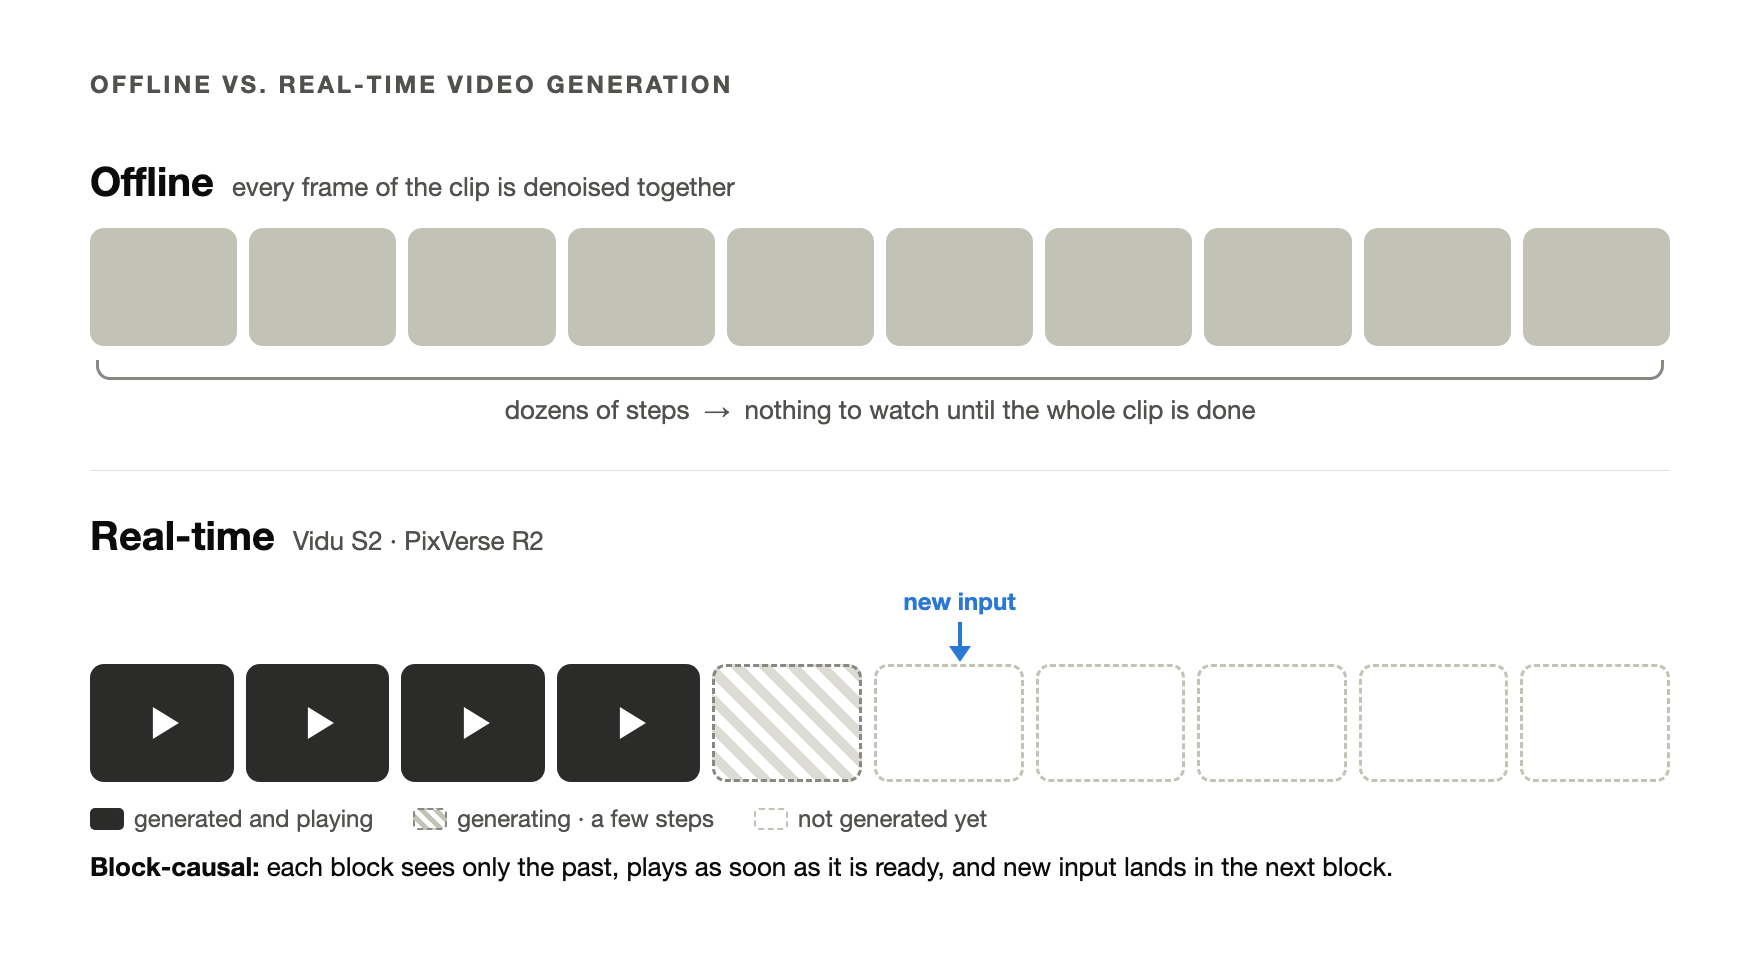
Большинство видеомоделей работают офлайн. Все кадры ролика очищаются от шума вместе, за десятки шагов, и ничего не видно, пока не готов весь ролик. Всё, что вам нужно, должно быть в промпте до начала генерации.
Модель реального времени переворачивает эту схему. Она делит видео на блоки — несколько кадров плюс соответствующий отрезок звука — и генерирует их по порядку. Каждый блок получает лишь несколько шагов шумоподавления и воспроизводится, как только готов. Блок видит то, что было до него, но никогда не видит того, что будет после; именно это и означает поблочная причинность. Новая инструкция попадает в следующий блок.
Такая схема создаёт три проблемы, и почти каждое решение ниже отвечает на одну из них:
- Ошибки накапливаются. Каждый блок опирается на блоки, которые сгенерировала сама модель, поэтому маленькая ошибка передаётся всему, что идёт следом.
- История должна быть ограниченной. Поток может идти бесконечно; если хранить все прошлые блоки, каждый новый будет обходиться дороже.
- Бюджет времени беспощаден. При 25 кадрах в секунду на кадр приходится 40 миллисекунд.
S2 и R2 приходят к одному каркасу: поблочно-причинной авторегрессионной диффузионной модели, которая генерирует видео и звук вместе. Различия — в том, как её обучают, удерживают в стабильном состоянии, снабжают памятью, ускоряют и дают людям ею управлять.
Две системы
Vidu S2 (ShengShu Technology совместно с Университетом Цинхуа) — это две модели. S2-Avatar — цифровой персонаж в прямом эфире в 720p при 25–42 FPS; у S1 было 540p. Посреди эфира ему можно дать новое референсное изображение — чашку, куртку, пляж, — и персонаж берёт предмет, надевает вещь или переходит в новую сцену; он умеет и танцевать. S2-Editing в реальном времени меняет стиль входящего видеопотока — более 50 стилей, виртуальная примерка, замена человека и фона, — сохраняя исходное движение. В статье также исследуется стереовывод для VR-гарнитур.
PixVerse R2 — одна модель, рассчитанная на интерактивные миры. Во время работы в неё могут поступать четыре вида ввода — текст, мультимодальные референсы, звук и действия вроде WASD, — и каждый обновляет состояние мира, а не только текущий кадр. Игровой движок PixVerse уже работает на R2; публичная демонстрация сосредоточена на перемещении и промптах.
Решение 1: как обучается модель
Модели реального времени не обучают с нуля. Обычно отправная точка — сильная офлайн-генеративная модель, которую затем переделывают, чтобы она работала причинно и за несколько шагов. Здесь отчёты расходятся заметнее всего.
S2 устроена как эстафета. Сначала предобучается двунаправленная аудиовидеомодель, затем её дообучают с Diffusion-DPO, улучшая точность, выразительность, движение и синхронизацию звука с изображением. Внимание переводится в поблочно-причинный режим и обучается на смеси чистой и зашумлённой истории (решение 2). Затем Self-Replay Forcing дистиллирует модель до нескольких шагов, обучая её на собственных выходах, а финальный этап оптимизации предпочтений для потоковой генерации (Streaming NFT) настраивает причинную модель. Аватар и редактирование обучаются как отдельные модели.
R2 сохраняет единую основу. Omni Causal AR — причинная модель, которую непрерывно предобучают на коротких клипах, длинных видео, мультимодальных данных и траекториях взаимодействия. Затем Real-Time Acceleration дистиллирует эту же модель для работы в реальном времени: ученик инициализируется из неё, а учитель строится на ней. Формулировка отчёта — «ускорять, а не переучивать».
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| Отправная точка | Двунаправленная модель, дообученная с Diffusion-DPO | Непрерывно предобучаемая причинная модель |
| Путь к реальному времени | Поблочно-причинная адаптация → Self-Replay Forcing → оптимизация предпочтений для потока | Прямая дистилляция той же модели |
| Модели | Отдельные модели для аватара и редактирования | Одна модель для всех типов ввода |
В отчёте R2 распространённый подход изображён как пятиэтапная эстафета, и утверждается, что при каждой передаче теряется часть возможностей. Если читать прямо, конвейер S2 имеет именно такую многоэтапную форму, а главное улучшение приходится на последний этап. Ни одна из команд не опубликовала эксперимент, сравнивающий два пути, поэтому вопрос, какой из них лучше масштабируется, остаётся открытым.
Решение 2: как не дать потоку «уплыть»
Дрейф — характерный сбой потокового видео: цвет постепенно смещается, лицо медленно превращается в чужое, и в конце концов кадр разваливается. Причина в том, что при обучении модель видит чистую историю, а при инференсе — только собственный несовершенный выход.
Обе команды начинают с одного и того же решения. Они смешивают Teacher Forcing, при котором модель опирается на чистую реальную историю и сохраняет качество, и Diffusion Forcing, при котором история зашумлена до случайного уровня. Шум стирает мелкие детали, но сохраняет композицию и движение, поэтому модель учится опираться на структуру, а не доверять каждому пикселю прошлого.
Но зашумлённая реальная история — всё же не то же самое, что собственные ошибки модели, поэтому каждая команда добавляет второй слой.
S2: Self-Replay Forcing. Сначала модель генерирует длинный отрезок точно так же, как при инференсе, не сохраняя градиенты. Затем окно этой траектории заново зашумляется поблочно и прогоняется повторно за один причинный проход с градиентами; обучение идёт с функцией потерь дистилляции DMD и перцептивной функцией потерь. Поскольку повторно прогоняемые блоки находятся в одном вычислительном графе, градиенты проходят через границы блоков — модель узнаёт, как один блок влияет на следующий, — без обратного распространения через исходную генерацию.
R2: Error Bank. Типичные состояния сбоя, возникшие при генерации, сохраняются и воспроизводятся при обучении вместе с обычной историей, чтобы модель научилась восстанавливаться, когда отклонение уже попало в мир. Во внутренней поэтапной оценке PixVerse метрика долгосрочного дрейфа яркости снизилась с 0,201 до 0,129, то есть на 35,8%; улучшились 20 из 29 длинных последовательностей, а паразитное движение уменьшилось во всех пяти образцах без движения.
Эти подходы не конкурируют, а дополняют друг друга. Self-Replay Forcing обучается на том, в чём ошибается текущая модель; Error Bank раз за разом отрабатывает сбои, которые стоит запомнить.
Решение 3: ограниченная память
Обе модели навсегда сохраняют несколько начальных блоков как якорь (sink), держат скользящее окно из недавних блоков, а остальное отбрасывают, поэтому стоимость нового блока не растёт с длиной потока. Обе также удерживают позиционные координаты в диапазоне, который встречался при обучении, — в S1 это называется перепозиционированием RoPE, в R2 — относительным временным RoPE, — так что длинная сессия никогда не выводит позиции за пределы распределения.
S2 опирается на TwinCache из S1: каждый прошлый блок кэшируется дважды — в зашумлённом и в чистом виде. Промежуточные шаги шумоподавления читают зашумлённую копию, которая передаёт общее движение и работает как фильтр нижних частот против накопления артефактов; последний шаг читает чистую копию и восстанавливает детали. S2 распределяет это по двум своим этапам: основная сеть (backbone) читает сильно зашумлённый кэш, а Refiner — слабо зашумлённый кэш высокого разрешения.
R2 разделяет память по временным масштабам: Sink Memory — для идентичности, окружения, стиля и правил мира; Rolling History — для недавнего движения, позы и камеры; а Object KV Cache сжимает состояние объектов, которое ещё понадобится позже.
Это разделение отражает сами продукты. Цифровой персонаж должен оставаться тем же человеком. Мир же должен ещё и помнить, что в нём происходило, — предмет, который вы положили, выбор, который вы сделали.
Решение 4: откуда берётся скорость
Обе используют разреженное внимание и дистилляцию до нескольких шагов, но вкладывают усилия в разные места.
S2 делает ставку на системную инженерию и подробно её описывает. Внимание для каждого слоя выбирается из SageAttention, SpargeAttention и разреженно-линейного внимания, причём самые агрессивные приближения достаются наименее чувствительным слоям. Линейные слои выполняются как поблочные матричные умножения W8A8. Соседние операторы объединяются в ядра Triton/CUDA и воспроизводятся через CUDA Graphs. На нескольких GPU используется контекстный параллелизм в стиле Ulysses с квантованной передачей данных, а в конвейере редактирования VAE-кодировщик, основная сеть, Refiner и декодер делят GPU на общей временной шкале. Разрешение обеспечивается основной сетью низкого разрешения плюс одношаговым латентным Refiner до 720p.
R2 делает ставку на саму модель. Поблочно-разреженное внимание выучивается во время обучения и достигает разреженности более 90%. Дистилляция следует Decoupled DMD — следование управляющему сигналу и соответствие учителю оптимизируются как отдельные цели — плюс состязательное слагаемое из DMD2 для сохранения реалистичности. Разрешение растёт по пирамиде: один-два этапа низкого разрешения задают композицию, движение и камеру, а последний этап высокого разрешения добавляет текстуру. Выходное разрешение и частоту кадров R2 отчёт не указывает.
Решение 5: как люди ею управляют
S2 оборачивает модель в VLM-агента. Агент относит каждое референсное изображение к одному из типов — предмет в руках, фон или одежда — и пишет промпт для каждого сегмента: идентичность, выражение лица, взгляд, поза, действие и предметы в руках, сохраняя всё, что пользователь не просил менять. После генерации он просматривает кадры по порядку, решает, завершено ли действие, выполнено наполовину или пошло не так, и пишет следующий промпт с учётом этого. Для надевания и снятия аксессуаров промпты описывают и движение, и итоговое состояние, поэтому надетая обратно шляпа так и остаётся на голове. В режиме редактирования выравненное по кадрам внимание позволяет каждому выходному кадру читать только исходный кадр того же момента, так что движение и ритм точно совпадают с входным видео.
R2 встраивает в модель единый интерфейс ввода. Текст, референсы, звук, действия и сгенерированные агентами управляющие сигналы попадают в один и тот же работающий мир. Длина блока подстраивается под активный сигнал управления в пределах ограничения: нажатие клавиши получает короткие блоки для быстрой реакции, а целое событие или отрезок звука — более длинные, чтобы сохранить связность. Поверх модели игровой движок PixVerse добавляет слой агентов, который синхронизирует состояние игровых правил и сгенерированную сцену.
Что раскрывает каждый отчёт
Прежде чем сравнивать цифры, стоит сравнить, что вообще опубликовано.
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| Формат | Статья на arXiv | Техническая статья на сайте PixVerse |
| Разрешение и частота кадров | 720p, 25–42 FPS | Не указаны |
| Число параметров и сквозная задержка | Не указаны | Не указаны |
| Публичные бенчмарки | Один для аватаров, четыре для редактирования | Нет; только внутренняя оценка |
| Веса | Не опубликованы; есть API | Не опубликованы |
На StreamAV-Bench в собственной оценке S2 занимает первое место по всем девяти приведённым метрикам среди 14 систем: согласованность звука и изображения 0,353 против 0,272 у лучшей альтернативы, ошибка синхронизации 0,617 против 0,648. Некоторые разрывы — в третьем знаке после запятой: согласованность объекта 0,998 против 0,997. Опубликованные цифры R2 — снижение дрейфа на 35,8% и разреженность внимания выше 90%, при которой, по словам отчёта, сохраняются четыре внутренних показателя качества, но самих оценок не приводится.
Прямого сравнения нет. Статья о S2 сравнивает модель с предыдущим поколением — PixVerse R1, а R2 вышла позже.
Что это значит, если вы делаете видео с помощью агентов
Мы делаем настольное приложение, в котором работу выполняют агенты, и видео — одна из задач, которые им поручают. Из этих отчётов можно вынести две вещи.
Во-первых, граница между живым и готовым видео становится чётче. Модели реального времени созданы для сценариев, которые продолжают реагировать, — персонажей, игр, потока, стиль которого меняется во время воспроизведения. Но большая часть работы авторов по-прежнему заканчивается файлом. В Orkas VideoStudio превращает исходные материалы и задание в монтаж, который можно проверить, а когда кадр нужно сгенерировать, использует офлайн-модели: генерацию видео, которую предоставляет Orkas, или ваш собственный ключ для Seedance 2.0, Hailuo 2.3, Vidu Q3 Pro, Kling 3.0 Turbo, Veo 3.1 или Runway Gen-4.5. Ни S2, ни R2 сейчас внутри Orkas не работают.
Во-вторых, управляющий слой S2 — это цикл агента: написать промпт, сгенерировать, посмотреть на кадры, решить, что делать дальше. Такую же форму имеет любой агент, работающий с генеративной моделью, в реальном времени или нет, — и значительная часть результата зависит от этого цикла, а не только от весов.
Что мы из этого выносим
Каркас устоялся: поблочно-причинная авторегрессионная диффузия, совместная генерация видео и звука, чистая и зашумлённая история, sink и окно, дистилляция семейства DMD, разреженное внимание, сначала низкое разрешение. S2 и R2 различаются тем, куда они вкладывают усилия: эстафета точечных исправлений против единой основы, дистиллированной один раз; on-policy-повтор против банка ошибок; системная инженерия против выученной разреженности.
Оба документа стоит прочитать целиком: статью о Vidu S2 — ради подробностей обучения и развёртывания, а отчёт о PixVerse R2 — ради аргумента о том, как масштабировать модель реального времени, не переучивая её.