
Bu ay iki gerçek zamanlı video modeli bir hafta arayla yayımlandı. ShengShu'nun Vidu S2 modeli 15 Eylül'de kullanıma açıldı; PixVerse ise PixVerse R2'yi 22 Eylül'de duyurdu. S2, canlı dijital karakterler ve oynatılan bir video akışının tarzını anlık olarak değiştirme üzerine kurulu. R2 kendisini gerçek zamanlı bir dünya modeli olarak tanımlıyor: WASD tuşlarıyla içinde dolaştığınız, komutların, referansların ve sesin sonraki olayları değiştirdiği bir sahne.
İki ekip de modellerini nasıl geliştirdiklerini yayımladı: S2 bir arXiv makalesinde, R2 ise PixVerse sitesindeki teknik raporda anlatılıyor. İkisini yan yana okuduk. Temel mimaride birleşiyor, beş tasarım tercihinde ayrılıyor ve çok farklı düzeylerde bilgi açıklıyorlar. Bu yazı üçünü de ele alıyor, ancak bilerek kazanan ilan etmiyor: iki model aynı testte hiç ölçülmedi.
Gerçek zamanlı üretim neyi değiştiriyor?
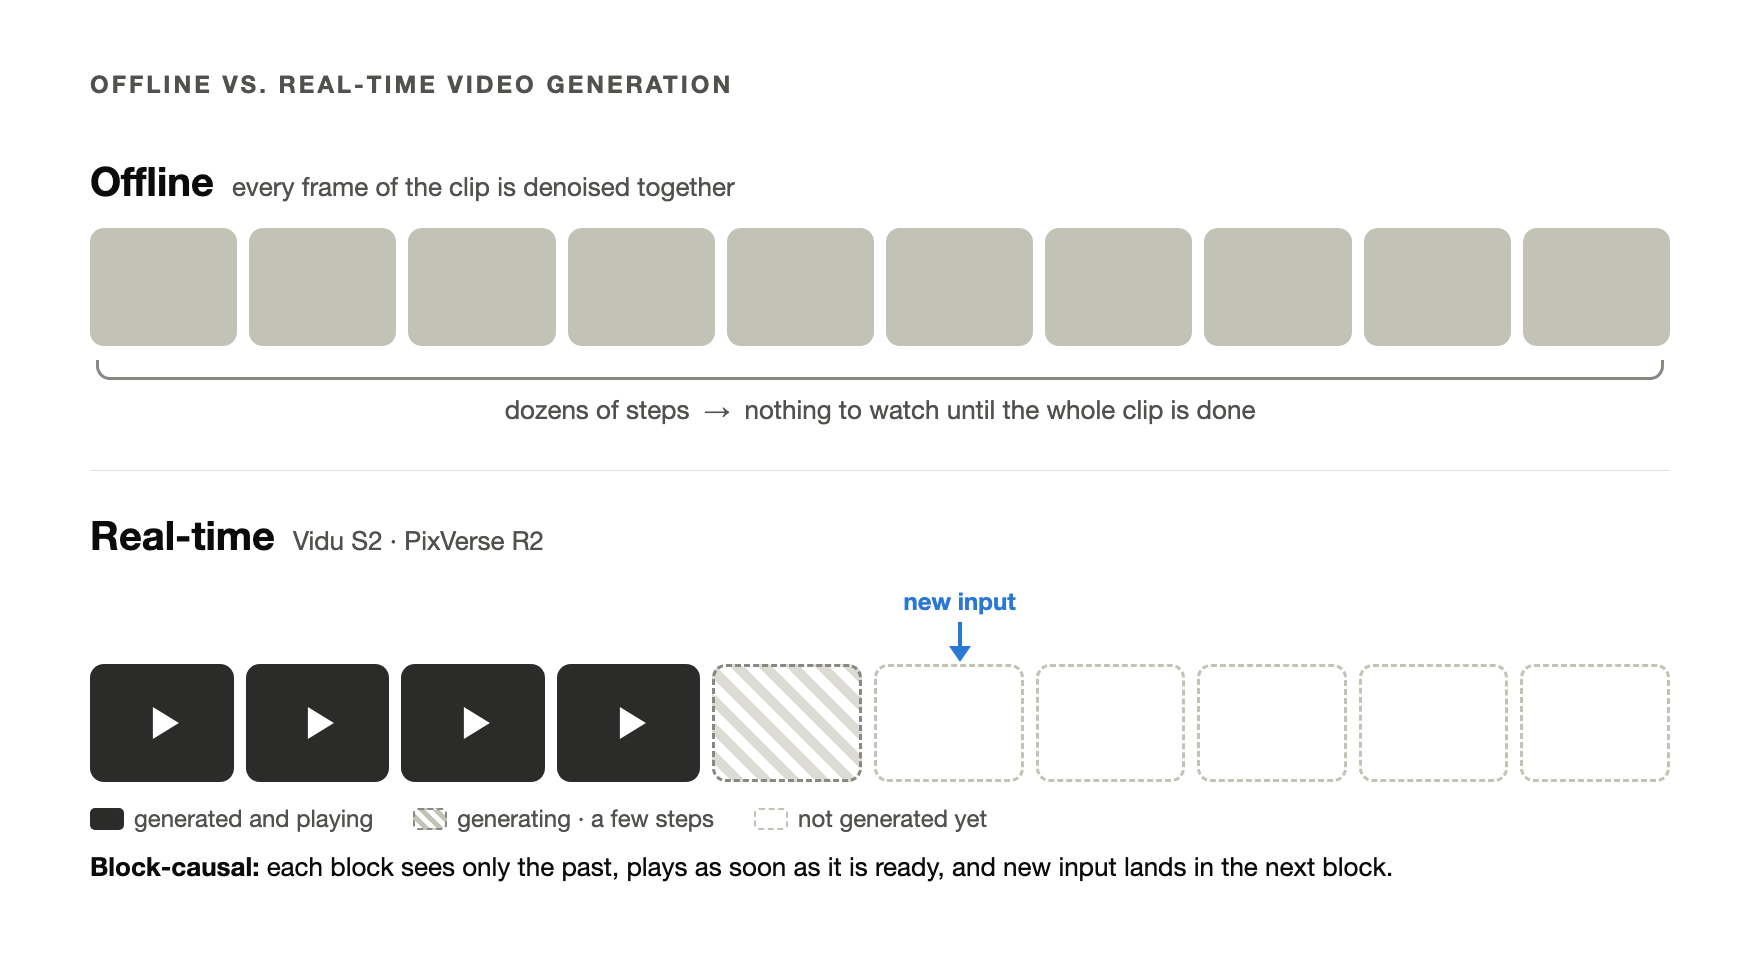
Video modellerinin çoğu çevrimdışı çalışır. Bir klibin her karesindeki gürültü, onlarca adım boyunca birlikte giderilir; klibin tamamı bitene kadar hiçbir şey görünmez. İstediğiniz her şey, üretim başlamadan önce komutta yer almalıdır.
Gerçek zamanlı model bunu tersine çevirir. Videoyu bloklara ayırır: birkaç kare ve bunlara karşılık gelen ses parçası. Blokları sırayla üretir. Her blok yalnızca birkaç gürültü giderme adımından geçer ve hazır olur olmaz oynatılır. Bir blok kendisinden öncekileri görebilir, sonrakileri ise asla göremez; block-causal terimi bunu anlatır. Yeni bir talimat sonraki blokta etkili olur.
Bu yapı üç sorun doğurur; aşağıdaki tasarım tercihlerinin neredeyse hepsi bunlardan birini çözer:
- Hatalar birikir. Her blok, modelin daha önce kendi ürettiği bloklara dayanır; küçük bir hata sonraki her bloğa aktarılır.
- Geçmişin sınırlandırılması gerekir. Bir akış süresiz devam edebilir; geçmişteki tüm blokları tutmak her yeni bloğu daha maliyetli kılar.
- Zaman bütçesi çok dardır. Saniyede 25 karede, her kareye 40 milisaniye düşer.
S2 ve R2 aynı temel mimaride buluşur: video ile sesi birlikte üreten, blok düzeyinde nedensel otoregresif bir difüzyon modeli. Farkları onu nasıl eğittiklerinde, kararlı tuttuklarında, hafıza verdiklerinde, hızlandırdıklarında ve kullanıcıya yönlendirme olanağı sunduklarındadır.
İki sistem
Vidu S2 (ShengShu Technology ve Tsinghua University) iki modelden oluşur. S2-Avatar, S1'deki 540p'den yükselerek 720p ve 25–42 FPS'de canlı bir dijital karakter üretir. Akış sırasında ona bardak, ceket veya plaj gibi yeni bir referans görseli verebilirsiniz; karakter nesneyi alır, giyer veya sahneye girer. Dans da edebilir. S2-Editing, gelen video akışının tarzını gerçek zamanlı olarak değiştirir: 50'den fazla tarz, sanal kıyafet deneme, özne ve arka plan değiştirme sunarken kaynak hareketi korur. Makale, VR başlıkları için stereo çıktıyı da inceler.
PixVerse R2, etkileşimli dünyalara yönelik tek bir modeldir. Çalışırken dört tür girdi alabilir: metin, çok modlu referanslar, ses ve WASD gibi eylemler. Her biri yalnızca mevcut kareyi değil, dünyanın durumunu günceller. PixVerse'ün oyun motoru artık R2 üzerinde çalışıyor; herkese açık demo hareket ve komutlara odaklanıyor.
Karar 1: model nasıl eğitiliyor?
Gerçek zamanlı modeller sıfırdan eğitilmez. Olağan başlangıç noktası güçlü bir çevrimdışı üretim öncülüdür; ardından birkaç adımda nedensel biçimde çalışacak şekilde dönüştürülür. İki raporun en açık biçimde ayrıldığı yer burasıdır.
S2 aşamalı bir aktarım izler. Çift yönlü bir ses–video modeli önceden eğitilir, ardından sadakat, ifade, hareket ve ses–görüntü eşleşmesi için Diffusion-DPO ile ayarlanır. Attention yapısı blok düzeyinde nedensel olacak şekilde değiştirilir ve temiz ile gürültülü geçmişin karışımıyla eğitilir (karar 2). Sonra Self-Replay Forcing, modeli kendi çıktıları üzerinde eğitirken az adımlı hâle damıtır; son bir akış tercihi aşaması (Streaming NFT) nedensel modeli ayarlar. Avatar ve düzenleme ayrı modeller olarak eğitilir.
R2 tek bir temeli korur. Omni Causal AR; kısa klipler, uzun videolar, çok modlu veriler ve etkileşim dizileri üzerinde sürekli önceden eğitilmiş nedensel bir modeldir. Real-Time Acceleration, aynı modeli canlı kullanım için damıtır: öğrenci model ondan başlatılır, öğretmen model de onun üzerine kurulur. Raporun ifadesiyle: “hızlandır, yeniden öğrenme.”
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| Başlangıç noktası | Diffusion-DPO ile ayarlanmış çift yönlü model | Sürekli önceden eğitilmiş nedensel model |
| Gerçek zamanlı çalışmaya geçiş | Blok düzeyinde nedensel uyarlama → Self-Replay Forcing → akış tercihi ayarı | Aynı modeli doğrudan damıtma |
| Modeller | Ayrı avatar ve düzenleme modelleri | Her girdi türü için tek model |
R2 raporu yaygın yaklaşımı beş aşamalı bir aktarım olarak gösteriyor ve her devrin bazı yetenekleri kaybettirdiğini savunuyor. Düz okunduğunda S2'nin hattı da böyle çok aşamalı bir yapıya sahip; başlıca iyileştirme son aşamada. İki yolu karşılaştıran bir deney henüz iki ekipten biri tarafından yayımlanmadı. Dolayısıyla hangisinin daha iyi ölçeklendiği açık bir soru.
Karar 2: akışın kaymasını önlemek
Kayma, video akışının belirgin hata biçimidir: renk yavaşça değişir, bir yüz giderek başka birine dönüşür ve sonunda görüntü bozulur. Bunun nedeni, eğitimde modelin temiz geçmiş görmesi, çıkarım sırasında ise yalnızca kendi kusurlu çıktısıyla karşılaşmasıdır.
İki ekip aynı çözümle başlar. Temiz gerçek geçmişe dayanarak kaliteyi koruyan Teacher Forcing ile geçmişe rastgele düzeyde gürültü ekleyen Diffusion Forcing yöntemlerini karıştırırlar. Gürültü ince ayrıntıları siler ama düzeni ve hareketi korur; böylece model geçmişin her pikseline güvenmek yerine yapıya dayanmayı öğrenir.
Gürültü eklenmiş gerçek geçmiş de modelin kendi hataları değildir; bu yüzden iki ekip de ikinci bir katman ekler.
S2: Self-Replay Forcing. Model önce çıkarımda yapacağı gibi uzun bir dizi üretir; bu sırada gradyan tutulmaz. Bu diziden bir pencere blok blok yeniden gürültülendirilir ve gradyan hesaplanan tek bir nedensel geçişte yeniden oynatılır. Eğitim, DMD damıtma kaybı ile algısal kaybı birleştirir. Yeniden oynatılan bloklar tek bir hesaplama grafiğinde bulunduğundan gradyanlar blok sınırlarını aşar; model bir bloğun sonrakini nasıl şekillendirdiğini öğrenir. İlk üretim boyunca geri yayılım yapmak gerekmez.
R2: Error Bank. Üretimdeki temsili hata durumları saklanır ve eğitim sırasında normal geçmişle birlikte yeniden oynatılır. Böylece model, sapma dünyaya girdikten sonra toparlanmayı öğrenir. PixVerse'ün şirket içi aşama değerlendirmesinde uzun vadeli parlaklık kayması ölçütü 0.201'den 0.129'a düştü; bu %35.8 azalma demek. 29 uzun dizinin 20'si iyileşti ve hareketsiz olması gereken beş örneğin tamamında istenmeyen hareket azaldı.
Bu iki yöntem rakip olmaktan çok birbirini tamamlar. Self-Replay Forcing mevcut modelin yaptığı hatalarla eğitir; Error Bank ise hatırlanmaya değer hatalara odaklanır.
Karar 3: sınırları belli bir hafıza
İkisi de baştaki birkaç bloğu kalıcı bir dayanak (sink) olarak tutar, yakın geçmiş için kayan bir pencere saklar ve kalanını atar. Böylece yeni bir bloğun maliyeti akışın uzunluğuyla artmaz. Ayrıca konum koordinatlarını eğitimde görülen aralıkta tutarlar: S1 buna RoPE repositioning, R2 ise relative temporal RoPE der. Böylece uzun bir oturum konumları eğitim dağılımının dışına taşımaz.
S2, S1'deki TwinCache üzerine kurulur. Geçmişteki her blok iki kez önbelleğe alınır: biri gürültülü, biri temiz. Ara gürültü giderme adımları genel hareketi taşıyan gürültülü kopyayı okur; bu kopya biriken bozulmalara karşı alçak geçiren filtre gibi çalışır. Son adım ise ayrıntıları geri getirmek için temiz kopyayı okur. S2 bunu iki aşamasına dağıtır: backbone yüksek gürültülü önbelleği, Refiner ise düşük gürültülü ve yüksek çözünürlüklü önbelleği okur.
R2 hafızayı zaman ölçeğine göre ayırır: kimlik, ortam, tarz ve dünya kuralları için Sink Memory; yakın dönemdeki hareket, poz ve kamera için Rolling History; ileride de önemli olacak nesne durumunu sıkıştıran Object KV Cache.
Bu ayrım ürünleri yansıtır. Dijital karakter aynı kişi olarak kalmalıdır. Bir dünya ise içinde ne olduğunu da hatırlamalıdır: yere bıraktığınız nesneyi, verdiğiniz kararı.
Karar 4: hız nereden geliyor?
İki model de sparse attention ve az adımlı damıtma kullanır. Ancak çabalarını farklı yerlere yöneltirler.
S2 sistem mühendisliğine dayanır ve bunu ayrıntılı anlatır. Her katman için SageAttention, SpargeAttention ve sparse-linear attention arasından seçim yapılır; en agresif yaklaşımlar en az hassas katmanlarda kullanılır. Doğrusal katmanlar blok başına W8A8 matris çarpımları olarak çalışır. Komşu işlemler Triton/CUDA çekirdeklerinde birleştirilir ve CUDA Graphs ile yeniden oynatılır. Birden çok GPU üzerinde Ulysses context parallelism ve kuantize iletişim kullanılır; düzenleme hattında VAE kodlayıcı, backbone, Refiner ve kod çözücü GPU'ları ortak bir zaman çizelgesinde paylaşır. Çözünürlük, düşük çözünürlüklü bir backbone ve 720p'ye kadar çıkan tek adımlı bir latent Refiner ile sağlanır.
R2 modele dayanır. Block-sparse attention eğitim sırasında öğrenilir ve %90'ın üzerinde seyreklik düzeyine ulaşır. Damıtma, Decoupled DMD'yi izler: kontrol sinyalini takip etmek ve öğretmen modeli eşlemek ayrı hedefler olarak iyileştirilir. Gerçekçiliği desteklemek için DMD2'den bir adversarial terim de eklenir. Çözünürlük piramit şeklinde ilerler: bir veya iki düşük çözünürlüklü aşama düzeni, hareketi ve kamerayı belirler; son yüksek çözünürlüklü aşama dokuyu ekler. Rapor, R2'nin çıktı çözünürlüğünü veya kare hızını belirtmez.
Karar 5: kullanıcılar modeli nasıl yönlendiriyor?
S2, modelin etrafına bir VLM aracısı yerleştirir. Aracı her referans görselini elde tutulan nesne, arka plan veya kıyafet olarak sınıflandırır. Sonra kimlik, ifade, bakış, poz, eylem ve tutulan nesneleri kapsayan, kullanıcının değiştirmek istemediği şeyleri koruyan bir komut yazar. Üretimden sonra kareleri sırayla inceler; eylemin tamamlandığına, yarım kaldığına veya yanlış gittiğine karar verir ve sonraki komutu buna göre yazar. Aksesuar takma veya çıkarma için komutlar hem hareketi hem de son durumu belirtir; böylece yeniden takılan şapka başta kalır. Düzenleme modunda kare hizalı attention, her çıktı karesinin yalnızca aynı andaki kaynak kareyi okumasını sağlar; hareket ve zamanlama girdiye tam uyar.
R2, tek bir girdi arayüzünü modelin içine kurar. Metin, referanslar, ses, eylemler ve aracı tarafından üretilen kontroller aynı çalışan dünyaya girer. Blok uzunluğu, bir üst sınır içinde etkin kontrole göre değişir: tuşa basıldığında hızlı yanıt için kısa bloklar; bütün bir olay veya ses bölümü için tutarlılığı koruyan daha uzun bloklar kullanılır. Modelin üzerinde PixVerse oyun motoru, oyun kurallarının durumuyla üretilen sahneyi eşzamanlı tutan bir aracı katmanı ekler.
Her rapor neleri açıklıyor?
Sayıları karşılaştırmadan önce nelerin yayımlandığına bakmak gerekir.
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| Biçim | arXiv makalesi | PixVerse sitesinde teknik yazı |
| Çözünürlük ve kare hızı | 720p, 25–42 FPS | Belirtilmiyor |
| Parametre sayısı ve uçtan uca gecikme | Belirtilmiyor | Belirtilmiyor |
| Herkese açık karşılaştırmalar | Bir avatar, dört düzenleme karşılaştırması | Yok; yalnızca şirket içi değerlendirme |
| Ağırlıklar | Yayımlanmadı; API mevcut | Yayımlanmadı |
S2, StreamAV-Bench'te kendi değerlendirmesindeki 14 sistem arasında bildirilen dokuz ölçütün hepsinde birinci sıradadır: ses–görüntü uyumu 0.353, en iyi alternatifte 0.272; eşzamanlama hatası 0.617, alternatifte 0.648. Bazı farklar üçüncü ondalık basamaktadır: özne tutarlılığı 0.998'e karşı 0.997. R2'nin yayımladığı sayılar %35.8 kayma azalması ve %90'ın üzerinde attention seyrekliğidir. Rapor, puan vermeden dört şirket içi kalite boyutunun korunduğunu söyler.
Doğrudan karşılaştırma yoktur. S2 makalesi önceki PixVerse R1 ile karşılaştırır; R2 daha sonra yayımlandı.
Aracılarla video üretiyorsanız bunun anlamı
Aracıların işi yaptığı bir masaüstü uygulaması geliştiriyoruz; video da insanların onlara verdiği işlerden biri. Bu raporlardan iki sonuç buraya taşınabilir.
İlki, canlı video ile bitmiş video arasındaki çizgi belirginleşiyor. Gerçek zamanlı modeller sürekli tepki veren deneyimler için yapılıyor: karakterler, oyunlar, oynarken tarzı değişen akışlar. İçerik üreticilerinin çoğu ise sonunda bir dosya ister. Orkas'ta VideoStudio, ham görüntüleri ve bir özeti gözden geçirilebilir bir kurguya dönüştürür. Yeni bir çekim üretilmesi gerektiğinde çevrimdışı modelleri kullanır: Orkas tarafından yönetilen video üretimi veya Seedance 2.0, Hailuo 2.3, Vidu Q3 Pro, Kling 3.0 Turbo, Veo 3.1 ya da Runway Gen-4.5 için kendi anahtarınız. Bugün ne S2 ne de R2 Orkas içinde çalışıyor.
İkincisi, S2'nin kontrol katmanı bir aracı döngüsüdür: komutu yaz, üret, karelere bak ve sonraki adımı belirle. Gerçek zamanlı olsun olmasın, bir üretim modeliyle çalışan her aracının izlediği yapı budur. Sonucun büyük bölümü yalnızca ağırlıklara değil, bu döngüye de bağlıdır.
Buradan çıkardığımız sonuç
Temel mimari belirginleşti: blok düzeyinde nedensel otoregresif difüzyon, video ve sesin birlikte üretilmesi, temiz ve gürültülü geçmiş, bir dayanak ile pencere, DMD ailesinden damıtma, sparse attention ve önce düşük çözünürlük. S2 ile R2'yi ayıran nokta çabalarını nereye harcadıklarıdır: hedefli düzeltmelerden oluşan aşamalı aktarım ya da bir kez damıtılan tek temel model; modelin kendi üretimi üzerinde yeniden oynatma ya da hata bankası; sistem mühendisliği ya da öğrenilmiş seyreklik.
İkisini de bütünüyle okumaya değer: eğitim ve sunum ayrıntıları için Vidu S2 makalesini, yeniden öğrenmeden gerçek zamanlı modeli ölçeklendirme savı için PixVerse R2 raporunu.