
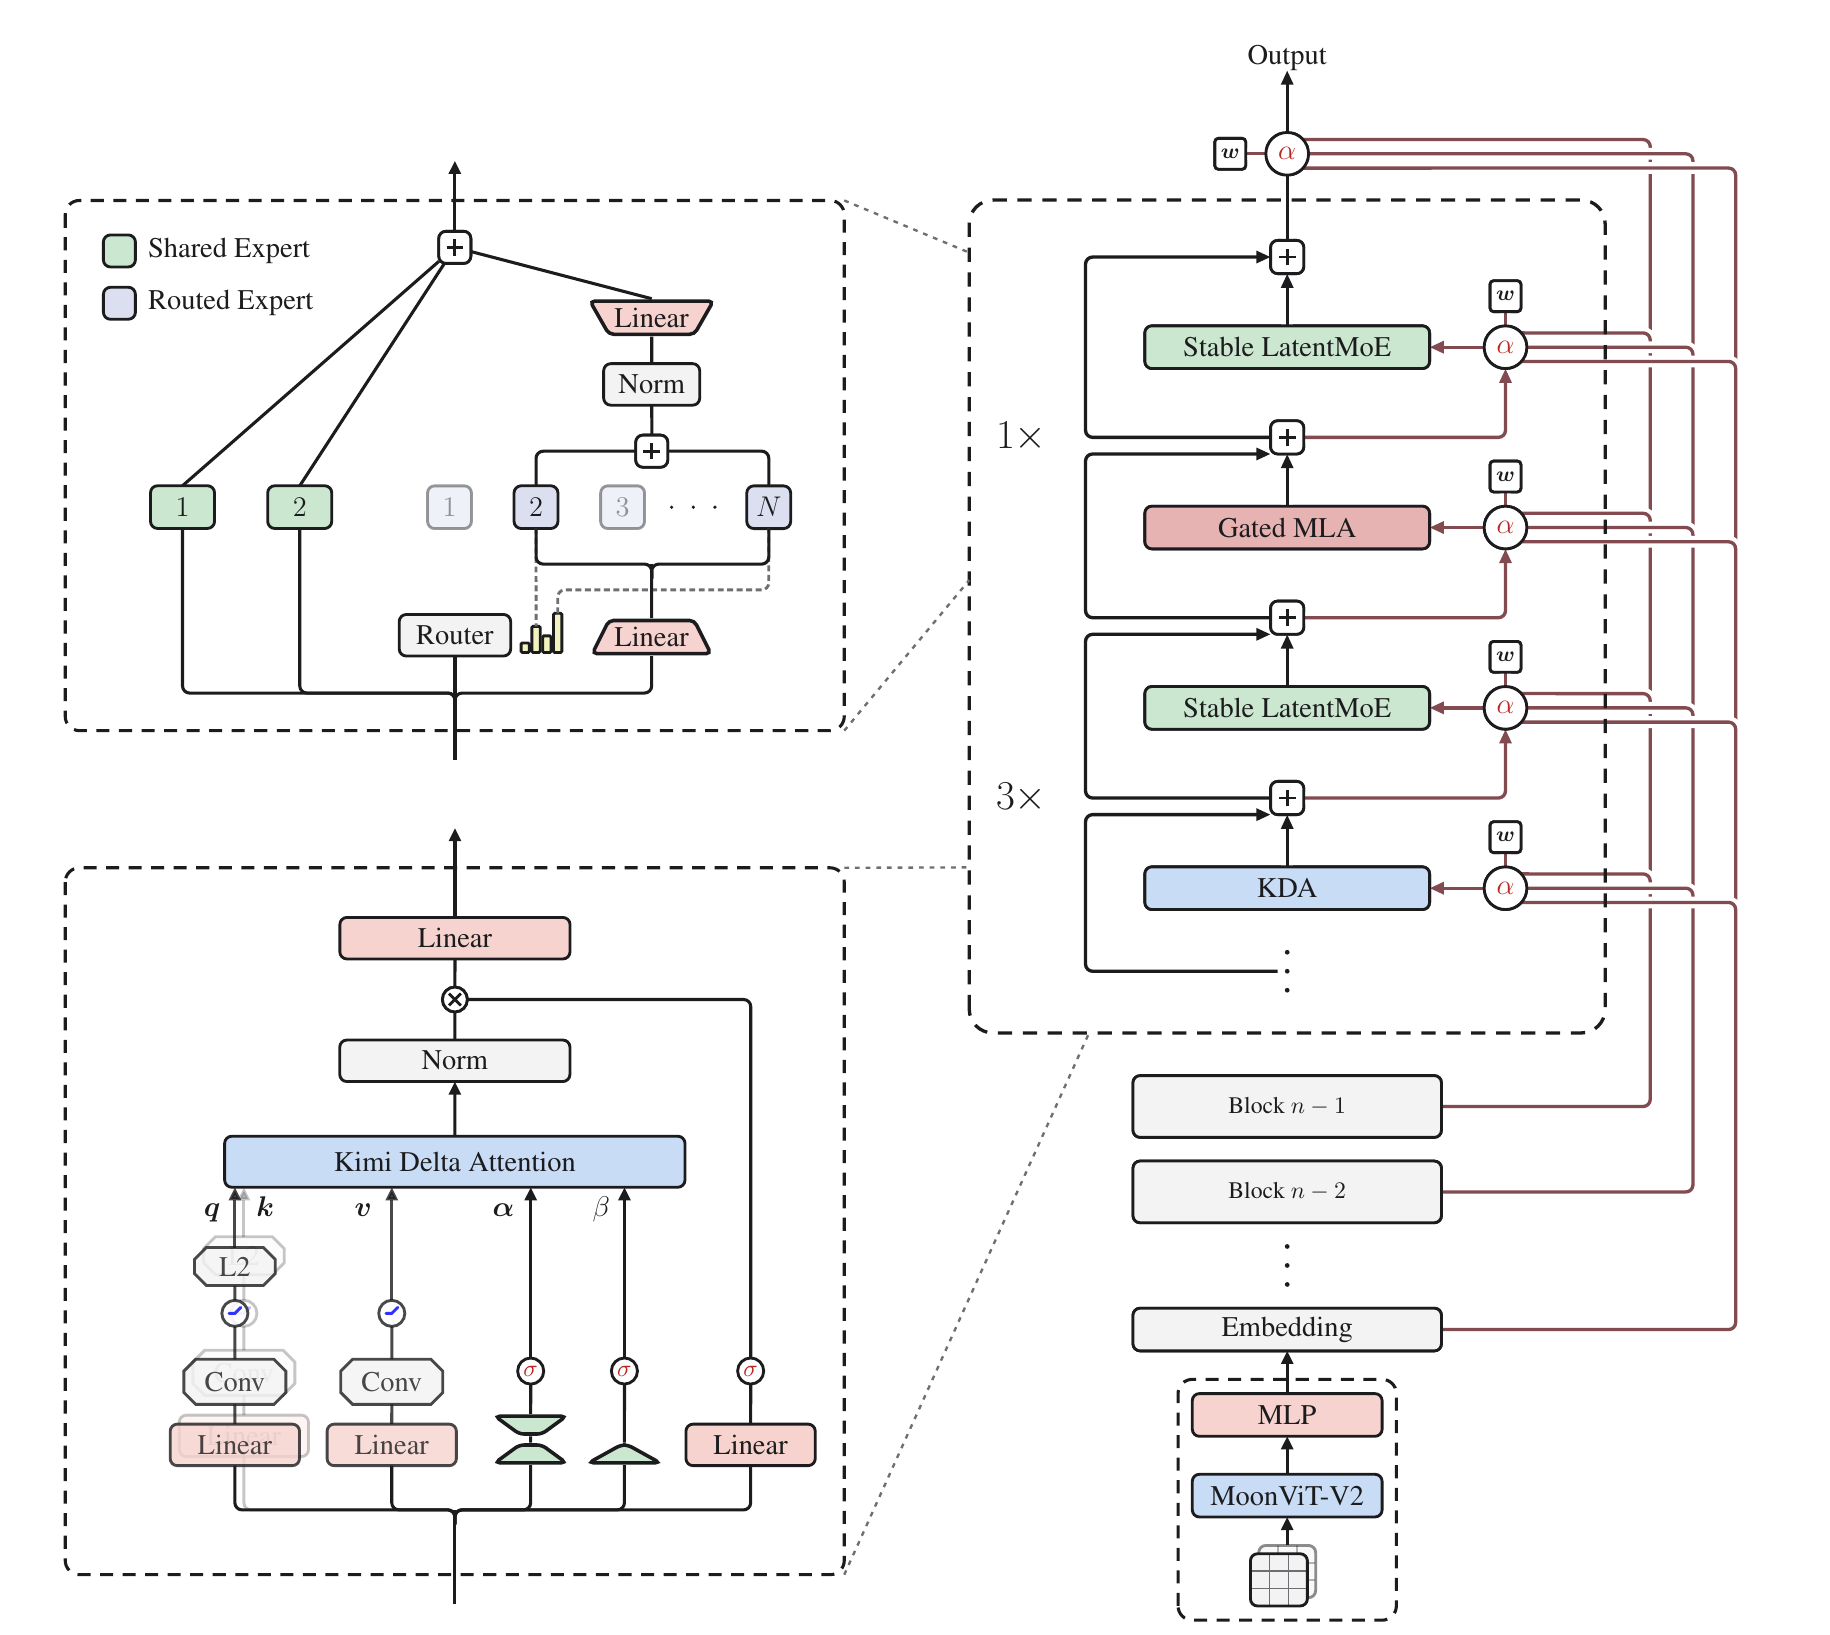
Kimi K3 का मुख्य आँकड़ा 2.8 ट्रिलियन पैरामीटर है। यह रिपोर्ट का सबसे कम दिलचस्प आँकड़ा है।
दिलचस्प बात यह है कि संरचना ऐसे सवाल के इर्द-गिर्द बनी है जिसका आकार से कोई संबंध नहीं है: जानकारी का प्रवाह कहाँ रुक रहा है? उत्तर के तीन हिस्से हैं — अनुक्रम में, गहराई में, चौड़ाई में — और हर हिस्से के लिए अपना तंत्र है।
समान गणना, Kimi K2 की लगभग 2.5× स्केलिंग दक्षता। यह आँकड़ा किसी तीसरे पक्ष की पुनरावृत्ति से नहीं, टीम के अपने फ़िट किए गए स्केलिंग-नियम वक्रों से आता है, इसलिए इसे उनका दावा समझें। लेकिन इसके पीछे के तंत्र इतने स्पष्ट हैं कि उन पर तर्क किया जा सकता है, और यही रिपोर्ट को पढ़ने लायक बनाता है।
यह एक गहन अध्ययन है Kimi K3 तकनीकी रिपोर्ट का (Moonshot AI), जिसमें उसकी संरचना वाले खंड पर ध्यान है। हम पहले लिख चुके हैं लंबी अवधि वाले एजेंटों के डिज़ाइन पर; यह लेख तकनीकी स्टैक के और निचले स्तर पर है।
तीन दिशाएँ, एक आँकड़ा नहीं
ट्रांसफ़ॉर्मर की हर परत जानकारी को तीन तरीक़ों से मिलाती है। टोकनों के बीच, ताकि स्थिति 900,000 स्थिति 1 को प्रभावित कर सके। गहराई में, ताकि परत 90 वह इस्तेमाल कर सके जो परत 3 ने पहचाना था। चैनलों के बीच, ताकि विशेषताएँ फिर से संयोजित हो सकें।
अधिकांश स्केलिंग कार्य सब कुछ बड़ा करके तीनों को एक साथ बदलते हैं। K3 उन्हें अलग करता है और हर एक को अपना तंत्र देता है:
- अनुक्रम — हाइब्रिड अटेंशन: हर एक Gated MLA परत के लिए तीन Kimi Delta Attention परतें।
- गहराई — Attention Residuals: हर परत एक संचित अवस्था विरासत में लेने के बजाय अपने पहले की सभी परतों के आउटपुट पर अटेंशन देती है।
- चौड़ाई — Stable LatentMoE: 896 रूट किए गए विशेषज्ञ, प्रति टोकन 16 सक्रिय।
हिडन आयाम बिल्कुल नहीं बदला। K2 में 7,168, K3 में 7,168। जो भी बड़ा हुआ, वह परत की चौड़ाई नहीं थी।
अनुक्रम: तीन चौथाई परतों ने सब कुछ पढ़ना बंद कर दिया
मानक अटेंशन हर नए टोकन के लिए पूरा पूर्वांश फिर पढ़ता है। दस लाख टोकनों पर यही लागत असहनीय हो जाती है।
K3 काम बाँटता है। तीन KDA परतें निश्चित आकार की चालू अवस्था रखती हैं — स्रोत दोबारा पढ़ने से अधिक नोट्स लेने जैसा — जिनके बाद एक Gated MLA परत पूर्ण वैश्विक अटेंशन करती है। यह क्रम दोहरता है, और बिल्कुल अंत में एक अतिरिक्त MLA परत होती है ताकि अंतिम परत हमेशा सब कुछ देखे। कुल 93 परतों में: 69 KDA, 24 MLA।
निश्चित आकार ही मुख्य बात है। अवस्था अनुक्रम के साथ नहीं बढ़ती, इसलिए उसका आकार अनियंत्रित नहीं हो सकता। इसमें जानकारी खोती भी है, इसलिए हर चौथी परत पूर्ण अटेंशन वाली है, ताकि नोट्स में छूटी जानकारी वापस मिल सके।
फिर एक द्वितीयक प्रभाव आता है। क्योंकि आवर्ती अवस्था में क्षय होता है — पुराने टोकनों के मुकाबले हालिया टोकन स्वाभाविक रूप से अधिक मौजूद रहते हैं — स्थिति की जानकारी बिना अतिरिक्त लागत के मिलती है। इसलिए K3 लागू करता है बिल्कुल कोई स्थितिगत एन्कोडिंग नहीं अपनी वैश्विक अटेंशन परतों में। न RoPE, न कुछ फिर से स्केल करने की ज़रूरत।
इसका अर्थ है कि दस लाख टोकनों तक विस्तार के लिए स्थितिगत एन्कोडिंग में कोई बदलाव नहीं करना पड़ा। संदर्भ विस्तार के लिए क्षेत्र में विकसित अंतर्वेशन तरकीबें यहाँ लागू नहीं होतीं, क्योंकि अंतर्वेशन करने के लिए कोई एन्कोडिंग है ही नहीं।
एक निचली सीमा जिसने GPU कोड पथ मिटा दिया
यह रिपोर्ट का हमारा पसंदीदा हिस्सा है, और इतना छोटा है कि सरसरी नज़र में छूट सकता है।
आवर्ती अवस्था आगे बढ़ते हुए भूलती जाती है। खंडों में इसकी कुशल गणना के लिए संचित क्षय से भाग देना पड़ता है, और संचित क्षय एक से छोटी संख्याओं का गुणनफल होता है। इसे अनियंत्रित छोड़ दें, तो आप शून्य के मनचाहे करीब पहुँची राशि से भाग दे रहे होते हैं।
पिछली पीढ़ी ने हर खंड को 16-टोकन टाइलों में बाँटकर और लॉग स्पेस में काम करके इसे सँभाला। यह काम करता था, लेकिन विकर्ण की टाइलों का मूल्यांकन अब भी स्थिति-युग्म दर स्थिति-युग्म करना पड़ता था — एक धीमा, विशेष कोड पथ जो टेंसर कोर इस्तेमाल नहीं कर सकता था।
K3 का समाधान पैरामीटरीकरण की एक पंक्ति है। लॉग-क्षय की निचली सीमा तय करें: हर चरण अपने पास मौजूद जानकारी का 0.67% बचने तक भूल सकता है, उससे आगे नहीं।
इसका परिणाम देखें। इस सीमा के साथ, 16-टोकन टाइल पर संचित लॉग-क्षय (−80, 0) के भीतर रहता है। इसलिए व्युत्क्रम e से कम रहता है80 ≈ 5.5 × 1034, जो BF16 की लगभग 3.4 × 10 की सीमा के भीतर आराम से है38। कुछ भी ओवरफ़्लो नहीं होता। इसलिए विकर्ण टाइलें भी बाकी सभी टाइलों जैसा सघन मैट्रिक्स गुणन इस्तेमाल कर सकती हैं।
विशेष पथ का अनुकूलन नहीं हुआ। वह समाप्त हो गया।
कारण-क्रम को उल्टा पढ़ें तो बात और दिलचस्प होती है: हार्डवेयर की डायनेमिक रेंज ने स्वीकार्य अंतराल तय किया, उससे स्थिरांक तय हुआ, और उससे तय हुआ कि सक्रियण की निचली सीमा होनी चाहिए। संख्यात्मक व्यवहार ने गणित चुना, उल्टा नहीं।
गहराई: रिले दौड़ से समूह चैट तक
तिरानवे परतों की गहराई पर मानक रेज़िडुअल स्ट्रीम एक रिले दौड़ है। परत 50 को परत 49 से एक संचित अवस्था मिलती है। परत 1 से 48 तक ने अलग-अलग जो भी पहचाना, वह उस अवस्था में जुड़ चुका होता है और अब अलग नहीं किया जा सकता।
शोधपत्र इसे वही बाधा मानता है जो RNN में समय के साथ आती है — और क्षेत्र ने उसे अटेंशन से पहले ही हल कर लिया है। Attention Residuals यही समाधान गहराई पर लागू करते हैं: हर परत में सीखने योग्य छद्म-क्वेरी होती है और वह पहले की सभी परतों के आउटपुट पर अटेंशन देकर चुनती है कि क्या पढ़ना है।
इसे सीधे लागू करने पर गणना लागत गहराई के वर्ग के अनुपात में बढ़ती है, और उससे भी खराब यह कि पाइपलाइन समानांतरता में हर परत का आउटपुट मेमोरी और संचार में बनाए रखना पड़ता है। इसलिए K3 ब्लॉक संस्करण इस्तेमाल करता है: 93 परतें बारह-बारह के समूहों में बाँटी जाती हैं, समूह के भीतर योग होता है और समूहों के बीच पूर्ण अटेंशन। अतिरिक्त लागत प्रति-परत से घटकर प्रति-समूह हो जाती है, और अनुमान के समय अवस्था सीमित रहती है।
चौड़ाई: 896 विशेषज्ञ, 16 सक्रिय
मिश्रित-विशेषज्ञ तंत्र एक बड़ा समूह रखता है और हर टोकन पर कुछ को सक्रिय करता है। K2, 384 में से 8 चुनता था। K3, 896 में से 16 चुनता है — विरलता 56।
समूह इतना बढ़ाने से दो चीज़ें बिगड़ती हैं, और रिपोर्ट दोनों के बारे में असामान्य रूप से स्पष्ट है।
संचार। पारंपरिक MoE में हर चुने हुए विशेषज्ञ को पूरी चौड़ाई वाला टोकन मिलता है, इसलिए ट्रैफ़िक चुने गए विशेषज्ञों की संख्या के साथ बढ़ता है। LatentMoE दोनों को अलग करता है: रूट किए गए विशेषज्ञ मॉडल की आधी चौड़ाई वाले संक्षिप्त लेटेंट स्पेस में काम करते हैं, जबकि पूरी चौड़ाई वाले दो साझा विशेषज्ञ हर टोकन की सामान्य ज़रूरत सँभालते हैं। संचार लागत बढ़ाए बिना समूह बढ़ सकता है।
स्थिरता। इतनी विरलता पर रूट की गई शाखा लगभग चार लगातार मैट्रिक्स गुणनों की शृंखला बन जाती है, और सक्रियण अनियंत्रित बढ़ते हैं। दो समाधान हैं: विशेषज्ञ समेकन और अप-प्रोजेक्शन के बीच RMSNorm, और नया सक्रियण SiTU-GLU, जो स्केल किए गए tanh से SwiGLU के दोनों गुणकों पर सीमा लगाता है ताकि कम परिशुद्धता में कोई भी अनियंत्रित न हो।
संतुलन। तीसरा समाधान अपनाने लायक है। लगभग 900 विशेषज्ञों पर समान भार रखने के लिए हर चरण में हर विशेषज्ञ का बायस समायोजित करना होता है। मानक विधि त्रुटि की दिशा में हर बायस को निश्चित मात्रा से बदलती है, जिससे या तो दोलन होता है या वह पीछे रह जाता है। K3 इसके बजाय उसका हल निकालता है: top-k की जगह top-(k+1) चलाएँ, और अतिरिक्त प्रविष्टि ही है वह स्कोर बताती है जो किसी टोकन को प्रवेश के लिए चाहिए। इन सीमाओं के ज्ञात होने पर, संभावित बायस के तहत किसी विशेषज्ञ को मिलने वाला भार एकदिश होता है, इसलिए लक्ष्य भार देने वाला बायस केवल मार्जिन का एक क्वांटाइल होता है। एक फ़ॉरवर्ड पास, ट्यून करने के लिए कोई चरण-आकार नहीं।
बड़े पैमाने पर वह क्वांटाइल सभी रैंक में फैले लाखों मानों को समेटता है, इसलिए वे हिस्टोग्राम से उसका अनुमान लगाते हैं: हर रैंक अपने बिन की गिनती करता है, एक all-reduce उन्हें जोड़ता है, और संयुक्त गिनतियों से क्वांटाइल पढ़ा जाता है। गिनतियाँ जुड़ती हैं, इसलिए टोकन चाहे जैसे बाँटे गए हों, अनुमान पूरे बैच को दर्शाता है, और लागत प्रति विशेषज्ञ कुछ सौ बिन की होती है।
लागत सर्विंग स्टैक में चुकानी पड़ती है
यह सब मुफ़्त नहीं है, और रिपोर्ट का ईमानदार हिस्सा बुनियादी ढाँचे वाला खंड है, जहाँ यह लागत सामने आती है।
निश्चित आकार की आवर्ती अवस्था को सहेजना और भेजना सस्ता है, लेकिन वह क्रमिक रूप से अद्यतन होती है और उसे सीधे जोड़ा नहीं जा सकता। दोनों गुण अतिरिक्त काम पैदा करते हैं:
- अनुक्रम को उपकरणों में बाँटना। सामान्य रैखिक अटेंशन हर उपकरण को शून्य से अपनी स्थानीय अवस्था की गणना करके परिणाम जोड़ने देता है। KDA आने वाली अवस्था पर टोकन-निर्भर परिवर्तन लागू करता है, इसलिए योग गलत है। समाधान हर खंड को संचित परिवर्तन और शून्य से शुरू हुई अवस्था में विभाजित करता है — दो राशियाँ जिन्हें संयोजित किया जा सकता है — और प्रीफ़िक्स स्कैन तथा निश्चित आकार के एक all-gather से हर उपकरण की प्रवेश अवस्था पुनः प्राप्त करता है।
- अनुरोधों में पूर्वांश का पुनः उपयोग। आधे कैश प्रति-टोकन पृष्ठ हैं, आधे हर अनुरोध की एक निश्चित अवस्था, और कैश हिट के लिए दोनों को एक ही सीमा पर बहाल किया जा सकना चाहिए। उनका उत्तर है सूक्ष्मता स्तरों को अलग करना: 512 टोकन पर हैश करें, 1024–6144 पर आवंटन करें, और आवर्ती अवस्था का जाँच-बिंदु केवल हैश अंतिम बिंदुओं के एक विरल उपसमूह पर बनाएँ।
- सट्टात्मक डिकोडिंग। अवस्था वहीं अद्यतन होती है, इसलिए अस्वीकृत मसौदे को वापस नहीं पलटा जा सकता। इसके बजाय वे प्रक्षेपित इनपुट कैश करते हैं — जो अवस्था से बहुत छोटे होते हैं — और चिप पर पुनर्निर्माण करते हैं।
तीनों में वही पैटर्न है जो क्षय सीमा में था, बस उल्टी दिशा में: संरचना ने निरूपण चुना, और निरूपण ने सिस्टम का काम तय किया।
एक आदत जिसे शोधपत्र चुपचाप छोड़ देता है
K3 मूल रूप से बहुमाध्यमीय है, और उसका विज़न एन्कोडर अगले टोकन की भविष्यवाणी से शुरू से प्रशिक्षित होता है। न SigLIP आरंभीकरण, न कॉन्ट्रास्टिव पूर्व-प्रशिक्षण — जबकि यही मानक तरीका है, टीम के अपने पिछले मॉडल में भी।
बताया गया कारण गुणवत्ता नहीं है। वह स्थिरता है: कॉन्ट्रास्टिव तरीके से आरंभ किए गए एन्कोडर में संयुक्त अनुकूलन के दौरान लगातार अधिक ग्रेडिएंट नॉर्म और बार-बार उछाल दिखे, जबकि शुरू से प्रशिक्षित एन्कोडर स्थिर रहा। विज़न मूल्यांकन बराबर रहे।
इससे निष्कर्ष किसी जीत से भी अधिक स्पष्ट हो जाता है। यदि शुरू से प्रशिक्षण बेहतर होता, तो आप उसे बेहतर तरीका कहते। उसने बराबरी की — इसलिए दावा यह है कि इस पैमाने पर क्षेत्र जिस चरण को अनिवार्य मानता है, वह केवल वैकल्पिक है।
यदि आप इन मॉडलों पर एजेंट चलाते हैं तो इसका क्या अर्थ है
हम बहु-एजेंट डेस्कटॉप क्लाइंट बनाते हैं, इसलिए हमारा ध्यान इस पर है कि लंबी अवधि का निष्पादन किफ़ायती रहता है या नहीं, इस पर नहीं कि लीडरबोर्ड में कौन शीर्ष पर है।
महत्त्वपूर्ण आँकड़ा संदर्भ विंडो का आकार नहीं है; वह दस लाख टोकन सर्व करने की लागत है। तीन चौथाई परतें निश्चित आकार की अवस्था रखती हैं, इसलिए बातचीत के साथ बढ़ने वाला कैश उतनी ही गहराई वाले पूर्ण-अटेंशन मॉडल के कैश के आकार का एक चौथाई है। BrowseComp पर रिपोर्ट K3 को लगभग $2 प्रति कार्य पर 91.2% बताती है — निकटतम स्वामित्व वाले स्कोर की लगभग आधी लागत, और अधिकतम प्रयास वाले Claude मॉडलों से लगभग दस गुना कम।
सैकड़ों टूल कॉल करने वाले एजेंट के लिए यही अनुपात तय करता है कि कार्य का प्रयास करना भी उचित है या नहीं। संरचना का काम, जो पहले विशुद्ध शोध लगता था, अब सीधे तय करता है कि लंबा निष्पादन आर्थिक रूप से उचित है या नहीं।
हम इससे क्या सीखते हैं
दो बातें, दोनों अन्य जगह लागू करने योग्य।
पहली, सवाल का ढाँचा। जानकारी का प्रवाह कहाँ रुक रहा है? इससे अलग तरह का काम निकलता है, बनिस्बत इसके कि हम इसे और कितना बड़ा कर सकते हैं? — और इसे हिस्सों में बाँटा जा सकता है, इसलिए तीन तंत्र अलग-अलग विकसित और मापे जा सके।
दूसरी, क्षय सीमा। अभिव्यक्ति क्षमता पर लगभग नगण्य लागत वाली एक बाधा ने कर्नेल से पूरा विशेष कोड पथ हटा दिया। तेज़ पथ नहीं — पथ ही नहीं। ऐसा समझौता जितनी बार अपनाया जाता है, उससे कहीं अधिक बार उपलब्ध होता है, और यह केवल उन्हीं को दिखता है जो गणित और हार्डवेयर दोनों को साथ समझते हैं।
रिपोर्ट और वेट उपलब्ध हैं GitHub पर खुले रूप में। संरचना वाला खंड आठ पृष्ठों का है और ध्यान से पढ़ने पर सार्थक समझ देता है।