
Il numero di punta di Kimi K3 è 2.8 mila miliardi di parametri. È il numero meno interessante del rapporto.
La parte interessante è che l'architettura è organizzata attorno a una domanda che non ha nulla a che fare con le dimensioni: dove si interrompe il flusso di informazioni? La risposta ha tre parti — lungo la sequenza, lungo la profondità, lungo la larghezza — e ciascuna ha il proprio meccanismo.
A parità di risorse di calcolo, l'efficienza di scalabilità è circa 2.5× quella di Kimi K2. Questo dato deriva dalle curve delle leggi di scala adattate dal team ai propri dati, non da una riproduzione indipendente: va quindi letto come una loro affermazione. Ma i meccanismi alla base sono abbastanza specifici da poter essere discussi nel merito, ed è questo che rende il rapporto degno del tempo necessario per leggerlo.
Questa è una lettura approfondita del rapporto tecnico di Kimi K3 (Moonshot AI), concentrata sulla sezione dedicata all'architettura. Abbiamo già scritto della progettazione di agenti a lungo orizzonte; questo articolo scende più in profondità nello stack.
Tre direzioni, non un solo numero
Ogni livello di un transformer combina informazioni in tre modi. Tra i token, così che la posizione 900,000 possa influenzare la posizione 1. Lungo la profondità, così che il livello 90 possa usare ciò che il livello 3 ha rilevato. Tra i canali, così che le caratteristiche possano ricombinarsi.
La maggior parte del lavoro sulla scalabilità interviene su tutte e tre le direzioni contemporaneamente, aumentando ogni dimensione. K3 le separa e assegna a ciascuna il proprio meccanismo:
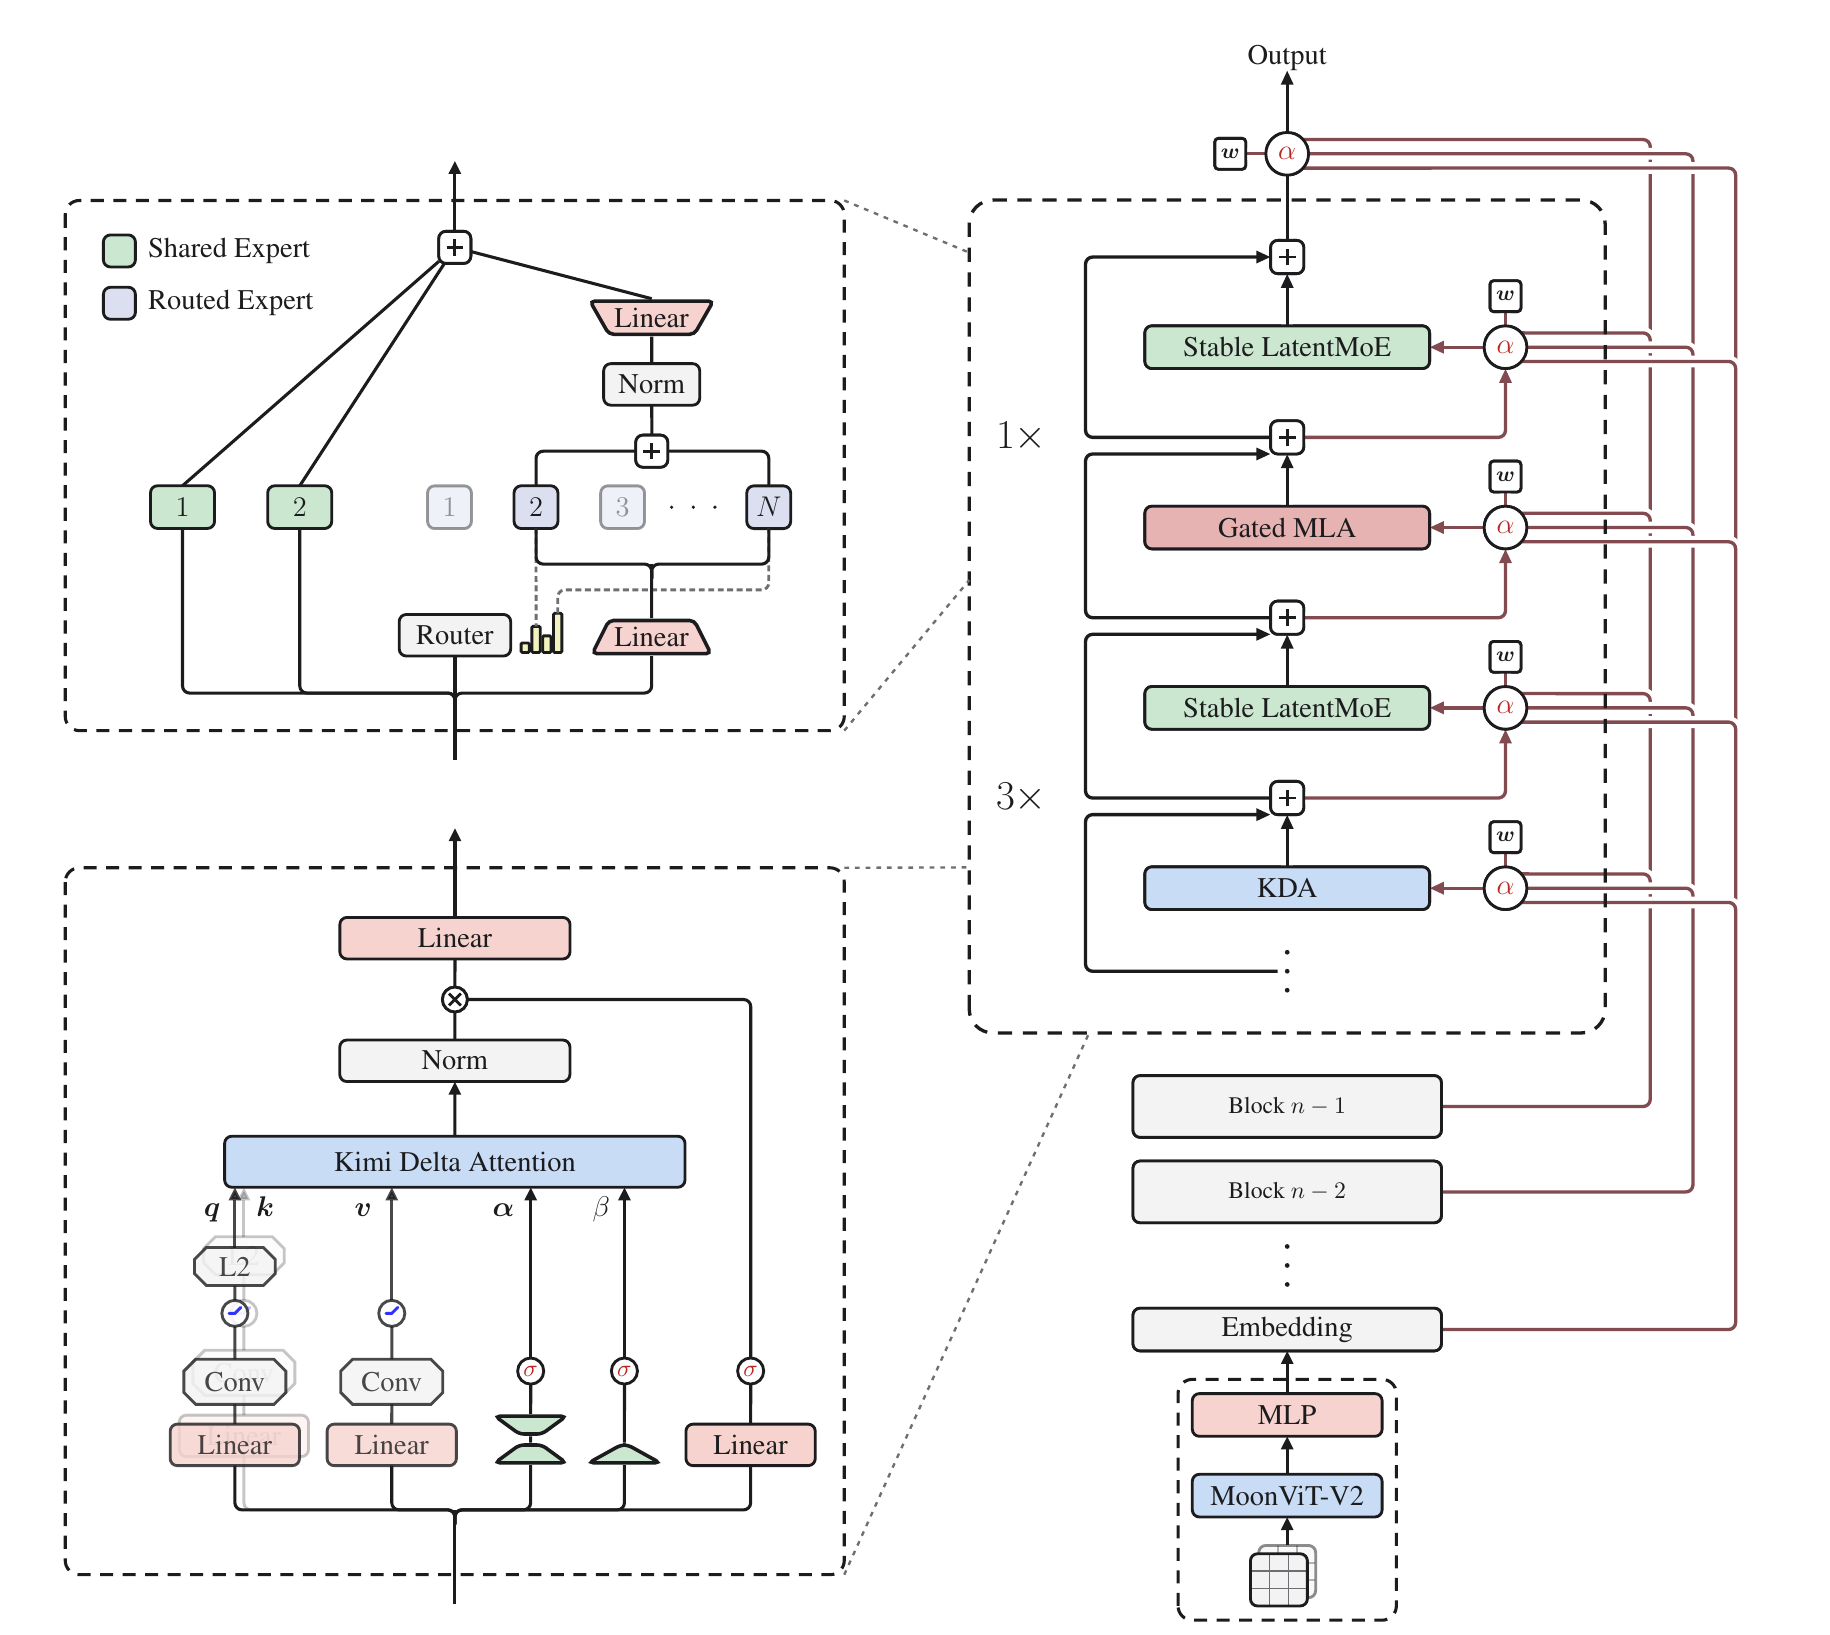
- Sequenza — attenzione ibrida: tre livelli Kimi Delta Attention per ogni livello Gated MLA.
- Profondità — Attention Residuals: ogni livello applica l'attenzione alle uscite di tutti i livelli precedenti, invece di ereditare un unico stato accumulato.
- Larghezza — Stable LatentMoE: 896 esperti selezionati tramite instradamento, 16 attivi per token.
La dimensione nascosta non è cambiata affatto. 7168 in K2, 7168 in K3. Qualunque cosa sia cresciuta, non è stata la larghezza di un livello.
Sequenza: tre quarti dei livelli hanno smesso di leggere tutto
L'attenzione standard rilegge l'intero prefisso per ogni nuovo token. A un milione di token, è questo costo a diventare insostenibile.
K3 suddivide il lavoro. Tre livelli KDA mantengono uno stato aggiornato di dimensione fissa — un processo più simile a prendere appunti che a rileggere la fonte — seguiti da un livello Gated MLA che applica l'attenzione globale completa. Lo schema si ripete, con un livello MLA aggiuntivo alla fine, in modo che l'ultimo livello veda sempre tutto. Su 93 livelli: 69 KDA, 24 MLA.
La dimensione fissa è il punto fondamentale. Lo stato non cresce con la sequenza, quindi non può espandersi senza controllo. Comporta però anche una perdita di informazioni: per questo ogni quarto livello è un livello di attenzione completa, che recupera ciò che gli appunti hanno omesso.
C'è poi un effetto di secondo ordine. Poiché lo stato ricorrente incorpora un decadimento — i token recenti sono naturalmente più presenti di quelli vecchi — l'informazione sulla posizione arriva senza costi aggiuntivi. Perciò K3 non applica alcuna codifica posizionale ai suoi livelli di attenzione globale. Niente RoPE, nulla da riscalare.
Questo significa che l'estensione a un milione di token non ha richiesto alcun intervento sulla codifica posizionale. Nessuno degli espedienti di interpolazione accumulati nel settore per estendere il contesto si applica qui, perché non c'è alcuna codifica da interpolare.
Un limite inferiore che ha eliminato un percorso di codice GPU
È la nostra parte preferita del rapporto, ed è abbastanza breve da poter passare inosservata.
Lo stato ricorrente dimentica man mano che procede. Per calcolarlo efficientemente a blocchi bisogna dividere per il decadimento accumulato, e il decadimento accumulato è un prodotto di numeri inferiori a uno. Se lo si lascia procedere senza vincoli, si finisce per dividere per un valore arbitrariamente vicino a zero.
La generazione precedente gestiva il problema suddividendo ogni blocco in tasselli da 16 token e lavorando nello spazio logaritmico. Funzionava, ma i tasselli sulla diagonale dovevano comunque essere valutati coppia di posizioni per coppia di posizioni: un percorso lento e dedicato a un caso speciale, che non poteva usare i tensor core.
La soluzione di K3 è una riga di parametrizzazione. Si pone un limite inferiore al logaritmo del decadimento: a ogni passaggio si può dimenticare fino a conservare lo 0.67% di ciò che si aveva, e non meno.
Vediamo le conseguenze. Con questo limite, il logaritmo del decadimento accumulato su un tassello da 16 token rimane nell'intervallo (−80, 0). Il reciproco è quindi inferiore a e80 ≈ 5.5 × 1034, ampiamente entro l'intervallo di BF16, che arriva a circa 3.4 × 1038. Non si verifica alcun overflow. I tasselli diagonali possono quindi usare la stessa moltiplicazione tra matrici dense di tutti gli altri tasselli.
Il percorso speciale non viene ottimizzato. Viene eliminato.
Ripercorrendo la causalità a ritroso, il risultato diventa ancora più interessante: l'intervallo dinamico dell'hardware ha determinato l'intervallo accettabile, che ha determinato la costante, che ha imposto un limite inferiore all'attivazione. È stata la rappresentazione numerica a scegliere la matematica, non il contrario.
Profondità: da una staffetta a una chat di gruppo
A novantatré livelli di profondità, il flusso residuo standard è una staffetta. Il livello 50 riceve un unico stato accumulato dal livello 49. Tutto ciò che i livelli da 1 a 48 hanno rilevato individualmente è stato sommato in quello stato e non è più separabile.
L'articolo presenta questo problema come lo stesso collo di bottiglia che una RNN incontra nel tempo, e che il settore ha già risolto con l'attenzione. Attention Residuals applica la stessa soluzione alla profondità: ogni livello dispone di una pseudo-query apprendibile e applica l'attenzione alle uscite di tutti i livelli precedenti, scegliendo cosa leggere.
Applicare letteralmente questo approccio comporta un costo di calcolo quadratico rispetto alla profondità e, peggio ancora, richiede di mantenere l'uscita di ogni livello in memoria e in transito nella rete quando si usa il parallelismo a pipeline. Perciò K3 usa la variante a blocchi: 93 livelli suddivisi in gruppi di dodici, con somma all'interno di ogni gruppo e attenzione completa tra i gruppi. Il costo aggiuntivo passa da uno per livello a uno per gruppo, e lo stato durante l'inferenza rimane limitato.
Larghezza: 896 esperti, 16 attivi
Mixture-of-experts mantiene un ampio insieme di esperti e ne attiva alcuni per token. K2 ne sceglieva 8 su 384. K3 ne sceglie 16 su 896: un rapporto di sparsità pari a 56.
Ampliare così tanto l'insieme compromette due aspetti, e il rapporto è insolitamente diretto su entrambi.
Comunicazione. In un MoE convenzionale, ogni esperto selezionato riceve il token a larghezza piena, quindi il traffico cresce con il numero di esperti selezionati. LatentMoE disaccoppia le due cose: gli esperti selezionati tramite instradamento lavorano in uno spazio latente compatto di larghezza pari alla metà di quella del modello, mentre due esperti condivisi a larghezza piena gestiscono ciò che serve a ogni token. L'insieme può crescere senza che cresca anche il costo delle comunicazioni.
Stabilità. A questo livello di sparsità, il ramo instradato diventa una catena di quasi quattro moltiplicazioni matriciali consecutive, e le attivazioni esplodono. Due soluzioni: una RMSNorm tra l'aggregazione degli esperti e la proiezione verso una dimensione maggiore, e una nuova attivazione, SiTU-GLU, che limita entrambi i fattori di una SwiGLU con una tanh scalata, affinché nessuno dei due possa crescere senza controllo a bassa precisione.
Bilanciamento. La terza soluzione è quella da cui vale la pena prendere spunto. Mantenere un carico uniforme su circa 900 esperti significa regolare un bias per ogni esperto a ogni passaggio. Il metodo standard sposta ogni bias di un incremento fisso nella direzione dell'errore, finendo per oscillare o restare indietro. K3, invece, lo calcola direttamente: esegue top-(k+1) anziché top-k, e l'elemento aggiuntivo è il punteggio richiesto da un token per l'ammissione. Con queste soglie, il carico ricevuto da un esperto al variare di un bias candidato è monotono, quindi il bias che raggiunge il carico obiettivo è semplicemente un quantile dei margini. Un solo passaggio in avanti, senza alcun passo di aggiornamento da regolare.
Su larga scala, quel quantile coinvolge milioni di valori distribuiti su tutti i processi, quindi viene stimato da un istogramma: ogni processo conta i valori nei propri intervalli, un'operazione all-reduce li somma e il quantile viene ricavato dai conteggi aggregati. I conteggi si sommano, quindi la stima riflette l'intero batch indipendentemente da come sono distribuiti i token, al costo di poche centinaia di intervalli per esperto.
Il conto arriva nello stack di erogazione dell'inferenza
Nulla di tutto questo è gratuito, e la parte schietta del rapporto è la sezione sull'infrastruttura, dove ricadono i costi.
Uno stato ricorrente di dimensione fissa costa poco da memorizzare e da trasferire, ma si aggiorna in modo seriale e non si può semplicemente sommare. Entrambe le proprietà richiedono lavoro:
- Suddividere una sequenza tra dispositivi. L'attenzione lineare ordinaria consente a ogni dispositivo di calcolare il proprio stato locale partendo da zero e di sommare i risultati. KDA applica allo stato in ingresso una transizione dipendente dal token, quindi la somma è sbagliata. La soluzione scompone ogni segmento in una transizione cumulativa e uno stato calcolato partendo da zero — due quantità che si possono comporre — e ricostruisce lo stato in ingresso di ogni dispositivo con una scansione dei prefissi e un'unica operazione all-gather di dimensione fissa.
- Riutilizzare un prefisso tra richieste. Metà delle cache è composta da pagine per token, l'altra metà da uno stato fisso per richiesta, e per sfruttare un dato presente in cache entrambe devono poter essere ripristinate allo stesso confine. La risposta del team è disaccoppiare le granularità: calcolare l'hash ogni 512 token, allocare a 1024–6144 e salvare un punto di ripristino dello stato ricorrente solo in un sottoinsieme rado dei confini degli hash.
- Decodifica speculativa. Lo stato viene aggiornato sul posto, quindi una bozza rifiutata non può essere annullata ripristinando lo stato precedente. Vengono invece memorizzati in cache gli ingressi proiettati — molto più piccoli dello stato stesso — per poi ricostruire lo stato sul chip.
Il filo conduttore di tutti e tre i casi è lo stesso del limite al decadimento, percorso nella direzione opposta: l'architettura ha scelto una rappresentazione, e la rappresentazione ha dettato il lavoro sui sistemi.
Un'abitudine che l'articolo abbandona senza clamore
K3 è nativamente multimodale e il suo codificatore visivo viene addestrato da zero con la previsione del token successivo. Nessuna inizializzazione SigLIP, nessun preaddestramento contrastivo: la ricetta standard, usata anche nel precedente modello dello stesso team.
Il motivo dichiarato non è la qualità. È la stabilità: il codificatore inizializzato con apprendimento contrastivo mostrava norme del gradiente persistentemente più alte, con picchi frequenti durante l'ottimizzazione congiunta, mentre quello addestrato da zero rimaneva stabile. Le valutazioni visive hanno dato risultati equivalenti.
Questo rende il risultato più incisivo di quanto sarebbe stata una vittoria. Se l'addestramento da zero fosse stato migliore, si parlerebbe di una ricetta migliore. Ha ottenuto lo stesso risultato: l'affermazione è quindi che, a questa scala, un passaggio considerato obbligatorio nel settore è semplicemente facoltativo.
Cosa significa per chi esegue agenti su questi modelli
Sviluppiamo un client desktop con più agenti, quindi ciò che osserviamo è se un'esecuzione a lungo orizzonte rimane economicamente sostenibile, non chi è in cima a una classifica.
Il numero che conta non è la dimensione della finestra di contesto, ma quanto costa elaborare un milione di token in inferenza. Tre quarti dei livelli mantengono uno stato di dimensione fissa, quindi la cache che cresce con la conversazione è un quarto di quella che servirebbe in un modello basato interamente sull'attenzione e con la stessa profondità. Su BrowseComp, il rapporto attribuisce a K3 un 91.2% a circa $2 per attività: all'incirca metà del costo del punteggio proprietario più vicino e un ordine di grandezza in meno rispetto ai modelli Claude con il massimo sforzo di ragionamento.
Per un agente che esegue centinaia di chiamate a strumenti, questo rapporto determina se vale la pena anche solo tentare un'attività. Il lavoro sull'architettura, che un tempo sembrava ricerca pura, oggi incide direttamente sulla ragionevolezza economica di un'esecuzione lunga.
Cosa ne ricaviamo
Due elementi, entrambi trasferibili.
Primo, l'impostazione della domanda. Dove si interrompe il flusso di informazioni? porta a un lavoro diverso da quanto possiamo ancora aumentare le dimensioni? — e si presta a essere scomposta, motivo per cui è stato possibile sviluppare e misurare separatamente tre meccanismi.
Secondo, il limite al decadimento. Un vincolo che costa quasi nulla in termini di espressività ha eliminato dal kernel un intero percorso dedicato a un caso speciale. Non un percorso più veloce: nessun percorso. Questo compromesso è disponibile molto più spesso di quanto venga adottato, ed è visibile solo a chi tiene presenti contemporaneamente la matematica e l'hardware.
Il rapporto e i pesi sono disponibili pubblicamente su GitHub. La sezione sull'architettura occupa otto pagine e merita una lettura attenta.