
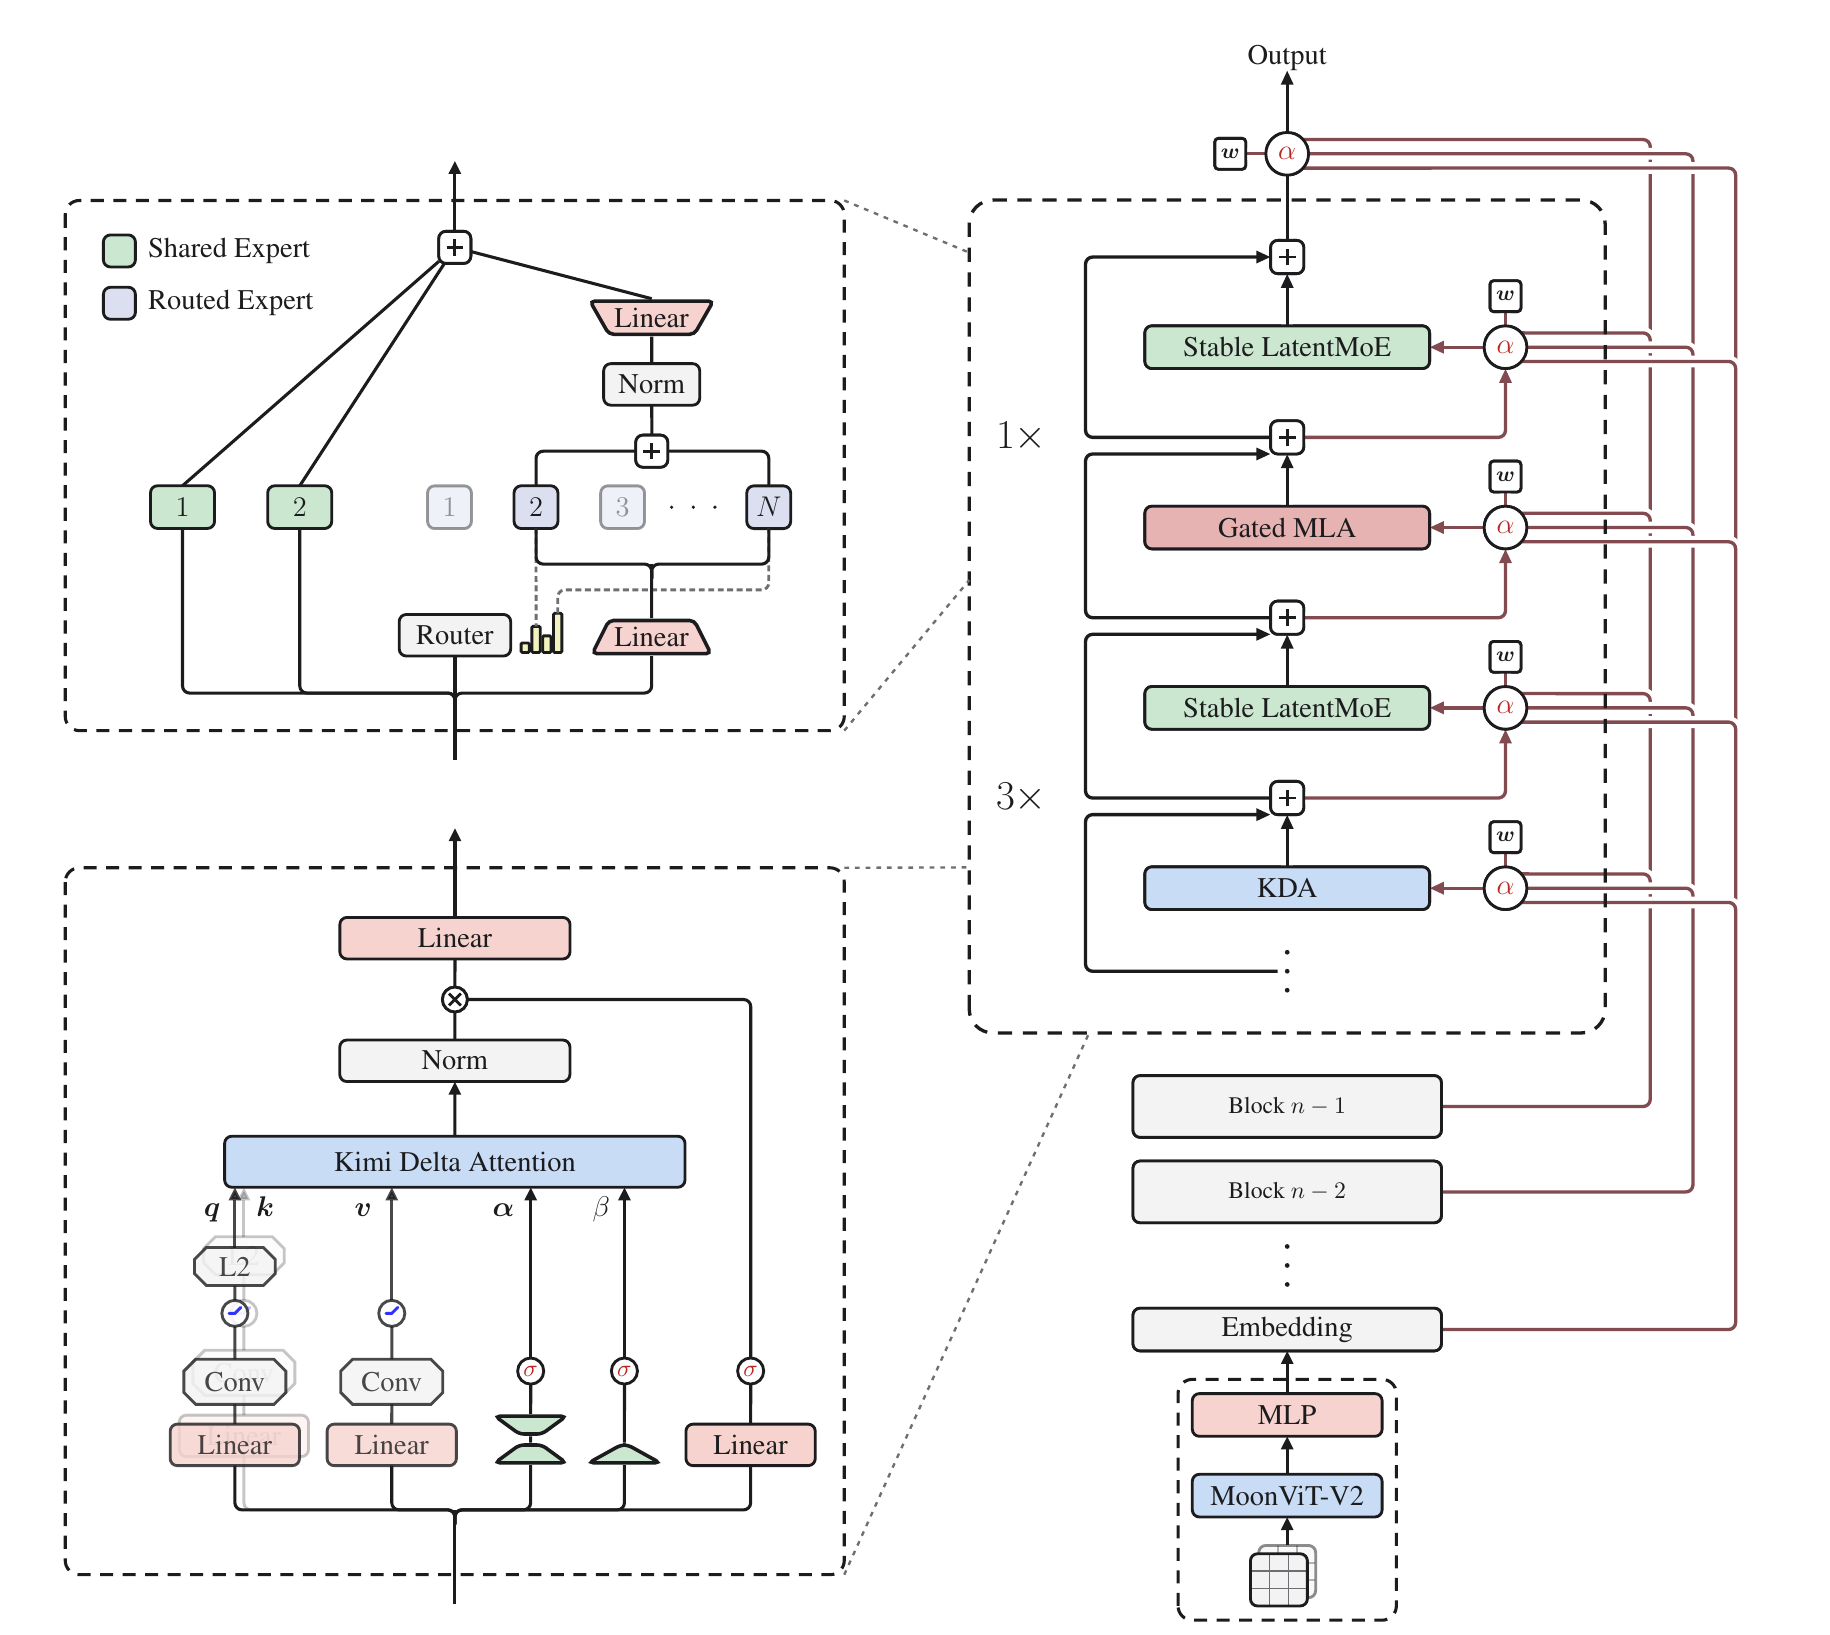
Главная цифра Kimi K3 — 2,8 триллиона параметров. Это наименее интересное число в отчёте.
Интересно то, что архитектура построена вокруг вопроса, не связанного с размером: где затруднено движение информации? Ответ состоит из трёх частей — вдоль последовательности, по глубине и по ширине, — и каждой соответствует свой механизм.
При тех же вычислительных затратах эффективность масштабирования примерно в 2,5 раза выше, чем у Kimi K2. Эта цифра взята из кривых законов масштабирования, аппроксимированных самой командой, а не из независимого воспроизведения, поэтому воспринимайте её как утверждение авторов. Но лежащие в основе механизмы достаточно конкретны для обсуждения, и именно поэтому отчёт стоит потраченного времени.
Это подробный разбор технического отчёта Kimi K3 (Moonshot AI), сосредоточенный на разделе об архитектуре. Ранее мы писали о проектировании агентов для длительных задач; здесь речь о более низком уровне стека.
Три направления, а не одно число
Каждый слой трансформера смешивает информацию тремя способами. Между токенами — чтобы позиция 900 000 могла влиять на позицию 1. По глубине — чтобы слой 90 мог использовать то, что заметил слой 3. Между каналами — чтобы признаки могли сочетаться заново.
Большинство работ по масштабированию двигает все три направления одновременно, увеличивая всё. K3 разделяет их и даёт каждому собственный механизм:
- Последовательность — гибридное внимание: три слоя Kimi Delta Attention на каждый слой Gated MLA.
- Глубина — Attention Residuals: каждый слой применяет внимание к выходам всех предыдущих слоёв вместо наследования одного накопленного состояния.
- Ширина — Stable LatentMoE: 896 маршрутизируемых экспертов, 16 активны для каждого токена.
Размер скрытого представления вообще не изменился. 7 168 в K2 и 7 168 в K3. Что бы ни выросло, это была не ширина слоя.
Последовательность: три четверти слоёв перестали читать всё
Стандартное внимание заново читает весь префикс для каждого нового токена. На миллионе токенов именно эта стоимость становится непосильной.
K3 делит работу. Три слоя KDA поддерживают текущее состояние фиксированного размера — скорее ведут заметки, чем перечитывают источник, — затем один слой Gated MLA выполняет полное глобальное внимание. Шаблон повторяется, а в самом конце добавлен ещё один слой MLA, чтобы последний слой всегда видел всё. Всего 93 слоя: 69 KDA и 24 MLA.
Фиксированный размер — вся суть. Состояние не растёт вместе с последовательностью, поэтому не может разрастись бесконтрольно. Но оно теряет информацию, поэтому каждый четвёртый слой использует полное внимание, восстанавливая то, что выпало из заметок.
Далее возникает вторичный эффект. Поскольку рекуррентное состояние затухает — недавние токены естественным образом представлены сильнее старых, — информация о позиции достаётся бесплатно. Поэтому K3 вообще не использует позиционное кодирование в слоях глобального внимания. Ни RoPE, ни чего-либо, что нужно перемасштабировать.
Значит, расширение до миллиона токенов не потребовало переделки позиционного кодирования. Никакие интерполяционные приёмы, накопленные для расширения контекста, здесь не нужны, потому что интерполировать нечего.
Нижняя граница, удалившая ветвь кода GPU
Это наша любимая часть отчёта, и она достаточно мала, чтобы её легко было пропустить.
Рекуррентное состояние постепенно забывает информацию. Для эффективного вычисления блоками нужно делить на накопленное затухание, а оно представляет собой произведение чисел меньше единицы. Без ограничений вы делите на величину, сколь угодно близкую к нулю.
Предыдущее поколение решало это разбиением каждого блока на плитки по 16 токенов и работой в логарифмическом пространстве. Это работало, но диагональные плитки всё равно приходилось вычислять для каждой пары позиций — медленной особой ветвью, неспособной использовать тензорные ядра.
Исправление K3 — одна строка параметризации. Ограничить логарифм затухания снизу: на каждом шаге можно сохранить лишь 0,67% прежнего содержимого, но не меньше.
Проследим следствие. С этой границей накопленный логарифм затухания на плитке из 16 токенов остаётся в пределах (−80, 0). Поэтому обратная величина меньше e80 ≈ 5,5 × 1034, что с большим запасом укладывается в диапазон BF16 около 3,4 × 1038. Переполнения нет. Значит, для диагональных плиток можно использовать то же плотное матричное умножение, что и для остальных.
Особую ветвь не оптимизировали. Её убрали.
Если прочитать причинную цепочку в обратную сторону, становится ещё интереснее: динамический диапазон оборудования определил допустимый интервал, тот определил константу, а она — необходимость ограничить активацию снизу. Численные ограничения выбрали математику, а не наоборот.
Глубина: от эстафеты к групповому чату
При глубине в девяносто три слоя стандартный остаточный поток похож на эстафету. Слой 50 получает одно накопленное состояние от слоя 49. Всё, что по отдельности заметили слои с 1 по 48, уже сложено в это состояние и больше неразделимо.
Авторы описывают это как то же узкое место, что есть у RNN по времени, — а его уже решили с помощью внимания. Attention Residuals применяет то же решение к глубине: каждый слой имеет обучаемый псевдозапрос и применяет внимание к выходам всех предыдущих слоёв, выбирая, что читать.
Буквальная реализация требует квадратичных по глубине вычислений и, хуже того, хранит выход каждого слоя в памяти и передаёт его при конвейерном параллелизме. Поэтому K3 использует блочный вариант: 93 слоя разбиты на группы по двенадцать, внутри группы выполняется суммирование, между группами — полное внимание. Накладные расходы становятся погрупповыми вместо послойных, а состояние при инференсе остаётся ограниченным.
Ширина: 896 экспертов, 16 активны
Смесь экспертов хранит большой пул и активирует несколько на токен. K2 выбирала 8 из 384. K3 выбирает 16 из 896 — коэффициент разреженности 56.
Такое увеличение пула ломает две вещи, и отчёт необычно прямо говорит об обеих.
Обмен данными. В обычной MoE каждый выбранный эксперт получает токен полной ширины, поэтому трафик растёт с числом выбранных экспертов. LatentMoE разделяет эти величины: маршрутизируемые эксперты работают в компактном латентном пространстве половинной ширины модели, а два общих эксперта полной ширины обрабатывают то, что нужно каждому токену. Пул может расти без соответствующего роста затрат на передачу.
Стабильность. При такой разреженности маршрутизируемая ветвь становится цепочкой почти из четырёх последовательных матричных умножений, и активации взрываются. Два исправления: RMSNorm между объединением экспертов и повышающей проекцией и новая активация SiTU-GLU, ограничивающая оба множителя SwiGLU масштабированным tanh, чтобы ни один не выходил из-под контроля при низкой точности.
Баланс. Третье исправление стоит перенять. Чтобы равномерно загружать примерно 900 экспертов, приходится на каждом шаге менять смещение каждого эксперта. Стандартный метод сдвигает смещение на фиксированную величину в направлении ошибки, что приводит либо к колебаниям, либо к запаздыванию. K3 вместо этого решает задачу напрямую: использует top-(k+1) вместо top-k, и дополнительный элемент является оценкой, которую токен требует для допуска. При известных порогах нагрузка эксперта монотонна по предполагаемому смещению, поэтому смещение для целевой нагрузки — просто квантиль разностей оценок относительно порога. Один прямой проход, без настройки размера шага.
На большом масштабе этот квантиль охватывает миллионы значений на всех рангах, поэтому его оценивают по гистограмме: каждый ранг считает свои интервалы, одна операция all-reduce суммирует их, а квантиль считывается из общих частот. Частоты складываются, поэтому оценка отражает весь пакет независимо от распределения токенов, ценой нескольких сотен интервалов на эксперта.
Расплачиваться приходится в стеке обслуживания
Ничто из этого не бесплатно, и честная часть отчёта — раздел об инфраструктуре, на которую ложатся затраты.
Рекуррентное состояние фиксированного размера дёшево хранить и передавать, но оно обновляется последовательно и не складывается простым суммированием. Оба свойства требуют работы:
- Разбиение последовательности между устройствами. Обычное линейное внимание позволяет каждому устройству вычислить локальное состояние с нуля и сложить результаты. KDA применяет к входящему состоянию зависящий от токена переход, поэтому суммирование неверно. Решение разлагает каждый сегмент на накопленный переход и состояние с нулевым началом — две величины, которые действительно компонуются, — и восстанавливает входное состояние каждого устройства префиксным сканированием и одной операцией all-gather фиксированного размера.
- Повторное использование префикса между запросами. Половина кешей — страницы токенов, половина — одно фиксированное состояние на запрос, и попадание в кеш требует восстановления обоих на одной границе. Ответ авторов — разделить гранулярности: хешировать каждые 512 токенов, выделять память блоками по 1024–6144 и сохранять рекуррентное состояние лишь на редком подмножестве границ хеширования.
- Спекулятивное декодирование. Состояние обновляется на месте, поэтому отклонённый черновик нельзя откатить. Вместо этого кешируют спроецированные входы — гораздо меньшие, чем само состояние, — и пересоздают его на чипе.
Во всех трёх случаях повторяется схема ограничения затухания, но в обратном направлении: архитектура выбрала представление, а представление продиктовало системную работу.
Одна привычка, от которой статья незаметно отказывается
K3 изначально мультимодальна, а её визуальный кодировщик обучается с нуля предсказанию следующего токена. Без инициализации SigLIP и контрастивного предобучения — стандартного рецепта, в том числе в предыдущей модели самой команды.
Заявленная причина — не качество, а стабильность: кодировщик с контрастивной инициализацией при совместной оптимизации постоянно показывал более высокие нормы градиентов с частыми всплесками, а обученный с нуля оставался стабильным. Оценки зрительных задач оказались равными.
Это делает вывод более выразительным, чем была бы победа. Если бы обучение с нуля оказалось лучше, его назвали бы лучшим рецептом. Но оно сравнялось, поэтому тезис в том, что на этом масштабе шаг, считающийся обязательным, лишь опционален.
Что это значит, если вы запускаете агентов на этих моделях
Мы создаём настольный клиент с несколькими агентами, поэтому следим за доступностью длительного запуска по цене, а не за лидером таблицы.
Важен не размер контекстного окна, а стоимость обслуживания миллиона токенов. Три четверти слоёв хранят состояние фиксированного размера, поэтому кеш, растущий с разговором, вчетверо меньше, чем был бы у модели той же глубины только с полным вниманием. На BrowseComp отчёт указывает для K3 91,2% примерно при $2 за задачу — около половины стоимости ближайшего результата закрытой модели и на порядок меньше моделей Claude с максимальным уровнем усилий.
Для агента, выполняющего сотни вызовов инструментов, это соотношение определяет, стоит ли вообще пытаться решать задачу. Архитектурная работа, прежде казавшаяся чистым исследованием, теперь напрямую влияет на экономическую разумность длительного запуска.
Что мы из этого выносим
Две вещи, обе применимы в других задачах.
Во-первых, постановку вопроса. Где затруднено движение информации? ведёт к другой работе, чем насколько ещё можно увеличить размер? — и этот вопрос раскладывается на части, поэтому три механизма удалось разработать и измерить отдельно.
Во-вторых, нижнюю границу затухания. Ограничение, почти ничего не стоящее в выразительности, убрало из ядра целую особую ветвь. Не ускорило ветвь, а устранило её. Такой обмен возможен гораздо чаще, чем им пользуются, и виден только тем, кто одновременно держит в уме математику и оборудование.
Отчёт и веса открыто доступны на GitHub. Раздел об архитектуре занимает восемь страниц и стоит внимательного чтения.