
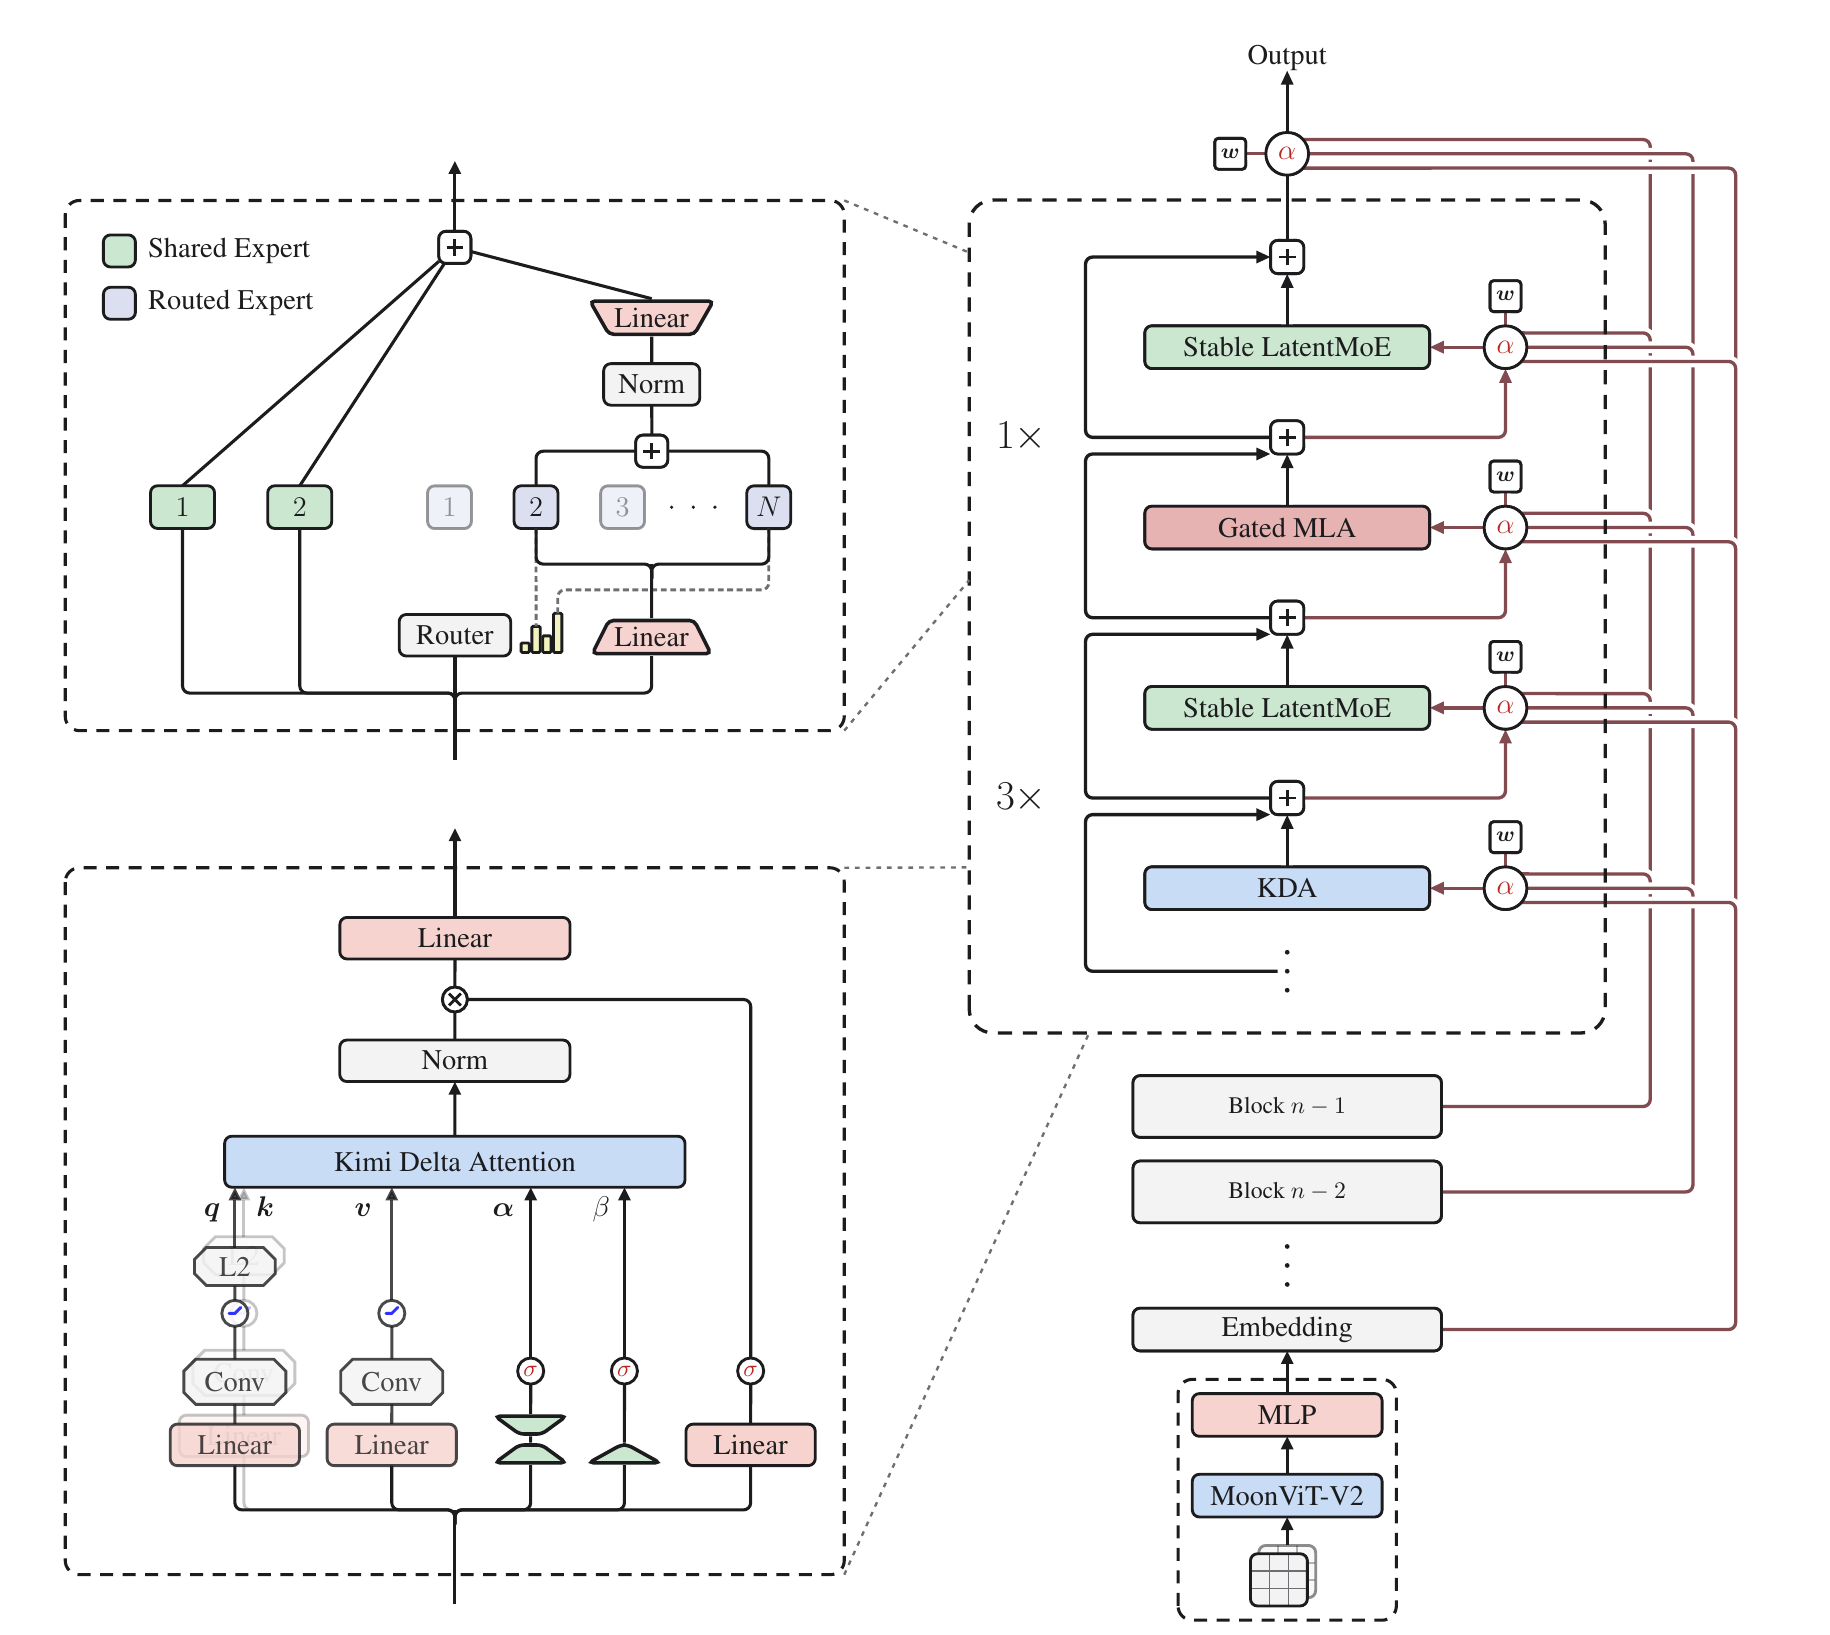
Kimi K3'ün öne çıkan sayısı 2.8 trilyon parametre. Bu, rapordaki en az ilginç sayı.
İlginç olan, mimarinin boyutla hiçbir ilgisi olmayan bir soru etrafında düzenlenmesi: bilgi nerede akamıyor? Yanıtın üç parçası var: dizi boyunca, derinlik boyunca ve genişlik boyunca; her biri kendi mekanizmasına sahip.
Aynı hesaplama gücüyle Kimi K2'nin yaklaşık 2.5× ölçekleme verimliliği. Bu rakam bağımsız bir tekrardan değil, ekibin kendi uydurduğu ölçekleme yasası eğrilerinden geliyor; dolayısıyla ekibin iddiası olarak okuyun. Ama arkasındaki mekanizmalar tartışılabilecek kadar somut; raporu zaman ayırmaya değer kılan da bu.
Bu yazı, Kimi K3 teknik raporunun (Moonshot AI) mimari bölümüne odaklanan yakın bir okumasıdır. Daha önce uzun ufuklu ajan tasarımıhakkında yazmıştık; bu yazı ise teknoloji yığınının daha alt katmanlarına iniyor.
Tek sayı değil, üç yön
Bir transformer'ın her katmanı bilgiyi üç şekilde karıştırır. Tokenlar arasında; böylece 900,000. konum 1. konumu etkileyebilir. Derinlik boyunca; böylece 90. katman, 3. katmanın fark ettiğini kullanabilir. Kanallar arasında; böylece özellikler yeniden birleşebilir.
Ölçekleme çalışmalarının çoğu, her şeyi büyüterek üçünü birden ilerletir. K3 bunları ayırır ve her birine kendi mekanizmasını verir:
- Dizi — hibrit dikkat: her bir Gated MLA katmanına karşılık üç Kimi Delta Attention katmanı.
- Derinlik — Attention Residuals: her katman, birikmiş tek bir durumu devralmak yerine önceki tüm katmanların çıktıları üzerinde dikkat uygular.
- Genişlik — Stable LatentMoE: 896 yönlendirilmiş uzman, token başına 16'sı etkin.
Gizli boyut hiç değişmedi. K2'de 7,168, K3'te 7,168. Büyüyen ne olursa olsun, bir katmanın genişliği değildi.
Dizi: katmanların dörtte üçü her şeyi okumayı bıraktı
Standart dikkat, her yeni token için önekin tamamını yeniden okur. Bir milyon tokenda sürdürülemez hâle gelen maliyet budur.
K3 işi böler. Üç KDA katmanı sabit boyutlu, sürekli güncellenen bir durum tutar; bu, kaynağı yeniden okumaktan çok not almaya benzer. Ardından bir Gated MLA katmanı tam küresel dikkat uygular. Örüntü tekrarlanır; son katmanın daima her şeyi görmesi için en sona fazladan bir MLA katmanı eklenir. Toplam 93 katmanda: 69 KDA, 24 MLA.
Bütün mesele sabit boyuttur. Durum, diziyle birlikte büyümez; dolayısıyla kontrolden çıkamaz. Aynı zamanda kayıplıdır; notların atladıklarını geri kazanmak için her dördüncü katmanda tam dikkat katmanı bulunmasının nedeni budur.
Sonra ikinci dereceden bir etki ortaya çıkar. Tekrarlayan durum bir azalma içerdiğinden — yakın tarihli tokenlar doğal olarak eskilerden daha belirgindir — konum bilgisi bedelsiz gelir. Bu yüzden K3, hiçbir konumsal kodlama uygulamaz küresel dikkat katmanlarına. RoPE yok, yeniden ölçeklenecek bir şey yok.
Bu da bir milyon tokena çıkmanın konumsal kodlamada hiçbir müdahale gerektirmediği anlamına gelir. Alanın bağlam genişletmek için biriktirdiği enterpolasyon hilelerinin hiçbiri burada geçerli değildir; çünkü enterpolasyon yapılacak bir kodlama yoktur.
Bir GPU kod yolunu ortadan kaldıran alt sınır
Raporun en sevdiğimiz kısmı bu; üstelik gözden kaçacak kadar küçük.
Tekrarlayan durum ilerledikçe unutur. Bunu parçalar hâlinde verimli hesaplamak, birikimli azalmaya bölmeyi gerektirir; birikimli azalma ise birden küçük sayıların çarpımıdır. Kontrolsüz bırakırsanız sıfıra keyfî derecede yakın bir değere bölmeye başlarsınız.
Önceki nesil bunu, her parçayı 16 tokenlık bloklara ayırıp logaritmik uzayda çalışarak çözüyordu. İşe yarıyordu; ancak köşegen üzerindeki blokların hâlâ konum çifti konum çifti değerlendirilmesi gerekiyordu. Bu, tensor çekirdeklerini kullanamayan yavaş ve özel bir kod yoluydu.
K3'ün çözümü tek satırlık bir parametreleştirme. Logaritmik azalmayı alttan sınırlandırın: her adım, elinde tuttuğunun %0.67'sine kadar unutabilir, daha fazlasını değil.
Sonucunu izleyin. Bu sınırla, 16 tokenlık bir blok boyunca birikimli logaritmik azalma (−80, 0) aralığında kalır. Dolayısıyla çarpmaya göre tersi e80 ≈ 5.5 × 1034değerinin altında kalır; BF16'nın yaklaşık 3.4 × 1038aralığının rahatça içindedir. Hiçbir şey taşmaz. Böylece köşegen bloklar, diğer tüm bloklarla aynı yoğun matris çarpımını kullanabilir.
Özel kod yolu optimize edilmiyor. Ortadan kalkıyor.
Nedenselliği tersinden okuyunca daha da ilginçleşiyor: donanımın dinamik aralığı kabul edilebilir aralığı belirledi; bu, sabiti belirledi; o da aktivasyonun alttan sınırlandırılması gerektiğini belirledi. Matematiği sayısal koşullar seçti, tersi değil.
Derinlik: bayrak yarışından grup sohbetine
Doksan üç katman derinliğinde standart artık bağlantı akışı bir bayrak yarışıdır. 50. katman, 49. katmandan birikmiş tek bir durum alır. 1'den 48'e kadar katmanların ayrı ayrı fark ettikleri bu durumda toplanmıştır ve artık birbirinden ayrılamaz.
Makale bunu, bir RNN'nin zaman içinde yaşadığı darboğazla aynı şekilde çerçeveliyor; alan bu sorunu zaten dikkat mekanizmasıyla çözmüştü. Attention Residuals aynı çözümü derinliğe uygular: her katman öğrenilebilir bir sözde sorgu taşır ve önceki tüm katmanların çıktıları üzerinde dikkat uygulayarak ne okuyacağını seçer.
Birebir uygulandığında bu, derinliğe göre karesel hesaplama maliyeti getirir; daha da kötüsü, boru hattı paralelliğinde her katmanın çıktısını bellekte ve iletişim hattında canlı tutar. Bu yüzden K3 blok sürümünü kullanır: 93 katman on ikilik gruplara ayrılır, grup içinde toplanır, gruplar arasında tam dikkat uygulanır. Ek yük katman başına olmaktan grup başına olmaya iner ve çıkarım sırasındaki durum sınırlı kalır.
Genişlik: 896 uzman, 16'sı etkin
Uzmanlar karışımı, büyük bir havuz tutar ve token başına birkaçını etkinleştirir. K2, 384 uzmandan 8'ini seçiyordu. K3, 896 uzmandan 16'sını seçiyor; seyreklik oranı 56.
Havuzu bu kadar büyütmek iki şeyi bozuyor ve rapor her ikisi konusunda da alışılmadık ölçüde açık.
İletişim. Geleneksel bir MoE'de seçilen her uzman tam genişlikteki tokenı alır; dolayısıyla trafik, seçtiğiniz uzman sayısıyla ölçeklenir. LatentMoE ikisini ayrıştırır: yönlendirilen uzmanlar, model genişliğinin yarısı kadar kompakt bir gizil uzayda çalışırken tam genişlikteki iki paylaşılan uzman her tokenın ihtiyaç duyduğu işleri üstlenir. Havuz, iletişim maliyeti onunla birlikte büyümeden genişleyebilir.
Kararlılık. Bu seyreklikte yönlendirilmiş dal, neredeyse art arda dört matris çarpımından oluşan bir zincire dönüşür ve aktivasyonlar patlar. İki çözüm var: uzman birleştirme ile üst boyuta izdüşüm arasına bir RMSNorm ve SwiGLU'nun iki çarpanını da ölçeklenmiş tanh ile sınırlayan yeni bir aktivasyon olan SiTU-GLU; böylece düşük hassasiyette ikisi de kontrolden çıkamaz.
Denge. Üçüncü çözüm, örnek alınmaya değer olanı. Yaklaşık 900 uzmanın yükünü dengede tutmak, her adımda uzman başına bir yanlılık değerini ayarlamak anlamına gelir. Standart yöntem, her yanlılığı hata yönünde sabit bir miktar kaydırır; bu da ya salınıma yol açar ya da geride kalır. K3 bunun yerine değeri çözer: top-k yerine top-(k+1) çalıştırılır ve ek giriş tam olarak bir tokenın kabul edilmek için gerektirdiği puandır. Bu eşikler eldeyken, bir uzmanın aday yanlılık altında aldığı yük monotondur; dolayısıyla hedef yüke ulaşan yanlılık, marjların bir kantilinden ibarettir. Tek ileri geçiş, ayarlanacak adım büyüklüğü yok.
Büyük ölçekte bu kantil, tüm işlem sıralarında milyonlarca değeri kapsar; bu yüzden histogramdan tahmin edilir: her işlem sırası kendi kutularını sayar, bir all-reduce bunları toplar, kantil birleştirilmiş sayımlardan okunur. Sayımlar toplanabildiği için tahmin, tokenların nasıl bölüştürüldüğünden bağımsız olarak tüm yığını yansıtır; maliyeti uzman başına birkaç yüz kutudur.
Fatura, sunum altyapısında ortaya çıkıyor
Bunların hiçbiri bedelsiz değil; raporun dürüst kısmı, maliyetin ortaya çıktığı altyapı bölümü.
Sabit boyutlu tekrarlayan bir durumu saklamak ve taşımak ucuzdur; ancak seri olarak güncellenir ve basitçe toplanamaz. Her iki özellik de ek iş doğurur:
- Bir diziyi cihazlar arasında bölmek. Sıradan doğrusal dikkat, her cihazın yerel durumunu sıfırdan hesaplamasına ve sonuçları toplamasına izin verir. KDA, gelen duruma tokena bağlı bir geçiş uygular; dolayısıyla toplamak yanlıştır. Çözüm, her segmenti birikimli geçişe ve sıfırdan başlayan duruma ayırır — bunlar bileştirilebilen iki niceliktir — ardından bir önek taraması ve sabit boyutlu tek bir all-gather ile her cihazın giriş durumunu elde eder.
- Bir öneki istekler arasında yeniden kullanmak. Önbelleklerin yarısı token başına sayfalar, yarısı ise istek başına tek bir sabit durumdur; önbellek isabeti için ikisinin de aynı sınırda geri yüklenebilmesi gerekir. Çözümleri, ayrıntı düzeylerini ayrıştırmak: 512 tokenda özet değeri hesaplamak, 1024–6144 aralığında alan ayırmak ve tekrarlayan durumun kontrol noktalarını yalnızca özet aralıklarının bitiş noktalarının seyrek bir alt kümesinde kaydetmek.
- Spekülatif kod çözme. Durum yerinde güncellenir; bu yüzden reddedilen bir taslak geri alınamaz. Bunun yerine, durumun kendisinden çok daha küçük olan izdüşümü alınmış girdileri önbelleğe alır ve çip üzerinde yeniden oluştururlar.
Üçünde de görülen örüntü, sönüm sınırındakiyle aynı, ancak ters yönde işler: mimari bir gösterim seçti ve bu gösterim sistem çalışmalarını belirledi.
Makalenin sessizce terk ettiği bir alışkanlık
K3, doğası gereği çok modludur ve görsel kodlayıcısı, sonraki token tahminiyle sıfırdan eğitilir. SigLIP ile başlatma yok, karşılaştırmalı ön eğitim yok; oysa ekibin önceki modeli de dahil olmak üzere standart yöntem budur.
Belirtilen neden kalite değil, kararlılık: karşılaştırmalı yöntemle başlatılan kodlayıcı, ortak optimizasyon sırasında sık sıçramalarla sürekli daha yüksek gradyan normları gösterirken sıfırdan eğitileninki sabit kaldı. Görsel değerlendirmeler başa baş sonuçlandı.
Bu, bulguyu bir üstünlükten daha çarpıcı kılıyor. Sıfırdan eğitim daha iyi olsaydı, buna daha iyi bir yöntem derdiniz. Ancak aynı düzeye ulaştı; dolayısıyla iddia şu: bu ölçekte, alanın zorunlu saydığı bir adım aslında isteğe bağlı.
Bu modeller üzerinde ajan çalıştırıyorsanız bunun anlamı
Çok ajanlı bir masaüstü istemcisi geliştiriyoruz; bu yüzden baktığımız şey, liderlik tablosunun tepesinde ne olduğu değil, uzun soluklu bir çalıştırmanın karşılanabilir maliyette kalıp kalmadığı.
Önemli olan bağlam penceresinin boyutu değil, bir milyon token için çıkarım sunmanın maliyetidir. Katmanların dörtte üçü sabit boyutlu bir durum taşır; dolayısıyla konuşmayla birlikte büyüyen önbellek, aynı derinlikte tamamen dikkat mekanizmasına dayalı bir modeldekine kıyasla dörtte bir boyuttadır. Rapora göre K3, BrowseComp'ta görev başına yaklaşık $2 maliyetle %91.2'ye ulaşıyor; bu, en yakın kapalı model skorunun yaklaşık yarı maliyeti ve en yüksek çaba düzeyindeki Claude modellerinden bir büyüklük mertebesi daha düşük.
Yüzlerce araç çağrısı yapan bir ajan için bu oran, bir görevi denemeye değip değmeyeceğini belirler. Eskiden salt araştırma gibi görünen mimari çalışmalar, artık uzun bir çalıştırmanın ekonomik açıdan makul olup olmadığını doğrudan etkiliyor.
Buradan çıkardıklarımız
İkisi de başka alanlara aktarılabilir iki şey.
İlki, soruyu ele alış biçimi. Bilgi nerede akamıyor? sorusu, şu sorudan farklı çalışmalar doğurur: Daha ne kadar büyüyebiliriz? — üstelik parçalara ayrılabilir; üç mekanizmanın ayrı ayrı geliştirilip ölçülebilmesinin nedeni de bu.
İkincisi, sönüm sınırı. İfade gücü açısından neredeyse hiçbir bedeli olmayan bir kısıt, çekirdekten özel durumlara ayrılmış bir kod yolunu bütünüyle kaldırdı. Daha hızlı bir yol değil; artık yol yok. Bu ödünleşim, kullanıldığından çok daha sık karşımıza çıkıyor ve ancak matematiği ve donanımı aynı anda düşünenlere görünür oluyor.
Rapor ve ağırlıklar GitHub'da açık olarak erişilebilir. Mimari bölümü sekiz sayfa ve dikkatle okumaya değer.