
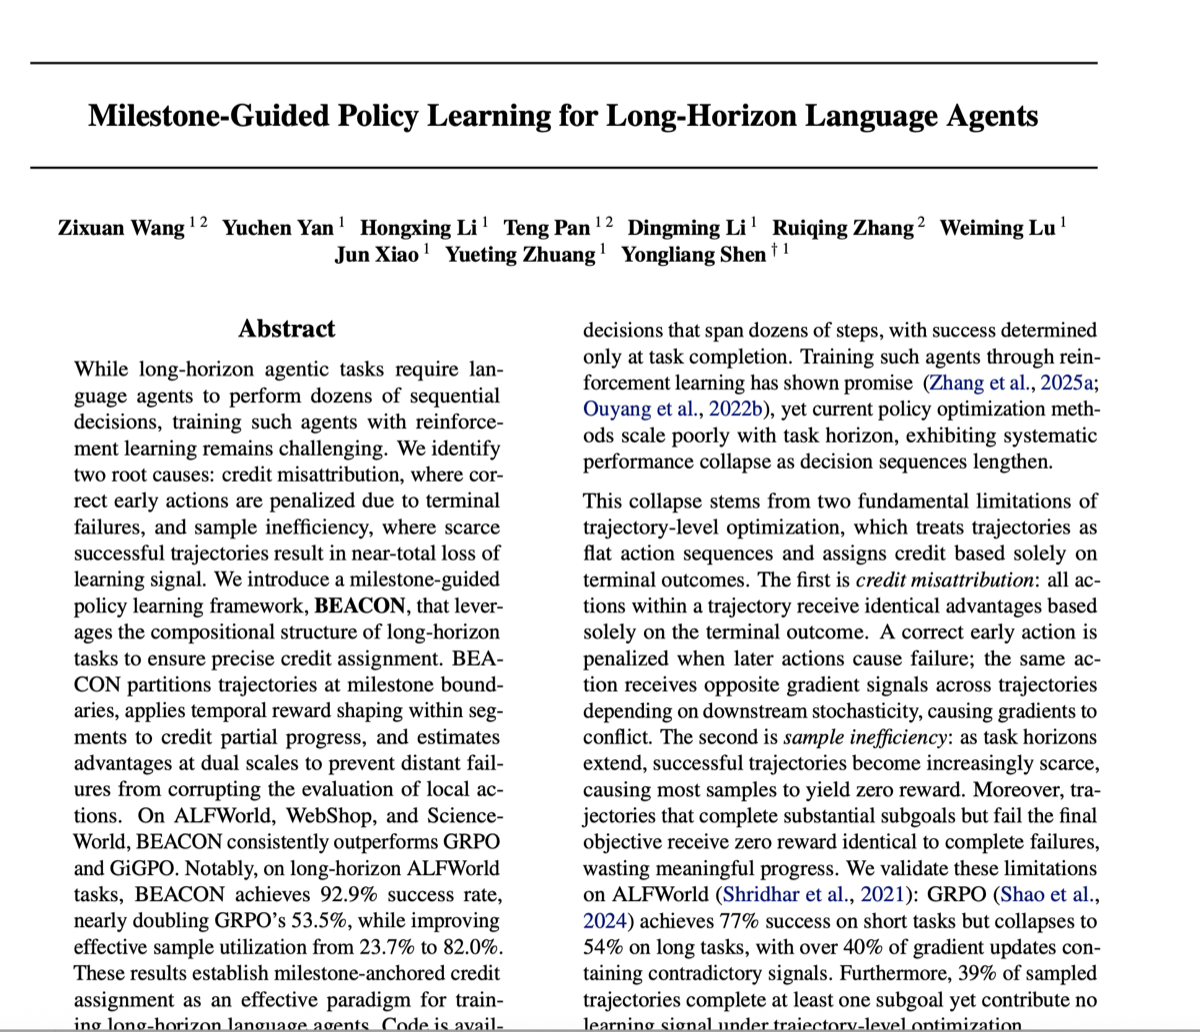
يفشل الوكلاء ذوو الأفق الطويل، الذين ينفّذون عشرات الخطوات قبل إنجاز أي شيء يمكن التحقق منه، بطريقة لا يفشل بها الوكلاء ذوو الأفق القصير. لا يتراجع الأداء تدريجيًا مع ازدياد طول المهام، بل ينهار فجأة.
ورقة بحثية حديثة من مختبر ZJU-REAL بجامعة تشجيانغ، تعلّم السياسات الموجّه بالمحطات المرحلية للوكلاء اللغويين ذوي الأفق الطويل، تشخّص هذا الانهيار بدقة تجعلها مفيدة حتى إن لم تدرّبوا سياسة بأنفسكم قط. تُسمّى الطريقة BEACON؛ وشيفرتها مفتوحة المصدر.
قرأناها بعناية لأن المشكلة التي تصفها هي نفسها التي نواجهها باستمرار على صعيد المنتج. فيما يلي حجة الورقة، وموضع اضطررنا فيه إلى تتبّع الرياضيات لفهم اتساق إحدى النتائج، وما نعتقد أنه قابل للنقل إلى معمارية الوكلاء.
نمطان من الفشل، كلاهما قابل للقياس
أكثر ما نقدّره أن الورقة لا تبدأ بطريقة، بل بتشريح للفشل: تدريب Qwen2.5-1.5B باستخدام GRPO على ALFWorld، مع تفكيك الانهيار إلى سببين مقاسَين كميًا .
سوء إسناد الفضل
يتعامل التعلّم المعزّز على مستوى المسار مع التنفيذ بوصفه تسلسلًا مسطّحًا من الإجراءات. تشترك جميع الإجراءات في درجة نهائية واحدة. لذا يحصل الإجراء الصحيح نفسه على تدرّج موجب في تنفيذ ناجح وآخر سالب في تنفيذ فاشل؛ ويعتمد كونه «صحيحًا» على ما حدث بعده.
يقيس المؤلفون ذلك بما يسمّونه نسبة الإجراءات المتناقضة: نسبة الإجراءات التي تتلقّى قيم أفضلية متعاكسة الإشارة عبر المسارات رغم تنفيذها في حالات متطابقة. وتبلغ ذروتها فوق 40%. وبعد أن تلغي تلك التدرّجات بعضها بعضًا، تهبط إشارة التعلّم الفعّالة إلى أقل من 20%.
ضعف كفاءة استخدام العينات
قسّموا المسارات إلى ثلاث فئات: نجاح كامل، ونجاح جزئي (إنجاز هدف فرعي واحد على الأقل مع بقاء المهمة فاشلة)، وفشل تام:
- تظل النجاحات الجزئية ثابتة عند 39–47% من العينات طوال التدريب.
- تبقى النجاحات الكاملة أقل من 27%.
في GRPO، يحصل كلّ من النجاح الجزئي والفشل التام على درجة صفر. لا تنتج أكثر من 73% من العينات أي إشارة تعلّم على الإطلاق.
تتفاقم المشكلتان مع امتداد الأفق: تنجح المهام الأطول بوتيرة أقل (فتزداد النجاحات الجزئية)، وتمنح العشوائية اللاحقة فرصًا أكثر لإفساد إسناد الفضل. وتحديدًا، على ALFWorld: 76.7% للمهام القصيرة و53.5% للطويلة.
الفكرة الأساسية: للمهام الطويلة بنية أصلًا
تنقسم المهام ذات الأفق الطويل إلى مراحل تحدّها محطات مرحلية — انتقالات حالة يمكن التحقق منها وتحدّد اكتمال الأهداف الفرعية. والتحسين المسطّح يتجاهل هذه البنية ببساطة.
يصوغ المؤلفون ذلك رسميًا في خاصية ماركوف للمحطات المرحلية: بمجرد الوصول إلى حالة محطة مرحلية، يعتمد التوزيع على بقية المسار أساسًا على الأهداف الفرعية المتبقية، لا على التاريخ الكامل لكيفية الوصول إليها.
بمجرد حصولكم على المفتاح، يعتمد ما يحدث تاليًا على ما تفعلونه به، لا على كيفية العثور عليه.
خاصية ماركوف التقريبية هذه هي ما يتيح فصل إسناد الفضل بين المقاطع.
الطريقة في ثلاث خطوات
1. التقسيم عند المحطات المرحلية
كاشف Φ يحدّد الخطوات الزمنية للمحطات المرحلية ويقسّم المسار إلى مقاطع. القرار التصميمي الذي نراه أقل تقديرًا مما يستحق: Φ لا يحتاج إلى نموذج متعلَّم ولا إلى توصيف بشري. يقرأ تغيّرات الحالة القابلة للرصد مباشرة من تغذية البيئة الراجعة: انتقالات حالة العناصر في ALFWorld، وانتقالات الصفحات في WebShop، وإشارات الأهداف الفرعية الصريحة في ScienceWorld.
لا نماذج إضافية، ولا عمليات توليد مسارات إضافية. هذه هي ميزة التكلفة بأكملها مقارنة بنماذج مكافأة العملية وتقدير القيمة بطريقة مونت كارلو.
2. تشكيل المكافأة زمنيًا داخل كل مقطع
r_t = R_ms * γ^(t_k − t)   if segment k ends in a completed milestone
    = 0                    otherwise
فقط المقاطع التي تنتهي بمحطة مرحلية تحصل على مكافأة، وداخل هذا المقطع تحصل الإجراءات الأقرب إلى المحطة على مكافأة أكبر. يصبح كل إجراء في مقطع مكتمل حاملًا لإشارة، فلا تعود النجاحات الجزئية تُهدر.
3. أفضلية على مقياسين
على مستوى المسار، يُستخدم تطبيع GRPO القياسي للمكافآت النهائية. أما مستوى المقطع فهو موطن الفكرة، وتحديدًا كيفية تعريف مجموعة المقارنة:
G_k = { i : K_i ≥ k }          # only trajectories that ALSO reached milestone k

A_seg(i,t) = r_t − (1/|G_k|) · Σ_{j∈G_k}  R_k(j) / |Seg_k(j)|
                               └── group-average PER-STEP return ──┘
الإجراءات في المقطع k تُقارَن فقط بالمسارات التي وصلت هي أيضًا إلى المحطة المرحلية k. ومن هذا يشتق المؤلفون خاصية عزل التباين: لا يمكن رياضيًا لنجاح المقاطع اللاحقة أو فشلها أن يلوّث إسناد الفضل للمقطع الحالي.
الأفضلية النهائية هي A_traj + λ · A_seg، وتُحسَّن باستخدام الهدف البديل المقصوص القياسي في PPO. المعلمات الفائقة γ=0.95, λ=1.0 ثابتة عبر جميع الاختبارات المرجعية، بلا ضبط خاص بكل مهمة.
النتائج
ALFWorld، Qwen2.5-1.5B:
| الطريقة | قصيرة | متوسط | طويلة | المتوسط |
|---|---|---|---|---|
| GRPO | 76.7 | 73.9 | 53.5 | 72.8 |
| GiGPO | 90.7 | 84.3 | 79.5 | 86.1 |
| BEACON | 96.8 | 87.0 | 92.9 | 91.4 |
معدل النجاح في البيئتين الأخريين:
| الطريقة | ScienceWorld | WebShop |
|---|---|---|
| GRPO | 21.1 | 56.8 |
| GiGPO | 25.8 | 65.0 |
| BEACON | 45.3 | 75.6 |
يتفوّق نموذج 1.5B على GPT-4o في ALFWorld (91.4 مقابل 48.0) وفي WebShop (75.6 مقابل 23.7)، ويتعادل معه في ScienceWorld (45.3 مقابل 45.4). وتحفّظ منصف: النماذج المغلقة تُوجَّه بمطالبات ReAct، ولا تُدرَّب. يرتفع استغلال العينات من 23.7% إلى 82.0%، ويصبح التقارب أسرع: نجاح بنسبة 60% بحلول التكرار 50، بينما يحتاج GRPO إلى التكرار 120.
النتيجة الأكثر إقناعًا هي أن المكاسب تتعاظم مع امتداد الأفق. في نموذج 7B، يرتفع التحسّن النسبي مقارنة بـGRPO من +13% للمهام القصيرة إلى +39% للمهام الطويلة؛ أما GiGPO فلا يرتفع إلا من +11% إلى +22%. والسبب مهم: يبني GiGPO مجموعات مقارنة على مستوى الخطوة انطلاقًا من الحالات المتكررة، ومع تحسّن السياسة وتنوّع مساراتها، يصبح تكرار الحالات أندر، فيتآكل مصدر إشارتها نفسه. أما مرتكزات المحطات المرحلية فلا تضعف مع ازدياد قوة السياسة.
طريقة تزداد فائدتها كلما ازدادت صعوبة المشكلة تقدّم حجة أقوى بكثير من مجرد متوسط درجات أعلى.
المقياس الذي يبدو متناقضًا
تعرّف الورقة نسبة تركّز إسناد الفضل — متوسط القيمة المطلقة للأفضلية في إجراءات المحطات المرحلية مقسومًا على نظيره في الإجراءات غير المرتبطة بمحطات مرحلية. والقيمة فوق 1 تعني تركّز إسناد الفضل عند المحطات المرحلية.
| الطريقة | CCR |
|---|---|
| GiGPO | 2.36 |
| GRPO | 1.37 |
| BEACON | 0.84 |
إذًا، الطريقة الأفضل أداءً هي التي تركّز إسناد الفضل على الخطوات الأساسية بالقدر الأقل — وهو ما يبدو تناقضًا مباشرًا مع «الإجراءات الأقرب إلى المحطة المرحلية تحصل على مكافأة أكبر». لكنه ليس كذلك. فالعبارتان تقيسان كميتين مختلفتين، يفصل بينهما تحويلان.
التحويل 1 — المكافأة المشكَّلة. داخل المقطع، تزداد المكافأة فعلًا باطراد باتجاه المحطة المرحلية. مع γ=0.95 ومقطع طوله 5، تحصل الإجراءات الخمسة على 0.8145, 0.857, 0.9025, 0.95, 1.0. لكن هذه مكافأة، وليست إسناد الفضل الذي يصل إلى التدرّج.
التحويل 2 — طرح خط الأساس للمجموعة. خط الأساس هو متوسط المجموعة من لكل خطوة العائد (عائد المقطع ÷ طول المقطع). ولمقطع طوله L، يكون العائد لكل خطوة (1−γ^L) / (L(1−γ)):
| طول المقطع | 3 | 5 | 8 | 10 |
|---|---|---|---|---|
| العائد لكل خطوة | 0.951 | 0.905 | 0.842 | 0.803 |
إذا استغرق مقطعكم 8 خطوات بينما بلغ متوسط المجموعة 5، فإن العائد لكل خطوة لديكم يقع دون خط الأساس، وتميل أفضلية بالكامل المقطع إلى السالب. لاحظوا معنى ذلك: عقوبة التخبّط لا تأتي من الاضمحلال نفسه، بل من تأثيره عبر خط الأساس لكل خطوة. الاضمحلال وحده لا يفعل سوى ترتيب الإجراءات داخل المقطع. وفي هذه المرحلة، تظل CCR داخل المقطع المكتمل أكبر من 1.
التحويل 3 — إضافة الحدّ على مستوى المسار. هنا تنخفض CCR إلى أقل من 1، بفعل تأثيرين غير متناظرين. أولًا، لا يدخل المقطع الأخير من المسار الفاشل في أي مجموعة مقارنة أصلًا: بما أن G_k = {i : K_i ≥ k} وفهرس المقطع الأخير غير المكتمل هو K_i + 1 > K_i، يُستبعد ذلك المسار. لا يتلقّى المقطع الأخير أي أفضلية على مستوى المقطع، بل الحدّ على مستوى المسار وحده بكامل قيمته المطلقة؛ وكل إجراء فيه غير مرتبط بمحطة مرحلية، مما يضخّم المقام. ثانيًا، في المسارات الفاشلة، يُلغي الحدّ السالب على مستوى المسار جزءًا من إسناد الفضل الموجب على مستوى المقطع لإجراءات المحطات المرحلية، فيدفع قيمتها المطلقة نحو الصفر.
يؤكّد الشكل 8 في الورقة نفسها ذلك. في مسار فاشل أكمل المحطتين المرحليتين S3 وS4:
| اذهب إلى المرحاض | ضع قطعة الصابون (S3✓) | اذهب إلى المنضدة (S4✓) | اذهب إلى المنضدة | اذهب إلى الحامل | |
|---|---|---|---|---|---|
| GRPO | −2.50 | −2.50 | −2.50 | −2.50 | −2.50 |
| BEACON | −0.92 | +0.51 | +0.32 | −2.20 | −2.20 |
القيمتان الأخيرتان متطابقتان — وهذه بصمة «المقطع الأخير لا يحصل إلا على الحدّ على مستوى المسار»، مما يتيح استنتاج A_traj ≈ −2.20. إجراءا المحطتين المرحليتين موجبان، لكن قيمتهما المطلقة لا تتجاوز ~0.5، لأن الحدّ السالب للمسار استهلك معظم إسناد الفضل على مستوى المقطع. تبلغ CCR لهذا المسار 0.23؛ وللمسار الناجح 2.95. أما القيمة الإجمالية 0.84 فهي مزيج الاثنين.
إذًا تقيس CCR تركّز القيمة المطلقة للتدرّج، لا مَن تلقّى المكافأة. انخفاض CCR ليس هدفًا تصميميًا، بل أثر جانبي للتوزيع الكثيف داخل المقاطع مع الجمع بين مقياسين. ولا يزال استنتاج المؤلفين صحيحًا وجيدًا: لا تصبّوا كل طاقة التدرّج في الخطوات الأساسية. فقيمة GiGPO البالغة 2.36 تعني أن الإجراءات التحضيرية البينية لا تتلقّى تقريبًا أي إشارة، وهي بالضبط ما يجعل الوصول إلى المحطة المرحلية ممكنًا.
أمر لا توضّحه الورقة صراحة
ثمة خلية غريبة في جدول استئصال المكوّنات. ضبط γ=1 — أي توزيع إسناد الفضل بالتساوي داخل كل مقطع — يحقّق 71.8، وهي نتيجة أسوأ من عدم التشكيل أصلًا (γ=0، 81.2)، بل أقل حتى من نتيجة GRPO البالغة 72.8. وتعزو الورقة ذلك إلى «تدرّجات مضلّلة».
تتبّعوا الرياضيات وستجدون إجابة أدق. مع γ=1 يحصل كل إجراء في مقطع مكتمل على المكافأة نفسها، لذا يكون لكل مقطع مكتمل، مهما كان طوله، عائد لكل خطوة يساوي تمامًا R_ms. ويساويه خط الأساس، ومن ثم:
A_seg(i,t) ≡ R_ms − R_ms = 0 for every actionالقناة على مستوى المقطع لا تضلّل، بل تنعدم تمامًا، وتُختزل الطريقة بالضبط إلى GRPO. قارنوها بالجدول: 71.8 مقابل 72.8 لـGRPO، بفارق نقطة واحدة، وهو ضجيج التفاوت بين مرات التشغيل.
وهذا يعيد تأطير الغرض من الاضمحلال. فهو لا يقتصر على التمييز بين الإجراءات داخل المقطع، بل هو شرط لازم لوجود الإشارة على مستوى المقطع أصلًا. ومن دونه، يلغي خط الأساس لكل خطوة الإشارة فورًا.
ثلاث تجارب تحسم الاعتراضات الواضحة
إنصافًا للمؤلفين، فقد استبقوا الأسئلة الثلاثة التي يطرحها القارئ المتشكّك:
- هل هذا مجرد استنساخ للسلوك؟ يصل الضبط الدقيق الخاضع للإشراف SFT على المسارات المرجعية المثالية إلى 43%؛ ويصل BEACON إلى 91.4%. تجد السياسة استراتيجيات تنفيذ أفضل من المرجع المثالي، لذا فهي لا تقلّده.
- هل تأتي المكاسب من مجرد التقسيم إلى مقاطع؟ يحقّق التقسيم العشوائي 74.2%، أعلى من GRPO بمقدار 1.4 نقطة فقط. وتحقّق المحطات المرحلية الحقيقية 91.4%، بفارق 17.2 نقطة. تأتي الفائدة من البنية المتأصّلة في المهمة.
- ماذا لو كان الكاشف غير موثوق؟ حتى إسقاط 50% من المحطات المرحلية عشوائيًا يحقّق 82.8%، أعلى من GRPO بعشر نقاط. ويتراجع الأداء تدريجيًا.
ما يمكن نقله إلى تصميم الوكلاء
BEACON طريقة تدريب، ومعظم المنتجات، ومنها منتجنا، تنسّق النماذج بدلًا من تدريبها. المعادلات لا تنتقل، لكن التشخيص ينتقل، وينطبق على المعمارية بصورة مباشرة على نحو مفاجئ.
يجب أن يكون التقدّم الجزئي حالة أساسية محفوظة بشكل دائم. أبرز أرقام الورقة أن 39–47% من عمليات التنفيذ تنجز أهدافًا فرعية حقيقية، ثم تُمنح الدرجة نفسها التي تُمنح لعمليات لم تنجز شيئًا. جلسة وكيل طويلة تُنجز ثلاثة أهداف فرعية ثم تتعطّل تواجه المشكلة نفسها: إذا لم يسجّل النظام سوى «قيد التنفيذ» و«مكتمل»، يُهدر ذلك التقدّم وتبدأ المحاولة الجديدة من الصفر. تمنحكم المحطات المرحلية المفردات اللازمة لتسجيله.
ينبغي أن تُستمد المحطات المرحلية من الآثار القابلة للرصد، لا من التقارير الذاتية. سبب انخفاض تكلفة Φ هو أنه يقرأ انتقالات حالة قابلة للتحقق بدلًا من سؤال السياسة عمّا إذا كانت قد أحرزت تقدّمًا. تتوافر لبيئات تشغيل الوكلاء الميزة نفسها، لكنها تتجاهلها غالبًا: ملف كُتب، أو اختبار انتهى برمز خروج صفر، أو استدعاء موصّل أعاد نجاحًا، أو مستند أُودع في قاعدة المعرفة. تلك حقائق مرجعية. أما تأكيد نموذج أن «الخطوة الأولى مكتملة» فليس كذلك.
حدود المحطات المرحلية نقاط مبرّرة لضغط السياق واستئناف العمل. تقول خاصية ماركوف للمحطات المرحلية إن ما سبق يصبح أقل أهمية بكثير بمجرد بلوغ محطة مرحلية. وهذا مبرّر لضغط السياق أفضل بكثير من «بلغنا حدًا من الرموز»، والحدّ نفسه هو نقطة التحقق الطبيعية لاستئناف العمل بعد الفشل.
تحقّقوا على مقياسين، لا مقياس واحد. هذه تجربة استئصال المكوّنات التي نؤكّد عليها لكل من يبني سير عمل للوكلاء: إزالة الإشارة على مستوى المسار تخفض نتيجة ALFWorld من 91.4% إلى 23.4%. مع التغذية الراجعة على مستوى المقطع وحده، تعزّز السياسة سلوكًا يبلغ المحطات المرحلية الوسيطة بينما ينحرف عن الهدف الحقيقي: كل مهمة فرعية تُنفَّذ بإتقان، لكن المُخرَج النهائي خاطئ. قبول المهمة الفرعية وقبول المُخرَج النهائي لا يحلّ أحدهما محل الآخر. ومن اللافت أن الوزن اللازم يختلف باختلاف المهمة: يظل WebShop قادرًا على تحقيق 67.9% من دون مستوى المسار لأن محطاته المرحلية تتوافق وثيقًا مع النجاح النهائي؛ بينما ينهار ALFWorld.
القيود، بصراحة
القيد الأكبر هو ما إذا كان Φ متاحًا أصلًا. تستمد الاختبارات المرجعية الثلاثة محطاتها المرحلية من قواعد: مطابقة الأنماط في استجابات البيئة، وانتقالات الصفحات، وإشارات الأهداف الفرعية الصريحة. أما البيئات المفتوحة، مثل أتمتة المتصفح وإعادة هيكلة قواعد الشيفرة والبحث المعمّق، فلا تملك انتقالات جاهزة قابلة للتحقق كهذه، ويذكر المؤلفون اكتشاف المحطات المرحلية آليًا بوصفه مشكلة مفتوحة. لذا يبدو هذا نموذجًا منهجيًا جرى التحقق منه في بيئات منظّمة، لا وصفة هندسية تُنقل كما هي.
درجة تفصيل المحطات المرحلية حساسة أيضًا: إذا كانت متباعدة أكثر من اللازم، تتراجع الطريقة نحو GRPO؛ وإذا كانت كثيفة أكثر من اللازم، تصبح أفضليات المقاطع مشوّشة. وخاصية ماركوف تقريبية فحسب، ويعتمد عليها عزل التباين. تتوقف التجارب عند 7B مع فضاءات إجراءات نصية متقطعة؛ ولم تُختبر بيئات التحكّم المستمر أو البيئات متعددة الوكلاء.
مع ذلك، يصعب علينا الاعتراض على الادّعاء الأساسي: للمهام الطويلة بنية تركيبية قابلة للاستغلال، والتعامل معها بوصفها عنصرًا أساسيًا يتفوّق على الأمل في أن يتتبّعها النموذج داخل السياق. نطبّق هذا التفكير على دعم المهام ذات الأفق الطويل في Orkas، وسنشارك المزيد من التصميم مع طرحه.