
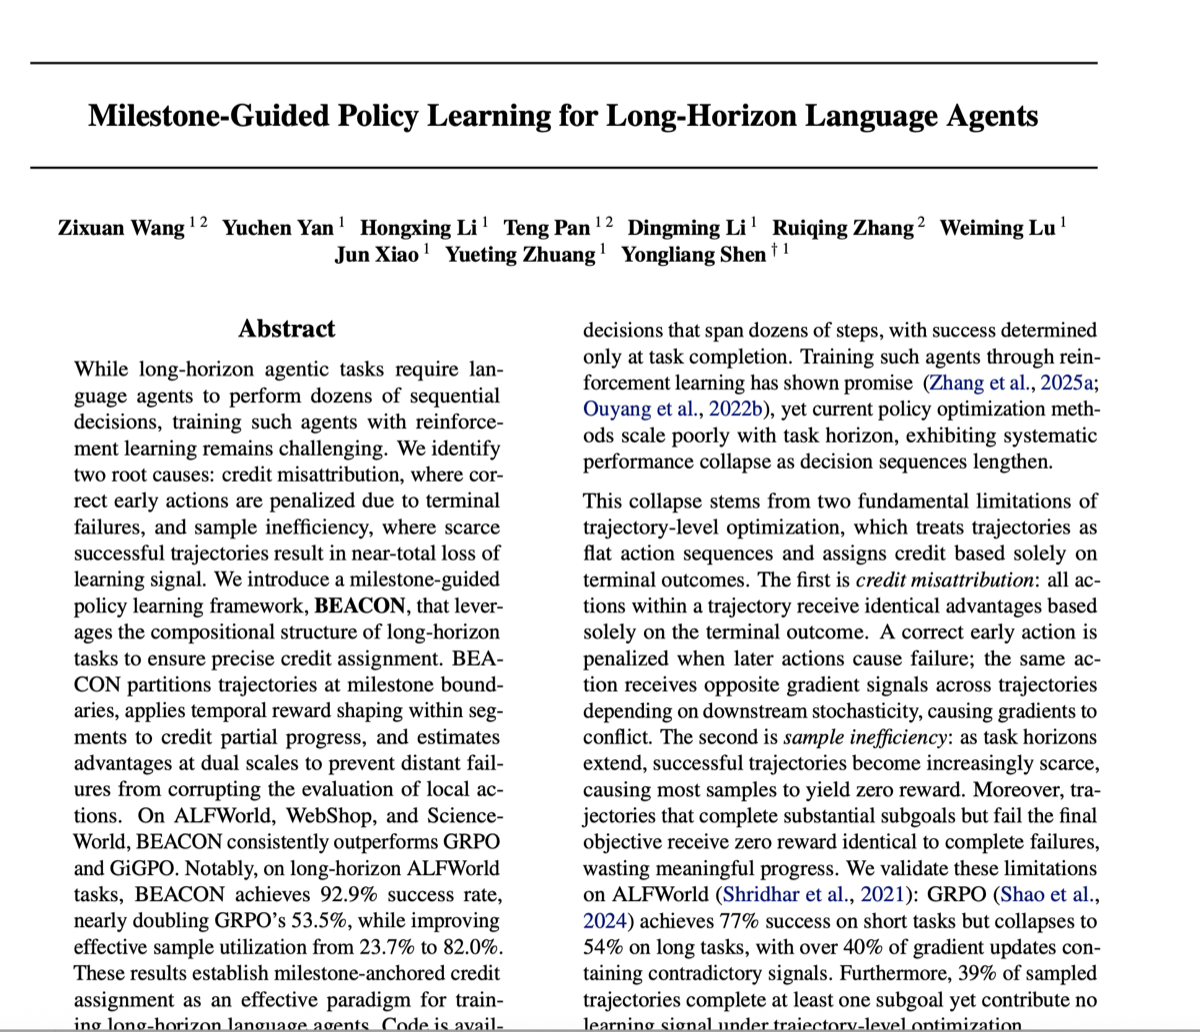
Les Agents de longue durée — ceux qui exécutent des dizaines d’étapes avant qu’un résultat soit vérifiable — échouent d’une manière inconnue des Agents de courte durée. Leurs performances ne diminuent pas doucement lorsque les tâches s’allongent. Elles s’effondrent.
Un article récent du laboratoire ZJU-REAL de l’université du Zhejiang, Apprentissage de politiques guidé par jalons pour les Agents de langage à long horizon, diagnostique cet effondrement assez précisément pour être utile même sans entraîner vous-même une politique. La méthode s’appelle BEACON ; son code est open source.
Nous l’avons lu attentivement, car le problème décrit est celui que nous rencontrons sans cesse côté produit. Voici l’argumentation de l’article, un point pour lequel nous avons dû reprendre les calculs afin de comprendre un résultat, et ce qui nous semble transposable à l’architecture des Agents.
Deux modes d’échec, tous deux mesurables
Nous apprécions surtout que l’article ne commence pas par une méthode, mais par une autopsie : Qwen2.5-1.5B entraîné avec GRPO sur ALFWorld, avec un effondrement décomposé en deux causes quantifiées.
Mauvaise attribution du mérite
L’apprentissage par renforcement au niveau de la trajectoire traite une exécution comme une séquence d’actions plate. Toutes les actions partagent un score terminal. Ainsi, la même action correcte reçoit un gradient positif dans une exécution réussie et négatif dans une exécution échouée : son caractère « juste » dépend de ce qui se passe ensuite.
Les auteurs le quantifient par le ratio d’actions contradictoires : la proportion d’actions recevant des avantages de signes opposés entre trajectoires alors qu’elles sont exécutées dans des états identiques. Il dépasse 40% au maximum. Après annulation de ces gradients, le signal d’apprentissage effectif tombe sous 20%.
Faible efficacité des échantillons
Répartissons les trajectoires en trois catégories : réussite complète, réussite partielle — au moins un sous-objectif atteint, mais échec de la tâche — et échec total :
- Les réussites partielles restent à 39–47% des échantillons tout au long de l’entraînement.
- Les réussites complètes restent sous 27%.
Avec GRPO, une réussite partielle et un échec total valent tous deux zéro. Plus de 73% des échantillons ne produisent aucun signal d’apprentissage.
Les deux problèmes s’amplifient avec la durée : les tâches longues réussissent moins souvent, donc produisent davantage de réussites partielles, et offrent plus d’occasions à l’aléa ultérieur de fausser l’attribution du mérite. Concrètement, sur ALFWorld : 76.7% sur les tâches courtes, 53.5% sur les longues.
L’idée clé : les tâches longues ont déjà une structure
Les tâches de longue durée se décomposent en phases délimitées par des jalons : des transitions d’état vérifiables qui marquent l’achèvement de sous-objectifs. L’optimisation à plat ignore simplement cette structure.
Les auteurs la formalisent comme la propriété de Markov des jalons : une fois un état-jalon atteint, la distribution de la suite de la trajectoire dépend surtout des sous-objectifs restants, plutôt que de l’historique complet du chemin parcouru.
Une fois la clé obtenue, la suite dépend de ce que vous en faites, pas de la façon dont vous l’avez trouvée.
Cette propriété de Markov approximative permet de découpler l’attribution du mérite entre segments.
La méthode en trois étapes
1. Partitionner aux jalons
Un détecteur Φ repère les instants correspondant à des jalons et découpe la trajectoire en segments. Un choix de conception nous semble sous-estimé : Φ n’exige aucun modèle appris ni aucune annotation humaine. Il lit directement les changements d’état observables dans les retours de l’environnement : transitions d’état des objets dans ALFWorld, transitions de pages dans WebShop, signaux explicites de sous-objectifs dans ScienceWorld.
Aucun modèle supplémentaire, aucune trajectoire supplémentaire. C’est tout l’avantage de coût par rapport aux modèles de récompense de processus et à l’estimation de valeur par Monte-Carlo.
2. Façonnage temporel de la récompense dans chaque segment
r_t = R_ms * γ^(t_k − t)   if segment k ends in a completed milestone
    = 0                    otherwise
Seuls les segments qui se terminent par un jalon reçoivent une récompense ; à l’intérieur, les actions les plus proches du jalon en reçoivent davantage. Chaque action d’un segment achevé porte désormais un signal : les réussites partielles ne sont plus jetées.
3. Avantage à deux échelles
Le niveau trajectoire utilise la normalisation GRPO classique des récompenses terminales. L’idée se situe au niveau segment, dans la définition du groupe de comparaison :
G_k = { i : K_i ≥ k }          # only trajectories that ALSO reached milestone k

A_seg(i,t) = r_t − (1/|G_k|) · Σ_{j∈G_k}  R_k(j) / |Seg_k(j)|
                               └── group-average PER-STEP return ──┘
Les actions du segment k sont comparées uniquement aux trajectoires qui ont elles aussi atteint le jalon k. Les auteurs en déduisent une propriété d’isolation de la variance : la réussite ou l’échec des segments ultérieurs ne peut mathématiquement contaminer le mérite du segment courant.
L’avantage final est A_traj + λ · A_seg, optimisé avec l’objectif de substitution écrêté standard de PPO. Les hyperparamètres γ=0.95, λ=1.0 sont fixes pour tous les benchmarks, sans réglage par tâche.
Résultats
ALFWorld, Qwen2.5-1.5B :
| Méthode | Court | Moyen | Long | Moyenne |
|---|---|---|---|---|
| GRPO | 76.7 | 73.9 | 53.5 | 72.8 |
| GiGPO | 90.7 | 84.3 | 79.5 | 86.1 |
| BEACON | 96.8 | 87.0 | 92.9 | 91.4 |
Taux de réussite dans les deux autres environnements :
| Méthode | ScienceWorld | WebShop |
|---|---|---|
| GRPO | 21.1 | 56.8 |
| GiGPO | 25.8 | 65.0 |
| BEACON | 45.3 | 75.6 |
Le modèle 1.5B dépasse GPT-4o sur ALFWorld (91.4 contre 48.0) et WebShop (75.6 contre 23.7), et fait jeu égal sur ScienceWorld (45.3 contre 45.4). Réserve nécessaire : les modèles fermés sont sollicités avec ReAct, sans entraînement. L’utilisation des échantillons passe de 23.7% à 82.0%, et la convergence est plus rapide : 60% de réussite à l’itération 50, contre l’itération 120 pour GRPO.
Le résultat le plus convaincant est que les gains augmentent avec la durée. Sur 7B, l’amélioration relative par rapport à GRPO passe de +13% pour les tâches courtes à +39% pour les longues ; GiGPO ne passe que de +11% à +22%. La raison compte : GiGPO forme des groupes de comparaison par étape à partir d’états répétés. À mesure que la politique s’améliore et que ses trajectoires se diversifient, les états se répètent moins : sa propre source de signal s’érode. Les repères des jalons ne se dégradent pas quand la politique se renforce.
Une méthode dont le bénéfice augmente avec la difficulté constitue un résultat bien plus fort qu’un meilleur score moyen.
L’indicateur qui semble contradictoire
L’article définit un ratio de concentration du mérite : l’amplitude moyenne de l’avantage des actions-jalons divisée par celle des autres actions. Au-dessus de 1, le mérite se concentre sur les jalons.
| Méthode | CCR |
|---|---|
| GiGPO | 2.36 |
| GRPO | 1.37 |
| BEACON | 0.84 |
La méthode la plus performante est donc celle qui concentre le moins le mérite sur les étapes clés, ce qui semble contredire directement « les actions proches du jalon reçoivent davantage de récompense ». Il n’y a pas de contradiction : les deux affirmations mesurent des quantités différentes, séparées par deux transformations.
Transformation 1 — récompense façonnée. Dans un segment, la récompense augmente bien de façon monotone vers le jalon. Avec γ=0.95 et un segment de longueur 5, les cinq actions reçoivent 0.8145, 0.857, 0.9025, 0.95, 1.0. Mais il s’agit de la récompense, pas du mérite qui atteint le gradient.
Transformation 2 — soustraire la référence du groupe. La référence est le rendement moyen du groupe par étape : rendement du segment ÷ longueur du segment. Pour un segment de longueur L, le rendement par étape est (1−γ^L) / (L(1−γ)):
| Longueur du segment | 3 | 5 | 8 | 10 |
|---|---|---|---|---|
| Rendement par étape | 0.951 | 0.905 | 0.842 | 0.803 |
Si votre segment prend 8 étapes alors que le groupe en compte 5 en moyenne, votre rendement par étape est inférieur à la référence et l’avantage du segment entier est tiré vers le négatif. Cela signifie que la pénalité d’errance ne vient pas de la décroissance seule, mais de son effet à travers la référence par étape. La décroissance seule ordonne uniquement les actions à l’intérieur d’un segment. À ce stade, le CCR d’un segment achevé reste supérieur à 1.
Transformation 3 — ajouter le terme au niveau trajectoire. Le CCR passe alors sous 1 par deux effets asymétriques. D’abord, le segment final d’une trajectoire échouée n’entre dans aucun groupe de comparaison : puisque G_k = {i : K_i ≥ k} et que la fin incomplète a pour indice K_i + 1 > K_i, cette trajectoire est exclue. Cette fin ne reçoit aucun avantage au niveau segment, seulement le terme au niveau trajectoire dans toute son amplitude. Toutes ses actions sont sans jalon, ce qui gonfle le dénominateur. Ensuite, dans les trajectoires échouées, le terme négatif de trajectoire annule une partie du mérite positif des actions-jalons au niveau segment, rapprochant leur amplitude de zéro.
La figure 8 de l’article le confirme. Pour une trajectoire échouée ayant atteint les jalons S3 et S4 :
| aller aux toilettes | poser le savon (S3✓) | aller au comptoir (S4✓) | aller au comptoir | aller au support | |
|---|---|---|---|---|---|
| GRPO | −2.50 | −2.50 | −2.50 | −2.50 | −2.50 |
| BEACON | −0.92 | +0.51 | +0.32 | −2.20 | −2.20 |
Les deux dernières valeurs sont identiques : c’est la signature d’un « segment final ne recevant que le terme de trajectoire », qui permet de lire directement A_traj ≈ −2.20. Les deux actions-jalons sont positives, mais leur amplitude n’est que de ~0.5, car le terme négatif de trajectoire a absorbé l’essentiel du mérite du segment. Le CCR de cette trajectoire vaut 0.23 ; celui d’une trajectoire réussie vaut 2.95. Le 0.84 global est leur mélange.
Le CCR mesure donc la concentration de l’amplitude du gradient, pas qui a été récompensé. Un CCR faible n’est pas un objectif de conception : c’est un effet secondaire de l’allocation dense dans les segments et de la superposition à deux échelles. La conclusion des auteurs reste valable : ne concentrez pas toute l’énergie du gradient sur les étapes clés. Le 2.36 de GiGPO signifie que les actions préparatoires intermédiaires reçoivent presque aucun signal, alors qu’elles rendent précisément les jalons accessibles.
Un point que l’article n’explicite pas
Une cellule du tableau d’ablation surprend. Régler γ=1 — un mérite uniforme dans chaque segment — donne 71.8, moins bien que l’absence totale de façonnage (γ=0, 81.2), et même moins que les 72.8 de GRPO. L’article l’attribue à des « gradients trompeurs ».
En reprenant les calculs, la réponse est plus précise. Avec γ=1 chaque action d’un segment achevé reçoit la même récompense : chaque segment achevé, quelle que soit sa longueur, a donc un rendement par étape exactement égal à R_ms. La référence lui est égale, et :
A_seg(i,t) ≡ R_ms − R_ms = 0 for every actionLe canal du niveau segment ne trompe pas. Il s’annule identiquement, et la méthode se réduit exactement à GRPO. Le tableau le confirme : 71.8 contre 72.8 pour GRPO, soit un point d’écart, compatible avec le bruit entre exécutions.
Cela redéfinit le rôle de la décroissance. Elle ne sert pas seulement à distinguer les actions dans un segment ; elle est une condition nécessaire à l’existence même du signal au niveau segment. Sans elle, la référence par étape annule immédiatement le signal.
Trois expériences qui répondent aux objections évidentes
Rendons aux auteurs ce qui leur revient : ils anticipent les trois questions d’un lecteur sceptique :
- Est-ce simplement du clonage comportemental ? Le SFT sur des trajectoires d’oracle atteint 43% ; BEACON atteint 91.4%. La politique trouve des stratégies d’exécution meilleures que l’oracle : elle ne l’imite donc pas.
- Les gains viennent-ils seulement du découpage ? Le partitionnement aléatoire obtient 74.2%, seulement 1.4 point de plus que GRPO. Les vrais jalons atteignent 91.4%, soit 17.2 points d’écart. Le bénéfice vient de la structure intrinsèque de la tâche.
- Et si le détecteur est peu fiable ? Supprimer aléatoirement 50% des jalons donne encore 82.8%, dix points au-dessus de GRPO. La dégradation est progressive.
Ce qui se transpose à la conception d’Agents
BEACON est une méthode d’entraînement, alors que la plupart des produits, le nôtre compris, orchestrent des modèles plutôt qu’ils ne les entraînent. Les formules ne se transposent pas. Le diagnostic, si, et il correspond étonnamment directement à l’architecture.
Le progrès partiel doit être un état explicite et persistant. Le chiffre le plus frappant de l’article est que 39–47% des exécutions accomplissent de vrais sous-objectifs, puis reçoivent le même score que celles qui n’ont rien fait. Une longue session d’Agent qui atteint trois sous-objectifs puis stagne souffre du même problème : si le système ne consigne que « en cours » et « terminé », ce progrès est perdu et la nouvelle tentative repart de zéro. Les jalons donnent le vocabulaire pour le conserver.
Les jalons doivent provenir d’effets observables, pas d’autodéclarations. Si Φ est peu coûteux, c’est parce qu’il lit des transitions d’état vérifiables au lieu de demander à la politique si elle a progressé. Les environnements d’exécution d’Agents disposent du même atout et l’ignorent souvent : un fichier écrit, un test sorti avec le code zéro, un appel de connecteur réussi, un document enregistré dans la base de connaissances. Ce sont des faits établis. L’affirmation d’un modèle « première étape terminée » n’en est pas un.
Les frontières des jalons sont des points fondés pour la compaction et la reprise. La propriété de Markov des jalons indique qu’une fois un jalon atteint, ce qui précède importe beaucoup moins. C’est une justification bien meilleure pour compacter le contexte que « nous avons atteint un seuil de tokens », et cette frontière est aussi le point de reprise naturel après un échec.
Vérifier à deux échelles, pas une. Voici l’ablation à souligner pour quiconque construit des processus d’Agents : retirer le signal au niveau trajectoire fait passer ALFWorld de 91.4% à 23.4%. Avec le seul retour au niveau segment, la politique renforce des comportements qui atteignent les jalons intermédiaires tout en dérivant de l’objectif réel : chaque sous-tâche est magnifiquement exécutée, mais le livrable est faux. La validation des sous-tâches ne remplace pas celle du livrable final. Le poids nécessaire varie selon la tâche : WebShop atteint encore 67.9% sans niveau trajectoire, car ses jalons sont étroitement liés à la réussite finale ; ALFWorld s’effondre.
Les limites, en toute honnêteté
La principale contrainte est de savoir si Φ peut seulement être obtenu. Les trois benchmarks déduisent leurs jalons de règles : reconnaissance de motifs dans les réponses de l’environnement, transitions de pages, signaux explicites de sous-objectifs. Les situations ouvertes comme l’automatisation du navigateur, la refonte d’une base de code ou la recherche approfondie n’offrent pas ces transitions vérifiables toutes faites, et les auteurs citent la découverte automatique des jalons comme problème ouvert. Il faut y voir un paradigme validé en environnement structuré, pas une recette technique à reprendre telle quelle.
La granularité des jalons est aussi sensible : trop rares, ils ramènent la méthode vers GRPO ; trop nombreux, ils rendent les avantages de segment bruités. La propriété de Markov est approximative, et l’isolation de la variance en dépend. Les expériences s’arrêtent à 7B avec des espaces d’actions textuelles discrets ; le contrôle continu et les contextes multi-Agents ne sont pas testés.
Il reste difficile de contester l’affirmation centrale : les tâches longues ont une structure compositionnelle exploitable ; la traiter comme un objet explicite vaut mieux que d’espérer qu’un modèle la suive dans son contexte. Nous appliquons cette idée à la prise en charge des tâches longues dans Orkas et partagerons davantage de détails de conception à mesure de son intégration.