
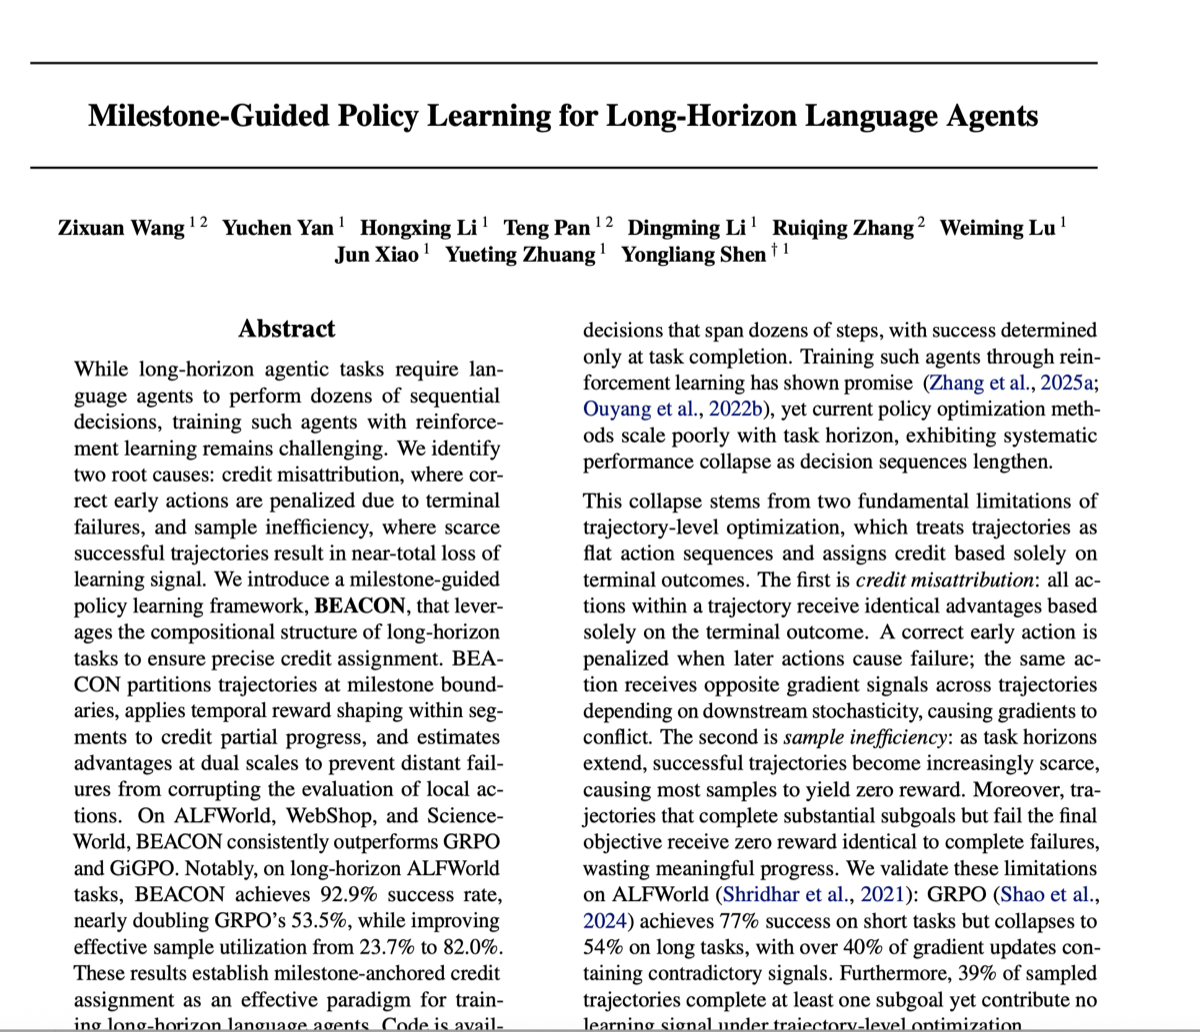
เอเจนต์ที่ทำงานระยะยาว ซึ่งทำงานหลายสิบขั้นตอนก่อนจะมีอะไรเสร็จสมบูรณ์จนตรวจสอบได้ ล้มเหลวในแบบที่เอเจนต์ระยะสั้นไม่เป็น ประสิทธิภาพไม่ได้ค่อย ๆ ลดลงเมื่องานยาวขึ้น แต่ร่วงฮวบ
งานวิจัยล่าสุดจากห้องแล็บ ZJU-REAL ของมหาวิทยาลัยเจ้อเจียง เรื่อง การเรียนรู้นโยบายที่ใช้หมุดหมายชี้นำสำหรับเอเจนต์ภาษาที่ทำงานระยะยาว วินิจฉัยการร่วงฮวบนี้ได้แม่นยำพอที่จะเป็นประโยชน์ แม้คุณจะไม่เคยฝึกนโยบายเองก็ตาม วิธีนี้ชื่อ BEACON และโค้ดเป็น โอเพนซอร์ส.
เราอ่านงานนี้อย่างละเอียด เพราะปัญหาที่งานอธิบายเป็นปัญหาเดียวกับที่เราพบซ้ำ ๆ ในฝั่งผลิตภัณฑ์ ต่อไปนี้คือข้อเสนอของงานวิจัย จุดหนึ่งที่เราต้องไล่คำนวณเพื่ออธิบายผลให้สอดคล้องกัน และสิ่งที่เราคิดว่านำไปใช้กับสถาปัตยกรรมเอเจนต์ได้
ความล้มเหลวสองรูปแบบที่วัดได้ทั้งคู่
สิ่งที่เราชื่นชมที่สุดคือ งานวิจัยไม่ได้เริ่มด้วยวิธีการ แต่เริ่มด้วยการชันสูตรปัญหา: Qwen2.5-1.5B ที่ฝึกด้วย GRPO บน ALFWorld โดยแยกการล่มเหลวออกเป็นสองสาเหตุที่ วัดเป็นตัวเลขได้ .
การจัดสรรเครดิตผิด
RL ระดับเส้นทางการทำงานมองการทำงานหนึ่งรอบเป็นลำดับการกระทำแบบแบน ทุกการกระทำใช้คะแนนปลายทางร่วมกัน ดังนั้นการกระทำที่ถูกต้องแบบเดียวกันจึงได้รับเกรเดียนต์บวกในรอบที่สำเร็จ และเกรเดียนต์ลบในรอบที่ล้มเหลว การกระทำนั้นจะถือว่า “ถูก” หรือไม่จึงขึ้นอยู่กับสิ่งที่เกิดขึ้น ภายหลัง.
ผู้เขียนวัดสิ่งนี้ด้วย อัตราส่วนการกระทำที่ขัดแย้งกัน: สัดส่วนของการกระทำที่ได้รับค่าแอดแวนเทจเครื่องหมายตรงข้ามกันในคนละเส้นทาง ทั้งที่กระทำในสถานะเดียวกัน ค่านี้พุ่งสูงสุด เกิน 40% เมื่อเกรเดียนต์เหล่านั้นหักล้างกัน สัญญาณการเรียนรู้ที่มีผลจริงก็ลดลง ต่ำกว่า 20%.
การใช้ตัวอย่างอย่างไม่มีประสิทธิภาพ
แบ่งเส้นทางการทำงานเป็นสามกลุ่ม ได้แก่ สำเร็จทั้งหมด สำเร็จบางส่วน (บรรลุเป้าหมายย่อยอย่างน้อยหนึ่งข้อ แต่ภารกิจยังล้มเหลว) และล้มเหลวทั้งหมด:
- รอบที่สำเร็จบางส่วนมีสัดส่วนคงที่อยู่ที่ 39–47% ของตัวอย่างตลอดการฝึก
- รอบที่สำเร็จทั้งหมดอยู่ ต่ำกว่า 27%.
ภายใต้ GRPO ทั้งรอบที่สำเร็จบางส่วนและรอบที่ล้มเหลวทั้งหมดได้คะแนนศูนย์ ตัวอย่างกว่า 73% ไม่สร้างสัญญาณการเรียนรู้เลย
ปัญหาทั้งสองทวีความรุนแรงเมื่องานยาวขึ้น งานที่ยาวขึ้นสำเร็จน้อยลง (มีรอบที่สำเร็จบางส่วนมากขึ้น) และเปิดโอกาสให้ความสุ่มในช่วงหลังบิดเบือนเครดิตมากขึ้น ตัวเลขบน ALFWorld คือ 76.7% สำหรับงานสั้น และ 53.5% สำหรับงานยาว
ข้อค้นพบสำคัญ: งานระยะยาวมีโครงสร้างอยู่แล้ว
งานระยะยาวแบ่งเป็นช่วงที่มีขอบเขตเป็น หมุดหมาย — การเปลี่ยนสถานะที่ตรวจสอบได้ ซึ่งบ่งบอกว่าบรรลุเป้าหมายย่อยแล้ว การหาค่าเหมาะที่สุดแบบแบนทิ้งโครงสร้างนี้ไปเฉย ๆ
ผู้เขียนนิยามสิ่งนี้อย่างเป็นทางการว่า สมบัติมาร์คอฟของหมุดหมาย: เมื่อไปถึงสถานะหมุดหมายแล้ว การแจกแจงของเส้นทางที่เหลือขึ้นอยู่กับเป้าหมายย่อยที่ยังเหลือเป็นหลัก ไม่ใช่ประวัติทั้งหมดว่ามาถึงจุดนั้นอย่างไร
เมื่อคุณได้กุญแจมาแล้ว สิ่งที่จะเกิดขึ้นต่อไปขึ้นอยู่กับว่าคุณใช้มันทำอะไร ไม่ใช่ว่าคุณหามันเจอได้อย่างไร
สมบัติมาร์คอฟโดยประมาณนี้ทำให้แยกการจัดสรรเครดิตระหว่างช่วงออกจากกันได้
วิธีการในสามขั้นตอน
1. แบ่งช่วงที่หมุดหมาย
ตัวตรวจจับ Φ ระบุขั้นเวลาที่เป็นหมุดหมายและตัดเส้นทางเป็นช่วง ๆ การตัดสินใจในการออกแบบที่เราคิดว่าถูกประเมินค่าต่ำไปคือ: Φ ไม่ต้องใช้โมเดลที่ผ่านการเรียนรู้หรือการติดป้ายกำกับโดยมนุษย์ มันอ่านการเปลี่ยนสถานะที่สังเกตได้จากผลตอบกลับของสภาพแวดล้อมโดยตรง ได้แก่ การเปลี่ยนสถานะวัตถุใน ALFWorld การเปลี่ยนหน้าใน WebShop และสัญญาณเป้าหมายย่อยที่ชัดเจนใน ScienceWorld
ไม่เพิ่มโมเดล ไม่เพิ่มการทดลองรัน นี่คือข้อได้เปรียบด้านต้นทุนทั้งหมดเมื่อเทียบกับโมเดลรางวัลตามกระบวนการและการประมาณค่าแบบมอนติคาร์โล
2. ปรับรูปแบบรางวัลตามเวลาภายในแต่ละช่วง
r_t = R_ms * γ^(t_k − t)   if segment k ends in a completed milestone
    = 0                    otherwise
มีเพียงช่วงที่ สิ้นสุด ที่หมุดหมายเท่านั้นที่ได้รับรางวัล และภายในช่วงนั้น การกระทำที่ใกล้หมุดหมายกว่าจะได้รางวัลมากกว่า ตอนนี้ทุกการกระทำในช่วงที่เสร็จสมบูรณ์มีสัญญาณแล้ว จึงไม่ทิ้งความสำเร็จบางส่วนอีกต่อไป
3. ค่าแอดแวนเทจสองระดับ
ระดับเส้นทางใช้การปรับมาตรฐานแบบ GRPO ตามปกติกับรางวัลปลายทาง ส่วนระดับช่วงคือจุดที่แนวคิดนี้อยู่ โดยเฉพาะวิธีนิยามกลุ่มเปรียบเทียบ:
G_k = { i : K_i ≥ k }          # only trajectories that ALSO reached milestone k

A_seg(i,t) = r_t − (1/|G_k|) · Σ_{j∈G_k}  R_k(j) / |Seg_k(j)|
                               └── group-average PER-STEP return ──┘
การกระทำในช่วง k จะถูกเปรียบเทียบ เฉพาะกับเส้นทางที่ไปถึงหมุดหมายเดียวกันด้วย k จากจุดนี้ ผู้เขียนอนุมานสมบัติการแยกความแปรปรวนได้ว่า ในทางคณิตศาสตร์ ความสำเร็จหรือความล้มเหลวของช่วงถัดไปไม่สามารถปนเปื้อนเครดิตของช่วงปัจจุบันได้
ค่าแอดแวนเทจสุดท้ายคือ A_traj + λ · A_seg ซึ่งหาค่าเหมาะที่สุดด้วยฟังก์ชันวัตถุประสงค์ตัวแทนแบบตัดค่าของ PPO ตามมาตรฐาน ไฮเปอร์พารามิเตอร์ γ=0.95, λ=1.0 ถูกกำหนดคงที่ในทุกเบนช์มาร์ก ไม่มีการปรับแต่งแยกตามงาน
ผลลัพธ์
ALFWorld, Qwen2.5-1.5B:
| วิธี | สั้น | ปานกลาง | ยาว | เฉลี่ย |
|---|---|---|---|---|
| GRPO | 76.7 | 73.9 | 53.5 | 72.8 |
| GiGPO | 90.7 | 84.3 | 79.5 | 86.1 |
| BEACON | 96.8 | 87.0 | 92.9 | 91.4 |
อัตราความสำเร็จในอีกสองสภาพแวดล้อม:
| วิธี | ScienceWorld | WebShop |
|---|---|---|
| GRPO | 21.1 | 56.8 |
| GiGPO | 25.8 | 65.0 |
| BEACON | 45.3 | 75.6 |
โมเดล 1.5B ทำคะแนนเหนือ GPT-4o บน ALFWorld (91.4 เทียบกับ 48.0) และ WebShop (75.6 เทียบกับ 23.7) และเสมอกันบน ScienceWorld (45.3 เทียบกับ 45.4) ข้อควรคำนึงเพื่อความเป็นธรรมคือ โมเดลปิดใช้พรอมป์ต์ ReAct ไม่ได้ผ่านการฝึก อัตราการใช้ประโยชน์จากตัวอย่างเพิ่มจาก 23.7% เป็น 82.0% และลู่เข้าเร็วขึ้น โดยสำเร็จ 60% ภายในรอบที่ 50 ขณะที่ GRPO ต้องถึงรอบที่ 120
ผลที่น่าเชื่อถือที่สุดคือ ประโยชน์เพิ่มขึ้นตามความยาวของงาน บนโมเดล 7B การปรับปรุงสัมพัทธ์เหนือ GRPO เพิ่มจาก +13% ในงานสั้นเป็น +39% ในงานยาว ขณะที่ GiGPO เพิ่มเพียงจาก +11% เป็น +22% เหตุผลสำคัญคือ GiGPO สร้างกลุ่มเปรียบเทียบระดับขั้นตอนจาก สถานะที่เกิดซ้ำ และเมื่อนโยบายดีขึ้นและเส้นทางหลากหลายขึ้น สถานะที่เกิดซ้ำก็น้อยลง แหล่งสัญญาณของมันเองจึงค่อย ๆ เสื่อมลง ส่วนจุดยึดหมุดหมายไม่เสื่อมลงเมื่อนโยบายแข็งแกร่งขึ้น
วิธีที่ให้ประโยชน์มากขึ้นเมื่อปัญหายากขึ้น เป็นข้ออ้างที่หนักแน่นกว่าการมีคะแนนเฉลี่ยสูงกว่าอย่างมาก
ตัวชี้วัดที่ดูขัดแย้งกัน
งานวิจัยนิยาม อัตราส่วนการกระจุกตัวของเครดิต — ค่าเฉลี่ยของ ขนาด ค่าแอดแวนเทจของการกระทำที่เป็นหมุดหมาย หารด้วยค่าของการกระทำที่ไม่ใช่หมุดหมาย ค่ามากกว่า 1 หมายถึงเครดิตกระจุกอยู่ที่หมุดหมาย
| วิธี | CCR |
|---|---|
| GiGPO | 2.36 |
| GRPO | 1.37 |
| BEACON | 0.84 |
ดังนั้นวิธีที่ทำได้ดีที่สุดกลับเป็นวิธีที่กระจุกเครดิตไว้ที่ขั้นตอนสำคัญ น้อยที่สุด — ซึ่งดูขัดแย้งโดยตรงกับข้อความว่า “การกระทำที่ใกล้หมุดหมายกว่าได้รับรางวัลมากกว่า” แต่ไม่ใช่เช่นนั้น ข้อความทั้งสองวัดคนละปริมาณ โดยมีการแปลงสองขั้นคั่นอยู่
การแปลงที่ 1 — รางวัลที่ปรับรูปแบบแล้ว ภายในช่วง รางวัลเพิ่มขึ้นอย่างเป็นเอกทิศทางเมื่อเข้าใกล้หมุดหมายจริง เมื่อใช้ γ=0.95 และช่วงมีความยาว 5 การกระทำทั้งห้าจะได้ 0.8145, 0.857, 0.9025, 0.95, 1.0 แต่นี่คือรางวัล ไม่ใช่เครดิตที่ส่งถึงเกรเดียนต์
การแปลงที่ 2 — ลบค่าฐานของกลุ่ม ค่าฐานคือค่าเฉลี่ยของกลุ่มสำหรับ ต่อขั้นตอน ผลตอบแทนต่อขั้นตอน (ผลตอบแทนของช่วง ÷ ความยาวช่วง) สำหรับช่วงที่ยาว L ผลตอบแทนต่อขั้นตอนคือ (1−γ^L) / (L(1−γ)):
| ความยาวช่วง | 3 | 5 | 8 | 10 |
|---|---|---|---|---|
| ผลตอบแทนต่อขั้นตอน | 0.951 | 0.905 | 0.842 | 0.803 |
ถ้าช่วงของคุณใช้ 8 ขั้นตอน ขณะที่กลุ่มใช้เฉลี่ย 5 ผลตอบแทนต่อขั้นตอนของคุณจะต่ำกว่าค่าฐาน และ ทั้งหมด ค่าแอดแวนเทจของช่วงจะเอนไปทางลบ สังเกตความหมายของสิ่งนี้: โทษจากการเดินอ้อมไม่ได้มาจากการลดทอนเอง แต่มาจากการลดทอนที่ออกผลผ่านค่าฐานต่อขั้นตอน การลดทอนเพียงอย่างเดียวทำได้แค่เรียงลำดับการกระทำ ภายใน ช่วง ณ จุดนี้ CCR ภายในช่วงที่เสร็จสมบูรณ์ยังมากกว่า 1
การแปลงที่ 3 — เพิ่มพจน์ระดับเส้นทาง นี่คือจุดที่ CCR ลดลงต่ำกว่า 1 ผ่านผลสองอย่างที่ไม่สมมาตรกัน อย่างแรก ช่วงท้ายของเส้นทางที่ล้มเหลวไม่เข้ากลุ่มเปรียบเทียบใดเลย เพราะ G_k = {i : K_i ≥ k} และช่วงท้ายที่ไม่เสร็จมีดัชนีเป็น K_i + 1 > K_i เส้นทางนั้นจึงถูกตัดออก ช่วงท้ายไม่ได้รับค่าแอดแวนเทจระดับช่วง ได้เพียงพจน์ระดับเส้นทางเต็มขนาด และทุกการกระทำในนั้นไม่ใช่หมุดหมาย จึงทำให้ตัวส่วนสูงขึ้น อย่างที่สอง ในเส้นทางที่ล้มเหลว พจน์ระดับเส้นทางที่เป็นลบจะหักล้างเครดิตระดับช่วงที่เป็นบวกของการกระทำที่เป็นหมุดหมาย ทำให้ขนาดของมันถูกบีบเข้าใกล้ศูนย์
รูปที่ 8 ของงานวิจัยยืนยันเรื่องนี้ ในเส้นทางที่ล้มเหลวแต่ผ่านหมุดหมาย S3 และ S4:
| ไปที่โถสุขภัณฑ์ | วางสบู่ก้อน (S3✓) | ไปที่เคาน์เตอร์ (S4✓) | ไปที่เคาน์เตอร์ | ไปที่ที่วาง | |
|---|---|---|---|---|---|
| GRPO | −2.50 | −2.50 | −2.50 | −2.50 | −2.50 |
| BEACON | −0.92 | +0.51 | +0.32 | −2.20 | −2.20 |
สองค่าสุดท้าย เท่ากันทุกประการ — เป็นร่องรอยเฉพาะของ “ช่วงท้ายได้รับเพียงพจน์ระดับเส้นทาง” ซึ่งทำให้เราอ่านค่าได้ว่า A_traj ≈ −2.20 การกระทำที่เป็นหมุดหมายทั้งสองมีค่าเป็นบวก แต่ขนาดเพียง ~0.5 เพราะพจน์ระดับเส้นทางที่เป็นลบหักล้างเครดิตระดับช่วงไปเกือบหมด CCR ของเส้นทางนี้คือ 0.23 ส่วนเส้นทางที่สำเร็จคือ 2.95 ค่าโดยรวม 0.84 คือผลผสมของทั้งสอง
ดังนั้น CCR วัด การกระจุกตัวของขนาดเกรเดียนต์ ไม่ใช่ว่าใครได้รับรางวัล CCR ต่ำไม่ใช่เป้าหมายการออกแบบ แต่เป็นผลพลอยได้จากการจัดสรรอย่างหนาแน่นภายในช่วงร่วมกับการซ้อนสองระดับ ข้อสรุปของผู้เขียนยังคงถูกต้องและเป็นข้อสรุปที่ดี: อย่าเทพลังเกรเดียนต์ทั้งหมดลงในขั้นตอนสำคัญ ค่า 2.36 ของ GiGPO หมายความว่าการกระทำเตรียมการระหว่างทางแทบไม่ได้รับสัญญาณ ทั้งที่การกระทำเหล่านั้นเองทำให้ไปถึงหมุดหมายได้
สิ่งที่งานวิจัยไม่ได้อธิบายตรง ๆ
มีช่องหนึ่งในตารางการทดลองตัดองค์ประกอบที่ดูแปลก เมื่อตั้งค่า γ=1 — ให้เครดิตเท่ากันภายในแต่ละช่วง — ได้คะแนน 71.8 ซึ่งแย่กว่าการไม่ปรับรูปแบบรางวัลเลย (γ=0, 81.2) และยังต่ำกว่า 72.8 ของ GRPO งานวิจัยระบุว่านี่เกิดจาก “เกรเดียนต์ที่ชี้นำผิด”
เมื่อไล่คำนวณ คำตอบจะชัดเจนกว่านั้น เมื่อใช้ γ=1 ทุกการกระทำในช่วงที่เสร็จสมบูรณ์จะได้รางวัลเท่ากัน ดังนั้นทุกช่วงที่เสร็จสมบูรณ์ ไม่ว่าจะยาวเท่าใด จะมีผลตอบแทนต่อขั้นตอนเท่ากับ R_ms พอดี ค่าฐานก็เท่ากัน และ:
A_seg(i,t) ≡ R_ms − R_ms = 0 for every actionช่องสัญญาณระดับช่วงไม่ได้ชี้นำผิด แต่มัน หายไปเป็นศูนย์โดยเอกลักษณ์ และวิธีนี้ลดรูปเป็น GRPO ทุกประการ ลองเทียบกับตาราง: 71.8 เทียบกับ 72.8 ของ GRPO ต่างกันหนึ่งจุด ซึ่งเป็นความผันผวนระหว่างการรัน
นี่เปลี่ยนมุมมองต่อหน้าที่ของการลดทอน มันไม่ได้มีไว้แค่แยกแยะการกระทำภายในช่วง แต่เป็น เงื่อนไขจำเป็นที่ทำให้สัญญาณระดับช่วงมีอยู่ได้ หากไม่มีมัน ค่าฐานต่อขั้นตอนจะหักล้างสัญญาณทันที
การทดลองสามอย่างที่ตอบข้อกังขาชัด ๆ
ต้องให้เครดิตผู้เขียน พวกเขาตอบคำถามสามข้อที่ผู้อ่านช่างสงสัยจะถามไว้ล่วงหน้า:
- นี่เป็นแค่การเลียนแบบพฤติกรรมหรือเปล่า? SFT บนเส้นทางออราเคิลทำได้ 43% ส่วน BEACON ทำได้ 91.4% นโยบายค้นพบกลยุทธ์การลงมือทำที่ดีกว่าออราเคิล จึงไม่ได้เป็นเพียงการเลียนแบบ
- ผลที่ดีขึ้นมาจากการแบ่งช่วงเท่านั้นหรือเปล่า? การแบ่งช่วงแบบสุ่มได้ 74.2% สูงกว่า GRPO เพียง 1.4 จุด การใช้หมุดหมายจริงได้ 91.4% ห่างกัน 17.2 จุด ประโยชน์จึงมาจากโครงสร้างภายในของงาน
- ถ้าตัวตรวจจับไม่น่าเชื่อถือล่ะ? แม้สุ่มทิ้งหมุดหมาย 50% ก็ยังได้ 82.8% สูงกว่า GRPO สิบจุด ประสิทธิภาพลดลงอย่างค่อยเป็นค่อยไป
สิ่งที่นำไปใช้กับการออกแบบเอเจนต์ได้
BEACON เป็นวิธีฝึก และผลิตภัณฑ์ส่วนใหญ่ รวมถึงของเรา ประสานงานโมเดลแทนที่จะฝึกเอง สูตรนำไปใช้ตรง ๆ ไม่ได้ แต่การวินิจฉัยนำไปใช้ได้ และเชื่อมโยงกับสถาปัตยกรรมได้ตรงอย่างน่าประหลาดใจ
ความคืบหน้าบางส่วนต้องเป็นสถานะสำคัญที่ระบบจัดเก็บไว้อย่างถาวร ตัวเลขที่สะดุดตาที่สุดของงานวิจัยคือ 39–47% ของรอบการทำงานบรรลุเป้าหมายย่อยจริง แต่กลับได้คะแนนเท่ากับรอบที่ไม่ได้ทำอะไรเลย เซสชันเอเจนต์ระยะยาวที่บรรลุเป้าหมายย่อยสามข้อแล้วหยุดค้างก็มีปัญหาเดียวกัน หากระบบบันทึกเพียง “กำลังทำงาน” และ “เสร็จแล้ว” ความคืบหน้านั้นจะถูกทิ้ง และการลองใหม่จะเริ่มจากศูนย์ หมุดหมายให้คำศัพท์ที่ใช้บันทึกความคืบหน้านี้ได้
หมุดหมายควรมาจากผลที่เกิดขึ้นจริงซึ่งสังเกตได้ ไม่ใช่การรายงานของตัวเอง เหตุผลที่ Φ มีต้นทุนต่ำคือ มันอ่านการเปลี่ยนสถานะที่ตรวจสอบได้ แทนที่จะถามนโยบายว่ามีความคืบหน้าหรือไม่ รันไทม์ของเอเจนต์ก็มีข้อมูลแบบเดียวกัน แต่มักมองข้าม ไม่ว่าจะเป็นไฟล์ที่เขียนแล้ว การทดสอบที่จบด้วยรหัสศูนย์ การเรียกคอนเน็กเตอร์ที่ตอบกลับว่าสำเร็จ หรือเอกสารที่บันทึกเข้าฐานความรู้ สิ่งเหล่านี้คือข้อเท็จจริงอ้างอิง ส่วนการที่โมเดลยืนยันว่า “ขั้นตอนที่หนึ่งเสร็จแล้ว” ไม่ใช่
ขอบเขตหมุดหมายเป็นจุดย่อบริบทและเริ่มทำต่อที่มีหลักการรองรับ สมบัติมาร์คอฟของหมุดหมายบอกว่า เมื่อไปถึงหมุดหมายแล้ว สิ่งที่เกิดขึ้นก่อนหน้าจะสำคัญน้อยลงมาก นี่เป็นเหตุผลสำหรับการย่อบริบทที่ดีกว่า “ถึงเกณฑ์จำนวนโทเคนแล้ว” มาก และขอบเขตเดียวกันก็เป็นจุดตรวจที่เหมาะโดยธรรมชาติสำหรับกลับมาทำต่อหลังล้มเหลว
ตรวจสอบสองระดับ ไม่ใช่ระดับเดียว นี่คือการทดลองตัดองค์ประกอบที่เราอยากขีดเส้นใต้ให้ทุกคนที่สร้างเวิร์กโฟลว์เอเจนต์: เมื่อตัดสัญญาณระดับเส้นทางออก คะแนน ALFWorld ลดจาก 91.4% เหลือ 23.4% เมื่อมีเพียงผลตอบกลับระดับช่วง นโยบายจะเสริมพฤติกรรมที่ผ่านหมุดหมายระหว่างทาง แต่หลุดจากเป้าหมายจริง งานย่อยทุกชิ้นทำได้อย่างสวยงาม แต่ผลงานส่งมอบผิด การตรวจรับงานย่อยและการตรวจรับผลงานสุดท้ายใช้แทนกันไม่ได้ ที่น่าสังเกตคือ น้ำหนักที่จำเป็นแตกต่างกันตามงาน: WebShop ยังทำได้ 67.9% เมื่อไม่มีระดับเส้นทาง เพราะหมุดหมายสอดคล้องกับความสำเร็จสุดท้ายอย่างใกล้ชิด ส่วน ALFWorld กลับล่มเหลว
ข้อจำกัดที่ระบุอย่างตรงไปตรงมา
ข้อจำกัดใหญ่ที่สุดคือ เราจะหา Φ ได้หรือไม่ เบนช์มาร์กทั้งสามได้หมุดหมายจากกฎ ได้แก่ การจับคู่รูปแบบในคำตอบของสภาพแวดล้อม การเปลี่ยนหน้า และสัญญาณเป้าหมายย่อยที่ชัดเจน บริบทปลายเปิด เช่น ระบบอัตโนมัติบนเบราว์เซอร์ การปรับโครงสร้างโค้ดเบส และการวิจัยเชิงลึก ไม่มีการเปลี่ยนสถานะที่ตรวจสอบได้สำเร็จรูปเช่นนี้ และผู้เขียนระบุว่าการค้นพบหมุดหมายอัตโนมัติยังเป็นปัญหาที่เปิดอยู่ จึงควรมองว่านี่เป็นกรอบคิดที่ผ่านการตรวจสอบในสภาพแวดล้อมที่มีโครงสร้าง ไม่ใช่สูตรทางวิศวกรรมที่ยกไปใช้ได้ทันที
ความละเอียดของหมุดหมายก็มีผลมาก: ถ้าห่างเกินไป วิธีจะเสื่อมกลับไปใกล้ GRPO ถี่เกินไป ค่าแอดแวนเทจของช่วงจะมีสัญญาณรบกวน สมบัติมาร์คอฟเป็นเพียงค่าประมาณ และการแยกความแปรปรวนก็อาศัยสมบัตินี้ การทดลองไปถึงเพียง 7B โดยใช้ปริภูมิการกระทำแบบข้อความไม่ต่อเนื่อง ยังไม่ได้ทดสอบการควบคุมแบบต่อเนื่องหรือระบบหลายเอเจนต์
ถึงอย่างนั้น ข้อเสนอหลักก็เป็นสิ่งที่เราโต้แย้งได้ยาก: งานระยะยาวมีโครงสร้างแบบประกอบส่วนที่ใช้ประโยชน์ได้ และการให้โครงสร้างนั้นเป็นองค์ประกอบหลักของระบบดีกว่าการหวังให้โมเดลติดตามมันในบริบทเอง เรากำลังนำแนวคิดนี้ไปใช้รองรับงานระยะยาวใน Orkas และจะแชร์รายละเอียดการออกแบบเพิ่มเติมเมื่อพร้อมใช้งาน