
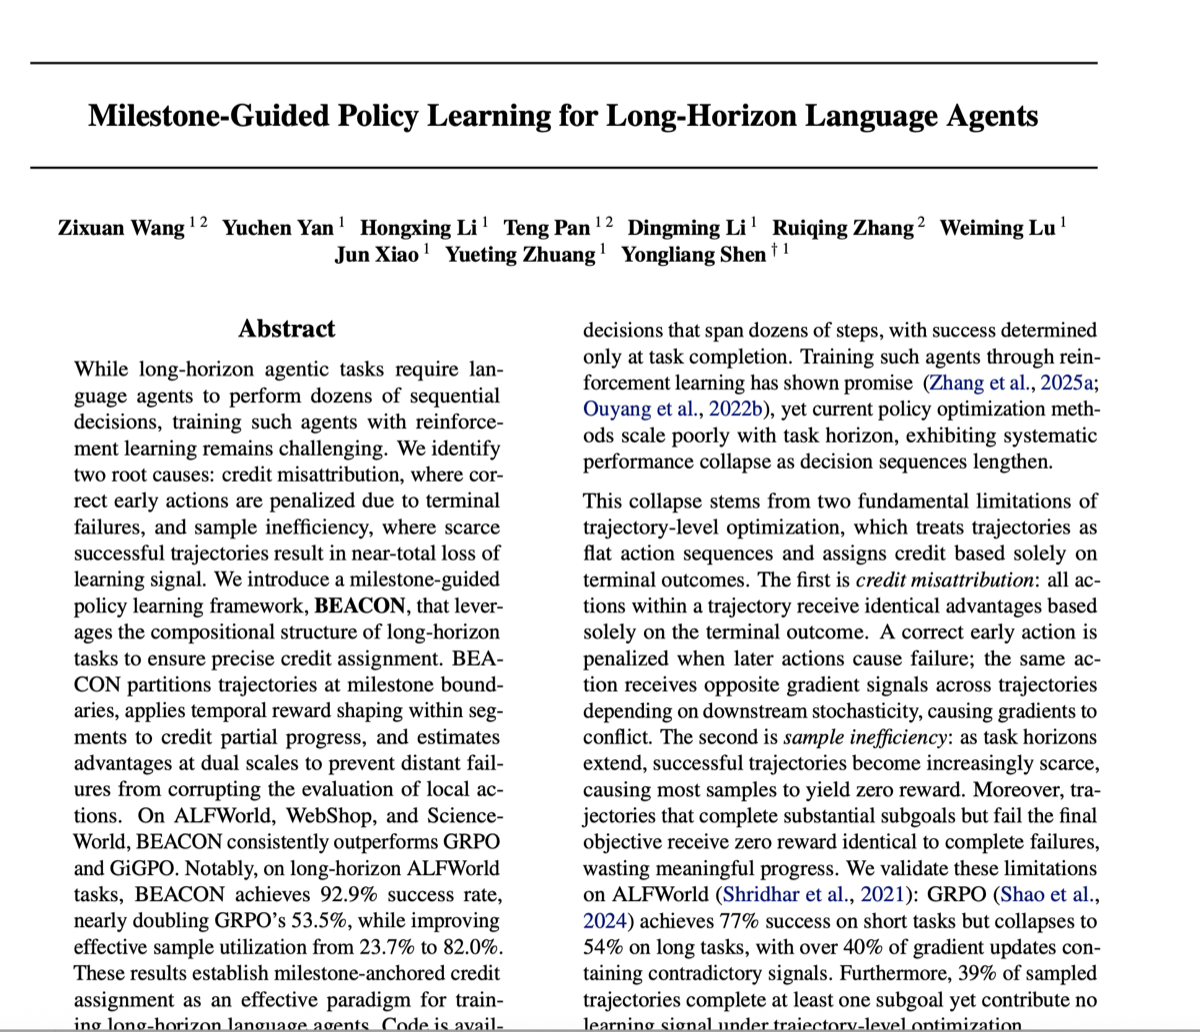
長程 Agent——那種要連續跑幾十步才有可驗證成果的 Agent——的失敗方式和短程 Agent 不一樣。它的表現不是隨任務變長而平緩下降,而是斷崖式往下掉。
浙江大學 ZJU-REAL 實驗室最近的一篇論文 Milestone-Guided Policy Learning for Long-Horizon Language Agents 把這個斷崖診斷得足夠清楚——清楚到即使你從不訓練模型,也能用得上。方法叫 BEACON,代碼已開源。
我們仔細讀了這篇,因為它描述的問題正是我們在產品側反復遇到的那個。下面是論文的論證、一處我們不得不自己推公式才對上的結果,以及我們認為能遷移到 Agent 架構上的部分。
兩個病因,都可量化
我們最欣賞的一點是,它沒有上來就講方法,而是先做了一次解剖:Qwen2.5-1.5B 用 GRPO 在 ALFWorld 上訓練,把崩潰拆成兩個被量化的病因。
信用錯配
軌跡級 RL 把一次運行當成扁平的動作序列,所有動作共享同一個終局分數。於是同一個正確動作,在成功軌跡里拿正梯度,在失敗軌跡里拿負梯度——它到底對不對,取決於後面發生了什麼。
作者把這個量化為 Contradictory Action Ratio:在相同狀態下執行的同一動作,跨軌跡拿到反號 advantage 的比例。峰值超過 40%。這些梯度互相抵消之後,有效學習信號跌破 20%。
樣本浪費
把軌跡分成三類——全成功、部分成功(至少完成一個子目標但任務失敗)、全盤失敗:
- 部分成功在整個訓練過程中穩定佔 39%~47%。
- 全成功始終低於 27%。
而在 GRPO 里,部分成功和全盤失敗都是 0 分。超過 73% 的樣本產生不了任何學習信號。
兩個問題隨 horizon 增長而復合惡化:任務越長成功率越低(部分成功越多),下游隨機性污染信用的機會也越多。具體到 ALFWorld:短任務 76.7%,長任務 53.5%。
核心洞察:長任務本身就有結構
長程任務天然被里程碑切成若干階段——里程碑就是標誌子目標達成的、可驗證的狀態躍遷。扁平化優化把這個結構直接扔掉了。
作者把它形式化為里程碑馬爾可夫性:一旦到達某個里程碑狀態,後續軌跡的分布主要取決於還剩哪些子目標,而不取決於你之前是怎麼走到這兒的。
一旦拿到鑰匙,接下來的成敗只看你拿它做什麼,不看你是怎麼找到它的。
正是這個近似馬爾可夫性,讓信用可以在段與段之間解耦。
方法三步走
1. 按里程碑切段
檢測器 Φ 標出里程碑時刻,把軌跡切成若干段。我們認為被低估的設計決策是:Φ 不需要訓練模型,也不需要人工標注。它只讀環境反饋里可觀測的狀態變化——ALFWorld 的物體狀態躍遷、WebShop 的頁面跳轉、ScienceWorld 直接給出的子目標信號。
零額外模型、零額外採樣開銷。這就是它相對過程獎勵模型和蒙特卡洛估值的全部成本優勢。
2. 段內時序獎勵塑形
r_t = R_ms * γ^(t_k − t)   if segment k ends in a completed milestone
= 0 otherwise只有收尾於里程碑的段才拿獎勵,段內越靠近里程碑的動作拿得越多。完成段裡的每個動作現在都有信號,部分成功不再被丟棄。
3. 雙尺度 advantage
軌跡級就是標準 GRPO 對終局獎勵做歸一化。真正的思想在段級——在於比較組怎麼定義:
G_k = { i : K_i ≥ k }          # only trajectories that ALSO reached milestone k

A_seg(i,t) = r_t − (1/|G_k|) · Σ_{j∈G_k}  R_k(j) / |Seg_k(j)|
                               └── group-average PER-STEP return ──┘
第 k 段的動作,只跟同樣到達了里程碑 k 的軌跡相比。由此作者推出方差隔離性質:後續段的成敗在數學上無法污染當前段的信用。
最終 advantage 是 A_traj + λ · A_seg,套標準 PPO clipped surrogate 優化。超參 γ=0.95, λ=1.0 全 benchmark 固定,不做任務級調參。
效果
ALFWorld,Qwen2.5-1.5B:
| 方法 | 短 | 中 | 長 | 平均 |
|---|---|---|---|---|
| GRPO | 76.7 | 73.9 | 53.5 | 72.8 |
| GiGPO | 90.7 | 84.3 | 79.5 | 86.1 |
| BEACON | 96.8 | 87.0 | 92.9 | 91.4 |
另外兩個環境的成功率:
| 方法 | ScienceWorld | WebShop |
|---|---|---|
| GRPO | 21.1 | 56.8 |
| GiGPO | 25.8 | 65.0 |
| BEACON | 45.3 | 75.6 |
1.5B 的模型在 ALFWorld(91.4 對 48.0)和 WebShop(75.6 對 23.7)上都超過 GPT-4o,在 ScienceWorld 上打平(45.3 對 45.4)。需要說明的是:閉源模型用的是 ReAct 提示,沒有訓練。樣本利用率從 23.7% 升到 82.0%,收斂也更快——第 50 步就到 60% 成功率,GRPO 要到第 120 步。
最有說服力的結果是增益隨 horizon 放大。7B 上相對 GRPO 的提升,從短任務的 +13% 漲到長任務的 +39%;而 GiGPO 只從 +11% 漲到 +22%。原因很關鍵:GiGPO 靠狀態復現構造 step-level 比較組,而策略越強、軌跡越多樣,狀態復現就越稀疏——它的信號源在自我削弱。里程碑錨點則不會隨策略變強而衰減。
一個方法的收益隨問題變難而變大,這比刷高平均分有說服力得多。
那個看起來自相矛盾的指標
論文定義了 Credit Concentration Ratio——里程碑動作的平均 advantage 幅度除以非里程碑動作的平均幅度。大於 1 表示信用集中在里程碑上。
| 方法 | CCR |
|---|---|
| GiGPO | 2.36 |
| GRPO | 1.37 |
| BEACON | 0.84 |
也就是說,效果最好的方法反而最不把信用集中在關鍵步上——這讀起來和「越靠近里程碑的動作獎勵越高」直接打架。其實不矛盾:兩句話量的不是同一個東西,中間隔著兩步變換。
變換一:shaped reward。段內獎勵確實單調遞增。γ=0.95、段長為 5 時,五個動作分別拿到 0.8145, 0.857, 0.9025, 0.95, 1.0。但這是 reward,不是最終餵給梯度的 credit。
變換二:減去組內基線。基線是組內平均每步回報(段回報 ÷ 段長)。段長為 L 時,每步回報是 (1−γ^L) / (L(1−γ)):
| 段長 | 3 | 5 | 8 | 10 |
|---|---|---|---|---|
| 每步回報 | 0.951 | 0.905 | 0.842 | 0.803 |
如果你這段走了 8 步而組內平均 5 步,你的每步回報低於基線,整段的 advantage 一齊偏負。注意這意味著什麼:懲罰繞路的不是衰減本身,而是衰減通過每步基線起作用。單看衰減只是給段內動作排序。到這一步為止,完成段內部的 CCR 仍然大於 1。
變換三:疊加軌跡級項。CCR 掉到 1 以下發生在這裡,靠兩個不對稱效應。第一,失敗軌跡的尾段根本進不了任何比較組:因為 G_k = {i : K_i ≥ k},而未完成尾段的下標是 K_i + 1 > K_i,該軌跡被排除在外。尾段拿不到任何段級 advantage,只剩滿幅度的軌跡級項——而這些全是非里程碑動作,把分母抬高了。第二,在失敗軌跡里,負的軌跡級項會抵消里程碑動作上正的段級 credit,把它們的幅度壓向 0。
論文自己的 Figure 8 就是驗證。一條完成了里程碑 S3、S4 後失敗的軌跡:
| go to toilet | put soapbar (S3✓) | go to counter (S4✓) | go to counter | go to holder | |
|---|---|---|---|---|---|
| GRPO | −2.50 | −2.50 | −2.50 | −2.50 | −2.50 |
| BEACON | −0.92 | +0.51 | +0.32 | −2.20 | −2.20 |
最後兩個值完全相同——這正是「尾段只剩軌跡級項」的指紋,由此可以反推出 A_traj ≈ −2.20。兩個里程碑動作雖然是正的,幅度卻只有 0.5 上下,因為負的軌跡級項吃掉了大部分段級 credit。這條軌跡的 CCR 是 0.23,而成功軌跡上是 2.95,全局的 0.84 就是兩者的混合。
所以 CCR 測的是梯度幅度的集中度,而不是「獎勵發給了誰」。低 CCR 不是設計目標,而是「段內密集分配 + 雙尺度疊加」的副產品。作者的結論依然成立,而且是個好洞察:別把梯度能量全砸在關鍵步上。GiGPO 的 2.36 意味著中間那些鋪墊動作幾乎沒有信號,而它們恰恰是到達里程碑的前提。
論文自己沒點破的一點
消融表裡有一格很奇怪。γ=1——段內均勻給分——得 71.8,比完全不塑形(γ=0,81.2)還差,甚至低於 GRPO 的 72.8。論文把它歸因於「誤導性梯度」。
把公式推一遍,答案更鋒利。γ=1 時完成段內每個動作獎勵相同,於是任何長度的完成段,每步回報都恰好是 R_ms。基線也等於它,於是:
A_seg(i,t) ≡ R_ms − R_ms = 0 for every action段級通道不是在誤導,而是恆等於零地消失了,方法精確退化成 GRPO。對照表格:71.8 對 GRPO 的 72.8,差一個點,就是 run-to-run 噪聲。
這也重新定義了衰減的作用:它不只是區分段內動作,更是段級信號能夠存在的必要條件。沒有它,每步基線會把信號當場抵消掉。
三個堵住明顯質疑的實驗
這一點值得肯定——作者主動回答了懷疑者會問的三個問題:
- 是不是變相的行為克隆?用 oracle 軌跡做 SFT 只有 43%,BEACON 達到 91.4%。策略找到了比 oracle 更優的執行方式,不是在模仿。
- 收益是不是僅僅來自切段?隨機切分只有 74.2%,僅比 GRPO 高 1.4 個點;真實里程碑是 91.4%,差距 17.2 個點。增益來自任務固有結構。
- 檢測器不准怎麼辦?隨機丟掉 50% 的里程碑仍有 82.8%,比 GRPO 高 10 個點。降級是平滑的。
哪些能遷移到 Agent 設計
BEACON 是訓練方法,而多數產品——包括我們——是在編排模型而不是訓練模型。公式不能遷移,但診斷可以,而且它對應到架構上出奇地直接。
部分進度必須成為一等的、持久化的狀態。論文最尖銳的數字是:39%~47% 的運行完成了真實子目標,卻和什麼都沒做的運行拿一樣的分。一個長時間運行的 Agent 會話,完成三個子目標後卡住,問題是一樣的:如果系統只記錄「運行中」和「已完成」,那部分進度就被丟掉了,重試從零開始。里程碑給了你記錄它的詞彙。
里程碑應來自可觀測的副作用,而不是自述。Φ 便宜的原因是它讀可驗證的狀態躍遷,而不是去問策略「你有沒有進展」。Agent 運行時手裡有同樣的資產,卻常常忽略它:一個寫入的檔案、一個退出碼為 0 的測試、一次返回成功的連接器呼叫、一條落庫的知識。這些是 ground truth;模型聲稱「第一步已完成」不是。
里程碑邊界是有原則的壓縮點和恢復點。里程碑馬爾可夫性說的是,一旦到達里程碑,之前的過程就沒那麼重要了。這比「到了 token 閾值所以壓縮」是好得多的依據,而同一個邊界也是失敗後最自然的恢復點。
驗收要雙尺度,不能只有一個。這是我們想給所有做 Agent 工作流的人划重點的一格消融:去掉軌跡級信號,ALFWorld 從 91.4% 掉到 23.4%。只有段級反饋時,策略會去強化那些達成中間里程碑卻偏離真實目標的行為——每個子任務都做得漂亮,交付物卻是錯的。子任務驗收和最終交付驗收不能互相替代。值得注意的是,所需權重隨任務而變:WebShop 去掉軌跡級仍有 67.9%,因為它的里程碑與最終成功高度對齊;ALFWorld 則直接崩掉。
局限也說清楚
最大的約束是 Φ 到底能不能拿到。三個 benchmark 的里程碑都來自規則——模式匹配環境響應、頁面跳轉、顯式子目標信號。而瀏覽器自動化、代碼庫改造、深度研究這類開放場景沒有這種現成的可驗證躍遷,作者也把自動里程碑發現列為 open problem。所以這更像是在結構化環境里被驗證的範式,而不是可以直接搬走的工程方案。
里程碑粒度同樣敏感:太稀會退化成 GRPO,太密則段級 advantage 變噪聲。馬爾可夫性只是近似,方差隔離建立在它之上。實驗止於 7B、離散文本動作空間,連續控制和多智能體都未驗證。
但核心主張我們很難反駁:長任務有可利用的組合結構,把這個結構當成一等對象來處理,勝過指望模型在上下文里自己記住。我們正把這個思路用在 Orkas 的長程任務能力上,後續會繼續分享這塊的設計。