
طُرح نموذجان لتوليد الفيديو في الوقت الفعلي بفارق أسبوع هذا الشهر. أطلقت ShengShu نموذج Vidu S2 في 15 سبتمبر، وأعلنت PixVerse عن PixVerse R2 في 22 سبتمبر. صُمم S2 حول الشخصيات الرقمية الحية وإعادة تصميم بث الفيديو أثناء تشغيله. أما R2 فيصف نفسه بأنه نموذج عالم يعمل في الوقت الفعلي: مشهد تتنقل فيه بمفاتيح WASD، بينما تغيّر المطالبات والمراجع والصوت ما يحدث بعد ذلك.
نشرت الشركتان شرحًا لطريقة البناء: S2 في ورقة على arXiv، وR2 في تقرير تقني على موقع PixVerse. قرأناهما جنبًا إلى جنب. يتفقان على البنية الأساسية، ويختلفان في خمسة قرارات تصميمية، ويكشفان مقادير متفاوتة جدًا من التفاصيل. تتناول هذه المقالة الجوانب الثلاثة من دون إعلان فائز، إذ لم يُقَس النموذجان على الاختبار نفسه قط.
ما الذي يغيّره العمل في الوقت الفعلي؟
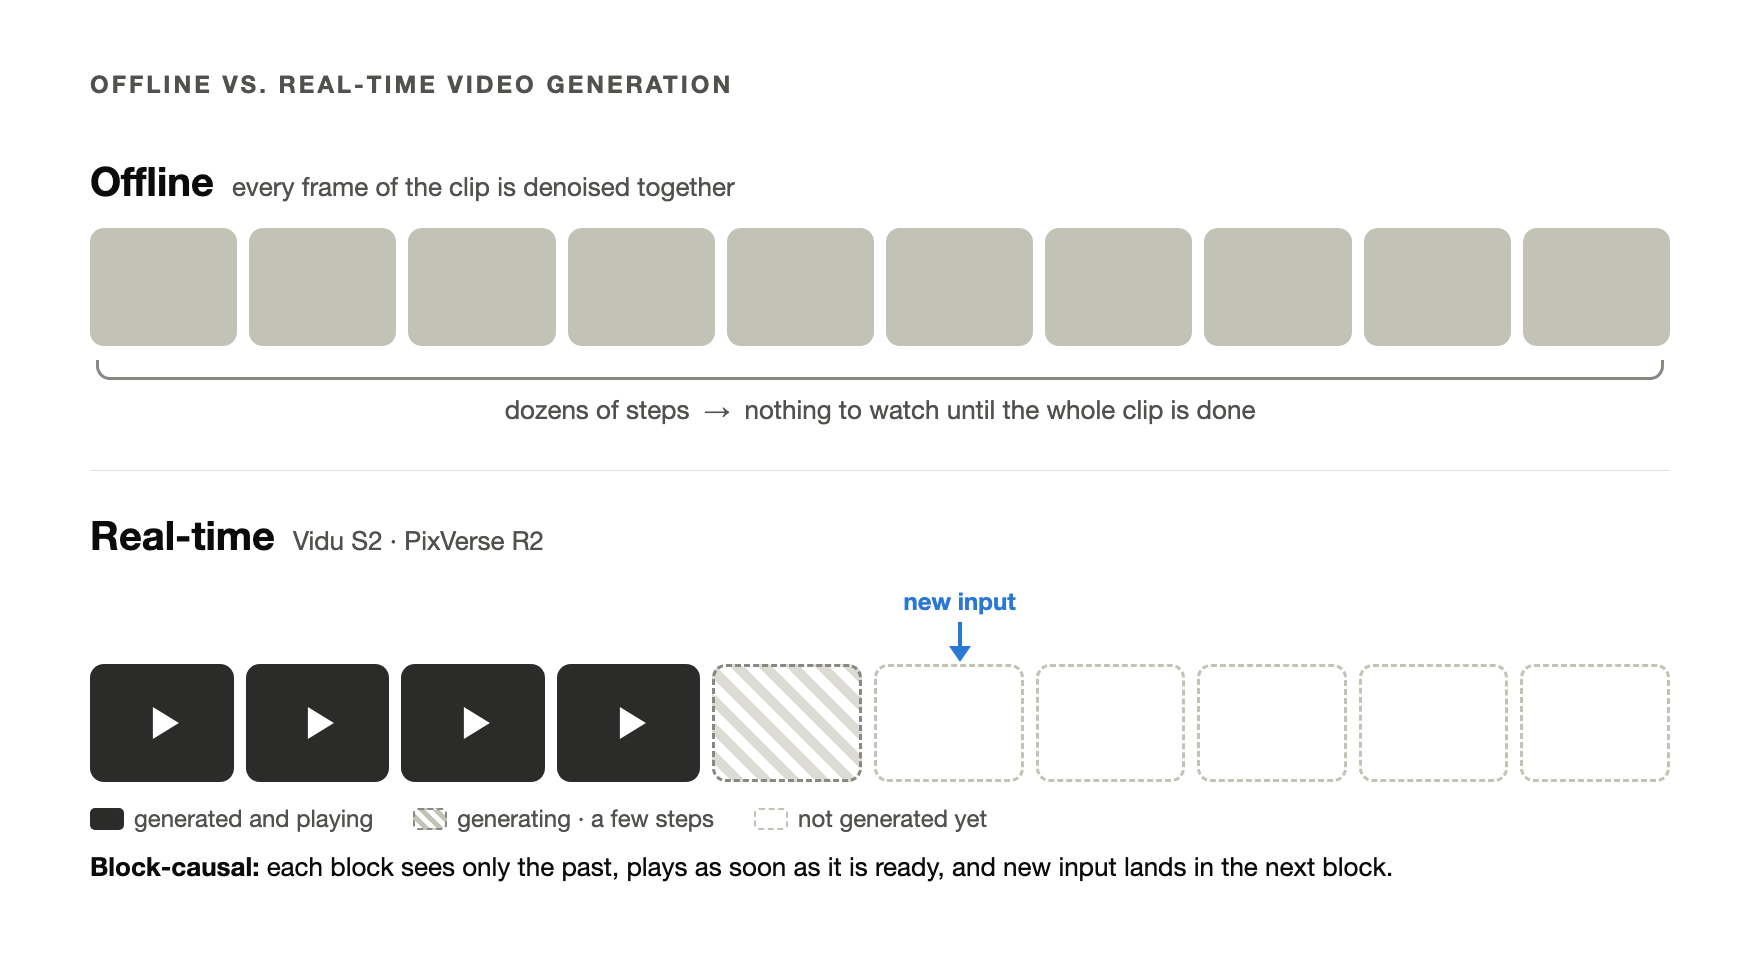
معظم نماذج الفيديو تعمل دون اتصال مباشر. تُزال الضوضاء من كل إطارات المقطع معًا على مدى عشرات الخطوات، ولا يظهر شيء حتى يكتمل المقطع كله. ويجب أن تضع كل ما تريده في المطالبة قبل بدء التوليد.
يقلب نموذج الوقت الفعلي هذه الآلية. فهو يقسم الفيديو إلى كتل، تضم كل منها بضعة إطارات والجزء الصوتي المقابل، ثم يولدها بالتتابع. تمر كل كتلة بخطوات قليلة فقط لإزالة الضوضاء وتُعرض فور جاهزيتها. تستطيع الكتلة الاطلاع على ما سبقها، لكن ليس ما يليها؛ وهذا معنى السببية على مستوى الكتل. ويظهر أثر التعليمات الجديدة في الكتلة التالية.
تخلق هذه البنية ثلاث مشكلات، وتجيب معظم قرارات التصميم أدناه عن إحداها:
- الأخطاء تتراكم. تعتمد كل كتلة على كتل ولّدها النموذج بنفسه، لذا ينتقل أي خطأ صغير إلى كل ما يأتي بعدها.
- يجب وضع حد للذاكرة. قد يستمر البث إلى أجل غير محدد؛ والاحتفاظ بكل الكتل السابقة سيجعل توليد كل كتلة جديدة أعلى كلفة.
- مهلة الزمن قاسية. عند 25 إطارًا في الثانية، لا يتاح لكل إطار سوى 40 مللي ثانية.
يعتمد S2 وR2 البنية الأساسية نفسها: نموذج انتشار انحداري ذاتي سببي على مستوى الكتل يولّد الفيديو والصوت معًا. وتكمن الفروق في كيفية تدريبهما، وتثبيت البث، وإدارة الذاكرة، وزيادة السرعة، وإتاحة التحكم للمستخدم.
النظامان
يتكون Vidu S2، من ShengShu Technology بالتعاون مع جامعة تسينغهوا، من نموذجين. S2-Avatar شخصية رقمية حية بدقة 720p ومعدل 25–42 FPS، بعد أن كانت الدقة 540p في S1. يمكنك تقديم صورة مرجعية جديدة أثناء البث، لكوب أو سترة أو شاطئ مثلًا، فتلتقط الشخصية الكوب أو ترتدي السترة أو تدخل المشهد؛ ويمكنها أيضًا الرقص. ويعيد S2-Editing تصميم بث فيديو وارد في الوقت الفعلي، بأكثر من 50 نمطًا وتجربة ملابس افتراضية واستبدال للشخصية والخلفية، مع الحفاظ على حركة المصدر. وتستكشف الورقة أيضًا إخراجًا مجسمًا لسماعات VR.
PixVerse R2 نموذج واحد مخصص للعوالم التفاعلية. يمكن أن تصله أربعة أنواع من المدخلات أثناء عمله: النص والمراجع متعددة الوسائط والصوت والأفعال مثل WASD. ويحدّث كل منها حالة العالم، لا الإطار الحالي فحسب. يعمل محرك ألعاب PixVerse الآن على R2؛ ويركز العرض العام على الحركة والمطالبات.
القرار 1: كيف يُدرَّب النموذج؟
لا تُدرَّب نماذج الوقت الفعلي من الصفر. تنطلق عادةً من نموذج توليد قوي يعمل دون اتصال مباشر، ثم يُحوَّل ليعمل سببيًا في خطوات قليلة. وهنا يختلف التقريران بأوضح صورة.
يسلك S2 مسارًا تتابعيًا. يُدرَّب مسبقًا نموذج صوت وفيديو ثنائي الاتجاه، ثم يُضبط باستخدام Diffusion-DPO لتحسين الدقة والتعبير والحركة وتزامن الصوت والصورة. بعد ذلك يُحوَّل انتباهه إلى سببية على مستوى الكتل ويُدرَّب على مزيج من سجل نظيف وآخر مشوش (القرار 2). ثم تختزل تقنية Self-Replay Forcing النموذج إلى خطوات قليلة بينما يتدرب على مخرجاته، وتضبط مرحلة أخيرة لتفضيلات البث (Streaming NFT) النموذج السببي. ويُدرَّب نموذجا الشخصيات والتحرير كلٌّ على حدة.
يحافظ R2 على نموذج أساس واحد. Omni Causal AR نموذج سببي يُدرَّب مسبقًا وباستمرار على مقاطع قصيرة وفيديوهات طويلة وبيانات متعددة الوسائط ومسارات تفاعل. ثم تختزل Real-Time Acceleration النموذج نفسه للاستخدام المباشر: يُهيَّأ النموذج الطالب منه ويُبنى عليه النموذج المعلم. وتلخص عبارة التقرير النهج بأنه «تسريع، لا إعادة تعلّم».
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| نقطة البداية | نموذج ثنائي الاتجاه ضُبط باستخدام Diffusion-DPO | نموذج سببي مدرَّب مسبقًا باستمرار |
| المسار إلى الوقت الفعلي | التكيّف مع سببية الكتل → Self-Replay Forcing → ضبط تفضيلات البث | اختزال النموذج نفسه مباشرةً |
| النماذج | نموذجان منفصلان للشخصيات والتحرير | نموذج واحد لكل أنواع المدخلات |
يصوّر تقرير R2 النهج الشائع على أنه مسار تتابعي من خمس مراحل، ويرى أن كل انتقال يفقد بعض القدرات. وبالقراءة المباشرة، يتخذ مسار S2 هذا الشكل متعدد المراحل، مع تركيز تحسينه الأساسي في المرحلة الأخيرة. لم تنشر أي من الشركتين تجربة تقارن المسارين، لذا يبقى السؤال عن الأفضل في التوسع مفتوحًا.
القرار 2: كيف نمنع انجراف البث؟
الانجراف هو العطل المميز للفيديو المتدفق: تتغير الألوان تدريجيًا، ويتحول الوجه ببطء إلى شخص آخر، ثم ينهار الإطار في النهاية. يحدث هذا لأن النموذج يرى سجلًا نظيفًا أثناء التدريب، بينما لا يرى عند التشغيل سوى مخرجاته غير الكاملة.
يبدأ الفريقان بالحل نفسه. يمزجان بين Teacher Forcing، الذي يعتمد على سجل حقيقي نظيف ويحمي الجودة، وDiffusion Forcing، الذي يعتمد على سجل أضيفت إليه ضوضاء بمستوى عشوائي. تمحو الضوضاء التفاصيل الدقيقة لكنها تُبقي التخطيط والحركة، فيتعلم النموذج الاعتماد على البنية بدل الثقة بكل بكسل من الماضي.
لكن السجل الحقيقي المشوش لا يمثل أخطاء النموذج نفسه، لذا يضيف كل فريق طبقة ثانية.
S2: تقنية Self-Replay Forcing. يولّد النموذج أولًا تسلسلًا طويلًا كما سيفعل عند التشغيل تمامًا، من دون الاحتفاظ بالتدرجات. ثم تُضاف الضوضاء مجددًا إلى نافذة من ذلك المسار، كتلةً تلو الأخرى، ويعاد تشغيلها في مرور سببي واحد مع تفعيل التدرجات، باستخدام خسارة اختزال DMD وخسارة إدراكية. ولأن الكتل المعاد تشغيلها تقع في رسم حسابي واحد، تعبر التدرجات حدود الكتل، فيتعلم النموذج كيف تؤثر كتلة في التالية، من دون نشر التدرجات عكسيًا عبر التوليد الأصلي.
R2: مخزن الأخطاء Error Bank. تُخزَّن حالات فشل ممثلة من التوليد وتُعاد أثناء التدريب إلى جانب السجل العادي، ليتعلم النموذج التعافي بعد دخول الانحراف إلى العالم. وفي تقييم PixVerse الداخلي لهذه المرحلة، انخفض مقياس انجراف السطوع على المدى الطويل من 0.201 إلى 0.129، أي بنسبة 35.8%؛ وتحسنت 20 سلسلة طويلة من أصل 29، وانخفضت الحركة غير المقصودة في العينات الخمس الخالية من الحركة.
النهجان متكاملان أكثر منهما متنافسان. تدرّب Self-Replay Forcing النموذج على ما يخطئ فيه حاليًا، بينما تكرّس Error Bank التدريب للإخفاقات الجديرة بالتذكر.
القرار 3: ذاكرة تبقى ضمن حدود
يحتفظ كلاهما ببضع كتل افتتاحية دائمًا بوصفها مرساة (sink)، ويحتفظ بنافذة منزلقة من الكتل الحديثة، ويتخلى عن الباقي. وهكذا لا تزيد كلفة الكتلة الجديدة مع طول البث. كما يُبقيان إحداثيات المواضع ضمن النطاق الذي ظهر أثناء التدريب؛ ويسمي S1 ذلك RoPE repositioning، ويسميه R2 relative temporal RoPE، حتى لا تدفع الجلسة الطويلة المواضع خارج التوزيع.
يبني S2 على TwinCache من S1، حيث تُخزَّن كل كتلة سابقة مرتين: نسخة مشوشة وأخرى نظيفة. تقرأ خطوات إزالة الضوضاء الوسيطة النسخة المشوشة، التي تحمل الحركة العامة وتعمل مرشحًا منخفض التمرير ضد تراكم العيوب؛ وتقرأ الخطوة الأخيرة النسخة النظيفة لاستعادة التفاصيل. ويوزع S2 ذلك على مرحلتين: تقرأ الشبكة الأساسية ذاكرة عالية الضوضاء، ويقرأ Refiner ذاكرة منخفضة الضوضاء وعالية الدقة.
يفصل R2 الذاكرة بحسب المدى الزمني: Sink Memory للهوية والبيئة والأسلوب وقواعد العالم؛ وRolling History للحركة والوضعية والكاميرا في الماضي القريب؛ وObject KV Cache التي تضغط حالة الأشياء التي ستظل مهمة لاحقًا.
يعكس هذا التقسيم طبيعة المنتجين. يجب أن تبقى الشخصية الرقمية الشخص نفسه. ويجب أن يتذكر العالم أيضًا ما حدث فيه، مثل الشيء الذي وضعته أو القرار الذي اتخذته.
القرار 4: من أين تأتي السرعة؟
يستخدم كلاهما انتباهًا متناثرًا واختزالًا إلى خطوات قليلة، لكنهما يركزان جهودهما في موضعين مختلفين.
يعتمد S2 على هندسة الأنظمة ويوثقها. يُختار الانتباه لكل طبقة من SageAttention وSpargeAttention والانتباه الخطي المتناثر، مع تطبيق أقوى التقريبات على الطبقات الأقل حساسية. تعمل الطبقات الخطية بضرب مصفوفات W8A8 لكل كتلة. وتُدمج العمليات المتجاورة في نوى Triton/CUDA وتُعاد باستخدام CUDA Graphs. تستخدم بيئات GPU المتعددة توازي السياق Ulysses مع اتصال مكمّم، وفي مسار التحرير تتشارك أداة ترميز VAE والشبكة الأساسية وRefiner وأداة فك الترميز وحدات GPU وفق جدول زمني واحد. وتتحقق الدقة عبر شبكة أساسية منخفضة الدقة يتبعها Refiner كامن بخطوة واحدة وصولًا إلى 720p.
يعتمد R2 على النموذج. يُتعلم الانتباه المتناثر على مستوى الكتل أثناء التدريب، ويصل تناثره إلى أكثر من 90%. ويتبع الاختزال Decoupled DMD، حيث يُحسَّن اتباع إشارة التحكم ومطابقة المعلم كهدفين منفصلين، مع حد خصومي من DMD2 للحفاظ على الواقعية. وتتبع الدقة هرمًا: تحدد مرحلة أو مرحلتان منخفضتا الدقة التخطيط والحركة والكاميرا، ثم تضيف مرحلة أخيرة عالية الدقة الملمس. ولا يذكر التقرير دقة إخراج R2 أو معدل إطاراته.
القرار 5: كيف يتحكم المستخدم؟
يحيط S2 النموذج بوكيل VLM. يصنف الوكيل كل صورة مرجعية على أنها شيء محمول أو خلفية أو ملابس، ثم يكتب مطالبة لكل مقطع تشمل الهوية والتعبير واتجاه النظر والوضعية والفعل والأشياء المحمولة، مع إبقاء ما لم يطلب المستخدم تغييره. وبعد التوليد، يراجع الإطارات بالترتيب، ويحكم هل اكتمل الفعل أم اكتمل جزئيًا أم أخفق، ثم يكتب المطالبة التالية وفقًا لذلك. وعند ارتداء الملحقات أو خلعها، تنص المطالبات على الحركة والحالة النهائية معًا، حتى تبقى القبعة في مكانها بعد إعادتها إلى الرأس. وفي وضع التحرير، يسمح الانتباه المحاذي للإطارات لكل إطار ناتج بقراءة إطار المصدر في اللحظة نفسها فقط، فتطابق الحركة والتوقيت المدخلات تمامًا.
يدمج R2 واجهة مدخلات واحدة في النموذج. يدخل النص والمراجع والصوت والأفعال وعناصر التحكم التي يولدها الوكيل جميعًا إلى العالم الجاري نفسه. ويتبع طول الكتلة نوع التحكم النشط حتى حد أقصى: تحصل ضغطة المفتاح على كتل قصيرة للاستجابة السريعة، بينما تُخصص كتل أطول لحدث كامل أو مقطع صوتي حفاظًا على الاتساق. وفوق النموذج، يضيف محرك ألعاب PixVerse طبقة وكيل تُبقي حالة قواعد اللعبة والمشهد المولَّد متزامنين.
ما الذي يكشفه كل تقرير؟
قبل مقارنة الأرقام، قارن ما نُشر أصلًا.
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| الصيغة | ورقة على arXiv | منشور تقني على موقع PixVerse |
| الدقة ومعدل الإطارات | 720p، 25–42 FPS | غير مذكورين |
| عدد المعلمات والكمون الكلي | غير مذكورين | غير مذكورين |
| الاختبارات المرجعية العامة | اختبار واحد للشخصيات وأربعة اختبارات للتحرير | لا يوجد؛ تقييم داخلي فقط |
| الأوزان | لم تُنشر؛ توجد واجهة API | لم تُنشر |
في StreamAV-Bench، يحتل S2 المركز الأول في المقاييس التسعة المعلنة عبر 14 نظامًا في تقييمه الخاص: بلغت محاذاة الصوت والصورة 0.353 مقابل 0.272 لأفضل بديل، وخطأ التزامن 0.617 مقابل 0.648. بعض الفروق لا يتجاوز منزلة الألف؛ فثبات الشخصية 0.998 مقابل 0.997. أما الأرقام التي نشرها R2 فهي انخفاض الانجراف بنسبة 35.8% وتناثر الانتباه بأكثر من 90%، ويقول التقرير إن ذلك يحافظ على أربعة أبعاد داخلية للجودة من دون تقديم درجاتها.
لا توجد مقارنة مباشرة. تقارن ورقة S2 بنموذج PixVerse R1 السابق، وقد صدر R2 بعدها.
ماذا يعني هذا لمن يصنع الفيديو باستخدام الوكلاء؟
نبني تطبيق سطح مكتب تنفذ فيه الوكلاء العمل، والفيديو إحدى المهام التي يوكلها الناس إليهم. ويمكن نقل فكرتين من هذين التقريرين إلى هذا السياق.
أولًا، يزداد وضوح الحد الفاصل بين الفيديو المباشر والفيديو النهائي. صُممت نماذج الوقت الفعلي لتجارب تواصل الاستجابة: شخصيات وألعاب وبث تعيد تصميمه أثناء تشغيله. لكن معظم عمل المبدعين ينتهي بملف. في Orkas، يحوّل VideoStudio اللقطات ووصف المهمة إلى نسخة مونتاج قابلة للمراجعة، وعندما يلزم إنشاء لقطة، يستخدم نماذج تعمل دون اتصال مباشر: إما توليد فيديو تديره Orkas، أو مفتاحك الخاص لـ Seedance 2.0 أو Hailuo 2.3 أو Vidu Q3 Pro أو Kling 3.0 Turbo أو Veo 3.1 أو Runway Gen-4.5. لا يعمل S2 ولا R2 داخل Orkas اليوم.
ثانيًا، طبقة التحكم في S2 حلقة عمل لوكيل: اكتب المطالبة، وولّد، وانظر إلى الإطارات، ثم قرر الخطوة التالية. هذه البنية نفسها لأي وكيل يعمل مع نموذج توليد، سواء أكان في الوقت الفعلي أم لا. ويعتمد قدر كبير من النتيجة على تلك الحلقة، وليس على أوزان النموذج وحدها.
ما الذي نستخلصه؟
استقرت البنية الأساسية: انتشار انحداري ذاتي سببي على مستوى الكتل، وتوليد مشترك للفيديو والصوت، وسجل يجمع بين النظيف والمشوش، ومرساة ونافذة، واختزال من عائلة DMD، وانتباه متناثر، والبدء بدقة منخفضة. ما يميز S2 وR2 هو موضع الجهد: سلسلة تحسينات متخصصة مقابل نموذج أساس واحد يُختزل مرة واحدة، وإعادة تشغيل تعتمد على مخرجات النموذج مقابل مخزن للإخفاقات، وهندسة أنظمة مقابل تناثر متعلَّم.
تستحق الوثيقتان القراءة كاملتين: ورقة Vidu S2 لتفاصيل التدريب والتشغيل، وتقرير PixVerse R2 لطرحه حول توسيع نموذج الوقت الفعلي من دون إعادة تعلّمه.