
Ce mois-ci, deux modèles vidéo en temps réel sont sortis à une semaine d’intervalle. Vidu S2, de ShengShu, a été mis en ligne le 15 septembre, et PixVerse a annoncé PixVerse R2 le 22 septembre. S2 est conçu pour des personnages numériques en direct et pour restyler un flux vidéo pendant sa lecture. R2 se présente comme un modèle de monde en temps réel : une scène que l’on parcourt avec WASD pendant que des textes, des références et de l’audio changent ce qui se passe ensuite.
Les deux équipes ont publié leur méthode : S2 dans un article sur arXiv, R2 dans un rapport technique sur le site de PixVerse. Nous les avons lus côte à côte. Ils s’accordent sur l’ossature, divergent sur cinq choix de conception et publient des informations en quantités très différentes. Cet article couvre ces trois points et s’abstient volontairement de désigner un gagnant : les deux n’ont jamais été mesurés sur le même test.
Ce que le temps réel change
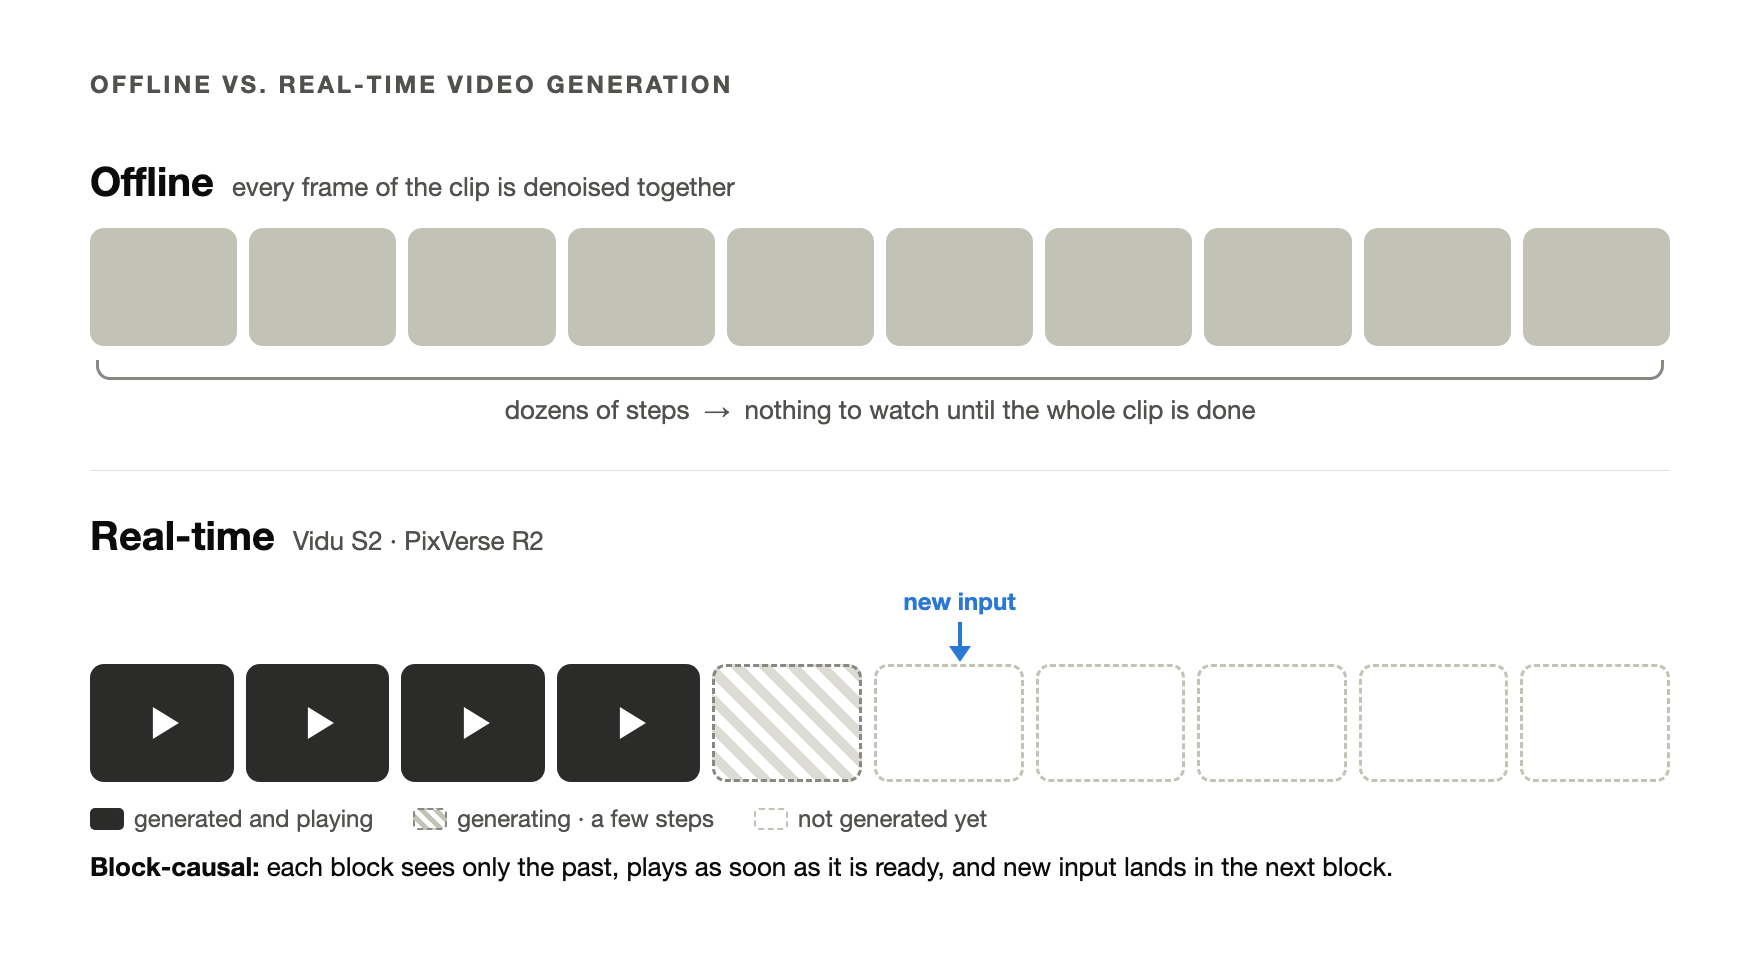
La plupart des modèles vidéo fonctionnent hors ligne. Toutes les images d’un clip sont débruitées ensemble, sur des dizaines d’étapes, et rien n’apparaît avant que le clip entier soit terminé. Tout ce que vous voulez doit figurer dans le prompt avant le début de la génération.
Un modèle en temps réel inverse la logique. Il découpe la vidéo en blocs — quelques images et la portion d’audio correspondante — et les génère dans l’ordre. Chaque bloc ne reçoit que quelques étapes de débruitage et se lit dès qu’il est prêt. Un bloc voit ce qui le précède mais jamais ce qui le suit ; c’est le sens de causal par blocs. Une nouvelle instruction s’applique au bloc suivant.
Cette forme crée trois problèmes, et presque chaque choix ci-dessous répond à l’un d’eux :
- Les erreurs s’accumulent. Chaque bloc est conditionné par des blocs que le modèle a lui-même générés ; une petite erreur se transmet donc à tout ce qui suit.
- L’historique doit rester borné. Un flux peut durer indéfiniment ; conserver tous les blocs passés rendrait chaque nouveau bloc plus coûteux.
- Le budget de temps est implacable. À 25 images par seconde, chaque image dispose de 40 millisecondes.
S2 et R2 aboutissent à la même ossature : un modèle de diffusion autorégressif, causal par blocs, qui génère la vidéo et l’audio ensemble. Les différences portent sur la manière de l’entraîner, de le garder stable, de lui donner une mémoire, de l’accélérer et de le laisser piloter.
Les deux systèmes
Vidu S2 (ShengShu Technology avec l’université Tsinghua) réunit deux modèles. S2-Avatar est un personnage numérique en direct en 720p, à 25–42 FPS, contre 540p pour S1. On peut lui donner une nouvelle image de référence en cours de diffusion — une tasse, une veste, une plage — et le personnage la saisit, l’enfile ou entre dans la scène ; il sait aussi danser. S2-Editing restyle en temps réel un flux vidéo entrant — plus de 50 styles, essayage virtuel, remplacement du sujet et de l’arrière-plan — tout en conservant le mouvement d’origine. L’article explore aussi une sortie stéréo pour casques de réalité virtuelle.
PixVerse R2 est un modèle unique orienté vers les mondes interactifs. Quatre types d’entrée peuvent arriver pendant qu’il tourne — texte, références multimodales, audio et actions comme WASD — et chacun met à jour l’état du monde, pas seulement l’image en cours. Le moteur de jeu de PixVerse tourne désormais sur R2 ; la démo publique se concentre sur le déplacement et les prompts.
Choix 1 : comment le modèle est entraîné
Un modèle en temps réel ne s’entraîne pas à partir de rien. Le point de départ habituel est un solide a priori génératif hors ligne, ensuite converti pour fonctionner de façon causale et en peu d’étapes. C’est là que les deux rapports divergent le plus ouvertement.
S2 procède par relais. Un modèle audio-vidéo bidirectionnel est pré-entraîné, puis ajusté avec Diffusion-DPO pour la fidélité, l’expression, le mouvement et la synchronisation audio-vidéo. Son attention devient causale par blocs et est entraînée sur un mélange d’historique propre et bruité (choix 2). Self-Replay Forcing le distille ensuite en peu d’étapes tout en l’entraînant sur ses propres sorties, et une dernière passe de préférences pour le streaming (Streaming NFT) ajuste le modèle causal. L’avatar et l’édition sont entraînés comme deux modèles distincts.
R2 conserve une seule fondation. Omni Causal AR est un modèle causal pré-entraîné en continu sur des clips courts, des vidéos longues, des données multimodales et des trajectoires d’interaction. Real-Time Acceleration distille ensuite ce même modèle pour un usage en direct : l’élève est initialisé à partir de lui et l’enseignant est construit sur lui. La formule du rapport : « accélérer, pas réapprendre ».
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| Point de départ | Modèle bidirectionnel ajusté avec Diffusion-DPO | Modèle causal pré-entraîné en continu |
| Chemin vers le temps réel | Adaptation causale par blocs → Self-Replay Forcing → ajustement des préférences pour le streaming | Distiller directement le même modèle |
| Modèles | Modèles séparés pour l’avatar et l’édition | Un seul modèle pour tous les types d’entrée |
Le rapport de R2 décrit l’approche courante comme un relais en cinq étapes et soutient que chaque passage de témoin fait perdre une part des capacités. Lu sans détour, le pipeline de S2 a cette forme en plusieurs étapes, avec sa principale amélioration dans la dernière. Aucune des deux équipes n’a publié d’expérience comparant les deux voies ; savoir laquelle passe le mieux à l’échelle reste une question ouverte.
Choix 2 : empêcher le flux de dériver
La dérive est la panne typique de la vidéo en streaming : la couleur glisse, un visage devient peu à peu quelqu’un d’autre, et l’image finit par se casser. Cela vient du fait que l’entraînement montre au modèle un historique propre, alors qu’à l’inférence il ne voit que sa propre sortie imparfaite.
Les deux équipes partent du même correctif. Elles mélangent Teacher Forcing, qui conditionne sur l’historique réel et propre et protège la qualité, et Diffusion Forcing, qui conditionne sur un historique bruité à un niveau aléatoire. Le bruit efface les détails fins mais garde la composition et le mouvement ; le modèle apprend ainsi à s’appuyer sur la structure plutôt que sur chaque pixel du passé.
Un historique réel bruité n’équivaut pas pour autant aux propres erreurs du modèle ; chaque équipe ajoute donc une seconde couche.
S2 : Self-Replay Forcing. Le modèle génère d’abord une longue séquence exactement comme à l’inférence, sans conserver de gradients. Une fenêtre de cette trajectoire est rebruitée bloc par bloc puis rejouée en une seule passe causale avec gradients, entraînée avec une perte de distillation DMD et une perte perceptuelle. Comme les blocs rejoués se trouvent dans un même graphe de calcul, les gradients franchissent les frontières entre blocs — le modèle apprend comment un bloc façonne le suivant — sans rétropropager à travers la génération d’origine.
R2 : Error Bank. Des états d’échec représentatifs issus de la génération sont stockés et rejoués pendant l’entraînement aux côtés de l’historique normal, afin que le modèle apprenne à se rattraper une fois qu’une déviation est déjà entrée dans le monde. Dans l’évaluation interne d’étape de PixVerse, une métrique de dérive de luminosité à long terme est passée de 0,201 à 0,129, soit une baisse de 35,8 % ; 20 séquences longues sur 29 se sont améliorées, et le mouvement parasite a diminué dans les cinq échantillons sans mouvement.
Les deux approches se complètent plutôt qu’elles ne s’opposent. Self-Replay Forcing s’entraîne sur ce que le modèle actuel rate ; Error Bank fait répéter les échecs qui méritent d’être retenus.
Choix 3 : une mémoire bornée
Les deux conservent en permanence quelques blocs initiaux comme ancre (un sink), gardent une fenêtre glissante de blocs récents et abandonnent le reste, si bien que le coût d’un nouveau bloc n’augmente pas avec la longueur du flux. Les deux maintiennent aussi les coordonnées de position dans la plage vue à l’entraînement — S1 parle de repositionnement RoPE, R2 de RoPE temporel relatif —, de sorte qu’une longue session ne sort jamais les positions de la distribution.
S2 s’appuie sur le TwinCache de S1, où chaque bloc passé est mis en cache deux fois : une version bruitée et une version propre. Les étapes intermédiaires de débruitage lisent la copie bruitée, qui transmet le mouvement d’ensemble et agit comme un filtre passe-bas contre l’accumulation d’artefacts ; la dernière étape lit la copie propre pour restituer le détail. S2 répartit ce principe sur ses deux étages : le backbone lit un cache très bruité, le Refiner un cache haute résolution peu bruité.
R2 sépare la mémoire par échelle de temps : Sink Memory pour l’identité, l’environnement, le style et les règles du monde ; Rolling History pour le mouvement, la pose et la caméra récents ; et un Object KV Cache qui compresse l’état des objets qui comptera encore plus tard.
Ce découpage reflète les produits. Un personnage numérique doit rester la même personne. Un monde doit aussi se souvenir de ce qui s’y est passé — l’objet que vous avez posé, le choix que vous avez fait.
Choix 4 : d’où vient la vitesse
Les deux utilisent l’attention creuse et la distillation en peu d’étapes, mais ils placent leurs efforts à des endroits différents.
S2 mise sur l’ingénierie système, et la documente. L’attention est choisie couche par couche parmi SageAttention, SpargeAttention et l’attention creuse-linéaire, avec les approximations les plus agressives sur les couches les moins sensibles. Les couches linéaires tournent en multiplications matricielles W8A8 par blocs. Les opérateurs voisins sont fusionnés en noyaux Triton/CUDA et rejoués avec CUDA Graphs. Sur plusieurs GPU, S2 utilise le parallélisme de contexte de type Ulysses avec des communications quantifiées, et, dans le pipeline d’édition, l’encodeur VAE, le backbone, le Refiner et le décodeur se partagent les GPU sur une chronologie commune. La résolution vient d’un backbone basse résolution suivi d’un Refiner latent en une étape jusqu’au 720p.
R2 mise sur le modèle. L’attention creuse par blocs est apprise pendant l’entraînement et dépasse 90 % de parcimonie. La distillation suit Decoupled DMD — suivre le signal de contrôle et coller à l’enseignant sont optimisés comme deux objectifs distincts — avec un terme adversarial issu de DMD2 pour ancrer le réalisme. La résolution suit une pyramide : un ou deux étages basse résolution fixent la composition, le mouvement et la caméra, puis un dernier étage haute résolution ajoute la texture. Le rapport n’indique ni la résolution ni la fréquence d’images de sortie de R2.
Choix 5 : comment on le pilote
S2 enveloppe le modèle dans un agent VLM. L’agent classe chaque image de référence comme objet tenu, arrière-plan ou vêtement, puis écrit un prompt pour chaque segment couvrant l’identité, l’expression, le regard, la pose, l’action et les objets tenus, en conservant tout ce que l’utilisateur n’a pas demandé de changer. Après la génération, il passe les images en revue dans l’ordre, juge si l’action est terminée, à moitié faite ou ratée, et rédige le prompt suivant en conséquence. Pour mettre ou retirer un accessoire, les prompts décrivent à la fois le geste et l’état final, si bien qu’un chapeau remis reste sur la tête. En mode édition, l’attention alignée par image fait lire à chaque image de sortie uniquement l’image source du même instant, de sorte que le mouvement et le rythme correspondent exactement à l’entrée.
R2 intègre une interface d’entrée unique au modèle. Texte, références, audio, actions et contrôles générés par des agents entrent tous dans le même monde en cours d’exécution. La longueur des blocs suit le contrôle actif, dans une limite : une touche pressée reçoit des blocs courts pour répondre vite, un événement entier ou une portion d’audio des blocs plus longs pour rester cohérent. Au-dessus du modèle, le moteur de jeu de PixVerse ajoute une couche d’agents qui garde synchronisés l’état des règles du jeu et la scène générée.
Ce que chaque rapport publie
Avant de comparer les chiffres, comparez ce qui a été publié.
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| Format | Article sur arXiv | Article technique sur le site de PixVerse |
| Résolution et fréquence d’images | 720p, 25–42 FPS | Non précisé |
| Paramètres et latence de bout en bout | Non précisé | Non précisé |
| Benchmarks publics | Un pour l’avatar, quatre pour l’édition | Aucun ; évaluation interne uniquement |
| Poids | Non publiés ; API disponible | Non publiés |
Sur StreamAV-Bench, S2 se classe premier sur les neuf métriques publiées parmi 14 systèmes, dans sa propre évaluation : un alignement audio-vidéo de 0,353 contre 0,272 pour la meilleure alternative, et une erreur de synchronisation de 0,617 contre 0,648. Certains écarts se jouent à la troisième décimale : la cohérence du sujet est de 0,998 contre 0,997. Les chiffres publiés par R2 sont la baisse de 35,8 % de la dérive et une parcimonie d’attention supérieure à 90 %, qui, selon le rapport, préserve quatre dimensions de qualité internes, sans en donner les scores.
Il n’y a pas de comparaison directe. L’article de S2 se compare à PixVerse R1, la génération précédente, et R2 est sorti après.
Ce que cela signifie si vous faites de la vidéo avec des agents
Nous développons une application de bureau où des agents font le travail, et la vidéo fait partie des tâches qu’on leur confie. Deux enseignements de ces rapports s’appliquent.
D’abord, la frontière entre vidéo en direct et vidéo finie se précise. Les modèles en temps réel sont faits pour des expériences qui continuent de réagir — personnages, jeux, un flux que l’on restyle pendant sa lecture. L’essentiel du travail des créateurs aboutit encore à un fichier. Dans Orkas, VideoStudio transforme des rushes et un brief en un montage à relire et, quand un plan doit être généré, il utilise des modèles hors ligne : la génération vidéo gérée par Orkas, ou votre propre clé pour Seedance 2.0, Hailuo 2.3, Vidu Q3 Pro, Kling 3.0 Turbo, Veo 3.1 ou Runway Gen-4.5. Ni S2 ni R2 ne tournent aujourd’hui dans Orkas.
Ensuite, la couche de contrôle de S2 est une boucle d’agent : écrire le prompt, générer, regarder les images, décider de la suite. C’est la forme de tout agent qui travaille avec un modèle génératif, en temps réel ou non — et une bonne part du résultat dépend de cette boucle, pas seulement des poids.
Ce que nous en retenons
L’ossature s’est stabilisée : diffusion autorégressive causale par blocs, vidéo et audio générés ensemble, historique propre et bruité, un sink et une fenêtre, distillation de la famille DMD, attention creuse, basse résolution d’abord. Ce qui distingue S2 et R2, c’est l’endroit où ils placent leurs efforts : un relais de correctifs ciblés contre une fondation distillée une seule fois, un rejeu on-policy contre une banque d’échecs, l’ingénierie système contre une parcimonie apprise.
Les deux valent une lecture complète : l’article sur Vidu S2 pour le détail de l’entraînement et du déploiement, et le rapport sur PixVerse R2 pour son argument sur la mise à l’échelle d’un modèle en temps réel sans le réapprendre.