
इस महीने एक हफ़्ते के अंतर पर दो रियल-टाइम वीडियो मॉडल आए। ShengShu का Vidu S2 15 सितंबर को उपलब्ध हुआ और PixVerse ने 22 सितंबर को PixVerse R2 की घोषणा की। S2 को लाइव डिजिटल पात्रों और चलते वीडियो स्ट्रीम की शैली बदलने के लिए बनाया गया है। R2 स्वयं को रियल-टाइम वर्ल्ड मॉडल कहता है: ऐसा दृश्य जिसमें आप WASD से घूम सकते हैं, जबकि प्रॉम्प्ट, संदर्भ और ऑडियो आगे होने वाली घटना को बदलते हैं।
दोनों टीमों ने निर्माण का तरीका प्रकाशित किया है—S2 ने arXiv शोधपत्र में और R2 ने PixVerse वेबसाइट पर तकनीकी रिपोर्ट में। हमने दोनों को साथ पढ़ा। उनकी मूल संरचना एक जैसी है, पाँच डिज़ाइन विकल्पों में अंतर है और सार्वजनिक की गई जानकारी की मात्रा बहुत अलग है। यह लेख इन तीनों बातों पर है, किसी विजेता की घोषणा पर नहीं: दोनों को कभी एक ही परीक्षण में नहीं मापा गया।
रियल-टाइम मॉडल क्या बदलते हैं
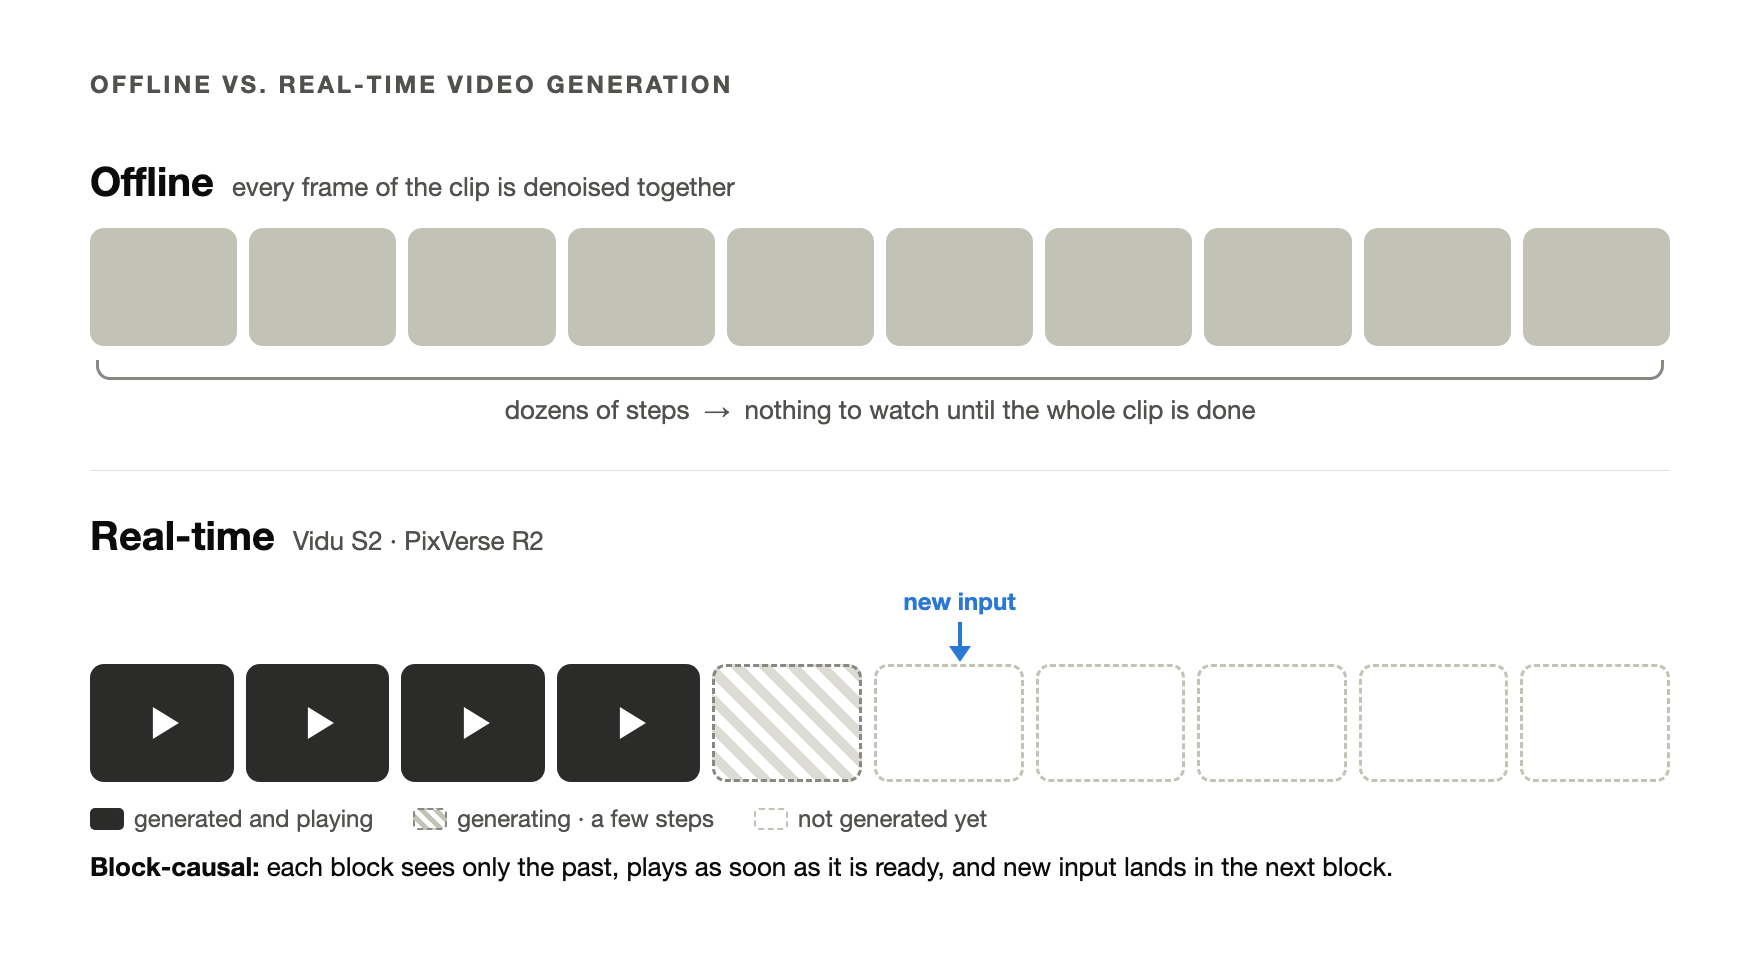
अधिकांश वीडियो मॉडल ऑफ़लाइन काम करते हैं। पूरे क्लिप के सभी फ़्रेमों से दर्जनों चरणों में एक साथ नॉइज़ हटाया जाता है और पूरा क्लिप बनने तक कुछ दिखाई नहीं देता। जनरेशन शुरू होने से पहले आपको अपनी सारी अपेक्षाएँ प्रॉम्प्ट में देनी पड़ती हैं।
रियल-टाइम मॉडल इसका उलटा करते हैं। वे वीडियो को ब्लॉक में बाँटते हैं—कुछ फ़्रेम और उनके अनुरूप ऑडियो का हिस्सा—और उन्हें क्रम से बनाते हैं। हर ब्लॉक को नॉइज़ हटाने के कुछ ही चरण मिलते हैं और तैयार होते ही वह चलने लगता है। ब्लॉक अपने पहले का हिस्सा देख सकता है, बाद का नहीं; इसी को ब्लॉक-कॉज़ल कहा जाता है। नया निर्देश अगले ब्लॉक पर लागू होता है।
इस व्यवस्था से तीन समस्याएँ पैदा होती हैं और नीचे दिए लगभग हर डिज़ाइन विकल्प का लक्ष्य इनमें से एक को हल करना है:
- गलतियाँ बढ़ती जाती हैं। हर ब्लॉक मॉडल के अपने बनाए पिछले ब्लॉक पर निर्भर है, इसलिए छोटी गलती भी आगे के सभी ब्लॉक में पहुँचती है।
- इतिहास सीमित रखना पड़ता है। स्ट्रीम अनिश्चित समय तक चल सकती है; सभी पुराने ब्लॉक रखने से हर नया ब्लॉक बनाना अधिक महँगा होता जाएगा।
- समय बहुत कम है। प्रति सेकंड 25 फ़्रेम पर हर फ़्रेम के लिए केवल 40 मिलीसेकंड मिलते हैं।
S2 और R2 की मूल संरचना समान है: वीडियो और ऑडियो साथ बनाने वाला ब्लॉक-कॉज़ल ऑटोरिग्रेसिव डिफ़्यूज़न मॉडल। अंतर इस बात में है कि वे इसे कैसे प्रशिक्षित करते हैं, स्थिर रखते हैं, स्मृति देते हैं, तेज़ बनाते हैं और लोगों को नियंत्रण देते हैं।
दोनों प्रणालियाँ
Vidu S2 (ShengShu Technology और Tsinghua University) में दो मॉडल हैं। S2-Avatar 720p और 25–42 FPS पर चलता लाइव डिजिटल पात्र है, जबकि S1 की रिज़ॉल्यूशन 540p थी। स्ट्रीम के बीच आप कप, जैकेट या समुद्र तट की नई संदर्भ छवि दे सकते हैं; पात्र उसे उठाता है, पहनता है या उस दृश्य में चला जाता है। वह नाच भी सकता है। S2-Editing आने वाली वीडियो स्ट्रीम को रियल-टाइम में नई शैली देता है—50 से अधिक शैलियाँ, वर्चुअल ट्राई-ऑन, पात्र और पृष्ठभूमि बदलना—जबकि स्रोत की गति बनी रहती है। शोधपत्र VR हेडसेट के लिए स्टीरियो आउटपुट की भी पड़ताल करता है।
PixVerse R2 इंटरैक्टिव दुनिया के लिए बना एक मॉडल है। चलते समय इसे चार प्रकार के इनपुट मिल सकते हैं—टेक्स्ट, मल्टीमॉडल संदर्भ, ऑडियो और WASD जैसी क्रियाएँ—और हर इनपुट सिर्फ़ मौजूदा फ़्रेम नहीं, पूरी दुनिया की स्थिति बदलता है। PixVerse का गेम इंजन अब R2 पर चलता है; सार्वजनिक डेमो गति और प्रॉम्प्ट पर केंद्रित है।
निर्णय 1: मॉडल को कैसे प्रशिक्षित किया जाता है
रियल-टाइम मॉडल शून्य से प्रशिक्षित नहीं किए जाते। सामान्य शुरुआत एक मज़बूत ऑफ़लाइन जनरेटिव आधार से होती है, जिसे फिर कम चरणों में कारण-क्रम के अनुसार चलाने के लिए बदला जाता है। इसी जगह दोनों रिपोर्ट सबसे स्पष्ट रूप से अलग होती हैं।
S2 कई चरणों वाला रास्ता लेता है। द्विदिश ऑडियो-वीडियो मॉडल को पहले प्रशिक्षित किया जाता है, फिर फ़िडेलिटी, अभिव्यक्ति, गति और ऑडियो-विज़ुअल तालमेल के लिए Diffusion-DPO से सुधारा जाता है। उसका अटेंशन ब्लॉक-कॉज़ल रूप में बदलकर साफ़ और शोर वाले इतिहास के मिश्रण पर प्रशिक्षित होता है (निर्णय 2)। फिर Self-Replay Forcing उसे अपने आउटपुट पर प्रशिक्षण देते हुए कुछ चरणों में डिस्टिल करता है और अंत में स्ट्रीमिंग वरीयता का चरण (Streaming NFT) कॉज़ल मॉडल को सुधारता है। Avatar और editing को अलग-अलग मॉडल के रूप में प्रशिक्षित किया जाता है।
R2 एक ही आधार बनाए रखता है। Omni Causal AR एक कॉज़ल मॉडल है जिसे छोटे क्लिप, लंबे वीडियो, मल्टीमॉडल डेटा और इंटरैक्शन ट्रैजेक्टरी पर लगातार प्रीट्रेन किया जाता है। फिर Real-Time Acceleration उसी मॉडल को लाइव उपयोग के लिए डिस्टिल करता है: छात्र मॉडल की शुरुआत उसी से होती है और शिक्षक मॉडल भी उसी पर बनाया जाता है। रिपोर्ट की भाषा में, “तेज़ करो, फिर से मत सिखाओ।”
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| शुरुआत | Diffusion-DPO से सुधारा गया द्विदिश मॉडल | लगातार प्रीट्रेन किया गया कॉज़ल मॉडल |
| रियल-टाइम तक का रास्ता | ब्लॉक-कॉज़ल रूपांतरण → Self-Replay Forcing → स्ट्रीमिंग वरीयता प्रशिक्षण | उसी मॉडल को सीधे डिस्टिल करना |
| मॉडल | Avatar और editing के अलग मॉडल | हर इनपुट प्रकार के लिए एक मॉडल |
R2 की रिपोर्ट सामान्य तरीके को पाँच चरणों की शृंखला के रूप में दिखाती है और तर्क देती है कि हर हस्तांतरण में कुछ क्षमता खोती है। सीधे पढ़ने पर S2 की प्रक्रिया इसी बहु-चरणीय रूप की है, जिसमें मुख्य सुधार आख़िरी चरण में है। किसी भी टीम ने दोनों रास्तों की तुलना करने वाला प्रयोग प्रकाशित नहीं किया, इसलिए बेहतर स्केलिंग किसकी है, यह अभी खुला प्रश्न है।
निर्णय 2: स्ट्रीम को भटकने से रोकना
स्ट्रीमिंग वीडियो की प्रमुख विफलता ड्रिफ़्ट है: रंग धीरे-धीरे बदलते हैं, चेहरा किसी और जैसा होने लगता है और अंततः फ़्रेम बिगड़ जाता है। कारण यह है कि प्रशिक्षण में मॉडल को साफ़ इतिहास दिखाया जाता है, जबकि उपयोग के समय उसे अपने ही अपूर्ण आउटपुट दिखाई देते हैं।
दोनों टीम एक ही सुधार से शुरू करती हैं। वे Teacher Forcing को, जो साफ़ वास्तविक इतिहास के आधार पर गुणवत्ता बनाए रखता है, Diffusion Forcing के साथ मिलाती हैं, जो इतिहास में यादृच्छिक स्तर का नॉइज़ जोड़ता है। नॉइज़ बारीकियाँ मिटा देता है, लेकिन संरचना और गति बची रहती हैं; इस तरह मॉडल पुराने हर पिक्सेल पर भरोसा करने के बजाय संरचना पर निर्भर रहना सीखता है।
नॉइज़ वाला वास्तविक इतिहास फिर भी मॉडल की अपनी गलतियों जैसा नहीं है, इसलिए हर टीम दूसरी परत जोड़ती है।
S2: Self-Replay Forcing. मॉडल पहले बिना ग्रेडिएंट सहेजे, ठीक उपयोग के समय की तरह एक लंबा क्रम बनाता है। उस क्रम की एक विंडो में हर ब्लॉक पर फिर से नॉइज़ जोड़ा जाता है और ग्रेडिएंट सक्षम एक ही कॉज़ल पास में उसे दोहराया जाता है; प्रशिक्षण में DMD डिस्टिलेशन लॉस और परसेप्चुअल लॉस लगते हैं। दोहराए गए ब्लॉक एक ही कम्प्यूटेशन ग्राफ़ में होने के कारण ग्रेडिएंट ब्लॉक की सीमाएँ पार करते हैं। मॉडल सीखता है कि एक ब्लॉक अगले को कैसे प्रभावित करता है, जबकि मूल बनाए गए क्रम में पीछे तक बैकप्रॉपगेशन नहीं करना पड़ता।
R2: Error Bank. जनरेशन के प्रतिनिधि विफलता-स्थितियों को संग्रहित करके सामान्य इतिहास के साथ प्रशिक्षण में फिर दिखाया जाता है, ताकि दुनिया में विचलन आने के बाद मॉडल वापसी करना सीखे। PixVerse के आंतरिक चरण मूल्यांकन में लंबे समय का ब्राइटनेस-ड्रिफ़्ट माप 0.201 से 0.129 पर आया—35.8% कमी; 29 में से 20 लंबे क्रम बेहतर हुए और बिना गति वाले सभी पाँच नमूनों में अनचाही गति घटी।
दोनों तरीके प्रतिस्पर्धी से अधिक पूरक हैं। Self-Replay Forcing वर्तमान मॉडल की गलतियों पर प्रशिक्षण देता है; Error Bank याद रखने योग्य विफलताओं का अभ्यास कराता है।
निर्णय 3: सीमित रहने वाली स्मृति
दोनों शुरुआती कुछ ब्लॉक को स्थायी आधार (sink) के रूप में रखते हैं, हाल के ब्लॉक की चलती विंडो रखते हैं और बाकी हटा देते हैं। इससे स्ट्रीम लंबी होने पर भी नया ब्लॉक बनाने की लागत नहीं बढ़ती। दोनों पोज़िशनल निर्देशांकों को प्रशिक्षण में देखी गई सीमा के भीतर रखते हैं—S1 इसे RoPE repositioning और R2 relative temporal RoPE कहता है—ताकि लंबा सत्र पोज़िशन को प्रशिक्षण वितरण से बाहर न ले जाए।
S2, S1 के TwinCache को आगे बढ़ाता है, जिसमें हर पुराने ब्लॉक को दो बार संग्रहित किया जाता है: एक शोरयुक्त और एक साफ़ प्रति। नॉइज़ हटाने के बीच के चरण शोरयुक्त प्रति पढ़ते हैं, जो मोटे स्तर की गति रखती है और जमा होती विकृतियों के विरुद्ध लो-पास फ़िल्टर जैसी काम करती है; आख़िरी चरण बारीकियाँ लौटाने के लिए साफ़ प्रति पढ़ता है। S2 इसे अपने दो चरणों में बाँटता है: backbone अधिक शोर वाला कैश और Refiner कम शोर वाला, उच्च रिज़ॉल्यूशन कैश पढ़ता है।
R2 स्मृति को समय-सीमा के अनुसार बाँटता है: पहचान, परिवेश, शैली और दुनिया के नियमों के लिए Sink Memory; हाल की गति, मुद्रा और कैमरे के लिए Rolling History; और बाद में भी महत्त्वपूर्ण रहने वाली वस्तुओं की स्थिति को संकुचित करने वाला Object KV Cache।
यह विभाजन दोनों उत्पादों जैसा है। डिजिटल पात्र वही व्यक्ति बना रहना चाहिए। दुनिया को यह भी याद रखना होता है कि उसमें क्या हुआ—आपने कौन-सी चीज़ रखी या क्या चुनाव किया।
निर्णय 4: गति कहाँ से आती है
दोनों sparse attention और कुछ चरणों वाले distillation का उपयोग करते हैं, लेकिन मेहनत अलग जगह लगाते हैं।
S2 सिस्टम इंजीनियरिंग पर निर्भर है और उसके विवरण देता है। हर लेयर के लिए SageAttention, SpargeAttention और sparse-linear attention में से चुनाव होता है; सबसे आक्रामक अनुमान उन लेयर पर लगते हैं जो कम संवेदनशील हैं। लीनियर लेयर हर ब्लॉक के लिए W8A8 मैट्रिक्स गुणन करती हैं। पास के ऑपरेटर Triton/CUDA कर्नेल में मिलाए जाते हैं और CUDA Graphs से दोहराए जाते हैं। कई GPU वाले रन क्वांटाइज़्ड संचार के साथ Ulysses context parallelism इस्तेमाल करते हैं। Editing प्रक्रिया में VAE encoder, backbone, Refiner और decoder एक ही समयरेखा पर GPU साझा करते हैं। कम रिज़ॉल्यूशन वाला backbone और एक-चरण latent Refiner मिलकर 720p तक पहुँचते हैं।
R2 मॉडल पर निर्भर है। ब्लॉक स्तर का sparse attention प्रशिक्षण में सीखा जाता है और 90% से अधिक sparsity हासिल करता है। Distillation में Decoupled DMD अपनाया जाता है—नियंत्रण संकेत का पालन और शिक्षक मॉडल से मिलान अलग लक्ष्य हैं—साथ ही वास्तविकता बनाए रखने के लिए DMD2 का adversarial term जोड़ा जाता है। रिज़ॉल्यूशन पिरामिड के रूप में बढ़ता है: कम रिज़ॉल्यूशन वाले एक या दो चरण संरचना, गति और कैमरा तय करते हैं; आख़िरी उच्च रिज़ॉल्यूशन चरण टेक्सचर जोड़ता है। रिपोर्ट R2 की आउटपुट रिज़ॉल्यूशन या फ़्रेम दर नहीं बताती।
निर्णय 5: लोग इसे कैसे नियंत्रित करते हैं
S2 मॉडल के आसपास VLM एजेंट लगाता है। एजेंट हर संदर्भ छवि को पकड़ी हुई वस्तु, पृष्ठभूमि या कपड़ों के रूप में वर्गीकृत करता है। फिर हर खंड के लिए पहचान, अभिव्यक्ति, नज़र, मुद्रा, क्रिया और पकड़ी वस्तुओं को समेटकर प्रॉम्प्ट लिखता है; उपयोगकर्ता ने जिसे बदलने को नहीं कहा, उसे वैसा ही रखता है। जनरेशन के बाद वह फ़्रेम क्रम से देखता है, तय करता है कि क्रिया पूरी हुई, आधी हुई या गलत हुई, और उसी अनुसार अगला प्रॉम्प्ट लिखता है। सामान पहनाने या उतारने के लिए प्रॉम्प्ट गति और अंतिम स्थिति दोनों बताते हैं, ताकि दोबारा पहनी गई टोपी पहनी रहे। Editing मोड में फ़्रेम-अलाइन अटेंशन हर आउटपुट फ़्रेम को उसी क्षण का स्रोत फ़्रेम पढ़ने देता है, इसलिए गति और समय इनपुट से ठीक मेल खाते हैं।
R2 मॉडल में एक ही इनपुट इंटरफ़ेस बनाता है। टेक्स्ट, संदर्भ, ऑडियो, क्रियाएँ और एजेंट द्वारा बनाए गए नियंत्रण, सभी एक ही चलती दुनिया में जाते हैं। ब्लॉक की लंबाई सक्रिय नियंत्रण के अनुसार, तय अधिकतम सीमा तक बदलती है: कुंजी दबाने पर तेज़ प्रतिक्रिया के लिए छोटे ब्लॉक मिलते हैं, जबकि पूरे इवेंट या ऑडियो के हिस्से को संगत रखने के लिए लंबे ब्लॉक मिलते हैं। मॉडल के ऊपर PixVerse का गेम इंजन एक एजेंट परत जोड़ता है, जो गेम नियमों की स्थिति और बने हुए दृश्य को एक साथ रखती है।
हर रिपोर्ट क्या बताती है
आँकड़ों की तुलना से पहले देखें कि क्या प्रकाशित हुआ है।
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| प्रारूप | arXiv शोधपत्र | PixVerse साइट पर तकनीकी लेख |
| रिज़ॉल्यूशन और फ़्रेम दर | 720p, 25–42 FPS | नहीं बताई गई |
| पैरामीटर और कुल विलंब | नहीं बताए गए | नहीं बताए गए |
| सार्वजनिक बेंचमार्क | एक Avatar बेंचमार्क, चार editing बेंचमार्क | कोई नहीं; केवल आंतरिक मूल्यांकन |
| वेट | जारी नहीं किए गए; API उपलब्ध है | जारी नहीं किए गए |
अपने मूल्यांकन में StreamAV-Bench पर S2, 14 प्रणालियों के बीच बताए गए सभी नौ मापों में पहले स्थान पर है: ऑडियो-विज़ुअल अलाइनमेंट 0.353 बनाम सर्वश्रेष्ठ विकल्प का 0.272 और सिंक्रनाइज़ेशन त्रुटि 0.617 बनाम 0.648। कुछ अंतर तीसरे दशमलव स्थान पर हैं—पात्र की निरंतरता 0.998 बनाम 0.997। R2 के प्रकाशित आँकड़े 35.8% ड्रिफ़्ट कमी और 90% से अधिक अटेंशन sparsity हैं। रिपोर्ट कहती है कि इससे गुणवत्ता के चार आंतरिक पहलू बने रहते हैं, लेकिन उनके स्कोर नहीं देती।
सीधी तुलना नहीं है। S2 का शोधपत्र पिछले PixVerse R1 से तुलना करता है; R2 बाद में जारी हुआ था।
एजेंटों से वीडियो बनाने वालों के लिए इसका अर्थ
हम ऐसा डेस्कटॉप ऐप बनाते हैं जिसमें एजेंट काम करते हैं, और वीडियो उन कामों में से एक है जो लोग उन्हें सौंपते हैं। इन रिपोर्टों की दो बातें इस संदर्भ में लागू होती हैं।
पहली, लाइव और तैयार वीडियो के बीच अंतर बढ़ रहा है। रियल-टाइम मॉडल लगातार प्रतिक्रिया देने वाले अनुभवों के लिए बने हैं—पात्र, गेम और ऐसी स्ट्रीम जिसकी शैली चलते समय बदलें। अधिकांश क्रिएटर का काम अब भी किसी फ़ाइल पर समाप्त होता है। Orkas में, VideoStudio फ़ुटेज और ब्रीफ़ को समीक्षा योग्य कट में बदलता है। जब कोई शॉट बनाना हो तो वह ऑफ़लाइन मॉडल उपयोग करता है: Orkas द्वारा संचालित वीडियो जनरेशन, या Seedance 2.0, Hailuo 2.3, Vidu Q3 Pro, Kling 3.0 Turbo, Veo 3.1 अथवा Runway Gen-4.5 के लिए आपकी अपनी कुंजी। आज Orkas के भीतर न S2 चलता है, न R2।
दूसरी, S2 की नियंत्रण परत एक एजेंट लूप है: प्रॉम्प्ट लिखना, बनाना, फ़्रेम देखना और अगला कदम तय करना। जनरेशन मॉडल के साथ काम करने वाले किसी भी एजेंट की यही संरचना है, चाहे वह रियल-टाइम हो या नहीं। परिणाम का बड़ा हिस्सा इस लूप पर निर्भर है, केवल मॉडल के वेट पर नहीं।
हमारा निष्कर्ष
मूल संरचना तय हो चुकी है: ब्लॉक-कॉज़ल ऑटोरिग्रेसिव डिफ़्यूज़न, वीडियो और ऑडियो की संयुक्त जनरेशन, साफ़ और शोर वाले इतिहास का मिश्रण, sink और window, DMD परिवार का distillation, sparse attention और पहले कम रिज़ॉल्यूशन। S2 और R2 में अंतर यह है कि वे प्रयास कहाँ लगाते हैं—विशेष सुधारों की शृंखला बनाम एक आधार मॉडल का एक बार distillation, मौजूदा मॉडल की गलतियों को दोहराना बनाम विफलताओं का भंडार, सिस्टम इंजीनियरिंग बनाम सीखी हुई sparsity।
दोनों को पूरा पढ़ना चाहिए: प्रशिक्षण और सेवा के विवरण के लिए Vidu S2 शोधपत्र और मॉडल को फिर से प्रशिक्षित किए बिना रियल-टाइम स्केलिंग के तर्क के लिए PixVerse R2 रिपोर्ट।