
Questo mese sono usciti due modelli video in tempo reale a una settimana di distanza. Vidu S2 di ShengShu è stato reso disponibile il 15 settembre, e PixVerse ha annunciato PixVerse R2 il 22 settembre. S2 è pensato per personaggi digitali dal vivo e per trasformare lo stile di un flusso video mentre scorre. R2 si presenta come un modello di mondo in tempo reale: una scena che percorri con WASD mentre testi, riferimenti e audio cambiano ciò che succede dopo.
Entrambi i team hanno pubblicato come l’hanno costruito: S2 in un articolo su arXiv, R2 in un rapporto tecnico sul sito di PixVerse. Li abbiamo letti in parallelo. Concordano sullo scheletro, si dividono su cinque scelte progettuali e rendono pubbliche quantità di informazioni molto diverse. Questo articolo tratta tutti e tre gli aspetti e, di proposito, non nomina un vincitore: i due non sono mai stati misurati sullo stesso test.
Che cosa cambia il tempo reale
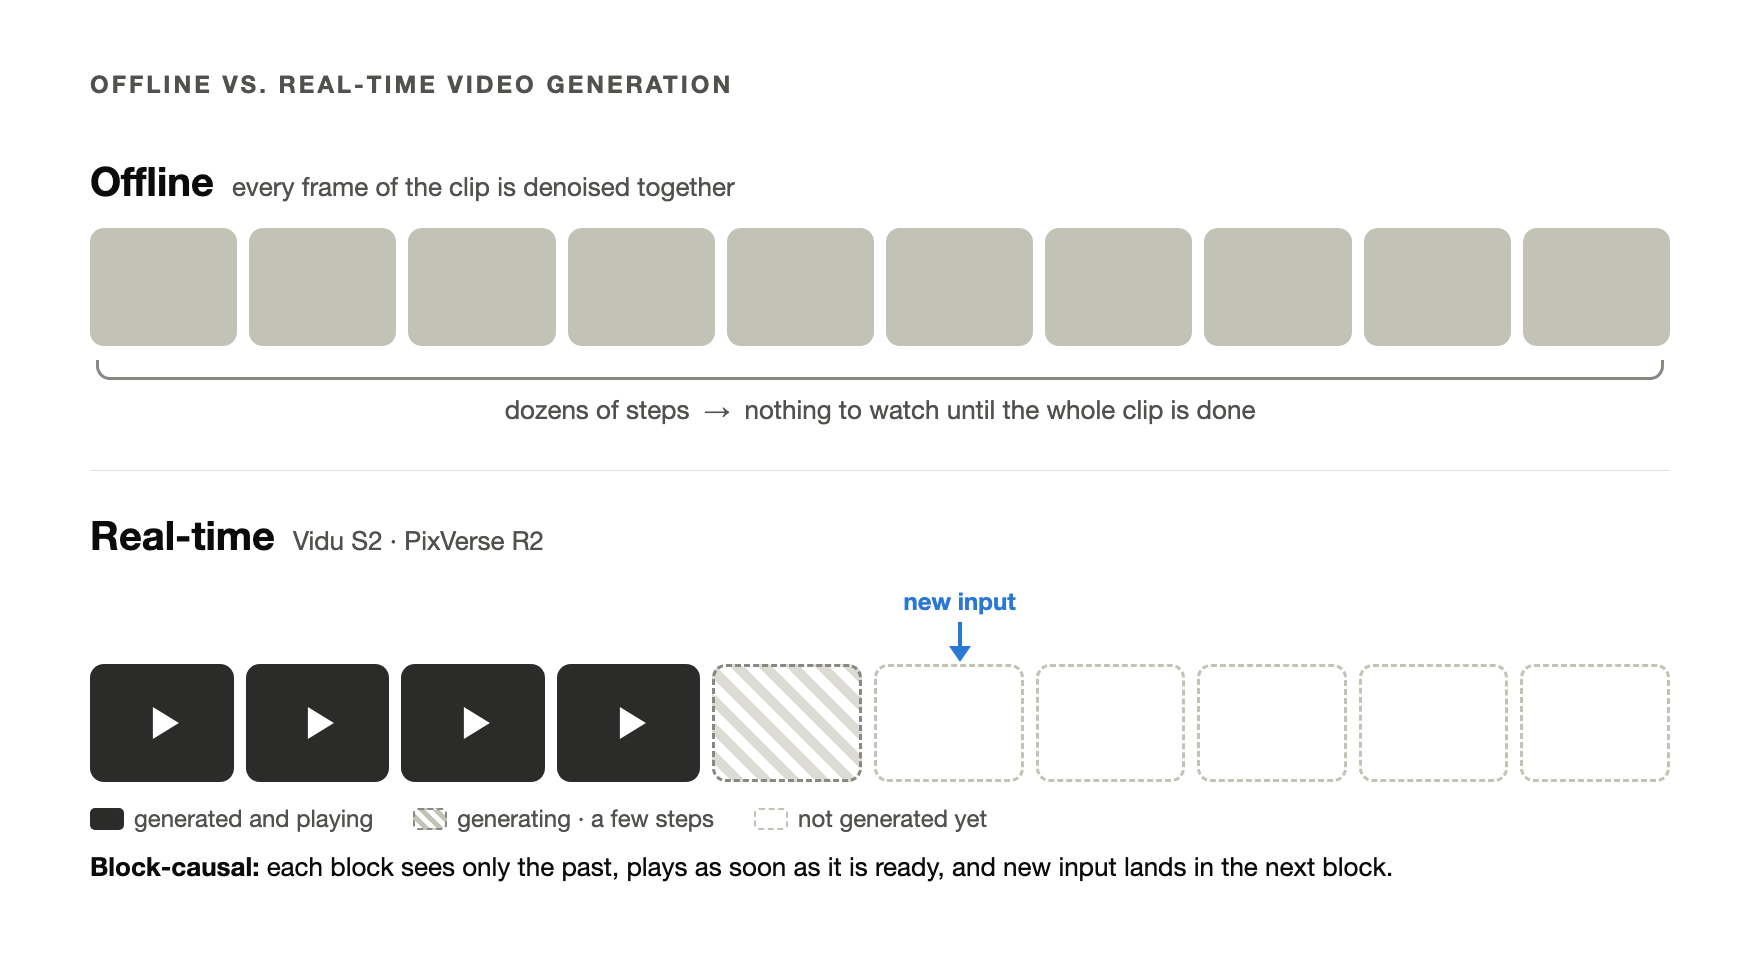
La maggior parte dei modelli video lavora offline. Tutti i fotogrammi di una clip vengono ripuliti dal rumore insieme, in decine di passaggi, e non si vede nulla finché l’intera clip non è pronta. Tutto ciò che vuoi deve stare nel prompt prima che la generazione inizi.
Un modello in tempo reale ribalta questa logica. Divide il video in blocchi — pochi fotogrammi più la porzione di audio corrispondente — e li genera in ordine. Ogni blocco riceve solo pochi passaggi di rimozione del rumore e viene riprodotto appena è pronto. Un blocco vede ciò che viene prima ma mai ciò che viene dopo: è questo il significato di causale a blocchi. Una nuova istruzione entra nel blocco successivo.
Questa forma crea tre problemi, e quasi tutte le scelte che seguono rispondono a uno di essi:
- Gli errori si accumulano. Ogni blocco è condizionato da blocchi generati dal modello stesso, quindi un piccolo errore viene ereditato da tutto ciò che segue.
- La cronologia deve restare limitata. Un flusso può durare all’infinito; conservare tutti i blocchi passati renderebbe ogni nuovo blocco più costoso.
- Il budget di tempo è spietato. A 25 fotogrammi al secondo, ogni fotogramma ha 40 millisecondi.
S2 e R2 arrivano allo stesso scheletro: un modello di diffusione autoregressivo e causale a blocchi che genera video e audio insieme. Le differenze stanno in come lo addestrano, lo mantengono stabile, gli danno memoria, lo rendono veloce e lo fanno controllare alle persone.
I due sistemi
Vidu S2 (ShengShu Technology con l’Università Tsinghua) comprende due modelli. S2-Avatar è un personaggio digitale dal vivo a 720p e 25–42 FPS, contro i 540p di S1. Puoi dargli una nuova immagine di riferimento a trasmissione in corso — una tazza, una giacca, una spiaggia — e il personaggio la prende, la indossa o entra nella scena; sa anche ballare. S2-Editing trasforma in tempo reale lo stile di un flusso video in ingresso — oltre 50 stili, prova virtuale degli abiti, sostituzione del soggetto e dello sfondo — mantenendo intatto il movimento originale. L’articolo esplora anche un’uscita stereo per visori di realtà virtuale.
PixVerse R2 è un unico modello pensato per mondi interattivi. Mentre è in esecuzione possono arrivare quattro tipi di input — testo, riferimenti multimodali, audio e azioni come WASD — e ognuno aggiorna lo stato del mondo, non solo il fotogramma corrente. Il motore di gioco di PixVerse ora gira su R2; la demo pubblica si concentra su movimento e prompt.
Scelta 1: come viene addestrato il modello
I modelli in tempo reale non si addestrano da zero. Il punto di partenza abituale è un solido prior generativo offline, poi convertito per funzionare in modo causale e in pochi passaggi. È qui che i due rapporti divergono in modo più aperto.
S2 procede a staffetta. Un modello audio-video bidirezionale viene pre-addestrato e poi ottimizzato con Diffusion-DPO per fedeltà, espressività, movimento e sincronizzazione tra audio e video. L’attenzione passa a causale a blocchi e viene addestrata su un mix di cronologia pulita e rumorosa (scelta 2). Poi Self-Replay Forcing lo distilla in pochi passaggi mentre si addestra sui propri output, e un’ultima fase di preferenze per lo streaming (Streaming NFT) mette a punto il modello causale. Avatar ed editing sono addestrati come modelli separati.
R2 mantiene un’unica base. Omni Causal AR è un modello causale pre-addestrato in modo continuo su clip brevi, video lunghi, dati multimodali e traiettorie di interazione. Real-Time Acceleration distilla poi lo stesso modello per l’uso dal vivo: lo studente viene inizializzato da esso e l’insegnante è costruito su di esso. La formula del rapporto è «accelerare, non riapprendere».
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| Punto di partenza | Modello bidirezionale ottimizzato con Diffusion-DPO | Modello causale pre-addestrato in modo continuo |
| Percorso verso il tempo reale | Adattamento causale a blocchi → Self-Replay Forcing → ottimizzazione delle preferenze per lo streaming | Distillare direttamente lo stesso modello |
| Modelli | Modelli separati per avatar ed editing | Un solo modello per ogni tipo di input |
Il rapporto di R2 descrive l’approccio comune come una staffetta in cinque fasi e sostiene che ogni passaggio di consegne faccia perdere una parte delle capacità. Letta in modo diretto, la pipeline di S2 ha proprio questa forma a più fasi, con il miglioramento principale nell’ultima. Nessuno dei due team ha pubblicato un esperimento che confronti i due percorsi, quindi quale scali meglio resta una domanda aperta.
Scelta 2: impedire al flusso di andare alla deriva
La deriva è il difetto tipico del video in streaming: il colore scivola, un volto diventa a poco a poco quello di un’altra persona e alla fine l’immagine si rompe. Succede perché l’addestramento mostra al modello una cronologia pulita, mentre in inferenza vede solo il proprio output imperfetto.
Entrambi i team partono dalla stessa soluzione. Mescolano Teacher Forcing, che condiziona sulla cronologia reale e pulita e protegge la qualità, con Diffusion Forcing, che condiziona su una cronologia con rumore di livello casuale. Il rumore cancella i dettagli fini ma conserva composizione e movimento, quindi il modello impara ad appoggiarsi alla struttura invece di fidarsi di ogni pixel del passato.
Una cronologia reale con rumore non coincide comunque con gli errori del modello stesso, quindi ogni team aggiunge un secondo livello.
S2: Self-Replay Forcing. Prima il modello genera un lungo tratto esattamente come farebbe in inferenza, senza conservare gradienti. Una finestra di quella traiettoria viene di nuovo resa rumorosa blocco per blocco e rigiocata in un unico passaggio causale con gradienti, addestrato con una perdita di distillazione DMD più una perdita percettiva. Poiché i blocchi rigiocati stanno in un unico grafo di calcolo, i gradienti attraversano i confini tra blocchi — il modello impara come un blocco influenza il successivo — senza retropropagare attraverso la generazione originale.
R2: Error Bank. Stati di errore rappresentativi prodotti durante la generazione vengono salvati e rigiocati in addestramento insieme alla cronologia normale, così il modello impara a riprendersi quando una deviazione è già entrata nel mondo. Nella valutazione interna di fase di PixVerse, una metrica di deriva della luminosità a lungo termine è scesa da 0,201 a 0,129, con una riduzione del 35,8%; 20 sequenze lunghe su 29 sono migliorate e il movimento spurio è diminuito in tutti e cinque i campioni senza movimento.
I due approcci sono complementari, non in competizione. Self-Replay Forcing si addestra su ciò che il modello attuale sbaglia; Error Bank fa esercitare più volte gli errori che vale la pena ricordare.
Scelta 3: una memoria limitata
Entrambi conservano in modo permanente alcuni blocchi iniziali come ancora (un sink), mantengono una finestra scorrevole di blocchi recenti e scartano il resto, così il costo di un nuovo blocco non cresce con la durata del flusso. Entrambi mantengono anche le coordinate di posizione nell’intervallo visto in addestramento — S1 lo chiama riposizionamento di RoPE, R2 RoPE temporale relativo — in modo che una sessione lunga non spinga mai le posizioni fuori distribuzione.
S2 parte dal TwinCache di S1, in cui ogni blocco passato viene memorizzato due volte: una versione rumorosa e una pulita. I passaggi intermedi di rimozione del rumore leggono la copia rumorosa, che trasmette il movimento generale e agisce come un filtro passa-basso contro l’accumulo di artefatti; l’ultimo passaggio legge la copia pulita per recuperare i dettagli. S2 distribuisce questo schema sulle sue due fasi: il backbone legge una cache molto rumorosa, il Refiner una cache ad alta risoluzione poco rumorosa.
R2 separa la memoria per scala temporale: Sink Memory per identità, ambiente, stile e regole del mondo; Rolling History per movimento, posa e inquadratura recenti; e una Object KV Cache che comprime lo stato degli oggetti che conterà ancora più avanti.
La suddivisione rispecchia i prodotti. Un personaggio digitale deve restare la stessa persona. Un mondo deve anche ricordare ciò che vi è accaduto: l’oggetto che hai posato, la scelta che hai fatto.
Scelta 4: da dove arriva la velocità
Entrambi usano attenzione sparsa e distillazione in pochi passaggi, ma concentrano gli sforzi in punti diversi.
S2 punta sull’ingegneria dei sistemi, e la documenta. L’attenzione viene scelta strato per strato tra SageAttention, SpargeAttention e attenzione sparsa-lineare, con le approssimazioni più aggressive negli strati meno sensibili. Gli strati lineari girano come moltiplicazioni di matrici W8A8 a blocchi. Gli operatori adiacenti vengono fusi in kernel Triton/CUDA e rigiocati con CUDA Graphs. Su più GPU si usa il parallelismo di contesto in stile Ulysses con comunicazione quantizzata, e nella pipeline di editing l’encoder VAE, il backbone, il Refiner e il decoder condividono le GPU su una linea temporale comune. La risoluzione deriva da un backbone a bassa risoluzione più un Refiner latente a un passaggio fino a 720p.
R2 punta sul modello. L’attenzione sparsa a blocchi viene appresa durante l’addestramento e supera il 90% di sparsità. La distillazione segue Decoupled DMD — seguire il segnale di controllo e aderire all’insegnante sono ottimizzati come obiettivi separati — più un termine avversariale ripreso da DMD2 per mantenere il realismo. La risoluzione segue una piramide: una o due fasi a bassa risoluzione fissano composizione, movimento e inquadratura, e una fase finale ad alta risoluzione aggiunge la texture. Il rapporto non indica la risoluzione né il frame rate in uscita di R2.
Scelta 5: come lo controllano le persone
S2 avvolge il modello in un agente VLM. L’agente classifica ogni immagine di riferimento come oggetto in mano, sfondo o abbigliamento, poi scrive un prompt per ogni segmento che copre identità, espressione, sguardo, posa, azione e oggetti tenuti in mano, mantenendo tutto ciò che l’utente non ha chiesto di cambiare. Dopo la generazione rivede i fotogrammi in ordine, valuta se l’azione è conclusa, fatta a metà o sbagliata, e scrive il prompt successivo di conseguenza. Per indossare o togliere accessori, i prompt descrivono sia il movimento sia lo stato finale, così un cappello rimesso resta in testa. In modalità editing, l’attenzione allineata ai fotogrammi fa leggere a ogni fotogramma in uscita solo il fotogramma sorgente dello stesso istante, così movimento e tempi coincidono esattamente con l’input.
R2 integra un’unica interfaccia di input nel modello. Testo, riferimenti, audio, azioni e controlli generati da agenti entrano tutti nello stesso mondo in esecuzione. La lunghezza dei blocchi segue il controllo attivo, fino a un limite: la pressione di un tasto riceve blocchi brevi per rispondere in fretta, un intero evento o un tratto di audio blocchi più lunghi per restare coerenti. Sopra il modello, il motore di gioco di PixVerse aggiunge un livello di agenti che mantiene sincronizzati lo stato delle regole di gioco e la scena generata.
Che cosa rende pubblico ciascun rapporto
Prima di confrontare i numeri, confronta ciò che è stato pubblicato.
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| Formato | Articolo su arXiv | Articolo tecnico sul sito di PixVerse |
| Risoluzione e frame rate | 720p, 25–42 FPS | Non indicati |
| Parametri e latenza end-to-end | Non indicati | Non indicati |
| Benchmark pubblici | Uno per l’avatar, quattro per l’editing | Nessuno; solo valutazione interna |
| Pesi | Non rilasciati; API disponibile | Non rilasciati |
Su StreamAV-Bench, S2 è primo in tutte e nove le metriche riportate tra 14 sistemi, nella propria valutazione: allineamento audio-video di 0,353 contro 0,272 della migliore alternativa, ed errore di sincronizzazione di 0,617 contro 0,648. Alcuni margini stanno alla terza cifra decimale: la coerenza del soggetto è 0,998 contro 0,997. I numeri pubblicati per R2 sono la riduzione del 35,8% della deriva e una sparsità dell’attenzione superiore al 90%, che secondo il rapporto preserva quattro dimensioni di qualità interne, senza fornire i punteggi.
Non c’è un confronto diretto. L’articolo di S2 si confronta con PixVerse R1, la generazione precedente, e R2 è uscito dopo.
Che cosa significa se fai video con gli agenti
Sviluppiamo un’app desktop in cui sono gli agenti a fare il lavoro, e il video è uno dei compiti che le persone affidano loro. Da questi rapporti si possono portare a casa due cose.
Primo, il confine tra video dal vivo e video finito si fa più netto. I modelli in tempo reale sono pensati per esperienze che continuano a reagire: personaggi, giochi, un flusso a cui cambi stile mentre scorre. Gran parte del lavoro dei creator finisce ancora in un file. In Orkas, VideoStudio trasforma girato e brief in un montaggio da rivedere e, quando un’inquadratura va generata, usa modelli offline: la generazione video gestita da Orkas oppure la tua chiave per Seedance 2.0, Hailuo 2.3, Vidu Q3 Pro, Kling 3.0 Turbo, Veo 3.1 o Runway Gen-4.5. Né S2 né R2 girano oggi all’interno di Orkas.
Secondo, il livello di controllo di S2 è un ciclo di agente: scrivere il prompt, generare, guardare i fotogrammi, decidere il passo successivo. È la stessa forma di qualunque agente che lavori con un modello generativo, in tempo reale o no, e buona parte del risultato dipende da quel ciclo, non solo dai pesi.
Che cosa ne ricaviamo
Lo scheletro si è stabilizzato: diffusione autoregressiva causale a blocchi, video e audio generati insieme, cronologia pulita più cronologia rumorosa, un sink e una finestra, distillazione della famiglia DMD, attenzione sparsa, prima la bassa risoluzione. Ciò che separa S2 e R2 è dove investono gli sforzi: una staffetta di correzioni mirate contro una base distillata una sola volta, il replay on-policy contro una banca di errori, l’ingegneria dei sistemi contro la sparsità appresa.
Vale la pena leggerli entrambi per intero: l’articolo su Vidu S2 per i dettagli di addestramento e di servizio, e il rapporto su PixVerse R2 per la tesi su come far crescere un modello in tempo reale senza riapprenderlo.