
เดือนนี้มีโมเดลสร้างวิดีโอแบบเรียลไทม์สองตัวเปิดตัวห่างกันเพียงหนึ่งสัปดาห์ Vidu S2 ของ ShengShu เปิดให้ใช้งานวันที่ 15 กันยายน และ PixVerse ประกาศ PixVerse R2 วันที่ 22 กันยายน S2 มุ่งที่ตัวละครดิจิทัลแบบสดและการเปลี่ยนสไตล์สตรีมวิดีโอระหว่างเล่น ส่วน R2 เรียกตัวเองว่าโมเดลโลกแบบเรียลไทม์: ฉากที่คุณเดินสำรวจด้วย WASD ขณะที่พรอมป์ต์ ภาพอ้างอิง และเสียงเปลี่ยนสิ่งที่จะเกิดขึ้นต่อไป
ทั้งสองทีมเผยแพร่วิธีสร้างโมเดล โดย S2 เป็น บทความบน arXiv และ R2 เป็น รายงานทางเทคนิคบนเว็บไซต์ PixVerse เราอ่านทั้งสองฉบับเทียบกัน พบว่าโครงหลักตรงกัน แต่ต่างกันในทางเลือกด้านการออกแบบห้าประการ และเปิดเผยรายละเอียดในระดับที่ต่างกันมาก บทความนี้กล่าวถึงทั้งสามเรื่อง โดยตั้งใจไม่ตัดสินว่าใครชนะ เพราะทั้งสองยังไม่เคยถูกวัดด้วยการทดสอบเดียวกัน
เรียลไทม์เปลี่ยนอะไร
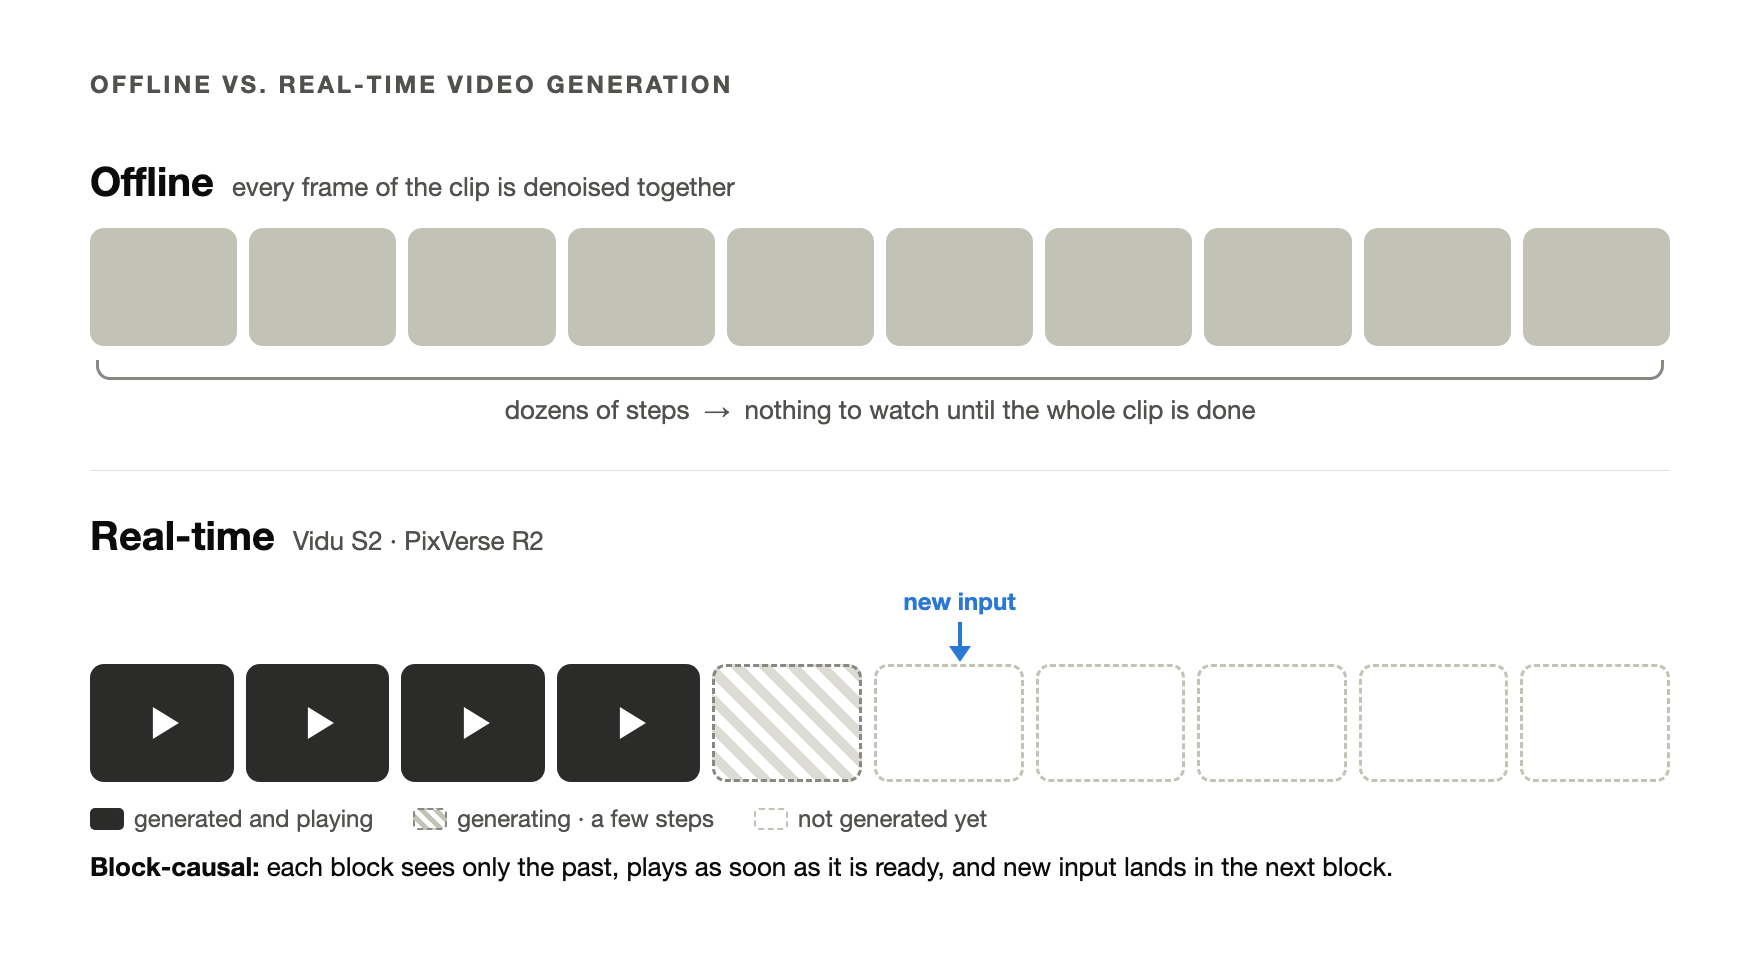
โมเดลวิดีโอส่วนใหญ่ทำงานแบบออฟไลน์ โดยลดสัญญาณรบกวนของทุกเฟรมในคลิปพร้อมกันผ่านหลายสิบขั้นตอน และจะยังไม่เห็นผลลัพธ์จนกว่าคลิปทั้งคลิปจะเสร็จ สิ่งที่คุณต้องการจึงต้องอยู่ในพรอมป์ต์ก่อนเริ่มสร้าง
โมเดลเรียลไทม์กลับวิธีนี้ โดยแบ่งวิดีโอเป็นบล็อก ซึ่งประกอบด้วยเฟรมไม่กี่เฟรมและช่วงเสียงที่ตรงกัน แล้วสร้างเรียงตามลำดับ แต่ละบล็อกผ่านขั้นตอนลดสัญญาณรบกวนเพียงไม่กี่ครั้งและเล่นทันทีที่พร้อม บล็อกหนึ่งมองเห็นสิ่งที่มาก่อนหน้าได้ แต่มองไม่เห็นสิ่งที่จะตามมา นี่คือความหมายของ block-causal คำสั่งใหม่จะเริ่มมีผลในบล็อกถัดไป
รูปแบบนี้ก่อปัญหาสามข้อ และทางเลือกด้านการออกแบบแทบทั้งหมดด้านล่างมีไว้แก้ปัญหาเหล่านี้:
- ข้อผิดพลาดสะสม แต่ละบล็อกอาศัยบล็อกที่โมเดลสร้างเองก่อนหน้า ดังนั้นความผิดพลาดเล็กน้อยจะส่งต่อไปยังทุกบล็อกถัดไป
- ประวัติต้องมีขอบเขต สตรีมอาจดำเนินต่อไปไม่สิ้นสุด หากเก็บทุกบล็อกที่ผ่านมา บล็อกใหม่แต่ละบล็อกจะใช้ทรัพยากรมากขึ้น
- เวลามีจำกัดอย่างมาก ที่ 25 เฟรมต่อวินาที แต่ละเฟรมมีเวลาเพียง 40 มิลลิวินาที
S2 และ R2 ใช้โครงหลักเดียวกัน: โมเดล diffusion แบบ autoregressive ที่ทำงานตามลำดับบล็อกและสร้างวิดีโอกับเสียงร่วมกัน ความต่างอยู่ที่วิธีฝึก รักษาเสถียรภาพ จัดการความจำ เพิ่มความเร็ว และเปิดให้ผู้ใช้ควบคุม
สองระบบ
Vidu S2 (ShengShu Technology ร่วมกับ Tsinghua University) มีสองโมเดล S2-Avatar สร้างตัวละครดิจิทัลแบบสดที่ 720p และ 25–42 FPS เพิ่มจาก 540p ใน S1 คุณส่งภาพอ้างอิงใหม่ระหว่างสตรีมได้ ไม่ว่าจะเป็นแก้ว เสื้อแจ็กเก็ต หรือชายหาด แล้วตัวละครจะหยิบ สวม หรือเดินเข้าไปในฉากนั้น และยังเต้นได้ด้วย S2-Editing เปลี่ยนสไตล์สตรีมวิดีโอที่รับเข้ามาแบบเรียลไทม์ มีมากกว่า 50 สไตล์ การลองสวมเสื้อผ้าเสมือนจริง และการเปลี่ยนตัวแบบหรือพื้นหลัง โดยคงการเคลื่อนไหวของต้นฉบับไว้ บทความยังสำรวจการส่งออกภาพสเตอริโอสำหรับแว่น VR
PixVerse R2 เป็นโมเดลเดียวที่มุ่งสร้างโลกแบบโต้ตอบ อินพุตสี่ประเภทเข้ามาได้ระหว่างทำงาน ได้แก่ ข้อความ ภาพอ้างอิงหลายสื่อ เสียง และการกระทำอย่าง WASD โดยแต่ละอย่างปรับสถานะของโลก ไม่ใช่เพียงเฟรมปัจจุบัน เอนจินเกมของ PixVerse ทำงานบน R2 แล้ว ส่วนเดโมสาธารณะเน้นการเคลื่อนไหวและพรอมป์ต์
ทางเลือกที่ 1: วิธีฝึกโมเดล
โมเดลเรียลไทม์ไม่ได้เริ่มฝึกจากศูนย์ จุดเริ่มต้นตามปกติคือโมเดลสร้างแบบออฟไลน์ที่แข็งแรง แล้วแปลงให้ทำงานตามลำดับเหตุและผลได้ในไม่กี่ขั้นตอน รายงานทั้งสองฉบับเห็นต่างกันชัดที่สุดตรงนี้
S2 ใช้กระบวนการส่งต่อหลายช่วง เริ่มจากฝึกโมเดลเสียง–วิดีโอแบบสองทิศทางล่วงหน้า แล้วปรับด้วย Diffusion-DPO เพื่อความเที่ยงตรง การแสดงอารมณ์ การเคลื่อนไหว และการซิงก์เสียงกับภาพ จากนั้นเปลี่ยน attention ให้ทำงานตามลำดับบล็อก และฝึกด้วยประวัติที่มีทั้งส่วนสะอาดและส่วนมีสัญญาณรบกวน (ทางเลือกที่ 2) ต่อมา Self-Replay Forcing กลั่นโมเดลให้ใช้เพียงไม่กี่ขั้นตอนพร้อมฝึกจากผลลัพธ์ของตัวเอง และรอบสุดท้ายของการปรับความชอบสำหรับสตรีม (Streaming NFT) ปรับโมเดลเชิงเหตุและผล Avatar กับ Editing ถูกฝึกเป็นคนละโมเดล
R2 ใช้โมเดลรากฐานเดียว Omni Causal AR เป็นโมเดลเชิงเหตุและผลที่ฝึกล่วงหน้าอย่างต่อเนื่องด้วยคลิปสั้น วิดีโอยาว ข้อมูลหลายสื่อ และลำดับการโต้ตอบ จากนั้น Real-Time Acceleration กลั่นโมเดลเดียวกันเพื่อใช้งานสด โดยเริ่มโมเดลนักเรียนจากโมเดลนี้และสร้างโมเดลครูบนฐานเดียวกัน รายงานสรุปแนวคิดว่า “เร่งความเร็ว ไม่ใช่เรียนรู้ใหม่”
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| จุดเริ่มต้น | โมเดลสองทิศทางที่ปรับด้วย Diffusion-DPO | โมเดลเชิงเหตุและผลที่ฝึกล่วงหน้าอย่างต่อเนื่อง |
| เส้นทางสู่เรียลไทม์ | ปรับให้ทำงานตามลำดับบล็อก → Self-Replay Forcing → ปรับความชอบสำหรับสตรีม | กลั่นโมเดลเดียวกันโดยตรง |
| จำนวนโมเดล | แยกโมเดล Avatar กับ Editing | โมเดลเดียวสำหรับอินพุตทุกประเภท |
รายงานของ R2 วาดแนวทางทั่วไปเป็นกระบวนการส่งต่อห้าช่วง และให้เหตุผลว่าทุกครั้งที่ส่งต่อ ความสามารถบางส่วนสูญเสียไป หากอ่านตรงไปตรงมา กระบวนการของ S2 มีรูปแบบหลายช่วงเช่นนั้น โดยปรับปรุงหลัก ๆ ในช่วงสุดท้าย ยังไม่มีทีมใดเผยแพร่การทดลองเปรียบเทียบสองเส้นทางนี้ จึงยังตอบไม่ได้ว่าเส้นทางใดขยายขนาดได้ดีกว่า
ทางเลือกที่ 2: ป้องกันสตรีมไม่ให้ค่อย ๆ เพี้ยน
อาการเพี้ยนสะสมเป็นความล้มเหลวที่พบได้เฉพาะในวิดีโอสตรีม: สีค่อย ๆ เปลี่ยน ใบหน้าค่อย ๆ กลายเป็นคนอื่น และท้ายที่สุดภาพก็พัง สาเหตุคือระหว่างฝึก โมเดลเห็นประวัติที่สะอาด แต่ตอนใช้งานจริงเห็นเพียงผลลัพธ์ที่ไม่สมบูรณ์ของตัวเอง
ทั้งสองทีมเริ่มจากวิธีแก้เดียวกัน คือผสม Teacher Forcing ซึ่งอาศัยประวัติจริงที่สะอาดเพื่อรักษาคุณภาพ กับ Diffusion Forcing ซึ่งอาศัยประวัติที่เติมสัญญาณรบกวนในระดับสุ่ม สัญญาณรบกวนลบรายละเอียดเล็ก ๆ แต่รักษาโครงภาพและการเคลื่อนไหว โมเดลจึงเรียนรู้ที่จะพึ่งโครงสร้างแทนการเชื่อทุกพิกเซลในอดีต
อย่างไรก็ตาม ประวัติจริงที่ถูกเติมสัญญาณรบกวนยังไม่ใช่ข้อผิดพลาดของโมเดลเอง แต่ละทีมจึงเพิ่มอีกหนึ่งชั้น
S2: Self-Replay Forcing โมเดลสร้างลำดับยาวออกมาก่อนเหมือนตอนใช้งานจริง โดยไม่เก็บ gradient แล้วนำช่วงหนึ่งของลำดับนั้นมาเติมสัญญาณรบกวนใหม่ทีละบล็อกและเล่นซ้ำในการคำนวณเชิงเหตุและผลหนึ่งรอบที่คำนวณ gradient ได้ ใช้การสูญเสียเพื่อกลั่นแบบ DMD ร่วมกับการสูญเสียเชิงการรับรู้ เพราะบล็อกที่เล่นซ้ำอยู่ใน computation graph เดียวกัน gradient จึงข้ามขอบบล็อกได้ โมเดลเรียนรู้ว่าบล็อกหนึ่งกำหนดบล็อกถัดไปอย่างไร โดยไม่ต้องย้อน gradient ผ่านการสร้างลำดับครั้งแรก
R2: Error Bank เก็บสถานะความล้มเหลวตัวแทนจากการสร้างและนำมาเล่นซ้ำระหว่างฝึกควบคู่กับประวัติปกติ โมเดลจึงเรียนรู้ที่จะกู้คืนหลังเกิดความเบี่ยงเบนในโลกแล้ว ในการประเมินแต่ละช่วงภายในของ PixVerse ค่าชี้วัดความสว่างที่ค่อย ๆ เพี้ยนในระยะยาวลดจาก 0.201 เหลือ 0.129 หรือลดลง 35.8%; ลำดับยาว 20 จาก 29 รายการดีขึ้น และการเคลื่อนไหวที่ไม่ควรเกิดลดลงในตัวอย่างที่ไม่มีการเคลื่อนไหวทั้งห้ารายการ
สองวิธีนี้เสริมกันมากกว่าจะแข่งขันกัน Self-Replay Forcing ฝึกจากสิ่งที่โมเดลปัจจุบันทำผิด ส่วน Error Bank ฝึกซ้ำกับความล้มเหลวที่ควรจดจำ
ทางเลือกที่ 3: ความจำที่มีขอบเขต
ทั้งคู่เก็บบล็อกแรก ๆ ไว้ถาวรเป็นจุดยึด (sink) เก็บหน้าต่างเลื่อนของบล็อกล่าสุด และทิ้งส่วนที่เหลือ ต้นทุนของบล็อกใหม่จึงไม่เพิ่มตามความยาวสตรีม ทั้งคู่ยังรักษาพิกัดตำแหน่งให้อยู่ในช่วงที่เห็นระหว่างฝึกด้วย โดย S1 เรียกวิธีนี้ว่า RoPE repositioning ส่วน R2 เรียกว่า relative temporal RoPE ทำให้เซสชันยาวไม่ดันตำแหน่งออกนอกการกระจายข้อมูลที่ฝึกไว้
S2 ต่อยอด TwinCache จาก S1 ซึ่งเก็บแต่ละบล็อกที่ผ่านมาไว้สองชุด ชุดหนึ่งมีสัญญาณรบกวน อีกชุดสะอาด ขั้นตอนลดสัญญาณรบกวนระหว่างทางอ่านชุดที่มีสัญญาณรบกวน ซึ่งบรรจุการเคลื่อนไหวโดยรวมและทำหน้าที่คล้ายตัวกรองความถี่ต่ำเพื่อลดสิ่งผิดปกติที่สะสม ส่วนขั้นตอนสุดท้ายอ่านชุดสะอาดเพื่อคืนรายละเอียด S2 แยกงานนี้ตามสองช่วง: backbone อ่านแคชที่มีสัญญาณรบกวนสูง ส่วน Refiner อ่านแคชสัญญาณรบกวนต่ำที่ความละเอียดสูง
R2 แยกความจำตามช่วงเวลา: Sink Memory สำหรับตัวตน สภาพแวดล้อม สไตล์ และกฎของโลก; Rolling History สำหรับการเคลื่อนไหว ท่าทาง และกล้องล่าสุด; และ Object KV Cache ที่บีบอัดสถานะระดับวัตถุซึ่งจะยังสำคัญในภายหลัง
การแบ่งเช่นนี้สะท้อนผลิตภัณฑ์ ตัวละครดิจิทัลต้องยังเป็นคนเดิม ส่วนโลกต้องจำได้ด้วยว่าเกิดอะไรขึ้นในนั้น เช่น สิ่งของที่คุณวางไว้หรือทางเลือกที่คุณตัดสินใจ
ทางเลือกที่ 4: ความเร็วมาจากไหน
ทั้งคู่ใช้ sparse attention และการกลั่นให้เหลือไม่กี่ขั้นตอน แต่ทุ่มแรงคนละจุด
S2 เน้นวิศวกรรมระบบและบันทึกรายละเอียดไว้ เลือก attention ในแต่ละเลเยอร์จาก SageAttention, SpargeAttention และ sparse-linear attention โดยใช้การประมาณที่รุนแรงที่สุดกับเลเยอร์ที่ไวต่อผลกระทบน้อยที่สุด เลเยอร์เชิงเส้นใช้การคูณเมทริกซ์แบบ W8A8 รายบล็อก ตัวดำเนินการที่ติดกันถูกรวมเป็นเคอร์เนล Triton/CUDA และเล่นซ้ำด้วย CUDA Graphs งานหลาย GPU ใช้ Ulysses context parallelism พร้อมการสื่อสารที่ผ่าน quantization และในสายงาน Editing ตัวเข้ารหัส VAE, backbone, Refiner และตัวถอดรหัสใช้ GPU ร่วมกันบนไทม์ไลน์เดียว ความละเอียดได้จาก backbone ความละเอียดต่ำร่วมกับ latent Refiner หนึ่งขั้นตอนจนถึง 720p
R2 เน้นที่ตัวโมเดล เรียนรู้ block-sparse attention ระหว่างฝึกและได้ความเบาบางมากกว่า 90% การกลั่นใช้ Decoupled DMD ซึ่งแยกการติดตามสัญญาณควบคุมกับการทำให้ตรงกับโมเดลครูเป็นคนละเป้าหมาย พร้อมส่วน adversarial จาก DMD2 เพื่อยึดความสมจริง ความละเอียดไล่ตามลำดับพีระมิด: หนึ่งหรือสองช่วงความละเอียดต่ำกำหนดโครงภาพ การเคลื่อนไหว และกล้อง แล้วช่วงความละเอียดสูงสุดท้ายเติมพื้นผิว รายงานไม่ได้ระบุความละเอียดเอาต์พุตหรืออัตราเฟรมของ R2
ทางเลือกที่ 5: ผู้ใช้ควบคุมอย่างไร
S2 ใช้เอเจนต์ VLM ครอบโมเดล เอเจนต์จัดประเภทภาพอ้างอิงแต่ละภาพว่าเป็นสิ่งของที่ถือ พื้นหลัง หรือเสื้อผ้า แล้วเขียนพรอมป์ต์สำหรับแต่ละช่วง ครอบคลุมตัวตน สีหน้า ทิศทางสายตา ท่าทาง การกระทำ และสิ่งของที่ถือ โดยคงทุกสิ่งที่ผู้ใช้ไม่ได้ขอเปลี่ยน หลังสร้างเสร็จ เอเจนต์ตรวจเฟรมตามลำดับ ตัดสินว่าการกระทำเสร็จ ทำได้ครึ่งหนึ่ง หรือผิดพลาด แล้วเขียนพรอมป์ต์ถัดไปตามนั้น สำหรับการสวมหรือถอดเครื่องประดับ พรอมป์ต์ระบุทั้งการเคลื่อนไหวและสถานะสุดท้าย เพื่อให้หมวกที่สวมกลับแล้วยังคงอยู่บนศีรษะ ในโหมด Editing attention ที่จัดแนวตามเฟรมทำให้แต่ละเฟรมเอาต์พุตอ่านได้เฉพาะเฟรมต้นฉบับในเวลาเดียวกัน จึงจับคู่การเคลื่อนไหวและจังหวะกับอินพุตได้ตรงกัน
R2 รวมอินเทอร์เฟซอินพุตไว้ในโมเดลเดียว ข้อความ ภาพอ้างอิง เสียง การกระทำ และการควบคุมที่เอเจนต์สร้าง ล้วนเข้าสู่โลกเดียวที่กำลังทำงาน ความยาวบล็อกปรับตามการควบคุมที่ใช้อยู่แต่ไม่เกินเพดาน: การกดปุ่มใช้บล็อกสั้นเพื่อให้ตอบสนองเร็ว ส่วนเหตุการณ์ทั้งเหตุการณ์หรือเสียงช่วงหนึ่งใช้บล็อกยาวกว่าเพื่อรักษาความต่อเนื่อง เหนือโมเดลขึ้นไป เอนจินเกมของ PixVerse เพิ่มชั้นเอเจนต์ที่รักษาสถานะกฎเกมให้สอดคล้องกับฉากที่สร้างขึ้น
แต่ละรายงานเปิดเผยอะไรบ้าง
ก่อนเปรียบเทียบตัวเลข ควรเปรียบเทียบสิ่งที่เผยแพร่ก่อน
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| รูปแบบ | บทความบน arXiv | บทความทางเทคนิคบนเว็บไซต์ PixVerse |
| ความละเอียดและอัตราเฟรม | 720p, 25–42 FPS | ไม่ระบุ |
| จำนวนพารามิเตอร์และเวลาแฝงตั้งแต่ต้นจนจบ | ไม่ระบุ | ไม่ระบุ |
| เบนช์มาร์กสาธารณะ | หนึ่งเบนช์มาร์ก Avatar และสี่เบนช์มาร์ก Editing | ไม่มี; มีเพียงการประเมินภายใน |
| น้ำหนักโมเดล | ไม่เผยแพร่; มี API ให้ใช้ | ไม่เผยแพร่ |
บน StreamAV-Bench S2 อยู่ลำดับแรกในตัวชี้วัดทั้งเก้ารายการที่รายงาน จาก 14 ระบบในการประเมินของตนเอง: คะแนนความสอดคล้องของเสียงและภาพ 0.353 เทียบกับทางเลือกที่ดีที่สุด 0.272 และข้อผิดพลาดการซิงก์ 0.617 เทียบกับ 0.648 บางค่าต่างกันเพียงหลักทศนิยมตำแหน่งที่สาม เช่น ความสม่ำเสมอของตัวแบบ 0.998 เทียบกับ 0.997 ตัวเลขที่ R2 เผยแพร่คือการลดอาการเพี้ยน 35.8% และความเบาบางของ attention มากกว่า 90% ซึ่งรายงานระบุว่าคงคุณภาพสี่มิติภายในไว้โดยไม่ให้คะแนน
ยังไม่มีการทดสอบเทียบกันโดยตรง บทความ S2 เปรียบเทียบกับ PixVerse R1 รุ่นก่อน และ R2 เปิดตัวหลังจากนั้น
เรื่องนี้หมายความอย่างไรหากคุณทำวิดีโอด้วยเอเจนต์
เราสร้างแอปเดสก์ท็อปที่ให้เอเจนต์ทำงาน และวิดีโอก็เป็นหนึ่งในงานที่ผู้ใช้มอบหมายให้เอเจนต์ ข้อค้นพบจากรายงานเหล่านี้มีสองเรื่องที่นำมาใช้ได้
ข้อแรก เส้นแบ่งระหว่างวิดีโอสดกับวิดีโอสำเร็จรูปชัดขึ้น โมเดลเรียลไทม์สร้างมาเพื่อประสบการณ์ที่ตอบสนองต่อเนื่อง เช่น ตัวละคร เกม หรือสตรีมที่เปลี่ยนสไตล์ระหว่างเล่น แต่งานของผู้สร้างส่วนใหญ่ยังจบเป็นไฟล์ ใน Orkas VideoStudio เปลี่ยนฟุตเทจและโจทย์งานเป็นวิดีโอตัดต่อที่ตรวจทานได้ และเมื่อต้องสร้างช็อตใหม่ จะใช้โมเดลออฟไลน์ ได้แก่ การสร้างวิดีโอที่ Orkas จัดการให้ หรือคีย์ของคุณเองสำหรับ Seedance 2.0, Hailuo 2.3, Vidu Q3 Pro, Kling 3.0 Turbo, Veo 3.1 หรือ Runway Gen-4.5 ปัจจุบันทั้ง S2 และ R2 ยังไม่ทำงานภายใน Orkas
ข้อสอง ชั้นควบคุมของ S2 เป็นวงจรของเอเจนต์: เขียนพรอมป์ต์ สร้างผลลัพธ์ ดูเฟรม แล้วตัดสินใจว่าจะทำอะไรต่อ รูปแบบนี้เหมือนกับเอเจนต์ใดก็ตามที่ทำงานกับโมเดลสร้างสรรค์ ไม่ว่าจะเป็นเรียลไทม์หรือไม่ และผลลัพธ์ส่วนใหญ่ขึ้นอยู่กับวงจรนี้ ไม่ใช่แค่น้ำหนักโมเดล
สิ่งที่เราได้จากงานนี้
โครงหลักเริ่มลงตัวแล้ว: diffusion แบบ autoregressive ที่ทำงานตามลำดับบล็อก สร้างวิดีโอกับเสียงร่วมกัน ใช้ประวัติทั้งสะอาดและมีสัญญาณรบกวน มีจุดยึดและหน้าต่างความจำ กลั่นด้วยตระกูล DMD ใช้ sparse attention และเริ่มจากความละเอียดต่ำ สิ่งที่แยก S2 กับ R2 คือจุดที่แต่ละฝ่ายทุ่มแรง: การส่งต่อพร้อมแก้ปัญหาเฉพาะจุดเทียบกับโมเดลรากฐานเดียวที่กลั่นครั้งเดียว การเล่นซ้ำตามผลลัพธ์ของโมเดลเทียบกับคลังข้อผิดพลาด วิศวกรรมระบบเทียบกับความเบาบางที่โมเดลเรียนรู้เอง
ทั้งสองฉบับควรอ่านเต็ม ๆ: บทความ Vidu S2 สำหรับรายละเอียดการฝึกและการให้บริการ และ รายงาน PixVerse R2 สำหรับข้อเสนอเรื่องการขยายโมเดลเรียลไทม์โดยไม่ต้องเรียนรู้ใหม่