
這個月,兩款即時影片模型相隔一週問世:生數科技的 Vidu S2 於 9 月 15 日推出,愛詩科技於 9 月 22 日發表了 PixVerse R2。S2 聚焦即時數位角色,以及在影片串流播放時改變影片風格;R2 自稱即時世界模型:你用 WASD 在場景中移動,同時用文字、參考圖片和音訊改變接下來發生的事。
兩家公司都公開了技術方案:S2 發表了 arXiv 論文,R2 在 PixVerse 官方網站刊登了技術報告。我們對照閱讀了兩份資料:骨架一致,五個設計選擇各走一路,公開的資訊量也相差很大。這篇把三件事都講清楚,但刻意不評孰優孰劣——兩者從來沒有接受過同一套測試。
「即時」帶來什麼改變
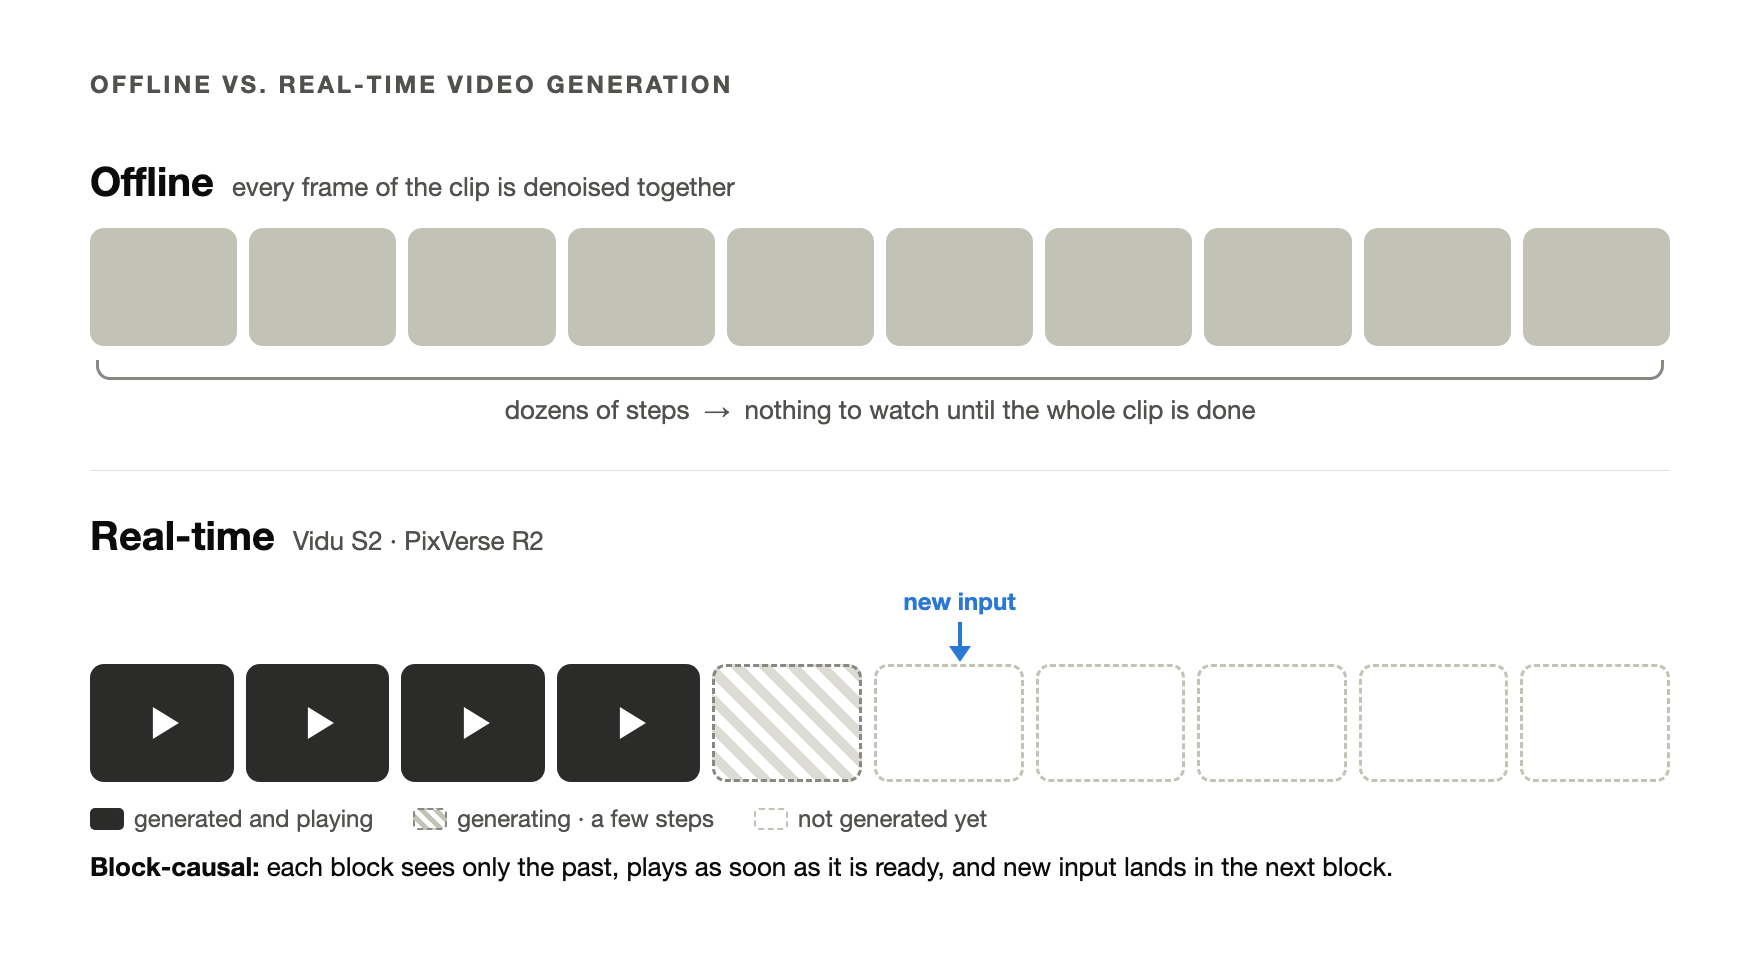
大多數影片模型是離線運作的:一段影片的所有影格一起去除雜訊,通常要跑幾十步,整段算完之前什麼都看不到。想要什麼,必須在生成開始前寫進提示詞。
即時模型把這個過程倒了過來。它把影片切成一個區塊接著一個區塊(每個區塊幾個影格,加上同一時段的音訊),依時間順序逐個區塊生成。每個區塊只去除雜訊幾步,生成完立刻播放。每個區塊只能看到之前的內容,看不到之後的內容,這就是區塊因果。新的指令會落在下一個區塊上。
這種結構帶來三個難題,下面幾乎每個設計選擇都在回答其中之一:
- 誤差會累積。每個區塊都以模型自己生成的區塊為條件,一個小錯會被之後的所有內容繼承。
- 歷史資料必須有上限。影片流可以一直進行下去,如果保留所有歷史區塊,每生成一個區塊的代價都會越來越高。
- 時間預算極緊。以每秒 25 影格計算,每個影格只有 40 毫秒。
S2 和 R2 落在同一副骨架上:區塊因果的自迴歸擴散模型,影片和音訊一起生成。差別在於怎麼訓練、怎麼保持穩定、怎麼記憶、怎麼提速,以及怎麼讓人來操控。
兩款模型
Vidu S2(生數科技聯合清華大學)包含兩個模型。S2-Avatar 是即時數位角色,720p、25–42 FPS,上一代 S1 是 540p。即時串流期間可以隨時給它一張新的參考圖——一個杯子、一件外套、一片海灘——角色就會拿起杯子、穿上外套或者走進新場景;它也能跳舞。S2-Editing 對輸入的影片流做即時改寫——50 多種風格、虛擬試穿、更換人物和背景——同時保留原影片的動作。論文還探索了面向 VR 頭戴裝置的立體輸出。
PixVerse R2 是一個面向可互動世界的模型。運作過程中可以隨時進來四類輸入——文字、多模態參考、音訊,以及 WASD 這類動作——每一種都會更新世界的狀態,而不只是改目前這個影格。PixVerse 的遊戲引擎已經跑在 R2 上;公開展示以移動和文字指令為主。
選擇一:模型怎麼訓練
即時模型不是從零開始訓練的。常見的起點是能力很強的離線生成模型,再把它改造成能按因果順序、以較少步數運作的模型。兩份報告在這一點上的分歧最明顯。
S2 走的是接力。先預訓練一個雙向的影音模型,再用 Diffusion-DPO 提升畫面品質、表情、動作和影音同步。然後把注意力改成區塊因果,以乾淨的歷史資料和加入雜訊的歷史資料混合訓練(見選擇二)。接著用 Self-Replay Forcing 讓模型在自己的輸出上訓練,同時蒸餾成少步數模型;最後再做一輪流式偏好調整(Streaming NFT)。數位角色和影片編輯是分開訓練的兩個模型。
R2 只保留一個基礎模型。Omni Causal AR 是一個因果模型,持續用短影片、長影片、多模態數據和交互軌跡做預訓練。之後由 Real-Time Acceleration 把同一個模型直接蒸餾成即時版本:學生模型從它初始化,教師模型也建立在它之上。報告的說法是「加速,而不是重學」。
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| 起點 | 用 Diffusion-DPO 調優過的雙向模型 | 持續預訓練的因果模型 |
| 走向即時的路徑 | 區塊因果改造 → Self-Replay Forcing → 流式偏好調整 | 直接蒸餾同一個模型 |
| 模型數量 | 數位角色、影片編輯各一個 | 所有輸入類型共用一個 |
R2 的報告把常見做法畫成一個五段接力,認為每交接一次都會損失一部分能力。客觀地看,S2 的流程就是這種多段結構,主要改進落在最後一段。兩家都沒有公開比較這兩條路線的實驗,哪條路線擴充性更好,目前仍然沒有答案。
選擇二:防止影片流越跑越偏
漂移是流式影片最典型的失敗:顏色慢慢偏、一張臉慢慢變成另一個人,最後畫面崩掉。原因在於訓練時模型看到的是乾淨的歷史資料,而推論時它只能看到自己生成的、不完美的輸出。
兩家的第一步相同:混合使用 Teacher Forcing(以乾淨的真實歷史資料為條件,保住畫面品質)和 Diffusion Forcing(以加入隨機強度的雜訊的歷史資料為條件)。雜訊會抹掉細節,但保留佈局和動作,模型因此學會依靠結構,而不是相信過去的每一個像素。
加入雜訊的真實歷史資料,仍然不等於模型自己犯的錯,所以兩家各自又加了一層。
S2:Self-Replay Forcing(自我重播)。模型先按推論時的方式連續生成一長段,不保留梯度。然後截取其中一段,逐塊重新加入雜訊,在一次帶梯度的因果前向傳遞中重播,用 DMD 蒸餾損失加感知損失訓練。重播的這些區塊在同一個運算圖中,梯度能跨越區塊邊界傳遞——模型學到的是一個區塊如何影響下一個區塊——同時又不用對最初那次長生成做反向傳播。
R2:Error Bank(錯誤資料庫)。把生成中出現的典型失敗狀態存起來,訓練時和正常歷史資料一起回放,讓模型學會在偏差已經進入畫面之後把它拉回來。在 PixVerse 的內部階段評測中,長程亮度漂移指標從 0.201 降到 0.129,降低 35.8%;29 條長序列中有 20 條改善,5 條靜止畫面樣本中的偽運動全部減少。
兩者是互補而不是競爭關係:Self-Replay Forcing 練的是當前模型會犯的錯,Error Bank 反覆練值得記住的典型失敗。
選擇三:有上限的記憶
兩家都把開頭幾個區塊永久保留作為錨點(sink),再保留一個最近幾個區塊的滑動視窗,其餘丟棄,所以生成新區塊的代價不會隨影片流變長而增長。兩家也都把位置座標限定在訓練見過的範圍內——S1 叫 RoPE 重定位,R2 叫相對時間 RoPE——會話再長,位置也不會超出訓練分布。
S2 在 S1 的 TwinCache 基礎上改進。TwinCache 給每個歷史區塊快取兩份:一份帶有雜訊、一份乾淨。去除雜訊的中間步驟讀帶有雜訊的那份,它只傳遞粗略的動作,相當於一個低通濾波,防止偽影累積;最後一步讀乾淨的那份,把細節補回來。S2 把這個設計拆到兩個階段:主幹讀高雜訊快取,Refiner 讀低雜訊的高解析度快取。
R2 按時間尺度拆分記憶:Sink Memory 記身份、環境、風格和世界規則;Rolling History 記近期的動作、姿態和鏡頭;Object KV Cache 壓縮保留之後還會用到的物體狀態。
這種劃分對應各自的產品。數位角色要一直是同一個人;世界還要記住裡面發生過什麼——你放下的物品、你做過的選擇。
選擇四:速度從哪裡來
兩家都用了稀疏注意力和少步蒸餾,但發力點不同。
S2 主要靠系統工程,而且寫得很詳細。注意力按層從 SageAttention、SpargeAttention 和稀疏線性注意力中挑選,最激進的近似放在最不敏感的層。線性層用 per-block W8A8 矩陣乘法。相鄰算子融合成 Triton/CUDA 核心,並用 CUDA Graphs 回放。多張顯示卡運作時使用 Ulysses 上下文並行,顯示卡間通訊也做量化;在影片編輯流程中,VAE 編碼器、主幹、Refiner 和解碼器按同一條時間線共用顯示卡。解析度由低解析度主幹加一個一步完成的潛在空間 Refiner 提升到 720p。
R2 主要靠模型本身。區區區區塊稀疏注意力在訓練中學出來,稀疏度超過 90%。蒸餾採用 Decoupled DMD——「聽從控制訊號」和「貼近教師模型的分布」作為兩個獨立目標分別優化——再加上一項來自 DMD2 的對抗損失保證畫面真實。解析度走金字塔結構:先用一至兩個低解析度階段確定佈局、動作和鏡頭,最後一個高解析度階段補上紋理。報告沒有給出 R2 的輸出解析度和影格率。
選擇五:人怎麼操控它
S2 在模型外面套了一層 VLM 代理。代理先判斷每張參考圖是手持物、背景還是服裝,再為每一段寫提示詞,分別描述身分、表情、視線、姿態、動作和手裡拿的物品,使用者沒要求改的保持不變。生成後它依時間順序檢查畫面,判斷動作是做完了、做了一半還是做錯了,再據此寫下一段的提示詞。穿戴配件這類動作,提示詞會同時寫動作和結束後的狀態,所以戴回去的帽子會一直戴著。在編輯模式下,影格對齊注意力讓每個輸出影格只讀取來源影片在同一時間點的影格,所以動作和節奏與輸入完全一致。
R2 把統一的輸入介面做進了模型。文字、參考、音訊、動作以及代理生成的控制,都進入同一個運作中的世界。每個區塊的長度跟隨當前的控制訊號,有上限:按鍵用短區塊,響應更快;一段完整事件或一段音訊用長區塊,保持連貫。在模型之上,PixVerse 的遊戲引擎還加了一層代理,負責讓遊戲規則的狀態和生成的場景保持同步。
兩份報告各自公開了什麼
比較數字之前,先比較公開了哪些信息。
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| 形式 | arXiv 論文 | PixVerse 官方網站上的技術文章 |
| 解析度與影格率 | 720p,25–42 FPS | 未公布 |
| 參數量與端對端延遲 | 未公布 | 未公布 |
| 公開基準測試 | 1 個數位角色基準,4 個影片編輯基準 | 無,只有內部評測 |
| 模型權重 | 未開放;提供 API | 未開放 |
在 StreamAV-Bench 上,S2 在自己的評測中(共 14 個系統)9 項指標全部排第一:影音對齊 0.353,其餘系統最好成績 0.272;影音同步誤差 0.617,其餘最好 0.648。也有差距只在千分位的,比如主體一致性 0.998 對 0.997。R2 公布的數字是漂移降低 35.8%,以及超過 90% 的注意力稀疏度——報告說在這個稀疏度下,四項內部品質指標保持住了,但沒有給出分數。
兩者沒有正面對比。S2 論文對比的是上一代 PixVerse R1,而 R2 發表在它之後。
如果你用代理做影片,這意味著什麼
我們做的是一款由代理完成工作的桌面應用程式,影片是大家交給它的工作之一。這兩份報告中有兩點可以直接帶走。
第一,現場和完成的影片之間的界線越來越清楚。即時模型面向的是持續響應的體驗——數位角色、遊戲、邊播邊改的影片流;而大多數創作工作最後仍然要落成一個檔案。在 Orkas 中,VideoStudio 把素材和需求變成可檢視的完整影片;需要生成鏡頭時,它用的是離線模型:Orkas 託管的影片生成,或者用你自己的 API 金鑰接入 Seedance 2.0、Hailuo 2.3、Vidu Q3 Pro、Kling 3.0 Turbo、Veo 3.1 或 Runway Gen-4.5。S2 和 R2 目前都不在 Orkas 中運作。
第二,S2 的控制層本身就是一個代理循環:寫提示詞、生成、看畫面、決定下一步。這和任何配合生成模型工作的代理是同一個形狀,不管模型是不是即時的——效果很大程度取決於這個循環,而不只是模型權重。
我們的收穫
骨架已經定型:區塊因果的自迴歸擴散,影音一起生成,乾淨的歷史資料搭配加入雜訊的歷史資料,sink 加滑動視窗,DMD 系蒸餾,稀疏注意力,先低解析度再高解析度。S2 和 R2 的區別在於力氣花在哪裡——一串有針對性的修補對一個只蒸餾一次的基礎模型,線上重播對一個失敗案例庫,系統工程對學出來的稀疏性。
兩份資料都值得完整讀一遍:Vidu S2 論文的訓練和推論部署細節,以及 PixVerse R2 技術報告中關於「不重新學習也能擴展即時模型」的論證。