
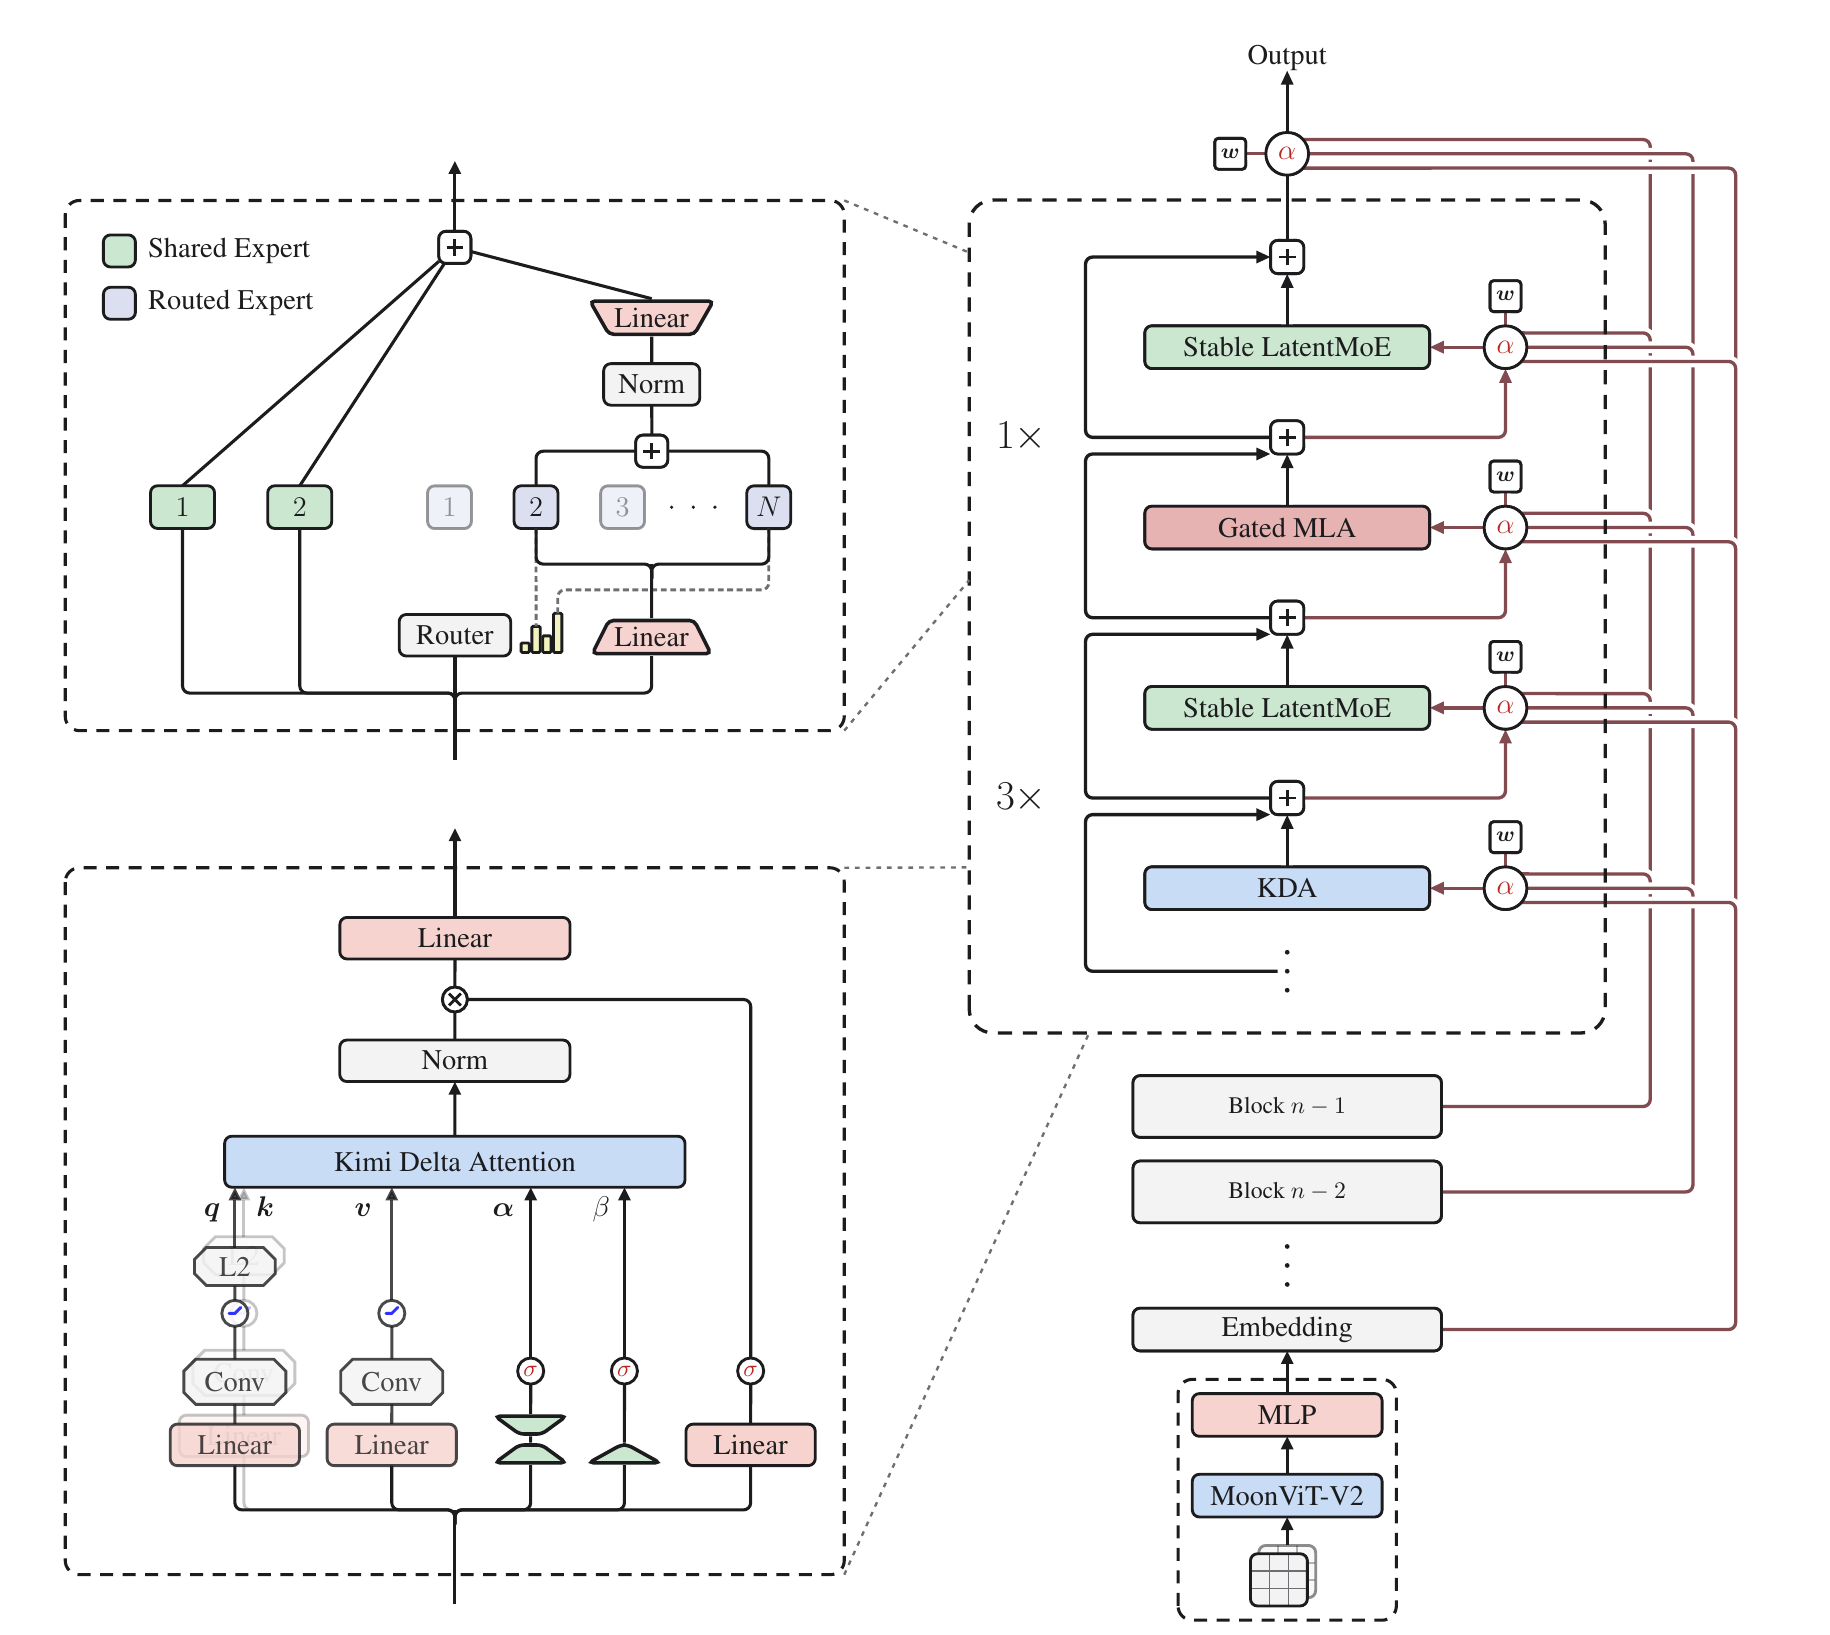
الرقم الأبرز لـKimi K3 هو 2.8 تريليون معلمة. وهو أقل أرقام التقرير إثارة للاهتمام.
المثير للاهتمام أن المعمارية منظّمة حول سؤال لا علاقة له بالحجم: أين يتعطّل تدفّق المعلومات؟ للإجابة ثلاثة أجزاء: عبر التسلسل، وعبر العمق، وعبر العرض؛ ولكل منها آليته الخاصة.
بالموارد الحاسوبية نفسها، تبلغ كفاءة التوسّع نحو 2.5× كفاءة Kimi K2. يأتي هذا الرقم من منحنيات قوانين التوسّع التي واءمها الفريق نفسه، لا من إعادة إنتاج مستقلة، لذا تعاملوا معه بوصفه ادّعاءهم. لكن الآليات التي تقف وراءه محدّدة بما يكفي لمناقشتها، وهذا ما يجعل التقرير مستحقًا للوقت.
هذه قراءة متأنية لـ التقرير التقني لـKimi K3 (Moonshot AI)، تركّز على قسم المعمارية. سبق أن كتبنا عن تصميم الوكلاء ذوي الأفق الطويل؛ أما هذه القراءة فتتناول مستوى أعمق في البنية التقنية.
ثلاثة اتجاهات، لا رقم واحد
تمزج كل طبقة في المحوّل المعلومات بثلاث طرق. عبر الرموز، بحيث يمكن للموضع 900,000 التأثير في الموضع 1. وعبر العمق، بحيث تستطيع الطبقة 90 استخدام ما لاحظته الطبقة 3. وعبر القنوات، بحيث يمكن إعادة تركيب السمات.
تحرّك معظم جهود التوسّع المحاور الثلاثة معًا بجعل كل شيء أكبر. يفصل K3 بينها ويمنح كلًا منها آليته الخاصة:
- التسلسل — انتباه هجين: ثلاث طبقات Kimi Delta Attention مقابل كل طبقة Gated MLA واحدة.
- العمق — Attention Residuals: توجّه كل طبقة انتباهها إلى مخرجات جميع الطبقات السابقة بدلًا من وراثة حالة متراكمة واحدة.
- العرض — Stable LatentMoE: 896 خبيرًا خاضعًا للتوجيه، يُفعَّل منهم 16 لكل رمز.
لم يتغيّر البُعد الخفي إطلاقًا. 7,168 في K2 و7,168 في K3. أيًا كان ما ازداد حجمًا، فإنه لم يكن عرض الطبقة.
التسلسل: ثلاثة أرباع الطبقات توقّفت عن قراءة كل شيء
يعيد الانتباه القياسي قراءة البادئة بأكملها لكل رمز جديد. وعند مليون رمز، تصبح هذه التكلفة هي ما يعطّل الأمور.
يقسّم K3 المهمة. تحتفظ ثلاث طبقات KDA بحالة متجدّدة ثابتة الحجم، أقرب إلى تدوين الملاحظات منها إلى إعادة قراءة المصدر، تتبعها طبقة Gated MLA واحدة تنفّذ انتباهًا عالميًا كاملًا. ويتكرّر النمط، مع طبقة MLA إضافية في النهاية تمامًا كي ترى الطبقة الأخيرة كل شيء دائمًا. عبر 93 طبقة: 69 KDA و24 MLA.
الحجم الثابت هو جوهر الفكرة. لا تنمو الحالة مع التسلسل، لذا لا يمكن أن يتضخّم حجمها بلا حد. لكنها تفقد بعض المعلومات أيضًا، ولهذا تظهر طبقة انتباه كامل كل أربع طبقات لاستعادة ما أسقطته الملاحظات.
ثم يأتي أثر من الدرجة الثانية. بما أن الحالة المتكررة تتضمّن اضمحلالًا، فتكون الرموز الحديثة حاضرة بطبيعتها أكثر من القديمة، تأتي معلومات الموضع بلا تكلفة إضافية. لذا لا يطبّق K3 أي ترميز موضعي إطلاقًا على طبقات الانتباه العالمي لديه. لا RoPE، ولا شيء يحتاج إلى إعادة تحجيم.
وهذا يعني أن التوسّع إلى مليون رمز لم يتطلّب أي تعديل جراحي للترميز الموضعي. لا تنطبق هنا أي من حيل الاستيفاء التي تراكمت في المجال لتوسيع السياق، إذ لا يوجد ترميز لإجراء الاستيفاء عليه.
حدّ أدنى أزال مسار شيفرة على GPU
هذا الجزء المفضّل لدينا في التقرير، وهو صغير بما يكفي ليمرّ عليه القارئ سريعًا.
تنسى الحالة المتكررة مع تقدّمها. وحساب ذلك بكفاءة ضمن كتل يتطلّب القسمة على الاضمحلال المتراكم، وهو حاصل ضرب أعداد أقل من الواحد. وإذا تُرك بلا ضابط، تصبح القسمة على قيمة تقترب من الصفر إلى أي حد.
عالج الجيل السابق هذا بتقسيم كل كتلة إلى بلاطات من 16 رمزًا والعمل في المجال اللوغاريتمي. نجح ذلك، لكن البلاطات الواقعة على القطر ظلّت تتطلّب حساب كل زوج من المواضع على حدة، عبر مسار بطيء خاص بهذه الحالة لا يستطيع استخدام أنوية الموترات.
حلّ K3 سطر واحد في صياغة المعلمات. وضع حدّ أدنى للوغاريتم الاضمحلال: يمكن لكل خطوة أن تنسى حتى لا يبقى سوى 0.67% مما كانت تحتفظ به، ولا أقل من ذلك.
تتبّعوا النتيجة. مع هذا الحد، يبقى لوغاريتم الاضمحلال المتراكم عبر بلاطة من 16 رمزًا ضمن (−80, 0). ومن ثم يكون المقلوب أقل من e80 ≈ 5.5 × 1034، ضمن نطاق BF16 البالغ نحو 3.4 × 1038 بهامش مريح. لا يحدث أي تجاوز للنطاق العددي. لذا تستطيع البلاطات القطرية استخدام ضرب المصفوفات الكثيف نفسه المستخدم في جميع البلاطات الأخرى.
لم يُحسَّن المسار الخاص، بل أُزيل.
اقرؤوا السببية بالعكس فتزداد الفكرة جمالًا: النطاق الديناميكي للعتاد حدّد المجال المقبول، الذي حدّد الثابت، الذي فرض أن تكون دالة التنشيط محدودة من الأسفل. الحسابات العددية اختارت الرياضيات، لا العكس.
العمق: من سباق تتابع إلى محادثة جماعية
على عمق 93 طبقة، يشبه تدفّق الوصلات المتبقية القياسي سباق تتابع. تتلقّى الطبقة 50 حالة متراكمة واحدة من الطبقة 49. وكل ما لاحظته الطبقات من 1 إلى 48 كلٌّ على حدة جُمِع في تلك الحالة ولم يعد قابلًا للفصل.
تصوغ الورقة ذلك بوصفه عنق الزجاجة نفسه الذي تواجهه RNN عبر الزمن، وقد حلّه المجال من قبل بالانتباه. تطبّق Attention Residuals الحل نفسه على العمق: تحمل كل طبقة استعلامًا شبهِيًا قابلًا للتعلّم، وتوجّه انتباهها إلى مخرجات جميع الطبقات السابقة، لتختار ما تقرأه.
تطبيق ذلك حرفيًا يكلّف حسابات تربيعية بالنسبة إلى العمق، والأسوأ أنه يُبقي مخرجات كل طبقة في الذاكرة وقيد النقل عند استخدام توازي خط الأنابيب. لذا يستخدم K3 النسخة الكتلية: تقسيم 93 طبقة إلى مجموعات من اثنتي عشرة طبقة، والجمع داخل المجموعة، والانتباه الكامل بين المجموعات. تنخفض الأعباء الإضافية من مستوى كل طبقة إلى مستوى كل مجموعة، وتبقى الحالة وقت الاستدلال محدودة.
العرض: 896 خبيرًا، يُفعَّل منهم 16
يحتفظ مزيج الخبراء بمجموعة كبيرة ويفعّل عددًا قليلًا منها لكل رمز. اختار K2 عدد 8 من أصل 384. ويختار K3 عدد 16 من أصل 896، بمعامل تناثر يبلغ 56.
توسيع المجموعة إلى هذا الحد يعطّل أمرين، والتقرير صريح بشأن كليهما على نحو غير معتاد.
الاتصال. في MoE التقليدي، يتلقّى كل خبير مختار الرمز بكامل عرضه، لذا تتزايد حركة البيانات مع عدد الخبراء المختارين. يفصل LatentMoE بين الأمرين: يعمل الخبراء الخاضعون للتوجيه في فضاء كامن مضغوط بنصف عرض النموذج، بينما يتولّى خبيران مشتركان بكامل العرض ما يحتاج إليه كل رمز. ويمكن أن تكبر المجموعة من دون أن تكبر معها تكلفة نقل البيانات.
الاستقرار. عند هذا القدر من التناثر، يصبح الفرع الخاضع للتوجيه سلسلة من نحو أربع عمليات ضرب مصفوفات متتالية، وتنفجر قيم التنشيط. هناك حلّان: RMSNorm بين تجميع الخبراء والإسقاط إلى بُعد أعلى، ودالة تنشيط جديدة، SiTU-GLU، تحدّ عاملَي SwiGLU باستخدام tanh محجَّمة، كي لا ينفلت أيّ منهما عند الدقة المنخفضة.
التوازن. الحل الثالث جدير بالاقتباس. إبقاء الحمل موزّعًا بالتساوي على نحو 900 خبير يعني تعديل انحياز خاص بكل خبير عند كل خطوة. تحرّك الطريقة القياسية كل انحياز بمقدار ثابت في اتجاه الخطأ، فتتذبذب أو تتأخر عن الاستجابة. أما K3 فيحسبه مباشرة: يُجري top-(k+1) بدلًا من top-k، ويكون العنصر الإضافي هو هو الدرجة التي يتطلّبها الرمز للقبول. وبمعرفة هذه العتبات، يكون الحمل الذي يتلقّاه الخبير تحت انحياز مرشّح رتيبًا، لذا فالانحياز الذي يحقّق الحمل المستهدف ليس سوى قيمة كميّة من الهوامش. تمرير أمامي واحد، بلا حجم خطوة يحتاج إلى ضبط.
على نطاق واسع، تمتد تلك القيمة الكميّة عبر ملايين القيم في جميع رتب المعالجة، لذا يقدّرونها باستخدام مدرّج تكراري: تحصي كل رتبة فئاتها، وتجمعها عملية all-reduce واحدة، ثم تُستخرج القيمة الكميّة من الأعداد المجمّعة. ولأن الأعداد قابلة للجمع، يعكس التقدير الدفعة بأكملها مهما كانت طريقة توزيع الرموز، بتكلفة بضع مئات من الفئات لكل خبير.
تظهر التكلفة في منظومة تقديم الاستدلال
لا شيء من هذا مجاني، والجزء الصريح من التقرير هو قسم البنية التحتية، حيث تظهر التكلفة.
الحالة المتكررة ثابتة الحجم قليلة التكلفة في التخزين والنقل، لكنها تُحدَّث تسلسليًا ولا يمكن جمعها ببساطة. وتولّد الخاصيتان عملًا إضافيًا:
- تقسيم التسلسل بين الأجهزة. يسمح الانتباه الخطي العادي لكل جهاز بحساب حالته المحلية من الصفر ثم جمع النتائج. أما KDA فيطبّق انتقالًا يعتمد على الرمز على الحالة الواردة، لذا يكون الجمع خاطئًا. يفكّك الحل كل مقطع إلى انتقال تراكمي وحالة تبدأ من الصفر، وهما كميتان يمكن تركيبهما، ويستعيد حالة الدخول لكل جهاز بمسح بادئي وعملية all-gather واحدة ثابتة الحجم.
- إعادة استخدام بادئة عبر الطلبات. نصف الذاكرات المخبئية صفحات لكل رمز، والنصف الآخر حالة ثابتة واحدة لكل طلب، وتتطلّب إصابة الذاكرة المخبئية إمكان استعادة الاثنين عند الحدّ نفسه. حلّهم هو فصل مستويات التفصيل: حساب التجزئة كل 512 رمزًا، والتخصيص عند 1024–6144، وحفظ نقاط تحقق للحالة المتكررة عند مجموعة فرعية متباعدة فقط من نهايات التجزئة.
- فك الترميز التخميني. تُحدَّث الحالة في موضعها، لذا لا يمكن التراجع عن مسودة مرفوضة. وبدلًا من ذلك يخزّنون المدخلات المسقطة مؤقتًا، وهي أصغر بكثير من الحالة نفسها، ثم يعيدون البناء على الشريحة.
النمط المشترك بين الثلاثة هو نمط حدّ الاضمحلال نفسه، لكن في الاتجاه المعاكس: اختارت المعمارية تمثيلًا، وفرض التمثيل العمل المطلوب على مستوى الأنظمة.
عادة واحدة تتخلّى عنها الورقة بهدوء
K3 متعدد الوسائط بطبيعته، ويُدرَّب مرمّز الرؤية فيه من الصفر بالتنبؤ بالرمز التالي. بلا تهيئة بـSigLIP، وبلا تدريب مسبق تبايني، رغم أن هذه هي الوصفة القياسية، بما في ذلك نموذج الفريق السابق نفسه.
السبب المعلن ليس الجودة، بل الاستقرار: أظهر المرمّز المهيّأ تباينيًا معايير تدرّج أعلى باستمرار مع قفزات متكررة أثناء التحسين المشترك، بينما بقي المرمّز المدرَّب من الصفر مستقرًا. وجاءت تقييمات الرؤية متعادلة.
وهذا يجعل النتيجة أدق دلالة مما لو كانت تفوّقًا. لو كان التدريب من الصفر أفضل، لاعتبرتموه وصفة أفضل. لكنه تعادل، لذا فالادّعاء هو أن خطوة يعاملها المجال بوصفها إلزامية تصبح، عند هذا النطاق، مجرد خيار.
ما الذي يعنيه هذا إذا كنتم تشغّلون وكلاء على هذه النماذج
نبني تطبيق سطح مكتب متعدد الوكلاء، لذا نراقب ما إذا كان التنفيذ ذو الأفق الطويل يظل ميسور التكلفة، لا ما يتصدّر لوحة النتائج.
الرقم المهم ليس حجم نافذة السياق، بل تكلفة تقديم الاستدلال لمليون رمز. تحمل ثلاثة أرباع الطبقات حالة ثابتة الحجم، لذا يبلغ حجم الذاكرة المخبئية التي تنمو مع المحادثة ربع ما ستكون عليه في نموذج يعتمد بالكامل على الانتباه وبالعمق نفسه. في BrowseComp، يسجّل التقرير لـK3 نتيجة 91.2% بتكلفة نحو $2 لكل مهمة، أي نحو نصف تكلفة أقرب نتيجة لنموذج مملوك، وأقل بنحو مرتبة مقدار كاملة من نماذج Claude عند أقصى جهد.
بالنسبة إلى وكيل ينفّذ مئات استدعاءات الأدوات، تحدّد هذه النسبة ما إذا كانت المهمة تستحق المحاولة أصلًا. العمل المعماري الذي كان يبدو بحثًا بحتًا بات يؤثّر مباشرة في مدى معقولية التنفيذ الطويل اقتصاديًا.
ما نستخلصه منه
أمران، كلاهما قابل للنقل.
أولًا، صياغة السؤال. أين يتعطّل تدفّق المعلومات؟ يقود إلى عمل مختلف عمّا يقود إليه إلى أي حد يمكننا زيادة الحجم؟ — وهو سؤال قابل للتفكيك، ولهذا أمكن تطوير ثلاث آليات وقياسها كلٌّ على حدة.
ثانيًا، حدّ الاضمحلال. قيد لا يكلّف تقريبًا شيئًا من القدرة التعبيرية أزال مسارًا كاملًا خاصًا بحالة معينة من النواة. لم يصبح المسار أسرع، بل اختفى. هذه المقايضة متاحة أكثر بكثير مما يُستفاد منها، ولا يراها إلا من يجمع فهم الرياضيات والعتاد معًا.
التقرير والأوزان متاحان على GitHub. يتكوّن قسم المعمارية من ثماني صفحات، ويستحق قراءة متأنية.