
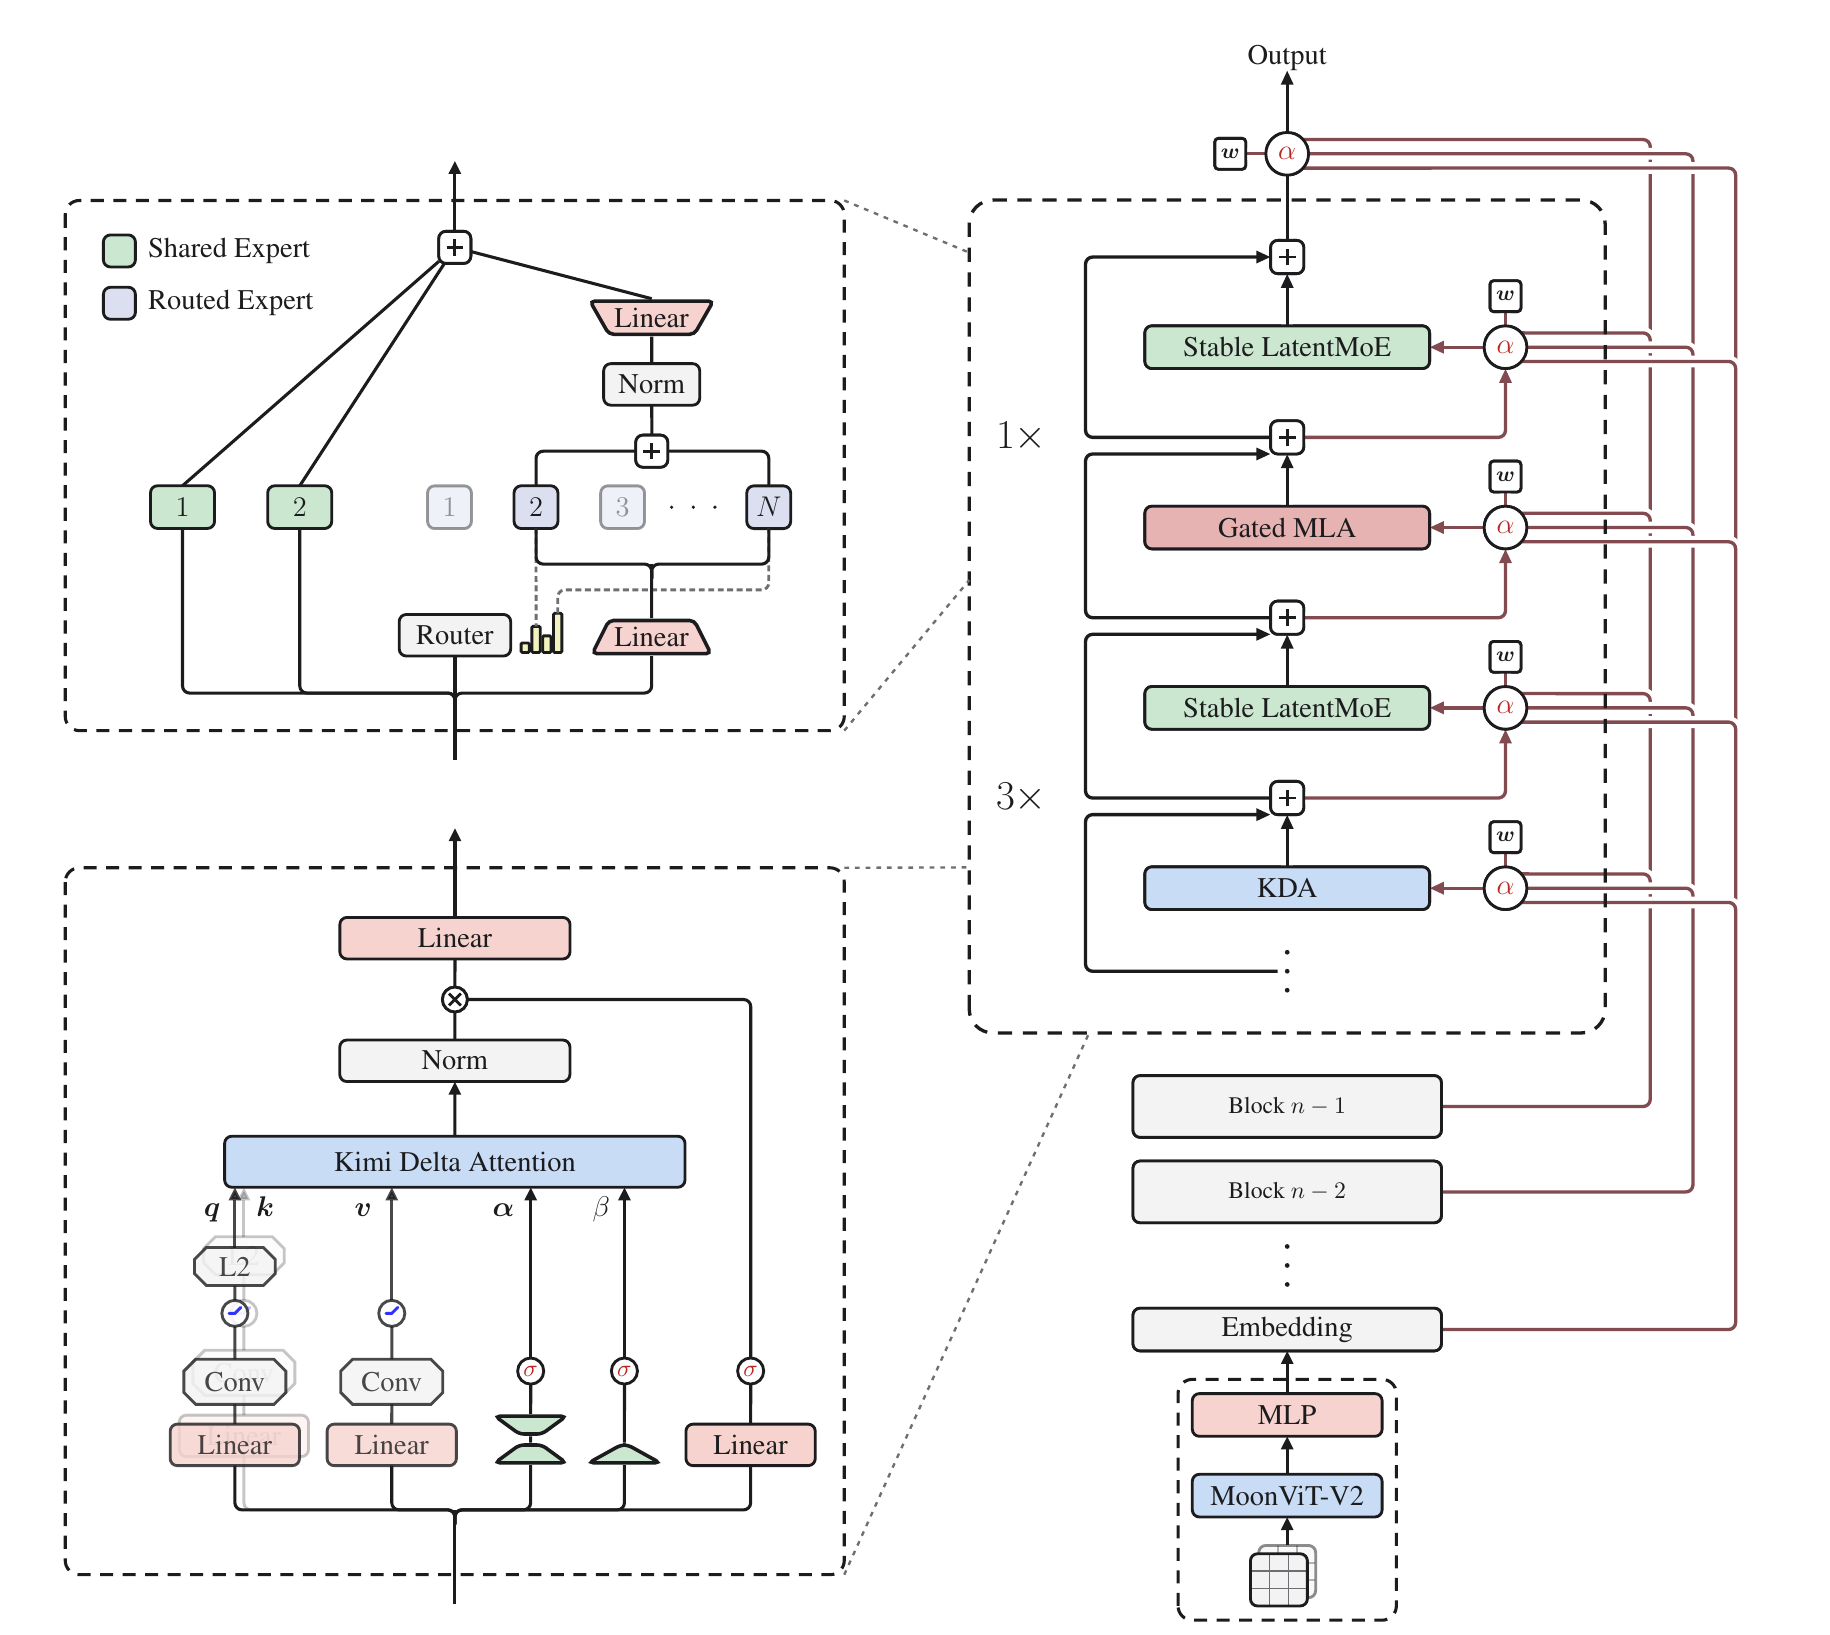
Le chiffre phare de Kimi K3 est de 2.8 billions de paramètres. C’est le chiffre le moins intéressant du rapport.
L’intérêt est ailleurs : l’architecture s’organise autour d’une question sans rapport avec la taille, où l’information circule-t-elle mal ? La réponse comporte trois volets — le long de la séquence, de la profondeur et de la largeur —, chacun doté de son propre mécanisme.
À calcul égal, l’efficacité du passage à l’échelle serait environ 2.5× celle de Kimi K2. Ce chiffre provient des courbes de lois d’échelle ajustées par l’équipe elle-même, pas d’une reproduction tierce : il faut donc le lire comme leur affirmation. Mais les mécanismes sous-jacents sont assez précis pour être discutés, ce qui rend le rapport digne d’intérêt.
Il s’agit d’une lecture attentive du rapport technique Kimi K3 de Moonshot AI, centrée sur sa section architecture. Nous avons déjà écrit sur la conception d’agents de longue durée ; cet article descend plus bas dans la pile technique.
Trois directions, pas un seul chiffre
Chaque couche d’un transformer mélange l’information de trois façons. Entre les tokens, pour que la position 900,000 puisse influencer la position 1. En profondeur, pour que la couche 90 puisse utiliser ce que la couche 3 a repéré. Entre les canaux, pour que les caractéristiques puissent se recombiner.
La plupart des travaux de passage à l’échelle font évoluer les trois à la fois en agrandissant tout. K3 les sépare et attribue à chacun son propre mécanisme :
- Séquence — attention hybride : trois couches Kimi Delta Attention pour une couche Gated MLA.
- Profondeur — Attention Residuals : chaque couche applique l’attention aux sorties de toutes les couches précédentes au lieu d’hériter d’un seul état accumulé.
- Largeur — Stable LatentMoE : 896 experts routés, dont 16 actifs par token.
La dimension cachée n’a pas changé du tout. 7168 dans K2, 7168 dans K3. Ce qui a grandi n’est donc pas la largeur d’une couche.
Séquence : trois quarts des couches ont cessé de tout relire
L’attention standard relit tout le préfixe pour chaque nouveau token. À un million de tokens, c’est ce coût qui devient intenable.
K3 partage le travail. Trois couches KDA maintiennent un état évolutif de taille fixe — davantage une prise de notes qu’une relecture de la source —, puis une couche Gated MLA réalise une attention globale complète. Ce motif se répète, avec une couche MLA supplémentaire tout à la fin pour que la dernière couche voie toujours l’ensemble. Sur 93 couches : 69 KDA, 24 MLA.
La taille fixe est tout l’intérêt. L’état ne grandit pas avec la séquence et ne peut donc pas exploser. Il perd aussi de l’information, raison pour laquelle une couche d’attention complète intervient toutes les quatre couches afin de retrouver ce que les notes ont omis.
Vient ensuite un effet secondaire. L’état récurrent comporte une décroissance : les tokens récents y sont naturellement plus présents que les anciens. L’information de position est donc obtenue sans coût supplémentaire. K3 n’applique ainsi aucun encodage positionnel à ses couches d’attention globale. Pas de RoPE, rien à remettre à l’échelle.
Étendre le contexte à un million de tokens n’a donc exigé aucune intervention sur l’encodage positionnel. Aucune des astuces d’interpolation accumulées dans le domaine pour étendre le contexte ne s’applique ici, puisqu’il n’y a aucun encodage à interpoler.
Une borne inférieure qui a supprimé un chemin de code GPU
C’est notre passage préféré du rapport, et il est assez court pour passer inaperçu.
L’état récurrent oublie au fil du temps. Pour calculer cela efficacement par blocs, il faut diviser par la décroissance accumulée, qui est un produit de nombres inférieurs à un. Sans limite, on finit par diviser par une valeur arbitrairement proche de zéro.
La génération précédente gérait cela en découpant chaque bloc en tuiles de 16 tokens et en travaillant dans l’espace logarithmique. Cela fonctionnait, mais les tuiles diagonales devaient encore être évaluées paire de positions par paire de positions : un chemin lent et spécifique, incapable d’utiliser les tensor cores.
La solution de K3 tient en une ligne de paramétrisation. Bornez inférieurement le logarithme de la décroissance : à chaque étape, l’état peut oublier jusqu’à ne conserver que 0.67% de son contenu, mais pas moins.
Suivons le raisonnement. Avec cette borne, le logarithme de la décroissance accumulée sur une tuile de 16 tokens reste dans (−80, 0). Son inverse est donc inférieur à e80 ≈ 5.5 × 1034, largement dans la plage de BF16, d’environ 3.4 × 1038. Aucun dépassement. Les tuiles diagonales peuvent donc utiliser la même multiplication matricielle dense que toutes les autres.
Le chemin spécifique n’est pas optimisé. Il disparaît.
Remontez la chaîne de causalité, et cela devient encore plus intéressant : la plage dynamique du matériel a déterminé l’intervalle acceptable, qui a déterminé la constante, qui a imposé une borne inférieure à l’activation. Les contraintes numériques ont choisi les mathématiques, pas l’inverse.
Profondeur : d’une course de relais à une discussion de groupe
Sur quatre-vingt-treize couches de profondeur, le flux résiduel standard est une course de relais. La couche 50 reçoit un état accumulé de la couche 49. Ce que chacune des couches 1 à 48 a repéré a été additionné dans cet état et n’est plus séparable.
L’article présente cela comme le même goulot d’étranglement que celui d’un RNN dans le temps, un problème que le domaine a déjà résolu avec l’attention. Attention Residuals applique la même solution à la profondeur : chaque couche porte une pseudo-requête apprenable et applique l’attention aux sorties de toutes les couches précédentes pour choisir ce qu’elle lit.
Appliqué littéralement, ce principe entraîne un coût de calcul quadratique avec la profondeur et, pire, oblige à conserver la sortie de chaque couche en mémoire et à la transmettre en parallélisme de pipeline. K3 utilise donc la variante par blocs : 93 couches réparties en groupes de douze, sommation au sein d’un groupe, attention complète entre groupes. Le surcoût passe de la couche au groupe, et l’état à l’inférence reste borné.
Largeur : 896 experts, 16 actifs
Un mélange d’experts conserve un vaste ensemble et n’en active que quelques-uns par token. K2 en choisissait 8 sur 384. K3 en choisit 16 sur 896, soit un facteur de parcimonie de 56.
Agrandir autant cet ensemble pose deux problèmes, que le rapport aborde avec une franchise inhabituelle.
Communication. Dans un MoE classique, chaque expert sélectionné reçoit le token sur toute sa largeur : le trafic augmente donc avec le nombre d’experts choisis. LatentMoE dissocie les deux : les experts routés travaillent dans un espace latent compact, de largeur égale à la moitié de celle du modèle, tandis que deux experts partagés de pleine largeur traitent les besoins communs à tous les tokens. L’ensemble peut grandir sans hausse correspondante du coût des échanges.
Stabilité. À ce niveau de parcimonie, la branche routée devient une chaîne de près de quatre multiplications matricielles consécutives, et les activations explosent. Deux corrections : une RMSNorm entre l’agrégation des experts et la projection ascendante, et une nouvelle activation, SiTU-GLU, qui borne les deux facteurs d’une SwiGLU avec une tanh mise à l’échelle, afin qu’aucun ne diverge en basse précision.
Équilibrage. La troisième correction mérite d’être reprise. Maintenir une charge équilibrée entre environ 900 experts exige d’ajuster un biais par expert à chaque étape. La méthode standard déplace chaque biais d’un incrément fixe dans le sens de l’erreur, ce qui provoque soit des oscillations, soit un retard. K3 calcule plutôt la solution : exécuter top-(k+1) au lieu de top-k, et l’entrée supplémentaire est le score exigé par un token pour être admis. Avec ces seuils, la charge reçue par un expert sous un biais candidat est monotone ; le biais qui atteint la charge cible est donc simplement un quantile des marges. Une passe avant, aucun pas d’ajustement à régler.
À grande échelle, ce quantile porte sur des millions de valeurs réparties entre tous les rangs ; il est donc estimé à partir d’un histogramme. Chaque rang compte ses classes, une opération all-reduce les additionne, puis le quantile est lu dans les comptages regroupés. Les comptages étant additifs, l’estimation reflète l’ensemble du lot quel que soit le partitionnement des tokens, au coût de quelques centaines de classes par expert.
Le coût se reporte sur la pile de service d’inférence
Rien de tout cela n’est gratuit, et la partie franche du rapport est la section infrastructure, où se manifeste le coût.
Un état récurrent de taille fixe coûte peu à stocker et à déplacer, mais ses mises à jour sont séquentielles et il ne s’additionne pas simplement. Ces deux propriétés demandent du travail :
- Répartir une séquence entre appareils. L’attention linéaire ordinaire permet à chaque appareil de calculer son état local à partir de zéro, puis d’additionner les résultats. KDA applique à l’état entrant une transition dépendante du token : la sommation est donc incorrecte. La solution décompose chaque segment en une transition cumulée et un état initialisé à zéro — deux quantités qui se composent bien —, puis retrouve l’état d’entrée de chaque appareil avec un balayage de préfixe et une opération all-gather de taille fixe.
- Réutiliser un préfixe entre requêtes. La moitié des caches est constituée de pages par token, l’autre d’un état fixe par requête, et une correspondance de cache exige que les deux puissent être restaurés à la même frontière. Leur réponse dissocie les granularités : hachage à 512 tokens, allocation entre 1024–6144, et points de contrôle de l’état récurrent uniquement sur un sous-ensemble peu dense des fins de blocs hachés.
- Décodage spéculatif. L’état est mis à jour sur place : un brouillon rejeté ne peut donc pas être annulé par retour arrière. Les entrées projetées, bien plus petites que l’état lui-même, sont mises en cache à la place, puis l’état est reconstruit sur la puce.
Dans les trois cas, on retrouve le schéma de la borne de décroissance, parcouru dans l’autre sens : l’architecture a choisi une représentation, et cette représentation a dicté le travail système.
Une habitude que l’article abandonne discrètement
K3 est nativement multimodal, et son encodeur de vision est entraîné à partir de zéro par prédiction du token suivant. Pas d’initialisation SigLIP, pas de préentraînement contrastif, alors que c’est la recette standard, y compris dans le modèle précédent de l’équipe.
La raison avancée n’est pas la qualité, mais la stabilité : l’encodeur initialisé par apprentissage contrastif affichait des normes de gradient durablement plus élevées, avec des pics fréquents lors de l’optimisation conjointe, tandis que celui entraîné de zéro restait stable. Les évaluations visuelles ont donné des résultats équivalents.
Ce constat est plus net qu’une victoire ne l’aurait été. Si l’entraînement de zéro avait été meilleur, on parlerait d’une meilleure recette. Les résultats étant équivalents, l’affirmation est qu’à cette échelle, une étape considérée comme obligatoire dans le domaine n’est en réalité que facultative.
Ce que cela signifie si vous exécutez des agents sur ces modèles
Nous construisons un client de bureau multi-agents. Nous regardons donc si une exécution de longue durée reste abordable, pas quel modèle domine un classement.
Le chiffre qui compte n’est pas la taille de la fenêtre de contexte, mais le coût de service d’un million de tokens. Trois quarts des couches portent un état de taille fixe : le cache qui grandit avec la conversation ne représente donc qu’un quart de celui d’un modèle de même profondeur entièrement fondé sur l’attention. Sur BrowseComp, le rapport attribue à K3 91.2% pour environ $2 par tâche, soit près de la moitié du coût du score propriétaire le plus proche et un ordre de grandeur de moins que les modèles Claude à effort maximal.
Pour un agent exécutant des centaines d’appels d’outils, ce ratio détermine si la tâche mérite même d’être tentée. Les travaux d’architecture qui semblaient relever de la recherche pure influent désormais directement sur la viabilité économique d’une longue exécution.
Ce que nous en retenons
Deux choses, toutes deux transposables.
D’abord, la manière de poser le problème. Où l’information circule-t-elle mal ? conduit à un travail différent de jusqu’où pouvons-nous agrandir ? Et la question se décompose, ce qui a permis de développer et de mesurer séparément trois mécanismes.
Ensuite, la borne de décroissance. Une contrainte presque sans coût en expressivité a supprimé tout un chemin spécifique du noyau. Pas un chemin plus rapide : plus de chemin du tout. Ce compromis est bien plus souvent possible qu’il n’est adopté, et seules les personnes qui maîtrisent à la fois les mathématiques et le matériel peuvent le voir.
Le rapport et les poids sont disponibles sur GitHub. La section architecture fait huit pages et mérite une lecture attentive.