
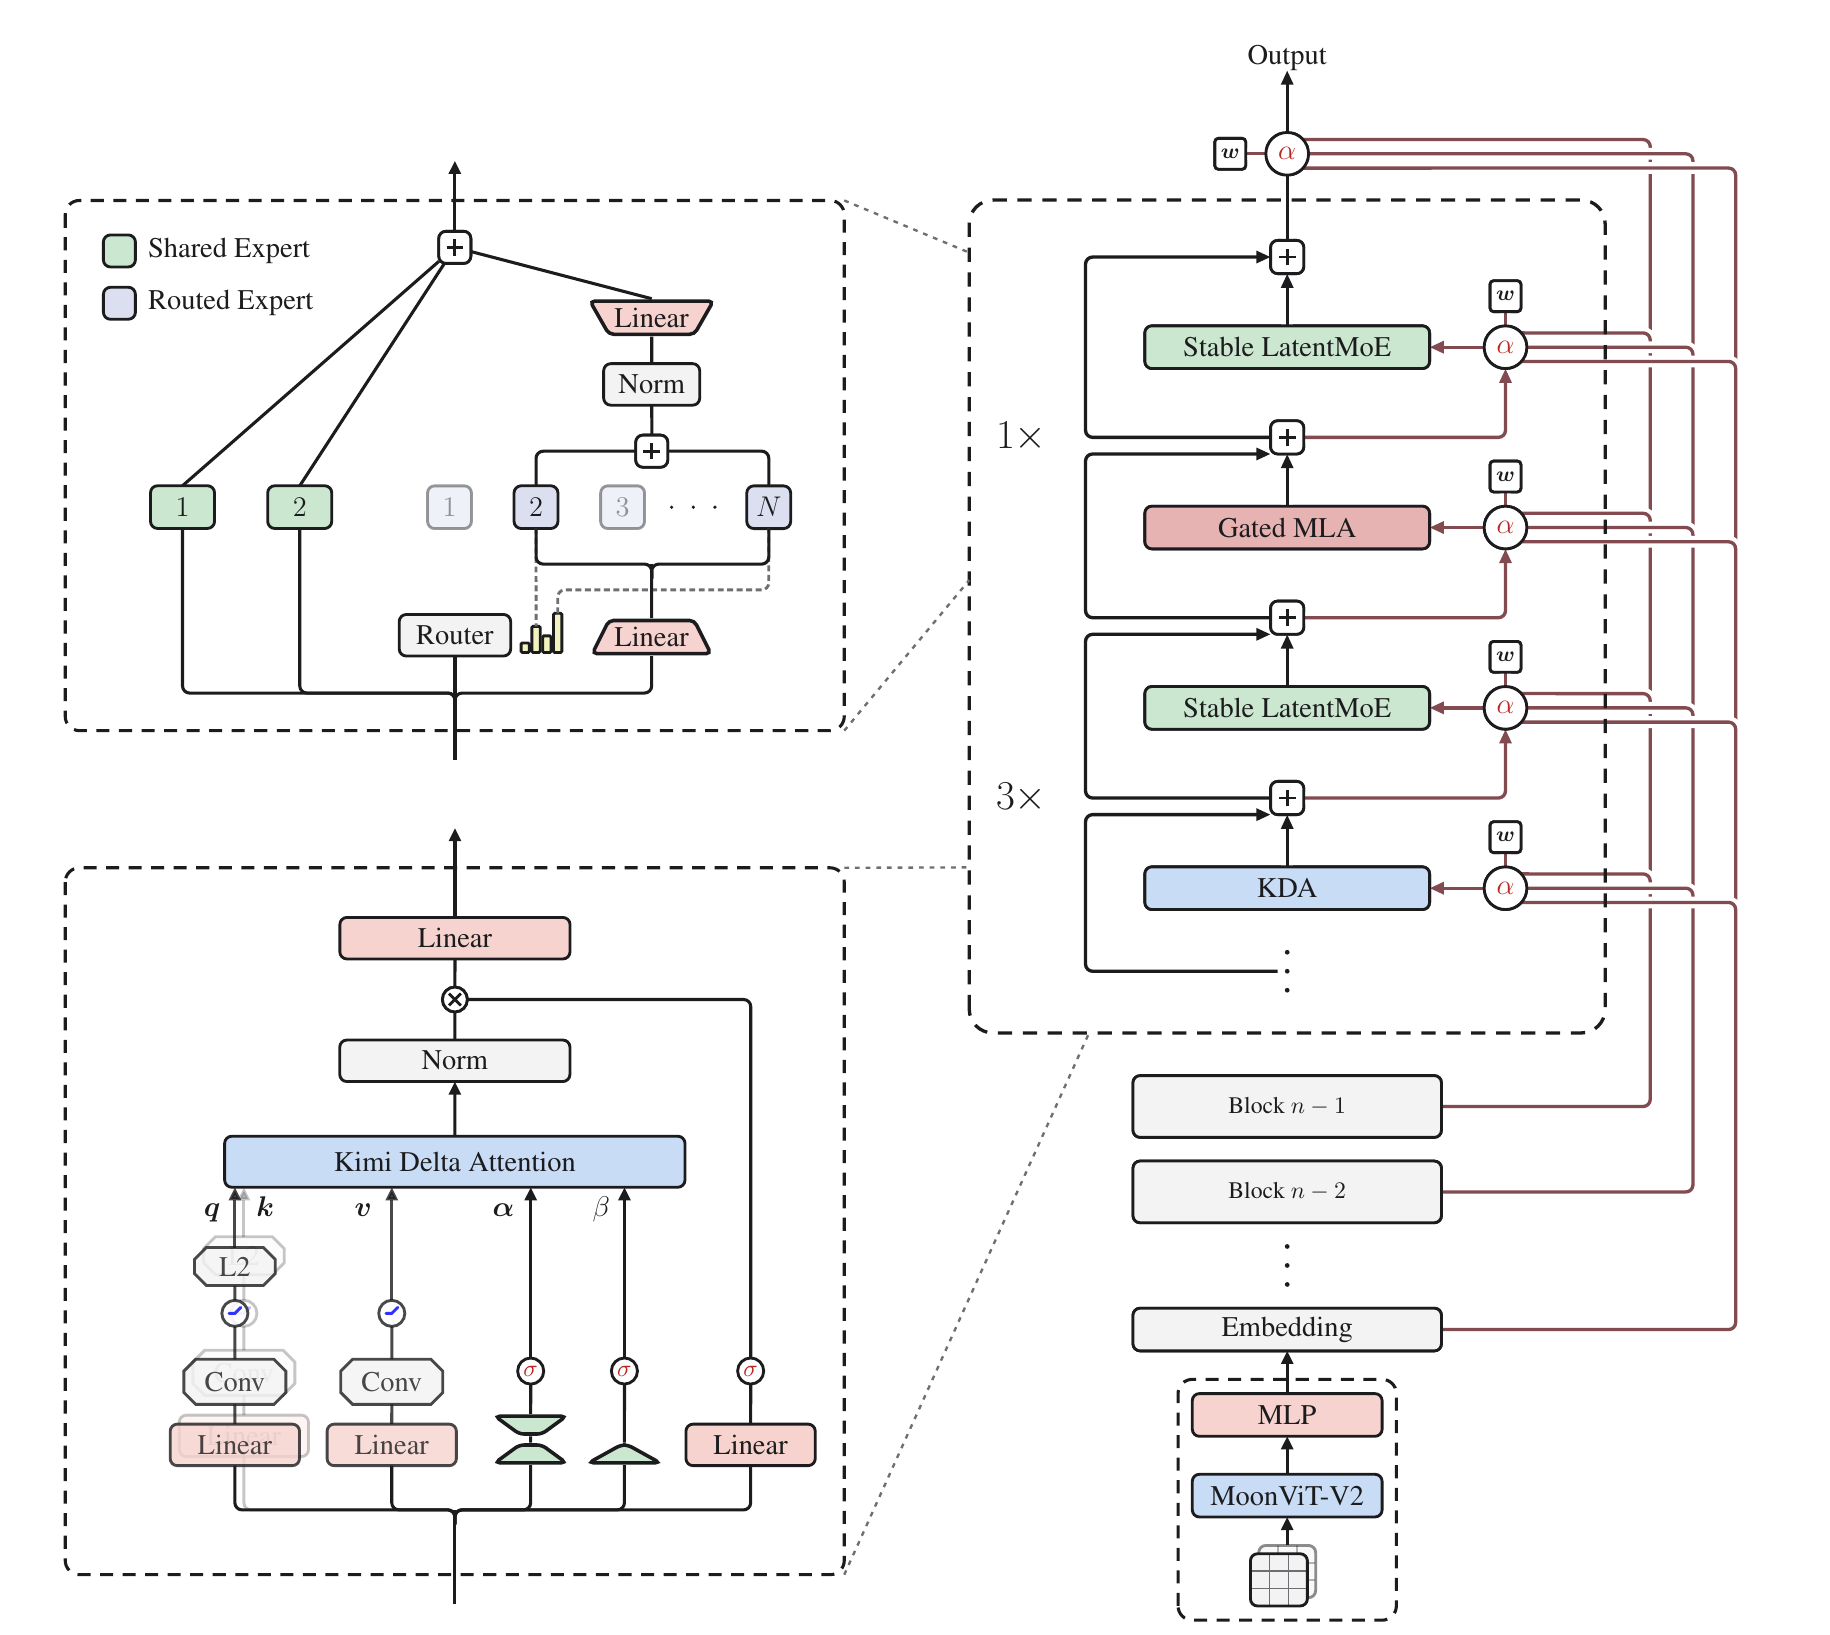
ตัวเลขพาดหัวของ Kimi K3 คือ 2.8 ล้านล้านพารามิเตอร์ แต่มันเป็นตัวเลขที่น่าสนใจน้อยที่สุดในรายงาน
สิ่งที่น่าสนใจคือ สถาปัตยกรรมถูกจัดวางรอบคำถามที่ไม่เกี่ยวกับขนาดเลย: ข้อมูลไหลติดขัดตรงไหน? คำตอบมีสามส่วน ได้แก่ ตามลำดับ ตามความลึก และตามความกว้าง โดยแต่ละส่วนมีกลไกของตัวเอง
ใช้การประมวลผลเท่าเดิม แต่มีประสิทธิภาพการขยายขนาดราว 2.5× ของ Kimi K2 ตัวเลขนี้มาจากเส้นโค้งกฎการขยายขนาดที่ทีมฟิตขึ้นเอง ไม่ใช่ผลทำซ้ำจากบุคคลที่สาม จึงควรอ่านในฐานะข้ออ้างของทีม แต่กลไกเบื้องหลังมีรายละเอียดเฉพาะพอให้ถกเถียงได้ ซึ่งทำให้รายงานนี้คุ้มค่าแก่การอ่าน
นี่คือการอ่าน รายงานทางเทคนิค Kimi K3 (Moonshot AI) อย่างละเอียด โดยเน้นส่วนสถาปัตยกรรม ก่อนหน้านี้เราเคยเขียนเรื่อง การออกแบบเอเจนต์ที่ทำงานระยะยาว บทความนี้ลงไปยังชั้นที่ลึกกว่าในระบบ
สามทิศทาง ไม่ใช่ตัวเลขเดียว
ทุกชั้นในทรานส์ฟอร์เมอร์ผสมข้อมูลสามทาง ข้ามโทเคน เพื่อให้ตำแหน่ง 900,000 ส่งผลต่อตำแหน่ง 1 ได้ ข้ามความลึก เพื่อให้ชั้น 90 ใช้สิ่งที่ชั้น 3 สังเกตพบได้ และข้ามแชนเนล เพื่อให้ฟีเจอร์ผสมกันใหม่ได้
งานขยายขนาดส่วนใหญ่ขยับทั้งสามทางพร้อมกันด้วยการทำให้ทุกอย่างใหญ่ขึ้น K3 แยกทั้งสามออกจากกันและให้แต่ละทางมีกลไกของตัวเอง:
- ลำดับ — กลไกแอตเทนชันแบบผสม: ชั้น Kimi Delta Attention สามชั้นต่อชั้น Gated MLA หนึ่งชั้น
- ความลึก — Attention Residuals: แต่ละชั้นทำแอตเทนชันกับเอาต์พุตของทุกชั้นก่อนหน้า แทนที่จะรับสถานะสะสมเพียงสถานะเดียว
- ความกว้าง — Stable LatentMoE: เอ็กซ์เพิร์ตที่เลือกผ่านการจัดเส้นทาง 896 ตัว ทำงาน 16 ตัวต่อโทเคน
มิติซ่อนไม่เปลี่ยนเลย K2 มี 7,168 และ K3 ก็มี 7,168 ไม่ว่าส่วนใดจะใหญ่ขึ้น แต่ไม่ใช่ความกว้างของชั้น
ลำดับ: สามในสี่ของชั้นเลิกอ่านทุกอย่าง
แอตเทนชันมาตรฐานอ่านข้อมูลก่อนหน้าทั้งหมดซ้ำสำหรับทุกโทเคนใหม่ เมื่อถึงหนึ่งล้านโทเคน ต้นทุนส่วนนี้จะรับไม่ไหว
K3 แบ่งงานออก ชั้น KDA สามชั้นเก็บสถานะต่อเนื่องขนาดคงที่ ซึ่งคล้ายการจดบันทึกมากกว่าการอ่านต้นฉบับซ้ำ ตามด้วยชั้น Gated MLA หนึ่งชั้นที่ทำแอตเทนชันทั่วทั้งลำดับอย่างเต็มรูปแบบ รูปแบบนี้ทำซ้ำไปเรื่อย ๆ โดยเพิ่มชั้น MLA อีกหนึ่งชั้นที่ท้ายสุด เพื่อให้ชั้นสุดท้ายเห็นทุกอย่างเสมอ รวม 93 ชั้น: KDA 69 ชั้น และ MLA 24 ชั้น
ขนาดคงที่คือหัวใจทั้งหมด สถานะไม่โตตามลำดับ จึงไม่ขยายจนควบคุมไม่ได้ แต่มันก็สูญเสียข้อมูลด้วย จึงมีชั้นแอตเทนชันเต็มรูปแบบทุกชั้นที่สี่เพื่อกู้สิ่งที่บันทึกตกหล่นไป
แล้วมีผลสืบเนื่องอีกชั้นหนึ่ง เพราะสถานะแบบวนซ้ำมีการลดทอน โทเคนล่าสุดจึงคงอยู่เด่นกว่าโทเคนเก่าโดยธรรมชาติ ข้อมูลตำแหน่งจึงติดมาด้วยโดยไม่ต้องเพิ่มอะไร ดังนั้น K3 จึง ไม่ใช้การเข้ารหัสตำแหน่งเลย ในชั้นแอตเทนชันทั่วทั้งลำดับ ไม่มี RoPE และไม่มีอะไรต้องปรับสเกล
นั่นหมายความว่า การขยายเป็นหนึ่งล้านโทเคนไม่ต้องผ่าตัดแก้การเข้ารหัสตำแหน่ง เทคนิคแทรกค่าต่าง ๆ ที่วงการสะสมมาเพื่อขยายบริบทไม่จำเป็นที่นี่ เพราะไม่มีการเข้ารหัสให้แทรกค่า
ขอบเขตล่างที่ลบเส้นทางโค้ด GPU ออกไป
นี่คือส่วนที่เราชอบที่สุดในรายงาน และเป็นรายละเอียดเล็กพอที่จะอ่านผ่านไปได้
สถานะแบบวนซ้ำลืมข้อมูลไปเรื่อย ๆ การคำนวณเป็นชังก์อย่างมีประสิทธิภาพต้องหารด้วยค่าการลดทอนสะสม และค่าการลดทอนสะสมคือผลคูณของตัวเลขที่ต่ำกว่าหนึ่ง หากปล่อยไว้โดยไม่ควบคุม คุณจะกำลังหารด้วยค่าที่เข้าใกล้ศูนย์ได้มากเท่าใดก็ได้
รุ่นก่อนจัดการเรื่องนี้ด้วยการแบ่งแต่ละชังก์เป็นไทล์ละ 16 โทเคนและคำนวณในปริภูมิลอการิทึม วิธีนี้ใช้ได้ แต่ไทล์บนแนวทแยงยังต้องคำนวณทีละคู่ตำแหน่ง เป็นเส้นทางกรณีพิเศษที่ช้าและใช้เทนเซอร์คอร์ไม่ได้
วิธีแก้ของ K3 คือการกำหนดพารามิเตอร์เพียงบรรทัดเดียว กำหนดขอบเขตล่างให้ลอการิทึมของการลดทอน: แต่ละขั้นลืมได้จนเหลือ 0.67% ของสิ่งที่เก็บไว้ แต่ต่ำกว่านั้นไม่ได้
ลองไล่ผลที่ตามมา ด้วยขอบเขตนี้ ลอการิทึมของการลดทอนสะสมในไทล์ 16 โทเคนจะอยู่ในช่วง (−80, 0) ดังนั้นค่าส่วนกลับจึงต่ำกว่า e80 ≈ 5.5 × 1034 ซึ่งอยู่ภายในช่วงค่าของ BF16 ที่ประมาณ 3.4 × 1038 ได้สบาย ไม่มีค่าใดล้นช่วง ไทล์บนแนวทแยงจึงใช้การคูณเมทริกซ์แบบหนาแน่นเดียวกับไทล์อื่นทั้งหมดได้
เส้นทางพิเศษไม่ได้ถูกปรับให้เร็วขึ้น แต่มันหายไปเลย
เมื่ออ่านเหตุและผลย้อนกลับจะยิ่งน่าสนใจ: ช่วงไดนามิกของฮาร์ดแวร์กำหนดช่วงค่าที่ยอมรับได้ ช่วงนั้นกำหนดค่าคงที่ และค่าคงที่กำหนดว่าฟังก์ชันกระตุ้นต้องมีขอบเขตล่าง ข้อจำกัดเชิงตัวเลขเป็นฝ่ายเลือกคณิตศาสตร์ ไม่ใช่กลับกัน
ความลึก: จากวิ่งผลัดสู่แชตกลุ่ม
ที่ความลึกเก้าสิบสามชั้น กระแสเรซิดิวอัลมาตรฐานเหมือนวิ่งผลัด ชั้น 50 รับสถานะสะสมหนึ่งสถานะจากชั้น 49 สิ่งที่แต่ละชั้นตั้งแต่ 1 ถึง 48 สังเกตพบถูกบวกรวมในสถานะนั้นแล้ว และแยกออกจากกันไม่ได้อีก
งานวิจัยมองว่านี่คือคอขวดเดียวกับที่ RNN พบตามแกนเวลา ซึ่งวงการแก้ไปแล้วด้วยแอตเทนชัน Attention Residuals นำวิธีแก้เดียวกันมาใช้กับความลึก แต่ละชั้นมีคำค้นเทียมที่เรียนรู้ได้ และทำแอตเทนชันกับเอาต์พุตของทุกชั้นก่อนหน้าเพื่อเลือกว่าจะอ่านอะไร
หากทำตรงตามนี้ ต้นทุนการคำนวณจะเพิ่มแบบกำลังสองตามความลึก และที่แย่กว่านั้นคือต้องเก็บเอาต์พุตของทุกชั้นไว้ในหน่วยความจำและส่งผ่านเครือข่ายเมื่อใช้การประมวลผลขนานแบบไปป์ไลน์ K3 จึงใช้แบบบล็อก: แบ่ง 93 ชั้นเป็นกลุ่มละสิบสอง บวกรวมภายในกลุ่ม และใช้แอตเทนชันเต็มรูปแบบข้ามกลุ่ม ต้นทุนส่วนเกินลดจากระดับชั้นเป็นระดับกลุ่ม และสถานะขณะอนุมานยังมีขอบเขตจำกัด
ความกว้าง: เอ็กซ์เพิร์ต 896 ตัว ทำงาน 16 ตัว
Mixture-of-experts เก็บเอ็กซ์เพิร์ตไว้จำนวนมาก แล้วเปิดใช้ไม่กี่ตัวต่อโทเคน K2 เลือก 8 จาก 384 ตัว ส่วน K3 เลือก 16 จาก 896 ตัว มีอัตราความเบาบาง 56
การขยายกลุ่มไปมากขนาดนั้นทำให้สองสิ่งพัง และรายงานพูดถึงทั้งสองอย่างตรงไปตรงมาอย่างหาได้ยาก
การสื่อสาร ใน MoE ทั่วไป เอ็กซ์เพิร์ตที่ถูกเลือกทุกตัวได้รับโทเคนเต็มความกว้าง ปริมาณข้อมูลรับส่งจึงเพิ่มตามจำนวนตัวที่เลือก LatentMoE แยกสองอย่างนี้ออกจากกัน: เอ็กซ์เพิร์ตที่เลือกผ่านการจัดเส้นทางทำงานในปริภูมิแฝงขนาดกะทัดรัดที่กว้างครึ่งหนึ่งของโมเดล ขณะที่เอ็กซ์เพิร์ตร่วมเต็มความกว้างสองตัวจัดการสิ่งที่ทุกโทเคนต้องใช้ กลุ่มเอ็กซ์เพิร์ตจึงโตได้โดยต้นทุนการรับส่งไม่โตตาม
เสถียรภาพ ที่ระดับความเบาบางนี้ แขนงที่ผ่านการจัดเส้นทางกลายเป็นสายการคูณเมทริกซ์ต่อเนื่องเกือบสี่ครั้ง และค่าแอกทิเวชันพุ่งระเบิด มีวิธีแก้สองอย่าง: เพิ่ม RMSNorm ระหว่างการรวมผลเอ็กซ์เพิร์ตกับการฉายขึ้น และใช้ฟังก์ชันกระตุ้นใหม่ SiTU-GLU ที่จำกัดตัวประกอบทั้งสองของ SwiGLU ด้วย tanh ที่ปรับสเกลแล้ว เพื่อไม่ให้ตัวใดพุ่งเกินควบคุมเมื่อใช้ความแม่นยำต่ำ
สมดุล วิธีแก้ที่สามเป็นวิธีที่ควรนำไปใช้ การกระจายโหลดให้เอ็กซ์เพิร์ตราว 900 ตัวอย่างสม่ำเสมอต้องปรับไบแอสรายเอ็กซ์เพิร์ตทุกขั้น วิธีมาตรฐานขยับไบแอสแต่ละตัวด้วยขนาดคงที่ตามทิศทางของความคลาดเคลื่อน ซึ่งทำให้แกว่งไปมาหรือตามไม่ทัน K3 แก้หาค่าโดยตรงแทน: ใช้ top-(k+1) แทน top-k แล้วรายการที่เพิ่มมานั้นคือ คือ คะแนนที่โทเคนกำหนดให้ต้องผ่านเพื่อได้รับเลือก เมื่อมีค่าเกณฑ์เหล่านี้ โหลดที่เอ็กซ์เพิร์ตได้รับภายใต้ค่าไบแอสที่พิจารณาจะเป็นฟังก์ชันเอกทิศทาง ดังนั้นไบแอสที่ทำให้ถึงโหลดเป้าหมายก็คือควอนไทล์ของค่ามาร์จิน ใช้การคำนวณไปข้างหน้าเพียงครั้งเดียว ไม่ต้องปรับขนาดก้าว
เมื่อขยายขนาด ควอนไทล์นั้นครอบคลุมค่าหลายล้านค่าจากทุกแรงก์ ทีมจึงประมาณจากฮิสโตแกรม: แต่ละแรงก์นับค่าในแต่ละช่วง ใช้ all-reduce หนึ่งครั้งบวกยอดเข้าด้วยกัน แล้วอ่านควอนไทล์จากยอดนับรวม เพราะยอดนับบวกกันได้ ค่าประมาณจึงสะท้อนทั้งแบตช์ไม่ว่าโทเคนจะถูกแบ่งอย่างไร โดยมีต้นทุนเพียงไม่กี่ร้อยช่วงต่อเอ็กซ์เพิร์ต
ต้นทุนมาตกที่ระบบให้บริการ
ไม่มีอะไรได้มาฟรี และส่วนที่ตรงไปตรงมาของรายงานคือส่วนโครงสร้างพื้นฐาน ซึ่งเป็นจุดที่ต้นทุนตกอยู่
สถานะแบบวนซ้ำขนาดคงที่เก็บและย้ายได้ด้วยต้นทุนต่ำ แต่ต้องอัปเดตตามลำดับ และนำมาบวกกันตรง ๆ ไม่ได้ คุณสมบัติทั้งสองทำให้มีงานเพิ่ม:
- การแบ่งลำดับข้ามอุปกรณ์ แอตเทนชันเชิงเส้นทั่วไปให้แต่ละอุปกรณ์คำนวณสถานะภายในจากศูนย์แล้วบวกผลเข้าด้วยกันได้ แต่ KDA ใช้การแปลงสถานะที่ขึ้นกับโทเคนกับสถานะขาเข้า การบวกจึงผิด วิธีแก้แยกแต่ละช่วงเป็นการแปลงสะสมกับสถานะที่เริ่มจากศูนย์ ซึ่งเป็นสองปริมาณที่ประกอบกันได้ แล้วกู้สถานะขาเข้าของแต่ละอุปกรณ์ด้วยการสแกนคำนำหน้าและ all-gather ขนาดคงที่หนึ่งครั้ง
- การใช้ข้อมูลส่วนต้นซ้ำข้ามคำขอ แคชครึ่งหนึ่งเป็นหน้าข้อมูลรายโทเคน อีกครึ่งเป็นสถานะคงที่หนึ่งสถานะต่อคำขอ และเมื่อพบแคชที่ตรงกัน ต้องกู้คืนทั้งสองส่วนที่ขอบเขตเดียวกันได้ คำตอบคือแยกความละเอียดออกจากกัน: แฮชทุก 512 โทเคน จัดสรรที่ 1024–6144 และบันทึกจุดตรวจของสถานะแบบวนซ้ำเฉพาะบางจุดปลายแฮชที่เว้นห่างกัน
- การถอดรหัสแบบคาดเดา สถานะอัปเดตทับที่เดิม จึงย้อนกลับไม่ได้เมื่อร่างถูกปฏิเสธ ทีมแคชอินพุตที่ผ่านการฉายแทน ซึ่งเล็กกว่าสถานะเองมาก แล้วสร้างสถานะใหม่บนชิป
รูปแบบร่วมของทั้งสามข้อเหมือนกับเรื่องขอบเขตการลดทอน แต่เดินคนละทิศ: สถาปัตยกรรมเลือกรูปแบบการแทนข้อมูล และรูปแบบนั้นกำหนดงานด้านระบบ
ธรรมเนียมหนึ่งที่งานวิจัยเลิกใช้อย่างเงียบ ๆ
K3 รองรับหลายสื่อมาแต่ต้น และตัวเข้ารหัสภาพฝึกจากศูนย์ด้วยการทำนายโทเคนถัดไป ไม่มีการตั้งต้นด้วย SigLIP ไม่มีการฝึกล่วงหน้าแบบเปรียบต่าง ซึ่งเป็นสูตรมาตรฐานที่แม้แต่โมเดลรุ่นก่อนของทีมเองก็ใช้
เหตุผลที่ระบุไม่ใช่คุณภาพ แต่เป็นเสถียรภาพ: ตัวเข้ารหัสที่ตั้งต้นจากการฝึกแบบเปรียบต่างมีนอร์มเกรเดียนต์สูงกว่าอย่างต่อเนื่องและพุ่งบ่อยเมื่อหาค่าเหมาะที่สุดร่วมกัน ขณะที่ตัวที่ฝึกจากศูนย์คงที่ ผลประเมินด้านภาพออกมาเสมอกัน
สิ่งนี้ทำให้ข้อค้นพบชัดกว่าการชนะเสียอีก ถ้าฝึกจากศูนย์แล้วดีกว่า คุณคงเรียกว่าสูตรที่ดีกว่า แต่ผลกลับเท่ากัน ข้อเสนอจึงเป็นว่า ที่ขนาดนี้ ขั้นตอนที่วงการถือว่าจำเป็นเป็นเพียงทางเลือก
สิ่งนี้หมายความอย่างไรเมื่อคุณใช้โมเดลเหล่านี้รันเอเจนต์
เราสร้างไคลเอนต์เดสก์ท็อปแบบหลายเอเจนต์ สิ่งที่เราดูจึงเป็นว่าการทำงานระยะยาวยังมีต้นทุนที่รับไหวหรือไม่ ไม่ใช่ว่าใครนำตารางจัดอันดับ
ตัวเลขที่สำคัญไม่ใช่ขนาดหน้าต่างบริบท แต่เป็นต้นทุนให้บริการหนึ่งล้านโทเคน สามในสี่ของชั้นเก็บสถานะขนาดคงที่ ดังนั้นแคชที่โตตามบทสนทนาจึงมีขนาดเพียงหนึ่งในสี่ของโมเดลที่ใช้แอตเทนชันทุกชั้นและมีความลึกเท่ากัน บน BrowseComp รายงานระบุว่า K3 ทำได้ 91.2% ด้วยต้นทุนราว $2 ต่องาน ประมาณครึ่งหนึ่งของต้นทุนโมเดลปิดที่ได้คะแนนใกล้ที่สุด และต่ำกว่าโมเดล Claude ที่ใช้ระดับความพยายามสูงสุดราวสิบเท่า
สำหรับเอเจนต์ที่เรียกใช้เครื่องมือหลายร้อยครั้ง อัตราส่วนนี้ตัดสินว่างานนั้นคุ้มจะลองทำหรือไม่ งานสถาปัตยกรรมที่เคยดูเป็นการวิจัยล้วน ๆ ตอนนี้ส่งผลโดยตรงว่าการทำงานระยะยาวสมเหตุสมผลด้านต้นทุนหรือไม่
สิ่งที่เราได้จากรายงาน
สองอย่างที่นำไปประยุกต์ใช้ได้ทั้งคู่
อย่างแรกคือการตั้งโจทย์ ข้อมูลไหลติดขัดตรงไหน? นำไปสู่งานที่ต่างจาก เราจะขยายให้ใหญ่ขึ้นได้อีกแค่ไหน? — และมันแยกเป็นส่วน ๆ ได้ จึงทำให้พัฒนาและวัดผลสามกลไกแยกกันได้
อย่างที่สองคือขอบเขตการลดทอน ข้อจำกัดที่แทบไม่ลดความสามารถในการแสดงออกของโมเดล ลบเส้นทางกรณีพิเศษทั้งเส้นออกจากเคอร์เนล ไม่ใช่เส้นทางที่เร็วขึ้น แต่ไม่มีเส้นทางนั้นอีกเลย โอกาสแลกเปลี่ยนแบบนี้มีบ่อยกว่าที่คนเลือกใช้มาก และมองเห็นได้เฉพาะคนที่เข้าใจทั้งคณิตศาสตร์และฮาร์ดแวร์พร้อมกัน
รายงานและน้ำหนักโมเดล เปิดเผยบน GitHub ส่วนสถาปัตยกรรมมีแปดหน้าและคุ้มค่าที่จะอ่านอย่างละเอียด