
Kimi K3 被拿來做標題的數字是 2.8 萬億參數。這是整份報告里最不值得看的一個數字。
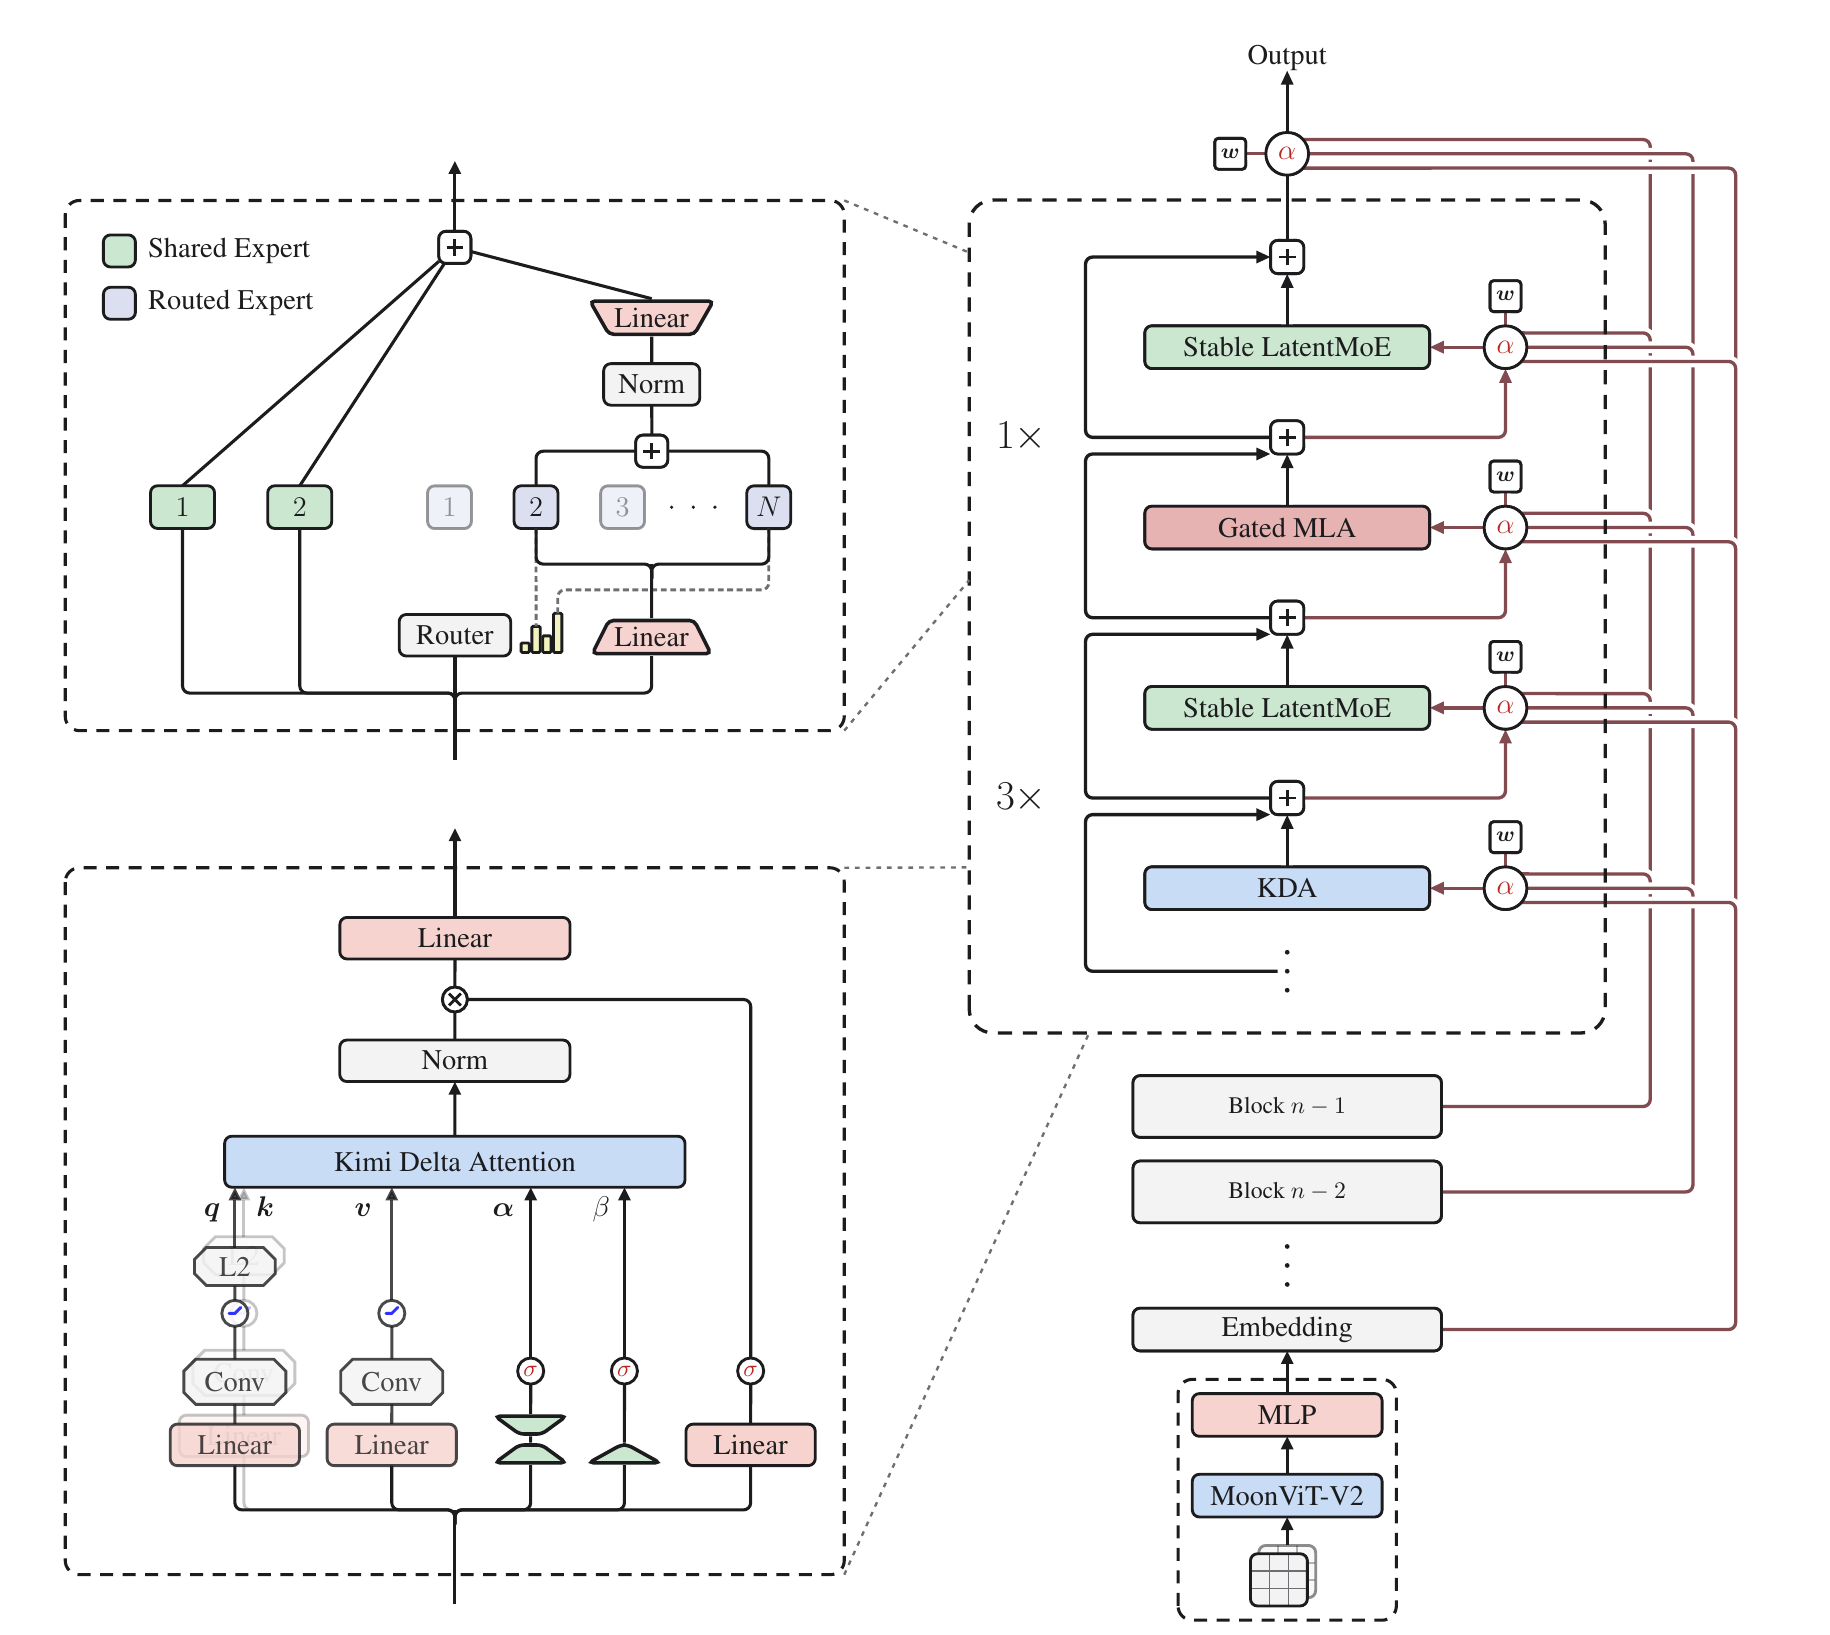
值得看的是:它的架構是圍繞一個跟規模無關的問題組織起來的——資訊在哪裡流不動? 答案分三部分:沿序列、沿深度、沿寬度,每一條各配一套機制。
同樣的算力,scaling 效率大約是 Kimi K2 的 2.5 倍。這個數來自團隊自己擬合的 scaling law 曲線,不是第三方復現,所以請把它當成他們的主張來讀。但支撐它的那幾套機制足夠具體、足夠可被質疑,這才是這份報告值得花時間的原因。
本文精讀 Kimi K3 技術報告(Moonshot AI)的架構部分。我們之前寫過長程 Agent 的設計,這一篇在技術棧上更靠下一層。
三個方向,而不是一個數字
Transformer 的每一層都在三個方向上混合資訊。跨 token,讓第 90 萬個位置能影響第 1 個位置;跨深度,讓第 90 層能用上第 3 層注意到的東西;跨通道,讓特徵可以重新組合。
大部分擴規模的工作是把三個方向一起變大。K3 把它們拆開,各給一套機制:
- 序列——混合注意力:每 3 層 Kimi Delta Attention 配 1 層 Gated MLA。
- 深度——Attention Residuals:每一層直接對前面所有層的輸出做注意力,而不是只繼承一個累積狀態。
- 寬度——Stable LatentMoE:896 個路由專家,每個 token 喚醒 16 個。
隱藏維度一點沒變。K2 是 7168,K3 還是 7168。不管什麼變大了,反正不是一層的寬度。
序列:四分之三的層不再讀全文
標準注意力每來一個新 token,都要把前面整段重讀一遍。到一百萬 token 的時候,壓垮系統的就是這筆賬。
K3 把這件事拆開做。3 層 KDA 維護一個固定大小的運行狀態——與其說是重讀原文,不如說是記筆記——後面跟 1 層 Gated MLA 做完整的全局注意力。這個模式一直重復,最後再額外補一層 MLA,保證最後一層永遠看得到全部。93 層里:69 層 KDA,24 層 MLA。
「固定大小」才是關鍵。狀態不隨序列增長,所以它撐不爆。但它同時是有損的,所以每四層要有一層全局注意力,把筆記丟掉的東西找回來。
然後是一個二階效應。因為這個遞歸狀態自帶衰減——越近的 token 天然越清晰——位置資訊就順帶有了。於是 K3 的全局注意力層完全不加位置編碼。沒有 RoPE,也就沒有什麼需要重新縮放的東西。
這意味著它擴到一百萬 token,不需要動任何位置編碼。這些年業界為擴上下文攢下的那一堆插值技巧,在這裡一個都用不上——因為根本沒有編碼可供插值。
一個下界,刪掉了一整條 GPU 代碼路徑
這是我們最喜歡的一段,而它小到很容易被翻過去。
遞歸狀態一邊走一邊遺忘。要按塊高效地算這件事,就得除以累積衰減,而累積衰減是一堆小於 1 的數連乘。放任不管,你就是在除以一個任意接近 0 的數。
上一代的處理辦法是把每個塊再切成 16 個 token 的小塊,並在對數空間里算。這管用,但對角線上的小塊仍然要一對一對位置地算——一條又慢又特殊、用不上 Tensor Core 的路徑。
K3 的解法只是改了一行參數化:給對數衰減加一個下界,每一步最多只能忘到還剩 0.67%,不許再少。
順著推下去。有了這個下界,16 個 token 的小塊上,累積對數衰減落在 (−80, 0) 區間內。倒數因此小於 e80 ≈ 5.5 × 1034,穩穩待在 BF16 約 3.4 × 1038 的範圍里。什麼都不會溢出。於是對角塊可以和其它塊用同一種稠密矩陣乘法。
那條特殊路徑不是被優化了,是沒有了。
把因果反過來讀會更有意思:是硬件的動態範圍決定了可接受的區間,區間決定了這個常數,常數決定了激活函數必須有下界。是數值精度選擇了數學形式,而不是反過來。
深度:從接力賽變成群聊
93 層深下去,標準的殘差流就是一場接力賽。第 50 層只收到第 49 層交給它的那一個累積狀態。第 1 到 48 層各自注意到了什麼,早就被加進那個狀態里,再也拆不出來了。
論文的說法是:這和 RNN 在時間維上的瓶頸是同一個——而那個瓶頸業界早就解決了,用的是注意力。Attention Residuals 把同一套解法搬到深度上:每一層帶一個可學習的偽 query,對前面所有層的輸出做注意力,自己決定讀誰。
照字面做,代價是深度上的平方級計算,更麻煩的是要把每一層的輸出都留在顯存里,在流水線並行下還要跨階段傳輸。所以 K3 用的是分塊版本:93 層切成每 12 層一組,組內求和,組間做全注意力。開銷從每層降到每組,推理時的狀態也被限住了。
寬度:896 個專家,醒著 16 個
MoE 的做法是養一個大池子,每個 token 只喚醒其中幾個。K2 是 384 里選 8,K3 是 896 里選 16——稀疏度 56。
把池子擴到這個程度會撞壞兩件事,而報告對這兩件事都寫得異常直白。
通信。 常規 MoE 里每個被選中的專家都要收到完整寬度的 token,所以流量隨選中數量線性增長。LatentMoE 把兩者解耦:路由專家在一個只有模型寬度一半的緊湊隱空間里工作,另有兩個全寬的共享專家處理每個 token 都需要的部分。池子可以變大,而線上的通信量不跟著漲。
穩定性。 在這個稀疏度下,路由分支變成了接近四次連乘的矩陣鏈,激活值會炸。兩個補丁:在專家聚合和上投影之間插一個 RMSNorm;換一個新的激活函數 SiTU-GLU,用帶縮放的 tanh 給 SwiGLU 的兩個乘子各加一個軟上限,讓它們在低精度下都跑不飛。
負載均衡。 第三個補丁是最值得偷的。讓大約 900 個專家保持負載均勻,意味著每一步都要調整每個專家的偏置。標準做法是按誤差方向以固定步長挪一下,結果不是震蕩就是跟不上。K3 改成直接求解:把 top-k 換成 top-(k+1),多出來的那一項本身就是這個 token 的准入門檻。有了這些門檻,某個專家在給定偏置下會拿到多少 token 就是單調的,於是命中目標負載的那個偏置,無非是 margin 的一個分位數。一次前向搞定,沒有步長要調。
在真實規模下,這個分位數橫跨所有 rank 上的數百萬個值,所以他們用直方圖來估:每個 rank 統計自己的 bin,一次 all-reduce 求和,再從池化後的計數里讀出分位數。計數是可加的,所以無論 token 怎麼分片,估出來的都等價於整個 batch 的分位數,代價只是每個專家幾百個 bin。
賬單落在服務棧上
這些都不是免費的。報告最誠實的部分是基礎設施那一章,代價就落在那裡。
固定大小的遞歸狀態存起來便宜、傳起來也便宜,但它是串行更新的,而且不能簡單相加。這兩個性質各自帶來一堆工作:
- 把序列切到多個設備上。 普通線性注意力可以讓每個設備從零算出自己的局部狀態,再求和。但 KDA 會把一個與 token 相關的轉移作用在入態上,所以求和是錯的。解法是把每一段拆成「累積轉移」和「從零起算的狀態」兩個量——這兩個是可以組合的——再用前綴掃描加一次固定大小的 all-gather 恢復每個設備的入態。
- 跨請求復用前綴。 一半的緩存是按 token 分頁的,另一半是每個請求一份定長狀態,而一次命中要求兩者能在同一個邊界上同時恢復。他們的答案是把粒度解耦:按 512 個 token 做哈希,按 1024–6144 分配物理塊,遞歸狀態只在哈希端點的一個稀疏子集上存快照。
- 投機解碼。 狀態是原地更新的,草稿被拒時沒法回滾。他們改成緩存投影後的輸入——比狀態本身小得多——然後在片上重建。
這三件事的模式,和那個衰減下界是同一個,只是方向相反:架構選定了一種表示,而表示反過來規定了系統層要做的活。
報告悄悄放棄的一個行業慣例
K3 是原生多模態的,而它的視覺編碼器是用 next-token prediction 從零訓出來的。沒有 SigLIP 初始化,沒有對比預訓練——而那才是標準配方,團隊自己上一代模型用的也是它。
給出的理由不是效果,是穩定性:對比初始化的編碼器在聯合優化時梯度範數一直偏高、還頻繁尖刺,從零訓的那個則全程平穩。視覺評測的成績打平。
正因為打平,這個發現反而比贏了更有分量。如果從零訓更好,你會說那是個更好的配方。它只是打平——所以結論是:在這個規模上,一個被業界當成必選項的步驟,其實只是可選項。
如果你在這些模型上跑 Agent,這意味著什麼
我們做的是多 Agent 桌面客戶端,所以我們盯的不是誰在榜首,而是一次長程任務跑下來還付不付得起。
真正要緊的數字不是上下文窗口有多大,而是一百萬 token 服務起來要多少錢。四分之三的層帶的是定長狀態,所以隨對話增長的那部分緩存,只有同深度全注意力模型的四分之一。BrowseComp 上,報告給出的是 91.2%、每個任務大約 2 美元——約為最接近的閉源分數的一半成本,比最高推理檔下的 Claude 系低一個數量級。
對一個要跑幾百次工具呼叫的 Agent 來說,這個比值直接決定了一個任務值不值得開始。過去讀起來像純研究的架構工作,現在直接體現在「這次長任務在經濟上合不合理」上。
我們從中拿走了什麼
兩件事,都可遷移。
第一是提問方式。資訊在哪裡流不動? 會導向和 我們還能做多大? 完全不同的工作——而且它可分解,這正是三套機制能被分別開發、分別度量的原因。
第二是那個衰減下界。一個在表達能力上幾乎不花錢的約束,從內核里移除了一整條特殊路徑。不是更快的路徑,是沒有路徑。這種交換的機會遠比實際被抓住的多,而且只有同時握著數學和硬件的人才看得見。
報告和權重都開在 GitHub 上。架構那一章八頁,值得慢慢讀一遍。