
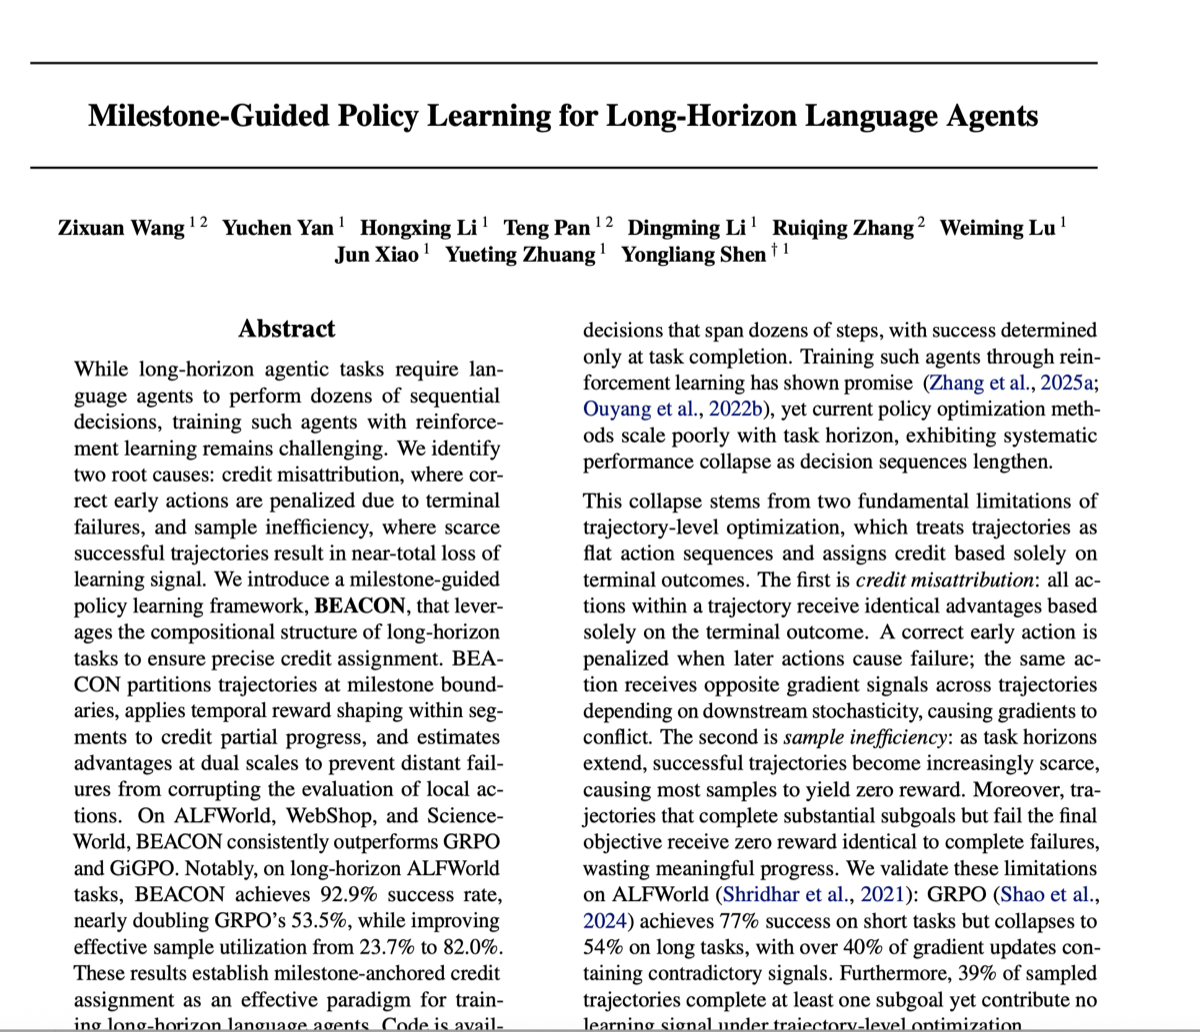
Los agentes de horizonte largo —los que ejecutan decenas de pasos antes de que algo esté terminado de forma verificable— fallan de una manera que no se da en los agentes de horizonte corto. El rendimiento no se deteriora gradualmente a medida que las tareas se alargan. Se desploma.
Un artículo reciente del laboratorio ZJU-REAL de la Universidad de Zhejiang, Aprendizaje de políticas guiado por hitos para agentes de lenguaje de horizonte largo, diagnostica ese desplome con suficiente precisión como para resultar útil incluso si nunca entrenas una política. El método se llama BEACON; el código es de código abierto.
Lo leímos con atención porque el problema que describe es el mismo con el que nos encontramos una y otra vez al desarrollar el producto. A continuación exponemos el argumento del artículo, un punto en el que tuvimos que revisar las matemáticas para conciliar un resultado y lo que creemos que se puede trasladar a la arquitectura de agentes.
Dos modos de fallo, ambos medibles
Lo que más valoramos es que el artículo no empieza con un método. Empieza con una autopsia: Qwen2.5-1.5B entrenado con GRPO en ALFWorld, con el colapso desglosado en dos causas cuantificadas.
Atribución incorrecta del crédito
El aprendizaje por refuerzo a nivel de trayectoria trata una ejecución como una secuencia plana de acciones. Todas las acciones comparten una única puntuación final. Así, una misma acción correcta recibe un gradiente positivo en una ejecución exitosa y uno negativo en una fallida: que fuera «correcta» depende de lo que ocurrió después.
Los autores cuantifican esto mediante la proporción de acciones contradictorias: la fracción de acciones que reciben ventajas de signo opuesto en distintas trayectorias pese a ejecutarse en estados idénticos. Alcanza un máximo superior al 40%. Tras la cancelación de esos gradientes, la señal efectiva de aprendizaje cae por debajo del 20%.
Uso ineficiente de las muestras
Clasifiquemos las trayectorias en tres grupos: éxito total, éxito parcial (al menos un subobjetivo completado, pero la tarea sigue habiendo fallado) y fracaso total:
- Los éxitos parciales se mantienen estables en el 39–47% de las muestras durante todo el entrenamiento.
- Los éxitos totales se mantienen por debajo del 27%.
Con GRPO, tanto un éxito parcial como un fracaso total reciben una puntuación de cero. Más del 73% de las muestras no producen ninguna señal de aprendizaje.
Ambos problemas se agravan a medida que se alargan los horizontes: las tareas más largas tienen éxito con menos frecuencia (más éxitos parciales) y ofrecen más oportunidades para que la aleatoriedad de los pasos posteriores distorsione el crédito. En concreto, en ALFWorld: 76.7% en tareas cortas y 53.5% en tareas largas.
La idea clave: las tareas largas ya tienen estructura
Las tareas de horizonte largo se descomponen en fases delimitadas por hitos: transiciones de estado verificables que marcan la finalización de subobjetivos. La optimización plana simplemente descarta esa estructura.
Los autores lo formalizan como la propiedad de Markov de los hitos: una vez que se alcanza un estado de hito, la distribución del resto de la trayectoria depende principalmente de qué subobjetivos quedan, no del historial completo de cómo se llegó hasta allí.
Una vez que tienes la llave, lo que ocurre después depende de lo que hagas con ella, no de cómo la encontraste.
Esa propiedad aproximada de Markov es lo que permite desacoplar el crédito entre segmentos.
El método, en tres pasos
1. Dividir en los hitos
Un detector Φ identifica los pasos temporales correspondientes a hitos y divide la trayectoria en segmentos. La decisión de diseño que creemos que se subestima: Φ no necesita ningún modelo aprendido ni anotaciones humanas. Lee los cambios de estado observables directamente de la retroalimentación del entorno: transiciones de estado de objetos en ALFWorld, transiciones de página en WebShop y señales explícitas de subobjetivos en ScienceWorld.
Cero modelos adicionales, cero trayectorias de ejecución adicionales. Esa es toda la ventaja de costo frente a los modelos de recompensa de proceso y la estimación de valor mediante Monte Carlo.
2. Moldeado temporal de recompensas dentro de cada segmento
r_t = R_ms * γ^(t_k − t)   if segment k ends in a completed milestone
    = 0                    otherwise
Solo reciben recompensa los segmentos que terminan en un hito y, dentro de ellos, las acciones más cercanas al hito reciben más. Ahora cada acción de un segmento completado aporta señal, de modo que los éxitos parciales dejan de descartarse.
3. Ventaja a dos escalas
El nivel de trayectoria utiliza la normalización estándar de GRPO sobre las recompensas finales. La idea central está en el nivel de segmento, en cómo se define el grupo de comparación:
G_k = { i : K_i ≥ k }          # only trajectories that ALSO reached milestone k

A_seg(i,t) = r_t − (1/|G_k|) · Σ_{j∈G_k}  R_k(j) / |Seg_k(j)|
                               └── group-average PER-STEP return ──┘
Las acciones del segmento k se comparan solo con trayectorias que también alcanzaron el hito k. A partir de esto, los autores derivan una propiedad de aislamiento de la varianza: que los segmentos posteriores tengan éxito o fracasen no puede contaminar matemáticamente el crédito del segmento actual.
La ventaja final es A_traj + λ · A_seg, optimizada con un objetivo sustituto recortado estándar de PPO. Los hiperparámetros γ=0.95, λ=1.0 se mantienen fijos en todas las pruebas de referencia, sin ajustes por tarea.
Resultados
ALFWorld, Qwen2.5-1.5B:
| Método | Cortas | Medias | Largas | Promedio |
|---|---|---|---|---|
| GRPO | 76.7 | 73.9 | 53.5 | 72.8 |
| GiGPO | 90.7 | 84.3 | 79.5 | 86.1 |
| BEACON | 96.8 | 87.0 | 92.9 | 91.4 |
Tasa de éxito en los otros dos entornos:
| Método | ScienceWorld | WebShop |
|---|---|---|
| GRPO | 21.1 | 56.8 |
| GiGPO | 25.8 | 65.0 |
| BEACON | 45.3 | 75.6 |
El modelo de 1.5B supera a GPT-4o en ALFWorld (91.4 frente a 48.0) y WebShop (75.6 frente a 23.7), y lo iguala en ScienceWorld (45.3 frente a 45.4). Conviene hacer una salvedad: los modelos cerrados reciben instrucciones con ReAct, no se entrenan. El aprovechamiento de las muestras sube del 23.7% al 82.0%, y la convergencia es más rápida: 60% de éxito en la iteración 50, mientras que GRPO necesita llegar a la iteración 120.
El resultado más convincente es que las mejoras aumentan con el horizonte. En 7B, la mejora relativa frente a GRPO pasa de +13% en tareas cortas a +39% en tareas largas; GiGPO solo pasa de +11% a +22%. La razón importa: GiGPO construye grupos de comparación a nivel de paso a partir de estados repetidos y, a medida que una política mejora y sus trayectorias se diversifican, la recurrencia de estados se vuelve más escasa: su propia fuente de señal se erosiona. Los hitos como puntos de referencia no pierden valor a medida que la política mejora.
Que el beneficio de un método crezca a medida que el problema se vuelve más difícil es una afirmación mucho más sólida que obtener una puntuación media más alta.
La métrica que parece una contradicción
El artículo define una razón de concentración del crédito: la magnitud media de la ventaja de las acciones de hito dividida por la de las acciones que no son hitos. Un valor superior a 1 significa que el crédito se concentra en los hitos.
| Método | CCR |
|---|---|
| GiGPO | 2.36 |
| GRPO | 1.37 |
| BEACON | 0.84 |
Así que el método con mejor rendimiento es el que menos concentra el crédito en los pasos clave, lo que parece contradecir directamente que «las acciones más cercanas al hito reciben más recompensa». No es así. Las dos afirmaciones miden cantidades distintas, con dos transformaciones de por medio.
Transformación 1: recompensa moldeada. Dentro de un segmento, la recompensa sí aumenta de forma monótona hacia el hito. Con γ=0.95 y un segmento de longitud 5, las cinco acciones reciben 0.8145, 0.857, 0.9025, 0.95, 1.0. Pero esto es la recompensa, no el crédito que llega al gradiente.
Transformación 2: restar el valor de referencia del grupo. El valor de referencia es el retorno medio del grupo por paso (retorno del segmento ÷ longitud del segmento). Para un segmento de longitud L, el retorno por paso es (1−γ^L) / (L(1−γ)):
| Longitud del segmento | 3 | 5 | 8 | 10 |
|---|---|---|---|---|
| Retorno por paso | 0.951 | 0.905 | 0.842 | 0.803 |
Si tu segmento necesitó 8 pasos mientras que el promedio del grupo fue de 5, tu retorno por paso queda por debajo del valor de referencia y la ventaja de todo el segmento tiende a ser negativa. Observa lo que esto significa: la penalización por dar rodeos no proviene del decaimiento en sí, sino del decaimiento al actuar a través del valor de referencia por paso. Por sí solo, el decaimiento únicamente ordena las acciones dentro de un segmento. En este punto, la CCR dentro de un segmento completado sigue siendo mayor que 1.
Transformación 3: sumar el término a nivel de trayectoria. Aquí es donde la CCR cae por debajo de 1, por dos efectos asimétricos. Primero, el segmento final de una trayectoria fallida no entra en ningún grupo de comparación: como G_k = {i : K_i ≥ k} y el tramo final incompleto tiene índice K_i + 1 > K_i, esa trayectoria queda excluida. El tramo final no recibe ventaja a nivel de segmento, solo el término a nivel de trayectoria en toda su magnitud, y todas esas acciones son acciones que no son hitos, lo que infla el denominador. Segundo, en las trayectorias fallidas, el término negativo a nivel de trayectoria se cancela con el crédito positivo a nivel de segmento de las acciones de hito, reduciendo su magnitud hacia cero.
La propia figura 8 del artículo lo confirma. En una trayectoria fallida que completó los hitos S3 y S4:
| go to toilet | put soapbar (S3✓) | go to counter (S4✓) | go to counter | go to holder | |
|---|---|---|---|---|---|
| GRPO | −2.50 | −2.50 | −2.50 | −2.50 | −2.50 |
| BEACON | −0.92 | +0.51 | +0.32 | −2.20 | −2.20 |
Los dos últimos valores son idénticos: la huella de que «el segmento final solo recibe el término a nivel de trayectoria», lo que permite deducir directamente A_traj ≈ −2.20. Las dos acciones de hito son positivas, pero su magnitud es de solo ~0.5, porque el término negativo de trayectoria absorbió la mayor parte del crédito a nivel de segmento. La CCR de esta trayectoria es 0.23; para una trayectoria exitosa es 2.95. El valor global de 0.84 es la mezcla.
Por tanto, la CCR mide la concentración de la magnitud del gradiente, no quién recibió recompensa. Una CCR baja no es un objetivo de diseño: es un efecto secundario de la asignación densa dentro de los segmentos y de la superposición de las dos escalas. La conclusión de los autores sigue siendo válida, y es buena: no concentres toda la energía del gradiente en los pasos clave. El 2.36 de GiGPO significa que las acciones preparatorias intermedias casi no reciben señal, y son precisamente las que hacen posible alcanzar un hito.
Algo que el artículo no explica de forma explícita
Hay una celda extraña en la tabla de ablación. Al fijar γ=1 —crédito uniforme dentro de cada segmento— se obtiene 71.8, peor que sin moldeado alguno (γ=0, 81.2) e incluso por debajo del 72.8 de GRPO. El artículo lo atribuye a «gradientes engañosos».
Al revisar las matemáticas, la respuesta es más precisa. Con γ=1, cada acción de un segmento completado recibe la misma recompensa, de modo que todos los segmentos completados, independientemente de su longitud, tienen un retorno por paso de exactamente R_ms. El valor de referencia es igual a ese valor, y:
A_seg(i,t) ≡ R_ms − R_ms = 0 for every actionEl canal a nivel de segmento no induce a error. Se anula de forma idéntica, y el método se reduce exactamente a GRPO. Compáralo con la tabla: 71.8 frente al 72.8 de GRPO, un punto de diferencia, que es ruido entre ejecuciones.
Esto replantea para qué sirve el decaimiento. No se trata solo de diferenciar acciones dentro de un segmento; es una condición necesaria para que exista siquiera la señal a nivel de segmento. Sin él, el valor de referencia por paso cancela la señal de inmediato.
Tres experimentos que resuelven las objeciones evidentes
Hay que reconocerles el mérito: los autores se anticipan a las tres preguntas que se hace un lector escéptico:
- ¿Esto es solo clonación de comportamiento? El ajuste fino supervisado (SFT) sobre trayectorias de un oráculo alcanza el 43%; BEACON llega al 91.4%. La política encuentra estrategias de ejecución mejores que las del oráculo, así que no está imitando.
- ¿Las mejoras se deben simplemente a la división en segmentos? La partición aleatoria obtiene un 74.2%, apenas 1.4 puntos por encima de GRPO. Los hitos reales obtienen un 91.4%: una diferencia de 17.2 puntos. El beneficio proviene de la estructura intrínseca de la tarea.
- ¿Qué pasa si el detector no es fiable? Omitir aleatoriamente el 50% de los hitos sigue dando un 82.8%, diez puntos por encima de GRPO. La degradación es gradual.
Qué se puede trasladar al diseño de agentes
BEACON es un método de entrenamiento, y la mayoría de los productos, incluido el nuestro, orquestan modelos en lugar de entrenarlos. Las fórmulas no se pueden trasladar. El diagnóstico sí, y se refleja en la arquitectura de una forma sorprendentemente directa.
El progreso parcial debe ser un estado de primer nivel y persistente. La cifra más reveladora del artículo es que el 39–47% de las ejecuciones completan subobjetivos reales y luego reciben la misma puntuación que las ejecuciones que no hicieron nada. Una sesión de agente de larga duración que completa tres subobjetivos y después se estanca tiene el mismo problema: si el sistema solo registra «en ejecución» y «terminado», ese progreso se pierde y el reintento empieza desde cero. Los hitos proporcionan el vocabulario para registrarlo.
Los hitos deben provenir de efectos observables, no de lo que el propio modelo declara. La razón por la que Φ tiene un costo bajo es que lee transiciones de estado verificables en lugar de preguntar a la política si avanzó. Los entornos de ejecución de agentes tienen ese mismo recurso disponible y a menudo lo ignoran: un archivo escrito, una prueba que terminó con código cero, una llamada a un conector que devolvió un resultado exitoso, un documento guardado en la base de conocimiento. Esos son hechos verificables. Que un modelo afirme «paso uno completado» no lo es.
Los límites entre hitos son puntos bien fundamentados para compactar y reanudar. La propiedad de Markov de los hitos dice que, una vez alcanzado un hito, lo anterior importa mucho menos. Esa es una justificación mucho mejor para compactar el contexto que «alcanzamos un umbral de tokens», y ese mismo límite es el punto de control natural desde el que reanudar después de un fallo.
Verifica a dos escalas, no a una. Este es el resultado de ablación que destacaríamos para cualquiera que construya flujos de trabajo con agentes: eliminar la señal a nivel de trayectoria hace caer ALFWorld del 91.4% al 23.4%. Con retroalimentación solo a nivel de segmento, la política refuerza comportamientos que alcanzan hitos intermedios mientras se alejan del objetivo real: cada subtarea ejecutada de maravilla, pero el entregable equivocado. La aceptación de las subtareas y la aceptación del entregable final no se sustituyen entre sí. Cabe destacar que el peso necesario varía según la tarea: WebShop todavía logra un 67.9% sin el nivel de trayectoria porque sus hitos están estrechamente alineados con el éxito final; ALFWorld se desploma.
Limitaciones, expuestas con honestidad
La mayor restricción es si se puede obtener Φ en primer lugar. Las tres pruebas de referencia derivan los hitos de reglas: coincidencia de patrones en las respuestas del entorno, transiciones de página y señales explícitas de subobjetivos. Los entornos abiertos, como la automatización del navegador, la refactorización de bases de código y la investigación en profundidad, no disponen de transiciones verificables de ese tipo ya definidas, y los autores señalan el descubrimiento automatizado de hitos como un problema abierto. Esto debe entenderse como un paradigma validado en entornos estructurados, no como una receta de ingeniería que pueda adoptarse tal cual.
La granularidad de los hitos también es un factor sensible: si son demasiado escasos, el método degenera hacia GRPO; si son demasiado densos, las ventajas de los segmentos se vuelven ruidosas. La propiedad de Markov es solo aproximada, y el aislamiento de la varianza se apoya en ella. Los experimentos llegan hasta 7B con espacios de acciones de texto discretas; no se han probado el control continuo ni los entornos multiagente.
Aun así, nos resulta difícil cuestionar la afirmación central: las tareas largas tienen una estructura compositiva aprovechable, y tratar esa estructura como un objeto de primer nivel es mejor que esperar que un modelo la siga dentro del contexto. Estamos aplicando esa idea al soporte de tareas de horizonte largo en Orkas, y compartiremos más detalles del diseño a medida que lo incorporemos.