
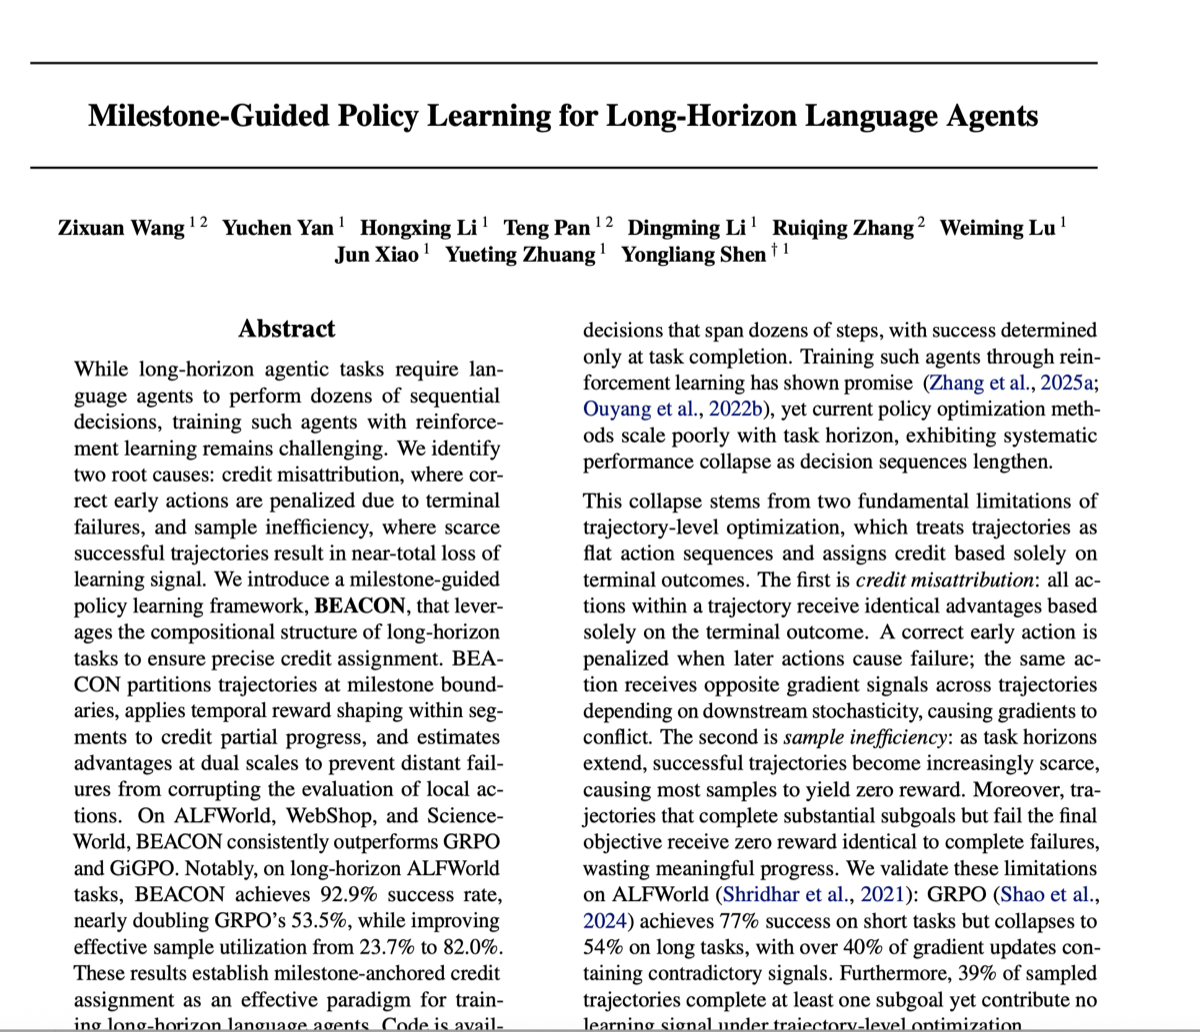
Agen cakrawala panjang - yang berjalan untuk puluhan langkah sebelum apa pun dapat diverifikasi selesai - gagal dengan cara yang tidak dilakukan oleh agen cakrawala pendek. Kinerja tidak menurun secara perlahan seiring dengan semakin lamanya tugas. Itu jatuh dari tebing.
Sebuah makalah terbaru dari laboratorium ZJU-REAL Universitas Zhejiang, Pembelajaran Kebijakan yang Dipandu Milestone untuk Agen Bahasa Horizon Panjang, mendiagnosis tebing itu cukup tepat untuk berguna bahkan jika Anda tidak pernah melatih kebijakan sendiri. Metodenya disebut BEACON; kodenya adalah Sumber terbuka.
Kami membacanya dengan seksama karena masalah yang dijelaskannya adalah masalah yang sama yang terus kami hadapi di sisi produk. Berikut ini adalah argumen makalah, satu tempat di mana kami harus mengerjakan matematika untuk merekonsiliasi hasil, dan apa yang kami pikirkan ditransfer ke arsitektur agen.
Dua mode kegagalan, keduanya dapat diukur
Yang paling kami hargai adalah kertasnya tidak dibuka dengan metode. Ini dibuka dengan otopsi: Qwen2.5-1.5B dilatih dengan GRPO di ALFWorld, dengan keruntuhan yang dipecah menjadi dua Diukur Penyebab.
Kesalahan atribusi kredit
RL tingkat lintasan memperlakukan lari sebagai urutan aksi datar. Setiap tindakan berbagi satu skor terminal. Jadi tindakan yang benar yang sama menghasilkan gradien positif dalam lari yang berhasil dan yang negatif dalam lari yang gagal — apakah itu "benar" tergantung pada apa yang terjadi Sesudah itu.
Para penulis mengukur ini sebagai Rasio Tindakan Yang Kontradiktif: fraksi tindakan yang menerima keuntungan tanda berlawanan di lintasan meskipun dieksekusi pada keadaan yang identik. Itu memuncak Di atas 40%. Setelah gradien itu dibatalkan, sinyal pembelajaran yang efektif turun Di bawah 20%.
Contoh ketidakefisienan
Bucket lintasan tiga cara — sukses penuh, sukses sebagian (setidaknya satu subtujuan selesai, tugas masih gagal), dan kegagalan total:
- Keberhasilan parsial tetap stabil di 39–47% Sampel selama pelatihan.
- Sukses penuh tetap Di bawah 27%.
Di bawah GRPO, keberhasilan parsial dan kegagalan total keduanya mendapat skor nol. Lebih dari 73% sampel tidak menghasilkan sinyal pembelajaran sama sekali.
Kedua masalah tersebut bertambah seiring dengan pertumbuhan cakrawala: tugas yang lebih lama lebih jarang berhasil (lebih banyak keberhasilan parsial) dan memberikan keacakan hilir lebih banyak peluang untuk merusak kredit. Secara konkret, di ALFWorld: 76,7% pada tugas pendek, 53,5% pada tugas panjang.
Wawasannya: tugas yang panjang sudah memiliki struktur
Tugas-tugas cakrawala panjang terurai menjadi fase-fase yang dibatasi oleh Tonggak sejarah — transisi keadaan yang dapat diverifikasi yang menandai penyelesaian subtujuan. Optimalisasi datar hanya membuang struktur itu.
Para penulis meresmikannya sebagai Properti Markov Milestone: setelah Anda mencapai keadaan tonggak sejarah, distribusi di atas lintasan lainnya sebagian besar bergantung pada subtujuan mana yang tetap ada, bukan pada riwayat lengkap bagaimana Anda sampai di sana.
Setelah Anda memiliki kuncinya, apa yang terjadi selanjutnya tergantung pada apa yang Anda lakukan dengannya — bukan bagaimana Anda menemukannya.
Properti Markov perkiraan itulah yang membuat kredit dapat dipisahkan di seluruh segmen.
Metodenya, dalam tiga langkah
1. Partisi pada tonggak sejarah
Sebuah detektor Φ Menandai langkah waktu tonggak sejarah dan memotong lintasan menjadi segmen. Keputusan desain yang kami pikir diremehkan: Φ Tidak membutuhkan model yang dipelajari dan tidak ada anotasi manusia. Ini membaca perubahan status yang dapat diamati langsung dari umpan balik lingkungan — transisi status objek di ALFWorld, transisi halaman di WebShop, sinyal subgoal eksplisit di ScienceWorld.
Tidak ada model tambahan, tidak ada peluncuran tambahan. Itu adalah keseluruhan keuntungan biaya atas model hadiah proses dan estimasi nilai Monte Carlo.
2. Pembentukan hadiah temporal di dalam setiap segmen
r_t = R_ms * γ^(t_k − t)   if segment k ends in a completed milestone
    = 0                    otherwise
Hanya segmen yang Mengakhiri Dalam tonggak mendapatkan hadiah, dan dalam segmen tindakan seperti itu lebih dekat ke tonggak mendapatkan lebih banyak. Setiap tindakan di segmen yang telah selesai sekarang membawa sinyal, sehingga keberhasilan parsial berhenti dibuang.
3. Keuntungan skala ganda
Tingkat lintasan adalah normalisasi GRPO standar atas hadiah terminal. Tingkat segmen adalah tempat ide hidup — dalam bagaimana kelompok perbandingan didefinisikan:
G_k = { i : K_i ≥ k }          # only trajectories that ALSO reached milestone k

A_seg(i,t) = r_t − (1/|G_k|) · Σ_{j∈G_k}  R_k(j) / |Seg_k(j)|
                               └── group-average PER-STEP return ──┘
Tindakan dalam segmen k Dibandingkan Hanya melawan lintasan yang juga mencapai tonggak sejarah k. Dari ini penulis memperoleh properti isolasi varians: apakah segmen selanjutnya berhasil atau gagal tidak dapat secara matematis mencemari kredit untuk yang sekarang.
Keuntungan terakhir adalah A_traj + λ · A_seg, dioptimalkan dengan pengganti terpotong PPO standar. Hiperparameter γ=0.95, λ=1.0 Ditetapkan di setiap tolok ukur — tidak ada penyetelan per-tugas.
Hasil
ALFWorld, Qwen2.5-1.5B:
| Metode | Pendek | Sedang | Panjang | Rata-rata |
|---|---|---|---|---|
| GRPO | 76.7 | 73.9 | 53.5 | 72.8 |
| GiGPO | 90.7 | 84.3 | 79.5 | 86.1 |
| SUAR | 96.8 | 87.0 | 92.9 | 91.4 |
Tingkat keberhasilan pada dua lingkungan lainnya:
| Metode | Dunia Sains | Toko Web |
|---|---|---|
| GRPO | 21.1 | 56.8 |
| GiGPO | 25.8 | 65.0 |
| SUAR | 45.3 | 75.6 |
Model 1.5B mengungguli GPT-4o di ALFWorld (91.4 vs 48.0) dan WebShop (75.6 vs 23.7), dan mengikatnya di ScienceWorld (45.3 vs 45.4). Peringatan yang adil: model tertutup diminta dengan ReAct, tidak dilatih. Pemanfaatan sampel meningkat dari 23,7% menjadi 82,0%, dan konvergensi lebih cepat — 60% keberhasilan dengan iterasi 50, di mana GRPO membutuhkan iterasi 120.
Hasil yang paling meyakinkan adalah bahwa skala keuntungan dengan cakrawala. Pada 7B, peningkatan relatif atas GRPO berubah dari +13% pada tugas-tugas singkat menjadi +39% Pada yang panjang; GiGPO hanya berubah dari +11% menjadi +22%. Alasannya penting: GiGPO membangun kelompok perbandingan tingkat langkah dari Keadaan berulang, dan ketika kebijakan membaik dan lintasannya terdiversifikasi, kekambuhan negara menjadi lebih jarang - sumber sinyalnya sendiri terkikis. Jangkar tonggak tidak membusuk saat kebijakan semakin kuat.
Metode yang manfaatnya tumbuh seiring dengan semakin sulitnya adalah klaim yang jauh lebih kuat daripada skor rata-rata yang lebih tinggi.
Metrik yang terlihat seperti kontradiksi
Makalah ini mendefinisikan sebuah Rasio Konsentrasi Kredit — keuntungan rata-rata Besarnya Untuk tindakan tonggak dibagi dengan itu untuk tindakan non-tonggak. Di atas 1 berarti kredit berkonsentrasi pada tonggak sejarah.
| Metode | CCR |
|---|---|
| GiGPO | 2.36 |
| GRPO | 1.37 |
| SUAR | 0.84 |
Jadi metode berkinerja terbaik adalah metode yang memusatkan kredit pada langkah-langkah kunci Paling sedikit — yang dibaca sebagai kontradiksi langsung dari "tindakan yang lebih dekat dengan tonggak sejarah mendapatkan lebih banyak hadiah." Itu tidak. Dua pernyataan tersebut mengukur kuantitas yang berbeda, dengan dua transformasi di antaranya.
Transformasi 1 — hadiah berbentuk. Dalam sebuah segmen, hadiah memang meningkat secara monoton menuju tonggak sejarah. Dengan γ=0.95 Dan segmen panjang 5, lima tindakan mendapatkan 0.8145, 0.857, 0.9025, 0.95, 1.0. Tapi ini adalah hadiah, bukan kredit yang mencapai gradien.
Transformasi 2 — kurangi garis dasar kelompok. Garis dasar adalah rata-rata kelompok Per-langkah Kembali (kembali segmen ÷ panjang segmen). Untuk segmen panjang L, pengembalian per langkah adalah (1−γ^L) / (L(1−γ)):
| Panjang segmen | 3 | 5 | 8 | 10 |
|---|---|---|---|---|
| Pengembalian per langkah | 0.951 | 0.905 | 0.842 | 0.803 |
Jika segmen Anda mengambil 8 langkah sementara kelompok rata-rata 5 langkah, pengembalian per langkah Anda berada di bawah garis dasar dan Seluruh Keuntungan segmen miring negatif. Perhatikan apa artinya ini: hukuman untuk mengembara tidak berasal dari peluruhan itu sendiri - itu berasal dari peluruhan yang bertindak melalui garis dasar per langkah. Pembusukan saja hanya memerintahkan tindakan Di dalam Sebuah segmen. Pada titik ini CCR di dalam segmen yang sudah selesai masih lebih besar dari 1.
Transformasi 3 — tambahkan istilah tingkat lintasan. Di sinilah CCR turun di bawah 1, melalui dua efek asimetris. Pertama, segmen ekor dari lintasan yang gagal tidak memasuki kelompok perbandingan sama sekali: sejak G_k = {i : K_i ≥ k} Dan ekor yang tidak lengkap memiliki indeks K_i + 1 > K_i, lintasan itu dikecualikan. Ekor tidak menerima keuntungan tingkat segmen, hanya istilah tingkat lintasan pada besarnya penuh - dan masing-masing adalah tindakan non-tonggak sejarah, menggembungkan penyebut. Kedua, dalam lintasan yang gagal, istilah tingkat lintasan negatif membatalkan kredit tingkat segmen positif pada tindakan tonggak sejarah, menekan besarnya ke nol.
Gambar 8 dari kertas itu sendiri mengonfirmasinya. Pada lintasan yang gagal yang menyelesaikan tonggak S3 dan S4:
| Pergi ke toilet | Letakkan sabun batangan (S3✓) | Pergi ke konter (S4✓) | Pergi ke konter | Pergi ke pemegang | |
|---|---|---|---|---|---|
| GRPO | −2.50 | −2.50 | −2.50 | −2.50 | −2.50 |
| SUAR | −0.92 | +0.51 | +0.32 | −2.20 | −2.20 |
Dua nilai terakhir adalah Identik — sidik jari dari "segmen ekor hanya mendapatkan istilah tingkat lintasan," yang memungkinkan Anda membaca A_traj ≈ −2.20. Dua tindakan tonggak itu positif tetapi hanya sebesar ~0,5, karena istilah lintasan negatif memakan sebagian besar kredit tingkat segmen. CCR untuk lintasan ini adalah 0,23; untuk lintasan yang berhasil adalah 2,95. Global 0,84 adalah campuran.
Jadi ukuran CCR Konsentrasi besarnya gradien, bukan siapa yang mendapat hadiah. CCR rendah bukanlah tujuan desain - ini adalah produk sampingan dari alokasi dalam segmen yang padat ditambah penumpukan skala ganda. Kesimpulan penulis masih berlaku, dan itu bagus: jangan membuang semua energi gradien Anda pada langkah-langkah kunci. GiGPO 2,36 berarti tindakan persiapan di antaranya hampir tidak mendapatkan sinyal, dan itulah yang membuat pencapaian menjadi mungkin.
Sesuatu yang tidak dijabarkan oleh kertas
Ada sel aneh di meja ablasi. Pengaturan γ=1 — kredit seragam di dalam setiap segmen — skor 71.8, lebih buruk daripada tidak membentuk sama sekali (γ=0, 81.2) dan bahkan di bawah GRPO 72.8. Makalah tersebut mengaitkan ini dengan "gradien yang menyesatkan."
Kerjakan matematika dan jawabannya akan lebih tajam. Dengan γ=1 Setiap tindakan dalam segmen yang sudah selesai mendapatkan hadiah yang sama, jadi setiap segmen yang sudah selesai — terlepas dari panjangnya — memiliki pengembalian per langkah yang tepat R_ms. Garis dasar sama dengan itu, dan:
A_seg(i,t) ≡ R_ms − R_ms = 0 for every actionSaluran tingkat segmen tidak menyesatkan. Itu Menghilang secara identik, dan metodenya mengurangi tepat ke GRPO. Periksa dengan tabel: 71,8 versus 72,8 GRPO — satu poin terpisah, yang merupakan kebisingan run-to-run.
Yang membingkai ulang untuk apa pembusukan itu. Ini bukan hanya tentang membedakan tindakan dalam sebuah segmen; ini adalah sebuah Kondisi yang diperlukan agar sinyal tingkat segmen ada sama sekali. Tanpa itu, garis dasar per langkah membatalkan sinyal di tempat.
Tiga percobaan yang menutup keberatan yang jelas
Kredit yang jatuh tempo — penulis mendahului tiga pertanyaan yang ditanyakan oleh pembaca yang skeptis:
- Apakah ini hanya kloning perilaku? SFT pada lintasan oracle mencapai 43%; BEACON mencapai 91,4%. Kebijakan ini menemukan strategi eksekusi yang lebih baik daripada oracle, jadi itu tidak meniru.
- Apakah keuntungannya hanya berasal dari chunking? Skor partisi acak 74,2%, hanya 1,4 poin di atas GRPO. Tonggak sejarah nyata mencetak 91,4% — selisih 17,2 poin. Manfaatnya berasal dari struktur intrinsik tugas.
- Bagaimana jika detektornya tidak dapat diandalkan? Menjatuhkan 50% tonggak secara acak masih menghasilkan 82,8%, sepuluh poin di atas GRPO. Degradasi itu anggun.
Transfer apa ke desain agen
BEACON adalah metode pelatihan, dan sebagian besar produk — termasuk milik kami — mengatur model daripada melatihnya. Formulanya tidak ditransfer. Diagnosisnya benar, dan secara mengejutkan memetakan arsitektur secara langsung.
Kemajuan parsial harus menjadi kelas satu, keadaan yang bertahan. Angka paling tajam dari makalah tersebut adalah bahwa 39-47% dari menjalankan menyelesaikan subtujuan nyata dan kemudian dinilai identik dengan menjalankan yang tidak melakukan apa-apa. Sesi agen yang berjalan lama yang menyelesaikan tiga subtujuan dan kemudian kios memiliki masalah yang sama: jika sistem mencatat hanya "berjalan" dan "selesai," kemajuan itu dibuang dan percobaan ulang dimulai dari nol. Milestones memberi Anda kosakata untuk merekamnya.
Tonggak sejarah harus berasal dari efek samping yang dapat diamati, bukan laporan diri. Alasannya Φ Murah adalah bahwa itu membaca transisi negara yang dapat diverifikasi daripada menanyakan kebijakan apakah itu membuat kemajuan. Runtime agen memiliki aset yang sama yang tersedia dan sering mengabaikannya: file yang ditulis, tes yang keluar dari nol, panggilan konektor yang mengembalikan kesuksesan, dokumen yang berkomitmen ke basis pengetahuan. Itu adalah kebenaran dasar. Model yang menegaskan "langkah satu selesai" tidak.
Batas tonggak adalah pemadatan berprinsip dan titik lanjut. Properti Milestone Markov mengatakan bahwa begitu tonggak tercapai, apa yang terjadi sebelumnya jauh lebih tidak penting. Itu adalah pembenaran yang jauh lebih baik untuk memadatkan konteks daripada "kita mencapai ambang batas token," dan batas yang sama adalah pos pemeriksaan alami untuk dilanjutkan setelah kegagalan.
Verifikasi pada dua skala, bukan satu. Ini adalah ablasi yang akan kami garis bawahi untuk siapa pun yang membangun alur kerja agen: menghapus sinyal tingkat lintasan menurunkan ALFWorld dari 91,4% menjadi 23.4%. Hanya dengan umpan balik tingkat segmen, kebijakan tersebut memperkuat perilaku yang mencapai tonggak antara sambil menyimpang dari tujuan yang sebenarnya — setiap subtugas dieksekusi dengan indah, yang dapat dikirimkan salah. Penerimaan sub-tugas dan penerimaan yang dapat dikirimkan akhir bukanlah pengganti. Khususnya, bobot yang diperlukan berbeda menurut tugas: WebShop masih mengelola 67,9% tanpa tingkat lintasan karena tonggak sejarahnya selaras dengan kesuksesan akhir; ALFWorld runtuh.
Keterbatasan, dinyatakan dengan jujur
Kendala terbesar adalah apakah Φ Dapat diperoleh sama sekali. Ketiga tolok ukur memperoleh tonggak sejarah dari aturan - pencocokan pola pada respons lingkungan, transisi halaman, sinyal subtujuan eksplisit. Pengaturan terbuka seperti otomatisasi peramban, refaktorisasi basis kode, dan penelitian mendalam tidak memiliki transisi yang dapat diverifikasi yang sudah jadi, dan penulis mencantumkan penemuan tonggak otomatis sebagai masalah terbuka. Ini dibaca sebagai paradigma yang divalidasi dalam lingkungan terstruktur, bukan resep teknik untuk mengangkat apa adanya.
Granularitas tonggak juga sensitif: terlalu jarang dan metodenya merosot ke arah GRPO, terlalu padat dan keunggulan segmen menjadi berisik. Properti Markov hanya perkiraan, dan isolasi varians bergantung padanya. Eksperimen berhenti di 7B dengan ruang aksi teks diskrit — kontrol terus menerus dan pengaturan multi-agen tidak teruji.
Namun, klaim intinya adalah salah satu yang menurut kami sulit untuk diperdebatkan: Tugas panjang memiliki struktur komposisi yang dapat dieksploitasi, dan memperlakukan struktur itu sebagai objek kelas satu mengalahkan berharap model melacaknya dalam konteks. Kami menerapkan pemikiran itu pada dukungan tugas cakrawala panjang di Orkas, dan kami akan membagikan lebih banyak desain saat mendarat.