
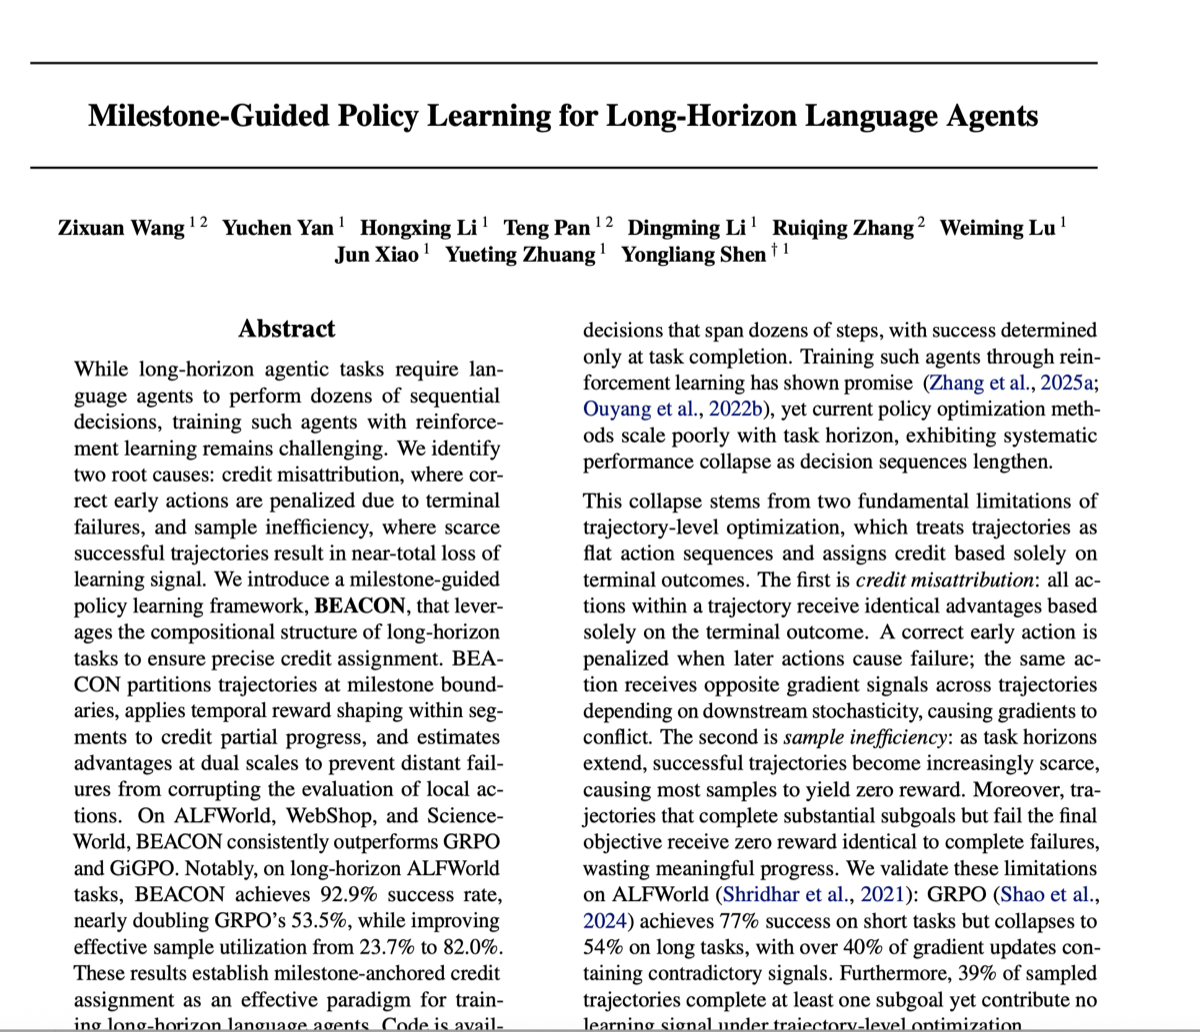
Tác nhân thực hiện tác vụ dài — những tác nhân chạy hàng chục bước trước khi có bất kỳ việc gì được xác minh là hoàn thành — thất bại theo cách tác nhân thực hiện tác vụ ngắn không gặp. Hiệu suất không giảm từ từ khi tác vụ dài hơn. Nó lao dốc.
Một bài báo gần đây từ phòng thí nghiệm ZJU-REAL của Đại học Chiết Giang, Học chính sách theo hướng dẫn của cột mốc cho tác nhân ngôn ngữ thực hiện tác vụ dài, chẩn đoán cú lao dốc đó đủ chính xác để hữu ích ngay cả khi bạn không bao giờ tự huấn luyện chính sách. Phương pháp có tên BEACON; mã nguồn được công khai theo dạng mã nguồn mở.
Chúng tôi đọc kỹ vì vấn đề được mô tả cũng là điều chúng tôi liên tục gặp ở phía sản phẩm. Sau đây là lập luận của bài báo, một chỗ chúng tôi phải lần theo phép toán để lý giải kết quả, và những điều chúng tôi nghĩ có thể áp dụng vào kiến trúc tác nhân.
Hai kiểu thất bại, cả hai đều đo được
Điều chúng tôi đánh giá cao nhất là bài báo không mở đầu bằng phương pháp. Nó mở đầu bằng phân tích nguyên nhân: Qwen2.5-1.5B được huấn luyện bằng GRPO trên ALFWorld, với sự suy sụp được chia thành hai nguyên nhân đã được định lượng .
Quy công sai
RL ở cấp quỹ đạo coi một lượt chạy là chuỗi hành động phẳng. Mọi hành động cùng nhận một điểm cuối. Vì vậy, cùng một hành động đúng nhận gradient dương trong lượt chạy thành công và gradient âm trong lượt chạy thất bại — nó có “đúng” hay không phụ thuộc vào những gì xảy ra sau đó.
Các tác giả định lượng điều này bằng Tỷ lệ hành động mâu thuẫn: tỷ lệ hành động nhận lợi thế trái dấu giữa các quỹ đạo dù được thực hiện ở trạng thái giống hệt nhau. Chỉ số này đạt đỉnh trên 40%. Sau khi các gradient đó triệt tiêu nhau, tín hiệu học hiệu dụng giảm xuống dưới 20%.
Hiệu quả sử dụng mẫu thấp
Chia quỹ đạo thành ba nhóm — thành công hoàn toàn, thành công một phần (hoàn thành ít nhất một mục tiêu phụ nhưng tác vụ vẫn thất bại) và thất bại hoàn toàn:
- Thành công một phần duy trì ổn định ở mức 39–47% số mẫu trong suốt quá trình huấn luyện.
- Thành công hoàn toàn luôn ở mức dưới 27%.
Với GRPO, thành công một phần và thất bại hoàn toàn đều được chấm không điểm. Hơn 73% số mẫu không tạo ra bất kỳ tín hiệu học nào.
Cả hai vấn đề cùng trầm trọng hơn khi tác vụ dài hơn: tác vụ dài ít thành công hơn (nhiều thành công một phần hơn) và tạo thêm cơ hội cho tính ngẫu nhiên ở các bước sau làm sai lệch việc quy công. Cụ thể trên ALFWorld: 76.7% ở tác vụ ngắn, 53.5% ở tác vụ dài.
Nhận ra cốt lõi: tác vụ dài vốn đã có cấu trúc
Tác vụ dài có thể phân rã thành các giai đoạn được phân định bởi cột mốc — những chuyển đổi trạng thái có thể xác minh, đánh dấu việc hoàn thành mục tiêu phụ. Tối ưu hóa phẳng đơn giản là bỏ qua cấu trúc đó.
Các tác giả hình thức hóa điều này thành Tính chất Markov của cột mốc: khi đã đạt trạng thái cột mốc, phân phối của phần quỹ đạo còn lại phụ thuộc chủ yếu vào những mục tiêu phụ còn lại, chứ không phải toàn bộ lịch sử dẫn bạn đến đó.
Khi đã có chìa khóa, điều xảy ra tiếp theo phụ thuộc vào cách bạn dùng nó — không phải cách bạn tìm thấy nó.
Tính chất Markov xấp xỉ đó cho phép tách việc quy công giữa các đoạn.
Phương pháp, qua ba bước
1. Phân đoạn tại các cột mốc
Một bộ phát hiện Φ đánh dấu các bước thời gian có cột mốc và cắt quỹ đạo thành các đoạn. Quyết định thiết kế mà chúng tôi cho là chưa được đánh giá đúng mức: Φ không cần mô hình đã học hay chú giải của con người. Nó đọc trực tiếp những thay đổi trạng thái quan sát được từ phản hồi môi trường — chuyển đổi trạng thái đối tượng trong ALFWorld, chuyển trang trong WebShop, tín hiệu mục tiêu phụ rõ ràng trong ScienceWorld.
Không thêm mô hình, không thêm lượt chạy thử. Đó là toàn bộ lợi thế chi phí so với mô hình phần thưởng quá trình và ước lượng giá trị Monte Carlo.
2. Định hình phần thưởng theo thời gian trong từng đoạn
r_t = R_ms * γ^(t_k − t)   if segment k ends in a completed milestone
    = 0                    otherwise
Chỉ những đoạn kết thúc ở một cột mốc mới nhận phần thưởng, và trong đoạn đó, hành động càng gần cột mốc càng nhận nhiều hơn. Mọi hành động trong một đoạn hoàn thành giờ đều mang tín hiệu, nên thành công một phần không còn bị bỏ đi.
3. Lợi thế ở hai cấp độ
Cấp quỹ đạo dùng phép chuẩn hóa GRPO tiêu chuẩn trên phần thưởng cuối. Cấp đoạn là nơi ý tưởng cốt lõi nằm ở đó — trong cách xác định nhóm so sánh:
G_k = { i : K_i ≥ k }          # only trajectories that ALSO reached milestone k

A_seg(i,t) = r_t − (1/|G_k|) · Σ_{j∈G_k}  R_k(j) / |Seg_k(j)|
                               └── group-average PER-STEP return ──┘
Các hành động trong đoạn k được so sánh chỉ với các quỹ đạo cũng đã đạt cột mốc k. Từ đó, các tác giả suy ra tính chất cô lập phương sai: về mặt toán học, việc các đoạn sau thành công hay thất bại không thể làm sai lệch việc quy công cho đoạn hiện tại.
Lợi thế cuối cùng là A_traj + λ · A_seg, được tối ưu bằng hàm mục tiêu thay thế có cắt ngưỡng PPO tiêu chuẩn. Các siêu tham số γ=0.95, λ=1.0 được giữ cố định trên mọi bộ chuẩn đánh giá — không tinh chỉnh riêng theo tác vụ.
Kết quả
ALFWorld, Qwen2.5-1.5B:
| Phương pháp | Ngắn | Trung bình | Dài | Trung bình |
|---|---|---|---|---|
| GRPO | 76.7 | 73.9 | 53.5 | 72.8 |
| GiGPO | 90.7 | 84.3 | 79.5 | 86.1 |
| BEACON | 96.8 | 87.0 | 92.9 | 91.4 |
Tỷ lệ thành công trên hai môi trường còn lại:
| Phương pháp | ScienceWorld | WebShop |
|---|---|---|
| GRPO | 21.1 | 56.8 |
| GiGPO | 25.8 | 65.0 |
| BEACON | 45.3 | 75.6 |
Mô hình 1.5B vượt GPT-4o trên ALFWorld (91.4 so với 48.0) và WebShop (75.6 so với 23.7), đồng thời ngang bằng trên ScienceWorld (45.3 so với 45.4). Lưu ý để so sánh công bằng: các mô hình đóng được đặt câu lệnh bằng ReAct, không được huấn luyện. Tỷ lệ tận dụng mẫu tăng từ 23.7% lên 82.0%, và hội tụ nhanh hơn — đạt 60% thành công ở vòng lặp 50, trong khi GRPO cần đến vòng lặp 120.
Kết quả thuyết phục nhất là mức cải thiện tăng theo độ dài tác vụ. Trên 7B, mức cải thiện tương đối so với GRPO tăng từ +13% ở tác vụ ngắn lên +39% ở tác vụ dài; GiGPO chỉ tăng từ +11% lên +22%. Lý do rất quan trọng: GiGPO xây dựng các nhóm so sánh cấp bước từ những trạng thái lặp lại, và khi chính sách cải thiện, quỹ đạo đa dạng hơn, sự tái xuất hiện của trạng thái thưa dần — nguồn tín hiệu của chính nó bị bào mòn. Các điểm neo cột mốc không suy giảm khi chính sách mạnh lên.
Một phương pháp mang lại lợi ích càng lớn khi bài toán càng khó là khẳng định mạnh hơn nhiều so với điểm trung bình cao hơn.
Chỉ số trông như một mâu thuẫn
Bài báo định nghĩa Tỷ lệ tập trung quy công — độ lớn lợi thế trung bình của hành động tại cột mốc chia cho của hành động ngoài cột mốc. Trên 1 nghĩa là việc quy công tập trung vào cột mốc.
| Phương pháp | CCR |
|---|---|
| GiGPO | 2.36 |
| GRPO | 1.37 |
| BEACON | 0.84 |
Vậy phương pháp đạt kết quả tốt nhất lại là phương pháp tập trung quy công vào các bước then chốt ít nhất — nghe như mâu thuẫn trực tiếp với “hành động càng gần cột mốc càng nhận nhiều phần thưởng”. Thực ra không phải. Hai phát biểu đo các đại lượng khác nhau, với hai phép biến đổi ở giữa.
Phép biến đổi 1 — phần thưởng đã định hình. Trong một đoạn, phần thưởng thực sự tăng đơn điệu khi tiến về cột mốc. Với γ=0.95 và một đoạn dài 5, năm hành động nhận được 0.8145, 0.857, 0.9025, 0.95, 1.0. Nhưng đây là phần thưởng, không phải mức quy công đi vào gradient.
Phép biến đổi 2 — trừ đường cơ sở của nhóm. Đường cơ sở là giá trị thu về trung bình của nhóm trên mỗi bước (giá trị thu về của đoạn ÷ độ dài đoạn). Với đoạn có độ dài L, giá trị thu về trên mỗi bước là (1−γ^L) / (L(1−γ)):
| Độ dài đoạn | 3 | 5 | 8 | 10 |
|---|---|---|---|---|
| Giá trị thu về trên mỗi bước | 0.951 | 0.905 | 0.842 | 0.803 |
Nếu đoạn của bạn mất 8 bước trong khi nhóm trung bình mất 5, giá trị thu về trên mỗi bước của bạn nằm dưới đường cơ sở và lợi thế của toàn bộ đoạn nghiêng về âm. Hãy chú ý ý nghĩa của điều này: hình phạt cho việc đi lòng vòng không đến từ bản thân hệ số suy giảm — nó đến từ tác động của suy giảm thông qua đường cơ sở trên mỗi bước. Chỉ riêng suy giảm chỉ sắp thứ tự các hành động bên trong một đoạn. Tại thời điểm này, CCR trong một đoạn đã hoàn thành vẫn lớn hơn 1.
Phép biến đổi 3 — cộng số hạng cấp quỹ đạo. Đây là lúc CCR giảm xuống dưới 1, qua hai tác động bất đối xứng. Thứ nhất, đoạn đuôi của quỹ đạo thất bại không tham gia bất kỳ nhóm so sánh nào: vì G_k = {i : K_i ≥ k} và đoạn đuôi chưa hoàn thành có chỉ số K_i + 1 > K_i, quỹ đạo đó bị loại. Đoạn đuôi không nhận lợi thế cấp đoạn, chỉ nhận số hạng cấp quỹ đạo với đầy đủ độ lớn — và mọi hành động trong đó đều là hành động ngoài cột mốc, làm mẫu số tăng lên. Thứ hai, trong quỹ đạo thất bại, số hạng cấp quỹ đạo âm triệt tiêu phần quy công cấp đoạn dương của hành động tại cột mốc, ép độ lớn của chúng về gần không.
Chính Hình 8 của bài báo xác nhận điều đó. Trên một quỹ đạo thất bại đã hoàn thành cột mốc S3 và S4:
| đi đến bồn cầu | đặt bánh xà phòng (S3✓) | đi đến mặt bàn (S4✓) | đi đến mặt bàn | đi đến giá đỡ | |
|---|---|---|---|---|---|
| GRPO | −2.50 | −2.50 | −2.50 | −2.50 | −2.50 |
| BEACON | −0.92 | +0.51 | +0.32 | −2.20 | −2.20 |
Hai giá trị cuối giống hệt nhau — dấu hiệu đặc trưng của “đoạn đuôi chỉ nhận số hạng cấp quỹ đạo”, cho phép đọc ra A_traj ≈ −2.20. Hai hành động tại cột mốc có giá trị dương nhưng độ lớn chỉ ~0.5, vì số hạng quỹ đạo âm đã triệt tiêu phần lớn mức quy công cấp đoạn. CCR của quỹ đạo này là 0.23; với quỹ đạo thành công là 2.95. Giá trị tổng thể 0.84 là kết quả pha trộn.
Vì vậy, CCR đo mức tập trung của độ lớn gradient, chứ không đo ai nhận phần thưởng. CCR thấp không phải mục tiêu thiết kế — đó là hệ quả của việc phân bổ dày đặc trong đoạn cộng với chồng hai cấp độ. Kết luận của các tác giả vẫn đúng và rất đáng giá: đừng dồn toàn bộ năng lượng gradient vào các bước then chốt. Mức 2.36 của GiGPO nghĩa là các hành động chuẩn bị ở giữa gần như không nhận tín hiệu, trong khi chính chúng giúp đạt được cột mốc.
Một điều bài báo không nói rõ
Có một ô lạ trong bảng thí nghiệm loại bỏ thành phần. Đặt γ=1 — quy công đồng đều trong từng đoạn — đạt điểm 71.8, kém hơn cả không định hình phần thưởng (γ=0, 81.2) và thậm chí thấp hơn mức 72.8 của GRPO. Bài báo quy nguyên nhân cho “gradient gây hiểu sai”.
Lần theo phép toán sẽ có câu trả lời chính xác hơn. Với γ=1 mọi hành động trong một đoạn hoàn thành nhận cùng phần thưởng, nên mọi đoạn hoàn thành — bất kể độ dài — đều có giá trị thu về trên mỗi bước bằng đúng R_ms. Đường cơ sở bằng chính nó, và:
A_seg(i,t) ≡ R_ms − R_ms = 0 for every actionKênh cấp đoạn không gây hiểu sai. Nó triệt tiêu hoàn toàn, và phương pháp trở về đúng GRPO. Đối chiếu với bảng: 71.8 so với 72.8 của GRPO — chênh một điểm, là nhiễu giữa các lượt chạy.
Điều này định nghĩa lại vai trò của suy giảm. Nó không chỉ để phân biệt hành động trong một đoạn; nó là điều kiện cần để tín hiệu cấp đoạn tồn tại. Không có nó, đường cơ sở trên mỗi bước triệt tiêu tín hiệu ngay lập tức.
Ba thí nghiệm giải đáp các phản biện rõ ràng
Cần ghi nhận đúng công sức — các tác giả đã đón trước ba câu hỏi của người đọc hoài nghi:
- Đây có chỉ là sao chép hành vi không? SFT trên quỹ đạo chuẩn đạt 43%; BEACON đạt 91.4%. Chính sách tìm ra chiến lược thực hiện tốt hơn quỹ đạo chuẩn, nên nó không chỉ bắt chước.
- Mức cải thiện có đơn thuần đến từ chia đoạn không? Phân đoạn ngẫu nhiên đạt 74.2%, chỉ cao hơn GRPO 1.4 điểm. Cột mốc thực đạt 91.4% — chênh 17.2 điểm. Lợi ích đến từ cấu trúc nội tại của tác vụ.
- Nếu bộ phát hiện không đáng tin cậy thì sao? Bỏ ngẫu nhiên 50% cột mốc vẫn đạt 82.8%, cao hơn GRPO mười điểm. Hiệu suất suy giảm từ từ.
Điều gì có thể áp dụng vào thiết kế tác nhân
BEACON là phương pháp huấn luyện, còn phần lớn sản phẩm — gồm cả của chúng tôi — điều phối mô hình thay vì huấn luyện chúng. Không thể chuyển nguyên công thức sang. Nhưng có thể áp dụng chẩn đoán, và nó tương ứng trực tiếp với kiến trúc đến bất ngờ.
Tiến độ một phần phải là trạng thái được quản lý chính thức và lưu bền vững. Con số sắc nét nhất của bài báo là 39–47% lượt chạy hoàn thành những mục tiêu phụ thực sự nhưng rồi được chấm giống hệt các lượt chẳng làm được gì. Một phiên tác nhân chạy dài hoàn thành ba mục tiêu phụ rồi bị đình trệ cũng gặp vấn đề tương tự: nếu hệ thống chỉ ghi “đang chạy” và “xong”, tiến độ đó bị bỏ đi và lần thử lại bắt đầu từ không. Cột mốc cho bạn cách biểu đạt để ghi nhận nó.
Cột mốc nên đến từ những tác động quan sát được, không phải tự báo cáo. Lý do Φ có chi phí thấp là nó đọc các chuyển đổi trạng thái có thể xác minh thay vì hỏi chính sách có tiến triển hay không. Môi trường thực thi tác nhân cũng có tài nguyên ấy nhưng thường bỏ qua: một tệp đã được ghi, một bài kiểm thử kết thúc với mã không, một lệnh gọi trình kết nối trả về thành công, một tài liệu được lưu vào cơ sở tri thức. Đó là sự thật có thể kiểm chứng. Mô hình khẳng định “bước một hoàn thành” thì không phải.
Ranh giới cột mốc là điểm nén ngữ cảnh và tiếp tục có cơ sở. Tính chất Markov của cột mốc cho biết khi đạt một cột mốc, những gì trước đó ít quan trọng hơn nhiều. Đây là lý do vững chắc hơn hẳn để nén ngữ cảnh so với “đã chạm ngưỡng token”, và cùng ranh giới đó là điểm lưu tự nhiên để tiếp tục sau thất bại.
Xác minh ở hai cấp độ, không chỉ một. Đây là thí nghiệm loại bỏ thành phần mà chúng tôi muốn nhấn mạnh với bất kỳ ai xây dựng quy trình tác nhân: bỏ tín hiệu cấp quỹ đạo khiến ALFWorld giảm từ 91.4% xuống 23.4%. Chỉ có phản hồi cấp đoạn, chính sách củng cố hành vi đạt cột mốc trung gian nhưng lệch khỏi mục tiêu thực — mọi tác vụ phụ đều thực hiện đẹp mắt, sản phẩm bàn giao lại sai. Nghiệm thu tác vụ phụ và nghiệm thu sản phẩm cuối không thể thay thế nhau. Đáng chú ý, trọng số cần thiết khác nhau theo tác vụ: WebShop vẫn đạt 67.9% khi không có cấp quỹ đạo vì các cột mốc của nó gắn sát với thành công cuối cùng; ALFWorld thì suy sụp.
Những giới hạn được nêu thẳng thắn
Ràng buộc lớn nhất là liệu Φ có thể thu được hay không. Cả ba bộ chuẩn đều suy ra cột mốc từ quy tắc — khớp mẫu trên phản hồi môi trường, chuyển trang, tín hiệu mục tiêu phụ rõ ràng. Những bối cảnh mở như tự động hóa trình duyệt, tái cấu trúc cơ sở mã và nghiên cứu chuyên sâu không có sẵn các chuyển đổi có thể xác minh như vậy, và các tác giả liệt kê việc tự động phát hiện cột mốc là một bài toán mở. Đây nên được hiểu là một mô hình tiếp cận đã được kiểm chứng trong môi trường có cấu trúc, không phải công thức kỹ thuật để bê nguyên vào dùng.
Độ chi tiết của cột mốc cũng nhạy cảm: quá thưa thì phương pháp thoái hóa về gần GRPO, quá dày thì lợi thế cấp đoạn trở nên nhiễu. Tính chất Markov chỉ là xấp xỉ, và sự cô lập phương sai dựa vào nó. Thí nghiệm dừng ở 7B với không gian hành động văn bản rời rạc — điều khiển liên tục và bối cảnh đa tác nhân chưa được thử nghiệm.
Dù vậy, khẳng định cốt lõi là điều chúng tôi khó có thể phản bác: tác vụ dài có cấu trúc hợp thành có thể khai thác, và quản lý cấu trúc đó như một đối tượng chính thức tốt hơn việc hy vọng mô hình tự theo dõi nó trong ngữ cảnh. Chúng tôi đang áp dụng cách nghĩ đó để hỗ trợ tác vụ dài trong Orkas, và sẽ chia sẻ thêm về thiết kế khi triển khai.