
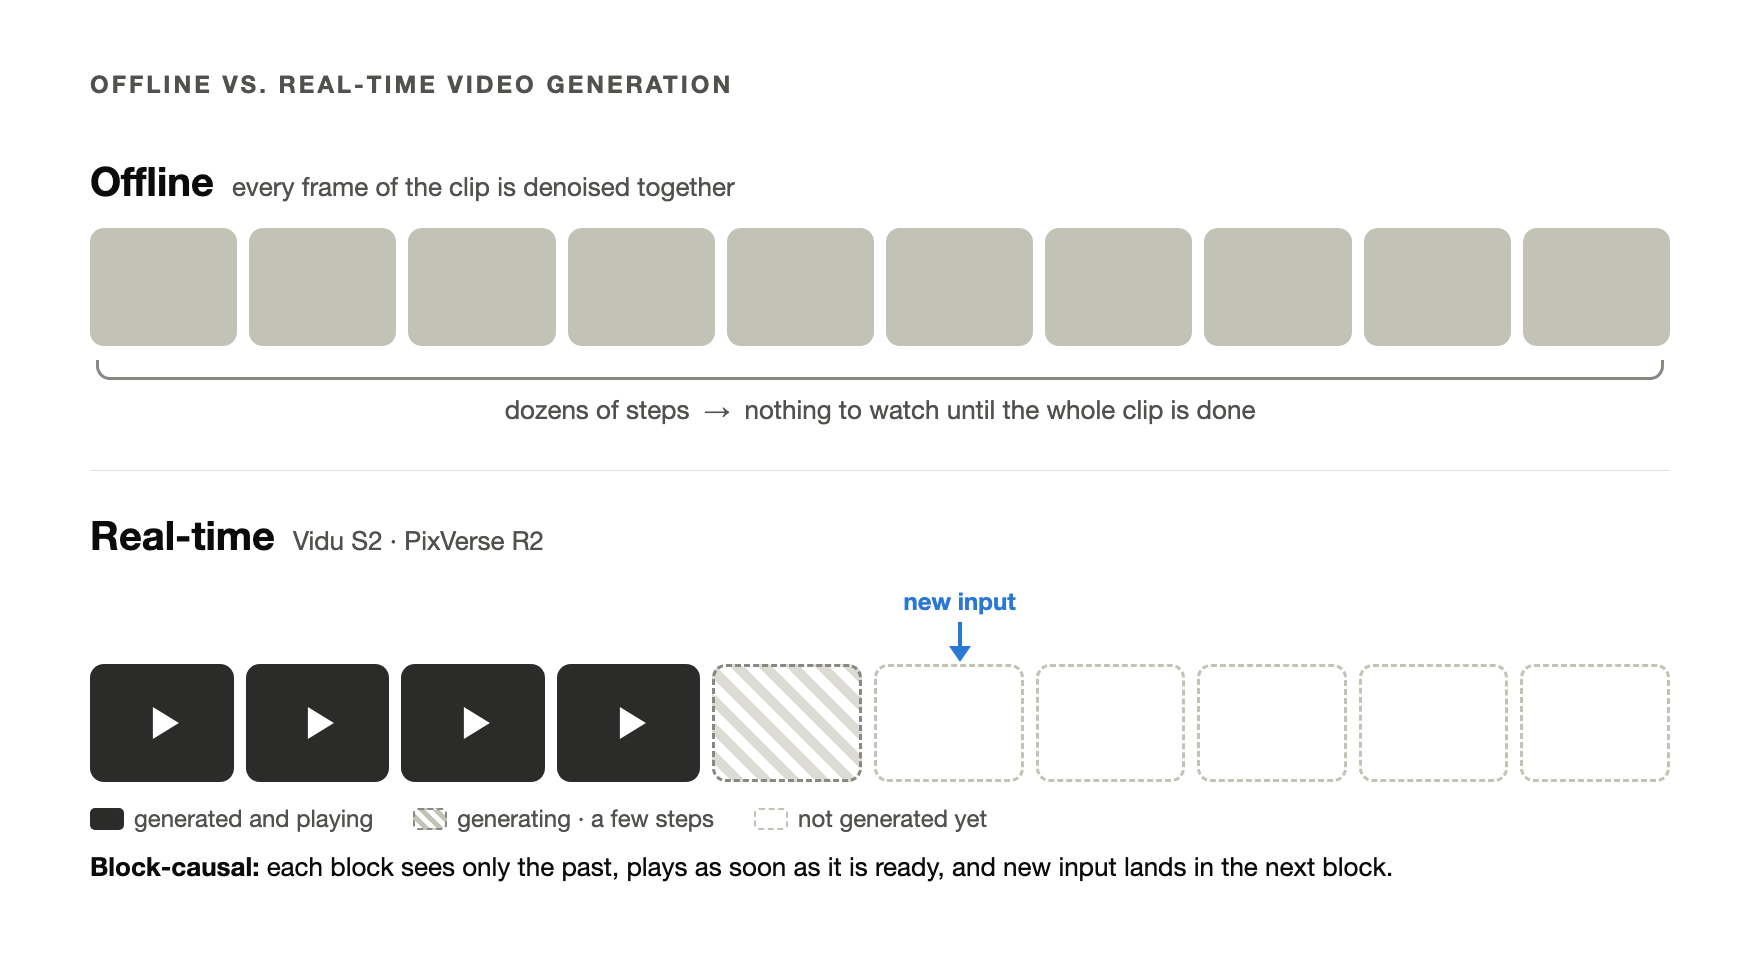
Dua model video real-time dikirimkan dengan jarak satu minggu di bulan ini. Milik ShengShu Video S2 Ditayangkan pada tanggal 15 September, dan PixVerse mengumumkan PixVerse R2 Pada tanggal 22 September. S2 dibangun di sekitar karakter digital langsung dan me-restyling streaming video saat diputar. R2 menyebut dirinya sebagai model dunia waktu nyata: sebuah adegan yang Anda lalui dengan WASD sementara petunjuk, referensi, dan audio mengubah apa yang terjadi selanjutnya.
Kedua tim menerbitkan bagaimana mereka membangunnya — S2 sebagai sebuah Kertas arXiv, R2 sebagai sebuah Laporan teknis di situs PixVerse. Kami membacanya berdampingan. Mereka menyetujui kerangka, membagi lima pilihan desain, dan mengungkapkan jumlah yang sangat berbeda. Postingan ini mencakup ketiganya dan dengan sengaja berhenti menyebutkan pemenang: keduanya tidak pernah diukur pada tes yang sama.
Apa perubahan waktu nyata
Sebagian besar model video sedang offline. Setiap bingkai klip didenoise bersama-sama selama puluhan langkah, dan tidak ada yang terlihat sampai seluruh klip selesai. Apa pun yang Anda inginkan harus ada dalam prompt sebelum generasi dimulai.
Model waktu nyata membalikkannya. Ini memotong video menjadi beberapa blok - beberapa bingkai ditambah potongan audio yang cocok - dan menghasilkannya secara berurutan. Setiap blok hanya mendapatkan beberapa langkah denoising dan bermain segera setelah siap. Sebuah blok dapat melihat apa yang terjadi sebelum itu tetapi tidak pernah melihat apa yang terjadi setelahnya; itulah yang Blok-kausal Berarti. Instruksi baru mendarat di blok berikutnya.
Bentuk itu menciptakan tiga masalah, dan hampir setiap pilihan desain di bawah ini menjawab salah satunya:
- Senyawa kesalahan. Setiap blok dikondisikan pada blok yang dihasilkan model itu sendiri, jadi kesalahan kecil diwariskan oleh segala sesuatu setelahnya.
- Sejarah harus tetap dibatasi. Aliran dapat berjalan tanpa batas waktu; menjaga setiap blok masa lalu akan membuat setiap yang baru lebih mahal.
- Anggaran waktunya brutal. Pada 25 frame per detik, setiap frame mendapatkan 40 milidetik.
S2 dan R2 mendarat pada kerangka yang sama: model difusi autoregresif blok-kausal yang menghasilkan video dan audio secara bersamaan. Perbedaannya adalah bagaimana mereka melatihnya, menjaganya tetap stabil, memberinya memori, membuatnya cepat, dan membiarkan orang mengarahkannya.
Dua sistem
Video S2 (Teknologi ShengShu dengan Universitas Tsinghua) adalah dua model. S2-Avatar adalah karakter digital langsung pada 720p dan 25-42 FPS, naik dari 540p di S1. Anda dapat memberikan gambar referensi baru di tengah-tengah aliran — cangkir, jaket, pantai — dan karakter mengambilnya, memakainya atau berjalan ke tempat kejadian; itu juga bisa menari. S2-Editing mengubah gaya aliran video yang masuk secara real time — lebih dari 50 gaya, percobaan virtual, penggantian subjek dan latar belakang — sementara gerakan sumber tetap utuh. Makalah ini juga mengeksplorasi keluaran stereo untuk headset VR.
PixVerse R2 Adalah salah satu model yang ditujukan untuk dunia interaktif. Empat jenis input dapat tiba saat berjalan — teks, referensi multimodal, audio, dan tindakan seperti WASD — dan masing-masing memperbarui keadaan dunia, bukan hanya bingkai saat ini. Mesin permainan PixVerse sekarang berjalan di R2; demo publik berfokus pada gerakan dan petunjuk.
Keputusan 1: bagaimana model dilatih
Model waktu nyata tidak dilatih dari ketiadaan. Titik awal yang biasa adalah generatif offline yang kuat sebelumnya, yang kemudian diubah untuk berjalan secara kausal dalam beberapa langkah. Di sinilah kedua laporan tersebut paling tidak setuju secara terbuka.
S2 menjalankan estafet. Model audio-video dua arah telah dilatih sebelumnya dan kemudian disetel dengan Diffusion-DPO untuk kesetiaan, ekspresi, gerakan, dan sinkronisasi audio-visual. Perhatiannya dialihkan ke blok-kausal dan dilatih pada campuran sejarah yang bersih dan berisik (keputusan 2). Self-Replay Forcecing kemudian menyaringnya menjadi beberapa langkah sementara itu melatih outputnya sendiri, dan pass preferensi streaming akhir (Streaming NFT) menyetel model kausal. Avatar dan pengeditan dilatih sebagai model terpisah.
R2 menyimpan satu fondasi. Omni Causal AR adalah model kausal yang telah dilatih sebelumnya secara terus menerus pada klip pendek, video panjang, data multimodal, dan lintasan interaksi. Akselerasi Real-Time kemudian menyaring model yang sama untuk penggunaan langsung: siswa diinisialisasi darinya dan guru dibangun di atasnya. Ungkapan laporannya adalah "mempercepat, jangan belajar kembali."
| Video S2 | PixVerse R2 | |
|---|---|---|
| Titik awal | Model dua arah disetel dengan Difusi-DPO | Model kausal yang telah dilatih sebelumnya secara terus menerus |
| Rute ke waktu nyata | Adaptasi blok-kausal → Self-Replay Forcing → penyetelan preferensi streaming | Menyuling model yang sama secara langsung |
| Model | Model avatar dan pengeditan terpisah | Satu model untuk setiap tipe input |
Laporan R2 menarik pendekatan umum sebagai estafet lima tahap dan berpendapat bahwa setiap serah terima kehilangan beberapa kemampuan. Baca dengan jelas, jalur pipa S2 memiliki bentuk multi-tahap, dengan peningkatan utamanya pada tahap terakhir. Tidak ada tim yang menerbitkan eksperimen yang membandingkan dua rute, jadi skala mana yang lebih baik masih menjadi pertanyaan terbuka.
Keputusan 2: menjaga aliran agar tidak melayang
Drift adalah kegagalan khas streaming video: warna merayap, wajah perlahan berubah menjadi orang lain, dan akhirnya bingkainya pecah. Itu terjadi karena pelatihan menunjukkan sejarah bersih model, sementara pada kesimpulan itu hanya melihat hasil yang tidak sempurna itu sendiri.
Kedua tim memulai dari perbaikan yang sama. Mereka bercampur Guru Memaksa, yang kondisinya pada sejarah kebenaran tanah yang bersih dan melindungi kualitas, dengan Pemaksaan Difusi, yang kondisi pada sejarah berbisik ke tingkat acak. Kebisingan menghapus detail halus tetapi mempertahankan tata letak dan gerakan, sehingga model belajar untuk bersandar pada struktur daripada mempercayai setiap piksel masa lalu.
Sejarah nyata yang berisik masih bukan kesalahan model itu sendiri, jadi setiap tim menambahkan lapisan kedua.
S2: Memaksa Pemutaran Ulang Diri. Model pertama-tama menggulung peregangan panjang persis seperti pada inferensi, tanpa gradien yang disimpan. Jendela lintasan itu diberi ulang blok demi blok dan diputar ulang dalam satu lintasan kausal yang diaktifkan gradien, dilatih dengan kehilangan distilasi DMD ditambah kehilangan persepsi. Karena blok yang diputar ulang berada dalam satu grafik komputasi, gradien melintasi batas blok - model mempelajari bagaimana satu blok membentuk yang berikutnya - tanpa menyebar kembali melalui peluncuran asli.
R2: Bank Kesalahan. Status kegagalan representatif dari generasi disimpan dan diputar ulang selama pelatihan bersama dengan riwayat normal, sehingga model belajar untuk pulih setelah penyimpangan telah memasuki dunia. Dalam evaluasi tahap internal PixVerse, metrik kecerahan-drift cakrawala panjang turun dari 0,201 menjadi 0,129, pengurangan 35,8%; 20 dari 29 urutan panjang meningkat, dan gerakan palsu turun di kelima sampel tanpa gerakan.
Keduanya saling melengkapi daripada bersaing. Self-Replay Memaksa kereta pada apa pun yang salah model saat ini; Error Bank mengebor kegagalan yang patut diingat.
Keputusan 3: memori yang tetap dibatasi
Keduanya menyimpan beberapa blok pembuka secara permanen sebagai jangkar (wastafel), menyimpan jendela geser dari blok terbaru dan menjatuhkan sisanya, sehingga biaya blok baru tidak bertambah dengan panjang aliran. Keduanya juga menjaga koordinat posisi di dalam jangkauan yang terlihat dalam pelatihan — S1 menyebutnya reposisi RoPE, R2 menyebutnya RoPE temporal relatif — sehingga sesi panjang tidak pernah mendorong posisi keluar dari distribusi.
S2 Dibangun di TwinCache dari S1, di mana setiap blok masa lalu di-cache dua kali: sekali berisik, sekali bersih. Langkah denoising menengah membaca salinan yang bising, yang membawa gerakan kasar dan bertindak seperti filter low-pass terhadap akumulasi artefak; langkah terakhir membaca salinan bersih untuk mengembalikan detail. S2 membagi ini di dua tahapnya: tulang punggung membaca cache dengan kebisingan tinggi, Refiner dengan kebisingan rendah, resolusi tinggi.
R2 Memisahkan memori berdasarkan skala waktu: Tenggelamkan Memori untuk identitas, lingkungan, gaya, dan aturan dunia; Rolling History untuk gerakan, pose, dan kamera terbaru; dan Object KV Cache yang mengompres keadaan tingkat objek yang masih akan penting nanti.
Perpecahan mencerminkan produk. Karakter digital harus tetap menjadi orang yang sama. Dunia juga harus mengingat apa yang terjadi di dalamnya — objek yang Anda letakkan, pilihan yang Anda buat.
Keputusan 4: dari mana kecepatan itu berasal
Keduanya menggunakan perhatian yang jarang dan distilasi beberapa langkah. Mereka menempatkan usaha mereka di tempat yang berbeda.
S2 bersandar pada rekayasa sistem, dan mendokumentasikannya. Perhatian dipilih per lapisan dari SageAttention, SpargeAttention dan sparse-linear attention, dengan perkiraan paling agresif pada lapisan yang paling tidak sensitif. Lapisan linier berjalan sebagai perkalian matriks W8A8 per blok. Operator yang berdekatan digabungkan ke dalam kernel Triton/CUDA dan diputar ulang dengan Grafik CUDA. Multi-GPU berjalan menggunakan paralelisme konteks Ulysses dengan komunikasi terkuantisasi, dan dalam pipa pengeditan encoder VAE, backbone, Refiner, dan decoder berbagi GPU pada garis waktu yang sama. Resolusi berasal dari tulang punggung resolusi rendah ditambah Refiner laten satu langkah hingga 720p.
R2 bersandar pada model. Perhatian yang jarang dipelajari selama pelatihan dan mencapai lebih dari 90% kelangkaan. Distilasi mengikuti DMD Terpisah - mengikuti sinyal kontrol dan mencocokkan guru dioptimalkan sebagai tujuan terpisah - ditambah istilah permusuhan dari DMD2 untuk jangkar realisme. Resolusi mengikuti piramida: satu atau dua tahap resolusi rendah mengatur tata letak, gerakan dan kamera, dan tahap resolusi tinggi terakhir menambahkan tekstur. Laporan tersebut tidak menyatakan resolusi keluaran atau laju bingkai R2.
Keputusan 5: bagaimana orang mengarahkannya
S2 membungkus model dalam agen VLM. Agen mengklasifikasikan setiap gambar referensi sebagai objek yang dipegang, latar belakang atau pakaian, kemudian menulis petunjuk untuk setiap segmen yang mencakup identitas, ekspresi, tatapan, pose, tindakan, dan objek yang dipegang, menyimpan apa pun yang tidak diminta pengguna untuk diubah. Setelah generasi itu meninjau bingkai secara berurutan, menilai apakah tindakan selesai, setengah selesai atau salah, dan menulis prompt berikutnya sesuai dengan itu. Untuk memasang atau melepas aksesori, petunjuk menyatakan gerakan dan keadaan akhir, sehingga topi yang dipasang kembali tetap menyala. Dalam mode pengeditan, perhatian yang selaras dengan bingkai memungkinkan setiap bingkai keluaran hanya membaca bingkai sumber pada saat yang sama, sehingga gerakan dan waktu cocok dengan input dengan tepat.
R2 membangun satu antarmuka input ke dalam model. Teks, referensi, audio, tindakan, dan kontrol yang dihasilkan agen semuanya memasuki dunia berjalan yang sama. Panjang blok mengikuti kontrol aktif, hingga batas: penekanan tombol mendapatkan blok pendek untuk respons cepat, sementara seluruh acara atau bentangan audio menjadi lebih panjang agar tetap koheren. Di atas model, mesin permainan PixVerse menambahkan lapisan agen yang menjaga keadaan aturan permainan dan adegan yang dihasilkan tetap sinkron.
Apa yang diungkapkan setiap laporan
Sebelum membandingkan angka, bandingkan apa yang telah dipublikasikan.
| Video S2 | PixVerse R2 | |
|---|---|---|
| Format | Kertas arXiv | Pos teknis di situs PixVerse |
| Resolusi dan kecepatan bingkai | 720p, 25-42 FPS | Tidak dinyatakan |
| Parameter dan latensi ujung ke ujung | Tidak dinyatakan | Tidak dinyatakan |
| Tolok ukur publik | Satu tolok ukur avatar, empat tolok ukur pengeditan | Tidak ada; hanya evaluasi internal |
| Bobot | Tidak dirilis; API tersedia | Tidak dirilis |
Di StreamAV-Bench, S2 menempati peringkat pertama pada kesembilan metrik yang dilaporkan di 14 sistem dalam evaluasinya sendiri: penyelarasan audio-visual 0,353 terhadap alternatif terbaik 0,272, dan kesalahan sinkronisasi 0,617 terhadap 0,648. Beberapa margin berada di tempat desimal ketiga — konsistensi subjek adalah 0,998 versus 0,997. Angka yang dipublikasikan R2 adalah pengurangan drift 35,8% dan kelangkaan perhatian 90%-plus, yang menurut laporan mempertahankan empat dimensi kualitas internal tanpa memberikan skor.
Tidak ada head-to-head. Kertas S2 dibandingkan dengan PixVerse R1 sebelumnya, dan R2 dirilis setelahnya.
Apa artinya ini jika kamu membuat video dengan agen
Kami membuat aplikasi desktop di mana agen melakukan pekerjaan, dan video adalah salah satu pekerjaan yang diberikan orang kepada mereka. Dua hal dari laporan-laporan ini terbawa.
Pertama, garis antara video langsung dan video yang sudah selesai semakin tajam. Model waktu nyata dibuat untuk pengalaman yang terus merespons — karakter, permainan, aliran yang Anda tata ulang saat diputar. Sebagian besar pekerjaan pembuat masih berakhir dalam sebuah file. Di Orkas, VideoStudio mengubah rekaman dan ringkasan menjadi potongan yang dapat ditinjau, dan ketika sebuah bidikan harus dihasilkan, itu menggunakan model offline: Pembuatan video yang dikelola Orkas, atau kunci Anda sendiri untuk Seedance 2.0, Hailuo 2.3, Vidu Q3 Pro, Kling 3.0 Turbo, Veo 3.1 atau Runway Gen-4.5. Baik S2 maupun R2 tidak berjalan di dalam Orkas hari ini.
Kedua, lapisan kontrol S2 adalah loop agen: tulis prompt, hasilkan, lihat bingkai, putuskan apa yang harus dilakukan selanjutnya. Itu adalah bentuk yang sama dengan agen mana pun yang bekerja dengan model generasi, real-time atau tidak — dan sebagian besar hasilnya tergantung pada lingkaran itu, tidak hanya pada bobotnya.
Apa yang kita ambil dari itu
Kerangka telah menetap: difusi autoregresif blok-kausal, video dan audio yang dihasilkan bersama, sejarah bersih-plus-bising, wastafel dan jendela, distilasi keluarga DMD, perhatian yang jarang, resolusi rendah terlebih dahulu. Apa yang memisahkan S2 dan R2 adalah di mana mereka menghabiskan upaya mereka - relai perbaikan yang ditargetkan versus satu fondasi yang disuling sekali, pemutaran ulang berdasarkan kebijakan versus bank kegagalan, rekayasa sistem versus kelangkaan yang dipelajari.
Keduanya layak dibaca secara penuh: Kertas Vidu S2 Untuk pelatihan dan detail pelayanannya, dan Laporan PixVerse R2 Untuk argumennya tentang penskalaan model waktu nyata tanpa mempelajarinya kembali.