
Trong tháng này, hai mô hình video thời gian thực ra mắt cách nhau một tuần. Vidu S2 của ShengShu được đưa vào sử dụng ngày 15 tháng 9, còn PixVerse công bố PixVerse R2 ngày 22 tháng 9. S2 tập trung vào nhân vật số tương tác trực tiếp và đổi phong cách luồng video ngay khi đang phát. R2 tự gọi mình là mô hình thế giới thời gian thực: một cảnh mà bạn có thể di chuyển bằng WASD, trong khi câu lệnh, tài liệu tham chiếu và âm thanh thay đổi điều xảy ra tiếp theo.
Cả hai nhóm đều công bố cách họ xây dựng mô hình: S2 trong một bài báo trên arXiv, R2 trong một báo cáo kỹ thuật trên trang PixVerse. Chúng tôi đọc và đối chiếu hai tài liệu. Chúng thống nhất về khung kiến trúc, khác nhau ở năm lựa chọn thiết kế và công bố lượng thông tin rất khác nhau. Bài viết này trình bày cả ba điểm, đồng thời chủ ý không tuyên bố bên nào thắng: hai mô hình chưa từng được đo trên cùng một bài kiểm tra.
Video thời gian thực thay đổi điều gì?
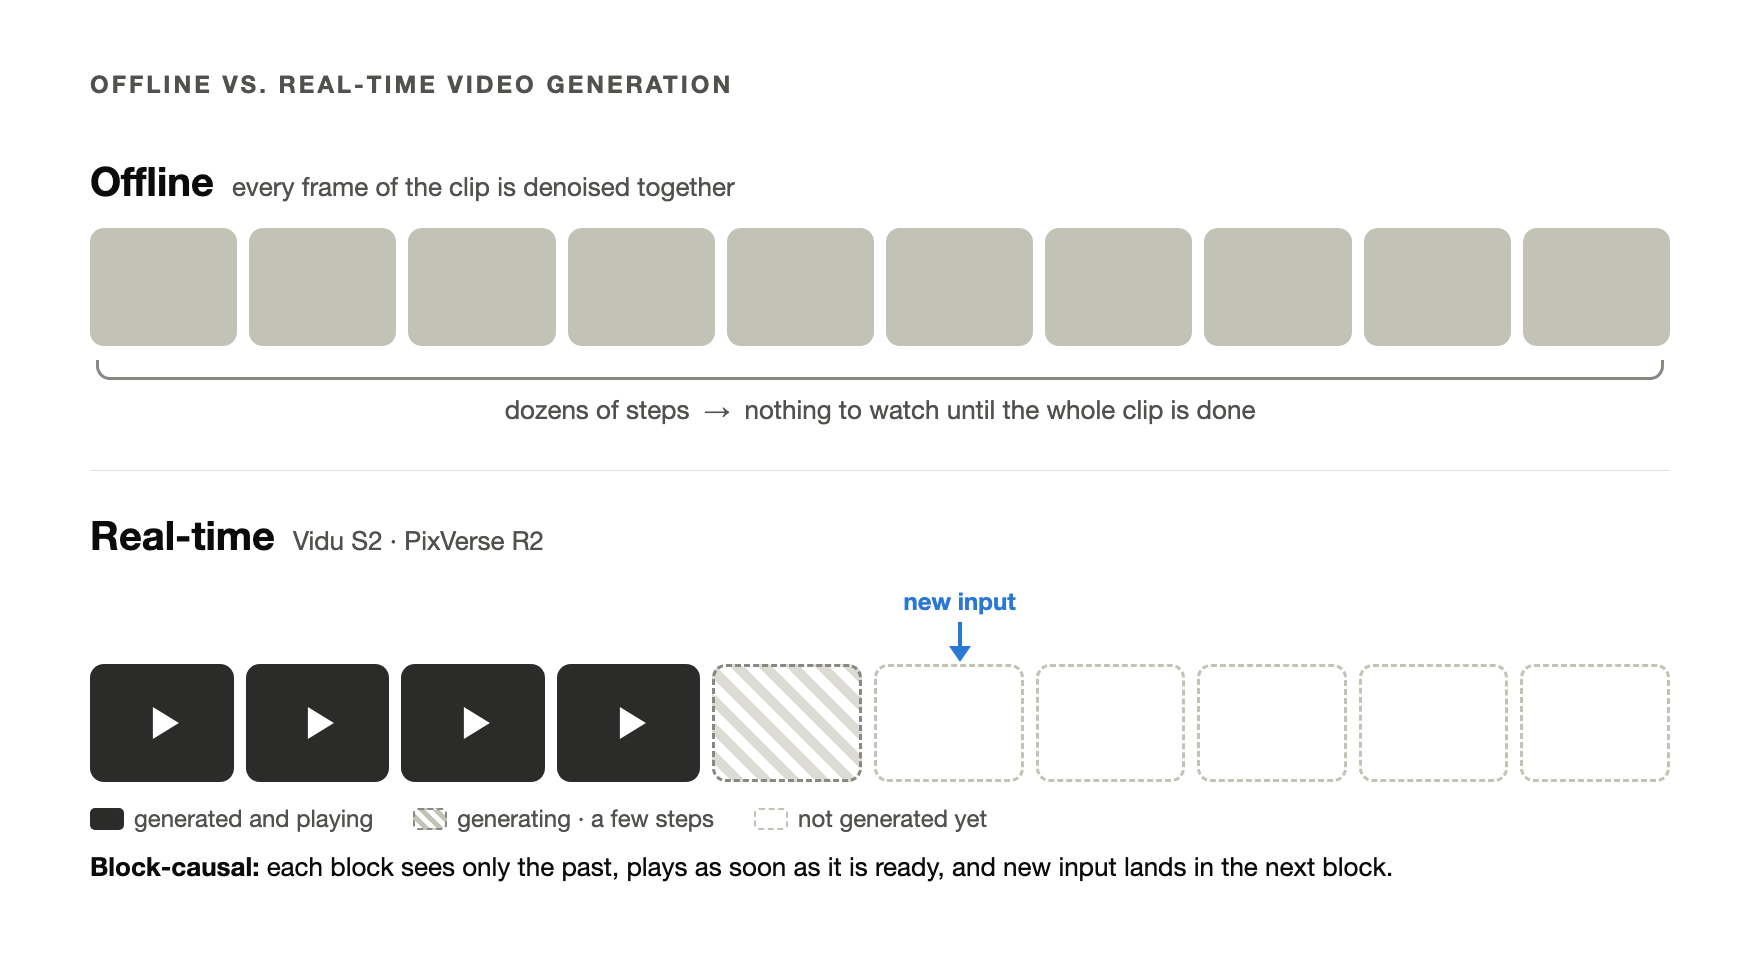
Phần lớn mô hình video hoạt động ngoại tuyến. Mọi khung hình trong một đoạn video được khử nhiễu cùng lúc qua hàng chục bước; bạn không thấy gì cho đến khi toàn bộ đoạn hoàn tất. Mọi điều bạn muốn phải có trong câu lệnh trước khi bắt đầu tạo.
Mô hình thời gian thực đảo ngược cách làm đó. Nó chia video thành các khối gồm vài khung hình và đoạn âm thanh tương ứng, rồi tạo theo thứ tự. Mỗi khối chỉ trải qua vài bước khử nhiễu và phát ngay khi sẵn sàng. Một khối có thể nhìn thấy những gì đến trước, nhưng không thể nhìn thấy những gì đến sau; đó là ý nghĩa của block-causal. Chỉ dẫn mới có hiệu lực ở khối tiếp theo.
Cấu trúc này tạo ra ba vấn đề, và gần như mọi lựa chọn thiết kế dưới đây đều nhằm giải quyết một trong số đó:
- Lỗi tích lũy. Mỗi khối dựa vào các khối mà chính mô hình đã tạo trước đó, nên một lỗi nhỏ sẽ truyền sang mọi khối tiếp theo.
- Lịch sử phải có giới hạn. Luồng có thể chạy vô thời hạn; giữ mọi khối trong quá khứ sẽ khiến mỗi khối mới ngày càng tốn kém.
- Quỹ thời gian cực kỳ eo hẹp. Ở tốc độ 25 khung hình/giây, mỗi khung hình chỉ có 40 mili giây.
S2 và R2 có cùng khung kiến trúc: mô hình khuếch tán tự hồi quy theo nhân quả từng khối, tạo video và âm thanh cùng nhau. Điểm khác biệt nằm ở cách huấn luyện, giữ ổn định, quản lý bộ nhớ, tăng tốc và cho phép người dùng điều khiển.
Hai hệ thống
Vidu S2 (ShengShu Technology cùng Tsinghua University) gồm hai mô hình. S2-Avatar tạo nhân vật số trực tiếp ở 720p và 25–42 FPS, tăng từ 540p của S1. Bạn có thể đưa hình tham chiếu mới giữa chừng, chẳng hạn chiếc cốc, áo khoác hoặc bãi biển; nhân vật sẽ cầm, mặc hoặc bước vào khung cảnh đó. Nhân vật cũng có thể nhảy. S2-Editing đổi phong cách luồng video đầu vào theo thời gian thực, với hơn 50 phong cách, thử trang phục ảo, thay chủ thể và nền, đồng thời giữ nguyên chuyển động gốc. Bài báo cũng khảo sát đầu ra lập thể cho kính VR.
PixVerse R2 là một mô hình duy nhất hướng đến thế giới tương tác. Bốn loại đầu vào có thể đến khi nó đang chạy: văn bản, tham chiếu đa phương thức, âm thanh và hành động như WASD. Mỗi loại cập nhật trạng thái của cả thế giới, không chỉ khung hình hiện tại. Công cụ trò chơi của PixVerse hiện chạy trên R2; bản demo công khai tập trung vào di chuyển và câu lệnh.
Lựa chọn 1: huấn luyện mô hình như thế nào?
Mô hình thời gian thực không được huấn luyện từ con số không. Điểm xuất phát thường là một mô hình sinh ngoại tuyến mạnh, sau đó được chuyển đổi để hoạt động theo quan hệ nhân quả chỉ trong vài bước. Đây là chỗ hai báo cáo bất đồng rõ rệt nhất.
S2 đi qua nhiều chặng. Mô hình âm thanh–video hai chiều được tiền huấn luyện rồi tinh chỉnh bằng Diffusion-DPO để cải thiện độ trung thực, biểu cảm, chuyển động và đồng bộ âm thanh–hình ảnh. Cơ chế attention được đổi thành nhân quả theo từng khối và huấn luyện bằng hỗn hợp lịch sử sạch và có nhiễu (lựa chọn 2). Tiếp đó, Self-Replay Forcing chưng cất mô hình xuống còn vài bước trong khi huấn luyện trên chính đầu ra của nó; cuối cùng, một vòng tinh chỉnh ưu tiên cho luồng (Streaming NFT) điều chỉnh mô hình nhân quả. Avatar và Editing được huấn luyện thành hai mô hình riêng.
R2 giữ một nền tảng duy nhất. Omni Causal AR là mô hình nhân quả được tiền huấn luyện liên tục trên đoạn video ngắn, video dài, dữ liệu đa phương thức và chuỗi tương tác. Real-Time Acceleration sau đó chưng cất chính mô hình đó cho việc sử dụng trực tiếp: mô hình học trò được khởi tạo từ nó, còn mô hình thầy được xây dựng trên nó. Báo cáo tóm tắt là “tăng tốc, không học lại”.
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| Điểm xuất phát | Mô hình hai chiều tinh chỉnh bằng Diffusion-DPO | Mô hình nhân quả được tiền huấn luyện liên tục |
| Đường đến thời gian thực | Chuyển sang nhân quả từng khối → Self-Replay Forcing → tinh chỉnh ưu tiên cho luồng | Chưng cất trực tiếp chính mô hình đó |
| Các mô hình | Avatar và Editing là hai mô hình riêng | Một mô hình cho mọi loại đầu vào |
Báo cáo R2 mô tả cách làm thông thường như một quy trình chuyển tiếp năm giai đoạn và lập luận rằng mỗi lần chuyển tiếp đều làm mất một phần năng lực. Hiểu theo nghĩa trực tiếp, quy trình của S2 có hình dạng nhiều giai đoạn ấy, với cải tiến chính ở giai đoạn cuối. Chưa nhóm nào công bố thí nghiệm so sánh hai hướng đi, vì vậy hướng nào mở rộng tốt hơn vẫn là câu hỏi bỏ ngỏ.
Lựa chọn 2: giữ cho luồng không bị trôi dần
Trôi dạt là kiểu lỗi đặc trưng của video trực tuyến: màu sắc thay đổi từ từ, khuôn mặt dần biến thành người khác, rồi cuối cùng khung hình hỏng hẳn. Nguyên nhân là khi huấn luyện, mô hình nhìn thấy lịch sử sạch, còn lúc suy luận nó chỉ thấy đầu ra không hoàn hảo của chính mình.
Hai nhóm bắt đầu bằng cùng một cách sửa. Họ kết hợp Teacher Forcing, vốn dựa trên lịch sử thực sạch để giữ chất lượng, với Diffusion Forcing, vốn dựa trên lịch sử được thêm nhiễu ở mức ngẫu nhiên. Nhiễu xóa chi tiết nhỏ nhưng giữ bố cục và chuyển động, khiến mô hình học cách dựa vào cấu trúc thay vì tin vào từng pixel trong quá khứ.
Tuy nhiên, lịch sử thực được thêm nhiễu vẫn không phải lỗi do chính mô hình tạo ra, nên mỗi nhóm bổ sung một lớp nữa.
S2: Self-Replay Forcing. Trước hết, mô hình tạo một chuỗi dài đúng như khi suy luận, không lưu gradient. Một cửa sổ của chuỗi đó được thêm nhiễu lại theo từng khối rồi phát lại trong một lượt tính toán nhân quả có gradient, huấn luyện bằng hàm mất mát chưng cất DMD cộng với hàm mất mát cảm nhận. Vì các khối phát lại nằm trong cùng một đồ thị tính toán, gradient đi qua ranh giới khối: mô hình học cách một khối định hình khối tiếp theo, mà không cần lan truyền ngược qua lượt tạo ban đầu.
R2: Error Bank. Các trạng thái lỗi tiêu biểu trong quá trình tạo được lưu lại và phát lại khi huấn luyện cùng với lịch sử bình thường, để mô hình học cách phục hồi sau khi thế giới đã xuất hiện sai lệch. Trong đánh giá theo giai đoạn nội bộ của PixVerse, chỉ số trôi độ sáng trên chuỗi dài giảm từ 0.201 xuống 0.129, tương đương giảm 35.8%; 20 trong 29 chuỗi dài cải thiện, và chuyển động ngoài ý muốn giảm ở cả năm mẫu không có chuyển động.
Hai phương pháp bổ sung cho nhau hơn là cạnh tranh. Self-Replay Forcing huấn luyện trên những gì mô hình hiện tại làm sai; Error Bank tập trung luyện lại những lỗi đáng ghi nhớ.
Lựa chọn 3: bộ nhớ có giới hạn
Cả hai đều giữ vĩnh viễn một vài khối mở đầu làm điểm neo (sink), giữ một cửa sổ trượt của các khối gần đây và bỏ phần còn lại; nhờ đó chi phí tạo khối mới không tăng theo độ dài luồng. Cả hai cũng giữ tọa độ vị trí trong phạm vi đã thấy khi huấn luyện: S1 gọi là RoPE repositioning, còn R2 gọi là relative temporal RoPE. Vì vậy, phiên chạy dài không đẩy các vị trí ra ngoài phân phối huấn luyện.
S2 phát triển từ TwinCache của S1, trong đó mỗi khối quá khứ được lưu hai bản: một bản có nhiễu, một bản sạch. Các bước khử nhiễu trung gian đọc bản có nhiễu, vốn giữ chuyển động tổng quát và hoạt động như bộ lọc thông thấp chống lại lỗi tích lũy. Bước cuối đọc bản sạch để phục hồi chi tiết. S2 chia việc này cho hai giai đoạn: backbone đọc cache nhiễu cao, Refiner đọc cache nhiễu thấp ở độ phân giải cao.
R2 phân chia bộ nhớ theo thang thời gian: Sink Memory cho danh tính, môi trường, phong cách và quy tắc thế giới; Rolling History cho chuyển động, tư thế và camera gần đây; Object KV Cache nén trạng thái ở mức vật thể vẫn còn quan trọng về sau.
Sự phân chia này phản ánh hai sản phẩm. Nhân vật số phải luôn là cùng một người. Một thế giới còn phải nhớ những gì xảy ra bên trong nó: món đồ bạn đặt xuống, lựa chọn bạn đã đưa ra.
Lựa chọn 4: tốc độ đến từ đâu?
Cả hai dùng sparse attention và chưng cất còn ít bước. Nhưng họ dồn công sức vào những chỗ khác nhau.
S2 dựa vào kỹ thuật hệ thống và mô tả rõ điều đó. Mỗi lớp chọn attention từ SageAttention, SpargeAttention và sparse-linear attention; phép xấp xỉ mạnh nhất đặt ở những lớp ít nhạy cảm nhất. Các lớp tuyến tính chạy phép nhân ma trận W8A8 theo từng khối. Các toán tử liền kề được gộp vào kernel Triton/CUDA và phát lại bằng CUDA Graphs. Tác vụ nhiều GPU dùng Ulysses context parallelism với truyền thông được lượng tử hóa; trong quy trình Editing, bộ mã hóa VAE, backbone, Refiner và bộ giải mã chia sẻ GPU theo cùng một dòng thời gian. Độ phân giải đến từ backbone độ phân giải thấp cộng với latent Refiner một bước để đạt tới 720p.
R2 dựa vào mô hình. Block-sparse attention được học trong lúc huấn luyện và đạt độ thưa trên 90%. Việc chưng cất theo Decoupled DMD: bám tín hiệu điều khiển và khớp với mô hình thầy được tối ưu như hai mục tiêu riêng, kèm một thành phần đối kháng từ DMD2 để giữ tính chân thực. Độ phân giải theo dạng kim tự tháp: một hoặc hai giai đoạn độ phân giải thấp đặt bố cục, chuyển động và camera; giai đoạn độ phân giải cao cuối cùng bổ sung chi tiết bề mặt. Báo cáo không nêu độ phân giải đầu ra hoặc tốc độ khung hình của R2.
Lựa chọn 5: người dùng điều khiển ra sao?
S2 đặt một tác tử VLM bao quanh mô hình. Tác tử phân loại từng ảnh tham chiếu thành đồ vật cầm trên tay, nền hoặc trang phục; sau đó viết câu lệnh cho mỗi phân đoạn, bao quát danh tính, biểu cảm, hướng nhìn, tư thế, hành động và đồ vật đang cầm, đồng thời giữ nguyên những gì người dùng không yêu cầu đổi. Sau khi tạo, nó xem lại các khung hình theo thứ tự, xác định hành động đã hoàn thành, mới hoàn thành một phần hay bị sai, rồi viết câu lệnh tiếp theo. Khi đeo hoặc tháo phụ kiện, câu lệnh nêu cả chuyển động lẫn trạng thái cuối, để chiếc mũ đội lại sẽ vẫn ở trên đầu. Trong chế độ Editing, attention căn theo khung hình cho phép mỗi khung đầu ra chỉ đọc khung nguồn tại cùng thời điểm, nhờ đó chuyển động và thời gian khớp chính xác với đầu vào.
R2 xây một giao diện đầu vào duy nhất vào trong mô hình. Văn bản, tham chiếu, âm thanh, hành động và điều khiển do tác tử tạo đều đi vào cùng một thế giới đang vận hành. Độ dài khối thay đổi theo cách điều khiển đang hoạt động, trong giới hạn tối đa: nhấn phím dùng khối ngắn để phản hồi nhanh, còn toàn bộ sự kiện hoặc một đoạn âm thanh dùng khối dài hơn để giữ mạch lạc. Trên mô hình, công cụ trò chơi của PixVerse thêm một lớp tác tử để đồng bộ trạng thái quy tắc trò chơi với cảnh được tạo.
Mỗi báo cáo công bố những gì?
Trước khi so sánh con số, hãy so sánh những gì được công bố.
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| Hình thức | Bài báo arXiv | Bài kỹ thuật trên trang PixVerse |
| Độ phân giải và tốc độ khung hình | 720p, 25–42 FPS | Không nêu |
| Số tham số và độ trễ đầu cuối | Không nêu | Không nêu |
| Đánh giá chuẩn công khai | Một đánh giá Avatar, bốn đánh giá Editing | Không có; chỉ đánh giá nội bộ |
| Trọng số mô hình | Chưa phát hành; có API | Chưa phát hành |
Trên StreamAV-Bench, S2 đứng đầu cả chín chỉ số được báo cáo trong 14 hệ thống theo đánh giá của chính họ: độ khớp âm thanh–hình ảnh 0.353 so với phương án tốt nhất khác là 0.272, và lỗi đồng bộ 0.617 so với 0.648. Có những khoảng cách chỉ nằm ở chữ số thập phân thứ ba: độ nhất quán chủ thể là 0.998 so với 0.997. Những con số R2 công bố là mức giảm trôi dạt 35.8% và độ thưa attention trên 90%; báo cáo nói vẫn giữ bốn khía cạnh chất lượng nội bộ nhưng không đưa điểm số.
Không có so sánh trực tiếp. Bài báo S2 so sánh với PixVerse R1 trước đó, còn R2 ra mắt sau.
Điều này có ý nghĩa gì nếu bạn làm video bằng tác tử?
Chúng tôi xây dựng ứng dụng máy tính nơi tác tử thực hiện công việc, và video là một trong những việc người dùng giao cho chúng. Có hai điều từ các báo cáo này đáng mang sang.
Thứ nhất, ranh giới giữa video trực tiếp và video hoàn chỉnh ngày càng rõ. Mô hình thời gian thực dành cho trải nghiệm liên tục phản hồi: nhân vật, trò chơi, luồng đổi phong cách trong lúc phát. Phần lớn công việc sáng tạo vẫn kết thúc bằng một tệp. Trong Orkas, VideoStudio biến cảnh quay cùng bản mô tả thành bản dựng có thể duyệt lại. Khi cần tạo một cảnh mới, nó dùng mô hình ngoại tuyến: dịch vụ tạo video do Orkas quản lý hoặc khóa riêng của bạn cho Seedance 2.0, Hailuo 2.3, Vidu Q3 Pro, Kling 3.0 Turbo, Veo 3.1 hay Runway Gen-4.5. Hiện nay cả S2 lẫn R2 đều chưa chạy bên trong Orkas.
Thứ hai, lớp điều khiển của S2 là một vòng lặp tác tử: viết câu lệnh, tạo kết quả, xem các khung hình, quyết định việc cần làm tiếp. Đó là cấu trúc của mọi tác tử làm việc với mô hình tạo sinh, dù có thời gian thực hay không; phần lớn kết quả phụ thuộc vào vòng lặp này chứ không chỉ trọng số mô hình.
Điều chúng tôi rút ra
Khung kiến trúc đã dần ổn định: khuếch tán tự hồi quy theo nhân quả từng khối, video và âm thanh được tạo cùng nhau, lịch sử sạch lẫn có nhiễu, điểm neo và cửa sổ bộ nhớ, chưng cất họ DMD, sparse attention và bắt đầu ở độ phân giải thấp. S2 và R2 khác nhau ở nơi họ dồn công sức: chuỗi sửa đổi có mục tiêu so với một mô hình nền tảng chưng cất một lần; phát lại theo chính đầu ra của mô hình so với kho lỗi; kỹ thuật hệ thống so với độ thưa được học.
Cả hai tài liệu đều đáng đọc trọn vẹn: bài báo Vidu S2 để hiểu chi tiết huấn luyện và vận hành, còn báo cáo PixVerse R2 để xem lập luận về mở rộng mô hình thời gian thực mà không phải học lại.