
这个月,两款实时视频模型相隔一周上线:生数科技的 Vidu S2 在 9 月 15 日上线,爱诗科技在 9 月 22 日发布了 PixVerse R2。S2 做的是实时数字人,以及在视频流播放的同时实时改视频;R2 自称实时世界模型:你用 WASD 在场景里移动,同时用文字、参考图和音频改变接下来发生的事。
两家都公开了技术方案:S2 发了 arXiv 论文,R2 在 PixVerse 官网发了技术报告。我们把两份资料对照着读完:骨架一致,五个设计选择各走一路,公开的信息量差别很大。这篇把三件事都讲清楚,但刻意不评谁更强——两者从来没有在同一个测试上比过。
「实时」改变了什么
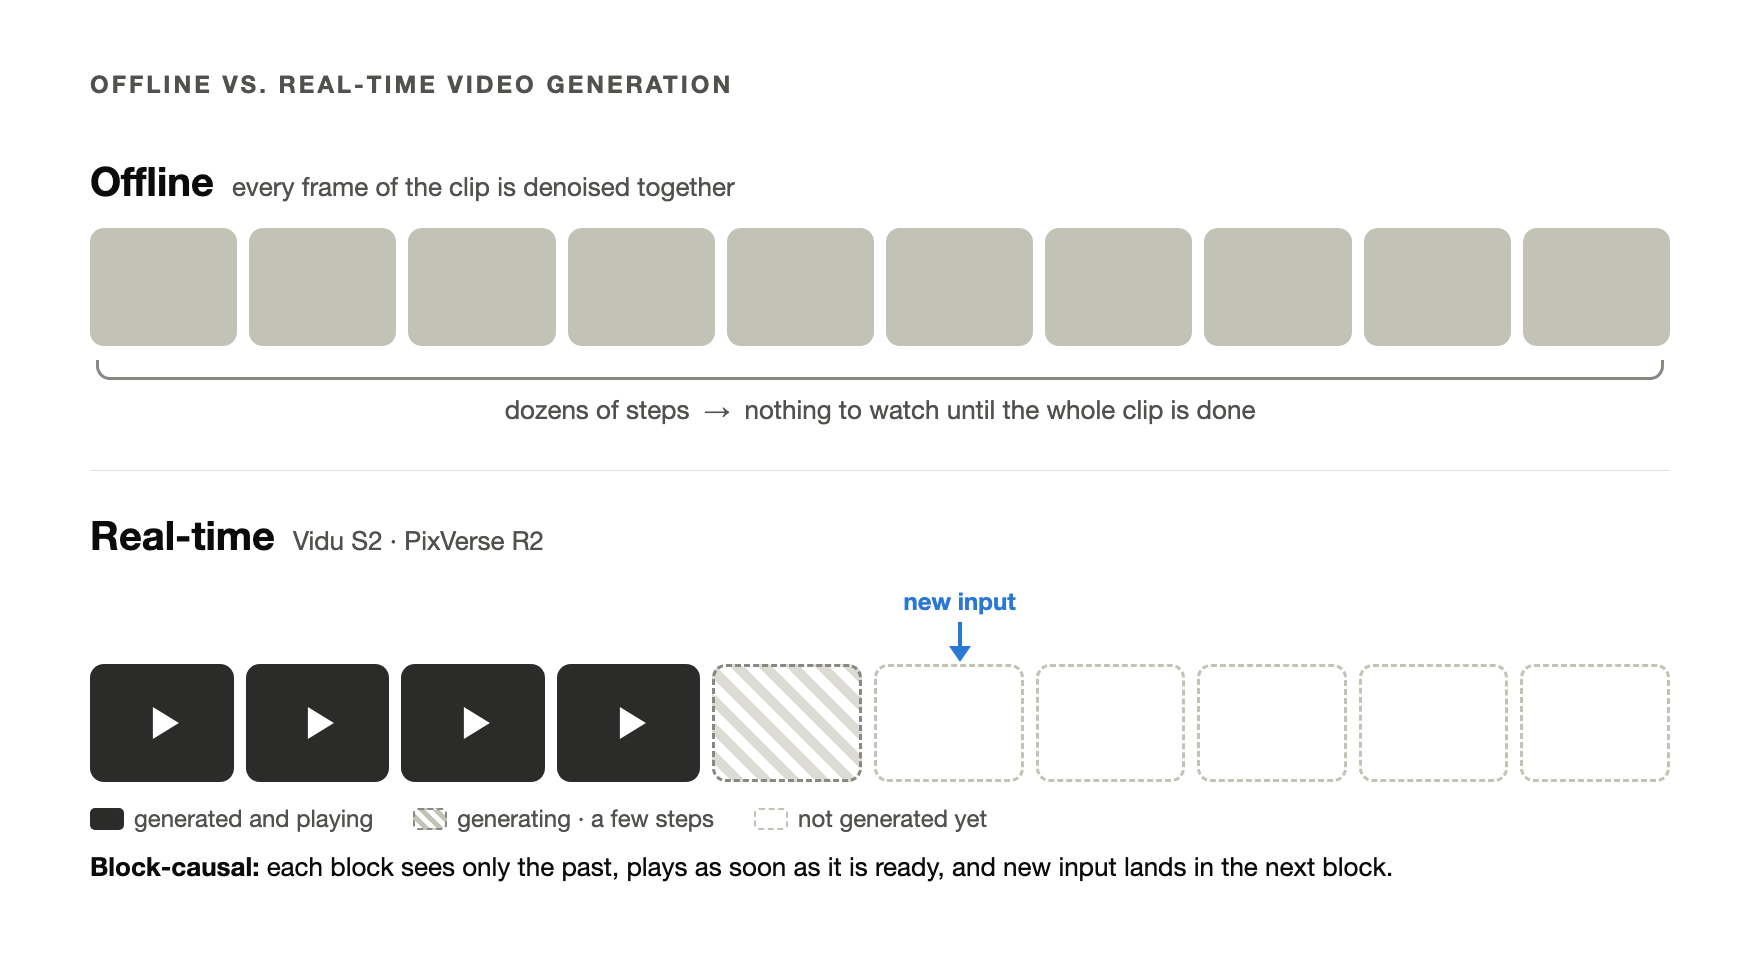
大多数视频模型是离线的:一段视频的所有帧一起去噪,通常要跑几十步,整段算完之前什么都看不到。想要什么,必须在生成开始前写进 prompt。
实时模型把这个过程倒了过来。它把视频切成一块一块(每块几帧,加上同一时段的音频),按时间顺序逐块生成。每块只去噪几步,生成完立刻播放。每一块只能看到之前的内容,看不到之后的内容,这就是块因果。新的指令会落在下一块上。
这种结构带来三个难题,下面几乎每个设计选择都在回答其中之一:
- 误差会累积。每一块都以模型自己生成的块为条件,一个小错会被之后的所有内容继承。
- 历史必须有上限。视频流可以一直进行下去,如果保留所有历史块,每生成一块的代价都会越来越高。
- 时间预算极紧。按每秒 25 帧算,每一帧只有 40 毫秒。
S2 和 R2 落在同一副骨架上:块因果的自回归扩散模型,视频和音频一起生成。差别在于怎么训练、怎么保持稳定、怎么记忆、怎么提速,以及怎么让人来操控。
两款模型
Vidu S2(生数科技联合清华大学)包含两个模型。S2-Avatar 是实时数字人,720p、25–42 FPS,上一代 S1 是 540p。直播过程中可以随时给它一张新的参考图——一个杯子、一件外套、一片海滩——角色就会拿起杯子、穿上外套或者走进新场景;它也能跳舞。S2-Editing 对输入的视频流做实时改写——50 多种风格、虚拟试衣、换人、换背景——同时保留原视频的动作。论文还探索了面向 VR 头显的立体输出。
PixVerse R2 是一个面向可交互世界的模型。运行过程中可以随时进来四类输入——文字、多模态参考、音频,以及 WASD 这类动作——每一种都会更新世界的状态,而不只是改当前这一帧。PixVerse 的游戏引擎已经跑在 R2 上;公开体验以移动和文字指令为主。
选择一:模型怎么训练
实时模型不是从零训出来的。常见的起点是一个很强的离线生成先验,再把它改造成能按因果顺序、少步运行的模型。两份报告在这一点上的分歧最明显。
S2 走的是接力。先预训练一个双向的音视频模型,再用 Diffusion-DPO 提升画质、表情、动作和音画同步。然后把注意力改成块因果,用干净历史和加噪历史混合训练(见选择二)。接着用 Self-Replay Forcing 让模型在自己的输出上训练,同时蒸馏成少步模型;最后再做一轮流式偏好优化(Streaming NFT)。数字人和视频编辑是分开训练的两个模型。
R2 只保留一个底座。Omni Causal AR 是一个因果模型,持续用短视频、长视频、多模态数据和交互轨迹做预训练。之后由 Real-Time Acceleration 把同一个模型直接蒸馏成实时版本:学生从它初始化,老师也建立在它之上。报告的说法是「加速,而不是重学」。
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| 起点 | 用 Diffusion-DPO 调优过的双向模型 | 持续预训练的因果模型 |
| 走向实时的路径 | 块因果改造 → Self-Replay Forcing → 流式偏好优化 | 直接蒸馏同一个模型 |
| 模型数量 | 数字人、视频编辑各一个 | 所有输入类型共用一个 |
R2 的报告把常见做法画成一个五段接力,认为每交接一次都会损失一部分能力。客观地看,S2 的流程就是这种多段结构,主要改进落在最后一段。两家都没有公开比较这两条路线的实验,哪条路线扩展性更好,目前仍然没有答案。
选择二:防止视频流越跑越偏
漂移是流式视频最典型的失败:颜色慢慢偏、一张脸慢慢变成另一个人,最后画面崩掉。原因在于训练时模型看到的是干净的历史,而推理时它只能看到自己生成的、不完美的输出。
两家的第一步相同:混合使用 Teacher Forcing(以干净的真实历史为条件,保住画质)和 Diffusion Forcing(以加了随机强度噪声的历史为条件)。噪声会抹掉细节,但保留布局和动作,模型因此学会依靠结构,而不是相信过去的每一个像素。
加了噪声的真实历史,仍然不等于模型自己犯的错,所以两家各自又加了一层。
S2:Self-Replay Forcing(自我重放)。模型先按推理时的方式连续生成一长段,不保留梯度。然后截取其中一段,逐块重新加噪,在一次带梯度的因果前向里重放,用 DMD 蒸馏损失加感知损失训练。重放的这些块在同一个计算图里,梯度能跨过块的边界传递——模型学到的是一块如何影响下一块——同时又不用对最初那次长生成做反向传播。
R2:Error Bank(错题库)。把生成中出现的典型失败状态存起来,训练时和正常历史一起回放,让模型学会在偏差已经进入画面之后把它拉回来。在 PixVerse 的内部阶段评测里,长程亮度漂移指标从 0.201 降到 0.129,降低 35.8%;29 条长序列中有 20 条改善,5 条静止画面样本里的伪运动全部减少。
两者是互补而不是竞争关系:Self-Replay Forcing 练的是当前模型会犯的错,Error Bank 反复练值得记住的典型失败。
选择三:有上限的记忆
两家都把开头几块永久保留作为锚点(sink),再保留一个最近几块的滑动窗口,其余丢弃,所以生成新一块的代价不会随视频流变长而增长。两家也都把位置坐标限定在训练见过的范围里——S1 叫 RoPE 重定位,R2 叫相对时间 RoPE——会话再长,位置也不会超出训练分布。
S2 在 S1 的 TwinCache 基础上改进。TwinCache 给每个历史块缓存两份:一份带噪、一份干净。去噪的中间步骤读带噪的那份,它只传递粗略的动作,相当于一个低通滤波,防止伪影累积;最后一步读干净的那份,把细节补回来。S2 把这个设计拆到两个阶段:主干读高噪声缓存,Refiner 读低噪声的高分辨率缓存。
R2 按时间尺度拆分记忆:Sink Memory 记身份、环境、风格和世界规则;Rolling History 记近期的动作、姿态和镜头;Object KV Cache 压缩保留之后还会用到的物体状态。
这种划分对应各自的产品。数字人要一直是同一个人;世界还要记住里面发生过什么——你放下的东西、你做过的选择。
选择四:速度从哪里来
两家都用了稀疏注意力和少步蒸馏,但发力点不同。
S2 主要靠系统工程,而且写得很详细。注意力按层从 SageAttention、SpargeAttention 和稀疏线性注意力中挑选,最激进的近似放在最不敏感的层。线性层用 per-block W8A8 矩阵乘法。相邻算子融合成 Triton/CUDA 内核,并用 CUDA Graphs 回放。多卡运行用 Ulysses 上下文并行,卡间通信也做量化;在视频编辑管线里,VAE 编码器、主干、Refiner 和解码器按同一条时间线共用 GPU。分辨率由低分辨率主干加一个一步的潜空间 Refiner 提升到 720p。
R2 主要靠模型本身。块稀疏注意力在训练中学出来,稀疏度超过 90%。蒸馏采用 Decoupled DMD——「听从控制信号」和「贴近老师分布」作为两个独立目标分别优化——再加上一项来自 DMD2 的对抗损失保证画面真实。分辨率走金字塔结构:先用一到两个低分辨率阶段确定布局、动作和镜头,最后一个高分辨率阶段补上纹理。报告没有给出 R2 的输出分辨率和帧率。
选择五:人怎么操控它
S2 在模型外面套了一层 VLM 智能体。智能体先判断每张参考图是手持物、背景还是服装,再为每一段写 prompt,分别描述身份、表情、视线、姿态、动作和手里拿的东西,用户没要求改的保持不变。生成后它按时间顺序检查画面,判断动作是做完了、做了一半还是做错了,再据此写下一段的 prompt。摘戴配饰这类动作,prompt 会同时写动作和结束后的状态,所以戴回去的帽子会一直戴着。在编辑模式下,帧对齐注意力让每个输出帧只读取原视频同一时刻的那一帧,所以动作和节奏与输入完全一致。
R2 把统一的输入接口做进了模型。文字、参考、音频、动作以及智能体生成的控制,都进入同一个运行中的世界。每一块的长度跟随当前的控制信号,有上限:按键用短块,响应更快;一段完整事件或一段音频用长块,保持连贯。在模型之上,PixVerse 的游戏引擎还加了一层智能体,负责让游戏规则的状态和生成的场景保持同步。
两份报告各自公开了什么
比较数字之前,先比较公开了哪些信息。
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| 形式 | arXiv 论文 | PixVerse 官网技术文章 |
| 分辨率与帧率 | 720p,25–42 FPS | 未公布 |
| 参数量与端到端延迟 | 未公布 | 未公布 |
| 公开基准 | 1 个数字人基准,4 个视频编辑基准 | 无,只有内部评测 |
| 模型权重 | 未开放;提供 API | 未开放 |
在 StreamAV-Bench 上,S2 在自己的评测中(共 14 个系统)9 项指标全部排第一:音画对齐 0.353,其余系统最好成绩 0.272;音画同步误差 0.617,其余最好 0.648。也有差距只在千分位的,比如主体一致性 0.998 对 0.997。R2 公布的数字是漂移降低 35.8%,以及超过 90% 的注意力稀疏度——报告说在这个稀疏度下,四项内部质量维度保持住了,但没有给出分数。
两者没有正面对比。S2 论文对比的是上一代 PixVerse R1,而 R2 发布在它之后。
如果你用智能体做视频,这意味着什么
我们做的是一款由智能体完成工作的桌面应用,视频是大家交给它的工作之一。这两份报告里有两点可以直接带走。
第一,现场和成片之间的界线越来越清楚。实时模型面向的是持续响应的体验——数字人、游戏、边播边改的视频流;而大多数创作工作最后仍然要落成一个文件。在 Orkas 里,VideoStudio 把素材和需求变成可审阅的成片;需要生成镜头时,它用的是离线模型:Orkas 官方托管的视频生成,或者用你自己的 Key 接入 Seedance 2.0、Hailuo 2.3、Vidu Q3 Pro、Kling 3.0 Turbo、Veo 3.1 或 Runway Gen-4.5。S2 和 R2 目前都不在 Orkas 里运行。
第二,S2 的控制层本身就是一个智能体循环:写 prompt、生成、看画面、决定下一步。这和任何配合生成模型工作的智能体是同一个形状,不管模型是不是实时的——效果很大程度取决于这个循环,而不只是模型权重。
我们的收获
骨架已经定型:块因果的自回归扩散,音视频一起生成,干净历史加加噪历史,sink 加滑动窗口,DMD 系蒸馏,稀疏注意力,先低分辨率再高分辨率。S2 和 R2 的区别在于力气花在哪里——一串有针对性的修补对一个只蒸馏一次的底座,在线重放对一个失败案例库,系统工程对学出来的稀疏性。
两份资料都值得完整读一遍:Vidu S2 论文的训练和推理部署细节,以及 PixVerse R2 技术报告里关于「不重学也能扩展实时模型」的论证。