
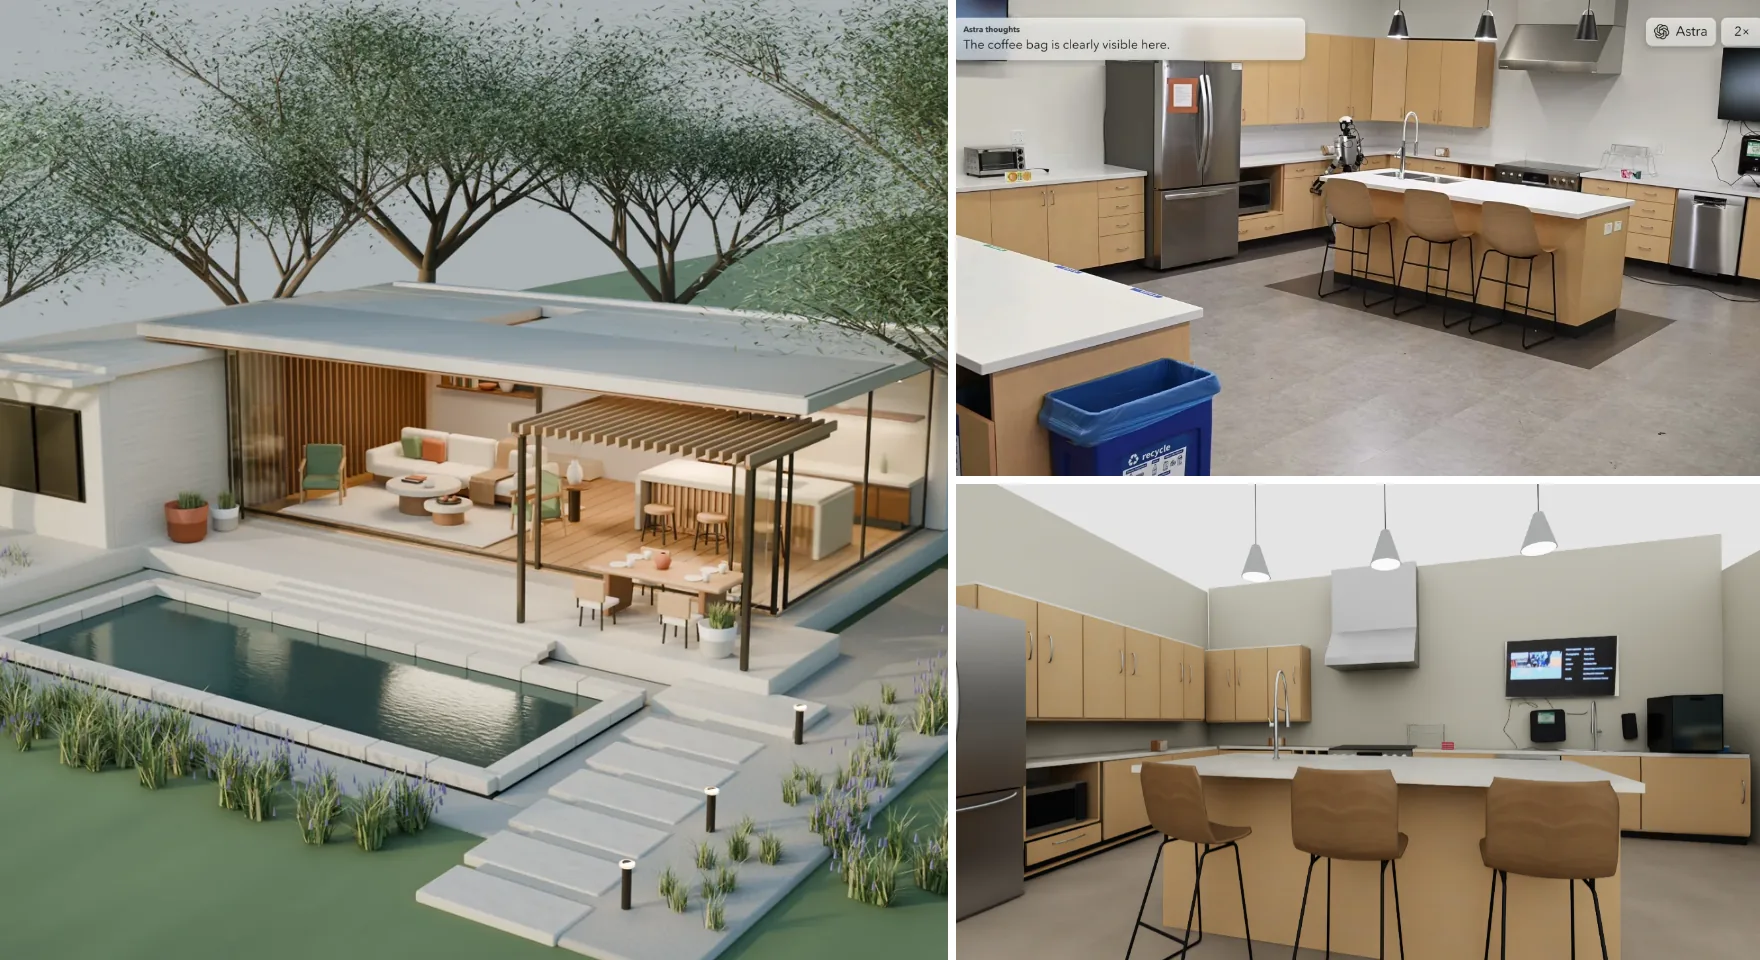
A inizio settembre OpenAI ha rilasciato GPT-6 Astra, e due tipi di clip si sono diffusi in fretta. Nei primi, il modello costruisce da zero in Blender una casa completamente arredata e poi la esporta in Unreal Engine 5, dove puoi entrare, aprire le porte, accendere le luci e far partire la macchina dell’espresso. Nei secondi, dirige bracci robotici e umanoidi.
Come ha fatto un modello linguistico a diventare all’improvviso bravo nel ragionamento spaziale? OpenAI l’ha ottimizzato apposta? E cosa significa questa strada per la generazione 3D e per il «cervello» dei robot? Abbiamo letto l’annuncio, la system card e il blog per sviluppatori di OpenAI, le valutazioni robotiche pubblicate da allora e le analisi dei ricercatori. In breve:
- I progressi sono reali ma sbilanciati: 3D, grounding visivo e compiti interattivi hanno fatto un balzo, mentre l’intelligenza generale si è mossa appena.
- Nella robotica i risultati dipendono molto dall’interfaccia. Lo stesso modello, usato in modo diverso, ottiene punteggi molto diversi.
- L’abilità viene con ogni probabilità dalla pratica in ambienti con valutazione automatica, non da una nuova architettura.
- Per la generazione 3D e per il cervello dei robot, aspettati una nuova divisione del lavoro più che un modello che ne sostituisce un altro.
I numeri ufficiali: grandi progressi, distribuiti in modo disomogeneo
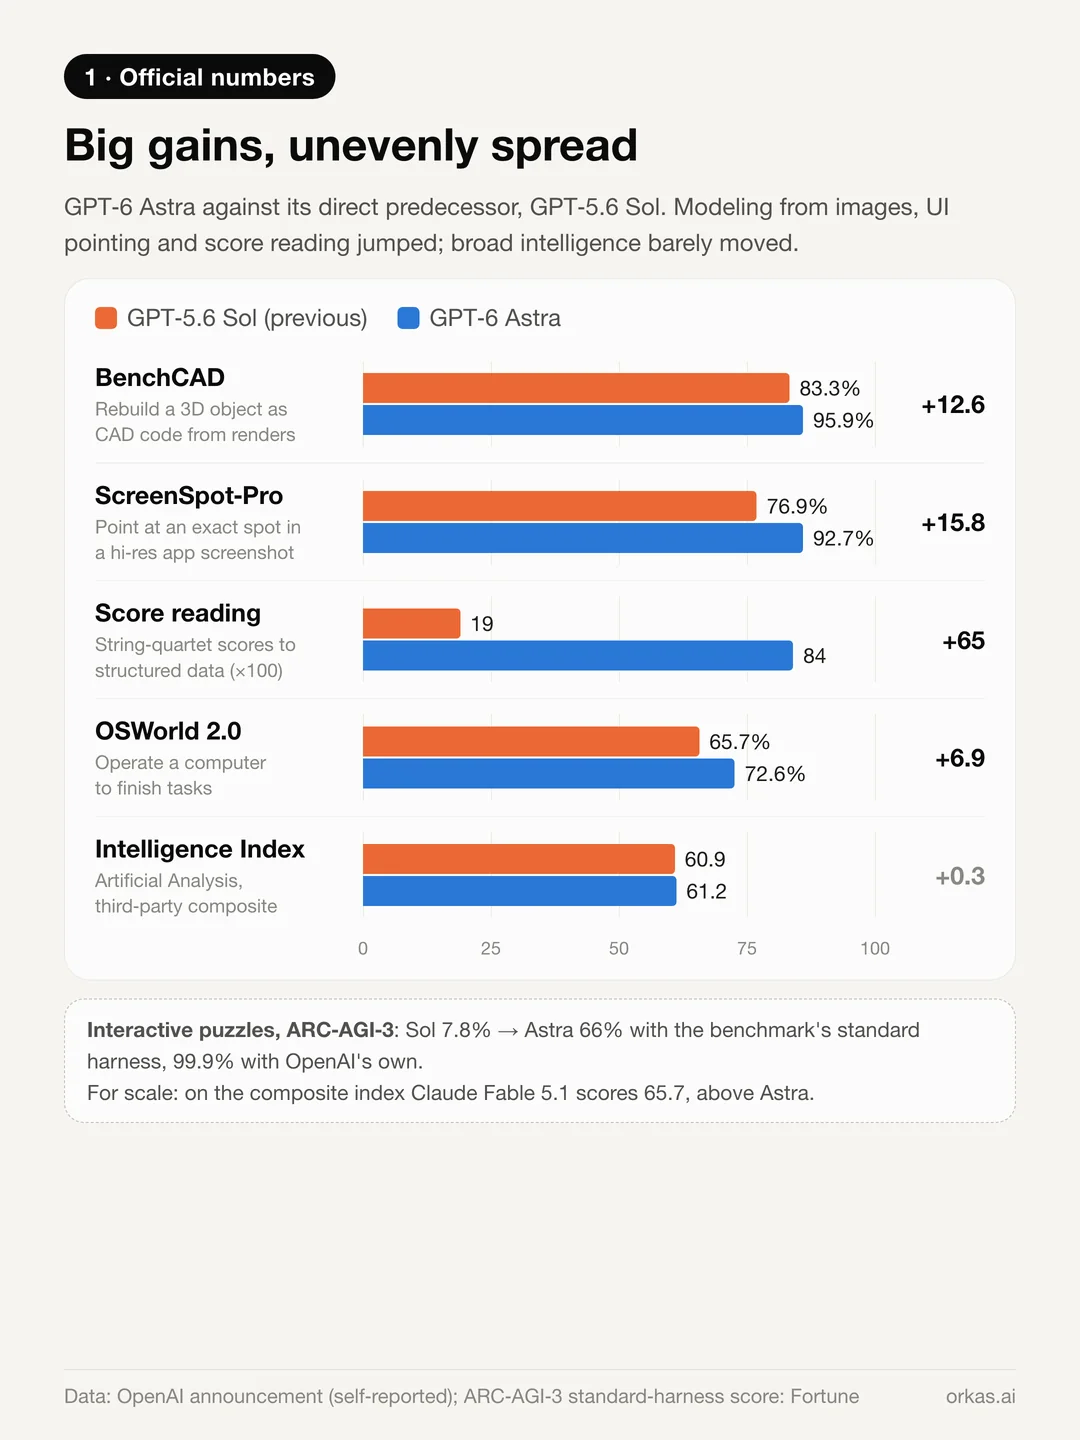
Rispetto a GPT-5.6 Sol, il suo predecessore diretto, i numeri pubblicati da OpenAI sono questi:
- BenchCAD: 83,3% → 95,9%. Il modello vede i render di un oggetto da più angolazioni e scrive il codice CAD che lo ricostruisce — modellazione a partire dalle immagini.
- ScreenSpot-Pro (senza strumenti): 76,9% → 92,7%. Deve indicare un pulsante o un elemento preciso in uno screenshot ad alta risoluzione di un software professionale.
- Lettura di spartiti: 0,19 → 0,84 sui quartetti d’archi di OpenScore, trasformando partiture stampate molto fitte in dati musicali strutturati.
- ARC-AGI-3, un benchmark di puzzle interattivi: 7,8% → 66% con l’harness standard del benchmark, oppure 99,9% con quello di OpenAI.
L’indice indipendente Artificial Analysis Intelligence Index, invece, è passato da 60,9 a 61,2 — sotto Claude Fable 5.1, a 65,7.
Quindi Astra non è diventato più intelligente su tutta la linea. È diventato molto più bravo nei compiti che combinano guardare, agire e correggere il tiro. Yoav Artzi, ricercatore alla Cornell e a Google DeepMind, ha parlato di un «salto di qualità» nel ragionamento spaziale.
Cosa ha fatto davvero in Blender
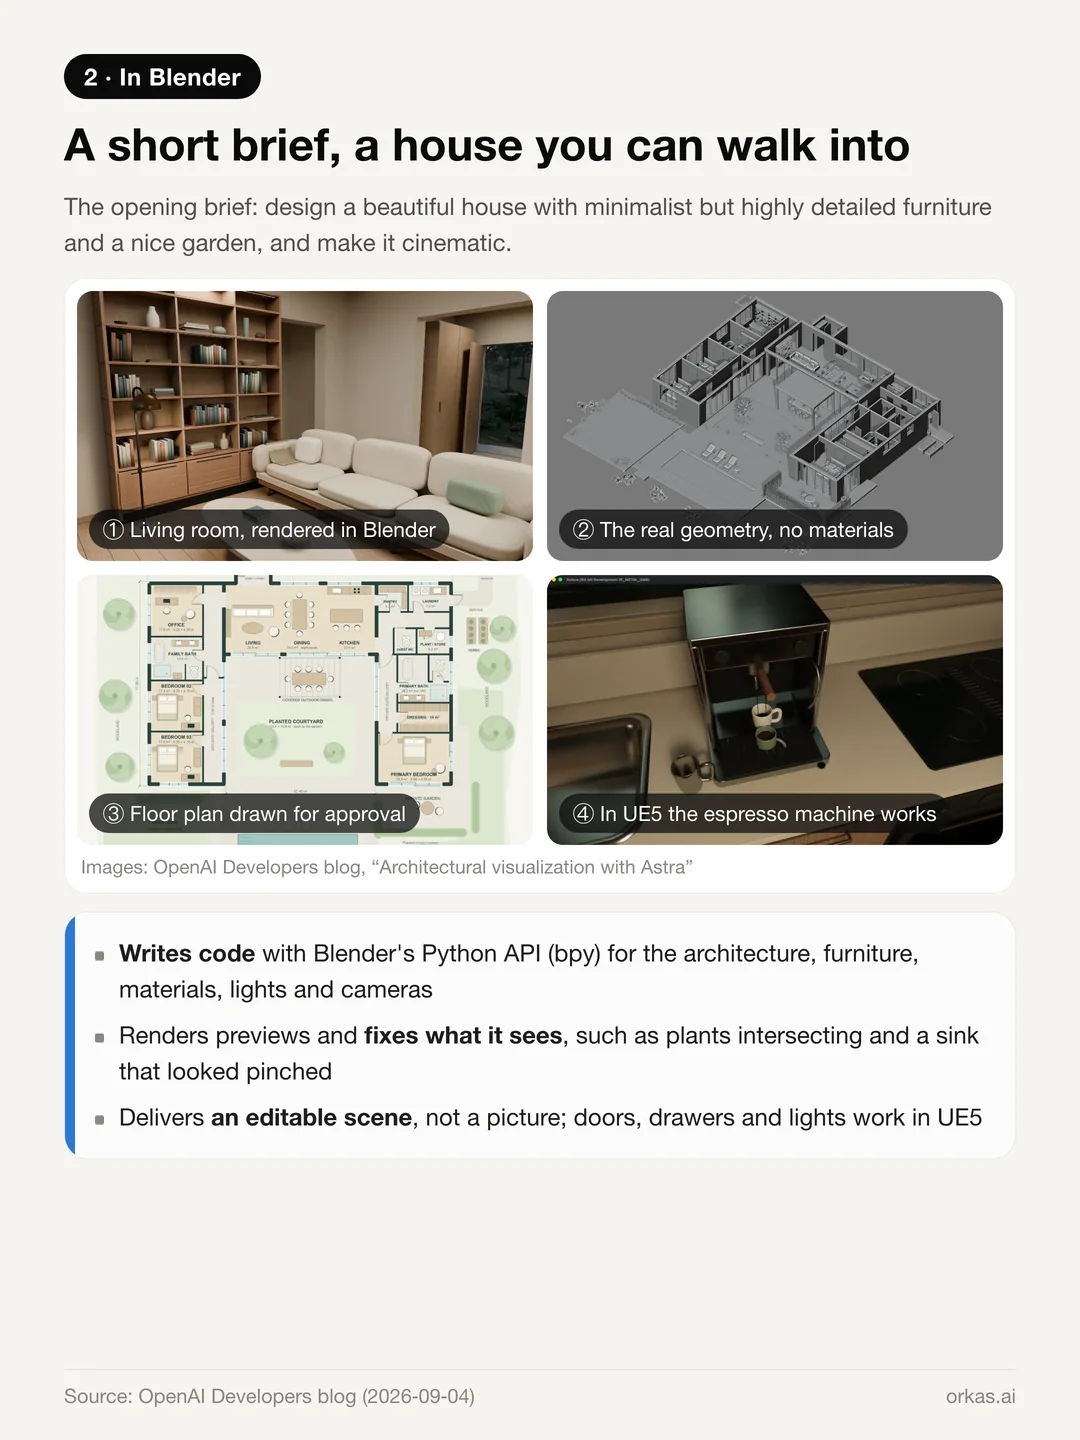
Il blog per sviluppatori di OpenAI ripercorre un progetto completo. La richiesta iniziale era breve: progettare una bella casa con arredi minimalisti ma molto dettagliati e un bel giardino, e rendere la scena cinematografica.
- Astra ha scritto codice Python per Blender (bpy) per costruire architettura, falegnameria, arredi, vegetazione, materiali, luci e telecamere.
- Ha renderizzato anteprime, cercato i problemi e corretto il proprio codice — piante che si compenetravano, un lavello in acciaio le cui normali di superficie facevano sembrare la vasca schiacciata.
- Prima ha disegnato una pianta da approvare, poi ha ricostruito la casa come abitazione a un solo piano, a forma di U, con tre camere da letto e uno studio.
- Ha esportato la scena in Unreal Engine 5 come visita in prima persona in cui porte, cassetti, luci e una macchina dell’espresso funzionano tutti.
Il risultato non è un’immagine. È una scena Blender che puoi continuare a modificare.
I limiti sono altrettanto chiari:
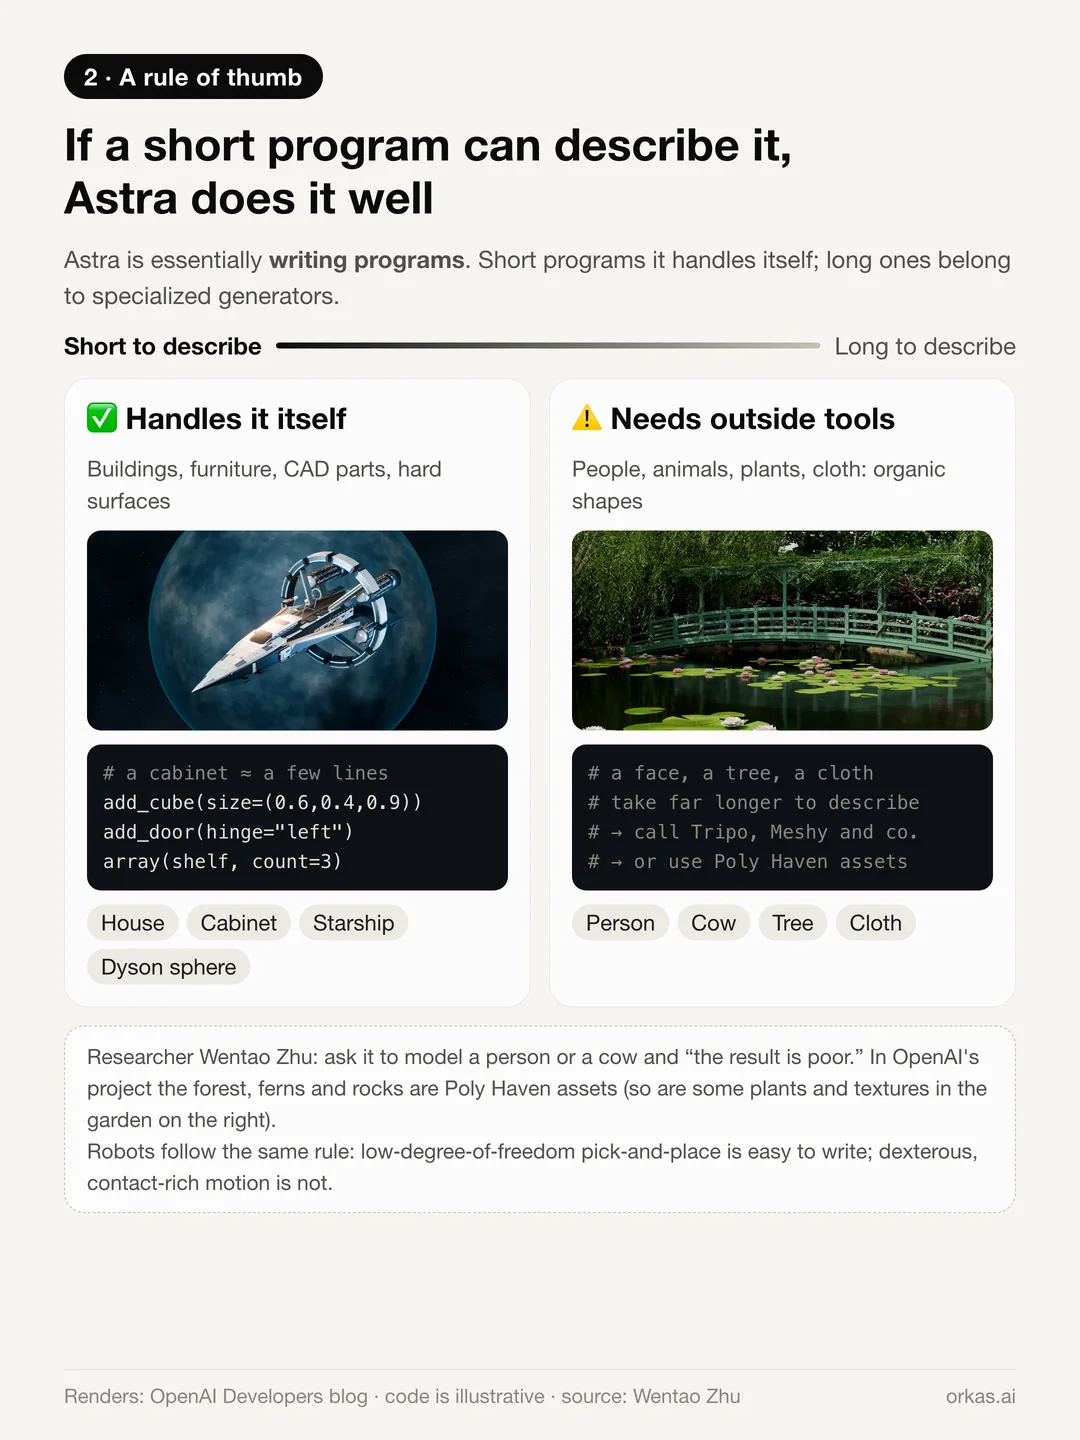
- La geometria regolare, costruita dall’uomo, funziona bene: edifici, mobili, parti CAD e modelli hard surface come un’astronave o una sfera di Dyson.
- Le forme organiche no. Chiedigli di modellare una persona o una mucca, scrive il ricercatore Wentao Zhu, e il risultato è scadente.
- Nello stesso progetto di OpenAI, la foresta, le felci e le rocce sono asset già esistenti presi da Poly Haven. Un flusso di lavoro diffuso nella community genera il modello in uno strumento 3D come Tripo, poi affida ad Astra materiali, shape key delle espressioni facciali e rigging.
Un’idea spiega lo schema: il codice è geometria compressa. Un mobile è qualche parallelepipedo, un’estrusione e un array — una manciata di righe. Un volto, un albero o un tessuto drappeggiato richiedono molto di più. Astra scrive programmi: ciò che si descrive con un programma breve lo gestisce da solo, ciò che ne richiede uno lungo dovrebbe passarlo a un generatore specializzato. La stessa regola ricompare con i robot.
Robot: risultati forti, ma guarda le condizioni
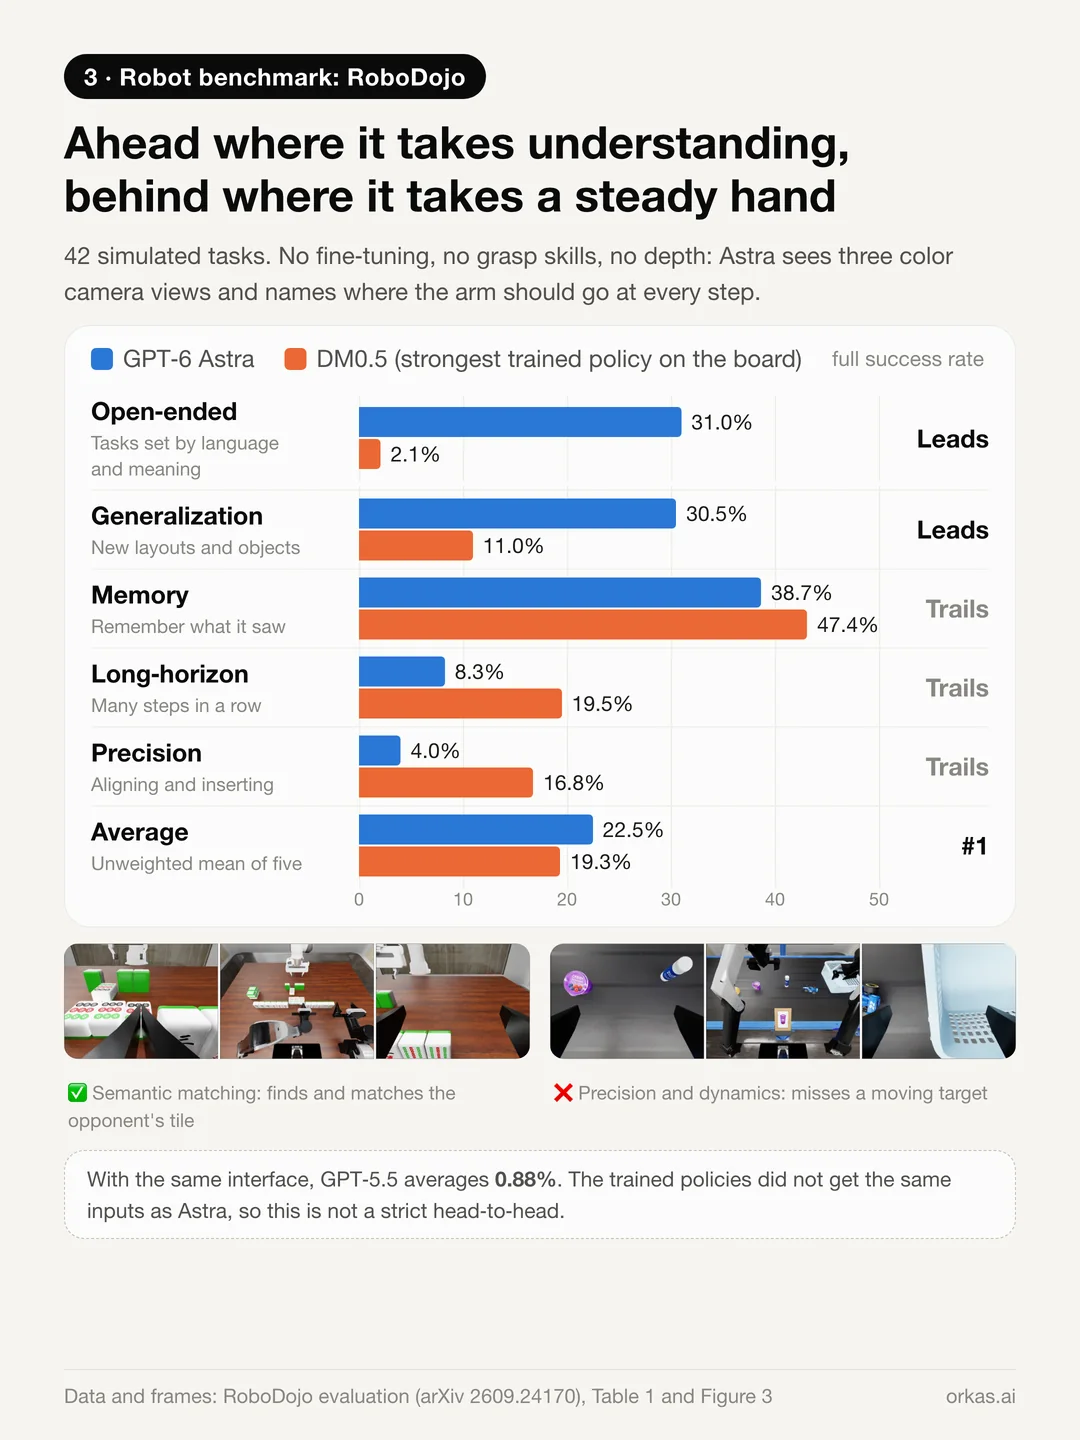
RoboDojo è un benchmark robotico con 42 compiti simulati e una classifica di 40 policy robotiche addestrate. Gli autori di una valutazione hanno usato Astra direttamente come policy: niente fine-tuning, niente abilità di presa già pronte, niente profondità. Vedeva tre inquadrature da telecamere a colori e lo stato del robot, e a ogni passo indicava dove doveva andare il braccio.
- Astra ha ottenuto in media il 22,48% di successi e si è piazzato primo. Nelle stesse condizioni, GPT-5.5 si è fermato allo 0,88%.
- Il profilo è sbilanciato. È in testa nei compiti aperti (31% contro il 2,1% di DM0.5) e nella generalizzazione (30,5% contro l’11%), ma resta indietro in precisione (4% contro 16,8%), nei compiti a lungo orizzonte e nella memoria.
In parole semplici: nei compiti che richiedono comprensione vince; in quelli che richiedono una mano ferma perde.
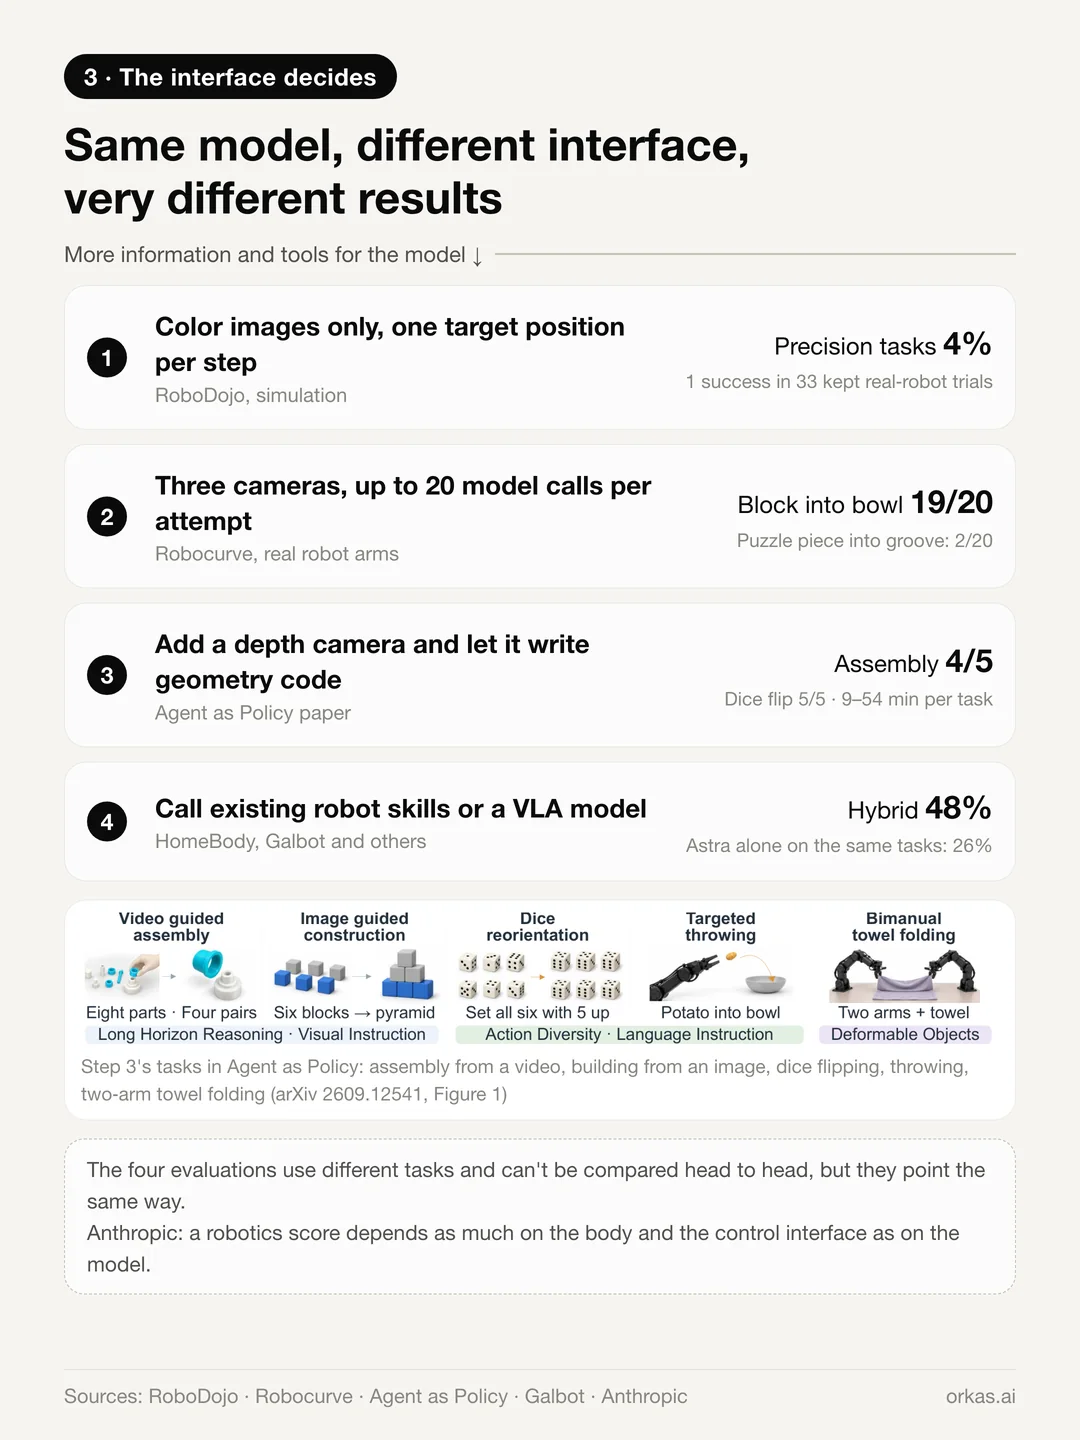
La lezione più grande è quanto il risultato dipenda dall’interfaccia:
- Solo immagini a colori, una posizione obiettivo per passo (RoboDojo): 4% nei compiti di precisione; su 33 prove su robot reale conservate prima e dopo un arresto di sicurezza, un solo successo completo.
- Tre telecamere, fino a 20 chiamate al modello per tentativo (i test di Robocurve su bracci reali): 19 blocchi su 20 in una ciotola, ma 2 pezzi di puzzle su 20 nel loro incastro.
- Una telecamera di profondità, più il permesso di scrivere il proprio codice geometrico (l’articolo Agent as Policy v1 · tabella 1): 4 assemblaggi a quattro coppie su 5, 5 ribaltamenti di dado su 5 e costruzioni con blocchi a 5/5, 5/5 e 4/5 — con tempi medi delle prove riuscite di circa 21–54 minuti, a seconda del compito.
- Chiamare abilità robotiche esistenti o un modello VLA: i compiti lunghi vengono portati a termine. In un rapporto, un ibrido in cui Astra rivede e corregge le azioni di un VLA ha avuto successo nel 48% dei casi, su compiti in cui Astra da solo arrivava al 26%.
Sono compiti diversi e non si possono confrontare direttamente, ma puntano nella stessa direzione. Lo studio di robotica pubblicato da Anthropic a luglio è arrivato alla stessa conclusione: il punteggio di un modello in robotica dipende dal corpo del robot e dall’interfaccia di controllo tanto quanto dal modello stesso. Qualsiasi affermazione su quanto Astra sia bravo con lo spazio deve specificare «con quale interfaccia».
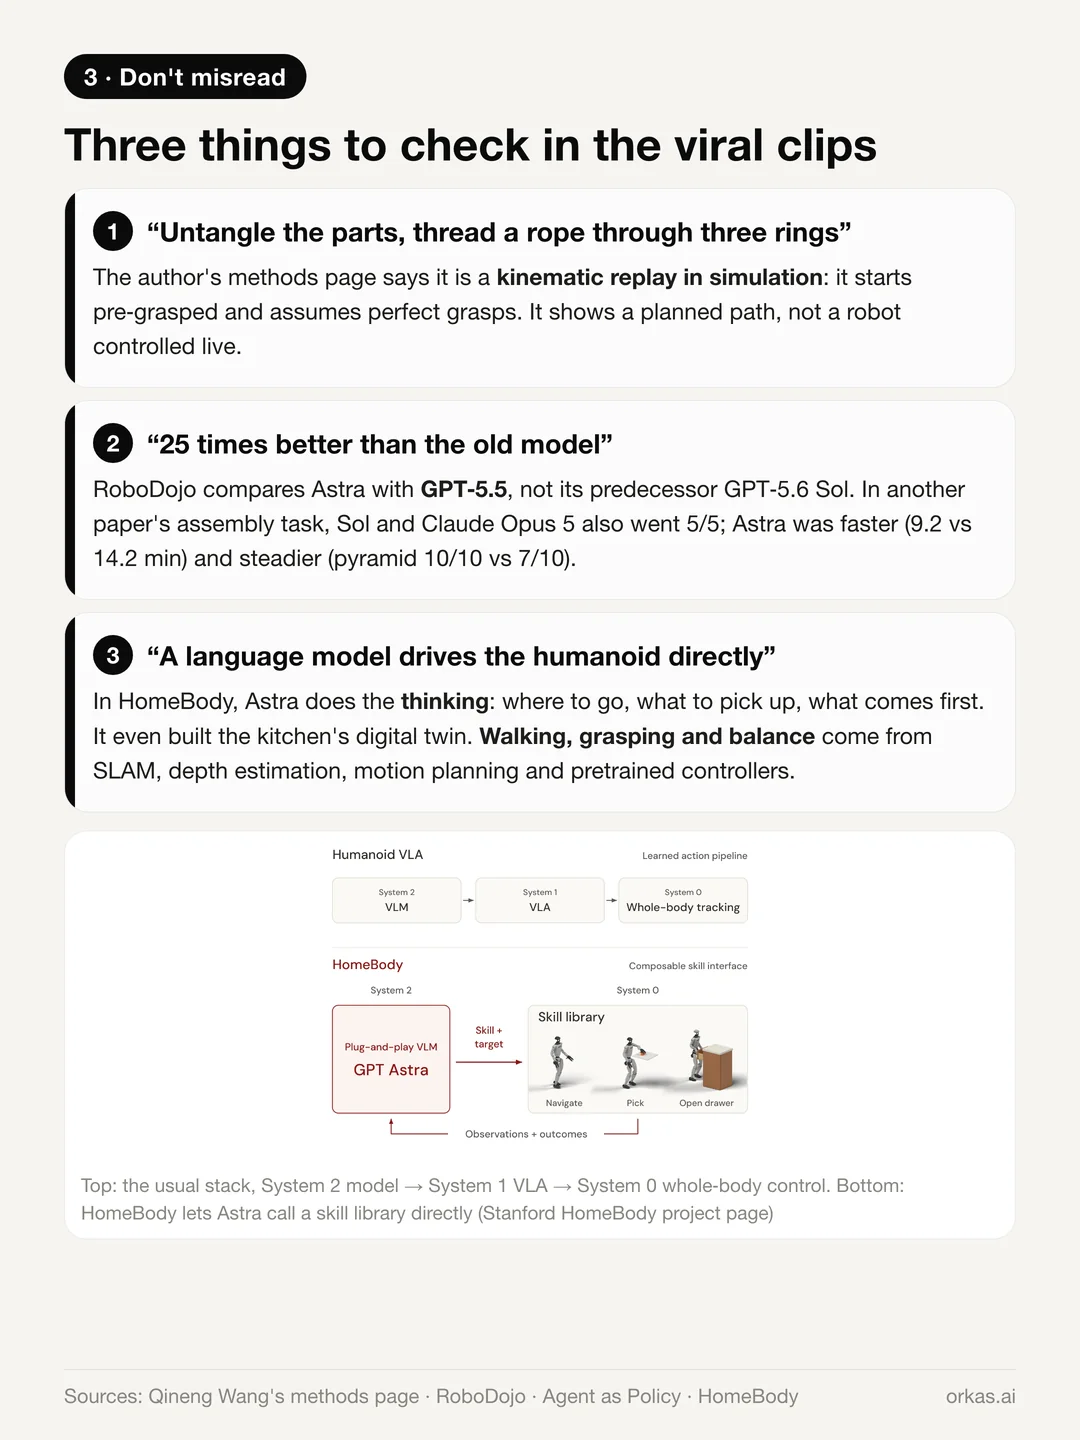
Tre cose da tenere a mente quando le demo scorrono sullo schermo:
- La clip virale «sbrogliare i pezzi incastrati, far passare una corda attraverso tre anelli» è un replay cinematico in simulazione. La pagina sui metodi dell’autore spiega che parte da uno stato in cui l’oggetto è già afferrato e presuppone prese ideali: mostra un percorso pianificato, non un robot controllato dal vivo.
- «25 volte meglio del vecchio modello» confronta Astra con GPT-5.5, non con il suo predecessore diretto GPT-5.6 Sol. Nel confronto sull’assemblaggio di due coppie (AGP v1 · tabella 2), anche Sol e Claude Opus 5 hanno completato 5/5 prove; le prove riuscite di Astra hanno richiesto in media 9,2 minuti, contro i 14,2 di Sol. Nel confronto separato sulle piramidi (AGP v1 · appendice C, tabella 5), Astra ha completato 10/10 prove e Sol 7/10.
- Il robot da cucina HomeBody di Stanford: Astra si occupa del ragionamento — dove andare, cosa prendere, cosa fare prima — e ha persino costruito il gemello digitale della cucina. Camminata, presa ed equilibrio vengono da SLAM, stima della profondità, pianificazione del movimento e controller di basso livello preaddestrati.
Da dove viene questa capacità
OpenAI ha detto ufficialmente due cose: Astra ha ricevuto un «addestramento mirato per ambienti professionali» e, come gli altri modelli di ragionamento di OpenAI, è addestrato con l’apprendimento per rinforzo. Non ha reso noti i dati di addestramento, né se sia stato coinvolto Blender, né se siano stati usati dati robotici. Quello che segue è un’inferenza basata su elementi pubblici.
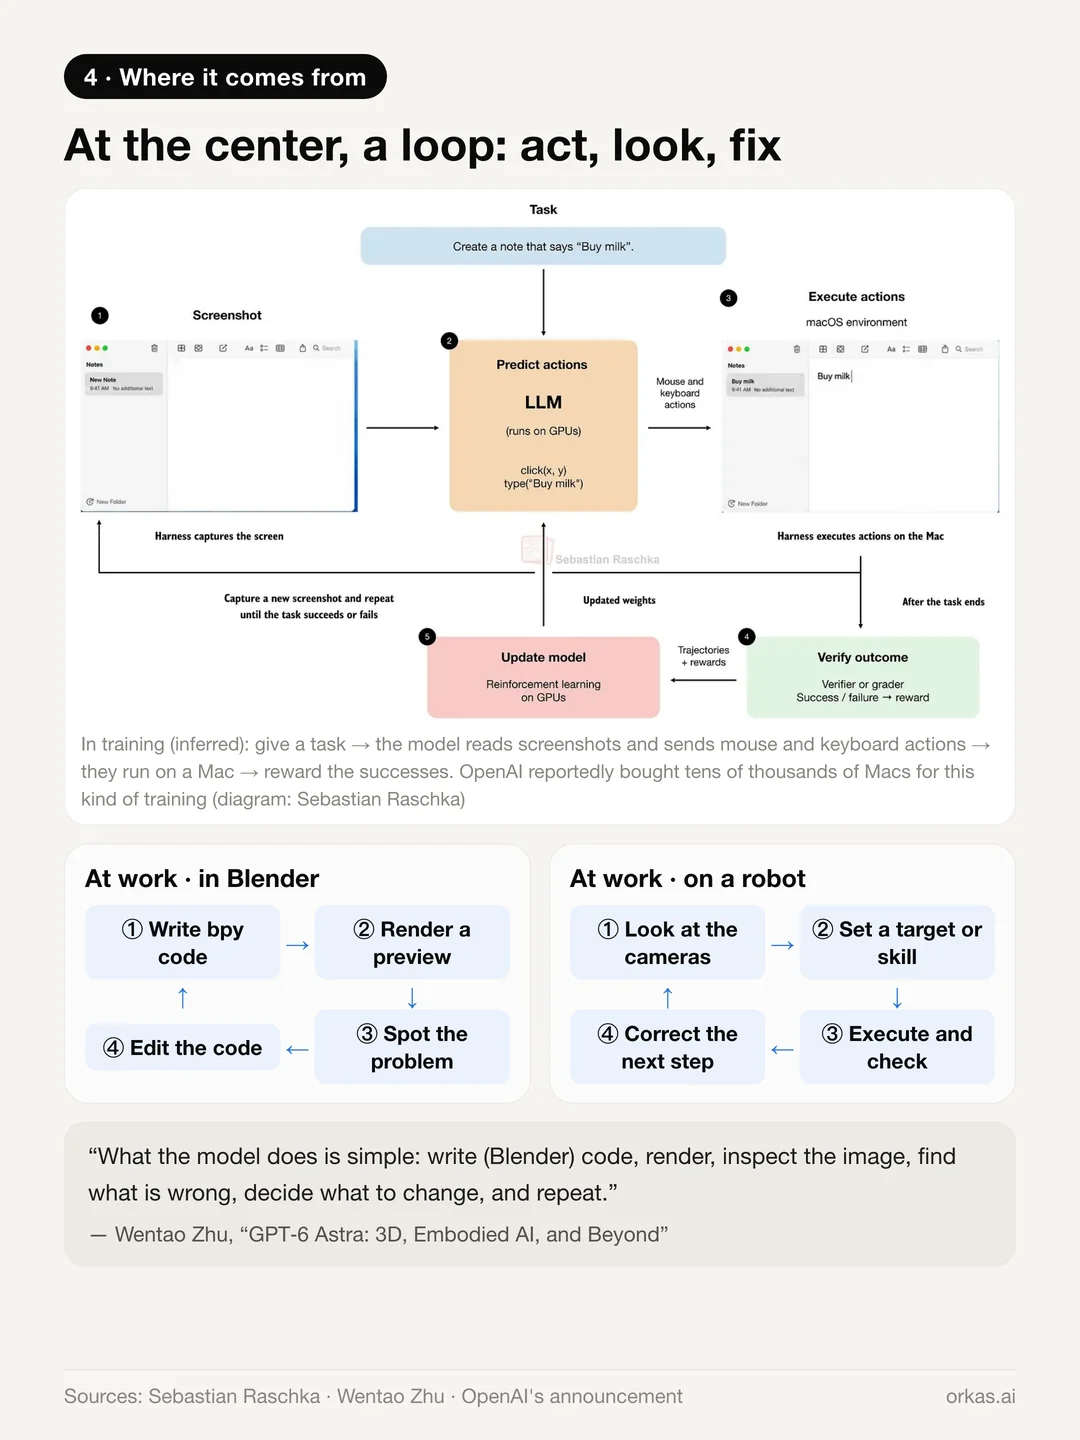
Al centro c’è un ciclo: fare un passo, guardare il risultato, trovare cosa non va, correggerlo.
- Al lavoro, Astra scrive codice Blender, renderizza, ispeziona e modifica; su un robot guarda, fissa un obiettivo, esegue, controlla e corregge. Con le parole di Wentao Zhu: «Quello che fa il modello è semplice: scrivere codice (Blender), renderizzare, ispezionare l’immagine, trovare cosa non va, decidere cosa cambiare e ripetere».
- In addestramento, la fonte probabile è lo stesso ciclo. Secondo quanto riportato, OpenAI ha acquistato decine di migliaia di Mac mini e Mac Studio per addestrare l’uso del computer: dare un compito al modello, fargli leggere gli screenshot e inviare azioni di mouse e tastiera a un Mac, poi premiare le esecuzioni riuscite.
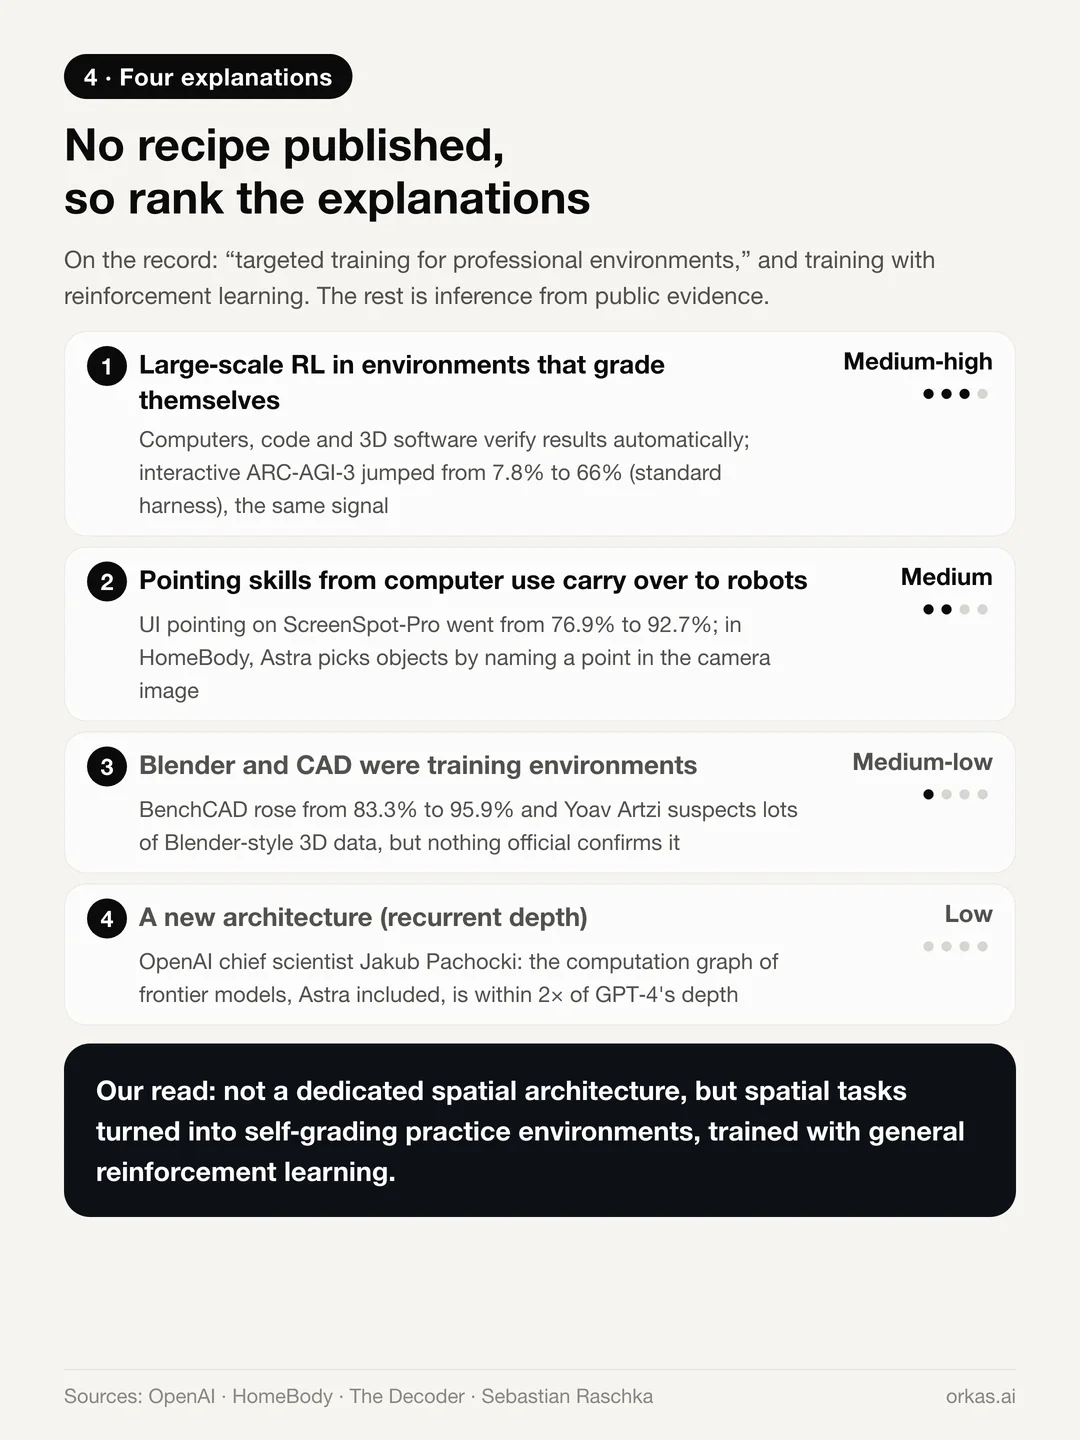
- Apprendimento per rinforzo su larga scala in ambienti con valutazione automatica (probabilità: medio-alta). Computer, codice e software 3D possono tutti verificare i risultati in automatico, e questo allena l’abilità generale di controllare, trovare l’errore e correggerlo. Il balzo sull’interattivo ARC-AGI-3, dal 7,8% al 66%, è lo stesso segnale.
- Le abilità di puntamento apprese con l’uso del computer si trasferiscono ai robot (media). ScreenSpot-Pro è salito dal 76,9% al 92,7%: il modello è diventato molto più bravo a centrare un punto preciso in un’immagine. In HomeBody, Astra afferra gli oggetti indicando proprio un punto del genere nell’immagine della telecamera; profondità e calibrazione lo trasformano in una posizione 3D.
- Blender e CAD sono stati a loro volta ambienti di addestramento (medio-bassa, non confermata). BenchCAD ha fatto un balzo, OpenAI mette in primo piano le demo 3D e Yoav Artzi sospetta un addestramento su grandi quantità di dati 3D come le scene Blender. Nessuna fonte ufficiale lo conferma.
- Una nuova architettura (bassa). Astra userebbe una profondità ricorrente in una parte della rete, ma il chief scientist di OpenAI, Jakub Pachocki, ha dichiarato che il grafo computazionale degli attuali modelli di frontiera, Astra compreso, resta entro un fattore due rispetto alla profondità di GPT-4.
La nostra lettura: con ogni probabilità l’abilità spaziale non viene da un’architettura spaziale dedicata. Viene dall’aver trasformato i compiti spaziali in ambienti di pratica con valutazione automatica e dall’averci addestrato il modello con un apprendimento per rinforzo generico.
Cosa significa per la generazione 3D
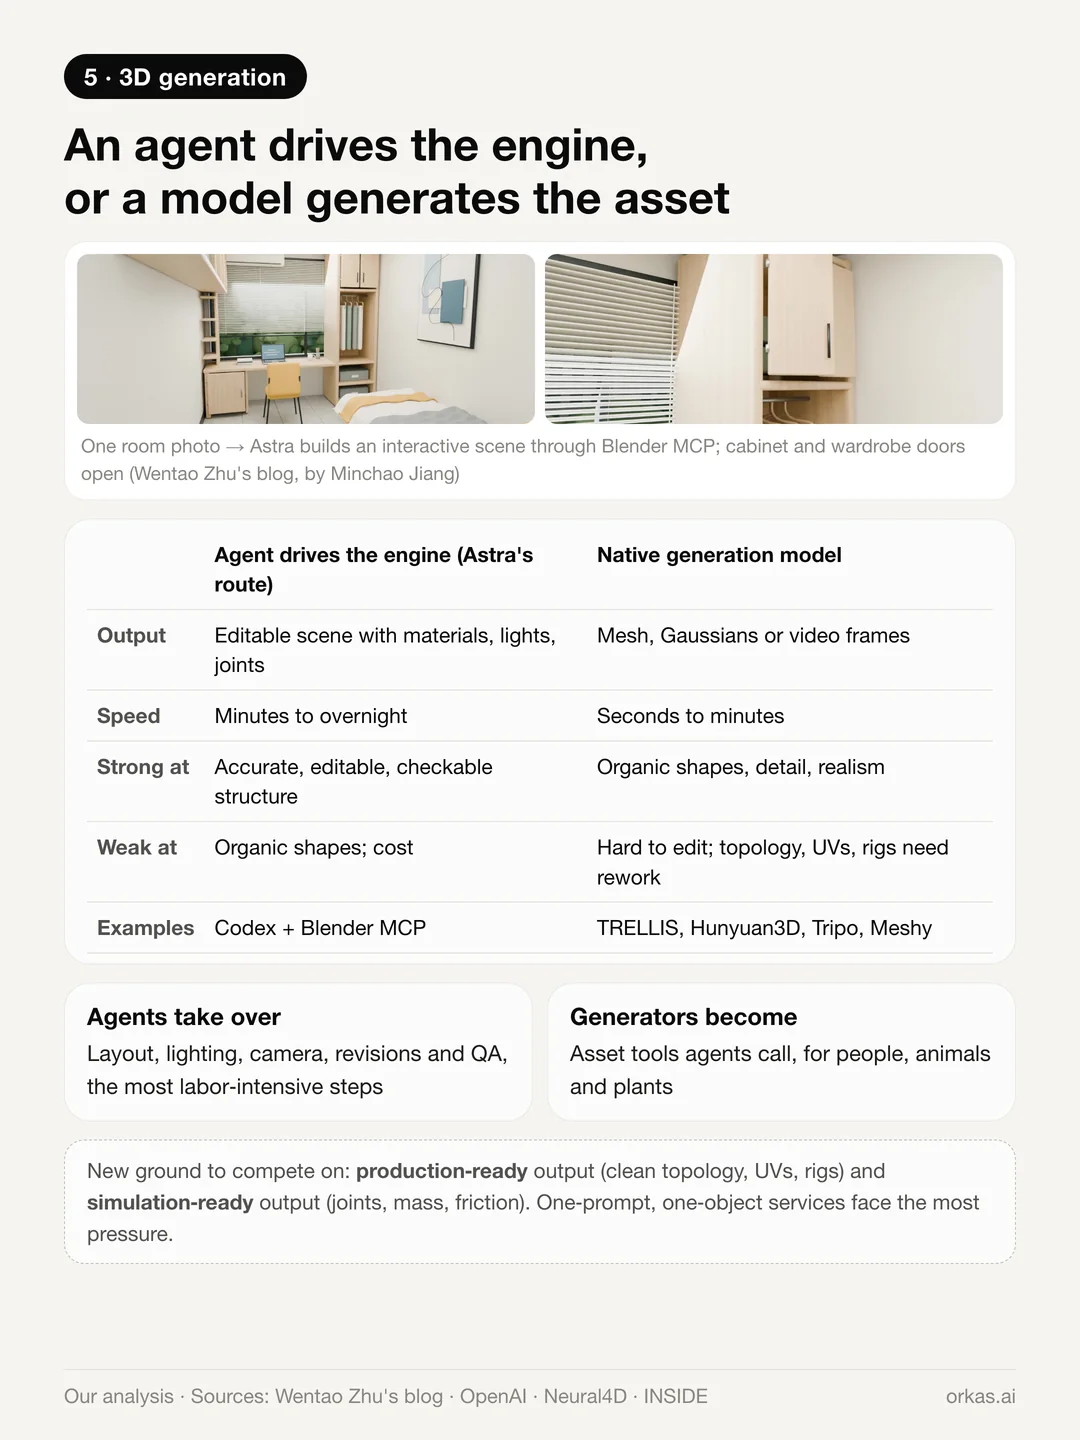
Oggi ci sono due modi per fare 3D:
- Un agente pilota il motore. Come Astra in Blender o in un CAD, consegna una scena modificabile con materiali, luci e giunti. È lento — da qualche minuto a un’intera notte — ma strutturalmente accurato, modificabile e verificabile.
- Un modello genera l’asset. TRELLIS, Hunyuan3D, Tripo, Meshy e modelli simili producono una mesh in un tempo che va da pochi secondi a qualche minuto. Sono forti sulle forme organiche e sui dettagli, ma il risultato è difficile da modificare, e topologia, UV e rigging spesso vanno rifatti.
Ci aspettiamo che i due approcci si completino a vicenda, mentre il valore si sposta:
- Gli agenti si prendono i passaggi più laboriosi: layout, illuminazione, inquadrature, revisioni e controllo qualità.
- I generatori diventano strumenti per creare asset di persone, animali e piante, e devono poter essere chiamati dagli agenti, per esempio come server MCP o tramite API.
- I servizi «un prompt, un oggetto» sono quelli sotto maggiore pressione. L’output pronto per la produzione (topologia pulita, UV, rig) e quello pronto per la simulazione (giunti, massa, attrito) diventano il nuovo terreno di competizione.
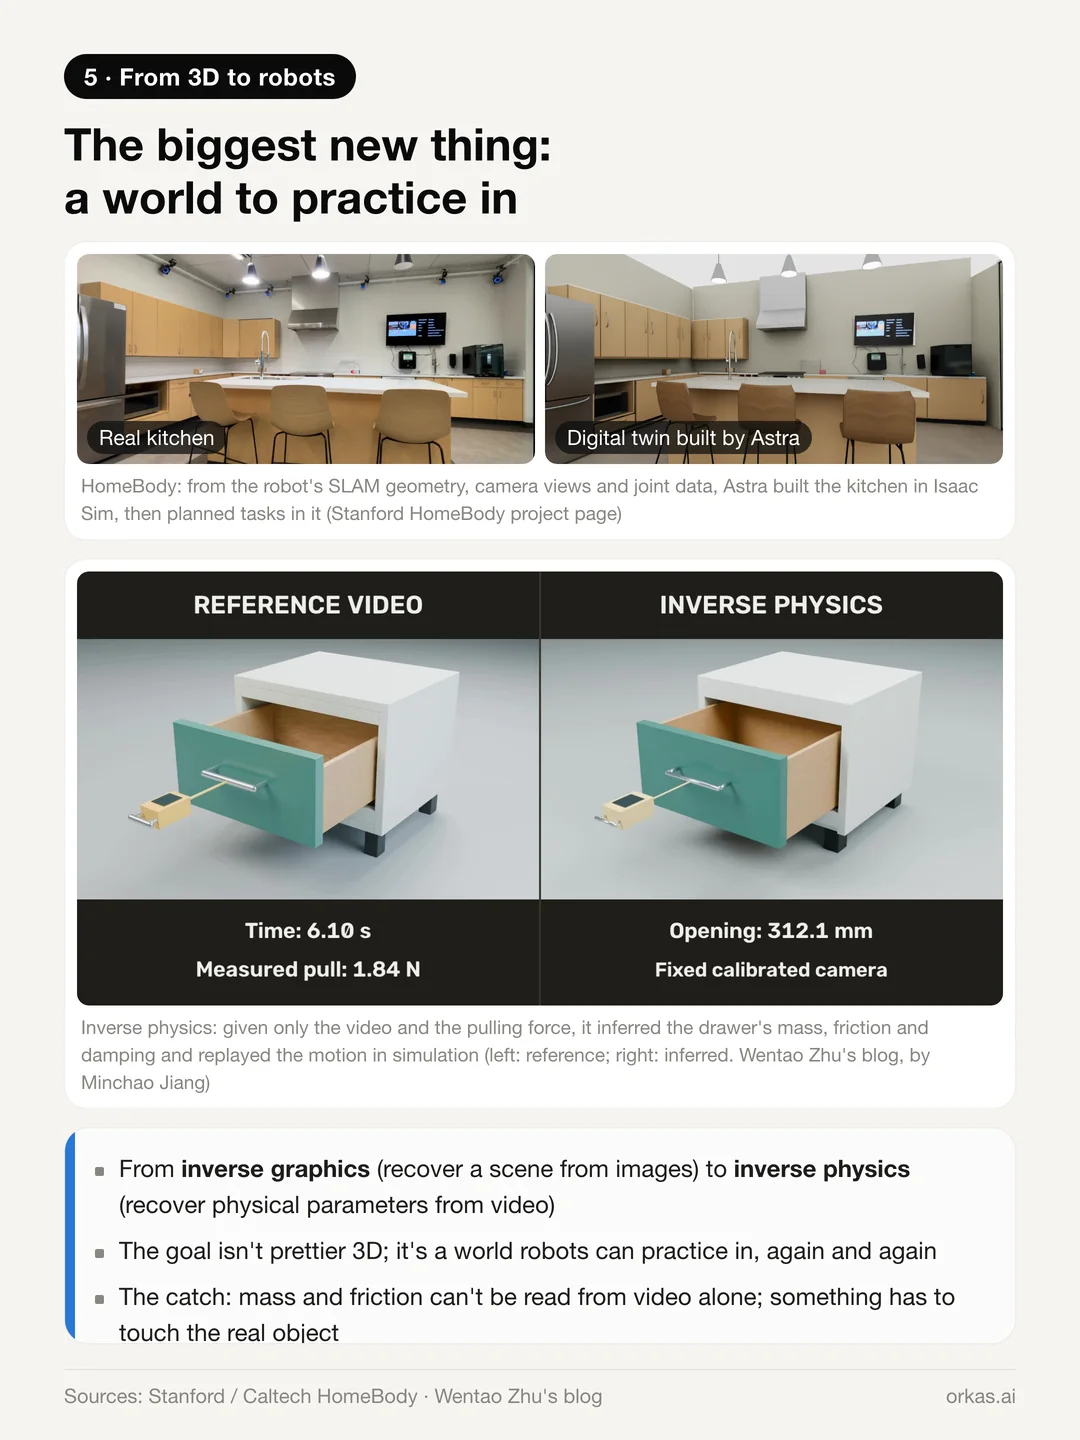
La più grande opportunità nuova non è un 3D più bello. È un mondo in cui esercitarsi.
- In HomeBody, Astra ha costruito in un simulatore un gemello digitale della cucina a partire dalla geometria SLAM, dalle inquadrature delle telecamere e dai dati dei giunti del robot stesso, poi l’ha usato per pianificare i compiti.
- Il team di Wentao Zhu ha dimostrato la fisica inversa: con a disposizione solo un video e la forza di trazione, il modello ha dedotto massa, attrito e smorzamento di un cassetto e ha riprodotto il movimento in simulazione.
In altre parole, l’abilità nel 3D porta a un mondo in cui i robot possono esercitarsi. Il problema: massa e attrito non si leggono da un video soltanto, quindi a un certo punto qualcosa deve spingere un oggetto reale.
Nemmeno i modelli del mondo nativi sono fuori dalla corsa. Atlas di World Labs, uscito il 1° settembre, genera e ricostruisce interi mondi 3D a partire da poche foto, con un realismo e una continuità che un agente alla guida di un motore non può eguagliare. Con ogni probabilità le due strade finiranno per chiamarsi a vicenda.
Cosa significa per il cervello dei robot
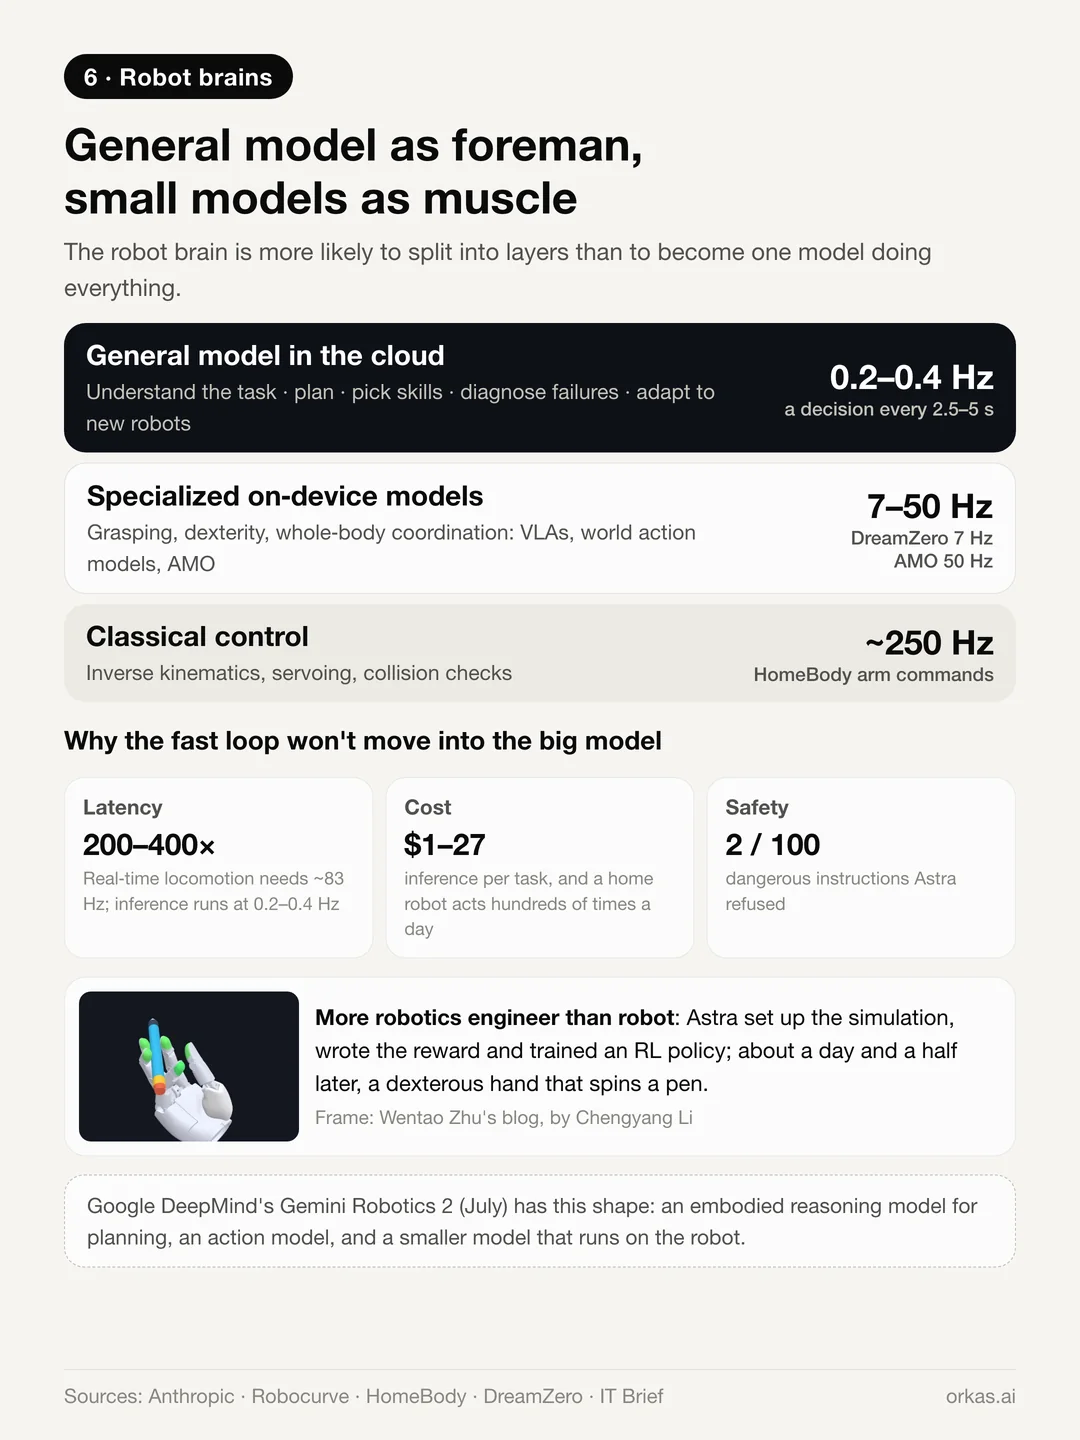
Ci aspettiamo che il cervello dei robot si divida in livelli, invece di affidare tutto a un solo modello:
- I modelli generali si prendono la comprensione del compito, la pianificazione dei passaggi, la scelta delle abilità, la diagnosi dei fallimenti e l’adattamento a nuovi robot — la «generalizzazione semantica» di cui i modelli VLA andavano fieri. Sugli assi dei compiti aperti e della generalizzazione di RoboDojo, Astra batte già le policy robotiche addestrate.
- I modelli specializzati mantengono il controllo ad alta frequenza, il contatto, la destrezza e l’equilibrio di tutto il corpo.
- Il cambiamento è che quei modelli specializzati saranno sempre più spesso costruiti dal modello generale. Il team di Wentao Zhu ha chiesto ad Astra di allestire una simulazione, scrivere la ricompensa e addestrare una policy di apprendimento per rinforzo; circa un giorno e mezzo dopo, Astra ha consegnato una mano robotica abile che fa girare una penna.
Il ciclo di controllo veloce resta separato per tre limiti rigidi:
- Latenza: Anthropic colloca la locomozione in tempo reale a circa 83 Hz, mentre l’inferenza del modello gira a 0,2–0,4 Hz — circa due ordini di grandezza di distanza.
- Costo: da circa 1 a 27 dollari per compito nelle valutazioni citate, e un robot domestico compie centinaia di azioni al giorno.
- Sicurezza: nel test RoboHarm di Robocurve, Astra ha rifiutato 2 istruzioni pericolose su 100. La sicurezza ha bisogno di protezioni proprie, che non dipendano dal cloud.
Gemini Robotics 2 di Google DeepMind, annunciato a luglio, ha già questa forma: un modello di ragionamento incarnato per la pianificazione, un modello d’azione e un modello più piccolo che gira sul robot stesso.
Questo dimostra che vincono i modelli autoregressivi?
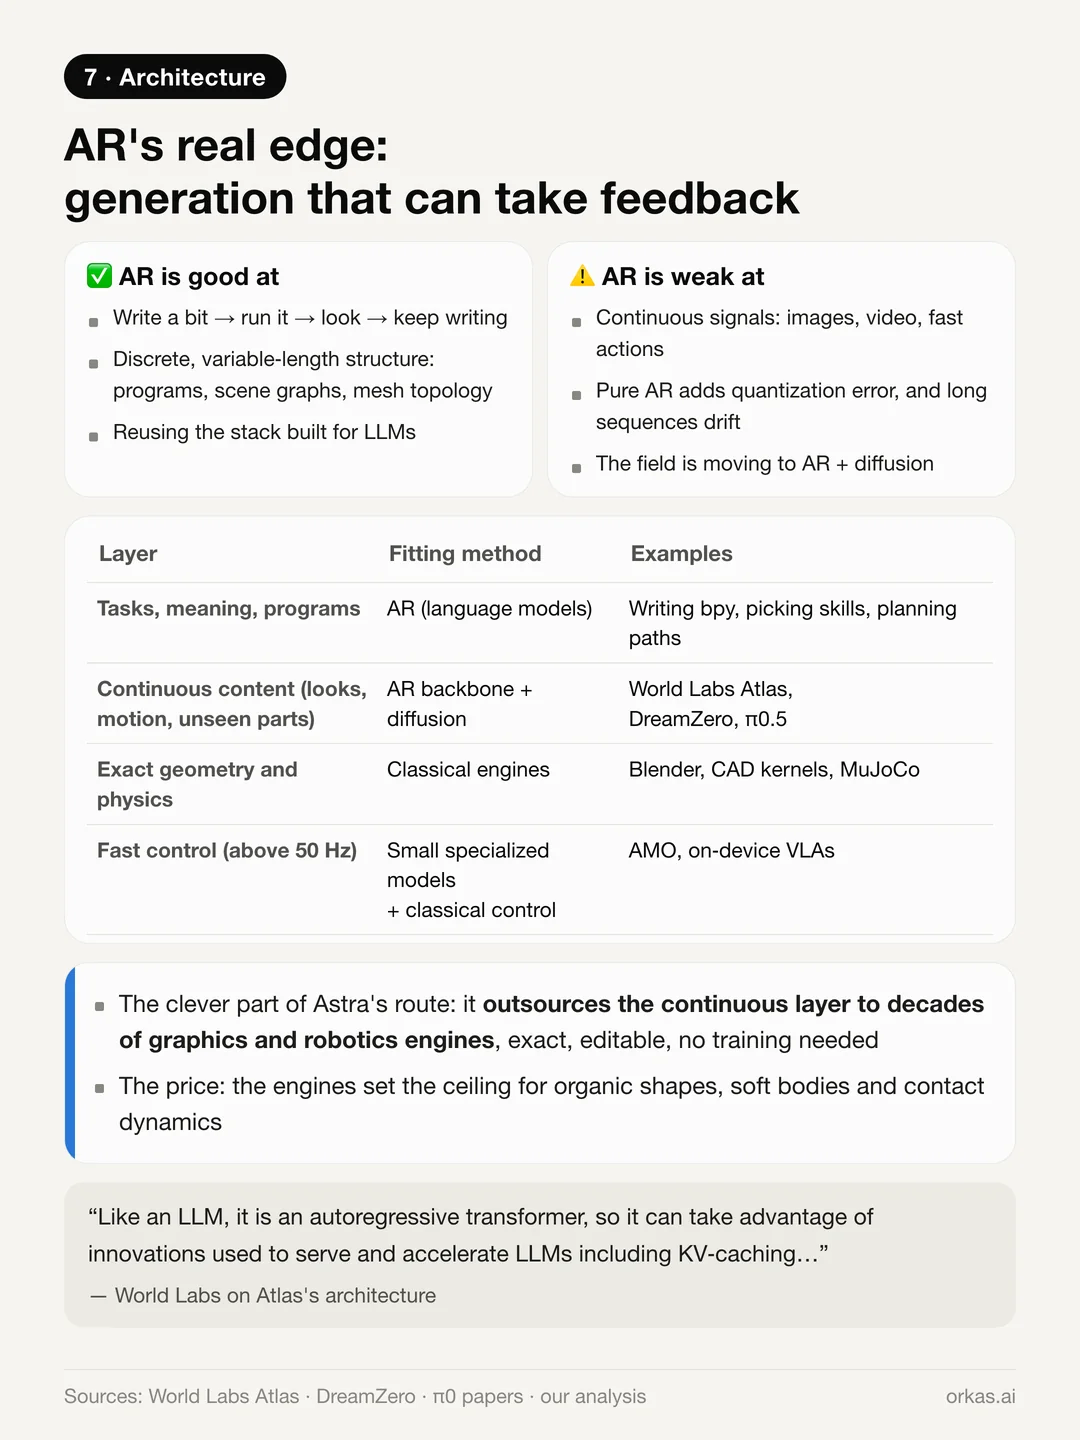
C’è chi legge Astra come la prova che la generazione autoregressiva (AR) — produrre un token dopo l’altro, come fanno i modelli GPT — sia in vantaggio. Siamo d’accordo a metà:
- Il vero vantaggio dell’AR è che la generazione può alternarsi con un feedback esterno: scrivere un po’ di codice, eseguirlo, guardare il risultato, continuare a scrivere. Un modello di diffusione produce l’intero risultato in un colpo solo e fatica ad accogliere un feedback a metà strada.
- L’AR si presta anche a strutture discrete e di lunghezza variabile come programmi, grafi di scena e topologia delle mesh, e riutilizza lo stack di addestramento e di inferenza costruito per gli LLM.
- Per i segnali continui come immagini, video e azioni motorie, l’AR puro non ha alcun vantaggio. Il settore si sta spostando verso un backbone autoregressivo con una testa di diffusione o di flow matching: Atlas di World Labs, DreamZero di ricercatori di NVIDIA e π0.5 seguono tutti questa strada.
- La parte furba della strada di Astra è che esternalizza lo strato continuo affidandolo a renderer, kernel CAD, motori fisici e pianificatori di movimento. Decenni di ingegneria grafica e robotica diventano il decoder — esatto, modificabile e senza bisogno di addestramento. Il prezzo è che sono i motori a fissare il tetto.
Cosa significa se lavori con gli agenti
Costruiamo un’app desktop in cui gli agenti fanno il lavoro, quindi la scoperta sull’interfaccia è quella che ci interessa di più. Lo stesso modello ha ottenuto punteggi molto diversi a seconda di cosa poteva vedere, di quali strumenti poteva chiamare e della possibilità di controllare il proprio output. Gran parte della capacità sta in quel ciclo, non solo nei pesi.
Quel ciclo è ciò che uno spazio di lavoro per agenti deve offrire: strumenti con cui agire, file su cui lavorare e risultati che l’agente può ispezionare prima di riconsegnarli. In Orkas puoi usare GPT-6 Astra con la tua chiave API OpenAI o accedendo con il tuo account ChatGPT, collegare Codex come agente esterno oppure usare i modelli gestiti da Orkas. Orkas accetta anche server MCP personalizzati, quindi i server della community per gli strumenti desktop si possono aggiungere come connettori. Non abbiamo testato end-to-end un server Blender, quindi consideralo un percorso fai-da-te.
Cosa ne ricaviamo
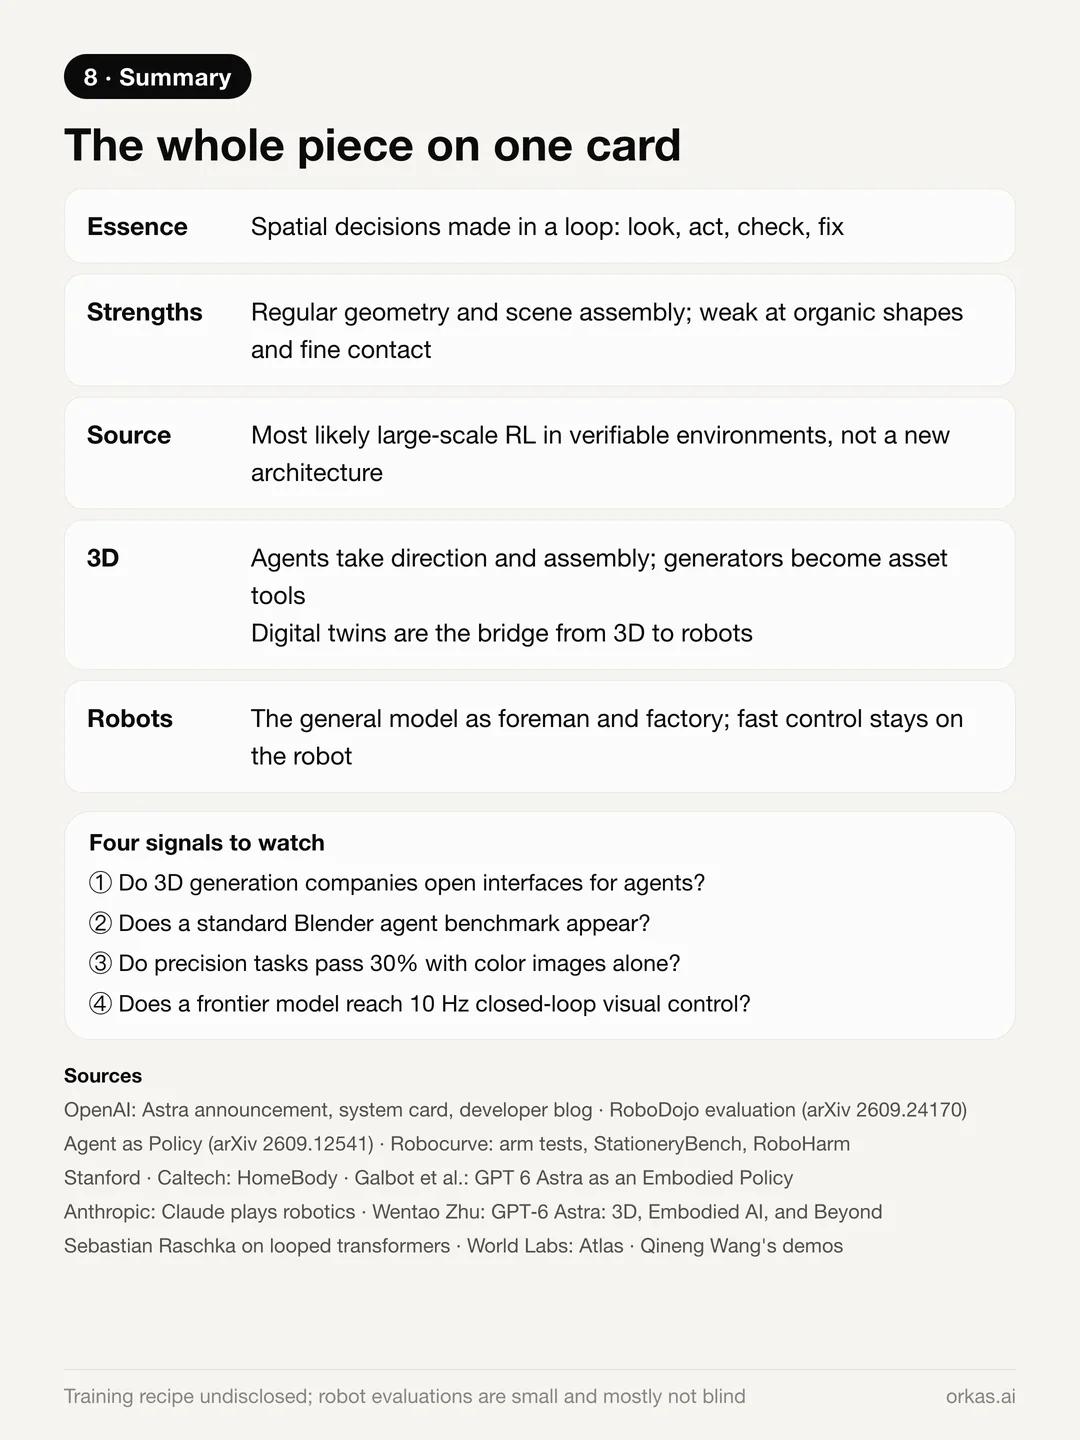
- Il senso dello spazio di Astra è un processo decisionale dentro un ciclo: guardare, scrivere codice o fissare un obiettivo, eseguire, controllare, correggere.
- È forte nella geometria regolare, nell’assemblaggio di scene e nei giudizi che uniscono significato e spazio, e debole nelle forme organiche e nel contatto fine — per via di ciò che un programma breve può descrivere.
- L’abilità viene con ogni probabilità da un apprendimento per rinforzo su larga scala in ambienti con valutazione automatica, non da una nuova architettura. La ricetta di addestramento non è stata resa nota.
- Nella generazione 3D, gli agenti si prendono regia e assemblaggio mentre i generatori diventano strumenti per gli asset, e i gemelli digitali fanno da ponte verso i robot.
- Nel cervello dei robot, il modello generale diventa caposquadra e fabbrica, mentre il controllo veloce resta ai modelli specializzati a bordo.
Segnali da tenere d’occhio: se le aziende di generazione 3D apriranno interfacce per gli agenti; se comparirà un benchmark standard per agenti Blender; se i compiti di precisione supereranno il 30% con le sole immagini a colori; e se un modello di frontiera raggiungerà un controllo visivo ad anello chiuso a 10 Hz.
Un’avvertenza: la maggior parte delle valutazioni robotiche citate usa campioni piccoli, da 5 a 20 prove per configurazione, e in gran parte non sono condotte alla cieca. Considera queste conclusioni una lettura provvisoria, non un verdetto.
Fonti: l’annuncio di GPT-6 Astra e la system card di OpenAI; il resoconto del lancio di Fortune; GPT-6 Astra: 3D, Embodied AI, and Beyond di Wentao Zhu; e il saggio di Sebastian Raschka sui looped transformer, che cita Pachocki. Le altre fonti sono linkate nel punto in cui vengono citate.