
Orkas 想成为 AI Native 公司的底座。在这个目标下,有一个绕不开的问题:多个人和多个智能体在同一个项目上,怎么协作。
这件事和我们熟悉的团队协作很不一样。要讲清楚,得先回头看看人和人之间的协作是怎么来的。(共享项目在产品里具体怎么用,《共享项目:人和 AI 智能体怎样在 Orkas 里一起干活》里有完整的流程。这篇只讲背后的想法。)
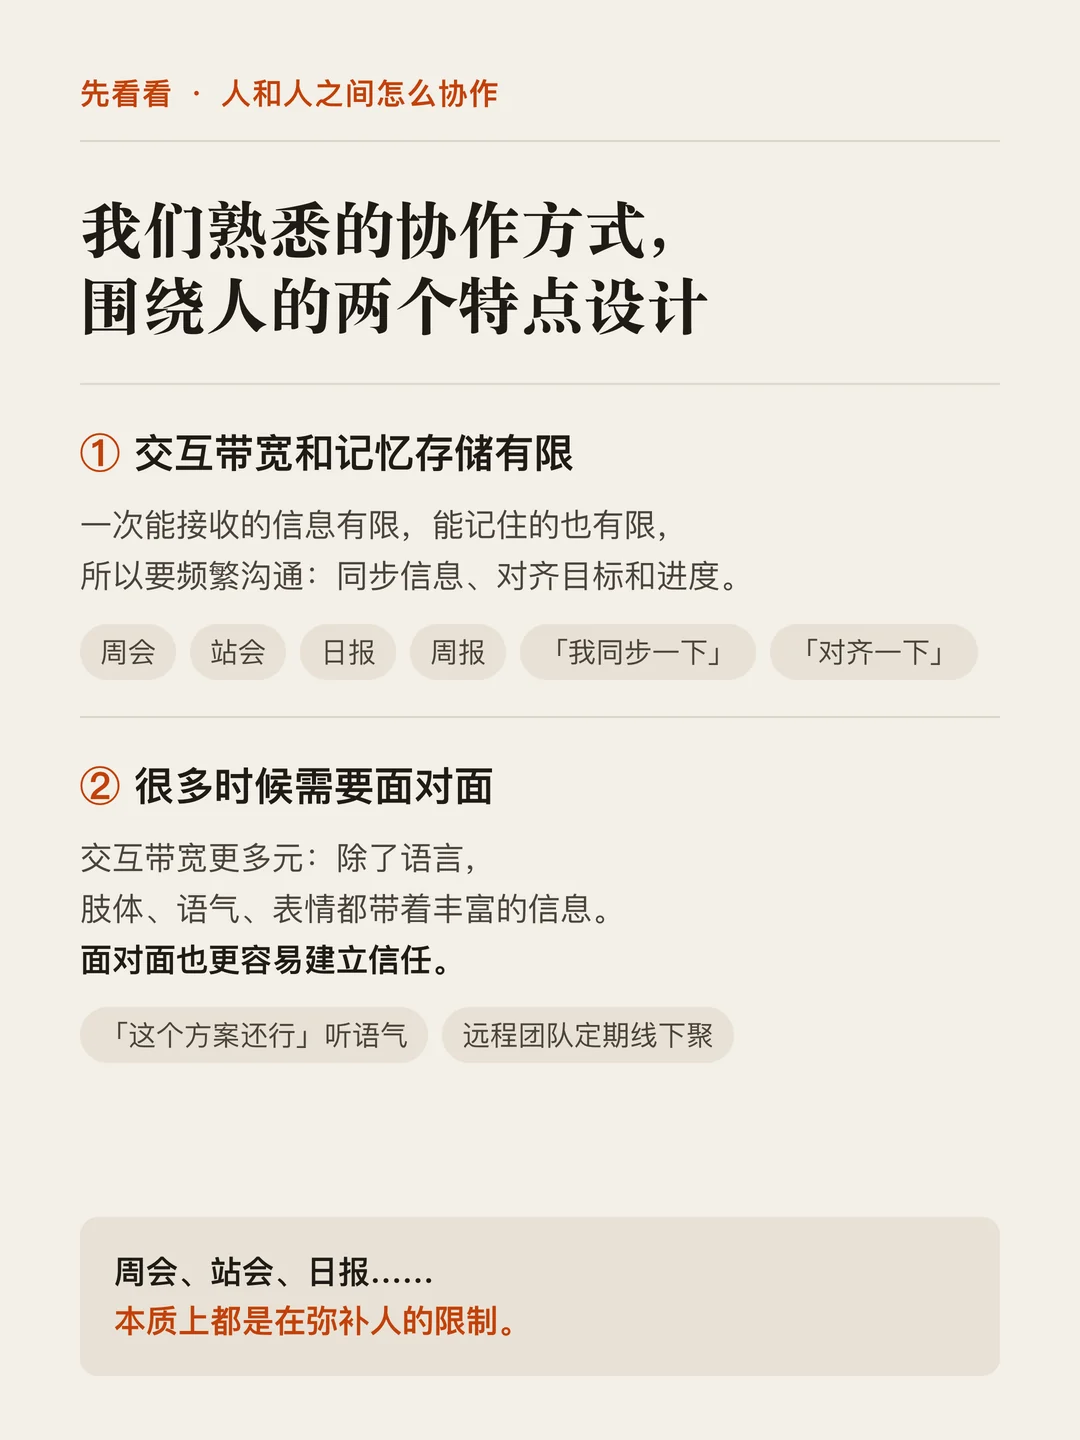
人和人的协作,是围绕人的两个限制长出来的
第一,人的交互带宽和记忆存储能力是有限的。一个人一次能接收的信息有限,能记住的也有限。所以团队需要频繁地沟通:同步信息,对齐目标,对齐进度。周会、站会、日报、周报,「我同步一下」「我们对齐一下」,本质上都在弥补这个限制。
第二,很多协作需要面对面。一方面,面对面的交互带宽更多元:除了语言,肢体、语气、表情都带着丰富的信息。同一句「这个方案还行」,当面说,你能听出来是真认可还是有保留。另一方面,也是很重要的一点:面对面更容易建立信任。这也是为什么很多远程团队,还是要定期线下聚一次。
智能体加入之后,变了什么
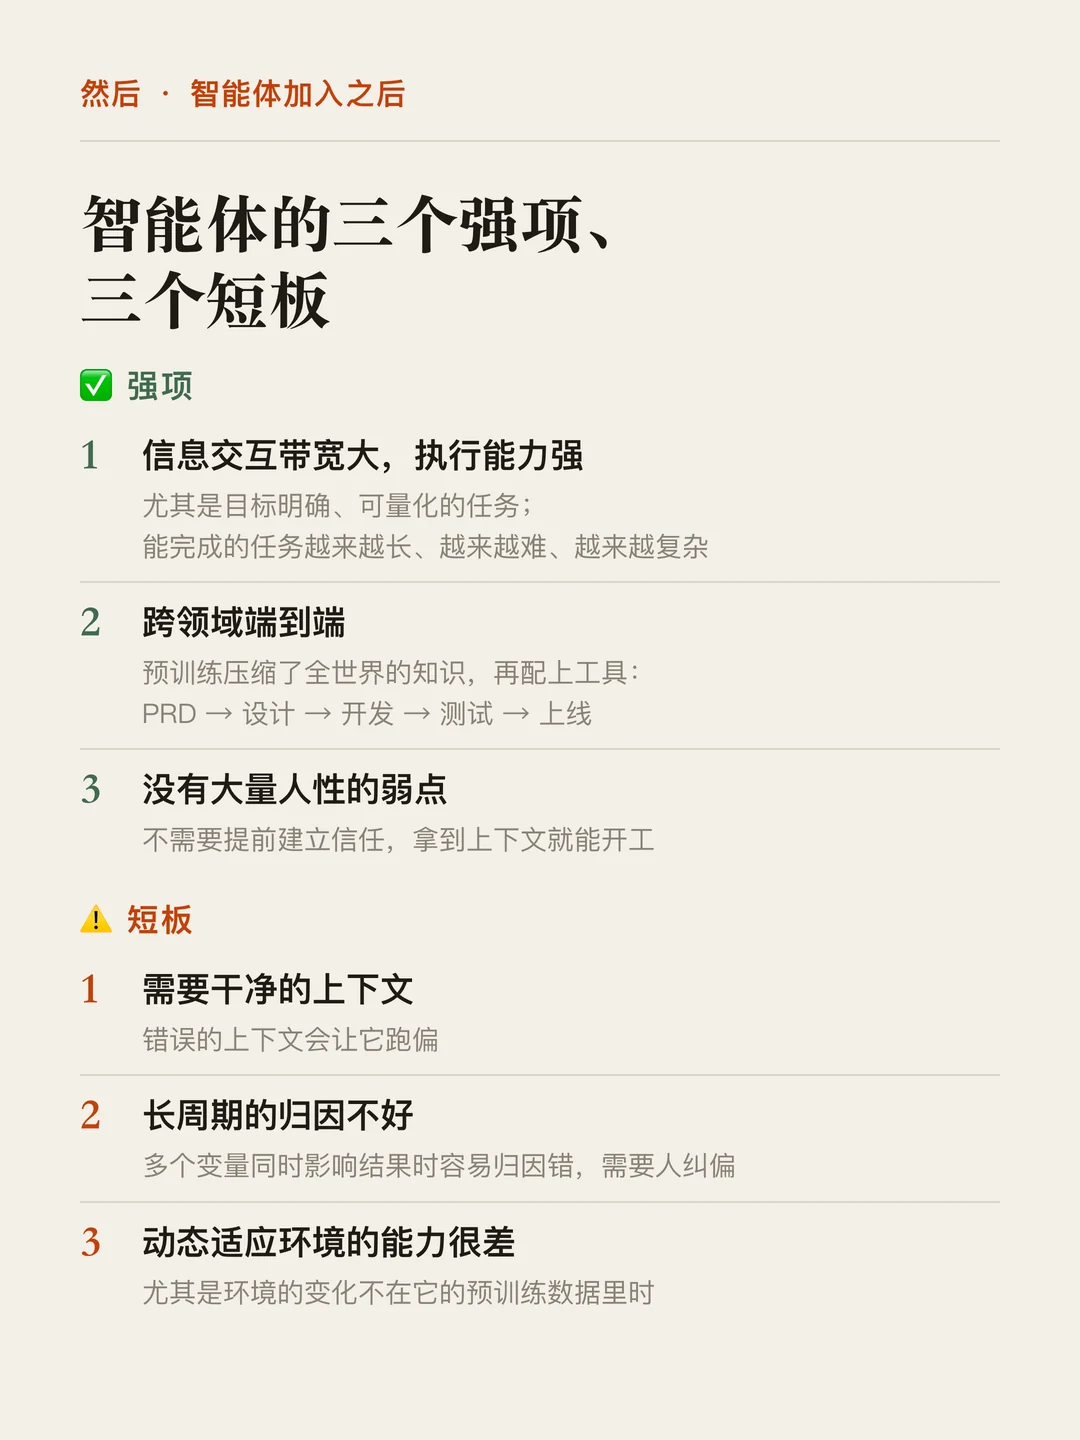
多人和多智能体的协作里,人的这部分继续需要保留。但智能体这部分,和人的协作会有很大的差异。它有三个明显的强项,也有三个明显的短板。
三个强项
信息交互带宽大,执行能力强。尤其是目标明确、可以量化的任务。而且它能完成的任务,时间长度、难度和复杂度都在快速提升。Meta 介绍自家的编程智能体时提到,在一个 GPU 算子优化任务上,智能体连续工作了最长 24 小时、调用了 1000 多次工具(Meta)。Linus Torvalds 在 2026 年 10 月发出的一组 Linux 内核补丁,代码、测试程序和提交说明的初稿都由 Claude Code 完成,性能测量由他自己在本机跑(LWN)。
自带全世界的知识和工具,可以跨领域端到端。全世界的知识在预训练时已经压缩进了模型,再配上相关的工具,智能体可以跨领域把一件事从头做到尾:提 PRD → 做设计 → 开发 → 测试 → 上线。同样一件事,人来做,需要产品、设计、开发、测试几个职能角色配合,每次交接都要再对齐一遍。
没有大量人性的弱点,不需要提前建立信任。它不会累,不闹情绪,也不怕问了显得自己不懂。一个新智能体拿到项目的上下文就能开工,不需要磨合期,也不需要先「处好关系」。
三个短板
需要干净的上下文。错误的上下文会让它跑偏。我们自己就踩过:数据看板里有个字段显示「无法关联」,其实数据是能关联上的,是这个字段自己算错了。结果两个智能体读到这句,都直接放弃了一整块用户路径分析。人看到这种结论,会多问一句「这个还准吗」;智能体往往照单全收。
长周期的归因不好。尤其是多个变量同时影响结果的时候,容易归因错误,需要人来纠偏。有段时间,我们官网有几个新页面一直没被 Google 收录。智能体的判断是「站点权重不够,Google 不肯花抓取预算」,建议先去做外链。我们追问之后去实测,发现全站绝大多数页面其实都被收录了;没收录的那几篇,更像是题材和网站主题离得太远。问题根本不在预算上,如果照原来的判断去做外链,方向就错了。
动态适应环境的能力很差。尤其是环境的变化不在它的预训练数据里的时候。一个刚改版的网站、一条刚改的平台规则、一个上个月才发布的新产品:人看一眼就知道「变了」,会换个做法;智能体常常还按它知道的老样子去理解,一遍遍地重试。
为什么 IM 那套不适合
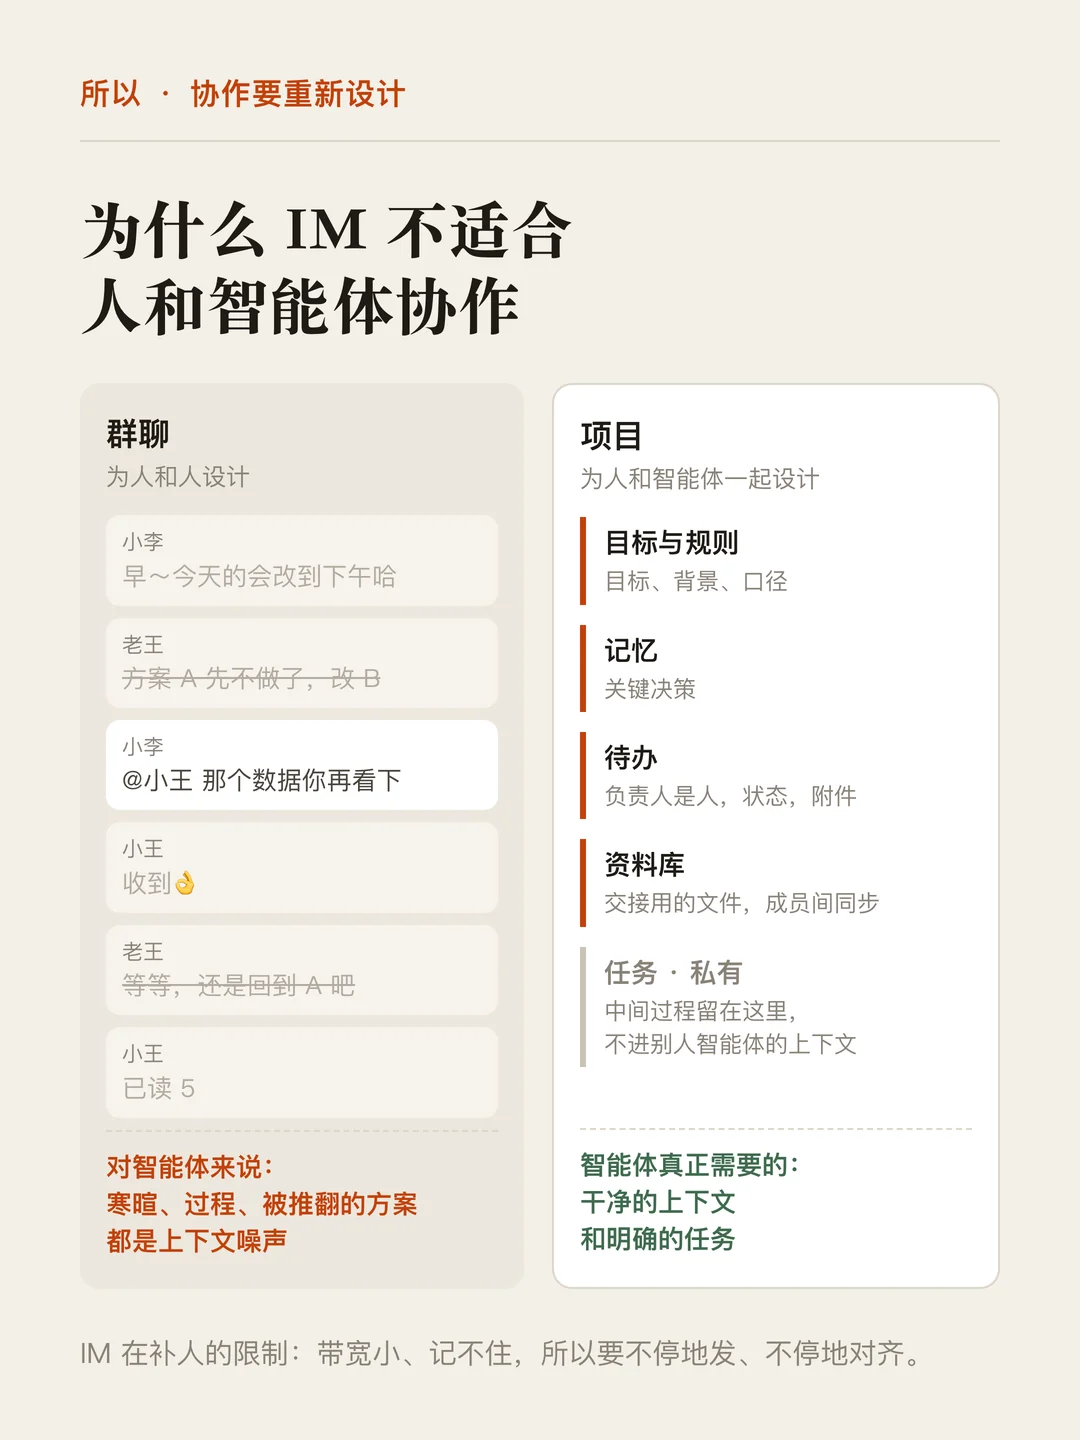
IM 是为人和人的协作设计的:消息一条条往下滚,靠 @ 和「已读」来同步,信息散落在各个群里。这套设计正好在补人的那两个限制:带宽小、记不住,所以要不停地发、不停地对齐。
放到智能体身上就不对了:
- 群里的寒暄、讨论的过程、已经被推翻的方案,对智能体来说都是上下文噪声;
- 它不需要靠聊天来建立信任;
- 它真正需要的,是干净的上下文和明确的任务。
所以多人和智能体的协作需要重新设计。而且随着智能体的能力持续提升,协作的方式也会跟着变化。Orkas 也还在持续探索中。
Orkas 的做法:保留不变的,重新设计变了的
我们的思路是:保留协作里不变的部分,重新设计变了的部分。下面是 Orkas 里一个共享项目的界面,四件事分别落在图上标出的四个地方。
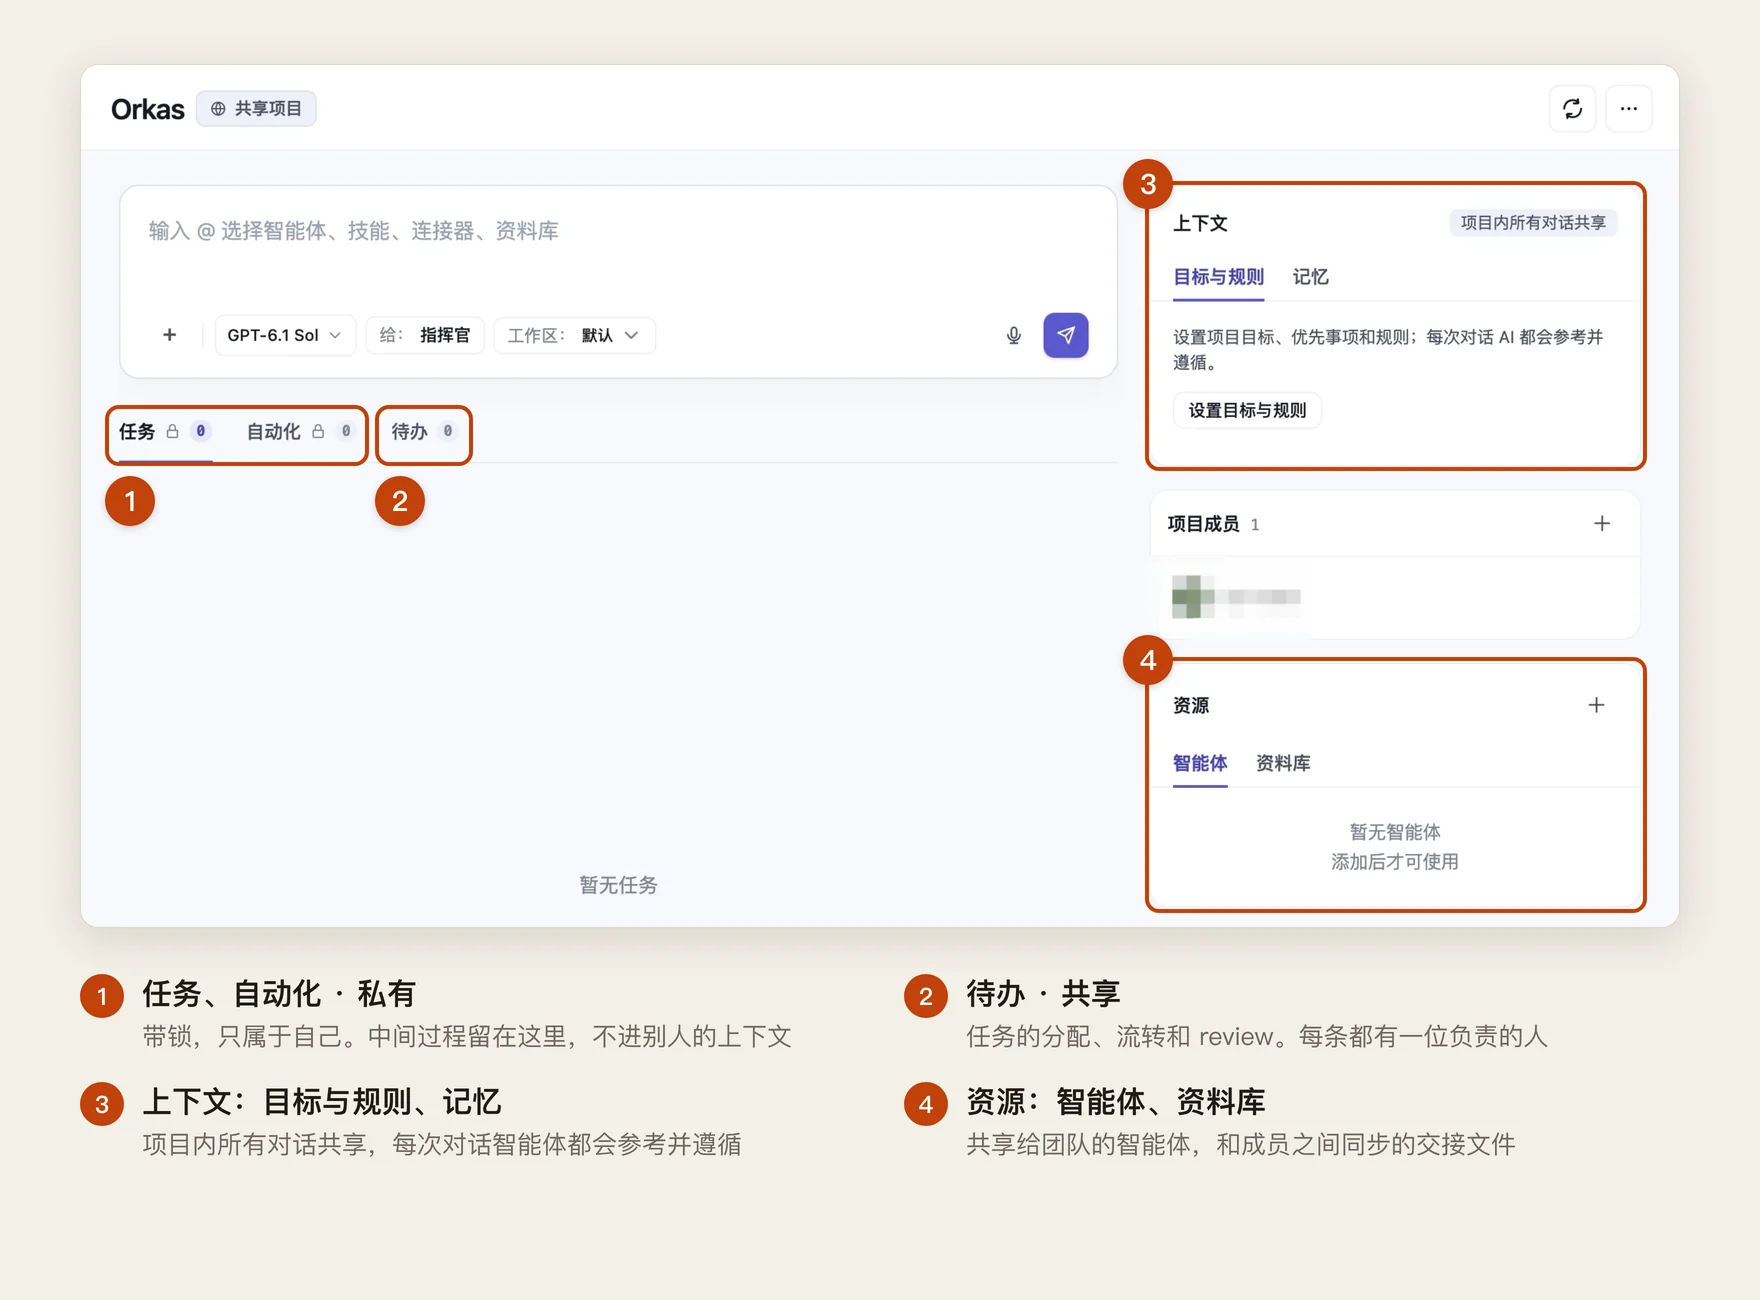
1. 任务的分配、流转和 review:待办
这部分在人和人的协作里就有,现在依然需要。现阶段,我们所有任务的负责人都是人类,任务最终的结果得由人类来负责。
落到产品里是这样的:每条待办都指派给一个人,再由这个人决定用哪个智能体去做。只有负责人能启动这条待办,智能体在负责人自己的电脑上、用他的模型和积分完成工作。做完以后,智能体把状态改成待确认,而不是自己标成已完成;负责的人看过、改过,这件事才算完。
2. 目标、背景和上下文的共享:目标与规则、记忆
在这一层,人和智能体共享同样的上下文,保证关键信息持续对齐。
项目的「目标与规则」和「记忆」在项目内所有对话之间共享,每次对话,智能体都会参考并遵循。比如把「月留存 = 下个月还回来的新用户」这样的口径写进目标与规则,把关键决策记进项目记忆。新成员和他的智能体一进来,读到的就是同一份。
3. 通过文件交接,中间过程隔离
项目里的资料库在成员之间同步,待办可以把任意文件作为附件。交接靠的是文件,不是聊天记录。
大量的中间过程和步骤,我们特意做了隔离,以免给智能体带来有害的上下文噪声。界面上带锁的「任务」和「自动化」只属于自己。一个智能体可能跑了几百步、试了三个方案,才出一份报告;交到同事手里的只有这份报告,过程留在各自的任务里,不会混进别人智能体的上下文。
4. 私有智能体共享给团队
项目成员的私有智能体,可以共享给团队成员调用。这些智能体内化了成员个人的经验和品味判断。共享出来,一方面可以加快整体的效率;另一方面,使用过程中发现的问题,可以通过自演进的机制持续改进,让项目整体的能力水平不断提升。
共享时,Orkas 打包的是这个智能体的工作说明和技能,包括它在工作中自己沉淀下来的技能;它的记忆和聊天记录不在包里。共享者更新这个智能体后,成员会自动拿到新版本。
这是一个很早期的开放领域
多人和智能体的协作目前还很早期,方案完全没有收敛。而且随着模型能力的提升,大量智能体协作的能力会被内化到模型里。
现在已经有模型能原生做到:同时并发多个子智能体做多维度的探索,先规划、再调度子智能体去执行。比如 Meta 在 2026 年 10 月开源的 Muse Spark Open,官方介绍里就写着训练了它拆分任务、派给子智能体并协调的能力(PyTorch 博客)。
所以协作的方式,也会随着模型能力的提升而改变。今天的待办、上下文、文件交接和共享智能体,是我们在当前模型能力下给出的答案,不是最终形态。
写在最后
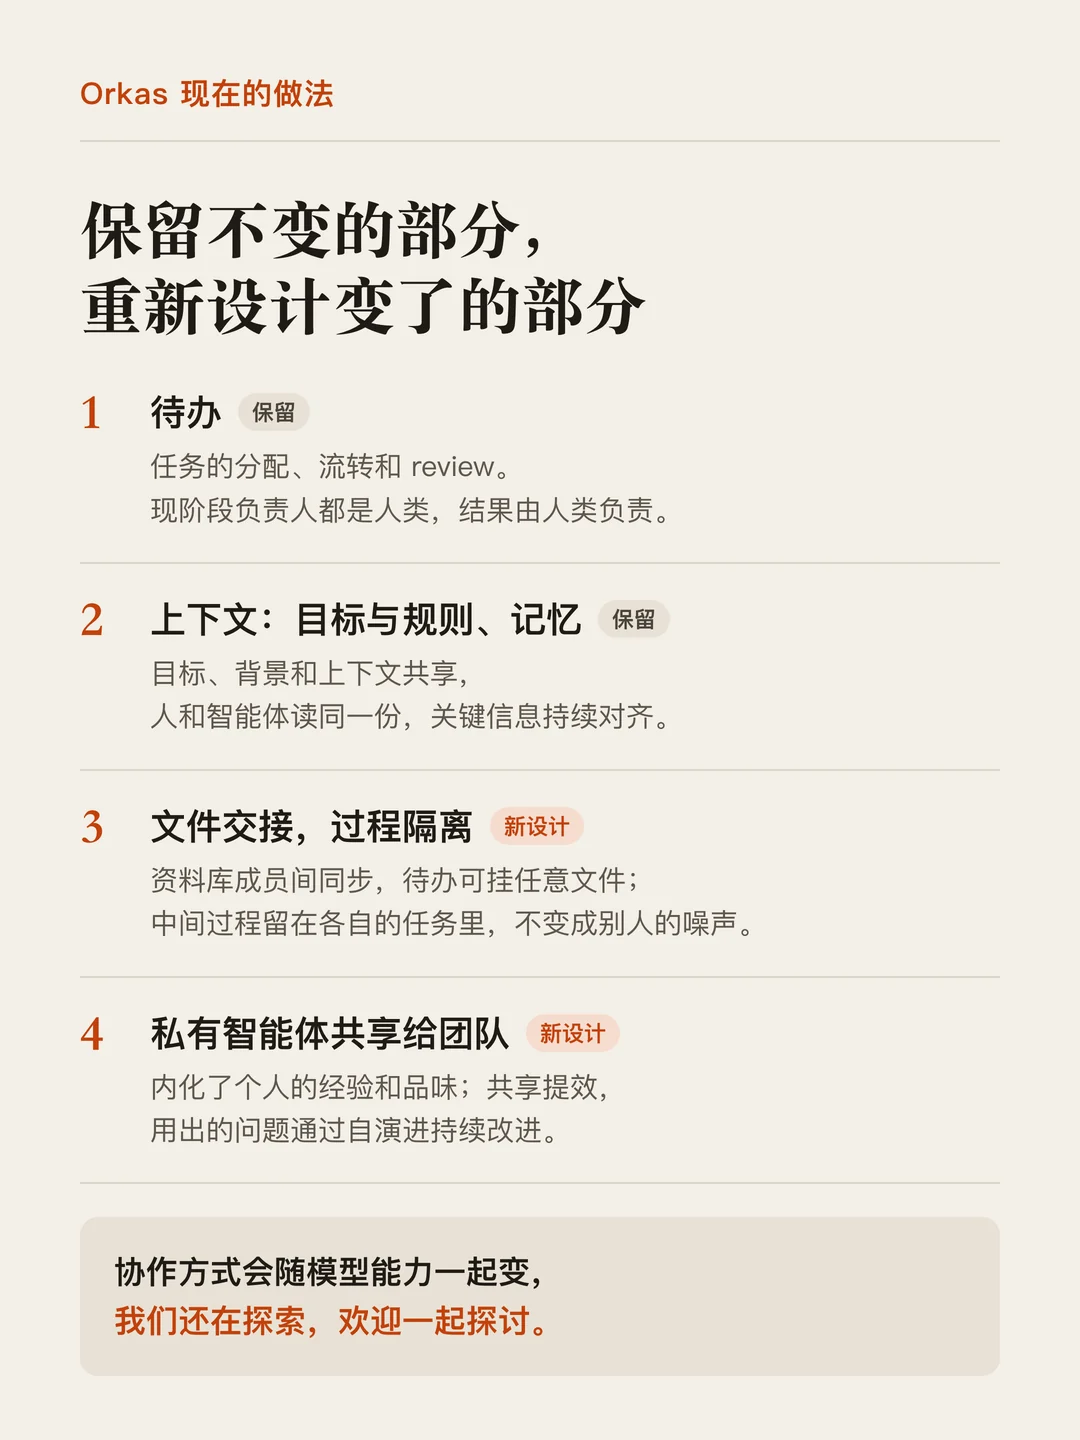
我们保留了协作里不变的部分:有人负责,有人 review,目标和上下文持续对齐。我们重新设计了变了的部分:用文件交接,把过程隔离,把个人的经验和品味变成团队能调用的智能体。
这件事我们也还在探索,欢迎一起探讨。如果你也在带一个人和智能体一起干活的团队,可以先拿一个项目试试。Orkas 可以免费下载,支持 macOS 和 Windows。