
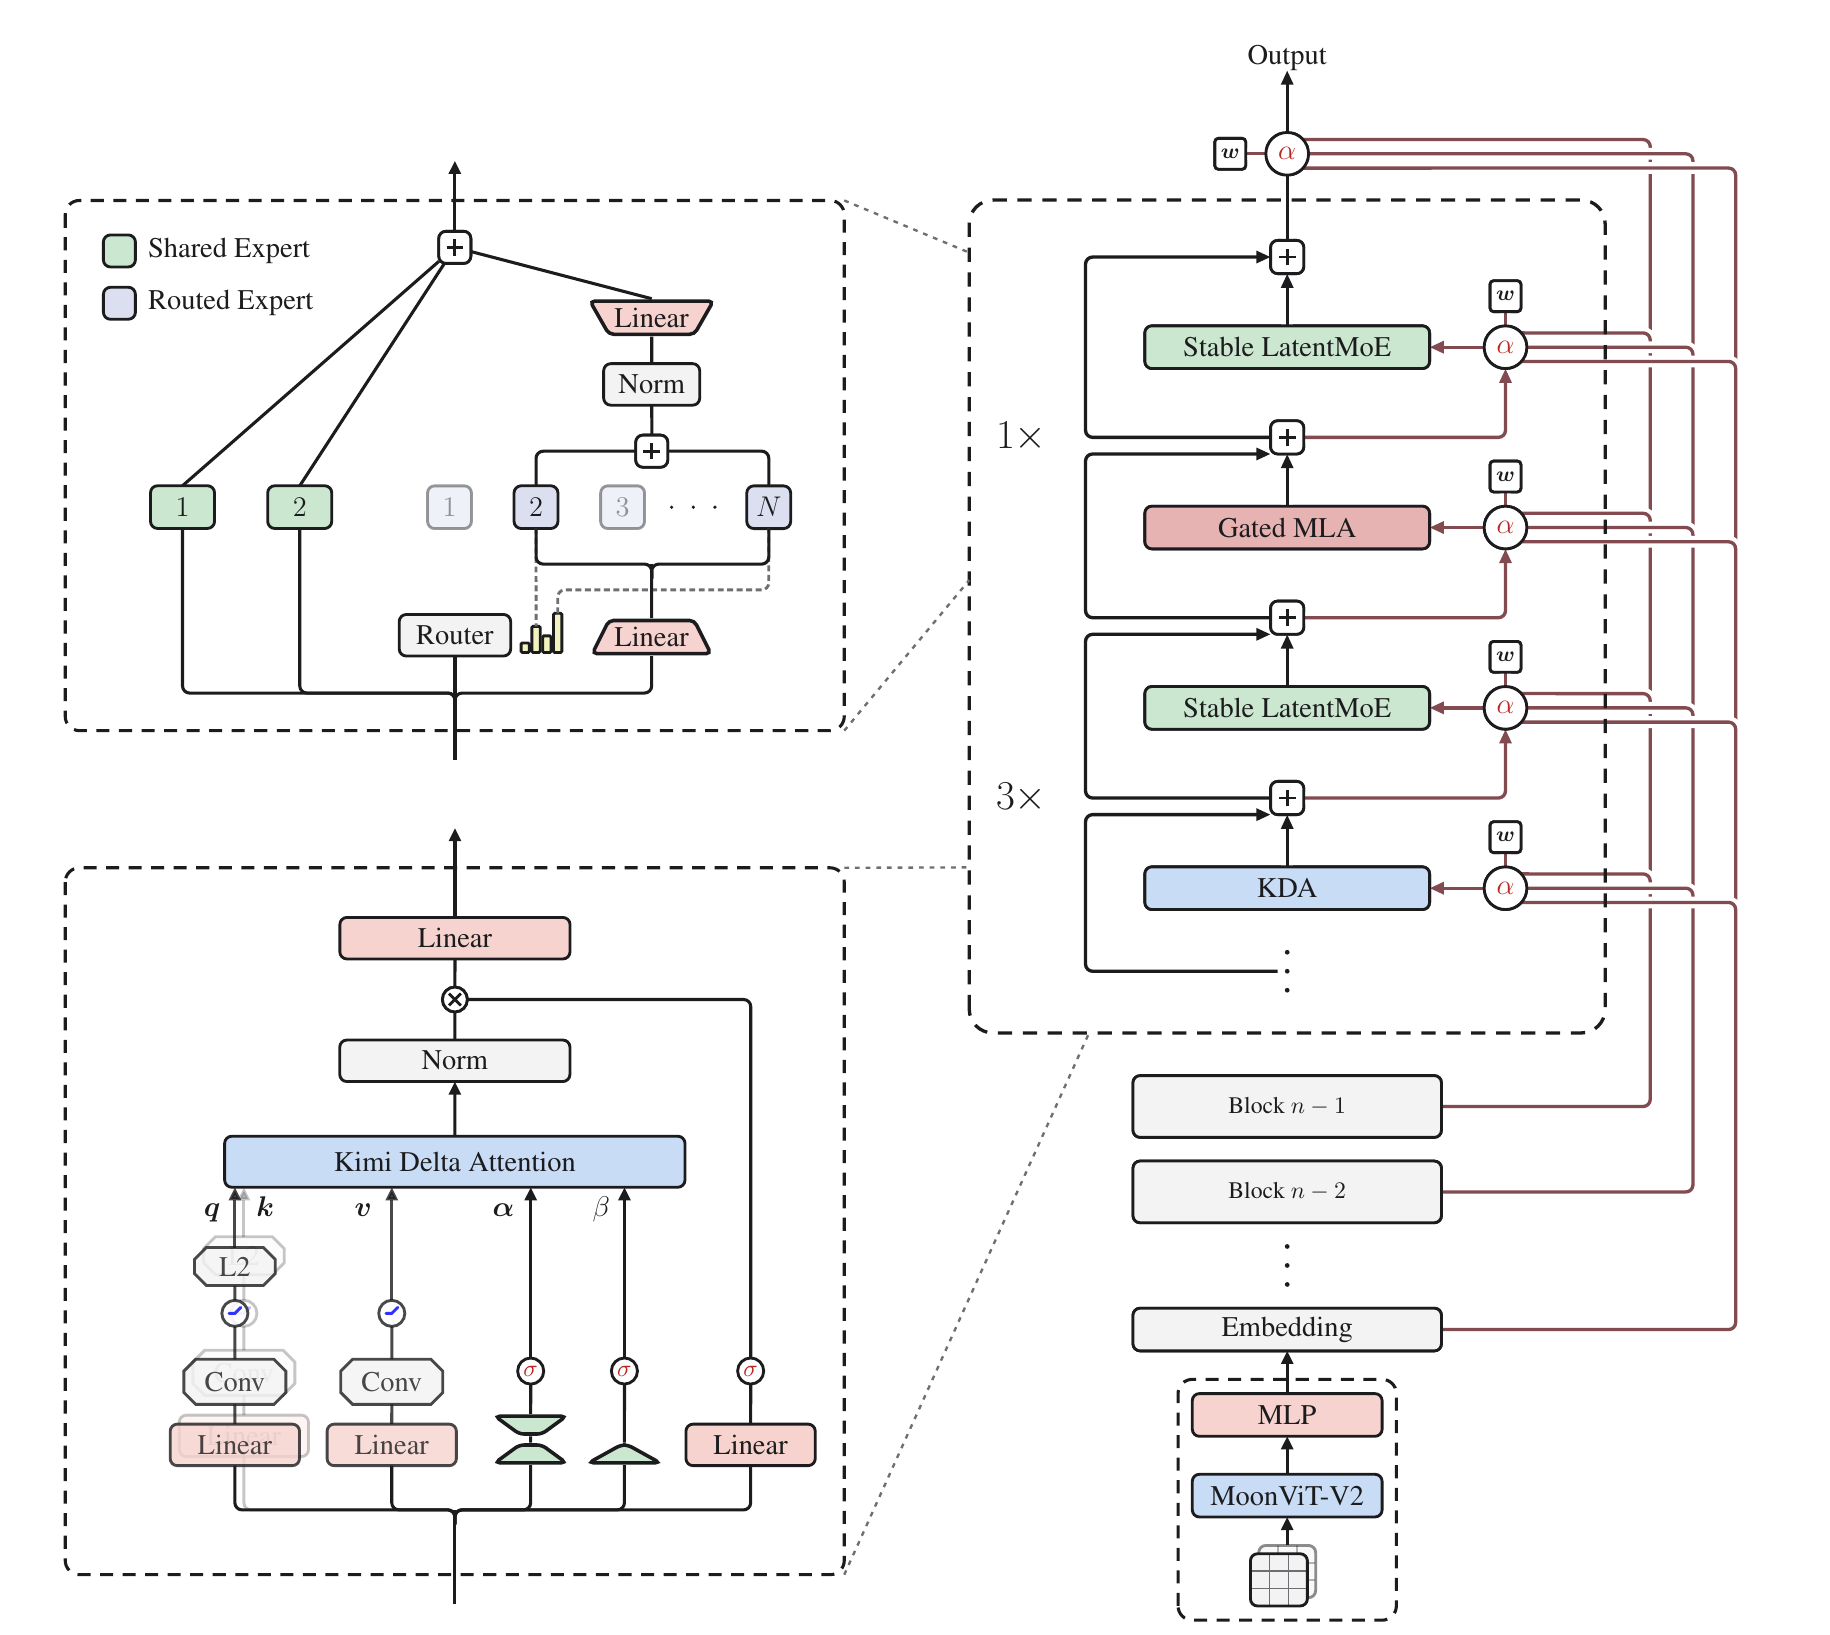
La cifra que acapara los titulares de Kimi K3 es 2.8 billones de parámetros. Es la cifra menos interesante del informe.
Lo interesante es que la arquitectura se organiza en torno a una pregunta que no tiene nada que ver con el tamaño: ¿dónde está dejando de fluir la información? La respuesta tiene tres partes —a lo largo de la secuencia, de la profundidad y de la anchura— y cada una cuenta con su propio mecanismo.
El mismo cómputo, aproximadamente 2.5× la eficiencia de escalado de Kimi K2. Esa cifra proviene de las curvas de leyes de escalado ajustadas por el propio equipo, no de una reproducción de terceros, así que debe interpretarse como una afirmación suya. Pero los mecanismos que la sustentan son lo bastante concretos como para poder debatirlos, y eso hace que el informe merezca el tiempo de lectura.
Este es un análisis detallado del informe técnico de Kimi K3 (Moonshot AI), centrado en su sección de arquitectura. Ya hemos escrito sobre el diseño de agentes de horizonte largo; este artículo se sitúa en una capa más profunda de la pila tecnológica.
Tres direcciones, no una cifra
Cada capa de un transformer mezcla información de tres maneras. Entre tokens, para que la posición 900,000 pueda afectar a la posición 1. A lo largo de la profundidad, para que la capa 90 pueda usar lo que detectó la capa 3. Entre canales, para que las características puedan recombinarse.
La mayoría de los trabajos sobre escalado hacen avanzar las tres a la vez aumentando el tamaño de todo. K3 las separa y asigna a cada una su propio mecanismo:
- Secuencia: atención híbrida, con tres capas de Kimi Delta Attention por cada capa de Gated MLA.
- Profundidad: Attention Residuals, donde cada capa aplica atención a las salidas de todas las capas anteriores en lugar de heredar un único estado acumulado.
- Anchura: Stable LatentMoE, con 896 expertos enrutados, de los que se activan 16 por token.
La dimensión oculta no cambió en absoluto. 7168 en K2, 7168 en K3. Lo que aumentó de tamaño no fue la anchura de una capa.
Secuencia: tres cuartas partes de las capas dejaron de leerlo todo
La atención estándar vuelve a leer todo el prefijo para cada nuevo token. Con un millón de tokens, ese costo es lo que se vuelve insostenible.
K3 divide el trabajo. Tres capas KDA mantienen un estado de tamaño fijo que se actualiza continuamente —más parecido a tomar notas que a releer la fuente—, seguidas de una capa Gated MLA que realiza atención global completa. El patrón se repite, con una capa MLA adicional al final para que la última capa siempre lo vea todo. En las 93 capas: 69 KDA y 24 MLA.
El tamaño fijo es la clave. El estado no crece con la secuencia, así que no puede dispararse. También pierde información, por eso hay una capa de atención completa cada cuatro capas para recuperar lo que las notas omitieron.
Luego aparece un efecto secundario. Como el estado recurrente incorpora un decaimiento —los tokens recientes están naturalmente más presentes que los antiguos—, la información de posición viene incluida sin costo. Por eso K3 no aplica ninguna codificación posicional a sus capas de atención global. Sin RoPE, sin nada que reescalar.
Esto significa que ampliar el contexto a un millón de tokens no requirió modificar la codificación posicional. Ninguno de los trucos de interpolación que el campo ha acumulado para extender el contexto se aplica aquí, porque no hay ninguna codificación que interpolar.
Un límite inferior que eliminó una ruta de código de GPU
Esta es nuestra parte favorita del informe, y es lo bastante breve como para pasarla por alto.
El estado recurrente va olvidando a medida que avanza. Calcular eso de forma eficiente por bloques requiere dividir por el decaimiento acumulado, y el decaimiento acumulado es un producto de números menores que uno. Si se deja sin controlar, se termina dividiendo por algo arbitrariamente cercano a cero.
La generación anterior lo resolvía dividiendo cada bloque en subbloques de 16 tokens y trabajando en el espacio logarítmico. Funcionaba, pero los subbloques de la diagonal aún debían evaluarse par de posiciones por par de posiciones: una ruta lenta para un caso especial que no podía usar los núcleos tensoriales.
La solución de K3 es una línea de parametrización. Se impone un límite inferior al logaritmo del factor de decaimiento: cada paso puede olvidar hasta quedarse con el 0.67% de lo que contenía, pero no menos.
Veamos las consecuencias. Con ese límite, el logaritmo del decaimiento acumulado en un subbloque de 16 tokens se mantiene dentro de (−80, 0). Por tanto, el recíproco queda por debajo de e80 ≈ 5.5 × 1034, holgadamente dentro del rango de BF16, de aproximadamente 3.4 × 1038. No se produce ningún desbordamiento. Así, los subbloques diagonales pueden usar la misma multiplicación de matrices densas que los demás subbloques.
La ruta especial no se optimiza. Desaparece.
Si se lee la cadena causal al revés, resulta aún mejor: el rango dinámico del hardware determinó el intervalo aceptable, que determinó la constante, que determinó que la activación debía tener un límite inferior. Las restricciones numéricas eligieron las matemáticas, y no al revés.
Profundidad: de una carrera de relevos a un chat grupal
Con noventa y tres capas de profundidad, el flujo residual estándar es una carrera de relevos. La capa 50 recibe un único estado acumulado de la capa 49. Lo que las capas 1 a 48 detectaron individualmente se ha sumado a ese estado y ya no puede separarse.
El artículo plantea que este es el mismo cuello de botella que tiene una RNN a lo largo del tiempo, y el campo ya lo resolvió con la atención. Attention Residuals aplica la misma solución a la profundidad: cada capa incorpora una pseudoconsulta que puede aprenderse y aplica atención a las salidas de todas las capas anteriores, eligiendo qué leer.
Aplicarlo literalmente supone un costo de cómputo cuadrático respecto a la profundidad y, peor aún, mantiene disponible la salida de cada capa en memoria y en la comunicación cuando se usa paralelismo en pipeline. Por eso K3 utiliza la variante por bloques: 93 capas divididas en grupos de doce, con suma dentro de cada grupo y atención completa entre grupos. La sobrecarga pasa de ser por capa a ser por grupo, y el estado durante la inferencia permanece acotado.
Anchura: 896 expertos, 16 activos
La mezcla de expertos mantiene un gran conjunto y activa unos pocos por token. K2 elegía 8 de 384. K3 elige 16 de 896: una relación de dispersión de 56.
Ampliar tanto el conjunto rompe dos cosas, y el informe es inusualmente directo respecto a ambas.
Comunicación. En una MoE convencional, cada experto seleccionado recibe el token con toda su anchura, por lo que el tráfico aumenta según cuántos se seleccionen. LatentMoE desacopla ambos factores: los expertos enrutados trabajan en un espacio latente compacto con la mitad de la anchura del modelo, mientras que dos expertos compartidos de anchura completa se encargan de lo que necesita cada token. El conjunto puede crecer sin que el costo de comunicación crezca con él.
Estabilidad. Con este grado de dispersión, la rama enrutada se convierte en una cadena de casi cuatro multiplicaciones de matrices consecutivas, y las activaciones se disparan. Dos soluciones: una RMSNorm entre la agregación de expertos y la proyección ascendente, y una nueva activación, SiTU-GLU, que limita ambos factores de una SwiGLU mediante una tanh escalada para que ninguno se descontrole con baja precisión.
Equilibrio. La tercera solución es la que vale la pena adoptar. Mantener una carga equilibrada entre aproximadamente 900 expertos implica ajustar un sesgo por experto en cada paso. El método estándar modifica cada sesgo mediante un incremento fijo en la dirección del error, lo que provoca oscilaciones o retrasos. K3, en cambio, calcula el valor que lo resuelve: ejecuta top-(k+1) en lugar de top-k, y la entrada adicional es la puntuación que exige un token para admitir a un experto. Con esos umbrales, la carga que recibe un experto bajo un sesgo candidato es monótona, de modo que el sesgo que alcanza la carga objetivo es simplemente un cuantil de los márgenes. Una sola pasada hacia adelante, sin tamaño de paso que ajustar.
A gran escala, ese cuantil abarca millones de valores entre todos los procesos, por lo que lo estiman a partir de un histograma: cada proceso cuenta los valores de sus intervalos, una operación all-reduce los suma y el cuantil se obtiene de los recuentos agrupados. Los recuentos se suman, así que la estimación refleja todo el lote, independientemente de cómo se distribuyan los tokens, con un costo de unos cientos de intervalos por experto.
El costo aparece en la infraestructura de servicio
Nada de esto es gratis, y la parte honesta del informe es la sección de infraestructura, donde recaen los costos.
Un estado recurrente de tamaño fijo cuesta poco de almacenar y de transferir, pero se actualiza secuencialmente y no se puede sumar sin más. Ambas propiedades generan trabajo:
- Dividir una secuencia entre dispositivos. La atención lineal habitual permite que cada dispositivo calcule su estado local desde cero y sume los resultados. KDA aplica al estado entrante una transición dependiente del token, por lo que la suma es incorrecta. La solución descompone cada segmento en una transición acumulativa y un estado calculado desde cero —dos cantidades que sí se pueden componer— y recupera el estado de entrada de cada dispositivo mediante una operación de prefijos acumulados y una operación all-gather de tamaño fijo.
- Reutilizar un prefijo entre solicitudes. La mitad de las cachés son páginas por token; la otra mitad es un estado fijo por solicitud, y un acierto de caché requiere que ambas puedan restaurarse en el mismo límite. Su respuesta es desacoplar las granularidades: calcular hashes cada 512 tokens, asignar memoria en bloques de 1024–6144 y guardar puntos de control del estado recurrente solo en un subconjunto disperso de los puntos finales de hash.
- Decodificación especulativa. El estado se actualiza en el mismo lugar, por lo que un borrador rechazado no puede revertirse. En su lugar, almacenan en caché las entradas proyectadas —mucho más pequeñas que el propio estado— y lo reconstruyen en el chip.
El patrón de los tres casos es el mismo que el del límite de decaimiento, pero en sentido inverso: la arquitectura eligió una representación, y esa representación dictó el trabajo de ingeniería de sistemas.
Una práctica que el artículo abandona discretamente
K3 es multimodal de forma nativa, y su codificador de visión se entrena desde cero mediante predicción del siguiente token. Sin inicialización con SigLIP ni preentrenamiento contrastivo, que es la receta estándar, también utilizada en el modelo anterior del propio equipo.
La razón declarada no es la calidad. Es la estabilidad: el codificador con inicialización contrastiva mostró normas de gradiente persistentemente más altas, con picos frecuentes durante la optimización conjunta, mientras que el entrenado desde cero se mantuvo estable. Las evaluaciones de visión dieron resultados equivalentes.
Eso hace que el hallazgo sea más revelador de lo que habría sido una victoria. Si entrenar desde cero hubiera dado mejores resultados, se consideraría una receta mejor. Dio resultados equivalentes, así que la afirmación es que, a esta escala, un paso que el campo trata como obligatorio es simplemente opcional.
Qué significa esto si ejecutas agentes con estos modelos
Desarrollamos un cliente de escritorio multiagente, así que lo que observamos es si una ejecución de horizonte largo sigue siendo asequible, no qué modelo encabeza una clasificación.
La cifra que importa no es el tamaño de la ventana de contexto, sino cuánto cuesta procesar un millón de tokens durante el servicio. Tres cuartas partes de las capas mantienen un estado de tamaño fijo, por lo que la caché que crece con la conversación tiene una cuarta parte del tamaño que tendría en un modelo de la misma profundidad compuesto solo por capas de atención. En BrowseComp, el informe sitúa a K3 en el 91.2% con un costo aproximado de $2 por tarea: cerca de la mitad del costo de la puntuación más cercana de un modelo propietario y un orden de magnitud por debajo de los modelos Claude con el esfuerzo máximo.
Para un agente que ejecuta cientos de llamadas a herramientas, esa relación determina si siquiera vale la pena intentar una tarea. El trabajo de arquitectura que antes parecía investigación pura ahora se refleja directamente en si una ejecución larga tiene sentido económico.
Qué extraemos de todo esto
Dos cosas, ambas aplicables a otros ámbitos.
Primero, el planteamiento. ¿Dónde está dejando de fluir la información? lleva a un trabajo distinto de ¿cuánto más podemos aumentar el tamaño?, y permite descomponer el problema, por lo que los tres mecanismos pudieron desarrollarse y medirse por separado.
Segundo, el límite de decaimiento. Una restricción que apenas reduce la capacidad expresiva eliminó toda una ruta especial del kernel. No una ruta más rápida: ninguna ruta. Esa posibilidad de intercambio se presenta mucho más a menudo de lo que se aprovecha, y solo es visible para quienes tienen presentes al mismo tiempo las matemáticas y el hardware.
El informe y los pesos están disponibles abiertamente en GitHub. La sección de arquitectura tiene ocho páginas y merece una lectura atenta.