
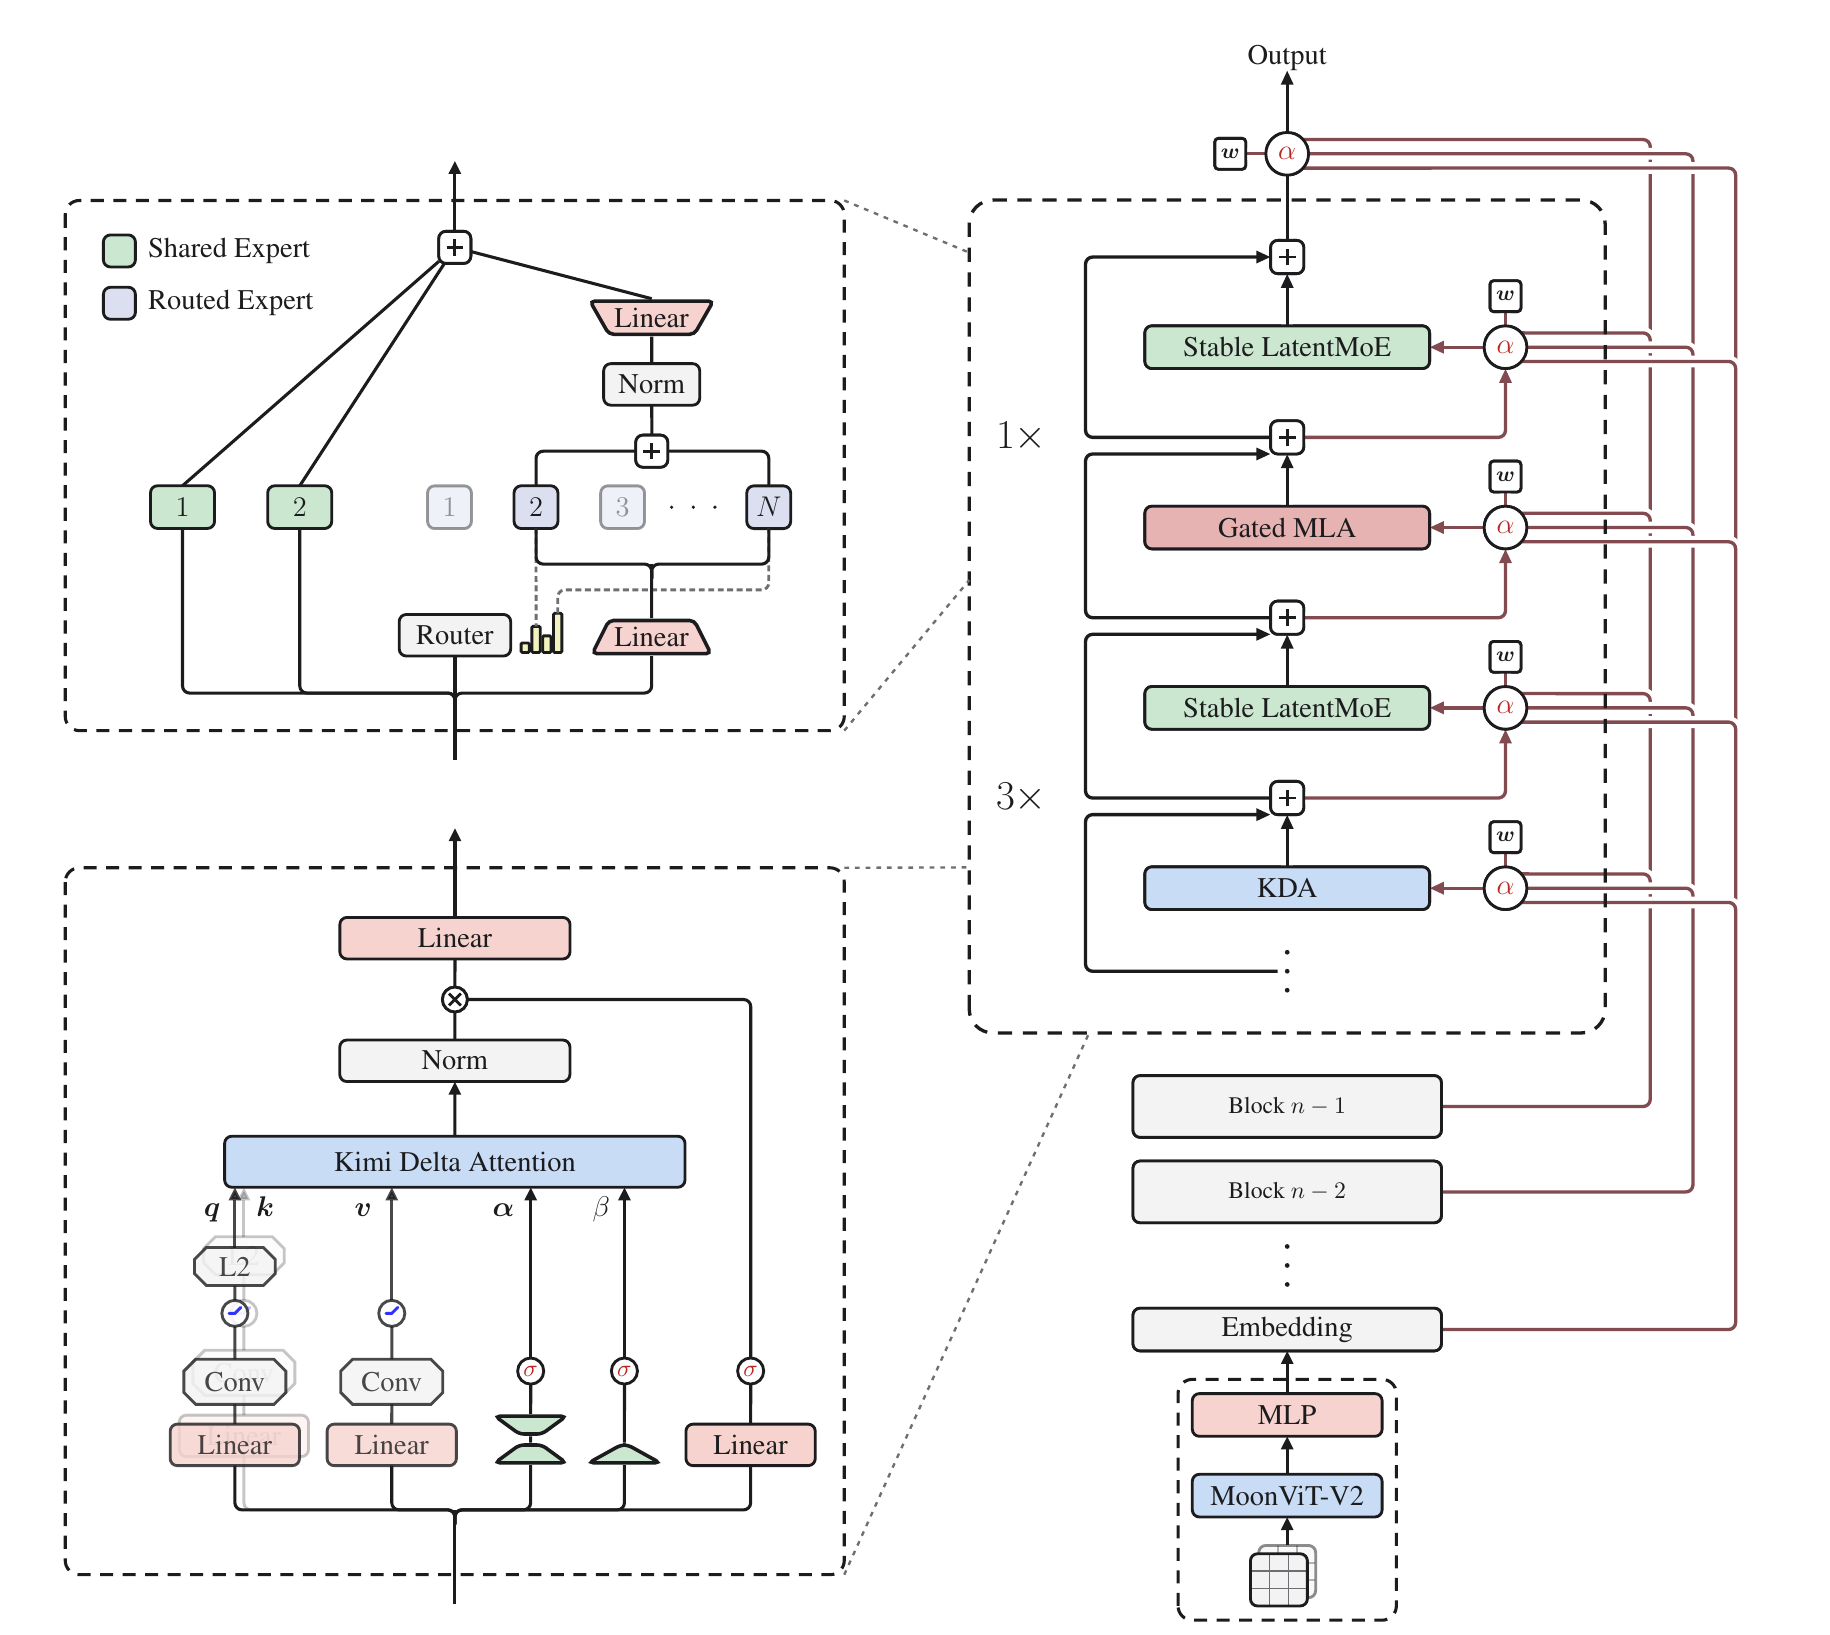
Nomor utama Kimi K3 adalah 2,8 triliun parameter. Itu adalah angka yang paling tidak menarik dalam laporan.
Bagian yang menarik adalah bahwa arsitektur diatur di sekitar pertanyaan yang tidak ada hubungannya dengan ukuran: Dimana informasi gagal mengalir? Jawabannya memiliki tiga bagian — sepanjang urutan, sepanjang kedalaman, sepanjang lebar — dan masing-masing mendapatkan mekanismenya sendiri.
Komputasi yang sama, kira-kira 2,5× efisiensi penskalaan Kimi K2. Angka itu berasal dari kurva hukum penskalaan tim yang pas daripada reproduksi pihak ketiga, jadi bacalah sebagai klaim mereka. Tetapi mekanisme di baliknya cukup spesifik untuk diperdebatkan, itulah yang membuat laporan itu sepadan dengan waktu.
Ini adalah bacaan dekat dari Laporan teknis Kimi K3 (Moonshot AI), berfokus pada bagian arsitekturnya. Kami telah menulis sebelumnya tentang Desain agen cakrawala panjang; yang ini duduk lebih jauh di bawah tumpukan.
Tiga arah, bukan satu angka
Setiap lapisan dalam transformator mencampur informasi dengan tiga cara. Di seluruh token, jadi posisi 900.000 dapat mempengaruhi posisi 1. Melintasi kedalaman, sehingga lapisan 90 dapat menggunakan apa yang diperhatikan lapisan 3. Di seluruh saluran, sehingga fitur dapat digabungkan kembali.
Sebagian besar pekerjaan penskalaan memindahkan ketiganya sekaligus dengan membuat semuanya lebih besar. K3 memisahkan mereka dan masing-masing memberikan mekanismenya sendiri:
- Urutan — perhatian hibrida: tiga lapisan Perhatian Kimi Delta untuk setiap lapisan MLA Gated.
- Kedalaman — Sisa Perhatian: setiap lapisan menghadiri output dari semua lapisan sebelumnya alih-alih mewarisi satu keadaan yang terakumulasi.
- Lebar — Stable LatentMoE: 896 ahli yang dialihkan, 16 yang terjaga per token.
Dimensi tersembunyi tidak berubah sama sekali. 7.168 di K2, 7.168 di K3. Apa pun yang menjadi lebih besar, itu bukan lebar lapisan.
Urutan: tiga perempat lapisan berhenti membaca semuanya
Perhatian standar membaca ulang seluruh awalan untuk setiap token baru. Pada satu juta token, tagihan itulah yang rusak.
K3 membagi pekerjaan. Tiga lapisan KDA mempertahankan keadaan berjalan dengan ukuran tetap - lebih dekat untuk membuat catatan daripada membaca ulang sumbernya - diikuti oleh satu lapisan MLA Gated yang melakukan perhatian global penuh. Polanya berulang, dengan satu lapisan MLA tambahan di bagian paling akhir sehingga lapisan terakhir selalu melihat semuanya. Di 93 lapisan: 69 KDA, 24 MLA.
Ukuran tetap adalah intinya. Keadaan tidak tumbuh dengan urutan, sehingga tidak dapat meledak. Itu juga lossy, itulah sebabnya lapisan perhatian penuh muncul setiap lapisan keempat untuk memulihkan apa yang dijatuhkan catatan.
Kemudian efek orde kedua. Karena keadaan berulang membawa pembusukan - token terbaru secara alami lebih hadir daripada yang lama - informasi posisi datang secara gratis. Jadi K3 berlaku Tidak ada pengkodean posisi sama sekali Ke lapisan perhatian globalnya. Tidak ada RoPE, tidak ada yang perlu diubah.
Yang berarti memperluas ke satu juta token tidak memerlukan operasi pengkodean posisi. Tidak ada trik interpolasi yang telah dikumpulkan bidang untuk ekstensi konteks yang diterapkan di sini, karena tidak ada pengkodean untuk diinterpolasi.
Batas bawah yang menghapus jalur kode GPU
Ini adalah bagian favorit kami dari laporan, dan cukup kecil untuk dilewati.
Keadaan berulang lupa saat berjalan. Komputasi yang efisien dalam potongan membutuhkan pembagian dengan akumulasi peluruhan, dan akumulasi peluruhan adalah produk dari angka di bawah satu. Biarkan berjalan tanpa dicentang dan Anda membagi dengan sesuatu yang secara sewenang-wenang mendekati nol.
Generasi sebelumnya menangani ini dengan membagi setiap potongan menjadi ubin 16-token dan bekerja di ruang log. Itu berhasil, tetapi ubin pada diagonal masih harus dievaluasi pasangan posisi demi pasangan posisi — jalur casing khusus yang lambat yang tidak dapat menggunakan inti tensor.
Perbaikan K3 adalah satu baris parameterisasi. Terikat pembusukan log dari bawah: setiap langkah mungkin lupa hingga 0,67% dari apa yang dipegangnya, dan tidak lebih jauh.
Ikuti itu. Dengan batasan itu, akumulasi pembusukan log di atas ubin 16 token tetap di dalam (−80, 0). Oleh karena itu timbal balik berada di bawah e80 ≈ 5.5 × 1034, nyaman dalam jangkauan BF16 sekitar 3,4 × 1038. Tidak ada yang meluap. Jadi ubin diagonal dapat menggunakan perkalian matriks padat yang sama seperti setiap ubin lainnya.
Jalur khusus tidak dioptimalkan. Itu hilang.
Baca kausalitas secara terbalik dan itu menjadi lebih baik: rentang dinamis perangkat keras menentukan interval yang dapat diterima, yang menentukan konstanta, yang menentukan bahwa aktivasi harus dibatasi di bawah. Numerik memilih matematika, bukan sebaliknya.
Kedalaman: dari lomba estafet hingga obrolan grup
Sembilan puluh tiga lapisan dalam, aliran residu standar adalah perlombaan estafet. Lapisan 50 menerima satu akumulasi keadaan dari lapisan 49. Lapisan apa pun 1 hingga 48 yang diperhatikan secara individual telah dijumlahkan ke dalam keadaan itu dan tidak lagi dapat dipisahkan.
Pembingkaian kertas adalah bahwa ini adalah hambatan yang sama dengan yang dimiliki RNN dari waktu ke waktu - dan lapangan telah menyelesaikannya, dengan perhatian. Perhatian Sisa menerapkan perbaikan yang sama ke kedalaman: setiap lapisan membawa pertanyaan semu yang dapat dipelajari dan menghadiri output dari semua lapisan sebelumnya, memilih apa yang akan dibaca.
Dilakukan secara harfiah biaya ini menghitung kuadrat secara mendalam dan, lebih buruk lagi, menjaga output setiap lapisan tetap hidup dalam memori dan pada kabel di bawah paralelisme pipa. Jadi K3 menggunakan varian blok: 93 lapisan dipartisi menjadi dua belas kelompok, dijumlahkan dalam satu kelompok, perhatian penuh di seluruh kelompok. Overhead turun dari per-layer ke per-kelompok, dan keadaan inferensi-waktu tetap dibatasi.
Lebar: 896 ahli, 16 terjaga
Campuran-ahli menjaga kolam besar dan membangunkan beberapa per token. K2 memilih 8 dari 384. K3 memilih 16 dari 896 — jarang 56.
Menumbuhkan kolam yang jauh memecah dua hal, dan laporannya luar biasa langsung tentang keduanya.
Komunikasi. Dalam MoE konvensional, setiap ahli yang dipilih menerima token lebar penuh, sehingga lalu lintas menskalakan dengan berapa banyak yang Anda pilih. LatentMoE memisahkan keduanya: ahli yang dialihkan bekerja di ruang laten yang ringkas dengan setengah lebar model, sementara dua ahli bersama lebar penuh menangani apa yang dibutuhkan setiap token. Kolam dapat tumbuh tanpa biaya kawat yang tumbuh bersamanya.
Stabilitas. Pada kelangkaan ini, cabang yang dialihkan menjadi rantai hampir empat perkalian matriks berturut-turut, dan aktivasi meledak. Dua perbaikan: RMSNorm antara agregasi ahli dan proyeksi ke atas, dan aktivasi baru, SiTU-GLU, yang membatasi kedua faktor SwiGLU dengan tanh yang diskalakan sehingga tidak ada yang dapat melarikan diri dengan presisi rendah.
Keseimbangan. Perbaikan ketiga adalah yang layak dicuri. Menjaga sekitar 900 ahli dimuat secara merata berarti menyesuaikan bias per-ahli setiap langkah. Metode standar mendorong setiap bias dengan peningkatan tetap ke arah kesalahan, yang berosilasi atau tertinggal. K3 menyelesaikannya sebagai gantinya: jalankan top-(k+1) daripada top-k, dan entri tambahan Adalah Skor token menuntut untuk masuk. Dengan batas-batas itu di tangan, beban yang diterima seorang ahli di bawah bias kandidat adalah monoton, sehingga bias yang mengenai beban target hanyalah kuantil dari margin. Satu lintasan maju, tidak ada ukuran langkah untuk disetel.
Pada skala kuantil itu mencakup jutaan nilai di setiap peringkat, jadi mereka memperkirakannya dari histogram: setiap peringkat menghitung tempat sampahnya, satu pengurangan semuanya menjumlahkannya, kuantil dibaca dari hitungan yang dikumpulkan. Hitungan ditambahkan, sehingga perkiraan mencerminkan seluruh batch terlepas dari bagaimana token dipecah, dengan biaya beberapa ratus tempat sampah per ahli.
Tagihannya jatuh tempo di tumpukan penyajian
Tak satu pun dari ini gratis, dan bagian jujur dari laporan adalah bagian infrastruktur, di mana biaya mendarat.
Keadaan berulang ukuran tetap murah untuk disimpan dan murah untuk dipindahkan, tetapi diperbarui secara serial dan tidak hanya menambahkan. Kedua properti menciptakan pekerjaan:
- Membagi urutan di seluruh perangkat. Perhatian linier biasa memungkinkan setiap perangkat menghitung keadaan lokalnya dari nol dan menjumlahkan hasilnya. KDA menerapkan transisi yang bergantung pada token ke keadaan yang masuk, jadi penjumlahan salah. Perbaikan tersebut menguraikan setiap segmen menjadi transisi kumulatif dan keadaan nol-mulai - dua kuantitas yang menyusun - dan memulihkan setiap keadaan entri perangkat dengan pemindaian awalan dan satu pengumpulan semua ukuran tetap.
- Menggunakan kembali awalan di seluruh permintaan. Setengah dari cache adalah halaman per-token, setengahnya adalah satu keadaan tetap per permintaan, dan hit cache membutuhkan keduanya dapat dikembalikan pada batas yang sama. Jawaban mereka adalah untuk memisahkan granularitas: hash pada 512 token, mengalokasikan pada 1024–6144, dan pos pemeriksaan keadaan berulang hanya pada subset yang jarang dari titik akhir hash.
- Penguraian kode spekulatif. Pembaruan keadaan di tempat, sehingga draf yang ditolak tidak dapat dikembalikan. Sebagai gantinya, mereka menyimpan input yang diproyeksikan — jauh lebih kecil dari keadaan itu sendiri — dan membangun kembali pada chip.
Pola di ketiganya adalah salah satu dari peluruhan terikat, berjalan ke arah lain: arsitektur memilih representasi, dan representasi mendikte kerja sistem.
Satu kebiasaan kertas jatuh dengan tenang
K3 secara native multimodal, dan enkoder visinya dilatih dari awal dengan prediksi token berikutnya. Tidak ada inisialisasi SigLIP, tidak ada pra-pelatihan kontras — yang merupakan resep standar, termasuk dalam model tim sebelumnya.
Alasan yang dinyatakan bukan kualitas. Ini adalah stabilitas: encoder yang diinisialisasi secara kontras menunjukkan norma gradien yang terus-menerus lebih tinggi dengan lonjakan yang sering di bawah pengoptimalan sambungan, sementara yang dari awal tetap datar. Evaluasi penglihatan bahkan keluar.
Itu membuat temuannya lebih tajam daripada kemenangan yang seharusnya. Jika dari awal lebih baik, Anda akan menyebutnya resep yang lebih baik. Itu cocok - jadi klaimnya adalah bahwa pada skala ini, langkah yang diperlakukan lapangan sebagai wajib hanyalah opsional.
Apa artinya ini jika Anda menjalankan agen pada model-model ini
Kami membangun klien desktop multi-agen, jadi apa yang kami perhatikan adalah apakah jangka panjang tetap terjangkau, bukan apa yang berada di puncak papan peringkat.
Angka yang penting bukanlah ukuran jendela konteks; itu adalah berapa biaya satu juta token untuk melayani. Tiga perempat lapisan membawa keadaan ukuran tetap, sehingga cache yang tumbuh dengan percakapan adalah seperempat ukuran yang akan ada dalam model semua perhatian dengan kedalaman yang sama. Di BrowseComp, laporan menempatkan K3 pada 91,2% sekitar $2 per tugas - sekitar setengah dari biaya skor kepemilikan terdekat, dan urutan besarnya di bawah model Claude pada upaya maksimum.
Untuk agen yang menjalankan ratusan panggilan alat, rasio itu menentukan apakah suatu tugas layak untuk dicoba sama sekali. Pekerjaan arsitektur yang dulu dibaca sebagai penelitian murni sekarang muncul secara langsung dalam apakah jangka panjang itu waras secara ekonomi.
Apa yang kita ambil dari itu
Dua hal, keduanya dapat ditransfer.
Pertama, pembingkaian. Di mana informasi gagal mengalir? Menghasilkan pekerjaan yang berbeda dari Seberapa besar kita bisa pergi? — dan itu terurai, itulah sebabnya tiga mekanisme dapat dikembangkan dan diukur secara terpisah.
Kedua, pembusukan terikat. Kendala yang hampir tidak memerlukan biaya ekspresif menghapus seluruh jalur khusus dari kernel. Bukan jalan yang lebih cepat — tidak ada jalan. Perdagangan itu tersedia jauh lebih sering daripada yang diambil, dan hanya terlihat oleh orang-orang yang memegang matematika dan perangkat keras pada saat yang bersamaan.
Laporan dan bobotnya adalah Buka di GitHub. Bagian arsitektur terdiri dari delapan halaman dan membayar bacaan yang cermat.