
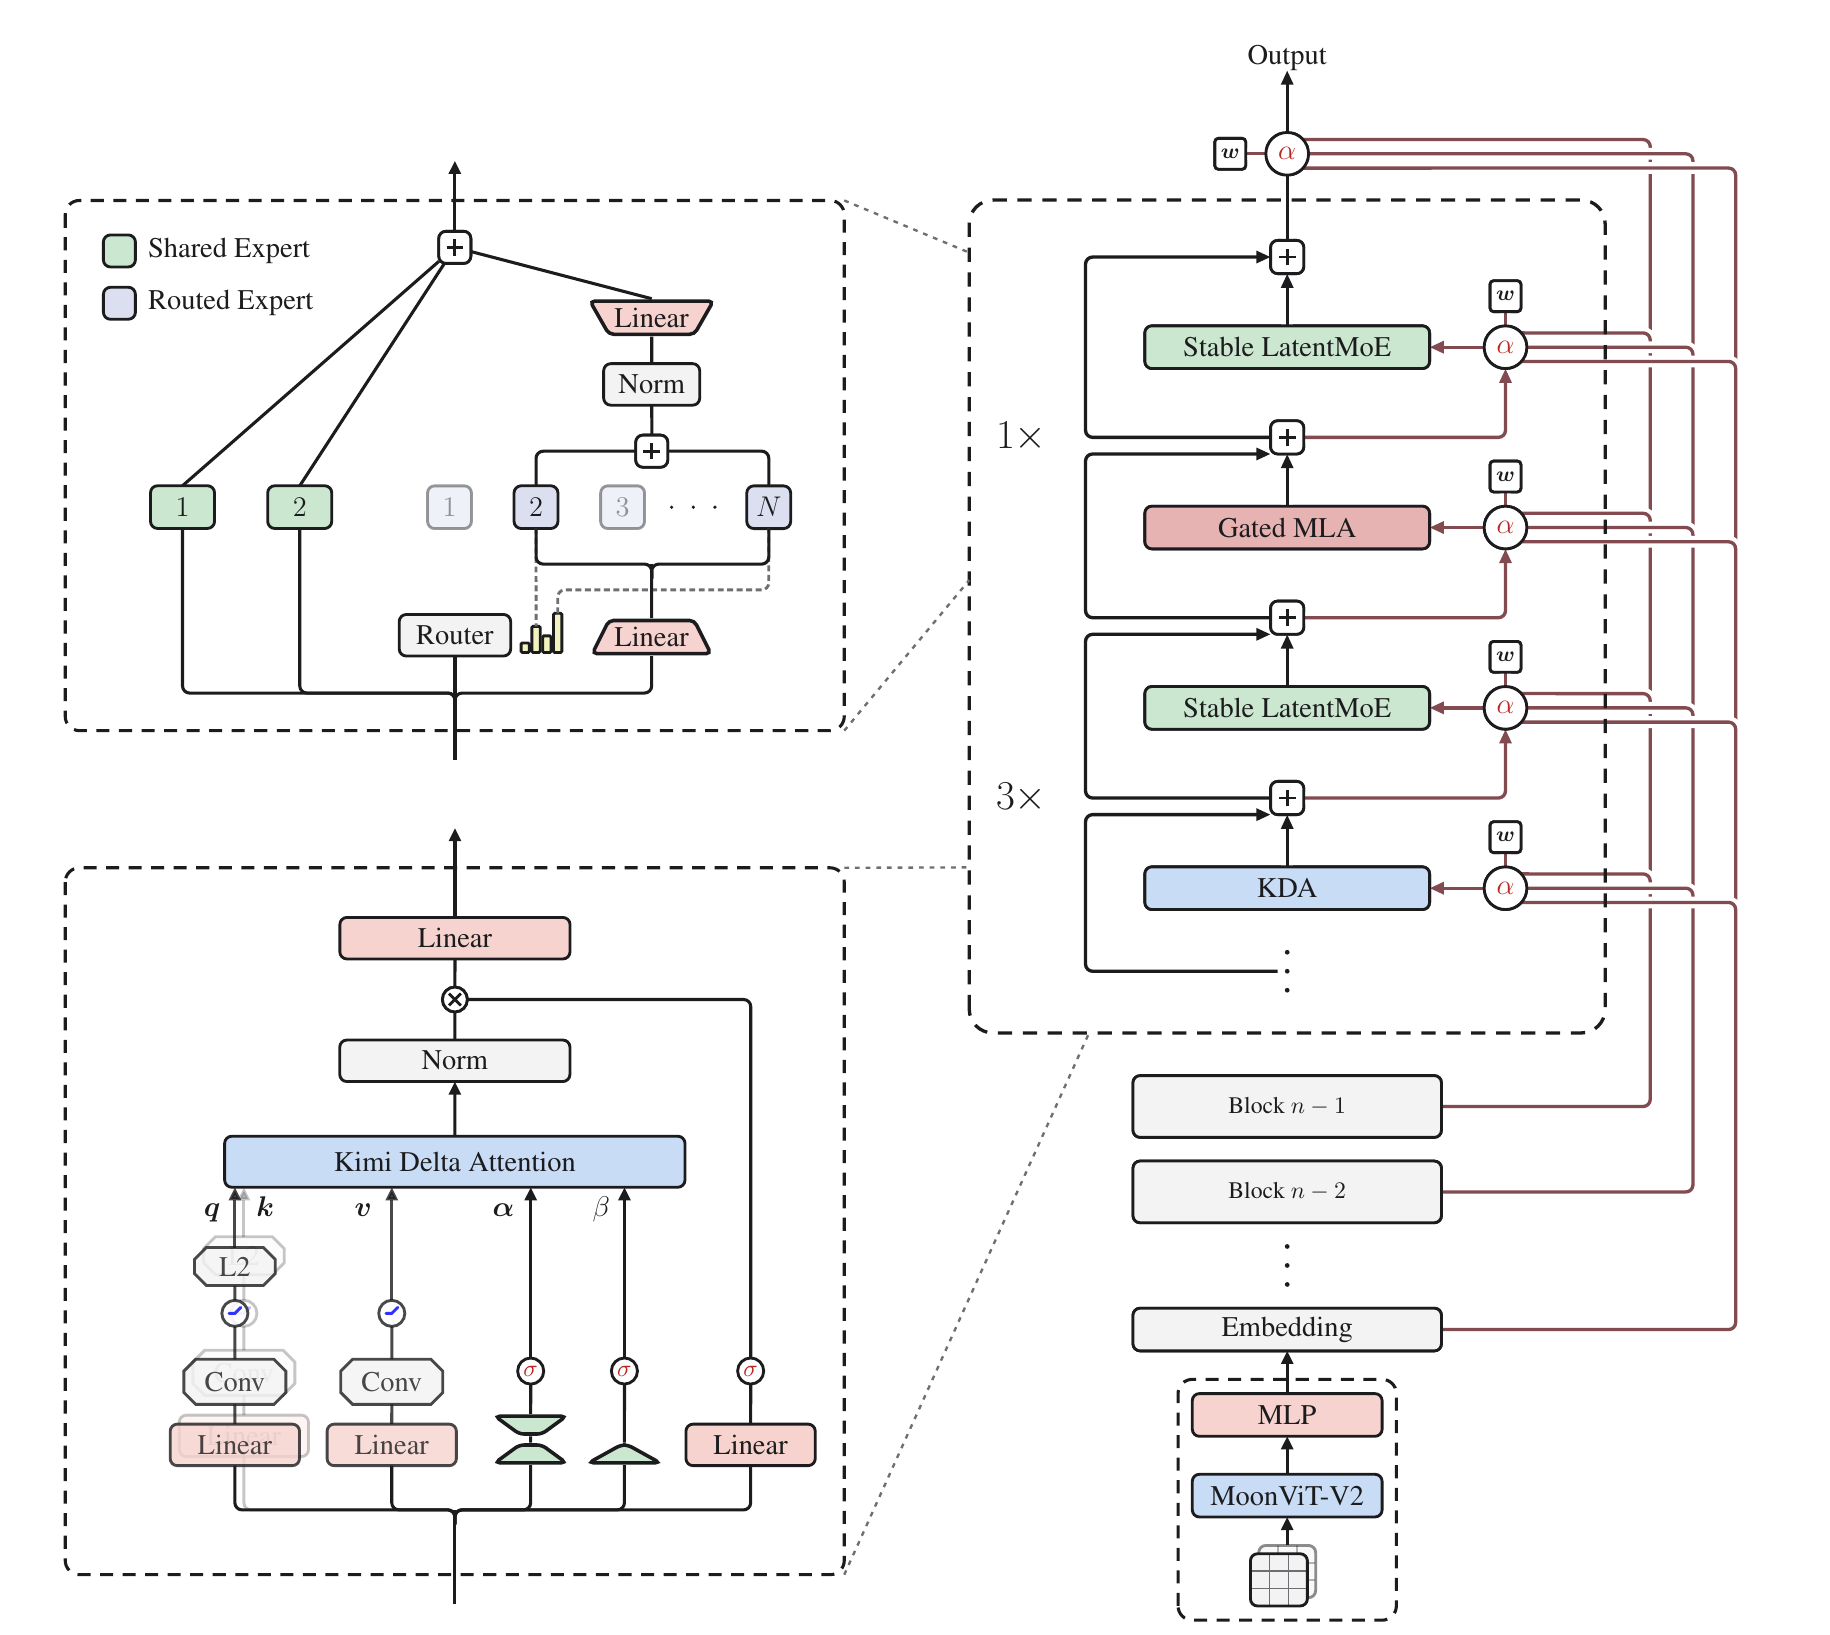
Kimi K3를 대표하는 수치는 매개변수 2.8조 개입니다. 하지만 보고서에서 가장 덜 흥미로운 숫자입니다.
흥미로운 점은 크기와 무관한 질문을 중심으로 아키텍처가 구성되어 있다는 것입니다. 정보는 어디서 제대로 흐르지 못하는가? 답은 시퀀스, 깊이, 너비의 세 부분으로 나뉘며 각각 고유한 메커니즘을 갖습니다.
같은 연산량에서 Kimi K2보다 확장 효율이 약 2.5배 높습니다. 이 수치는 제3자의 재현이 아니라 팀이 직접 적합한 스케일링 법칙 곡선에서 나왔으므로 그들의 주장으로 읽어야 합니다. 하지만 그 배후 메커니즘은 논의할 만큼 구체적이며, 그래서 시간을 들여 읽을 가치가 있습니다.
이 글은 Moonshot AI의 Kimi K3 기술 보고서를 아키텍처 절에 집중해 자세히 읽은 내용입니다. 앞서 장기 에이전트 설계를 다뤘다면, 이번 글은 기술 스택의 더 아래쪽을 다룹니다.
숫자 하나가 아니라 세 방향
트랜스포머의 모든 층은 세 가지 방식으로 정보를 혼합합니다. 900,000번째 위치가 1번째 위치에 영향을 줄 수 있도록 토큰 사이에서, 90번째 층이 3번째 층에서 포착한 것을 쓸 수 있도록 깊이 방향에서, 특징을 재조합할 수 있도록 채널 사이에서 혼합합니다.
대부분의 확장 연구는 모든 것을 키워 세 방향을 한꺼번에 움직입니다. K3는 이를 분리하고 각각 고유한 메커니즘을 부여합니다.
- 시퀀스 — 하이브리드 어텐션: Gated MLA 층 하나당 Kimi Delta Attention 층 세 개를 배치합니다.
- 깊이 — Attention Residuals: 각 층이 하나의 누적 상태를 물려받는 대신 앞선 모든 층의 출력에 어텐션을 적용합니다.
- 너비 — Stable LatentMoE: 라우팅 전문가 896개 중 토큰당 16개를 활성화합니다.
은닉 차원은 전혀 바뀌지 않았습니다. K2도 7,168, K3도 7,168입니다. 무엇이 커졌든 층의 너비는 아닙니다.
시퀀스: 층의 4분의 3이 전체를 읽지 않게 되었습니다
표준 어텐션은 새 토큰마다 전체 접두부를 다시 읽습니다. 토큰이 100만 개가 되면 이 비용이 한계를 드러냅니다.
K3는 일을 나눕니다. KDA 층 세 개는 원문을 다시 읽기보다 메모하듯 고정 크기의 누적 상태를 유지하고, 다음 Gated MLA 층 하나가 전체 전역 어텐션을 수행합니다. 이 패턴이 반복되며 마지막에 MLA 층을 하나 더 두어 최종 층은 항상 전체를 봅니다. 총 93개 층 중 KDA 69개, MLA 24개입니다.
고정 크기가 핵심입니다. 상태가 시퀀스에 따라 커지지 않으므로 폭증할 수 없습니다. 다만 정보 손실이 있으므로 네 번째 층마다 전체 어텐션 층을 넣어 메모에서 빠진 것을 복구합니다.
여기서 2차 효과가 생깁니다. 순환 상태에는 감쇠가 있어 최근 토큰이 오래된 토큰보다 자연스럽게 더 많이 남으므로 위치 정보가 저절로 따라옵니다. 그래서 K3는 전역 어텐션 층에 위치 인코딩을 전혀 적용하지 않습니다 . RoPE도 없고 재조정할 것도 없습니다.
따라서 100만 토큰으로 확장할 때 위치 인코딩을 손댈 필요가 없었습니다. 보간할 인코딩 자체가 없으므로 이 분야에서 맥락 확장을 위해 축적한 보간 기법은 여기에 적용되지 않습니다.
GPU 코드 경로 하나를 없앤 하한
보고서에서 우리가 가장 좋아하는 부분이며, 짧아서 지나치기 쉬운 대목입니다.
순환 상태는 진행하면서 잊습니다. 이를 청크 단위로 효율적으로 계산하려면 누적 감쇠로 나눠야 하며, 누적 감쇠는 1보다 작은 수들의 곱입니다. 제한 없이 두면 0에 한없이 가까운 값으로 나누게 됩니다.
이전 세대는 각 청크를 16토큰 타일로 나누고 로그 공간에서 계산해 처리했습니다. 작동은 했지만 대각선 타일은 여전히 위치 쌍마다 계산해야 했습니다. 텐서 코어를 쓰지 못하는 느린 특수 처리 경로였습니다.
K3의 해결책은 매개변수화 한 줄입니다. 로그 감쇠에 하한을 둡니다. 각 단계는 보유하던 정보의 0.67%까지 남기며 잊을 수 있지만 그 아래로는 못 내려갑니다.
결과를 따라가 보세요. 이 하한이 있으면 16토큰 타일의 누적 로그 감쇠는 (−80, 0) 안에 머뭅니다. 따라서 역수는 e80 ≈ 5.5 × 1034보다 작으며, 약 3.4 × 1038인 BF16 범위 안에 여유 있게 들어갑니다. 오버플로가 발생하지 않습니다. 그래서 대각선 타일도 다른 모든 타일과 같은 밀집 행렬 곱셈을 쓸 수 있습니다.
특수 경로를 최적화한 것이 아닙니다. 없애 버렸습니다.
인과관계를 거꾸로 읽으면 더 흥미롭습니다. 하드웨어의 동적 범위가 허용 구간을 정하고, 그 구간이 상수를 정하고, 그 상수가 활성화 함수에 하한이 필요하다는 것을 정했습니다. 수학이 수치 연산을 고른 것이 아니라 수치 연산이 수학을 골랐습니다.
깊이: 릴레이에서 단체 채팅으로
깊이 93개 층에서 표준 잔차 스트림은 릴레이와 같습니다. 50번째 층은 49번째 층에서 누적 상태 하나를 받습니다. 1~48번째 층이 각각 포착한 것은 모두 그 상태에 더해져 더 이상 분리할 수 없습니다.
논문은 이를 RNN이 시간축에서 겪는 것과 같은 병목으로 봅니다. 이 분야는 이미 어텐션으로 그 문제를 해결했습니다. Attention Residuals는 같은 해결책을 깊이에 적용합니다. 각 층은 학습 가능한 의사 쿼리를 갖고 앞선 모든 층의 출력에 어텐션을 적용해 읽을 것을 고릅니다.
그대로 구현하면 연산량이 깊이의 제곱으로 늘고, 더 나쁘게는 파이프라인 병렬화에서 모든 층의 출력을 메모리와 통신 경로에 계속 유지해야 합니다. 그래서 K3는 블록 변형을 씁니다. 93개 층을 12개씩 묶고 그룹 내부에서는 합산하며 그룹 사이에는 전체 어텐션을 적용합니다. 오버헤드는 층 단위에서 그룹 단위로 줄고 추론 시 상태 크기도 제한됩니다.
너비: 전문가 896개 중 16개 활성화
전문가 혼합은 큰 풀을 유지하고 토큰마다 일부만 깨웁니다. K2는 384개 중 8개를 골랐습니다. K3는 896개 중 16개를 고르며 희소도는 56입니다.
풀을 이만큼 키우면 두 가지가 문제가 되는데, 보고서는 둘 다 이례적으로 직접 설명합니다.
통신. 기존 MoE에서는 선택된 모든 전문가가 전체 너비의 토큰을 받으므로 선택 수에 따라 통신량이 늘어납니다. LatentMoE는 둘을 분리합니다. 라우팅 전문가는 모델 너비의 절반인 압축 잠재 공간에서 작업하고, 전체 너비를 가진 공유 전문가 두 개가 모든 토큰에 필요한 것을 처리합니다. 통신 비용을 함께 늘리지 않고도 풀을 키울 수 있습니다.
안정성.이 희소도에서 라우팅 분기는 거의 네 번 연속되는 행렬 곱셈이 되어 활성값이 폭증합니다. 해결책은 두 가지입니다. 전문가 집계와 상향 투영 사이의 RMSNorm, 그리고 새로운 활성화 함수 SiTU-GLU입니다. SiTU-GLU는 크기를 조정한 tanh로 SwiGLU의 두 인자를 모두 제한해 낮은 정밀도에서 어느 쪽도 폭주하지 못하게 합니다.
균형. 세 번째 해결책은 가져다 쓸 만합니다. 약 900개 전문가의 부하를 고르게 유지하려면 매 단계 전문가별 편향을 조정해야 합니다. 표준 방법은 오차 방향으로 고정된 증분만큼 편향을 움직이는데, 진동하거나 뒤처집니다. K3는 대신 해를 구합니다. top-k 대신 top-(k+1)을 실행하면 추가 항목이 바로 토큰이 진입하기 위해 요구하는 점수입니다. 이 기준값을 알면 후보 편향에 따른 전문가 부하가 단조적이므로 목표 부하를 맞추는 편향은 단순히 마진의 분위수입니다. 순전파 한 번이면 되고 조정할 스텝 크기도 없습니다.
대규모에서는 그 분위수가 모든 랭크에 걸친 수백만 개 값에 해당하므로 히스토그램으로 추정합니다. 각 랭크가 구간별 개수를 세고, 한 번의 all-reduce로 합친 뒤 통합된 개수에서 분위수를 읽습니다. 개수는 더할 수 있으므로 토큰을 어떻게 분할하든 추정치는 전체 배치를 반영하며, 비용은 전문가당 구간 몇백 개 수준입니다.
비용은 서빙 스택에서 돌아옵니다
이 모든 것이 공짜는 아닙니다. 보고서의 솔직한 부분은 그 비용이 나타나는 인프라 절입니다.
고정 크기 순환 상태는 저장과 이동이 저렴하지만 순차적으로 업데이트되며 단순히 더할 수 없습니다. 두 속성 모두 추가 작업을 만듭니다.
- 시퀀스를 여러 기기에 나누기. 일반적인 선형 어텐션은 각 기기가 0에서 로컬 상태를 계산한 뒤 결과를 합칠 수 있습니다. KDA는 입력 상태에 토큰 의존 전이를 적용하므로 합산하면 틀립니다. 해결책은 각 구간을 누적 전이와 0에서 시작한 상태라는 합성 가능한 두 양으로 분해하고, 접두부 스캔과 고정 크기 all-gather 한 번으로 각 기기의 시작 상태를 복구하는 것입니다.
- 요청 간 접두부 재사용. 캐시의 절반은 토큰별 페이지이고 절반은 요청별 고정 상태 하나입니다. 캐시 적중을 활용하려면 둘 다 같은 경계에서 복원할 수 있어야 합니다. 해결책은 세분화 단위를 분리하는 것입니다. 해시는 512토큰마다, 할당은 1024–6144토큰 단위로 하고, 순환 상태는 일부 해시 종료점에만 드물게 체크포인트를 만듭니다.
- 추측 디코딩. 상태가 제자리에서 업데이트되므로 거부된 초안을 롤백할 수 없습니다. 대신 상태 자체보다 훨씬 작은 투영 입력을 캐시하고 칩 안에서 다시 구성합니다.
세 경우의 공통 패턴은 감쇠 하한 사례를 반대 방향으로 실행한 것입니다. 아키텍처가 표현을 골랐고, 그 표현이 시스템 작업을 결정했습니다.
논문이 조용히 버린 관행 하나
K3는 기본적으로 멀티모달이며 비전 인코더를 다음 토큰 예측으로 처음부터 학습합니다. SigLIP 초기화도, 대조 사전학습도 없습니다. 팀의 이전 모델을 포함해 표준 방식으로 쓰이던 과정입니다.
명시된 이유는 품질이 아니라 안정성입니다. 대조 학습으로 초기화한 인코더는 공동 최적화에서 지속적으로 더 높은 기울기 노름과 잦은 급등을 보였지만 처음부터 학습한 인코더는 평탄하게 유지되었습니다. 비전 평가 결과는 비슷했습니다.
오히려 이겼을 때보다 발견이 더 선명해집니다. 처음부터 학습한 쪽이 더 좋았다면 더 나은 방법이라고 했을 것입니다. 동등했으므로, 이 규모에서는 업계가 필수로 여기는 단계가 사실 선택 사항이라는 주장입니다.
이 모델로 에이전트를 실행한다면 무엇을 의미할까요
우리는 멀티 에이전트 데스크톱 클라이언트를 만듭니다. 그래서 순위표 1위가 무엇인지보다 긴 실행의 비용을 감당할 수 있는지에 주목합니다.
중요한 수치는 맥락 창 크기가 아니라 100만 토큰을 서빙하는 비용입니다. 층의 4분의 3은 고정 크기 상태를 유지하므로 대화와 함께 커지는 캐시는 같은 깊이의 전체 어텐션 모델에 비해 4분의 1 크기입니다. 보고서에 따르면 BrowseComp에서 K3는 작업당 약 $2로 91.2%를 기록합니다. 가장 가까운 점수의 독점 모델 비용의 약 절반이고, 최대 추론 강도의 Claude 모델보다 약 10분의 1 수준입니다.
수백 번의 도구 호출을 실행하는 에이전트에는 이 비율이 작업을 시도할 가치가 있는지 자체를 결정합니다. 예전에는 순수 연구처럼 읽히던 아키텍처 작업이 이제 긴 실행의 경제적 타당성에 직접 영향을 줍니다.
우리가 얻은 것
두 가지이며 모두 다른 곳에도 적용할 수 있습니다.
첫째는 질문의 틀입니다. 정보는 어디서 제대로 흐르지 못하는가?는 다음 질문과 다른 작업을 이끕니다. 얼마나 더 키울 수 있는가? 또한 문제를 분해할 수 있어 세 메커니즘을 별도로 개발하고 측정할 수 있었습니다.
둘째는 감쇠 하한입니다. 표현력을 거의 희생하지 않는 제약으로 커널의 특수 처리 경로 하나를 통째로 없앴습니다. 더 빠른 경로가 아니라 경로 자체의 제거입니다. 이런 절충은 실제 채택되는 것보다 훨씬 자주 가능하며, 수학과 하드웨어를 동시에 이해하는 사람에게만 보입니다.
보고서와 가중치는 GitHub에 공개되어 있습니다. 아키텍처 절은 8페이지이며 꼼꼼히 읽을 가치가 있습니다.