
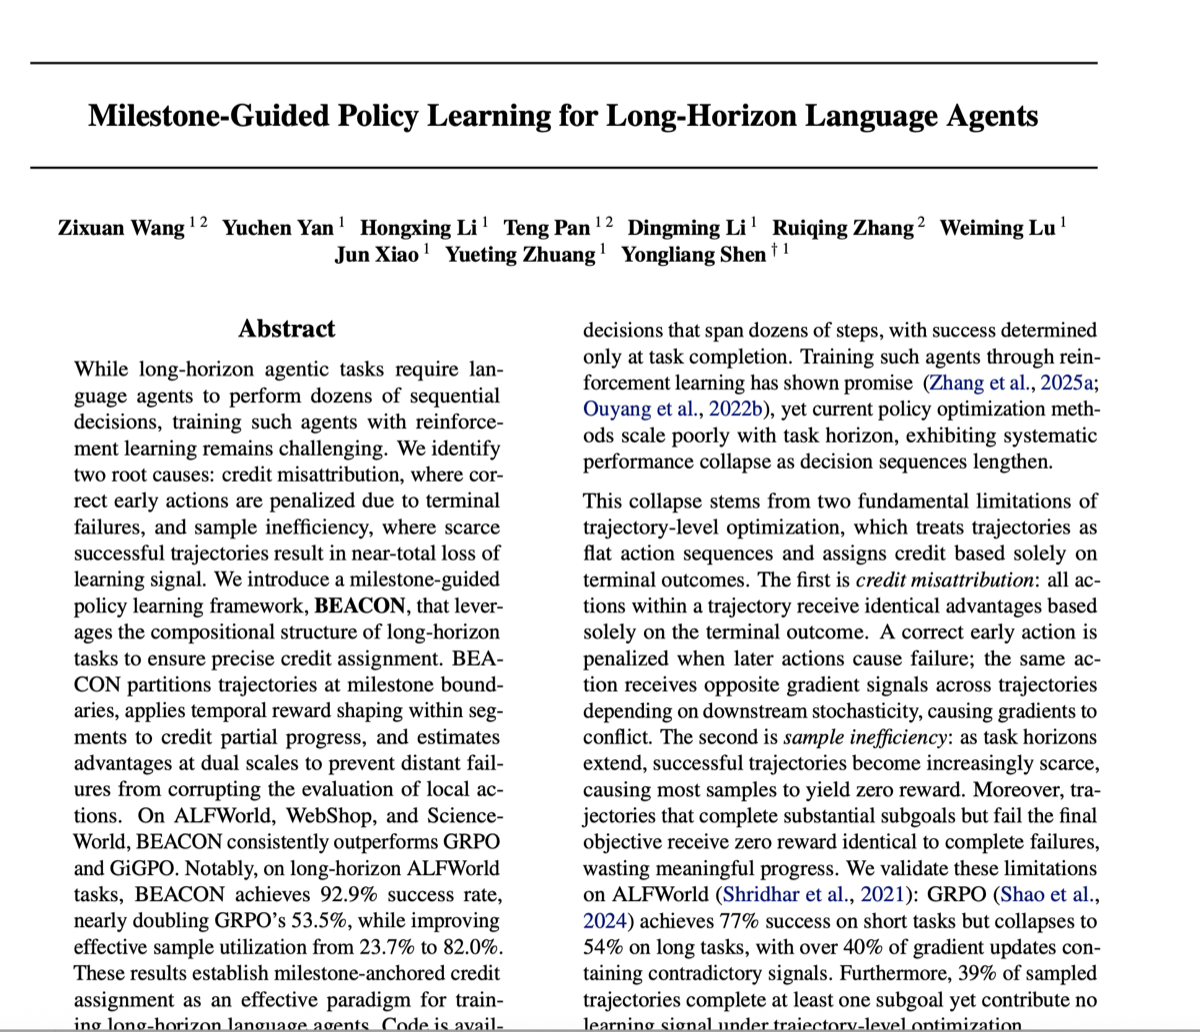
Os agentes de longo horizonte — aqueles que executam dezenas de passos antes de algo estar comprovadamente concluído — falham de uma forma que os agentes de horizonte curto não falham. O desempenho não se degrada gradualmente à medida que as tarefas se tornam mais longas. Cai a pique.
Um artigo recente do laboratório ZJU-REAL da Universidade de Zhejiang, Aprendizagem de políticas orientada por marcos para agentes de linguagem de longo horizonte, diagnostica esta queda abrupta com precisão suficiente para ser útil mesmo que nunca treine uma política. O método chama-se BEACON; o código é aberto.
Lemos com atenção porque o problema descrito é o mesmo que encontramos repetidamente no desenvolvimento do produto. A seguir: o argumento do artigo, um ponto em que precisamos de refazer os cálculos para conciliar um resultado, e o que acreditamos ser aplicável à arquitetura de agentes.
Dois modos de falha, ambos mensuráveis
O que mais valorizamos é que o artigo não começa pelo método. Começa por uma autópsia: Qwen2.5-1.5B treinado com GRPO no ALFWorld, com o colapso decomposto em duas causas quantificadas.
Atribuição incorreta de crédito
A aprendizagem por reforço ao nível da trajetória trata uma execução como uma sequência plana de ações. Todas as ações partilham uma única pontuação terminal. Assim, a mesma ação correta recebe um gradiente positivo numa execução bem-sucedida e negativo numa que falhou — se estava "certa" depende do que aconteceu depois.
Os autores quantificam isso como Rácio de Ações Contraditórias: a fração de ações que recebem vantagens de sinais opostos entre trajetórias, apesar de serem executadas em estados idênticos. O pico ultrapassa 40%. Depois de esses gradientes se anularem, o sinal efetivo de aprendizagem cai abaixo de 20%.
Ineficiência de amostras
Separe as trajetórias em três grupos — sucesso total, sucesso parcial (pelo menos um subobjetivo concluído, mas a tarefa continua sem sucesso) e falha total:
- Os sucessos parciais mantêm-se em 39–47% das amostras ao longo do treino.
- Os sucessos totais ficam abaixo de 27%.
No GRPO, o sucesso parcial e a falha total recebem igualmente uma pontuação de zero. Mais de 73% das amostras não produzem qualquer sinal de aprendizagem.
Os dois problemas agravam-se em conjunto com o horizonte: as tarefas mais longas têm uma taxa de sucesso inferior (mais sucessos parciais) e dão à aleatoriedade posterior mais oportunidades de corromper o crédito. Concretamente, no ALFWorld: 76,7% em tarefas curtas, 53,5% nas longas.
A ideia central: as tarefas longas já têm estrutura
As tarefas de longo horizonte decompõem-se em fases delimitadas por marcos — transições de estado verificáveis que assinalam a conclusão de um subobjetivo. A otimização plana simplesmente descarta essa estrutura.
Os autores formalizam isso como a Propriedade de Markov de Marcos: uma vez alcançado um estado de marco, a distribuição sobre o resto da trajetória depende principalmente dos subobjetivos que faltam, não de todo o histórico de como lá chegou.
Depois de ter a chave, o que acontece a seguir depende do que faz com ela — não de como a encontrou.
É essa propriedade de Markov aproximada que permite dissociar o crédito entre segmentos.
O método, em três passos
1. Dividir nos marcos
Um detetor Φ assinala os instantes dos marcos e divide a trajetória em segmentos. A decisão de conceção que consideramos subestimada: Φ não precisa de um modelo treinado nem de anotação humana. Lê alterações de estado observáveis diretamente das respostas do ambiente — transições de estado de objetos no ALFWorld, transições de página no WebShop, sinais explícitos de subobjetivo no ScienceWorld.
Zero modelos adicionais, zero execuções adicionais. Esta é toda a vantagem de custo face aos modelos de recompensa de processo e à estimação de valor por Monte Carlo.
2. Modelação temporal da recompensa dentro de cada segmento
r_t = R_ms * γ^(t_k − t)   if segment k ends in a completed milestone
    = 0                    otherwise
Só segmentos que terminam num marco recebem uma recompensa, e dentro deles as ações mais próximas do marco recebem mais. Todas as ações de um segmento concluído passam a transmitir sinal, pelo que os sucessos parciais deixam de ser descartados.
3. Vantagem em escala dupla
O nível da trajetória corresponde à normalização GRPO padrão sobre as recompensas terminais. A ideia está no nível do segmento — na definição do grupo de comparação:
G_k = { i : K_i ≥ k }          # only trajectories that ALSO reached milestone k

A_seg(i,t) = r_t − (1/|G_k|) · Σ_{j∈G_k}  R_k(j) / |Seg_k(j)|
                               └── group-average PER-STEP return ──┘
Ações no segmento k são comparadas apenas com trajetórias que também alcançaram o marco k. Daqui, os autores derivam uma propriedade de isolamento da variância: o sucesso ou fracasso de segmentos posteriores não pode, matematicamente, contaminar o crédito do segmento atual.
A vantagem final é A_traj + λ · A_seg, otimizada com uma função objetivo substituta PPO padrão. Os hiperparâmetros γ=0.95, λ=1.0 são fixos em todos os testes de referência — sem ajuste por tarefa.
Resultados
ALFWorld, Qwen2.5-1.5B:
| Método | Curta | Média | Longa | Média geral |
|---|---|---|---|---|
| GRPO | 76,7 | 73,9 | 53,5 | 72,8 |
| GiGPO | 90,7 | 84,3 | 79,5 | 86,1 |
| BEACON | 96,8 | 87,0 | 92,9 | 91,4 |
Taxa de sucesso nos outros dois ambientes:
| Método | ScienceWorld | WebShop |
|---|---|---|
| GRPO | 21,1 | 56,8 |
| GiGPO | 25,8 | 65,0 |
| BEACON | 45,3 | 75,6 |
O modelo de 1,5B supera o GPT-4o no ALFWorld (91,4 contra 48,0) e no WebShop (75,6 contra 23,7), e empata no ScienceWorld (45,3 contra 45,4). Uma ressalva justa: os modelos fechados são usados com um prompt ReAct, não são treinados. A utilização das amostras sobe de 23,7% para 82,0%, e a convergência é mais rápida — 60% de sucesso na iteração 50, contra a iteração 120 do GRPO.
O resultado mais convincente é que os ganhos aumentam com o horizonte. No 7B, a melhoria relativa sobre o GRPO vai de +13% em tarefas curtas a +39% nas longas; o GiGPO só vai de +11% a +22%. A razão é importante: o GiGPO cria grupos de comparação ao nível do passo a partir de estados repetidos, e à medida que a política melhora e as trajetórias se diversificam, a recorrência de estados torna-se mais rara — a sua própria fonte de sinal vai-se desgastando. As âncoras de marco não se degradam à medida que a política se torna mais forte.
Um método cujo benefício cresce à medida que o problema se torna mais difícil sustenta uma afirmação muito mais forte do que uma média superior.
A métrica que parece uma contradição
O artigo define um Rácio de Concentração de Crédito — a magnitude média da vantagem nas ações de marco dividida pela das ações que não são de marco. Acima de 1 significa que o crédito se concentra nos marcos.
| Método | CCR |
|---|---|
| GiGPO | 2,36 |
| GRPO | 1,37 |
| BEACON | 0,84 |
Ou seja, o método de melhor desempenho é o que menos concentra crédito nos passos-chave — o que se pode ler como uma contradição direta de "ações mais próximas do marco recebem mais recompensa". Não é. As duas afirmações medem quantidades diferentes, com duas transformações pelo meio.
Transformação 1 — recompensa modelada. Dentro de um segmento, a recompensa cresce de facto monotonicamente em direção ao marco. Com γ=0.95 e segmento de comprimento 5, as cinco ações recebem 0.8145, 0.857, 0.9025, 0.95, 1.0. Mas isso é recompensa, não o crédito que chega ao gradiente.
Transformação 2 — subtrair o valor de referência do grupo. O valor de referência é o retorno médio por passo do grupo (retorno do segmento ÷ comprimento do segmento). Para um segmento de comprimento L, o retorno por passo é (1−γ^L) / (L(1−γ)):
| Comprimento | 3 | 5 | 8 | 10 |
|---|---|---|---|---|
| Retorno por passo | 0,951 | 0,905 | 0,842 | 0,803 |
Se o seu segmento demorou 8 passos enquanto a média do grupo foi 5, o seu retorno por passo fica abaixo do valor de referência e a vantagem do segmento inteiro tende a ser negativa. Repare no que isso significa: a penalização por rodeios não vem do decaimento em si — vem do decaimento a atuar através do valor de referência por passo. O decaimento, por si só, apenas ordena ações dentro de um segmento. Até aqui, o CCR dentro de um segmento concluído ainda é maior do que 1.
Transformação 3 — somar o termo de trajetória. É aqui que o CCR cai abaixo de 1, por dois efeitos assimétricos. Primeiro, o segmento final de uma trajetória que falhou não entra em nenhum grupo de comparação: como G_k = {i : K_i ≥ k} e a cauda incompleta tem índice K_i + 1 > K_i, essa trajetória fica de fora. A cauda não recebe vantagem de segmento, apenas o termo de trajetória com a magnitude total — e todas essas ações são ações que não são de marco, aumentando o denominador. Segundo, nas trajetórias que falharam, o termo negativo de trajetória cancela o crédito positivo de segmento nas ações de marco, comprimindo a sua magnitude para perto de zero.
A própria Figura 8 do artigo confirma. Numa trajetória que falhou após concluir os marcos S3 e S4:
| ir à sanita | colocar sabonete (S3✓) | ir à bancada (S4✓) | ir à bancada | ir ao suporte | |
|---|---|---|---|---|---|
| GRPO | −2,50 | −2,50 | −2,50 | −2,50 | −2,50 |
| BEACON | −0,92 | +0,51 | +0,32 | −2,20 | −2,20 |
Os dois últimos valores são idênticos — a impressão digital de "o segmento final só recebe o termo de trajetória", o que permite ler A_traj ≈ −2.20. As duas ações de marco são positivas, mas com magnitude de apenas ~0,5, porque o termo negativo de trajetória consumiu a maior parte do crédito de segmento. O CCR dessa trajetória é 0,23; numa trajetória bem-sucedida é 2,95. O 0,84 global é a mistura.
Portanto o CCR mede a concentração da magnitude do gradiente, não quem foi recompensado. Um CCR baixo não é um objetivo de conceção — é um subproduto da atribuição densa dentro do segmento somada à sobreposição em duas escalas. A conclusão dos autores continua válida, e é boa: não concentre toda a energia do gradiente nos passos-chave. O 2,36 do GiGPO significa que as ações preparatórias intermédias quase não recebem sinal — e são exatamente elas que tornam possível alcançar um marco.
Algo que o artigo não explicita
Há uma célula estranha na tabela de ablação. Definir γ=1 — crédito uniforme dentro de cada segmento — dá 71,8, pior do que sem qualquer modelação (γ=0, 81,2) e até abaixo dos 72,8 do GRPO. O artigo atribui isso a "gradientes enganosos".
Refazendo os cálculos, a resposta é mais incisiva. Com γ=1, cada ação de um segmento concluído recebe a mesma recompensa, pelo que cada segmento concluído — independentemente do comprimento — tem um retorno por passo exatamente igual a R_ms. O valor de referência é igual a isso, e:
A_seg(i,t) ≡ R_ms − R_ms = 0 for every actionO canal de segmento não engana. Ele desaparece identicamente, e o método reduz-se exatamente ao GRPO. Confirme na tabela: 71,8 contra 72,8 do GRPO — um ponto de diferença, que é ruído entre execuções.
Isto muda o enquadramento da função do decaimento. Não serve apenas para diferenciar ações dentro de um segmento; é condição necessária para que o sinal de segmento exista. Sem ele, o valor de referência por passo cancela imediatamente o sinal.
Três experiências que resolvem as objeções óbvias
Dê-se o devido crédito — os autores antecipam-se às três perguntas de um leitor cético:
- Isto não é apenas clonagem de comportamento? O SFT sobre trajetórias de oráculo chega a 43%; o BEACON chega a 91,4%. A política encontra estratégias melhores do que as do oráculo, pelo que não está a imitar.
- Os ganhos vêm apenas da segmentação? A divisão aleatória dá 74,2%, apenas 1,4 pontos acima do GRPO. Os marcos reais dão 91,4% — uma diferença de 17,2 pontos. O benefício vem da estrutura intrínseca à tarefa.
- E se o detetor for pouco fiável? Descartar aleatoriamente 50% dos marcos ainda permite obter 82,8%, dez pontos acima do GRPO. A degradação é suave.
O que se transfere para a conceção de agentes
O BEACON é um método de treino, e a maioria dos produtos — incluindo o nosso — orquestra modelos em vez de os treinar. As fórmulas não se transferem. O diagnóstico sim, e traduz-se na arquitetura de forma surpreendentemente direta.
O progresso parcial tem de ser um estado de primeira classe e ficar guardado de forma persistente. O dado mais incisivo do artigo é que 39–47% das execuções concluem subobjetivos reais e recebem a mesma pontuação que as execuções que não fizeram nada. Uma sessão longa de um agente que conclui três subobjetivos e depois bloqueia tem o mesmo problema: se o sistema regista apenas "em execução" e "concluído", esse progresso é deitado fora e a nova tentativa começa do zero. Os marcos fornecem o vocabulário para o registar.
Os marcos devem resultar de efeitos secundários observáveis, não do que o próprio agente relata. Φ tem um custo baixo porque lê transições de estado verificáveis em vez de perguntar à política se houve progresso. Os ambientes de execução de agentes têm o mesmo recurso disponível e ignoram-no frequentemente: um ficheiro escrito, um teste que terminou com o código zero, uma chamada de conector que devolveu sucesso, um documento guardado na base de conhecimento. Isso são factos observáveis no terreno. Um modelo a afirmar "passo um concluído" não é.
As fronteiras dos marcos são pontos fundamentados para compactação e retoma. A Propriedade de Markov de Marcos diz que, alcançado um marco, o que veio antes importa muito menos. É uma justificação muito melhor para compactar o contexto do que "atingimos o limite de tokens", e a mesma fronteira é o ponto de controlo natural para retomar após uma falha.
Verifique em duas escalas, não numa. Esta é a ablação que sublinharíamos para quem constrói fluxos de agentes: remover o sinal de trajetória faz descer o ALFWorld de 91,4% para 23,4%. Apenas com feedback de segmento, a política reforça comportamentos que atingem marcos intermédios enquanto se desviam do objetivo real — cada subtarefa executada na perfeição, o resultado entregue errado. A aceitação da subtarefa e a aceitação do resultado final não se substituem. Note-se que o peso necessário varia consoante a tarefa: o WebShop ainda mantém 67,9% sem o nível de trajetória, porque os seus marcos estão estreitamente alinhados com o sucesso final; o ALFWorld colapsa.
Limitações, ditas com honestidade
A maior restrição é se Φ é sequer possível de obter. Os três testes de referência derivam marcos de regras — correspondência de padrões nas respostas do ambiente, transições de página, sinais explícitos de subobjetivo. Cenários abertos como a automatização do navegador, a refatoração de bases de código e a pesquisa aprofundada não dispõem dessas transições verificáveis prontas a usar, e os autores identificam a descoberta automática de marcos como um problema em aberto. Isto deve ser lido como um paradigma validado em ambientes estruturados, não como uma receita de engenharia pronta a aplicar.
A granularidade dos marcos também é sensível: demasiado esparsa e o método degenera em direção ao GRPO; demasiado densa e as vantagens de segmento tornam-se ruído. A propriedade de Markov é apenas aproximada, e o isolamento da variância apoia-se nela. As experiências ficam pelos 7B com espaços de ação textuais discretos — o controlo contínuo e os cenários multiagente não foram testados.
Ainda assim, a tese central é difícil de contestar: as tarefas longas têm uma estrutura composicional explorável, e tratar essa estrutura como um objeto de primeira classe dá melhores resultados do que esperar que o modelo a acompanhe no contexto. Estamos a aplicar esse raciocínio ao suporte a tarefas de longo horizonte no Orkas, e partilharemos mais pormenores da conceção à medida que esta avançar.