
이번 달, 실시간 동영상 모델 두 개가 일주일 간격으로 나왔습니다. ShengShu의 Vidu S2가 9월 15일에 공개됐고, PixVerse는 9월 22일에 PixVerse R2를 발표했습니다. S2는 라이브 디지털 캐릭터와, 재생 중인 동영상 스트림을 실시간으로 바꾸는 데 초점을 맞췄습니다. R2는 스스로를 실시간 월드 모델이라고 부릅니다. WASD로 장면 안을 움직이는 동안 텍스트, 참조, 오디오로 다음에 일어날 일을 바꿀 수 있습니다.
두 팀 모두 만든 방법을 공개했습니다. S2는 arXiv 논문으로, R2는 PixVerse 사이트의 기술 보고서로 냈습니다. 저희는 두 자료를 나란히 놓고 읽었습니다. 뼈대는 같고, 다섯 가지 설계 선택에서 갈라지며, 공개한 정보의 양은 크게 다릅니다. 이 글은 세 가지를 모두 다루지만 일부러 승자를 정하지 않습니다. 두 모델은 같은 테스트에서 측정된 적이 한 번도 없기 때문입니다.
실시간이 바꾸는 것
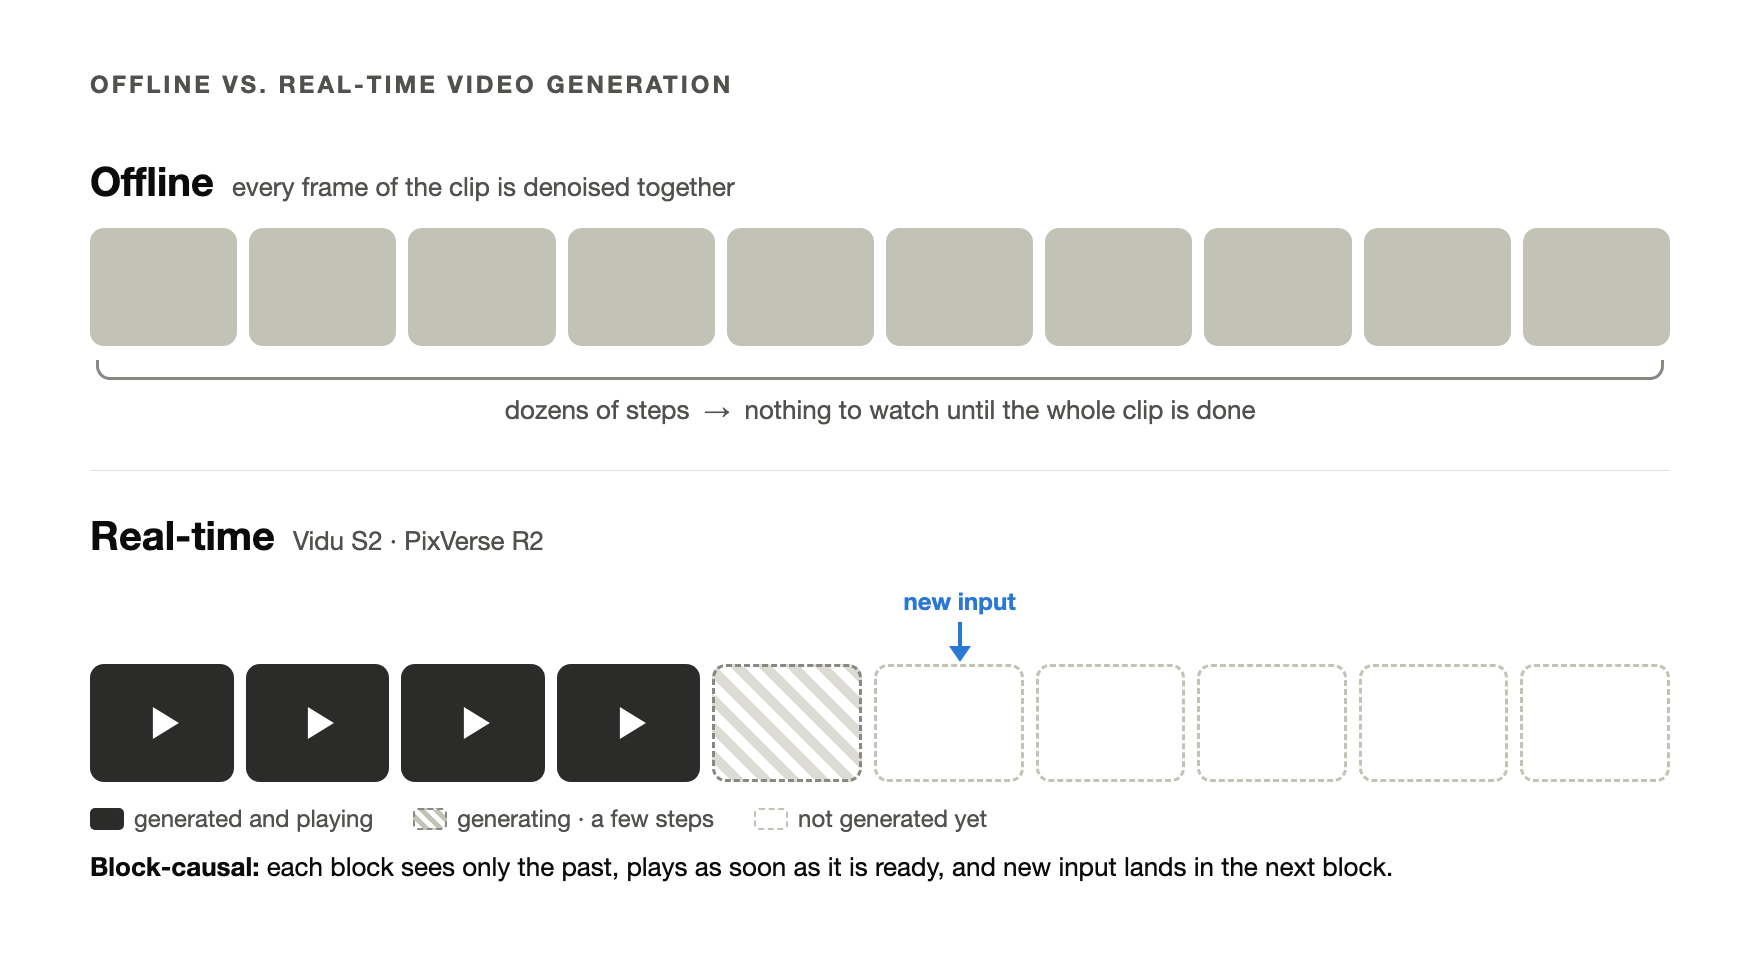
대부분의 동영상 모델은 오프라인입니다. 클립의 모든 프레임을 수십 단계에 걸쳐 한꺼번에 노이즈 제거하고, 클립 전체가 끝날 때까지 아무것도 보이지 않습니다. 원하는 내용은 생성이 시작되기 전에 프롬프트에 모두 들어 있어야 합니다.
실시간 모델은 이를 뒤집습니다. 동영상을 블록(몇 프레임과 그 구간의 오디오)으로 나누고 순서대로 생성합니다. 각 블록은 몇 단계의 노이즈 제거만 거치고, 준비되는 즉시 재생됩니다. 블록은 앞의 내용은 볼 수 있지만 뒤의 내용은 절대 보지 못합니다. 이것이 블록 인과의 뜻입니다. 새 지시는 다음 블록에 반영됩니다.
이 구조는 세 가지 문제를 낳고, 아래의 설계 선택은 거의 모두 그중 하나에 대한 답입니다.
- 오류가 누적됩니다. 모든 블록이 모델이 직접 생성한 블록을 조건으로 삼기 때문에, 작은 실수가 뒤따르는 모든 것에 이어집니다.
- 기록에는 상한이 있어야 합니다. 스트림은 끝없이 이어질 수 있습니다. 지난 블록을 전부 남기면 새 블록을 만들 때마다 비용이 커집니다.
- 시간 예산이 매우 빠듯합니다. 초당 25프레임이면 프레임 하나에 40밀리초가 주어집니다.
S2와 R2는 같은 뼈대에 도달했습니다. 영상과 오디오를 함께 생성하는 블록 인과 자기회귀 확산 모델입니다. 차이는 어떻게 학습시키고, 안정적으로 유지하고, 기억을 주고, 빠르게 만들고, 사람이 조작하게 하느냐에 있습니다.
두 시스템
Vidu S2(ShengShu Technology와 칭화대학교)는 두 모델로 이뤄져 있습니다. S2-Avatar는 720p, 25–42 FPS의 라이브 디지털 캐릭터로, S1의 540p보다 높아졌습니다. 방송 중간에 새 참조 이미지를 건네면 — 컵, 재킷, 해변 — 캐릭터가 그것을 집어 들거나, 입거나, 그 장면으로 걸어 들어갑니다. 춤도 출 수 있습니다. S2-Editing은 들어오는 동영상 스트림을 실시간으로 바꿉니다. 50가지가 넘는 스타일, 가상 피팅, 인물과 배경 교체를 지원하면서 원본의 움직임은 그대로 유지합니다. 논문은 VR 헤드셋용 스테레오 출력도 시험합니다.
PixVerse R2는 인터랙티브 월드를 겨냥한 단일 모델입니다. 실행 중에 네 가지 입력 — 텍스트, 멀티모달 참조, 오디오, WASD 같은 액션 — 이 언제든 들어올 수 있고, 각각이 현재 프레임만이 아니라 월드의 상태를 바꿉니다. PixVerse의 게임 엔진은 이제 R2 위에서 돌아가며, 공개 데모는 이동과 프롬프트 위주입니다.
선택 1: 모델을 어떻게 학습시키는가
실시간 모델은 처음부터 학습하지 않습니다. 보통의 출발점은 강력한 오프라인 생성 사전 지식이고, 이를 인과적으로, 적은 단계로 돌아가도록 바꿉니다. 두 보고서가 가장 분명하게 갈리는 지점이 바로 여기입니다.
S2는 릴레이 방식입니다. 양방향 오디오·비디오 모델을 사전 학습한 뒤, Diffusion-DPO로 화질, 표정, 움직임, 음성과 영상의 싱크를 개선합니다. 이어서 어텐션을 블록 인과로 바꾸고, 깨끗한 기록과 노이즈를 더한 기록을 섞어 학습합니다(선택 2). 그다음 Self-Replay Forcing이 모델 자신의 출력으로 학습시키면서 적은 단계로 증류하고, 마지막으로 스트리밍 선호도 최적화(Streaming NFT)가 인과 모델을 조정합니다. 아바타와 편집은 별도의 모델로 학습합니다.
R2는 하나의 기반을 유지합니다. Omni Causal AR은 짧은 클립, 긴 동영상, 멀티모달 데이터, 상호작용 궤적으로 지속적으로 사전 학습되는 인과 모델입니다. 그 뒤 Real-Time Acceleration이 같은 모델을 그대로 실시간용으로 증류합니다. 학생 모델은 여기서 초기화되고, 교사 모델도 이를 바탕으로 만들어집니다. 보고서의 표현은 "다시 배우지 말고 가속하라"입니다.
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| 출발점 | Diffusion-DPO로 조정한 양방향 모델 | 지속적으로 사전 학습한 인과 모델 |
| 실시간으로 가는 경로 | 블록 인과 적응 → Self-Replay Forcing → 스트리밍 선호도 최적화 | 같은 모델을 바로 증류 |
| 모델 구성 | 아바타와 편집용 모델을 따로 | 모든 입력에 모델 하나 |
R2의 보고서는 일반적인 방식을 5단계 릴레이로 그리고, 넘겨줄 때마다 능력이 조금씩 사라진다고 주장합니다. 있는 그대로 읽으면 S2의 파이프라인은 이런 다단계 형태이고, 주요 개선은 마지막 단계에 있습니다. 두 팀 모두 두 경로를 비교한 실험은 공개하지 않았으므로, 어느 쪽이 더 잘 확장되는지는 아직 알 수 없습니다.
선택 2: 스트림이 흐트러지지 않게 하기
드리프트는 스트리밍 영상의 대표적인 실패입니다. 색이 조금씩 변하고, 얼굴이 서서히 다른 사람이 되고, 결국 화면이 무너집니다. 학습 때는 모델에게 깨끗한 기록을 보여 주지만, 추론 때는 자기가 만든 불완전한 출력만 보게 되기 때문입니다.
두 팀의 출발점은 같습니다. 깨끗한 실제 기록을 조건으로 삼아 품질을 지키는 Teacher Forcing과, 무작위 세기의 노이즈를 더한 기록을 조건으로 삼는 Diffusion Forcing을 섞습니다. 노이즈는 세부를 지우지만 구도와 움직임은 남기므로, 모델은 과거의 모든 픽셀을 믿기보다 구조에 기대는 법을 배웁니다.
그래도 노이즈를 더한 실제 기록이 모델 자신의 실수와 같지는 않아서, 두 팀은 각자 한 층을 더합니다.
S2: Self-Replay Forcing. 먼저 모델이 추론 때와 똑같이 긴 구간을 생성합니다. 이때 그래디언트는 보관하지 않습니다. 그 궤적의 한 구간을 블록마다 다시 노이즈를 더해, 그래디언트가 흐르는 인과 패스 한 번으로 다시 재생하고, DMD 증류 손실과 지각 손실로 학습합니다. 다시 재생한 블록들이 하나의 계산 그래프 안에 있기 때문에 그래디언트가 블록 경계를 넘어 흐릅니다. 즉 한 블록이 다음 블록을 어떻게 만드는지를 배우면서도, 처음 생성한 전체 구간을 거슬러 역전파할 필요는 없습니다.
R2: Error Bank. 생성 중에 나타난 대표적인 실패 상태를 저장해 두었다가, 학습할 때 정상 기록과 함께 다시 재생합니다. 이렇게 해서 이미 월드에 편차가 들어온 뒤에 회복하는 법을 배웁니다. PixVerse의 내부 단계 평가에서 장기 밝기 드리프트 지표는 0.201에서 0.129로 35.8% 줄었고, 긴 시퀀스 29개 중 20개가 개선됐으며, 움직임이 없는 샘플 다섯 개 모두에서 불필요한 움직임이 줄었습니다.
두 방식은 경쟁이 아니라 보완 관계입니다. Self-Replay Forcing은 현재 모델이 틀리는 부분으로 학습하고, Error Bank는 기억해 둘 만한 실패를 반복해서 연습합니다.
선택 3: 상한이 있는 기억
둘 다 처음 몇 블록을 앵커(싱크)로 계속 남겨 두고, 최근 블록은 슬라이딩 윈도로 유지하며, 나머지는 버립니다. 그래서 새 블록의 비용이 스트림 길이에 따라 늘지 않습니다. 둘 다 위치 좌표도 학습 때 본 범위 안에 묶어 둡니다. S1은 이를 RoPE 재배치, R2는 상대 시간 RoPE라고 부르며, 세션이 길어져도 위치가 분포 밖으로 밀려나지 않습니다.
S2는 S1의 TwinCache를 바탕으로 합니다. TwinCache는 지난 블록마다 노이즈가 있는 것과 깨끗한 것, 두 가지로 캐시합니다. 중간의 노이즈 제거 단계는 노이즈가 있는 사본을 읽는데, 이 사본은 대략적인 움직임만 전달해 아티팩트가 쌓이는 것을 막는 저역 통과 필터처럼 작동합니다. 마지막 단계는 깨끗한 사본을 읽어 세부를 되살립니다. S2는 이를 두 단계로 나눠, 백본은 노이즈가 많은 캐시를, Refiner는 노이즈가 적은 고해상도 캐시를 읽습니다.
R2는 기억을 시간 규모별로 나눕니다. Sink Memory는 정체성, 환경, 스타일, 월드의 규칙을, Rolling History는 최근의 움직임, 자세, 카메라를 담고, Object KV Cache는 나중에도 중요할 물체 수준의 상태를 압축해 남깁니다.
이런 구분은 각자의 제품을 반영합니다. 디지털 캐릭터는 계속 같은 사람이어야 합니다. 월드는 거기서 일어난 일 — 내려놓은 물건, 내린 선택 — 까지 기억해야 합니다.
선택 4: 속도는 어디서 나오는가
둘 다 희소 어텐션과 적은 단계로의 증류를 씁니다. 다만 힘을 쏟는 곳이 다릅니다.
S2는 시스템 엔지니어링에 기대고, 그 내용을 자세히 적었습니다. 어텐션은 층마다 SageAttention, SpargeAttention, 희소-선형 어텐션 중에서 고르며, 가장 공격적인 근사는 가장 덜 민감한 층에 둡니다. 선형 층은 블록 단위 W8A8 행렬 곱으로 실행합니다. 인접한 연산자는 Triton/CUDA 커널로 합치고 CUDA Graphs로 재생합니다. 여러 GPU에서는 Ulysses 방식의 컨텍스트 병렬화를 쓰고 GPU 간 통신도 양자화하며, 편집 파이프라인에서는 VAE 인코더, 백본, Refiner, 디코더가 공통 타임라인 위에서 GPU를 나눠 씁니다. 해상도는 저해상도 백본과 1단계 잠재 공간 Refiner로 720p까지 올립니다.
R2는 모델 자체에 기댑니다. 블록 희소 어텐션을 학습 중에 익히며, 희소도는 90%를 넘습니다. 증류는 Decoupled DMD를 따르는데, 제어 신호를 따르는 것과 교사 분포에 맞추는 것을 별개의 목표로 최적화하고, 여기에 DMD2에서 가져온 적대적 항을 더해 사실감을 지킵니다. 해상도는 피라미드 구조를 따릅니다. 한두 개의 저해상도 단계가 구도, 움직임, 카메라를 정하고, 마지막 고해상도 단계가 질감을 더합니다. 보고서에는 R2의 출력 해상도와 프레임 속도가 나와 있지 않습니다.
선택 5: 사람이 어떻게 조작하는가
S2는 모델을 VLM 에이전트로 감쌉니다. 에이전트는 각 참조 이미지를 손에 든 물건, 배경, 옷 중 하나로 분류한 뒤, 세그먼트마다 정체성, 표정, 시선, 자세, 동작, 손에 든 물건을 담은 프롬프트를 쓰고, 사용자가 바꾸라고 하지 않은 것은 그대로 둡니다. 생성이 끝나면 프레임을 순서대로 검토해 동작이 끝났는지, 절반만 됐는지, 잘못됐는지 판단하고, 그에 맞춰 다음 프롬프트를 씁니다. 액세서리를 쓰고 벗는 동작에서는 프롬프트에 움직임과 끝난 뒤의 상태를 함께 적기 때문에, 다시 쓴 모자는 계속 쓴 채로 남습니다. 편집 모드에서는 프레임 정렬 어텐션으로 각 출력 프레임이 같은 순간의 원본 프레임만 읽기 때문에, 움직임과 타이밍이 입력과 정확히 일치합니다.
R2는 하나의 입력 인터페이스를 모델에 넣었습니다. 텍스트, 참조, 오디오, 액션, 그리고 에이전트가 생성한 제어 신호가 모두 같은 실행 중인 월드로 들어갑니다. 블록 길이는 상한 안에서 현재의 제어 신호를 따릅니다. 키 입력에는 짧은 블록으로 빠르게 반응하고, 하나의 사건이나 오디오 구간에는 긴 블록으로 일관성을 지킵니다. 모델 위에서는 PixVerse의 게임 엔진이 에이전트 층을 더해, 게임 규칙의 상태와 생성된 장면을 맞춰 줍니다.
각 보고서가 공개한 것
숫자를 비교하기 전에, 무엇이 공개됐는지부터 비교합니다.
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| 형식 | arXiv 논문 | PixVerse 사이트의 기술 글 |
| 해상도와 프레임 속도 | 720p, 25–42 FPS | 밝히지 않음 |
| 파라미터 수와 종단 간 지연 | 밝히지 않음 | 밝히지 않음 |
| 공개 벤치마크 | 아바타 1개, 편집 4개 | 없음, 내부 평가만 |
| 가중치 | 비공개, API 제공 | 비공개 |
StreamAV-Bench에서 S2는 자체 평가(14개 시스템)에서 보고한 9개 지표 모두 1위입니다. 음성·영상 정렬은 0.353으로 다른 시스템의 최고치 0.272보다 높고, 싱크 오차는 0.617로 다른 최고치 0.648보다 낮습니다. 차이가 소수점 셋째 자리에 그치는 지표도 있어서, 대상 일관성은 0.998 대 0.997입니다. R2가 공개한 숫자는 드리프트 35.8% 감소와 90%가 넘는 어텐션 희소도이며, 보고서는 이 희소도에서도 내부 품질 지표 네 가지가 유지됐다고 하지만 점수는 제시하지 않았습니다.
직접 비교는 없습니다. S2 논문이 비교한 대상은 이전 세대인 PixVerse R1이고, R2는 그 뒤에 나왔습니다.
에이전트로 동영상을 만든다면 무엇을 의미하는가
저희는 에이전트가 일을 처리하는 데스크톱 앱을 만들고 있고, 동영상은 사람들이 에이전트에게 맡기는 일 가운데 하나입니다. 이 보고서들에서 가져갈 점이 두 가지 있습니다.
첫째, 라이브와 완성 영상의 경계가 점점 뚜렷해지고 있습니다. 실시간 모델은 계속 반응하는 경험 — 캐릭터, 게임, 재생하면서 스타일을 바꾸는 스트림 — 을 위해 만들어졌습니다. 반면 크리에이터 작업의 대부분은 여전히 파일로 끝납니다. Orkas에서는 VideoStudio가 촬영 소스와 요청을 검토 가능한 편집본으로 만듭니다. 샷을 생성해야 할 때는 오프라인 모델을 쓰는데, Orkas가 제공하는 동영상 생성이나 직접 가진 키로 Seedance 2.0, Hailuo 2.3, Vidu Q3 Pro, Kling 3.0 Turbo, Veo 3.1, Runway Gen-4.5를 쓸 수 있습니다. S2와 R2는 현재 Orkas 안에서 실행되지 않습니다.
둘째, S2의 제어 계층은 에이전트 루프 그 자체입니다. 프롬프트를 쓰고, 생성하고, 프레임을 보고, 다음에 할 일을 정합니다. 실시간이든 아니든 생성 모델과 함께 일하는 에이전트는 모두 같은 모양이고, 결과의 상당 부분은 가중치뿐 아니라 이 루프에 달려 있습니다.
저희가 얻은 것
뼈대는 자리를 잡았습니다. 블록 인과 자기회귀 확산, 영상과 오디오의 동시 생성, 깨끗한 기록과 노이즈 기록의 병행, 싱크와 윈도, DMD 계열 증류, 희소 어텐션, 저해상도 먼저. S2와 R2를 가르는 것은 힘을 어디에 쓰느냐입니다. 목표를 좁힌 수정의 릴레이인가, 한 번만 증류하는 하나의 기반인가. 온폴리시 재생인가, 실패 은행인가. 시스템 엔지니어링인가, 학습된 희소성인가.
둘 다 전문을 읽어 볼 가치가 있습니다. 학습과 서빙의 세부 사항은 Vidu S2 논문에서, 다시 배우지 않고 실시간 모델을 확장한다는 주장은 PixVerse R2 보고서에서 볼 수 있습니다.