
Dois modelos de vídeo em tempo real foram lançados este mês com uma semana de intervalo. O Vidu S2, da ShengShu, foi lançado a 15 de setembro, e a PixVerse anunciou o PixVerse R2 a 22 de setembro. O S2 foi construído em torno de personagens digitais ao vivo e de alterar o estilo de um fluxo de vídeo durante a reprodução. O R2 apresenta-se como um modelo de mundo em tempo real: uma cena que se percorre com WASD enquanto texto, referências e áudio alteram o que acontece a seguir.
As duas equipas explicaram como os construíram — o S2 num artigo no arXiv, o R2 num relatório técnico no sítio da PixVerse. Lemos os dois lado a lado. Concordam na estrutura de base, divergem em cinco opções de conceção e divulgam quantidades de informação muito diferentes. Este artigo aborda os três pontos e, deliberadamente, não aponta um vencedor: os dois nunca foram medidos no mesmo teste.
O que muda com o tempo real
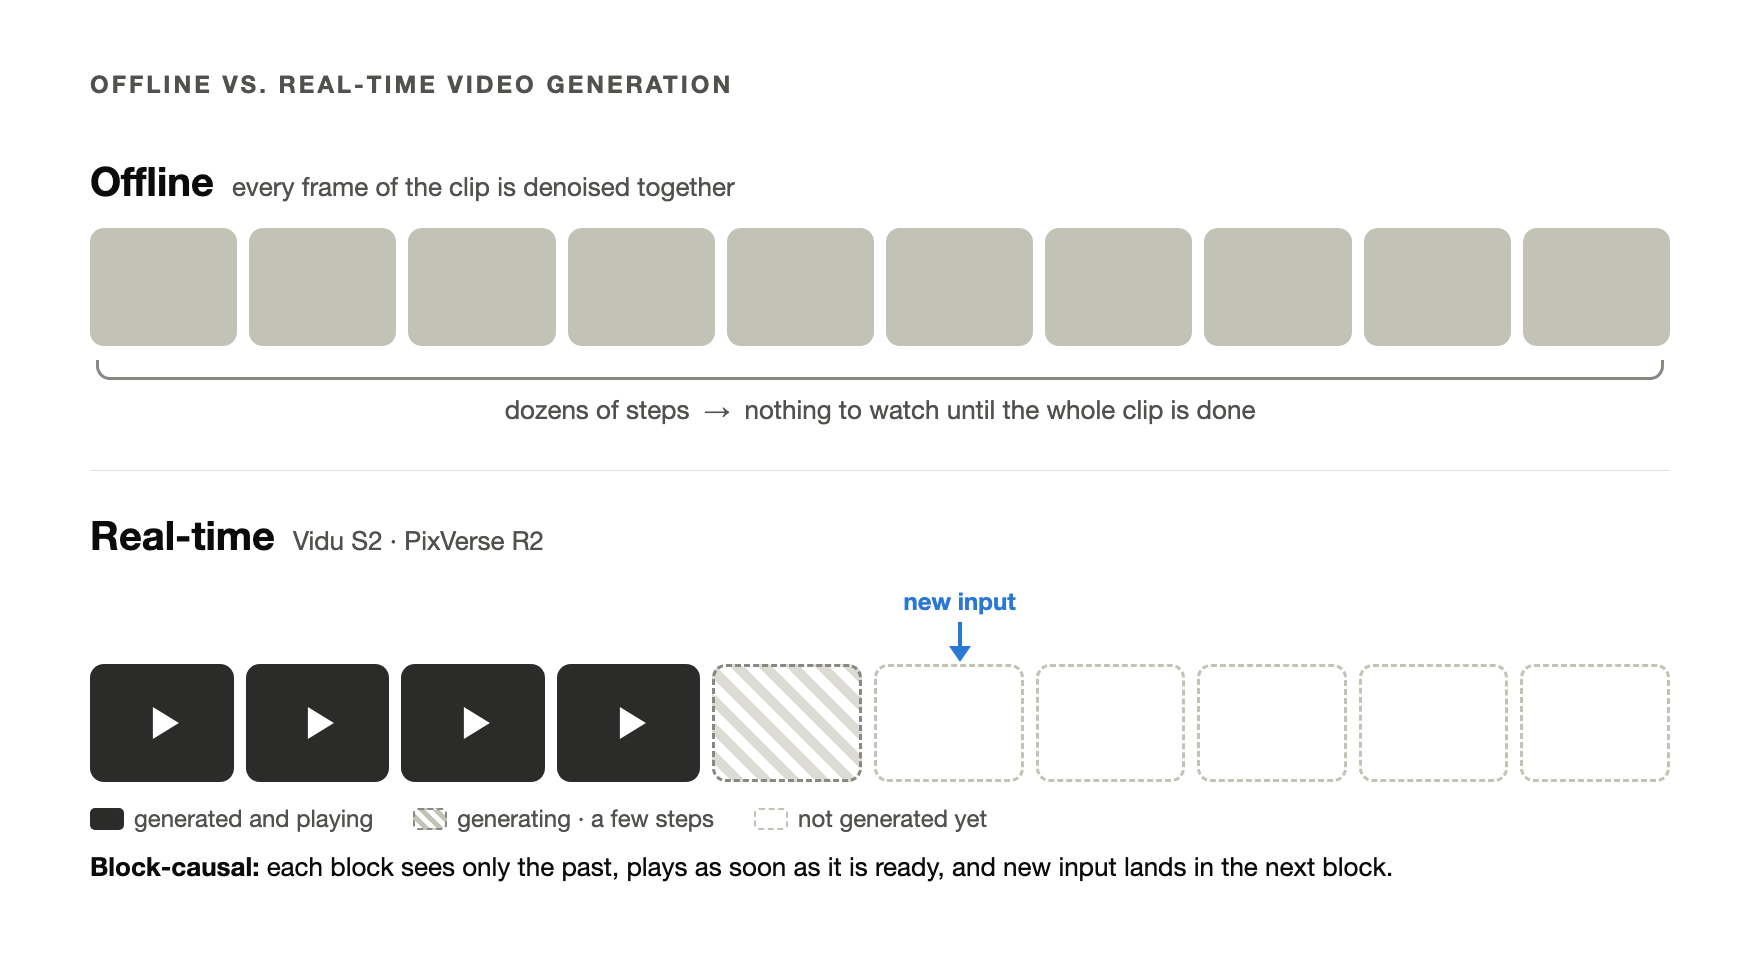
A maioria dos modelos de vídeo funciona sem geração em tempo real. Todos os fotogramas de um vídeo passam por remoção de ruído em conjunto, ao longo de dezenas de passos, e nada aparece até todo o vídeo estar pronto. Tudo o que se pretende tem de constar no prompt antes de a geração começar.
Um modelo em tempo real inverte isso. Divide o vídeo em blocos — alguns fotogramas mais o excerto de áudio correspondente — e os gera em ordem. Cada bloco passa apenas por alguns passos de remoção de ruído e é reproduzido assim que está pronto. Um bloco vê o que veio antes, mas nunca o que vem depois; é isso que significa causal por blocos. Uma nova instrução entra no bloco seguinte.
Esta estrutura cria três problemas, e quase todas as escolhas abaixo respondem a um deles:
- Os erros acumulam-se. Cada bloco é condicionado a blocos que o próprio modelo gerou, pelo que tudo o que vem depois herda um pequeno erro.
- O histórico tem de ser limitado. Um fluxo pode durar indefinidamente; guardar todos os blocos anteriores tornaria cada novo bloco mais caro.
- O tempo disponível é implacável. A 25 fotogramas por segundo, cada fotograma tem 40 milissegundos.
O S2 e o R2 chegam ao mesmo esqueleto: um modelo de difusão autorregressivo e causal por blocos, que gera vídeo e áudio juntos. As diferenças estão em como cada um é treinado, mantido estável, dotado de memória, acelerado e controlado pelas pessoas.
Os dois sistemas
O Vidu S2 (da ShengShu Technology com a Universidade Tsinghua) compreende dois modelos. O S2-Avatar é uma personagem digital ao vivo em 720p e 25–42 FPS, acima dos 540p do S1. Pode receber uma nova imagem de referência a meio da transmissão — uma chávena, um casaco, uma praia — e a personagem pega no objeto, veste a peça ou entra na cena; também pode dançar. O S2-Editing altera o estilo em tempo real de um fluxo de vídeo de entrada — mais de 50 estilos, prova virtual de roupa, substituição da pessoa e do cenário — mantendo intacto o movimento original. O artigo também explora saída estereoscópica para visores de realidade virtual.
O PixVerse R2 é um único modelo orientado para mundos interativos. Quatro tipos de entrada podem chegar durante a execução — texto, referências multimodais, áudio e ações como WASD — e cada um atualiza o estado do mundo, não apenas o fotograma atual. O motor de jogo da PixVerse já funciona com o R2; a demonstração pública centra-se em movimento e prompts.
Escolha 1: como o modelo é treinado
Modelos em tempo real não são treinados de raiz. O ponto de partida habitual é um sólido modelo generativo prévio offline, depois convertido para funcionar de forma causal e em poucos passos. É aqui que os dois relatórios discordam mais abertamente.
O S2 segue uma sequência de etapas. Um modelo bidirecional de áudio e vídeo é pré-treinado e depois ajustado com Diffusion-DPO para fidelidade, expressão, movimento e sincronia entre áudio e imagem. A atenção passa a ser causal por blocos e é treinada com uma mistura de histórico limpo e histórico com ruído (escolha 2). Em seguida, o Self-Replay Forcing destila o modelo para poucos passos enquanto o treina com as próprias saídas, e uma etapa final de preferência para streaming (Streaming NFT) ajusta o modelo causal. Avatar e edição são treinados como modelos separados.
O R2 mantém uma base única. O Omni Causal AR é um modelo causal pré-treinado continuamente com clipes curtos, vídeos longos, dados multimodais e trajetórias de interação. Depois, o Real-Time Acceleration destila esse mesmo modelo para uso ao vivo: o modelo-aluno é inicializado a partir dele e o modelo-professor assenta nele. A frase do relatório é "acelerar, não reaprender".
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| Ponto de partida | Modelo bidirecional ajustado com Diffusion-DPO | Modelo causal pré-treinado continuamente |
| Caminho para o tempo real | Adaptação causal por blocos → Self-Replay Forcing → ajuste de preferência para streaming | Destilar diretamente o mesmo modelo |
| Modelos | Modelos separados de avatar e de edição | Um modelo para todos os tipos de entrada |
O relatório do R2 desenha a abordagem comum como uma sequência de cinco etapas e argumenta que cada transição perde parte da capacidade. Numa leitura direta, o processo do S2 tem esse formato em várias etapas, com a principal melhoria na última. Nenhuma das equipas publicou uma experiência comparando os dois caminhos, pelo que ainda não se sabe qual deles escala melhor.
Escolha 2: evitar que o fluxo se desvie
A deriva é a falha típica do vídeo em streaming: a cor altera-se gradualmente, um rosto transforma-se gradualmente noutra pessoa e, no fim, o fotograma desfaz-se. Isto acontece porque o treino mostra ao modelo um histórico limpo, enquanto durante a inferência vê apenas a própria saída imperfeita.
As duas equipas partem da mesma correção. Elas misturam Teacher Forcing, que condiciona ao histórico real e limpo e protege a qualidade, com Diffusion Forcing, que condiciona a um histórico com ruído em nível aleatório. O ruído apaga os detalhes finos, mas preserva composição e movimento, e o modelo aprende a apoiar-se na estrutura em vez de confiar em cada pixel do passado.
O histórico real com ruído ainda não equivale aos erros do próprio modelo, pelo que cada equipa acrescenta uma segunda camada.
S2: Self-Replay Forcing. Primeiro o modelo gera um segmento longo exatamente como faria durante a inferência, sem guardar gradientes. Uma janela dessa trajetória recebe ruído de novo, bloco a bloco, e é reproduzida numa única passagem causal com gradientes, treinada com uma perda de destilação DMD mais uma perda perceptual. Como os blocos reproduzidos ficam no mesmo grafo computacional, os gradientes atravessam as fronteiras entre blocos — o modelo aprende como um bloco molda o seguinte — sem retropropagar pela geração original.
R2: Error Bank. Estados de falha representativos da geração são armazenados e reproduzidos no treino junto com o histórico normal, para que o modelo aprenda a recuperar depois de uma deriva já entrou no mundo. Na avaliação interna de etapa da PixVerse, uma métrica de deriva de luminosidade de longo prazo caiu de 0,201 para 0,129, uma redução de 35,8%; 20 das 29 sequências longas melhoraram, e o movimento espúrio diminuiu nas cinco amostras sem movimento.
Os dois complementam-se em vez de competir. O Self-Replay Forcing treina sobre o que o modelo atual erra; o Error Bank treina repetidamente as falhas que importa recordar.
Escolha 3: uma memória limitada
Os dois mantêm alguns blocos iniciais permanentemente como âncora (um sink), mantêm uma janela móvel de blocos recentes e descartam o resto, de modo que o custo de um novo bloco não aumenta com a duração do fluxo. Os dois também mantêm as coordenadas de posição dentro do intervalo observado no treino — o S1 chama isso de reposicionamento de RoPE, o R2 de RoPE temporal relativo —, pelo que uma sessão longa nunca empurra as posições para fora da distribuição.
O S2 parte do TwinCache do S1, em que cada bloco anterior é guardado duas vezes: uma com ruído e outra limpa. Os passos intermédios de remoção de ruído leem a cópia com ruído, que carrega o movimento geral e funciona como um filtro passa-baixo contra o acumulação de artefatos; o último passo lê a cópia limpa para recuperar os detalhes. O S2 divide este mecanismo pelas suas duas etapas: o backbone lê uma cache com muito ruído, e o Refiner, uma cache de alta resolução com pouco ruído.
O R2 separa a memória por escala de tempo: Sink Memory para identidade, ambiente, estilo e regras do mundo; Rolling History para movimento, pose e câmara recentes; e um Object KV Cache que comprime o estado dos objetos que ainda vai importar mais adiante.
A divisão espelha os produtos. Uma personagem digital tem de continuar a ser a mesma pessoa. Um mundo também precisa lembrar o que aconteceu nele — o objeto que se deixou no chão, a escolha que se fez.
Escolha 4: de onde vem a velocidade
Os dois usam atenção esparsa e destilação em poucos passos. Mas concentram o esforço em lugares diferentes.
O S2 aposta em engenharia de sistemas e documenta tudo. A atenção é escolhida camada por camada entre SageAttention, SpargeAttention e atenção linear esparsa, com as aproximações mais agressivas nas camadas menos sensíveis. As camadas lineares funcionam como multiplicações de matrizeseses W8A8 por bloco. Operadores vizinhos são fundidos em núcleos Triton/CUDA e reproduzidos com CUDA Graphs. Com várias GPU, usa paralelismo de contexto no estilo Ulysses com comunicação quantizada, e, no processo de edição, o codificador VAE, o backbone, o Refiner e o decodificador partilham as GPU numa linha temporal comum. A resolução vem de um backbone em baixa resolução mais um Refiner latente de um passo até 720p.
O R2 aposta no modelo. A atenção esparsa por blocos é aprendida durante o treino e passa de 90% de esparsidade. A destilação segue o Decoupled DMD — seguir o sinal de controlo e reproduzir o professor são otimizados como objetivos separados — mais um termo adversarial vindo do DMD2 para manter o realismo. A resolução segue uma pirâmide: uma ou duas etapas de baixa resolução definem composição, movimento e câmara, e uma etapa final em alta resolução acrescenta a textura. O relatório não informa a resolução nem a taxa de fotogramas de saída do R2.
Escolha 5: como as pessoas o controlam
O S2 envolve o modelo num agente VLM. O agente classifica cada imagem de referência como objeto na mão, cenário ou roupa e escreve um prompt para cada segmento, cobrindo identidade, expressão, olhar, pose, ação e objetos segurados, preservando tudo o que o utilizador não pediu para mudar. Depois da geração, revê os fotogramas em ordem, avalia se a ação terminou, ficou a meio ou correu mal e escreve o próximo prompt de acordo. Para colocar ou retirar acessórios, os prompts descrevem o movimento e o estado final, pelo que um chapéu recolocado mantém-se na cabeça. No modo de edição, a atenção alinhada por fotograma faz cada fotograma de saída ler apenas o fotograma de origem do mesmo instante, de modo que movimento e ritmo coincidem exatamente com a entrada.
O R2 incorpora uma única interface de entrada no modelo. Texto, referências, áudio, ações e controlos gerados por agentes entram todos no mesmo mundo em execução. O tamanho do bloco acompanha o controlo ativo, até um limite: uma tecla premida recebe blocos curtos, para responder depressa, e um evento inteiro ou um excerto de áudio recebe blocos mais longos, para manter a coerência. Acima do modelo, o motor de jogo da PixVerse adiciona uma camada de agentes que mantém sincronizados o estado das regras do jogo e a cena gerada.
O que cada relatório divulga
Antes de comparar números, compare o que foi publicado.
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| Formato | Artigo no arXiv | Artigo técnico no sítio da PixVerse |
| Resolução e taxa de fotogramas | 720p, 25–42 FPS | Não divulgado |
| Parâmetros e latência ponta a ponta | Não divulgado | Não divulgado |
| Testes de referência públicos | Um de avatar, quatro de edição | Nenhum; apenas avaliação interna |
| Pesos | Não disponibilizados; API disponível | Não disponibilizados |
No StreamAV-Bench, o S2 fica em primeiro lugar nas nove métricas apresentadas entre 14 sistemas, na sua própria avaliação: alinhamento entre áudio e imagem de 0,353, contra 0,272 da melhor alternativa, e erro de sincronia de 0,617, contra 0,648. Algumas margens estão na terceira casa decimal — a consistência da personagem é 0,998 contra 0,997. Os números publicados do R2 são a redução de 35,8% na deriva e a esparsidade de atenção acima de 90%, que, segundo o relatório, preserva quatro dimensões internas de qualidade, sem apresentar as notas.
Não há comparação direta. O artigo do S2 compara-o com o PixVerse R1, a geração anterior, e o R2 foi lançado depois dele.
O que isto significa para quem cria vídeo com agentes
Construímos uma aplicação para computador em que os agentes fazem o trabalho, e vídeo é uma das tarefas que as pessoas lhes confiam. Há duas conclusões destes relatórios que importam neste contexto.
Primeiro, a linha entre vídeo ao vivo e vídeo finalizado está a tornar-se mais nítida. Modelos em tempo real são feitos para experiências que respondem continuamente — personagens, jogos, um fluxo cujo estilo muda durante a reprodução. A maior parte do trabalho de criadores ainda termina num ficheiro. Na Orkas, o VideoStudio transforma material em bruto e um briefing numa edição que se pode rever e, quando é necessário gerar um plano, usa modelos offline: geração de vídeo gerida pela Orkas ou a sua própria chave de API de API para Seedance 2.0, Hailuo 2.3, Vidu Q3 Pro, Kling 3.0 Turbo, Veo 3.1 ou Runway Gen-4.5. Nem o S2 nem o R2 funcionam atualmente na Orkas.
Segundo, a camada de controlo do S2 é um ciclo de agente: escrever o prompt, gerar, observar os fotogramas, decidir o próximo passo. É o mesmo formato de qualquer agente que trabalha com um modelo gerativo, em tempo real ou não — e boa parte do resultado depende desse ciclo, não apenas dos pesos.
O que retiramos destes relatórios
A estrutura de base estabilizou: difusão autorregressiva causal por blocos, vídeo e áudio gerados juntos, histórico limpo mais histórico com ruído, um sink e uma janela, destilação da família DMD, atenção esparsa e baixa resolução primeiro. O que separa o S2 e o R2 é onde cada um investe esforço — uma sequência de ajustes específicos contra uma base destilada uma única vez, reprodução on-policy contra um banco de falhas, engenharia de sistemas contra esparsidade aprendida.
Vale a pena ler ambos na íntegra: o artigo do Vidu S2, pelos pormenores de treino e implementação, e o relatório do PixVerse R2, pelo argumento sobre escalar um modelo em tempo real sem reaprendê-lo.