
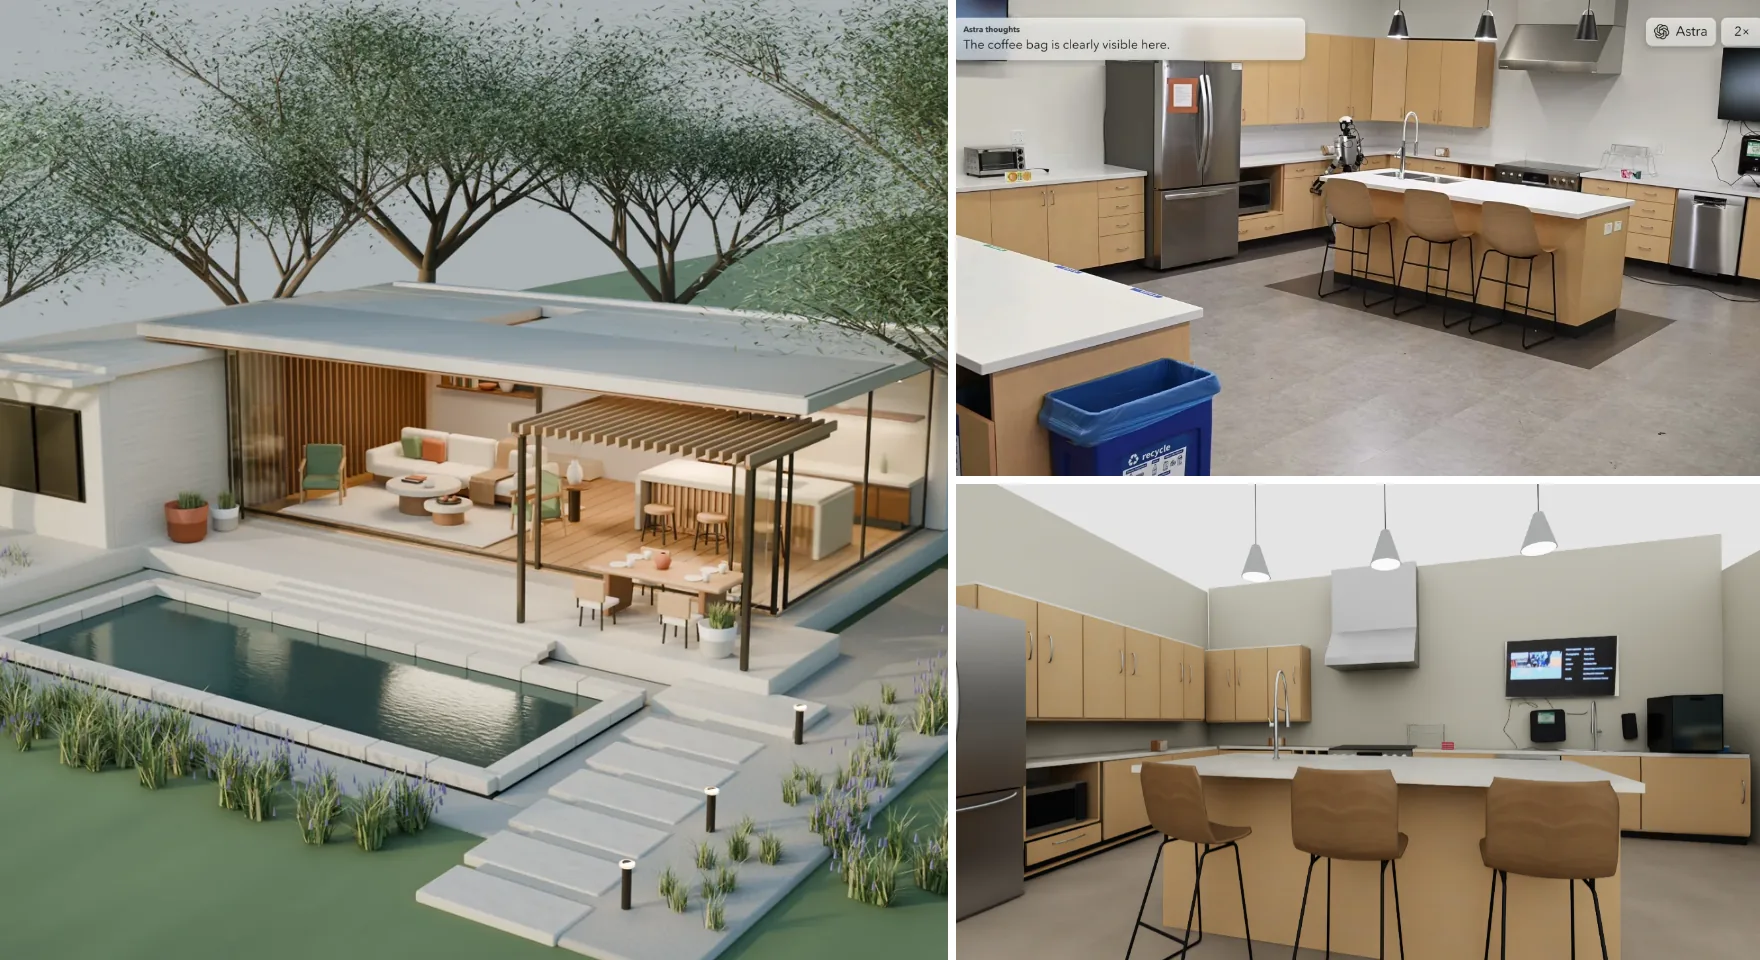
9 月初 OpenAI 发布 GPT-6 Astra 之后,有两类视频传得很快。一类是它在 Blender 里从零建出一整栋带家具的房子,再导进 Unreal Engine 5,人可以走进去开门、开灯、煮咖啡;另一类是它直接指挥机械臂和人形机器人干活。
一个语言模型,怎么突然“懂空间”了?OpenAI 有没有专门为空间做优化?这条路线对 3D 生成和机器人的“大脑”又意味着什么?我们读了 OpenAI 的发布页、系统卡和开发者博客,之后陆续发表的机器人评测,以及研究者的分析。先说结论:
- 进步是真的,但很“偏科”:3D、视觉定位和交互类任务涨得多,综合智力几乎没动。
- 机器人上的表现很看接口:同一个模型换一种用法,成绩能差很多。
- 这种能力大概率来自在“能自动判对错”的环境里反复练习,而不是新架构。
- 对 3D 生成和机器人大脑来说,更可能是重新分工,而不是谁取代谁。
官方成绩:进步很大,但分布很不均匀
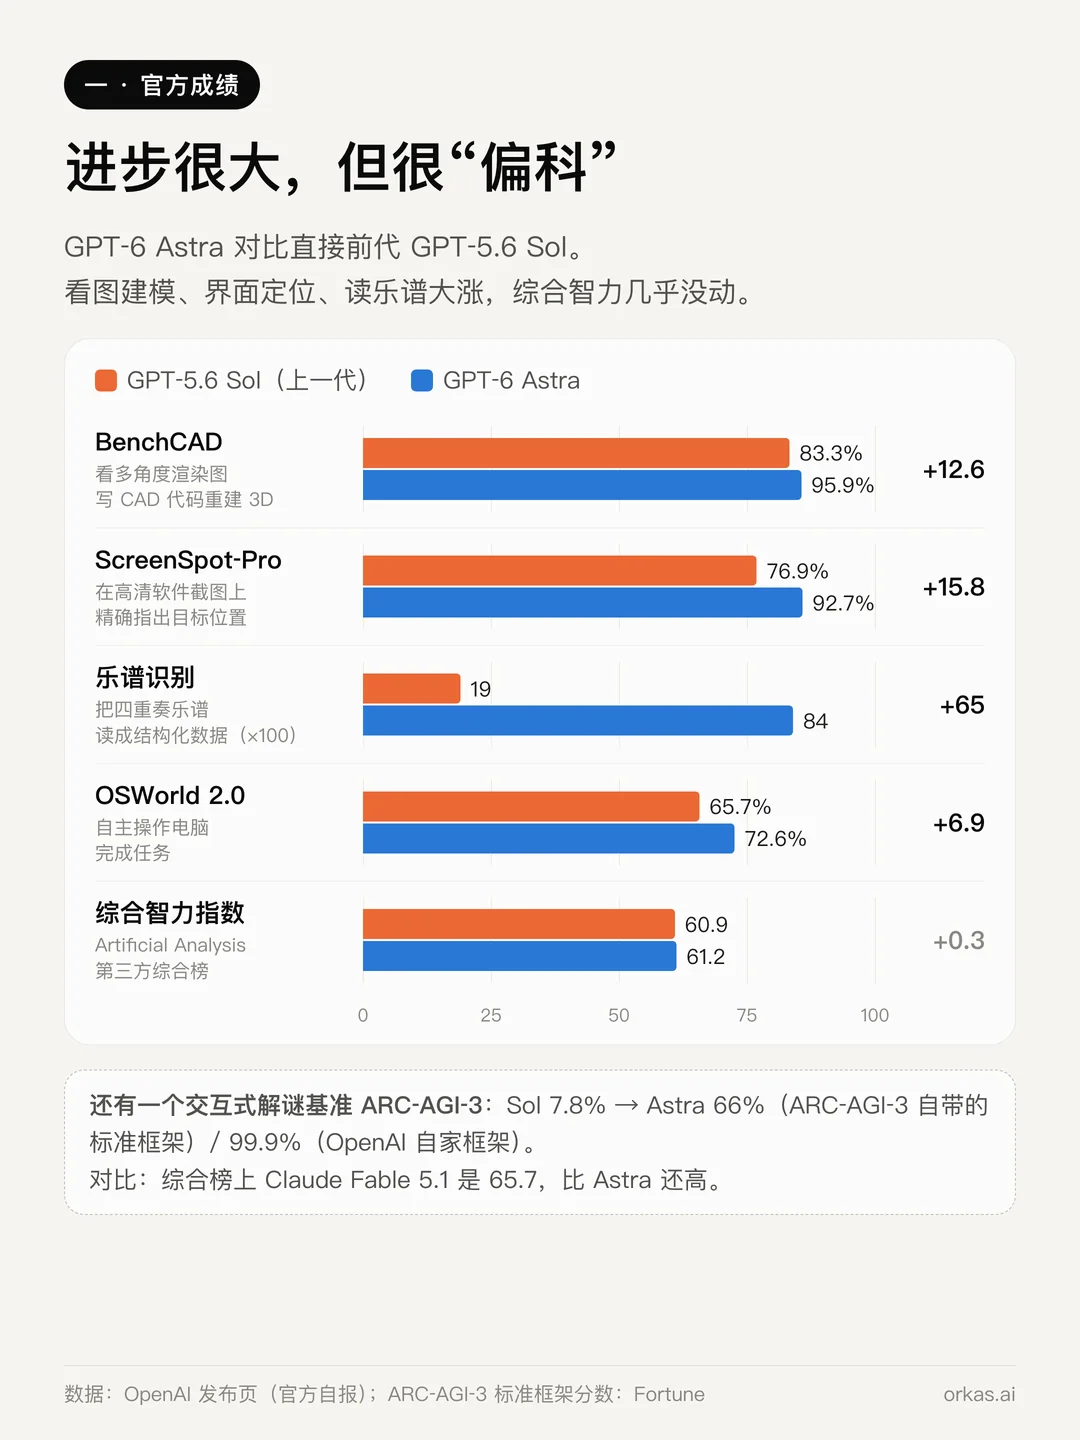
和直接前代 GPT-5.6 Sol 相比,OpenAI 公布的几个数字是这样的:
- BenchCAD:83.3% → 95.9%。给模型看一个物体多个角度的渲染图,让它写 CAD 代码把物体重建出来,相当于“看图建模”。
- ScreenSpot-Pro(不用工具):76.9% → 92.7%。在专业软件的高清截图上,精确指出某个按钮或元素在哪。
- 乐谱识别:在 OpenScore 弦乐四重奏上从 0.19 到 0.84,把密密麻麻的印刷乐谱读成结构化的乐谱数据。
- ARC-AGI-3(交互式解谜基准):7.8% → 66%(基准自带的标准测试框架),用 OpenAI 自家框架是 99.9%。
相比之下,第三方的 Artificial Analysis 综合智力指数只从 60.9 变成 61.2,还低于 Claude Fable 5.1 的 65.7。
所以 Astra 并不是全面变聪明了,而是在“看 + 动手 + 根据结果调整”这类任务上突飞猛进。康奈尔大学和 Google DeepMind 的研究者 Yoav Artzi 称之为空间推理上的“阶跃式进步”。
它在 Blender 里到底做了什么
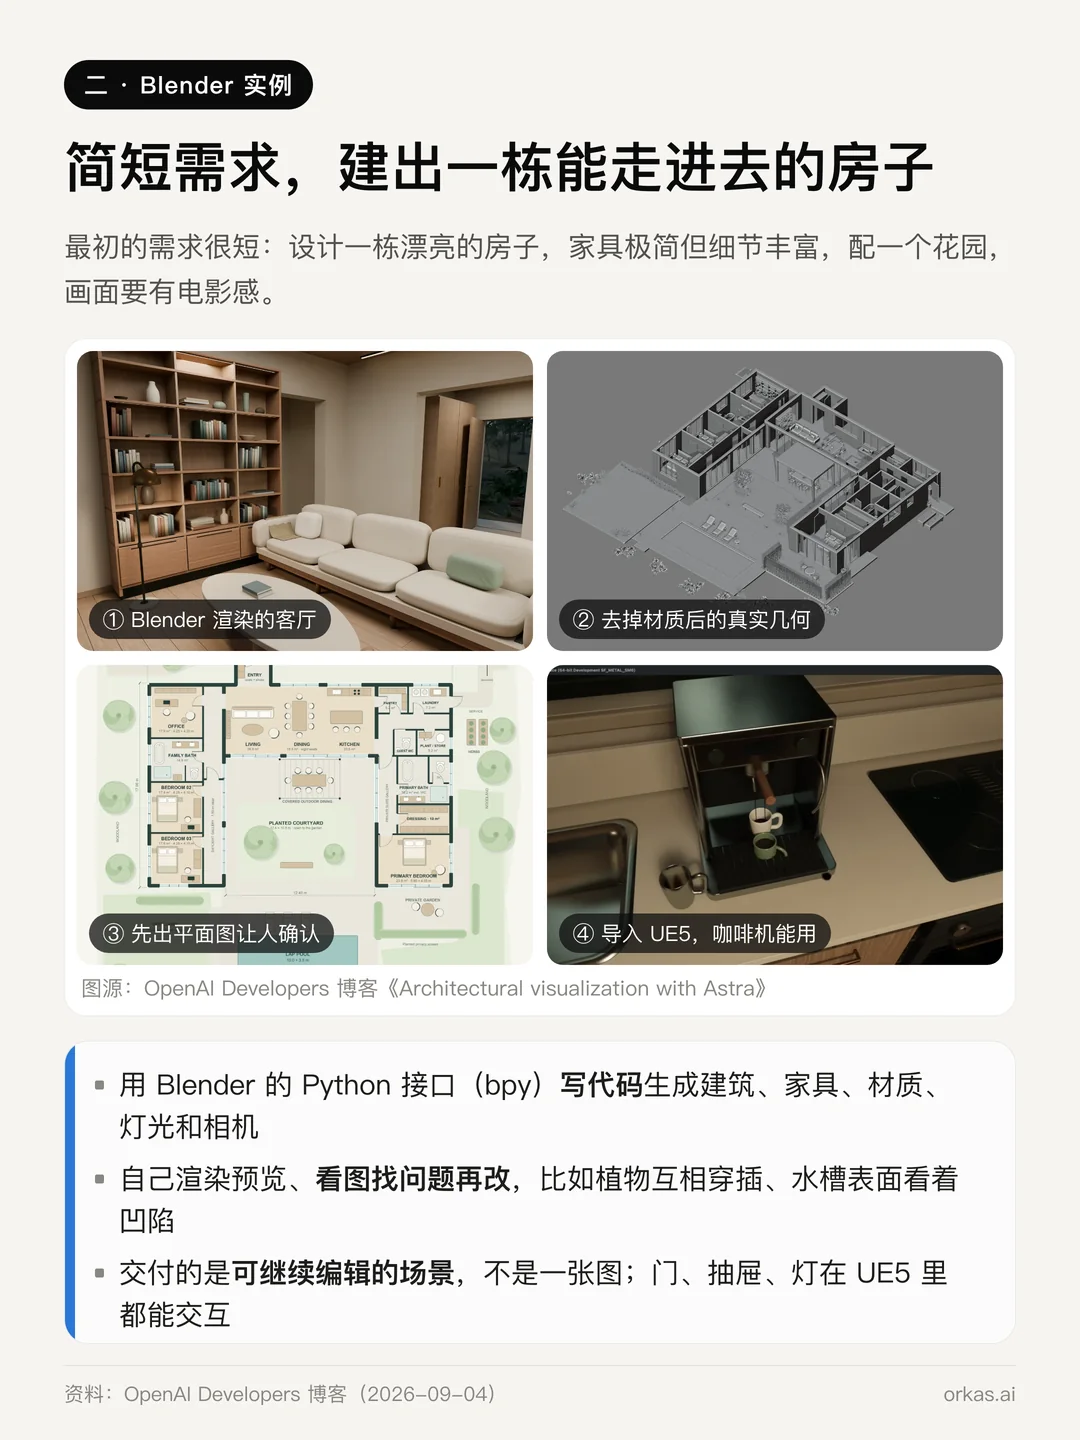
OpenAI 开发者博客里有一个完整的项目。最初的需求很短:设计一栋漂亮的房子,家具极简但细节丰富,配一个花园,画面要有电影感。
- Astra 用 Blender 的 Python 接口(bpy)写代码,把建筑、木作、家具、植物、材质、灯光和相机全部“写”了出来。
- 它自己渲染预览图、看图找问题,再改自己的代码,比如植物互相穿插、不锈钢水槽因为表面法线不对,看上去像被捏凹了一块。
- 它先画平面图让人确认,再把房子重建成一栋 U 型的单层住宅,有三间卧室和一间书房。
- 它把场景导出到 Unreal Engine 5,做成第一人称漫游,门、抽屉、灯和咖啡机都能用。
交付物不是一张图,而是一个可以继续编辑的 Blender 场景。
短板也同样清楚:
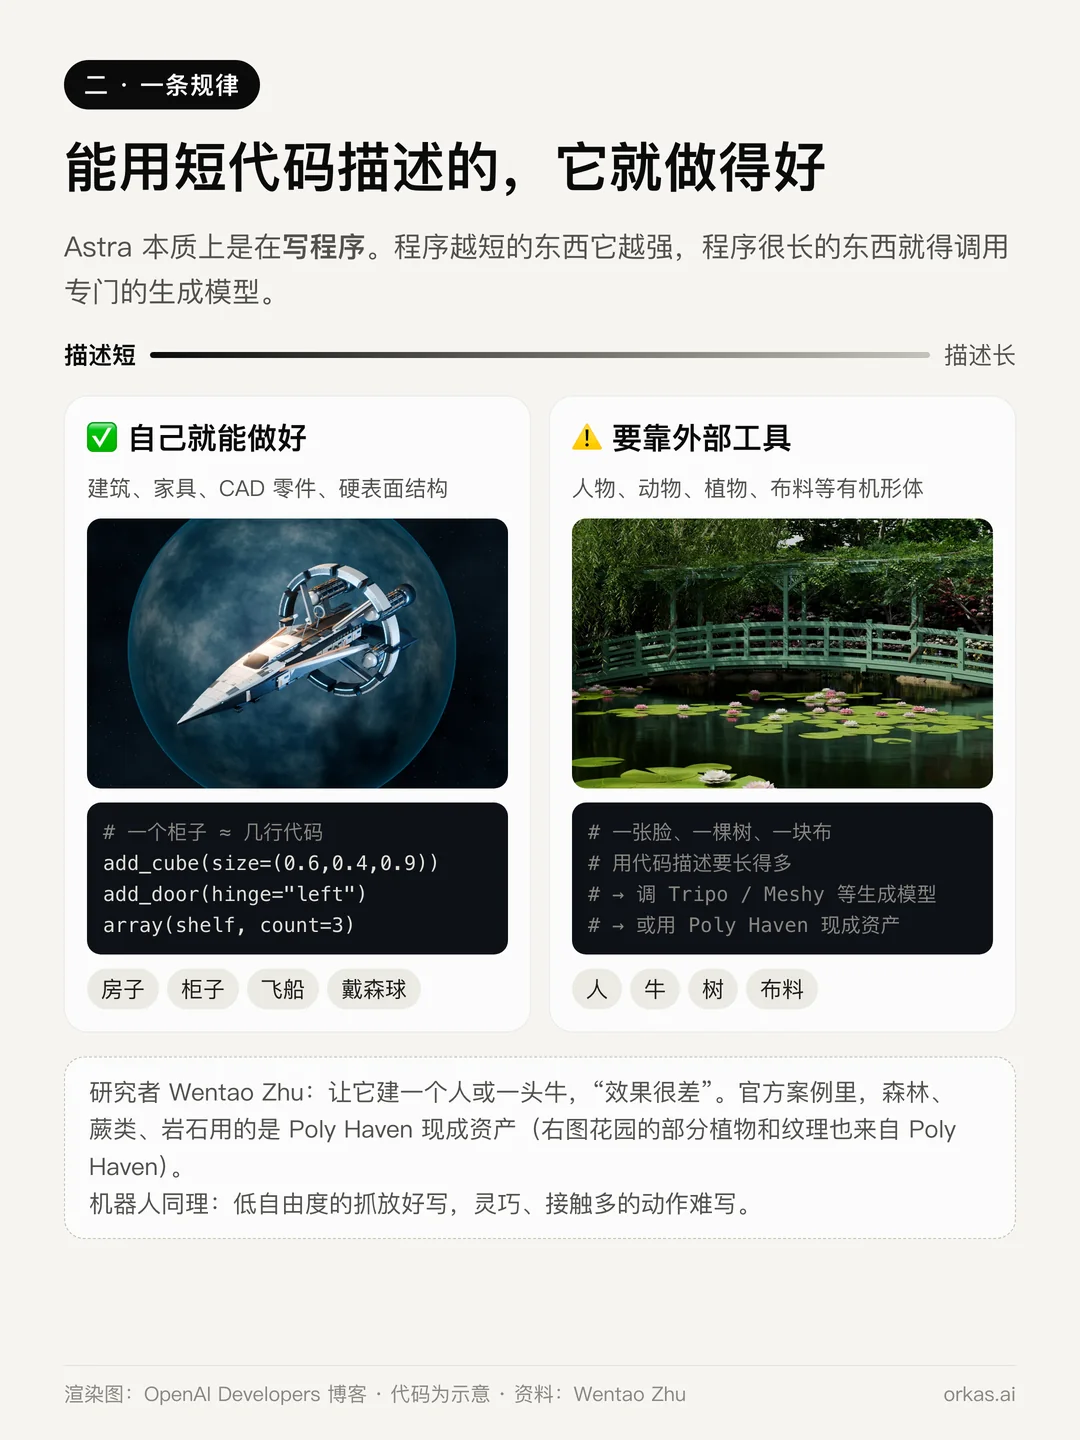
- 规则的人造几何做得好:建筑、家具、CAD 零件,以及飞船、戴森球这类硬表面模型。
- 有机形体做不好。研究者 Wentao Zhu 写道,让它建一个人或一头牛,效果很差。
- 在 OpenAI 自己的项目里,森林、蕨类和岩石用的是 Poly Haven 的现成资产。社区里常见的做法是先用 Tripo 这类 3D 工具生成模型,再把材质、表情形变和骨骼绑定交给 Astra。
一个想法就能解释这个规律:代码是对几何的压缩。一个柜子就是几个长方体,加上挤出和阵列,几行代码就够了;一张脸、一棵树、一块垂下来的布,要长得多。Astra 本质上是在写程序,所以程序短的东西它自己就能做好,程序长的东西就应该交给专门的生成模型。同样的规律,在机器人上还会再出现一次。
机器人:成绩亮眼,但要看清条件
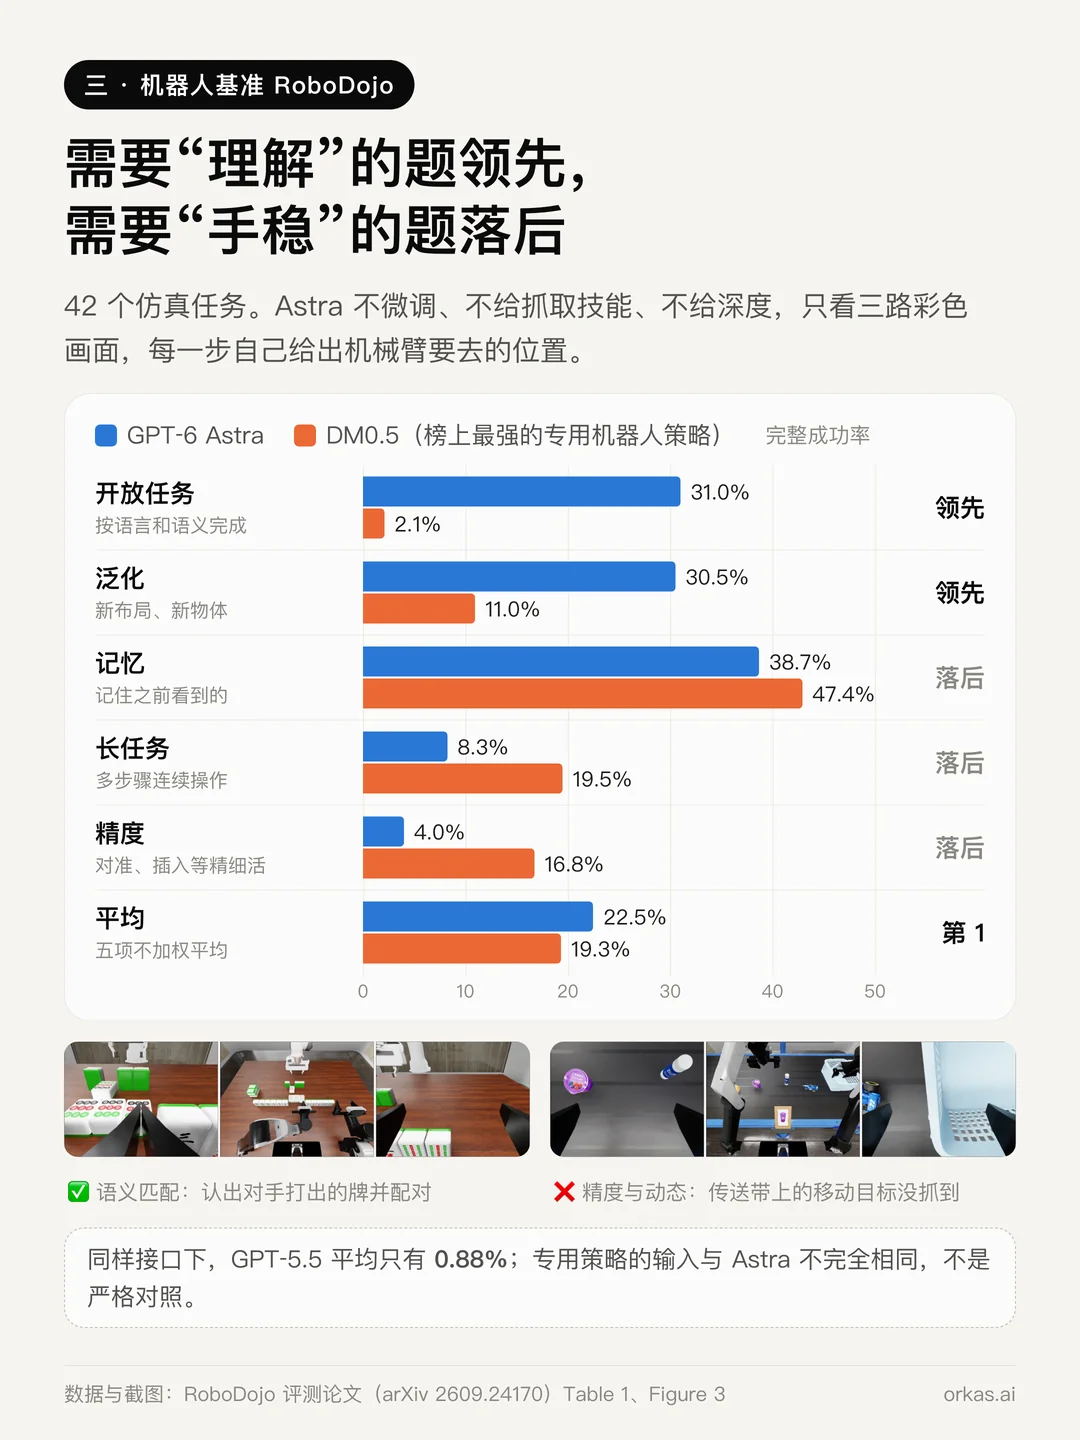
RoboDojo 是一个机器人基准,有 42 个仿真任务,榜上有 40 个专门训练出来的机器人策略。一篇评测论文直接把 Astra 当成机器人的“策略”来用:不微调,不给现成的抓取技能,也不给深度信息。它只看三路彩色画面和机器人状态,每一步自己报出机械臂要去的位置。
- Astra 平均成功率 22.48%,排第一。同样条件下,GPT-5.5 只有 0.88%。
- 但各项很分裂:开放任务 31% 对 DM0.5 的 2.1%、泛化 30.5% 对 11%,大幅领先;精度只有 4%(DM0.5 是 16.8%),长任务和记忆也落后。
简单说:需要“理解”的题它赢,需要“手稳”的题它输。
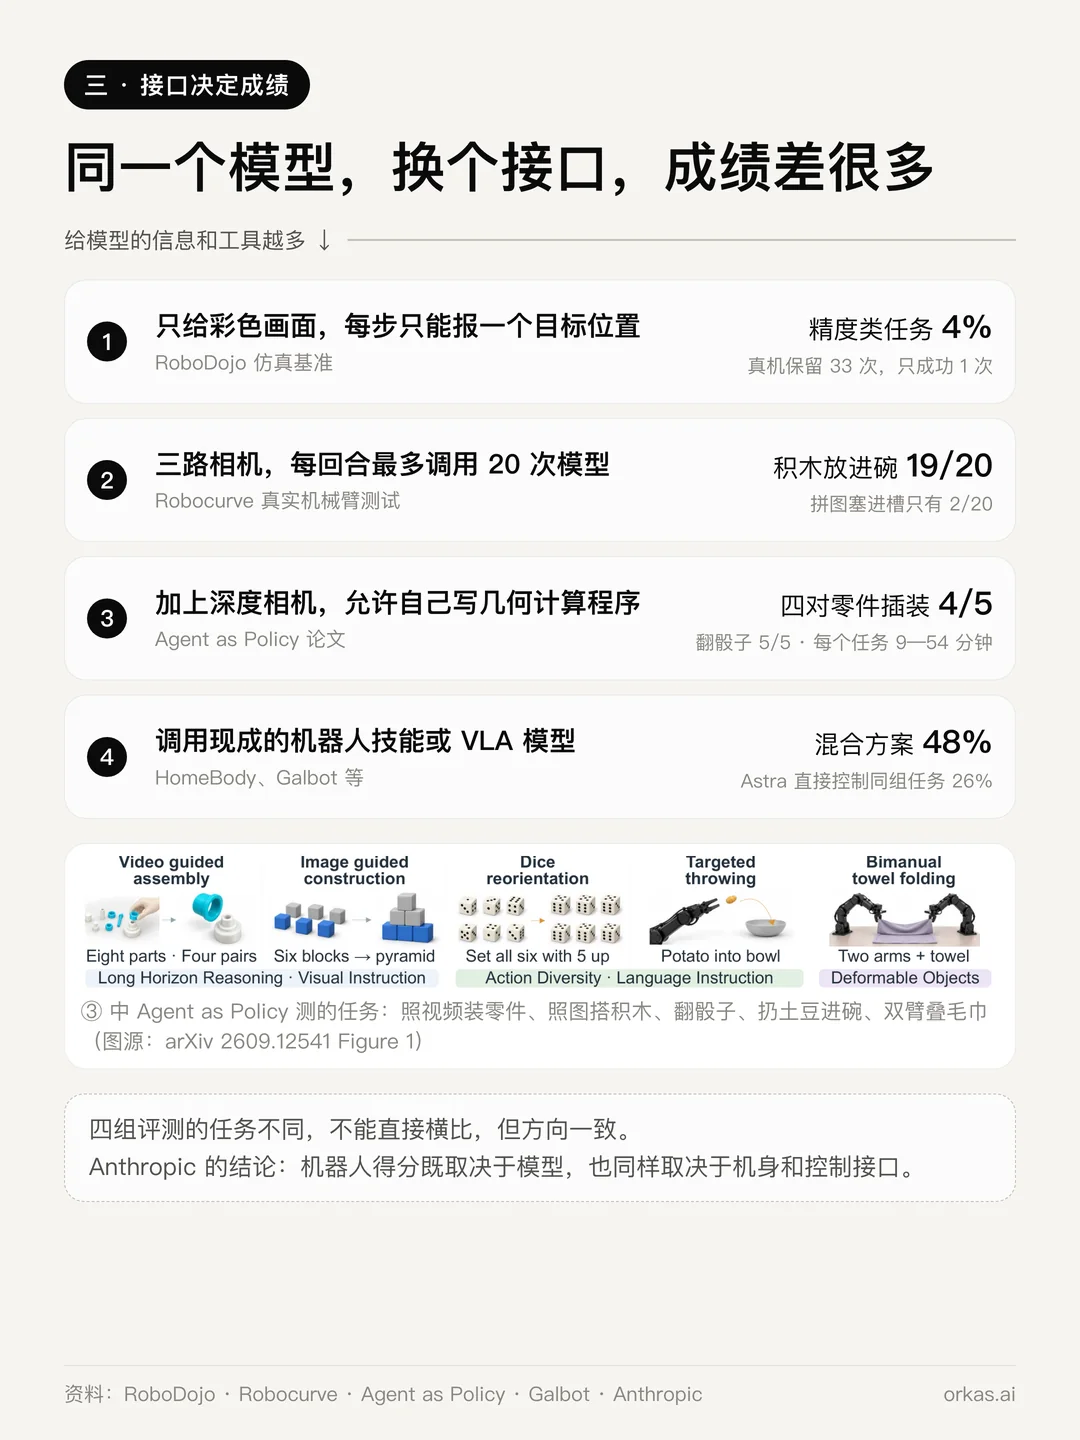
更值得注意的,是结果有多依赖接口:
- 只给彩色画面,每步只能报一个目标位置(RoboDojo):精度类任务 4%;安全停止前后保留下来的 33 次真机试验里,只有 1 次完整成功。
- 三路相机,每次尝试最多调用 20 次模型(Robocurve 的真实机械臂测试):积木放进碗 19/20,但拼图塞进槽只有 2/20。
- 加上深度相机,并允许它自己写几何计算程序(Agent as Policy v1 · 表 1 论文):四对零件插装 4/5,翻骰子 5/5,照图搭积木 5/5、5/5、4/5,这些任务的成功试验平均耗时约为 21—54 分钟。
- 调用现成的机器人技能或 VLA 模型:长任务能做完。在一份评测报告里,“Astra 审阅并修正 VLA 动作”的混合方案成功率是 48%,同一组任务上 Astra 直接控制只有 26%。
这几组评测任务不同,不能直接横比,但方向一致。Anthropic 7 月发布的机器人研究也是同样的结论:模型在机器人上的得分,既取决于模型本身,也同样取决于机身和控制接口。所以讨论“Astra 的空间能力有多强”,必须加上“在什么接口下”。
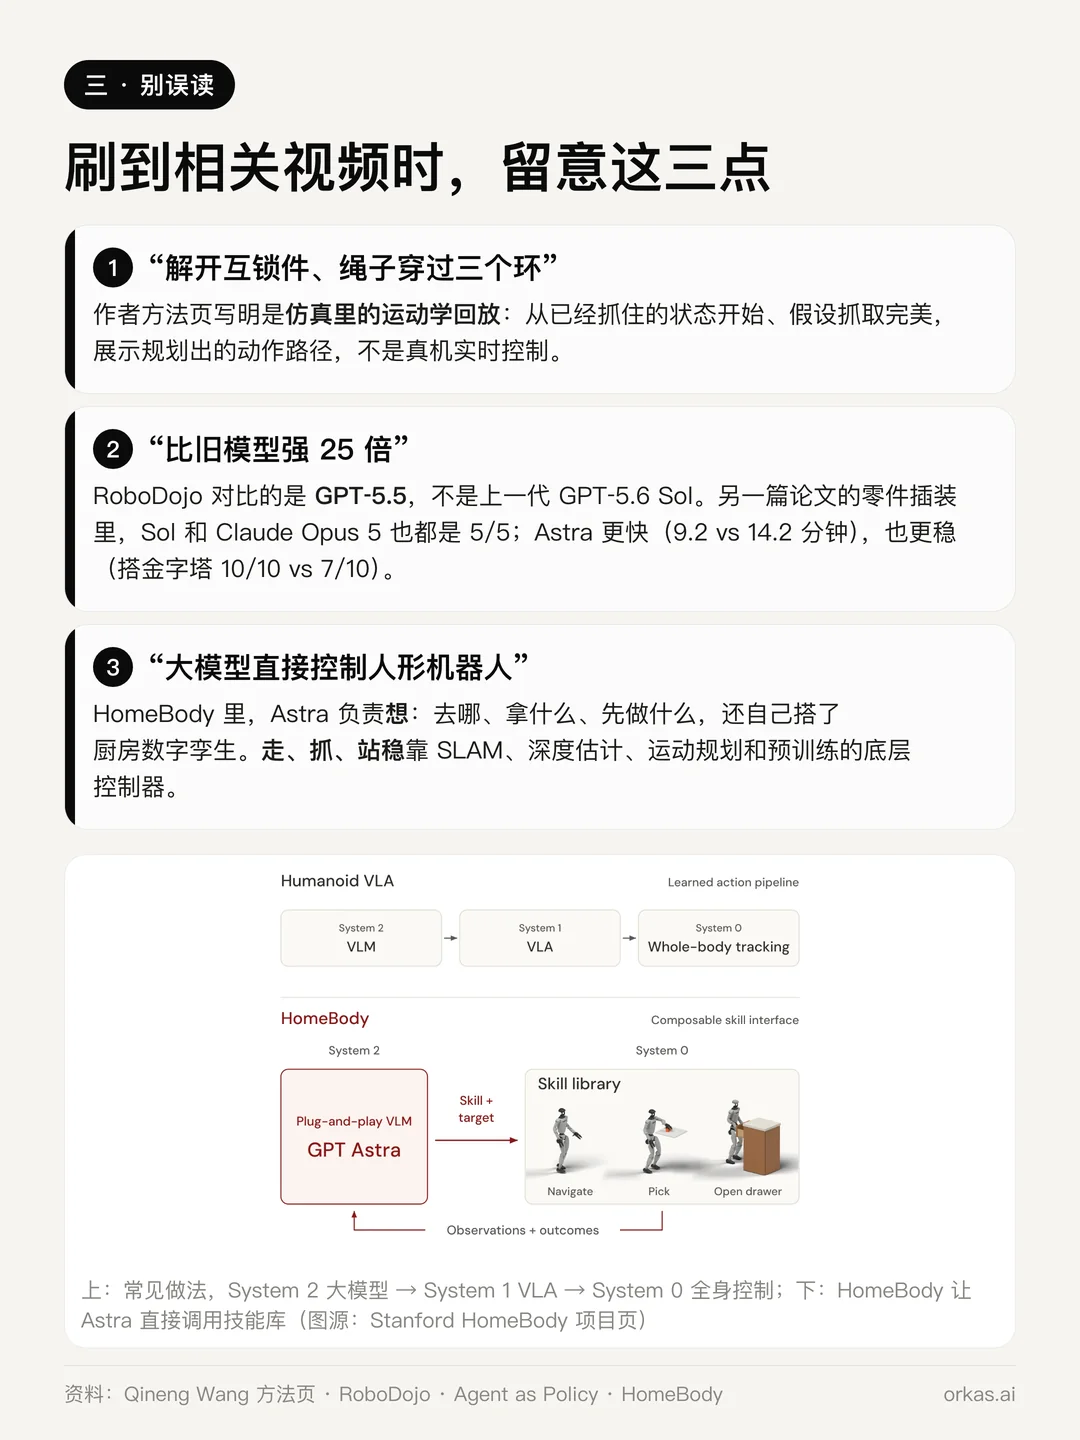
刷到相关演示时,有三点值得留意:
- 爆火的“解开互锁件、绳子穿过三个环”是仿真里的运动学回放。作者的方法页写明,它从已经抓住的状态开始,并假设抓取完美:展示的是规划出来的路径,不是真实机器人在实时控制。
- “比旧模型强 25 倍”对比的是 GPT-5.5,不是直接前代 GPT-5.6 Sol。 在两对零件的插装比较中(AGP v1 · 表 2),Sol 和 Claude Opus 5 也都是 5/5;成功试验中,Astra 平均用时 9.2 分钟,Sol 为 14.2 分钟。在单独的金字塔比较中(AGP v1 · 附录 C, 表 5),Astra 是 10/10,Sol 为 7/10。
- 斯坦福 HomeBody 的厨房机器人:Astra 负责“想”,决定去哪、拿什么、先做什么,还自己搭了厨房的数字孪生;走、抓和站稳,靠的是 SLAM、深度估计、运动规划和预训练的底层控制器。
这些能力是怎么来的
OpenAI 公开说过两点:Astra 做了“针对专业环境的针对性训练”,并且和 OpenAI 其他推理模型一样用强化学习训练。它没有公开训练数据,也没说有没有用 Blender、有没有机器人数据。下面是基于公开证据的推断。
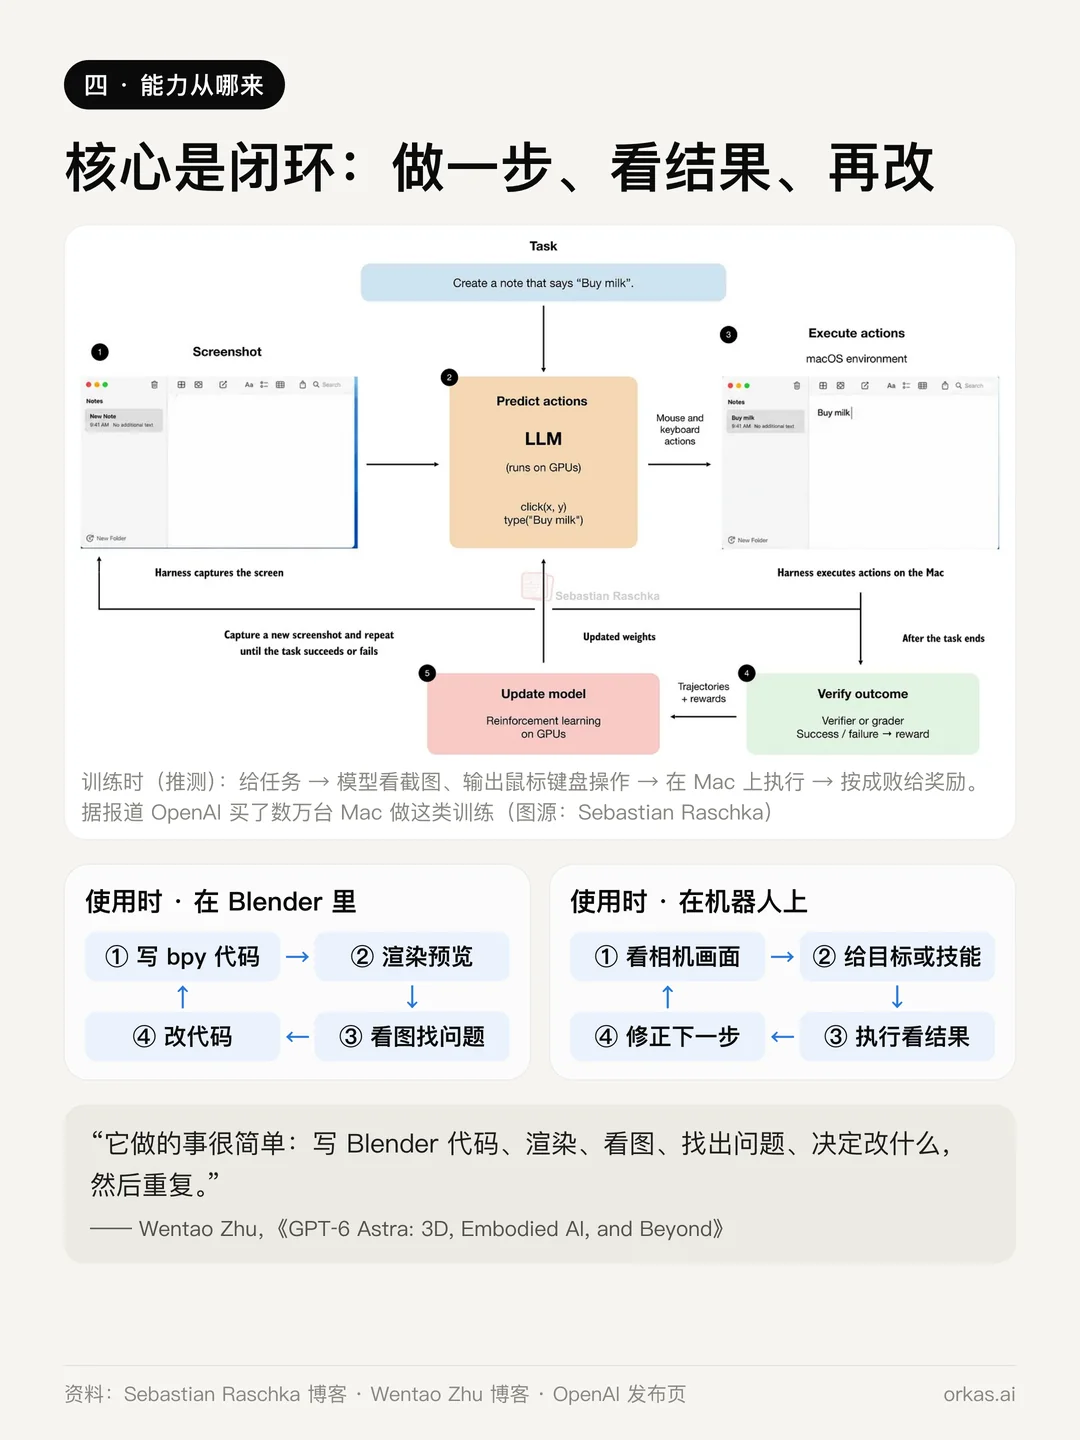
核心是一个闭环:做一步,看结果,找出哪里不对,再改。
- 使用时,Astra 在 Blender 里写代码、渲染、看图、修改;在机器人上看画面、给目标、执行、检查、修正。用 Wentao Zhu 的话说:“它做的事很简单:写(Blender)代码、渲染、看图、找出问题、决定改什么,然后重复。”
- 训练时,大概率也是这个闭环。据报道,OpenAI 买了数万台 Mac mini 和 Mac Studio 来训练模型操作电脑:给一个任务,让模型看截图、向 Mac 发出鼠标键盘操作,再奖励成功的那些。
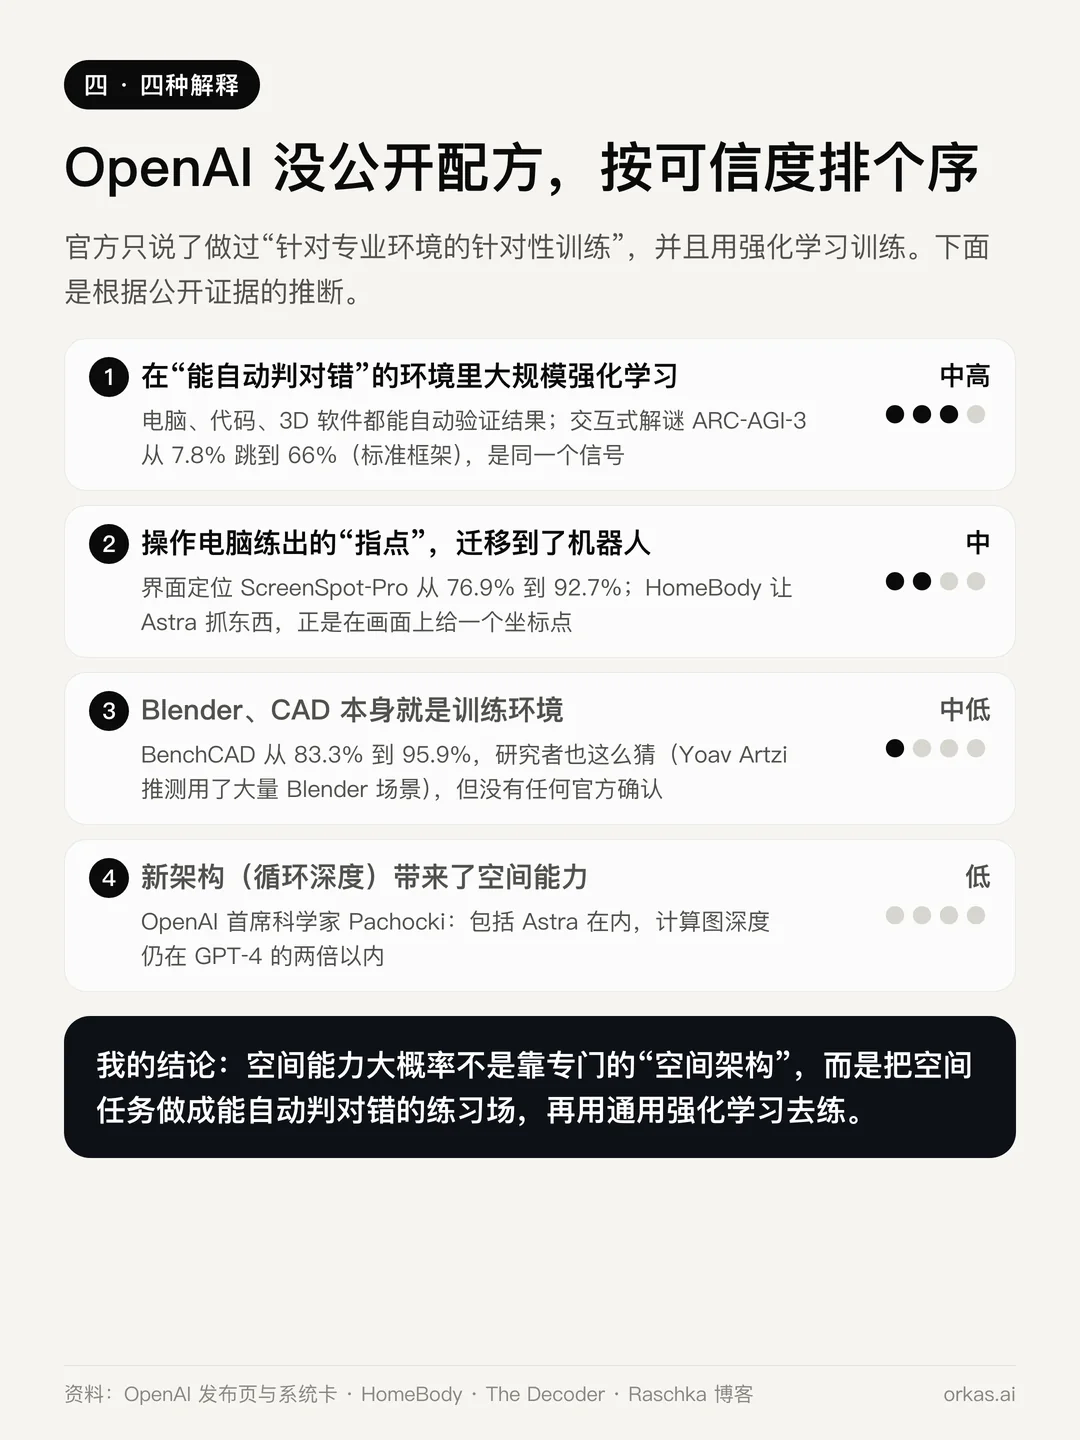
- 在能自动判对错的环境里大规模强化学习(可信度:中高)。电脑、代码和 3D 软件都能自动验证结果,练出的是“检查、找错、修正”的通用能力。交互式的 ARC-AGI-3 从 7.8% 跳到 66%,是同一个信号。
- 操作电脑练出来的“指点”能力迁移到了机器人上(可信度:中)。ScreenSpot-Pro 从 76.9% 涨到 92.7%,说明它在图上精确点中目标的能力强了很多。在 HomeBody 里,Astra 抓东西的方式恰好就是在相机画面上给出这样一个点,再由深度和标定算出三维位置。
- Blender 和 CAD 本身就是训练环境(可信度:中低,未证实)。BenchCAD 大涨,OpenAI 主推 3D 案例,Yoav Artzi 也推测训练用了大量 Blender 场景之类的 3D 数据,但没有任何官方确认。
- 新架构(可信度:低)。据报道 Astra 在部分网络结构里用了“循环深度”,但 OpenAI 首席科学家 Jakub Pachocki 表示,包括 Astra 在内,现有前沿模型的计算图深度仍在 GPT-4 的两倍以内。
我们的判断:空间能力大概率不是靠专门的空间架构换来的,而是把空间任务做成能自动判对错的练习场,再用通用的强化学习去练。
对 3D 生成意味着什么
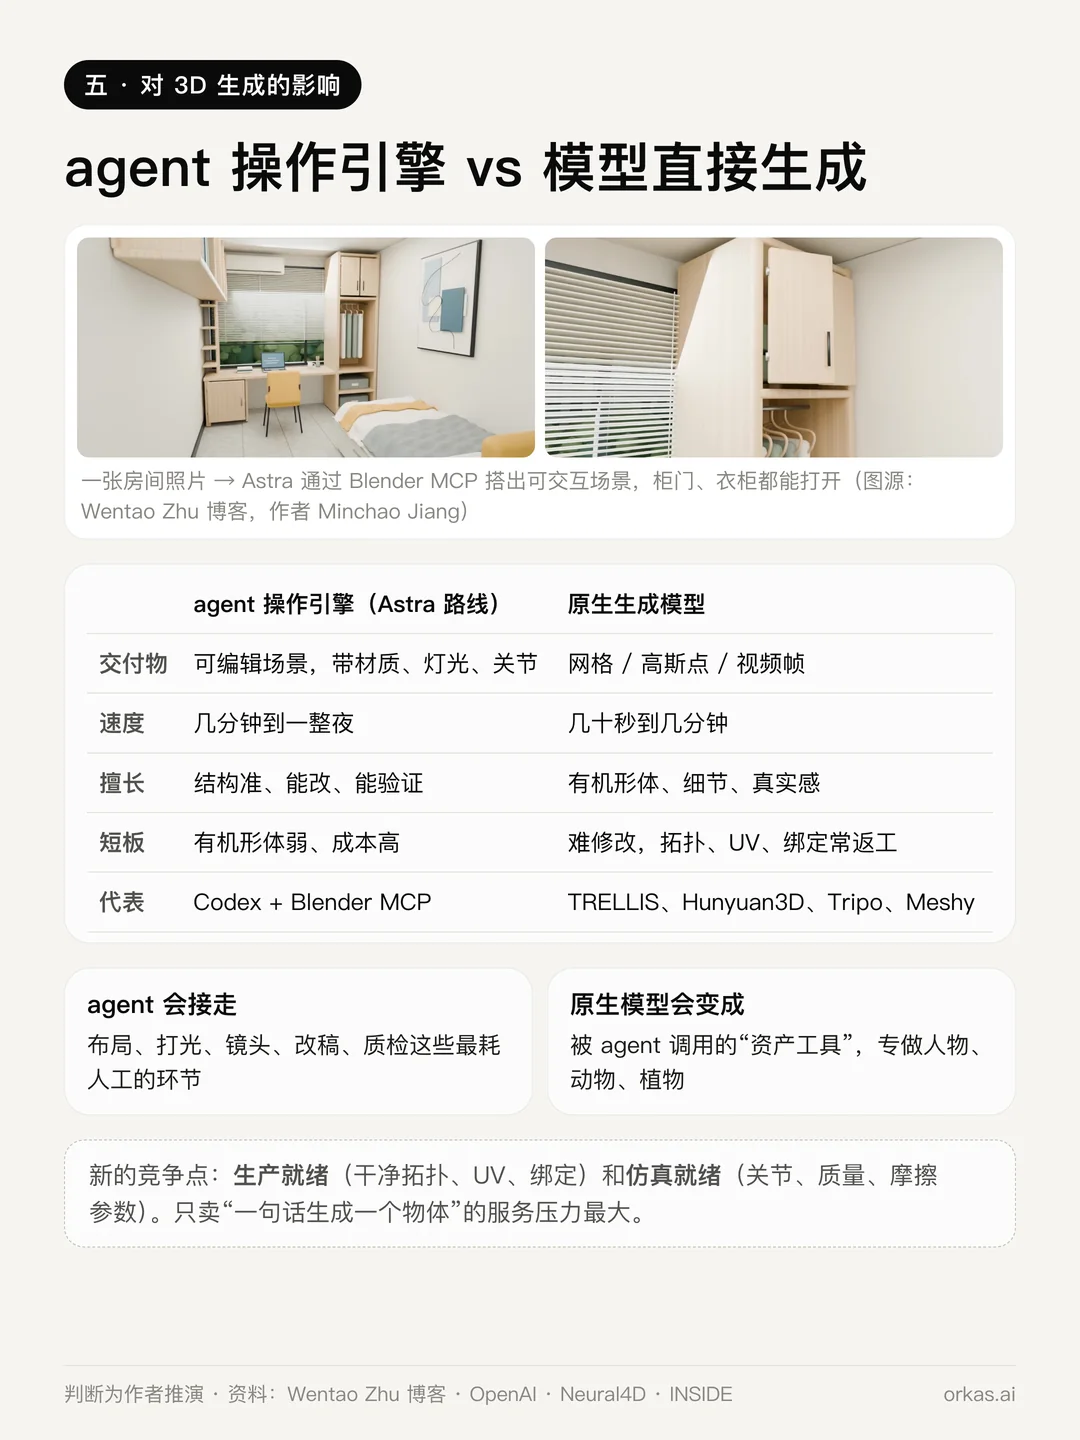
现在做 3D 有两条路:
- agent 操作引擎。像 Astra 在 Blender 或 CAD 里那样,交付带材质、灯光和关节的可编辑场景。慢,几分钟到一整夜,但结构准、能修改、能验证。
- 模型直接生成资产。TRELLIS、Hunyuan3D、Tripo、Meshy 这类模型几秒到几分钟就输出一个网格。擅长有机形体和细节,但结果不好改,拓扑、UV 和骨骼绑定常常要返工。
我们的判断是,两者会互补,但价值会重新分配:
- 最耗人工的环节会被 agent 接走:布局、打光、镜头、改稿和质检。
- 生成模型会变成做人物、动物、植物的资产工具,而且必须能被 agent 调用,比如做成 MCP 服务器或 API。
- 只卖“一句话生成一个物体”的服务压力最大。生产就绪(干净的拓扑、UV、骨骼绑定)和仿真就绪(关节、质量、摩擦参数)会成为新的竞争点。
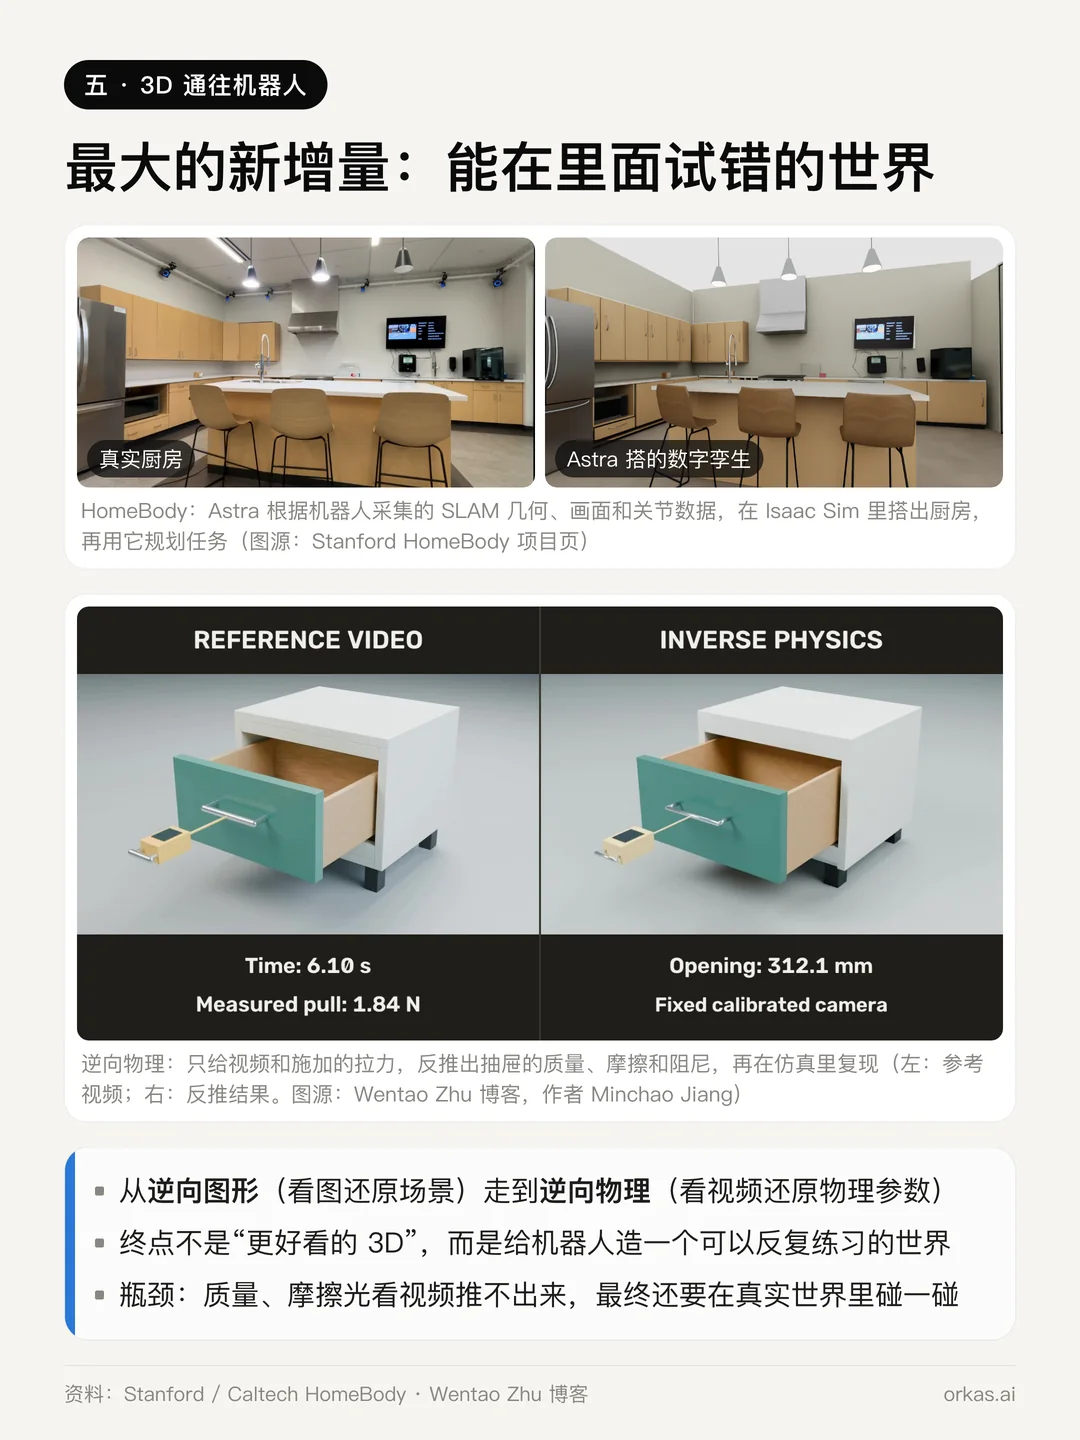
最大的新增量不是更好看的 3D,而是一个能在里面练习的世界。
- 在 HomeBody 里,Astra 根据机器人自己采集的 SLAM 几何、相机画面和关节数据,在仿真软件里搭出了厨房的数字孪生,再用它来规划任务。
- Wentao Zhu 团队演示了“逆向物理”:只给视频和施加的拉力,模型反推出抽屉的质量、摩擦和阻尼,并在仿真里复现了这段运动。
换句话说,3D 能力最终通向的,是给机器人用的练习场。难点在于:质量和摩擦光看视频推不出来,总有一步得真的去推一推实物。
原生世界模型这条路也没有出局。World Labs 的 Atlas 在 9 月 1 日发布,能从几张照片生成、重建整个 3D 世界,真实感和连续性是“agent 操作引擎”比不了的。两条路以后大概率会互相调用。
对机器人大脑意味着什么
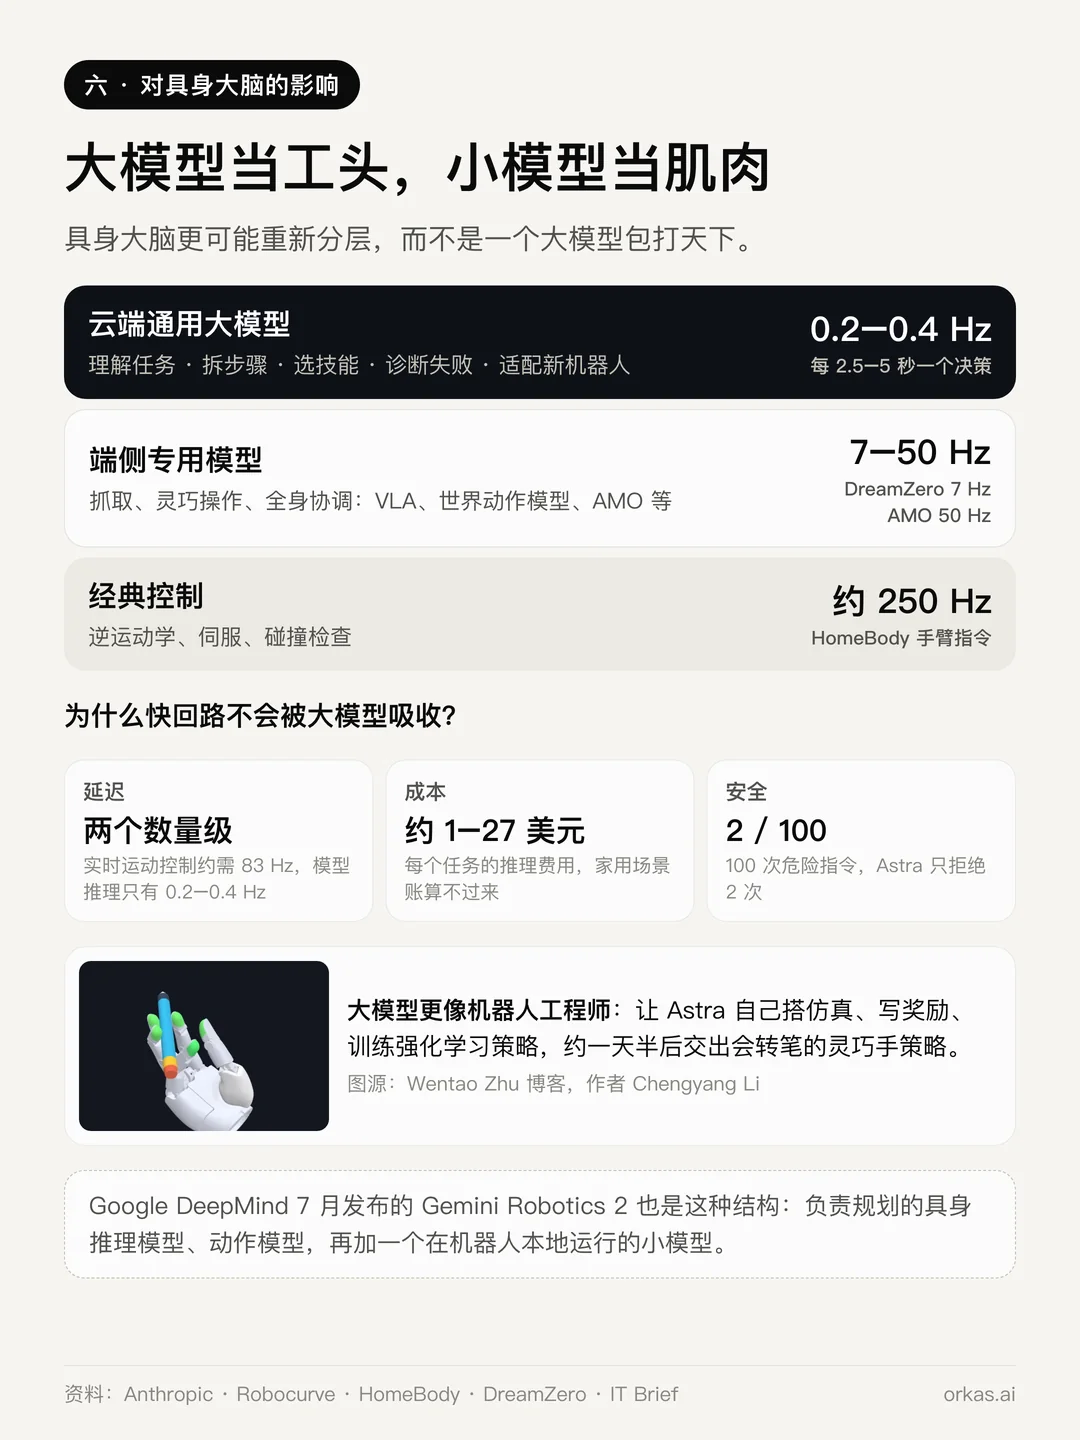
我们认为,机器人大脑会分层,而不是由一个模型包办一切:
- 通用大模型接走的:理解任务、拆解步骤、选择技能、诊断失败、适配新机器人,也就是 VLA 模型过去最引以为傲的“语义泛化”。在 RoboDojo 的开放任务和泛化两项上,Astra 已经超过了专门训练的机器人策略。
- 专用模型保留的:高频控制、接触、灵巧操作和全身平衡。
- 真正的变化在于,这些专用模型会越来越多地由通用模型“造”出来。Wentao Zhu 团队让 Astra 自己搭仿真、写奖励函数、训练强化学习策略,大约一天半后,它交出了一个会转笔的灵巧手策略。
快速控制回路之所以会留在外面,是因为三个硬约束:
- 延迟:Anthropic 测得实时运动控制大约需要 83 Hz,而模型推理只有 0.2—0.4 Hz,差了约两个数量级。
- 成本:上面这些评测里,每个任务大约 1—27 美元,而家用机器人一天要做几百个动作。
- 安全:在 Robocurve 的 RoboHarm 测试里,100 次危险指令 Astra 只拒绝了 2 次。安全需要一套不依赖云端的独立护栏。
Google DeepMind 7 月发布的 Gemini Robotics 2 已经是这种结构:一个负责规划的具身推理模型、一个动作模型,再加一个在机器人本地运行的小模型。
这能证明自回归模型赢了吗
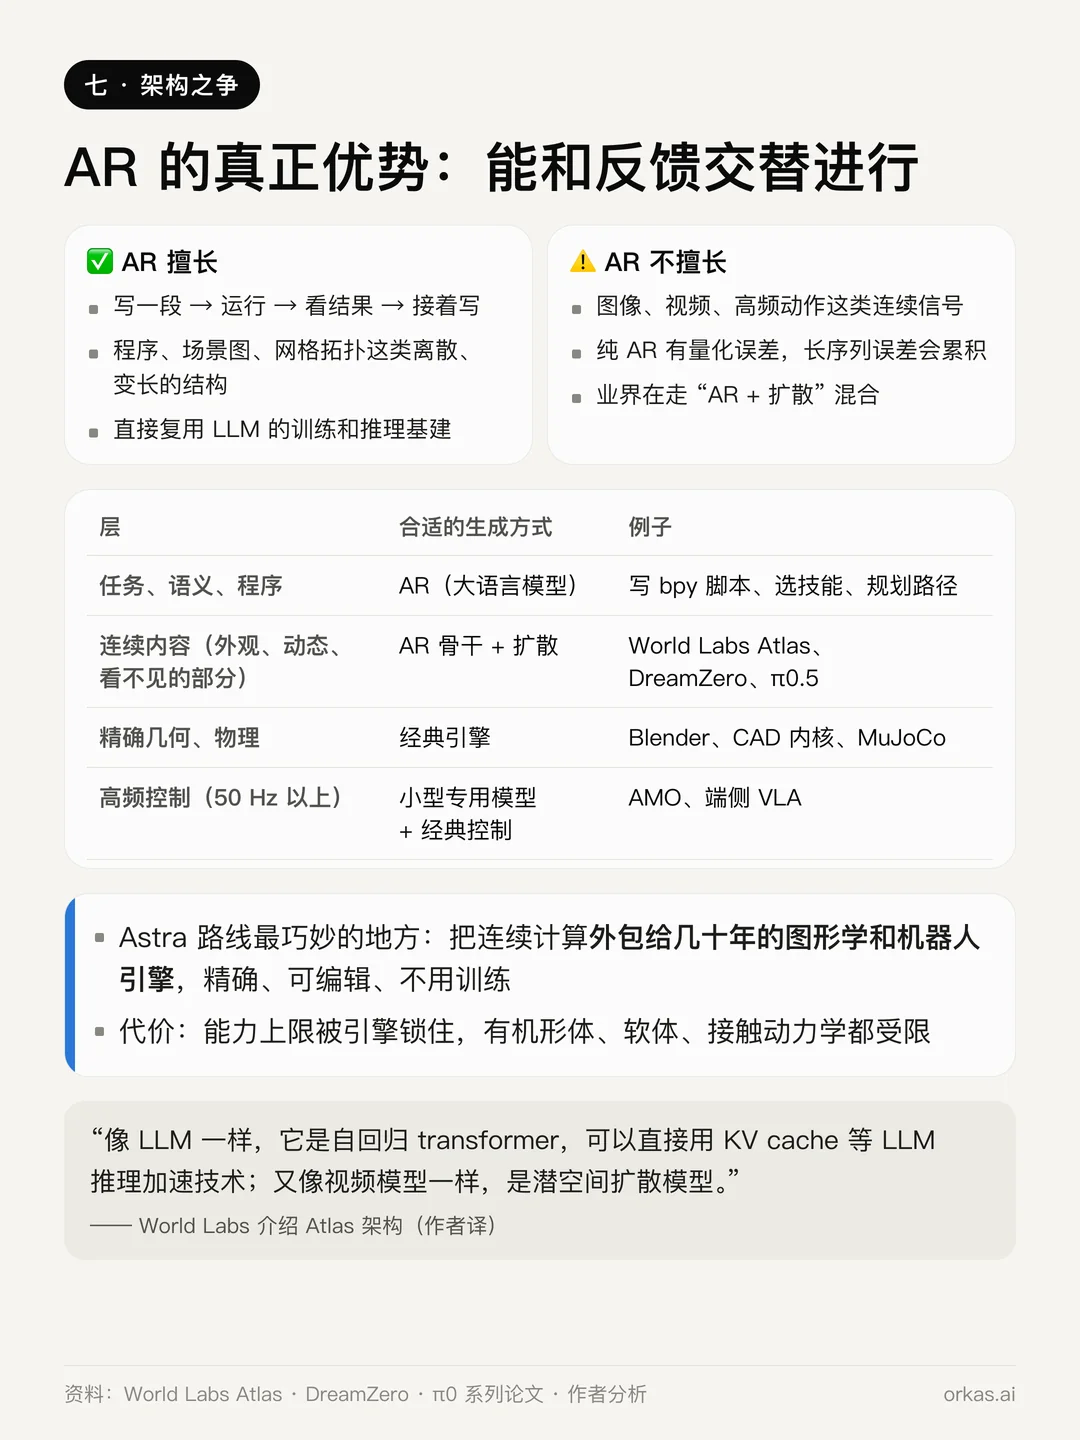
有观点认为,Astra 说明自回归(AR,也就是 GPT 那种一个 token 接一个 token 往后生成)的架构更有优势。我们同意一半:
- AR 真正的优势,是生成可以和外部反馈交替进行:写一段代码,运行,看结果,再接着写。扩散模型一次生成整个结果,很难在中途听取反馈。
- AR 也适合程序、场景图、网格拓扑这类离散、变长的结构,还能直接复用为 LLM 建好的训练和推理基础设施。
- 但在图像、视频、动作指令这类连续信号上,纯 AR 并不占优。业界正在走向“自回归骨干 + 扩散或流匹配生成头”:World Labs 的 Atlas、来自 NVIDIA 研究者的 DreamZero 和 π0.5 都是这个思路。
- Astra 路线最巧妙的地方,是把连续计算这一层外包给了渲染器、CAD 内核、物理引擎和运动规划器。几十年的图形学和机器人工程直接拿来当“解码器”,精确、可编辑、不用训练。代价是,能力上限由这些引擎决定。
对用 agent 干活的人意味着什么
我们做的是一个让 agent 干活的桌面应用,所以最在意的是关于接口的那个发现。同一个模型,能看到什么、能调用哪些工具、能不能检查自己的输出,成绩就差得很远。很大一部分能力存在于这个闭环里,而不只在模型权重里。
这个闭环,正是 agent 工作台要提供的:可以动手的工具,可以处理的文件,以及在交给你之前 agent 自己能检查的结果。在 Orkas 里,你可以用自己的 OpenAI API Key 或登录 ChatGPT 账号来运行 GPT-6 Astra,可以把 Codex 作为外部 agent 接进来,也可以直接用 Orkas 托管的模型。Orkas 还支持添加自定义 MCP 服务器,所以社区为桌面软件做的 MCP 服务器可以作为连接器加进来。我们没有端到端测试过 Blender 的 MCP 服务器,所以请把这当成一条需要自己动手的路。
我们的结论
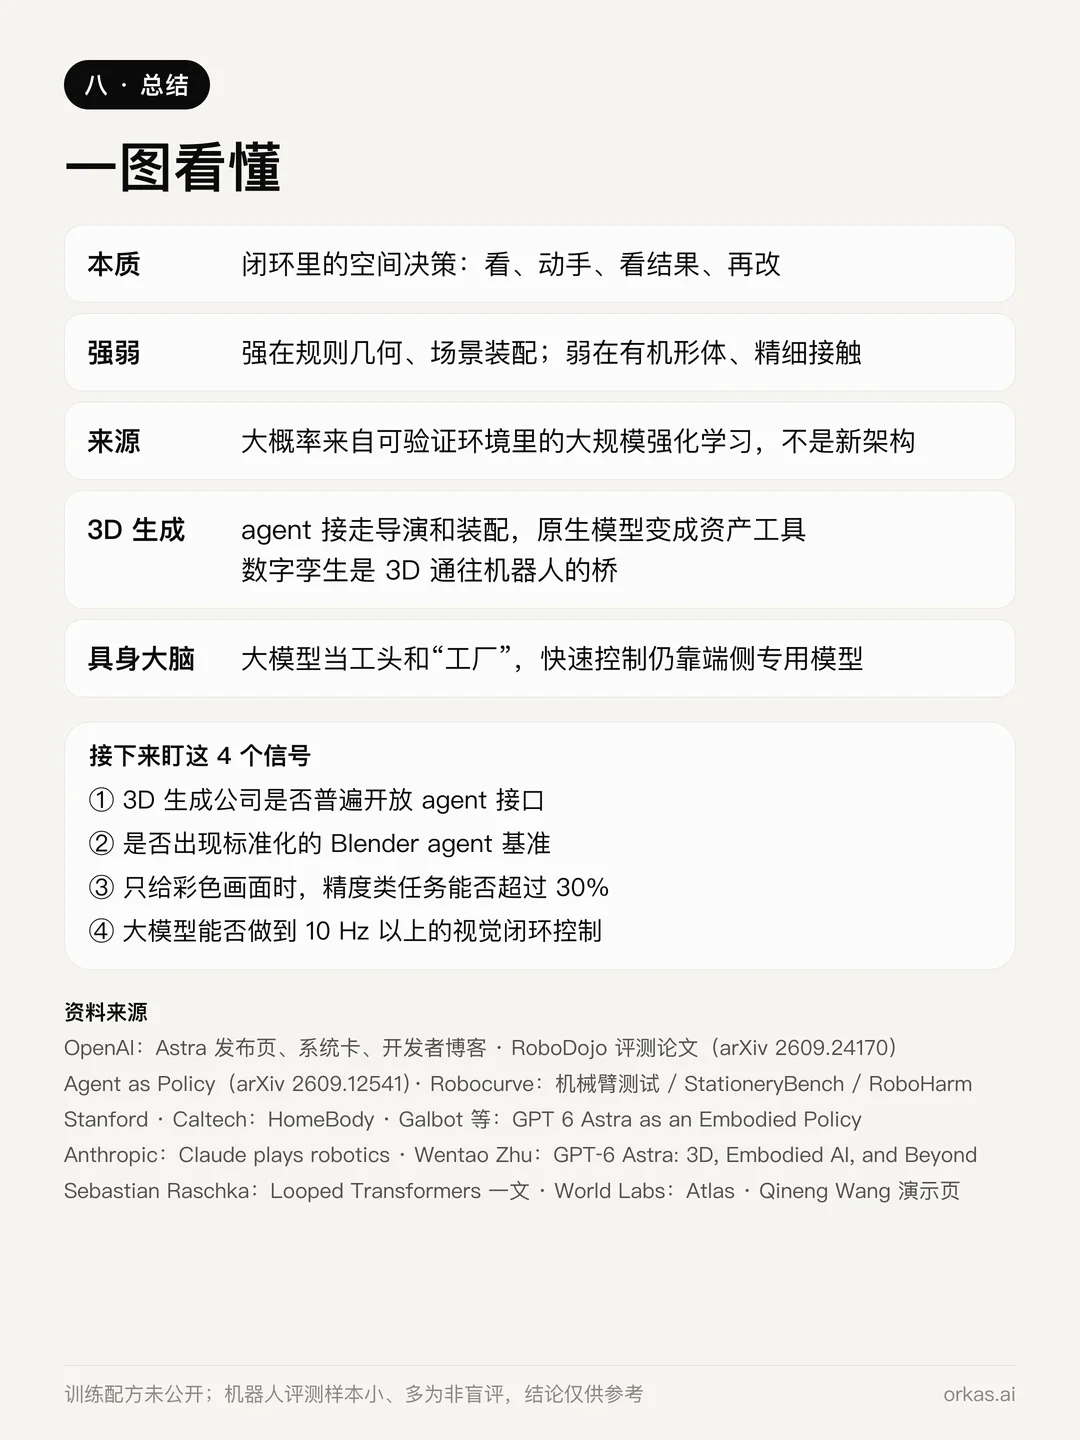
- Astra 的“懂空间”,本质是在闭环里做决策:看,写代码或给目标,执行,检查,修正。
- 它强在规则几何、场景装配和“语义 + 空间”的组合判断,弱在有机形体和精细接触,原因在于短程序能描述什么。
- 这种能力大概率来自在能自动判对错的环境里大规模强化学习,而不是新架构。训练配方至今没有公开。
- 在 3D 生成上,agent 接走导演和装配,生成模型变成资产工具,数字孪生是通往机器人的桥。
- 在机器人大脑上,通用模型成了工头和“工厂”,快速控制仍然留给端侧的专用模型。
接下来值得关注的信号:3D 生成公司会不会开放给 agent 用的接口;会不会出现标准化的 Blender agent 基准;只给彩色画面时,精度类任务能不能突破 30%;前沿模型能不能做到 10 Hz 以上的视觉闭环控制。
需要说明的是:上面的机器人评测大多样本很小,每组 5—20 次,而且多数不是盲评。请把这些结论当成阶段性的判断,而不是定论。
资料来源:OpenAI 的 GPT-6 Astra 发布页和系统卡;Fortune 的发布报道;Wentao Zhu 的 GPT-6 Astra: 3D, Embodied AI, and Beyond;以及 Sebastian Raschka 关于循环 Transformer 的文章,文中引用了 Pachocki 的说法。其他来源在正文引用处给出了链接。