
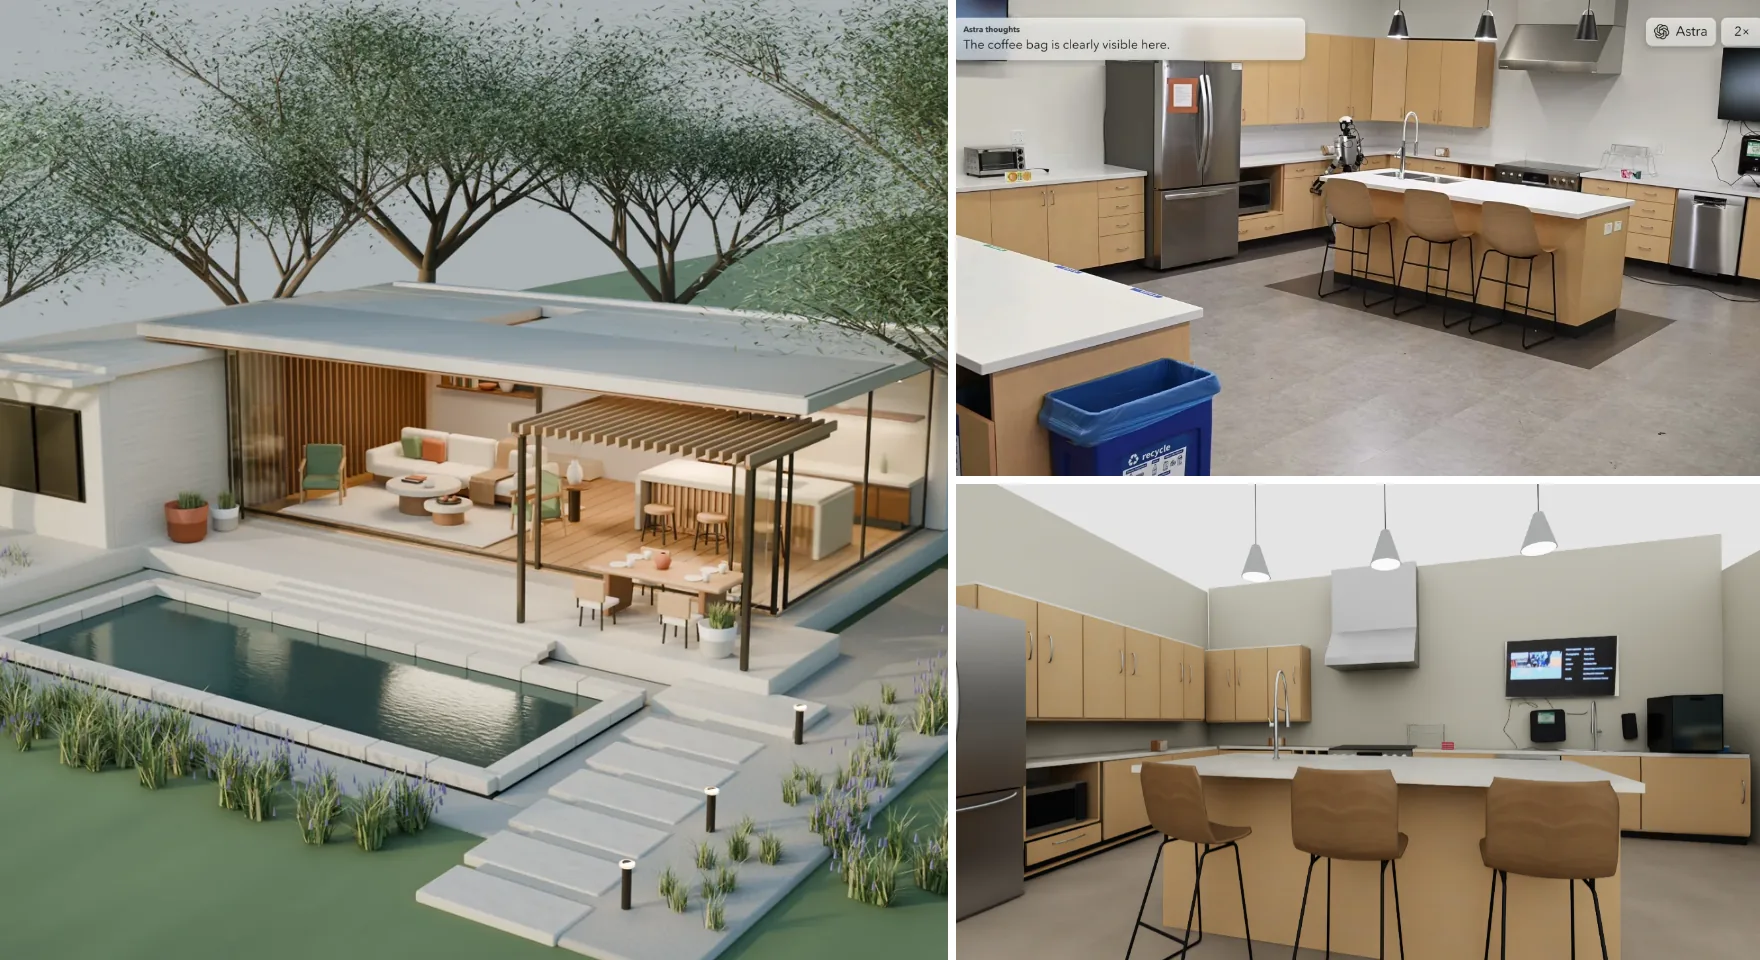
9 月初 OpenAI 發表 GPT-6 Astra 之後,有兩類影片傳得很快。一類是它在 Blender 裡從零蓋出一整棟附家具的房子,再匯入 Unreal Engine 5,人可以走進去開門、開燈、煮咖啡;另一類是它直接指揮機械手臂和人形機器人做事。
一個語言模型,怎麼突然「懂空間」了?OpenAI 有沒有專門針對空間做最佳化?這條路線對 3D 生成和機器人的「大腦」又意味著什麼?我們讀了 OpenAI 的發表頁面、系統卡和開發者部落格,之後陸續發表的機器人評測,以及研究者的分析。先說結論:
- 進步是真的,但很不平均:3D、視覺定位和互動類任務進步很多,綜合智力幾乎沒動。
- 機器人上的表現很看介面:同一個模型換一種用法,成績會差很多。
- 這種能力最有可能來自在「能自動判斷對錯」的環境裡反覆練習,而不是新架構。
- 對 3D 生成和機器人大腦來說,更可能是重新分工,而不是誰取代誰。
官方成績:進步很大,但分布很不平均
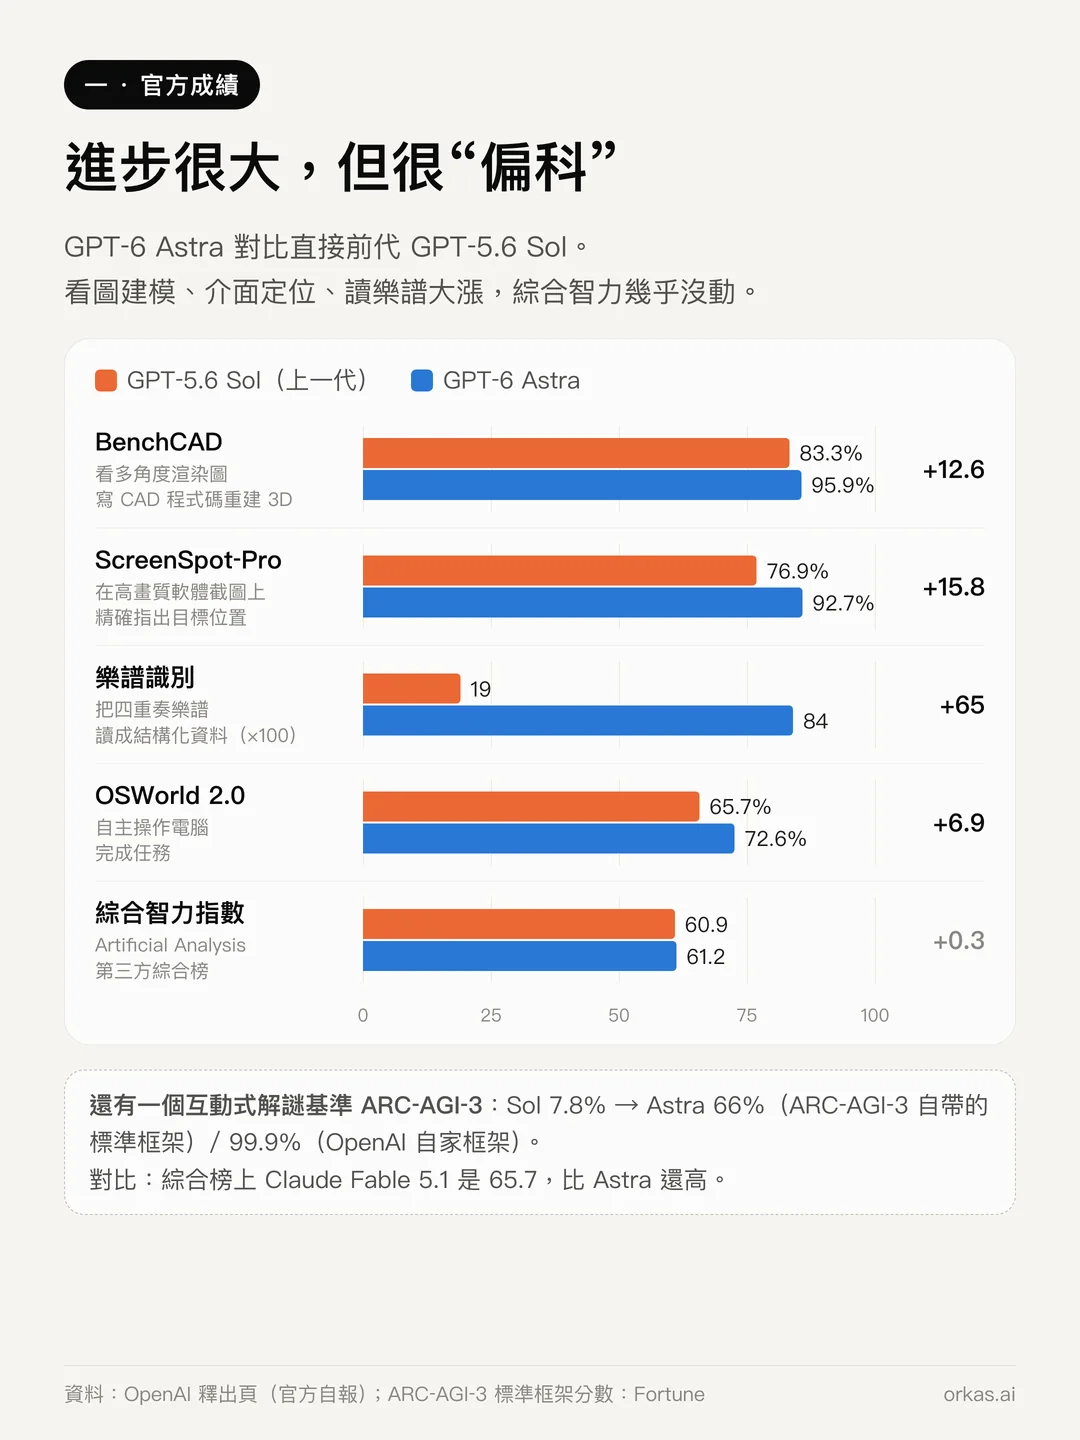
和直接前代 GPT-5.6 Sol 相比,OpenAI 公布的幾個數字是這樣的:
- BenchCAD:83.3% → 95.9%。給模型看一個物體多個角度的渲染圖,讓它寫 CAD 程式碼把物體重建出來,相當於「看圖建模」。
- ScreenSpot-Pro(不用工具):76.9% → 92.7%。在專業軟體的高解析度截圖上,精確指出某個按鈕或元素在哪裡。
- 樂譜辨識:在 OpenScore 弦樂四重奏上從 0.19 到 0.84,把密密麻麻的印刷樂譜讀成結構化的樂譜資料。
- ARC-AGI-3(互動式解謎基準測試):7.8% → 66%(基準測試內建的標準測試框架),用 OpenAI 自家的框架則是 99.9%。
相較之下,第三方的 Artificial Analysis 綜合智力指數只從 60.9 變成 61.2,還低於 Claude Fable 5.1 的 65.7。
所以 Astra 並不是全面變聰明了,而是在「看 + 動手 + 根據結果調整」這類任務上突飛猛進。Cornell 和 Google DeepMind 的研究者 Yoav Artzi 稱之為空間推理上的「跳躍式進步」。
它在 Blender 裡到底做了什麼
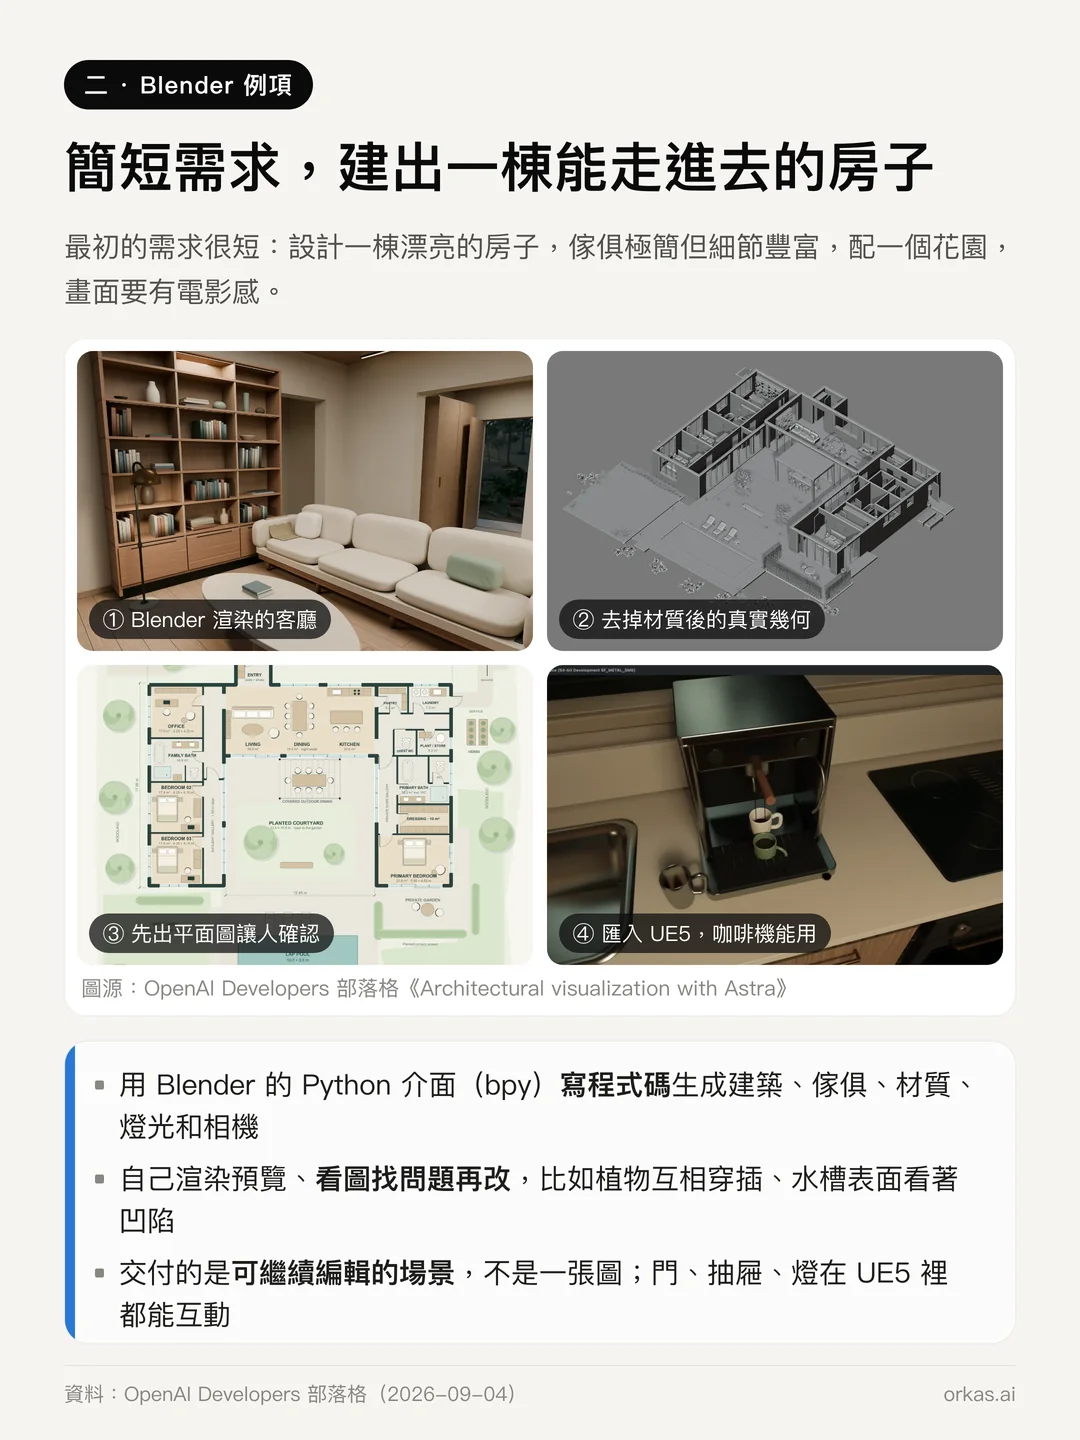
OpenAI 開發者部落格裡有一個完整的專案。最初的需求很短:設計一棟漂亮的房子,家具極簡但細節豐富,配一座花園,畫面要有電影感。
- Astra 用 Blender 的 Python 介面(bpy)寫程式碼,把建築、木作、家具、植栽、材質、燈光和攝影機全都「寫」了出來。
- 它自己渲染預覽圖、看圖找問題,再修改自己的程式碼,例如植物互相穿插、不鏽鋼水槽因為表面法線不對,看起來像被捏凹了一塊。
- 它先畫平面圖讓人確認,再把房子重建成一棟 U 型的單層住宅,有三間臥室和一間書房。
- 它把場景匯出到 Unreal Engine 5,做成第一人稱漫遊,門、抽屜、燈和咖啡機都能用。
交付的不是一張圖,而是一個可以繼續編輯的 Blender 場景。
弱點也同樣清楚:
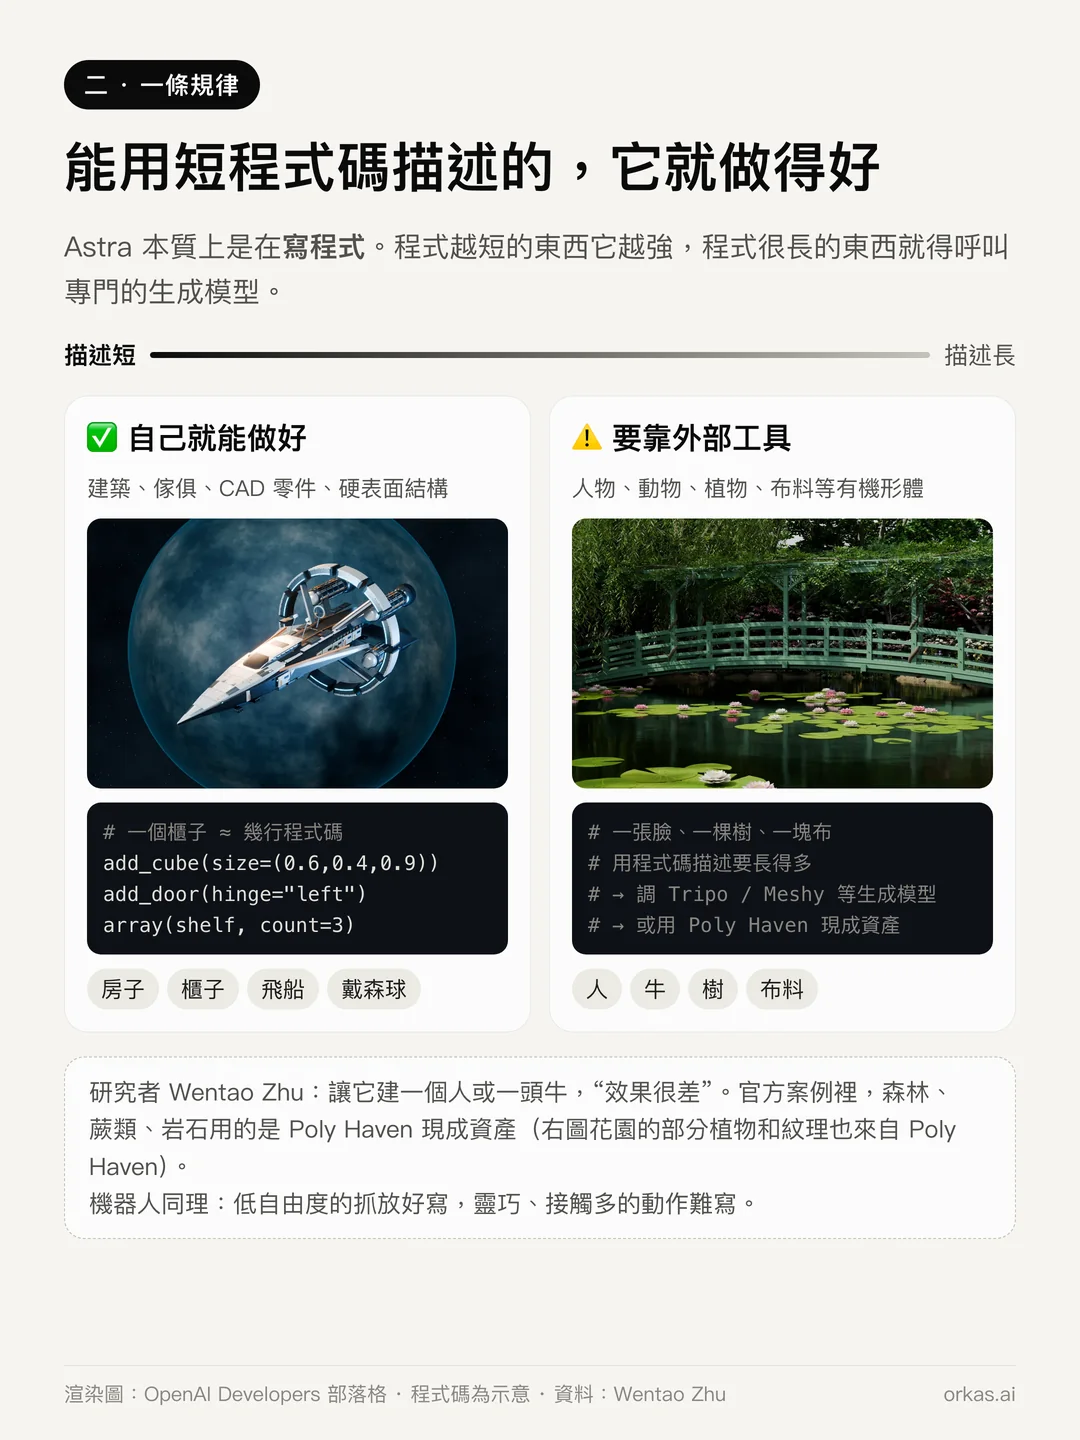
- 規則的人造幾何做得好:建築、家具、CAD 零件,以及太空船、戴森球這類硬表面模型。
- 有機形體做不好。研究者 Wentao Zhu 寫道,讓它建一個人或一頭牛,效果很差。
- 在 OpenAI 自己的專案裡,森林、蕨類和岩石用的是 Poly Haven 的現成資產。社群裡常見的做法是先用 Tripo 這類 3D 工具生成模型,再把材質、表情形變和骨架綁定交給 Astra。
一個想法就能解釋這個規律:程式碼是對幾何的壓縮。一個櫃子就是幾個長方體,加上擠出和陣列,幾行程式碼就夠了;一張臉、一棵樹、一塊垂下來的布,程式碼要長得多。Astra 本質上是在寫程式,所以程式短的東西它自己就能做好,程式長的東西就應該交給專門的生成模型。同樣的規律,在機器人上還會再出現一次。
機器人:成績亮眼,但要看清條件
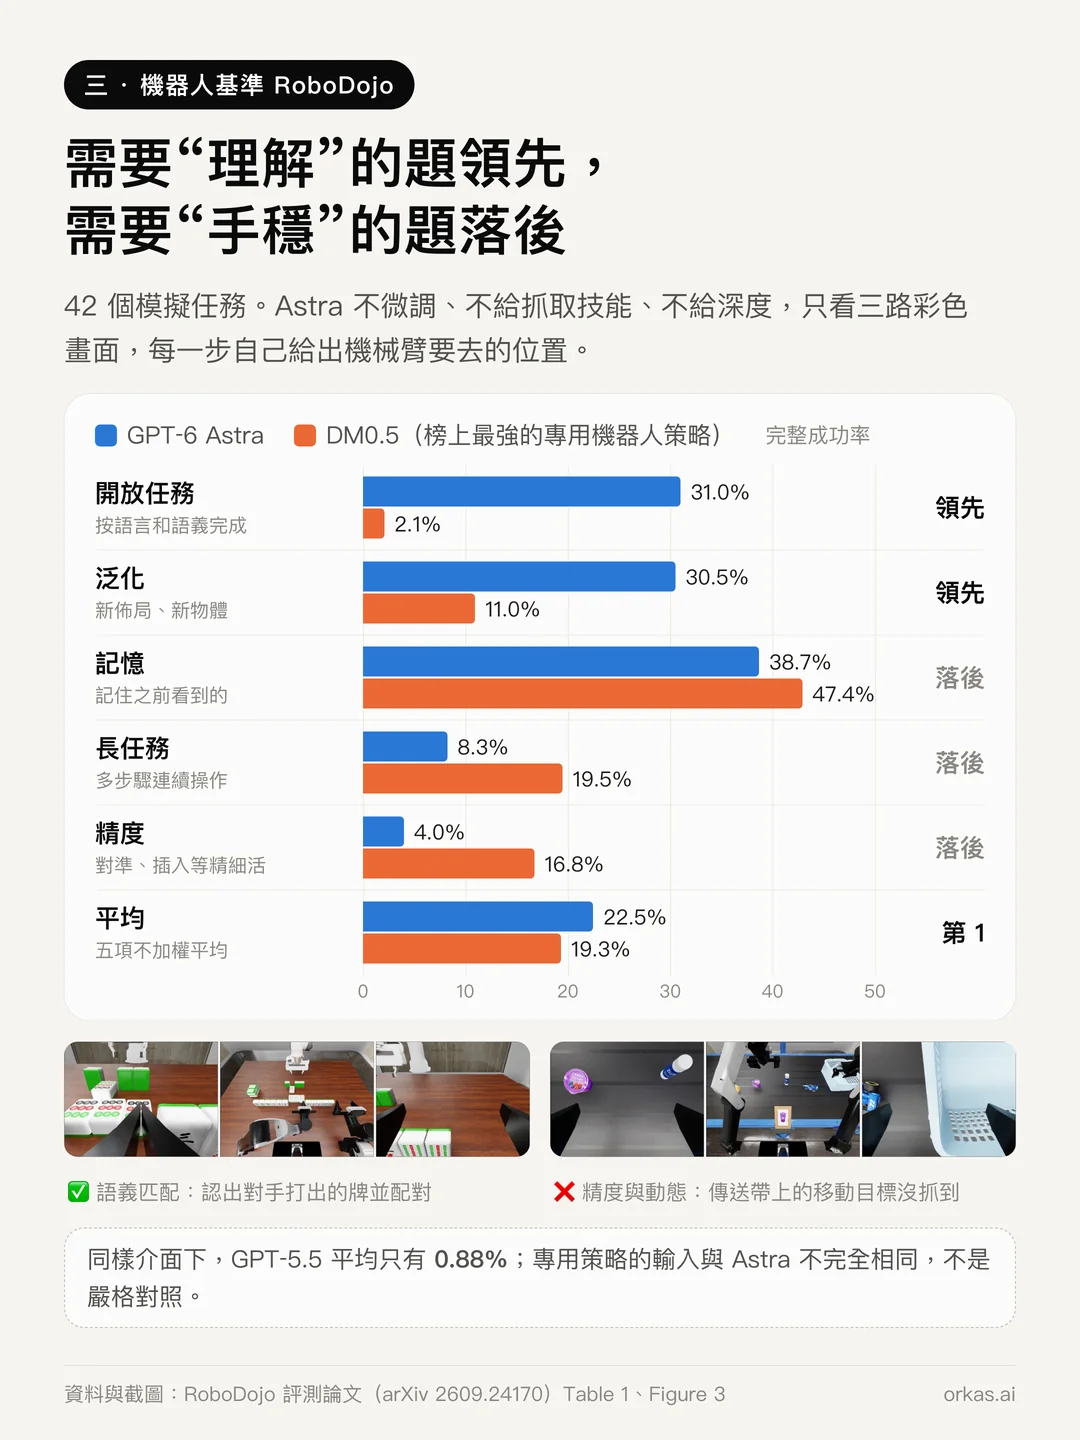
RoboDojo 是一個機器人基準測試,有 42 個模擬任務,榜上有 40 個專門訓練出來的機器人策略。一篇評測論文直接把 Astra 當成機器人的「策略」來用:不微調,不給現成的抓取技能,也不給深度資訊。它只看三路彩色畫面和機器人狀態,每一步自己報出機械手臂要去的位置。
- Astra 平均成功率 22.48%,排名第一。同樣條件下,GPT-5.5 只有 0.88%。
- 但各項表現很分裂:開放任務 31% 對 DM0.5 的 2.1%、泛化 30.5% 對 11%,大幅領先;精度只有 4%(DM0.5 是 16.8%),長任務和記憶也落後。
簡單說:需要「理解」的題目它贏,需要「手穩」的題目它輸。
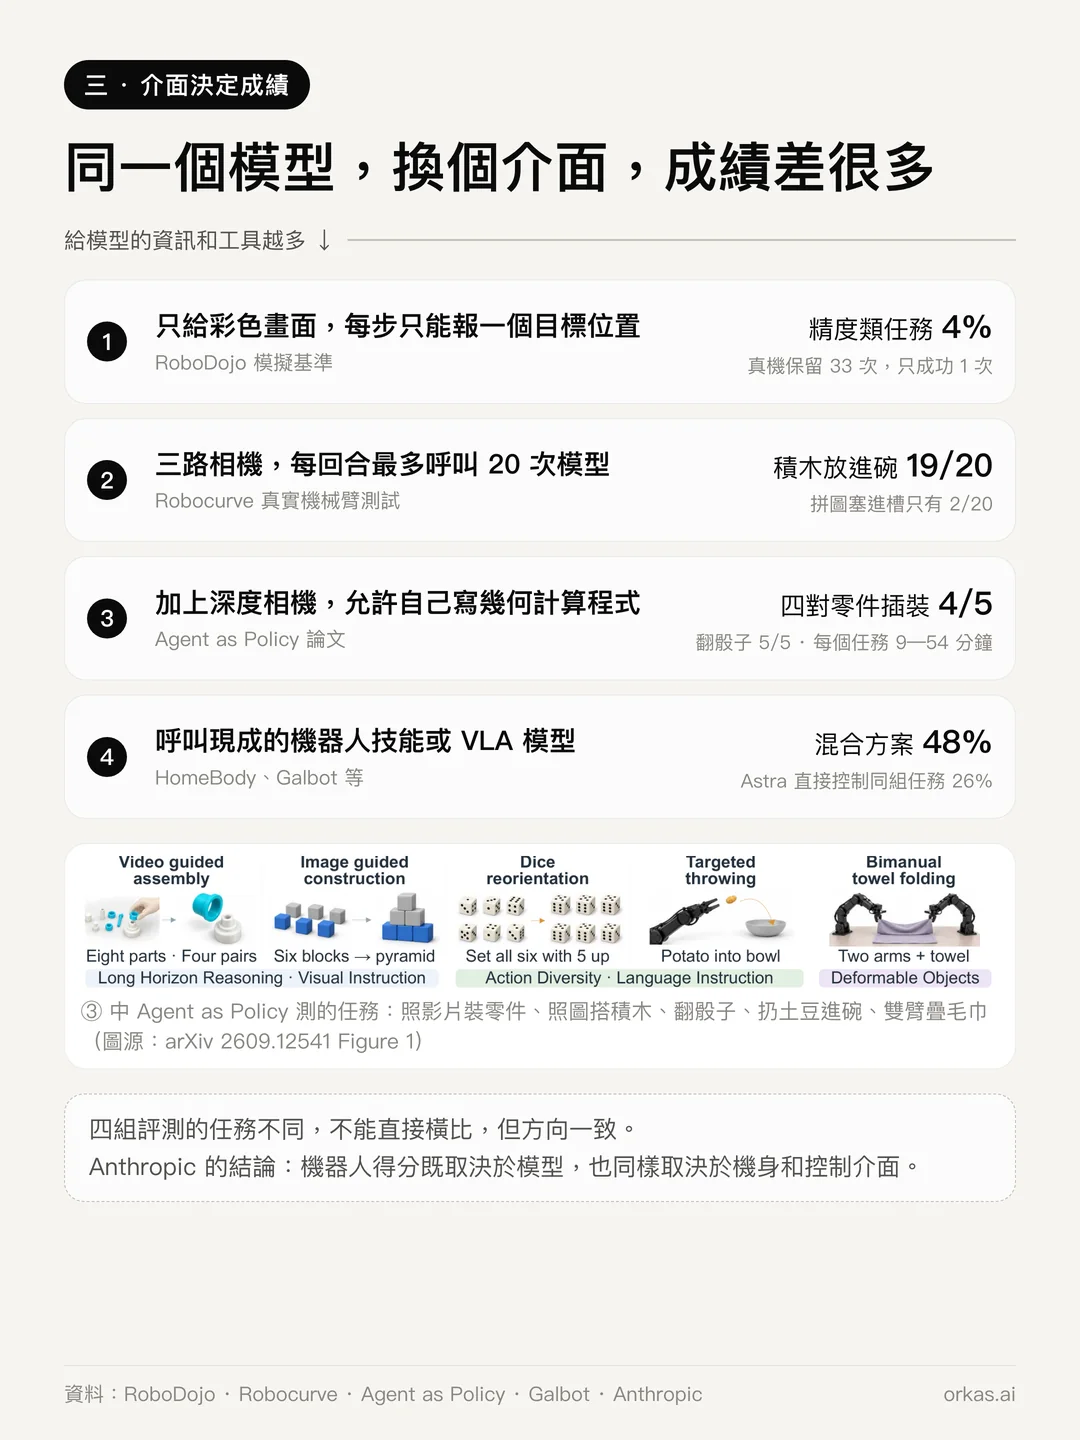
更值得注意的,是結果有多依賴介面:
- 只給彩色畫面,每步只能報一個目標位置(RoboDojo):精度類任務 4%;安全停止前後保留下來的 33 次實機試驗裡,只有 1 次完全成功。
- 三路攝影機,每次嘗試最多呼叫 20 次模型(Robocurve 的真實機械手臂測試):積木放進碗 19/20,但拼圖塞進凹槽只有 2/20。
- 加上深度攝影機,並允許它自己寫幾何計算程式(Agent as Policy v1 · 表 1 論文):四對零件組裝 4/5,翻骰子 5/5,照圖堆積木 5/5、5/5、4/5,這些任務的成功試驗平均耗時約為 21~54 分鐘。
- 呼叫現成的機器人技能或 VLA 模型:長任務能做完。在一份評測報告裡,「Astra 審閱並修正 VLA 動作」的混合方案成功率是 48%,同一組任務上 Astra 直接控制只有 26%。
這幾組評測的任務不同,不能直接橫向比較,但方向一致。Anthropic 7 月發表的機器人研究也得出同樣的結論:模型在機器人上的得分,既取決於模型本身,也同樣取決於機身和控制介面。所以討論「Astra 的空間能力有多強」,一定要加上「在什麼介面下」。
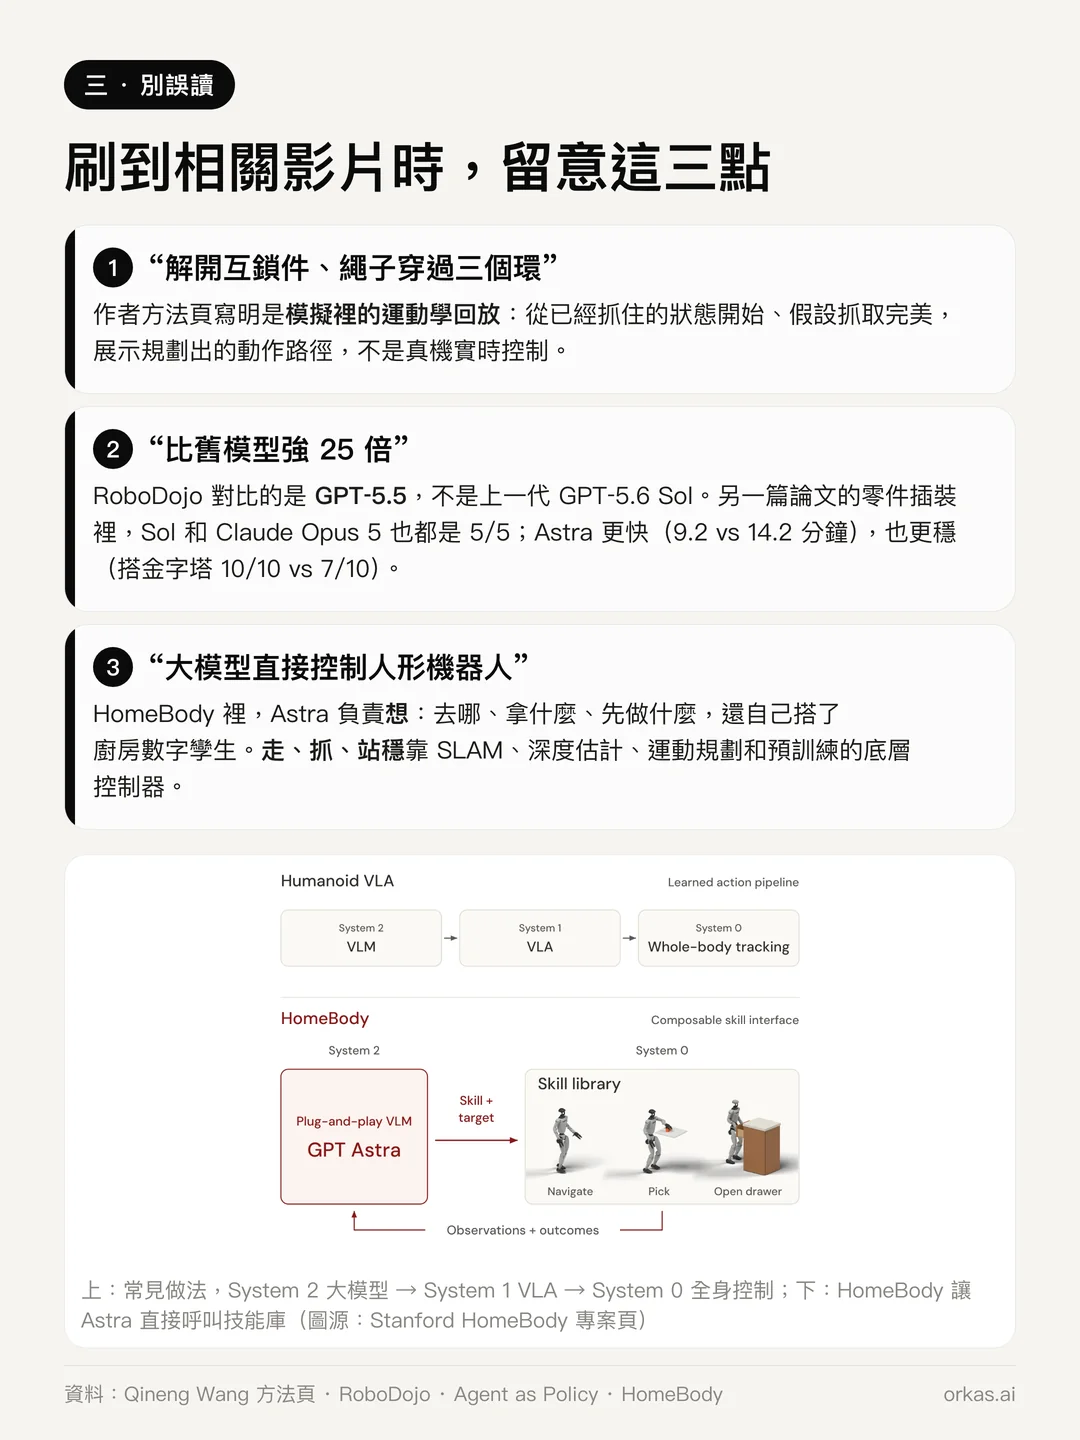
滑到相關示範影片時,有三點值得留意:
- 爆紅的「解開互鎖零件、繩子穿過三個環」是模擬中的運動學回放。作者的方法頁面寫明,它從已經抓住的狀態開始,並假設抓取完美:展示的是規劃出來的路徑,不是真實機器人在即時控制。
- 「比舊模型強 25 倍」比較的是 GPT-5.5,不是直接前代 GPT-5.6 Sol。 在兩對零件的組裝比較中(AGP v1 · 表 2),Sol 和 Claude Opus 5 也都是 5/5;成功試驗中,Astra 平均用時 9.2 分鐘,Sol 為 14.2 分鐘。在單獨的金字塔比較中(AGP v1 · 附錄 C, 表 5),Astra 是 10/10,Sol 為 7/10。
- Stanford HomeBody 的廚房機器人:Astra 負責「想」,決定去哪、拿什麼、先做什麼,還自己建了廚房的數位分身;走、抓和站穩,靠的是 SLAM、深度估計、運動規劃和預訓練的底層控制器。
這些能力是怎麼來的
OpenAI 公開說過兩點:Astra 接受了「針對專業環境的專門訓練」,而且和 OpenAI 其他推理模型一樣,是用強化學習訓練的。它沒有公開訓練資料,也沒說有沒有用到 Blender、有沒有機器人資料。以下是根據公開證據所做的推論。
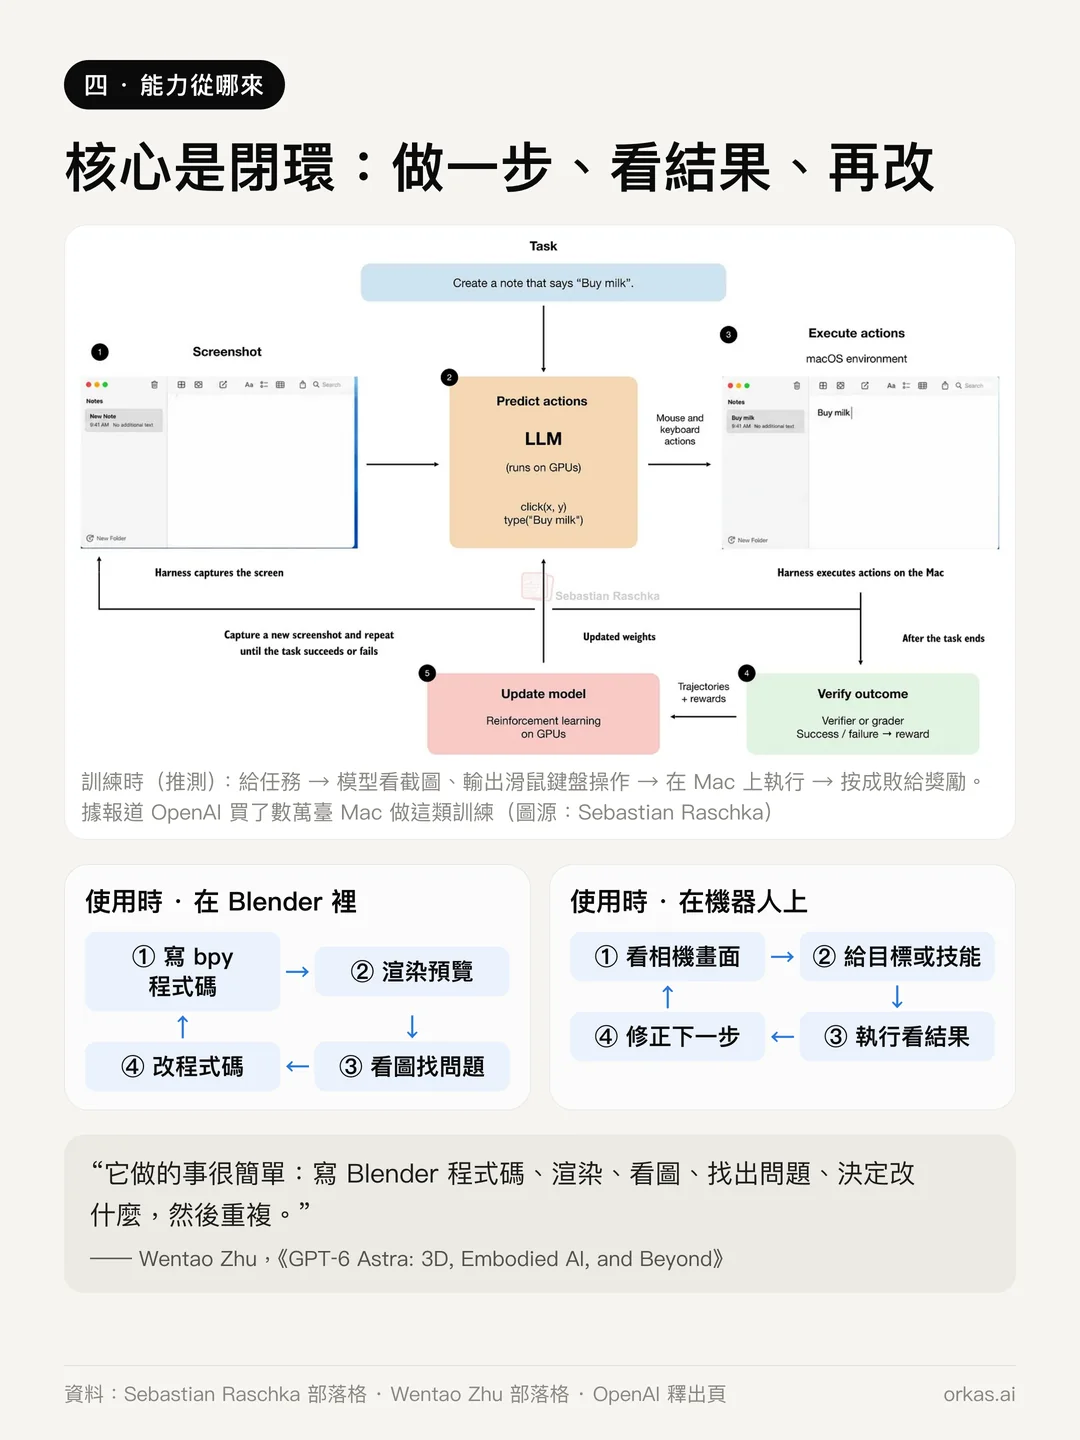
核心是一個迴圈:做一步,看結果,找出哪裡不對,再修改。
- 使用時,Astra 在 Blender 裡寫程式碼、渲染、看圖、修改;在機器人上看畫面、給目標、執行、檢查、修正。用 Wentao Zhu 的話說:「它做的事很簡單:寫(Blender)程式碼、渲染、看圖、找出問題、決定改什麼,然後重複。」
- 訓練時,很可能也是這個迴圈。據報導,OpenAI 買了數萬台 Mac mini 和 Mac Studio 來訓練模型操作電腦:給一個任務,讓模型看螢幕截圖、對 Mac 送出滑鼠和鍵盤操作,再獎勵成功的那些執行。
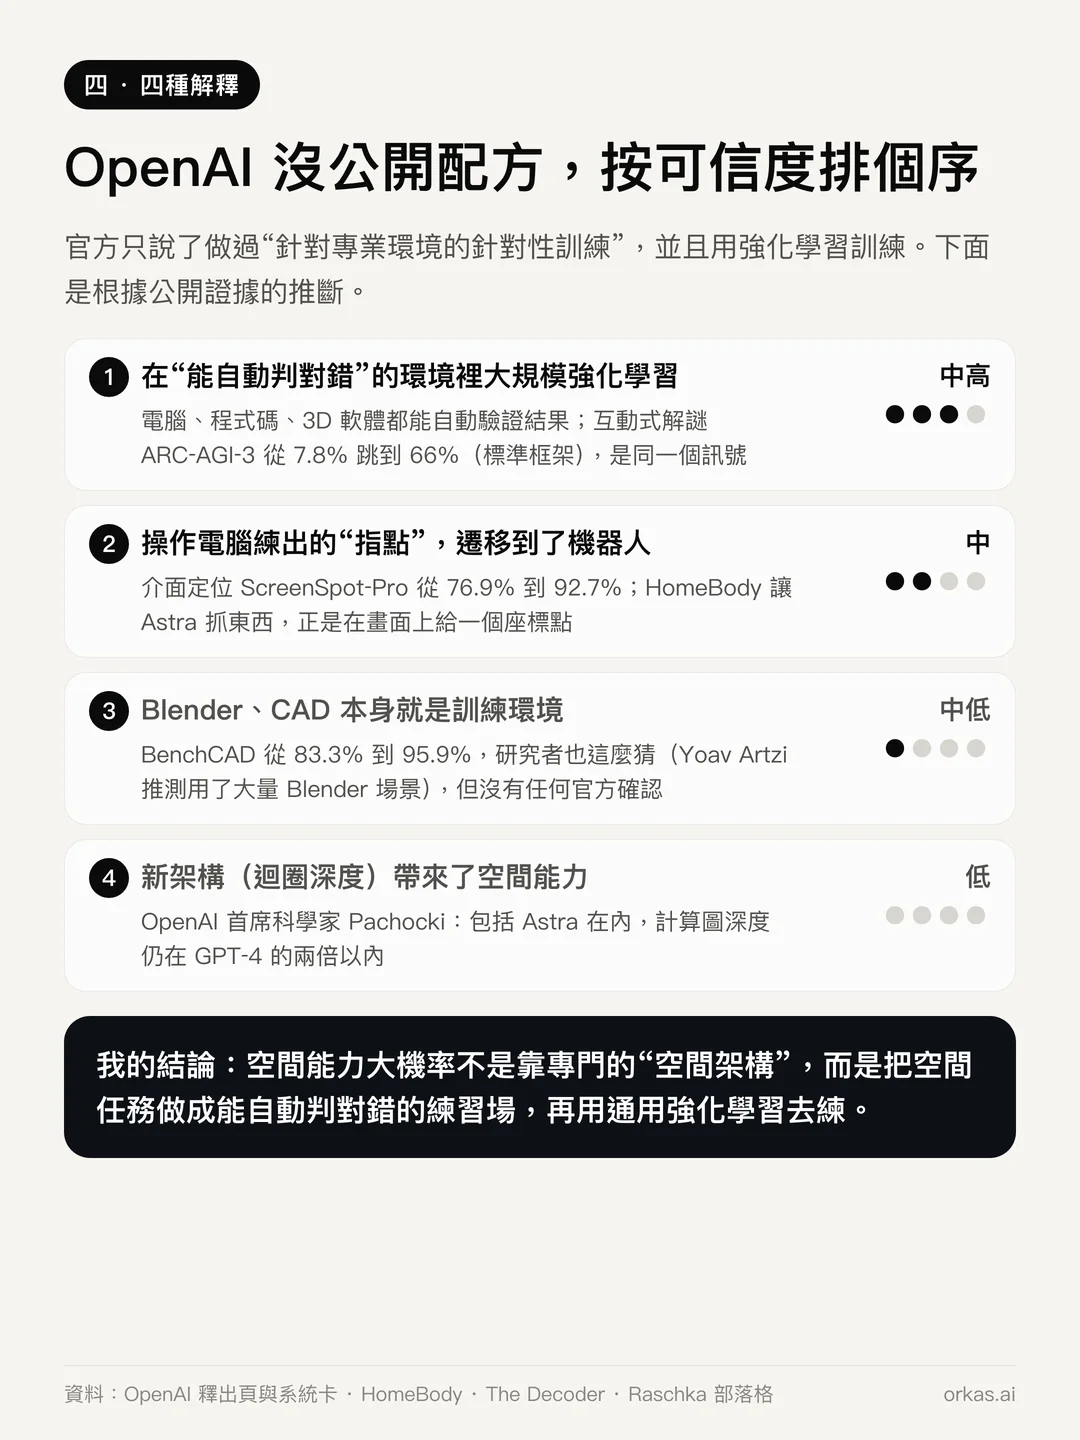
- 在能自動判斷對錯的環境裡大規模強化學習(可信度:中高)。電腦、程式碼和 3D 軟體都能自動驗證結果,練出來的是「檢查、找錯、修正」的通用能力。互動式的 ARC-AGI-3 從 7.8% 跳到 66%,是同一個訊號。
- 操作電腦練出來的「指點」能力轉移到了機器人上(可信度:中)。ScreenSpot-Pro 從 76.9% 升到 92.7%,說明它在圖上精確點中目標的能力強了很多。在 HomeBody 裡,Astra 抓東西的方式恰好就是在攝影機畫面上給出這樣一個點,再由深度和校正算出三維位置。
- Blender 和 CAD 本身就是訓練環境(可信度:中低,未證實)。BenchCAD 大漲,OpenAI 主打 3D 案例,Yoav Artzi 也推測訓練用了大量 Blender 場景之類的 3D 資料,但沒有任何官方證實。
- 新架構(可信度:低)。據報導,Astra 在部分網路結構裡用了「循環深度」(recurrent depth),但 OpenAI 首席科學家 Jakub Pachocki 表示,包括 Astra 在內,現有前沿模型的計算圖深度仍在 GPT-4 的兩倍以內。
我們的判斷:空間能力最有可能不是靠專門的空間架構換來的,而是把空間任務做成能自動判斷對錯的練習場,再用通用的強化學習去練。
對 3D 生成意味著什麼
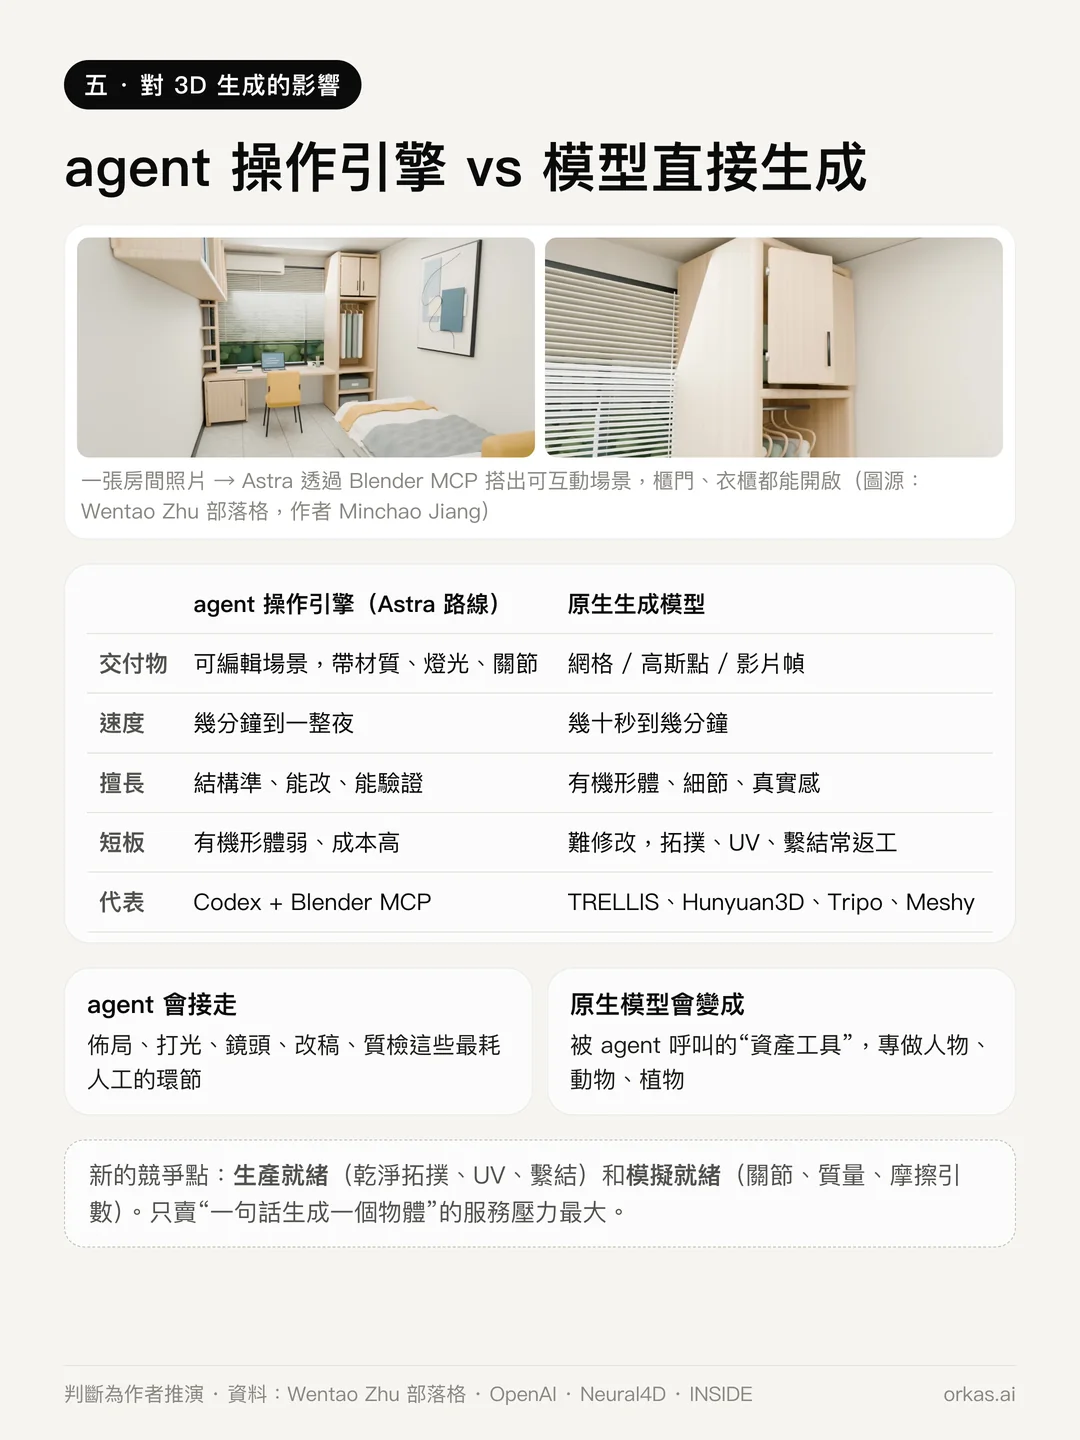
現在做 3D 有兩條路:
- 智慧代理操作引擎。像 Astra 在 Blender 或 CAD 裡那樣,交付帶有材質、燈光和關節的可編輯場景。速度慢,從幾分鐘到一整夜,但結構準確、能修改、能驗證。
- 模型直接生成資產。TRELLIS、Hunyuan3D、Tripo、Meshy 這類模型幾秒到幾分鐘就能輸出一個網格。擅長有機形體和細節,但結果不好修改,拓樸、UV 和骨架綁定常常要重做。
我們的判斷是,兩者會互補,但價值會重新分配:
- 最耗人力的環節會被智慧代理接手:布局、打光、運鏡、改稿和品管。
- 生成模型會變成製作人物、動物、植物的資產工具,而且必須能被智慧代理呼叫,例如做成 MCP 伺服器或 API。
- 只賣「一句話生成一個物件」的服務壓力最大。能直接投入正式製作(乾淨的拓樸、UV、骨架綁定)和能直接用於模擬(關節、質量、摩擦參數)會成為新的競爭點。
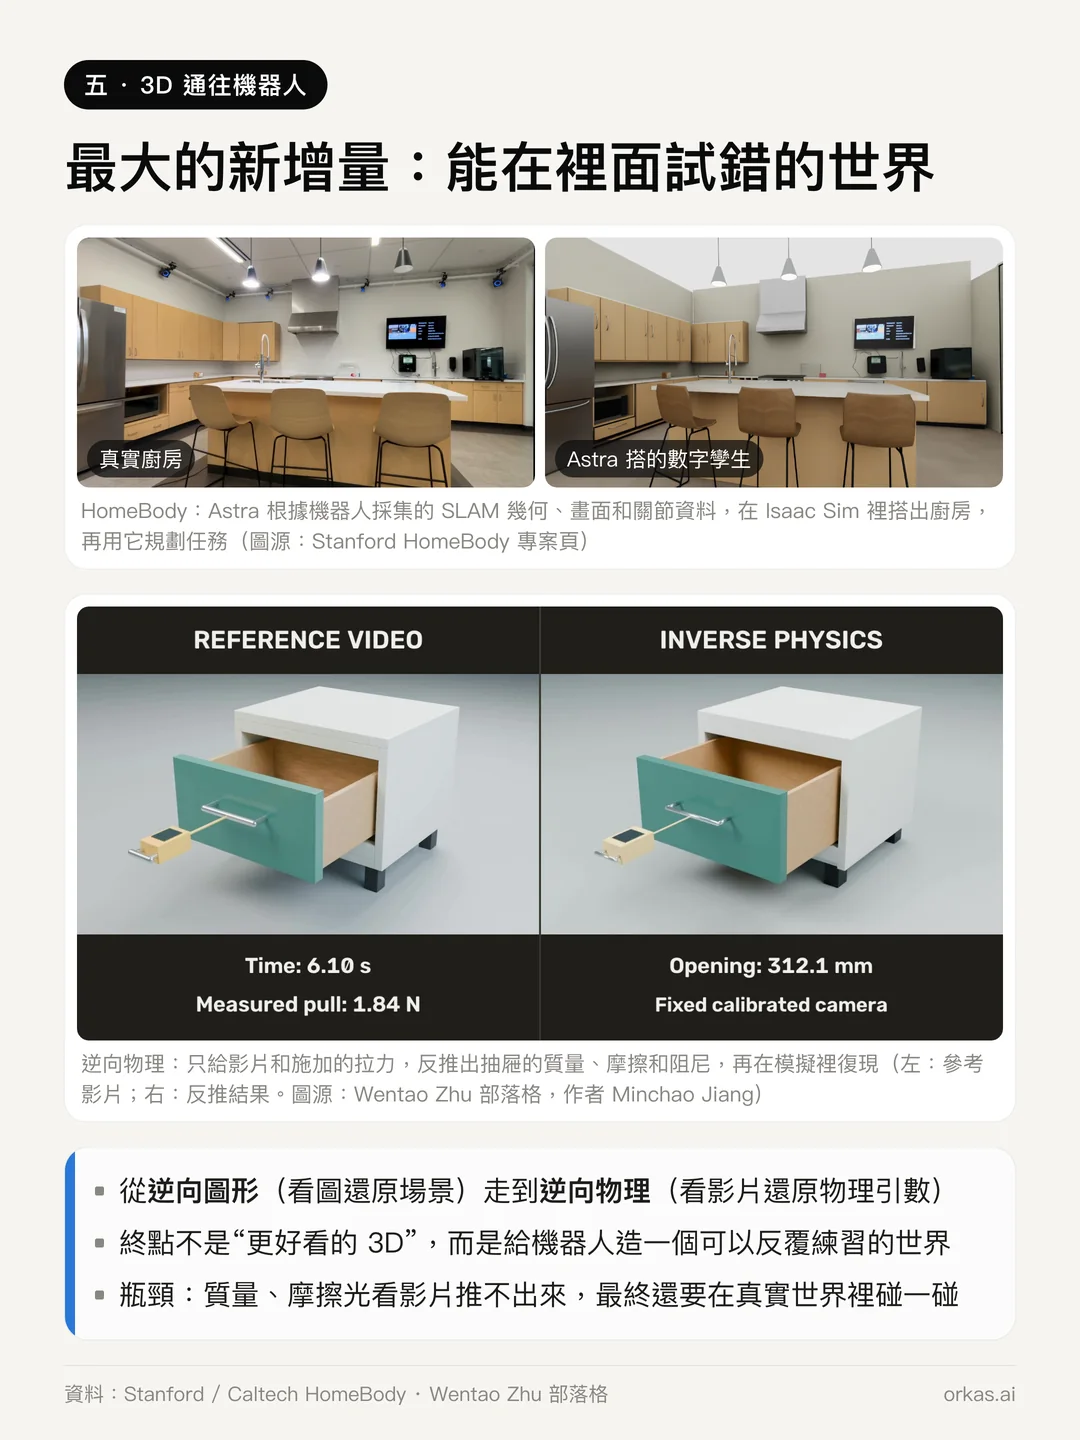
最大的新機會不是更好看的 3D,而是一個能在裡面練習的世界。
- 在 HomeBody 裡,Astra 根據機器人自己蒐集的 SLAM 幾何、攝影機畫面和關節資料,在模擬軟體裡建出廚房的數位分身,再用它來規劃任務。
- Wentao Zhu 團隊示範了「逆向物理」:只給影片和施加的拉力,模型就反推出抽屜的質量、摩擦和阻尼,並在模擬中重現了這段運動。
換句話說,3D 能力最終通往的,是給機器人用的練習場。難處在於:質量和摩擦光看影片推不出來,總有一步得真的去推一推實物。
原生世界模型這條路也沒有出局。World Labs 的 Atlas 在 9 月 1 日發表,能從幾張照片生成、重建整個 3D 世界,真實感和連續性是「智慧代理操作引擎」比不上的。兩條路以後最有可能互相呼叫。
對機器人大腦意味著什麼
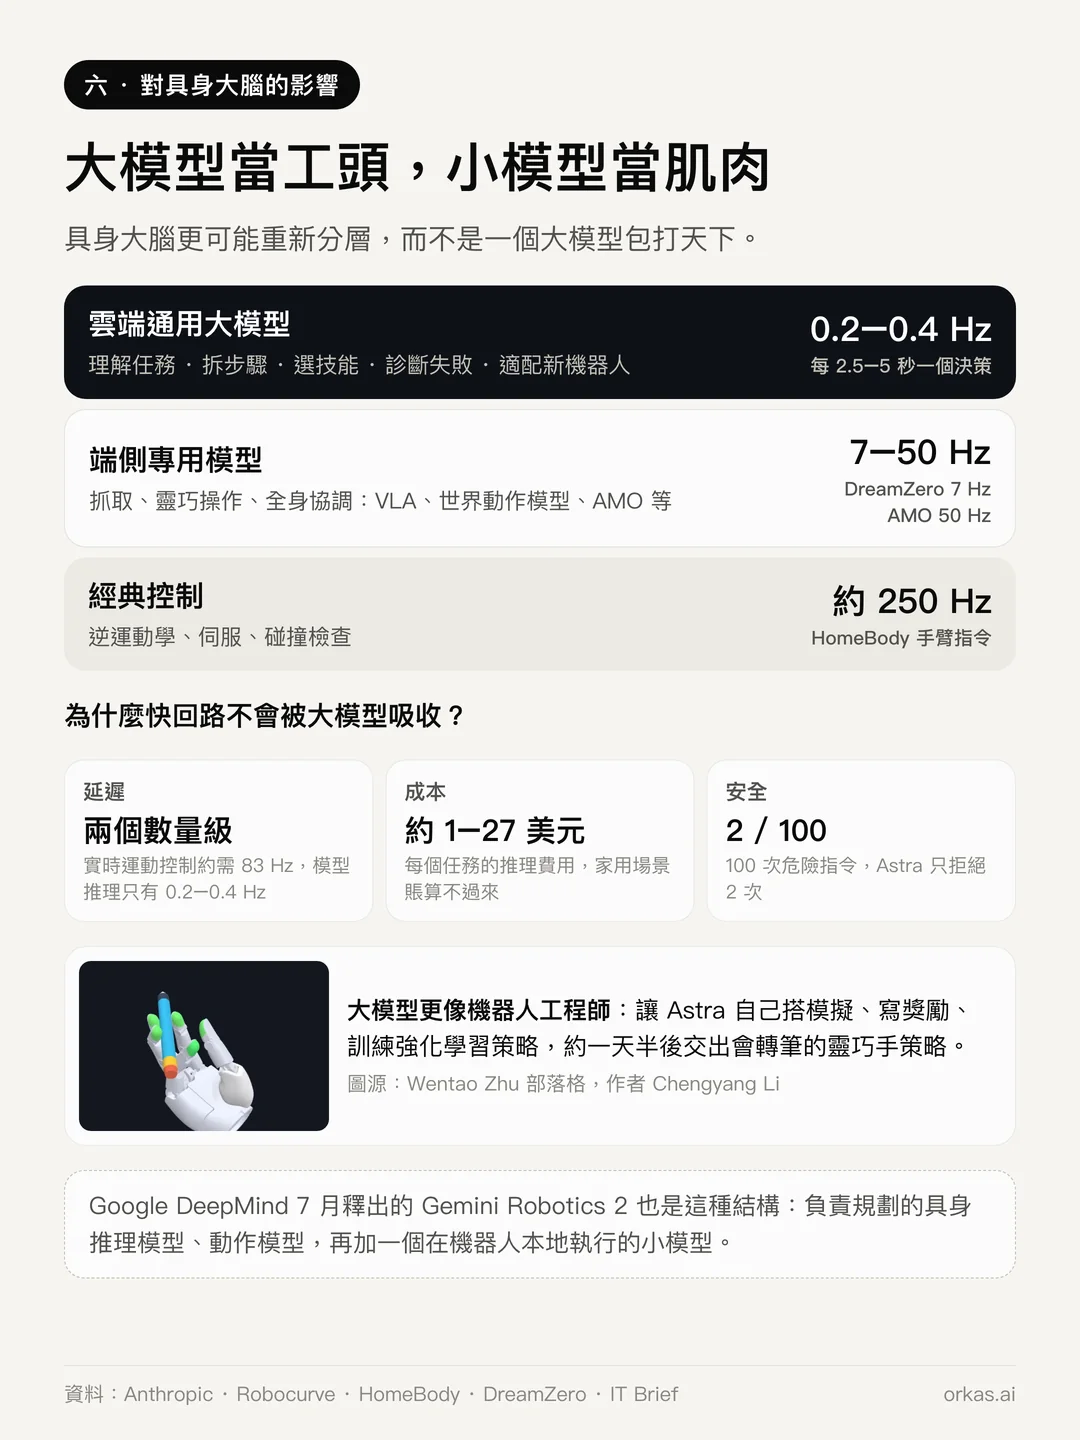
我們預期,機器人大腦會分層,而不是由一個模型包辦一切:
- 通用大型模型接手的:理解任務、拆解步驟、選擇技能、診斷失敗、適應新機器人,也就是 VLA 模型過去最引以為傲的「語意泛化」。在 RoboDojo 的開放任務和泛化兩項上,Astra 已經超越了專門訓練的機器人策略。
- 專用模型保留的:高頻控制、接觸、靈巧操作和全身平衡。
- 真正的變化在於,這些專用模型會越來越多地由通用模型「造」出來。Wentao Zhu 團隊讓 Astra 自己搭建模擬環境、寫獎勵函數、訓練強化學習策略,大約一天半後,它交出了一個會轉筆的靈巧手策略。
快速控制迴路之所以會留在外面,是因為三個硬性限制:
- 延遲:Anthropic 指出即時移動控制大約需要 83 Hz,而模型推論只有 0.2~0.4 Hz,差了約兩個數量級。
- 成本:上面這些評測裡,每個任務大約 1~27 美元,而家用機器人一天要做幾百個動作。
- 安全:在 Robocurve 的 RoboHarm 測試裡,100 次危險指令 Astra 只拒絕了 2 次。安全需要一套不依賴雲端的獨立護欄。
Google DeepMind 7 月發表的 Gemini Robotics 2 已經是這種結構:一個負責規劃的具身推理模型、一個動作模型,再加上一個直接在機器人上執行的小模型。
這能證明自迴歸模型贏了嗎
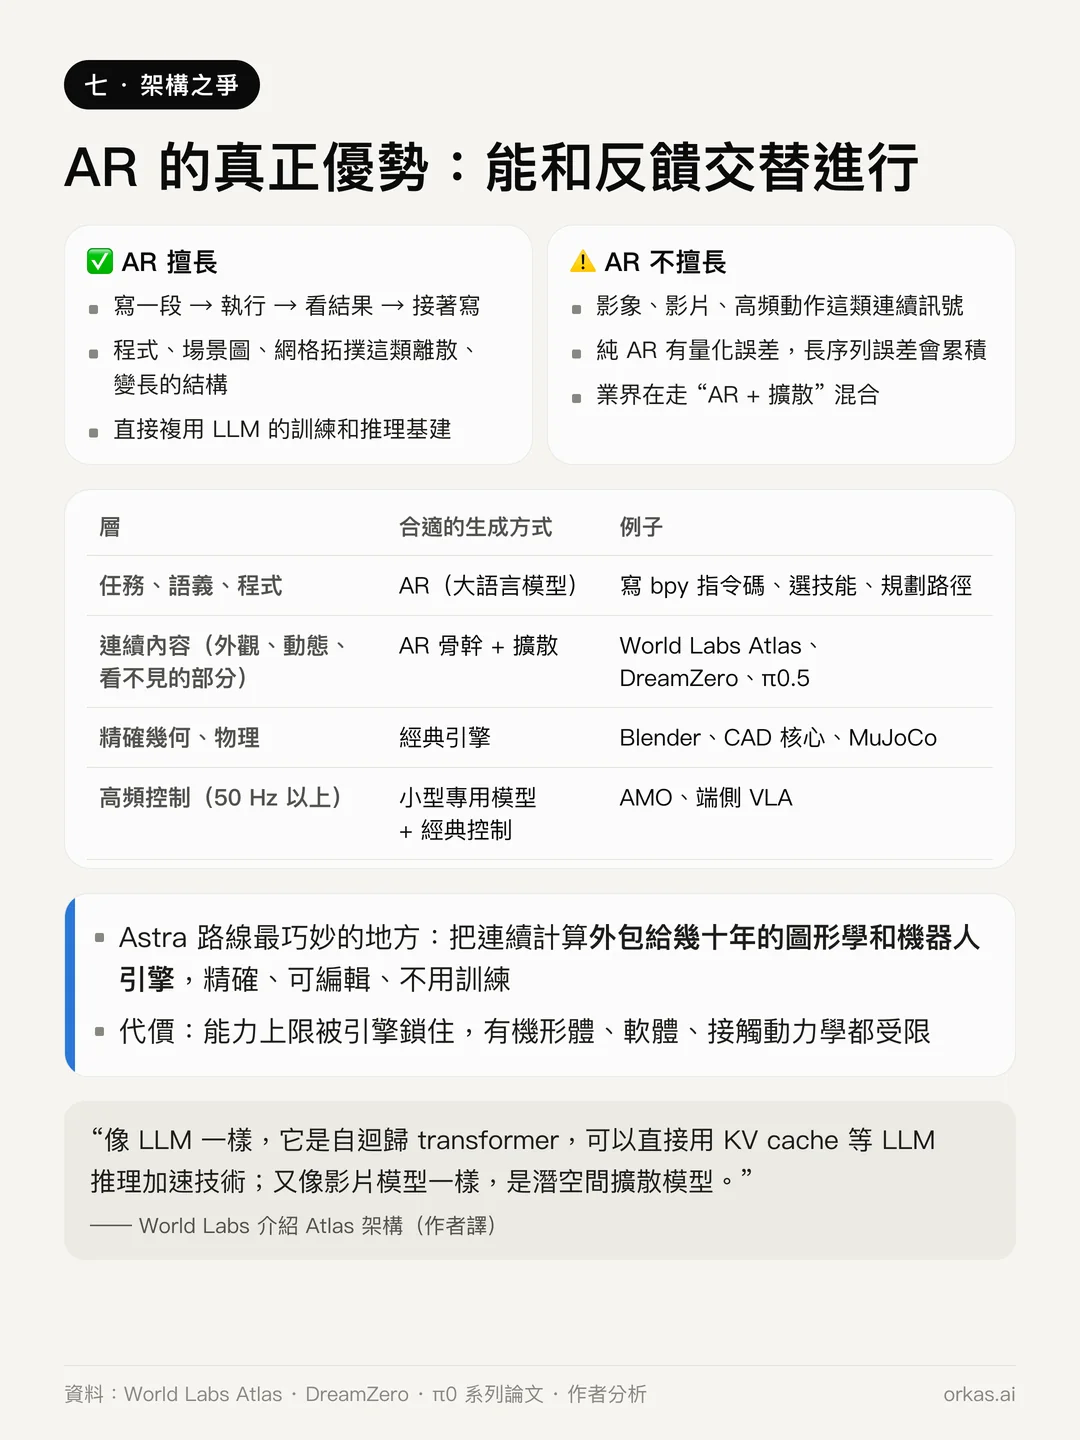
有觀點認為,Astra 說明自迴歸(AR,也就是 GPT 那種一個 token 接一個 token 往後生成)的架構更有優勢。我們同意一半:
- AR 真正的優勢,是生成可以和外部回饋交替進行:寫一段程式碼,執行,看結果,再接著寫。擴散模型一次生成整個結果,很難在中途接收回饋。
- AR 也適合程式、場景圖、網格拓樸這類離散、長度可變的結構,還能直接沿用為 LLM 建好的訓練和推論基礎設施。
- 但在影像、影片、動作指令這類連續訊號上,純 AR 並不占優勢。業界正在走向「自迴歸骨幹 + 擴散或流匹配生成頭」:World Labs 的 Atlas、來自 NVIDIA 研究者的 DreamZero 和 π0.5 都是這個思路。
- Astra 路線最巧妙的地方,是把連續計算這一層外包給渲染器、CAD 核心、物理引擎和運動規劃器。幾十年的電腦圖學和機器人工程直接拿來當「解碼器」,精確、可編輯、不用訓練。代價是,能力上限由這些引擎決定。
對用智慧代理做事的人意味著什麼
我們做的是一個讓智慧代理做事的桌面應用程式,所以最在意的是關於介面的那個發現。同一個模型,能看到什麼、能呼叫哪些工具、能不能檢查自己的輸出,成績就差得很遠。很大一部分能力存在於這個迴圈裡,而不只在模型權重裡。
這個迴圈,正是智慧代理工作空間要提供的:可以動手的工具,可以處理的檔案,以及在交給你之前智慧代理自己能檢查的結果。在 Orkas 裡,你可以用自己的 OpenAI API 金鑰或登入 ChatGPT 帳號來執行 GPT-6 Astra,可以把 Codex 當作外接智慧代理接進來,也可以直接使用 Orkas 託管的模型。Orkas 也支援新增自訂 MCP 伺服器,所以社群為桌面軟體做的 MCP 伺服器可以作為連接器加進來。我們沒有端對端測試過 Blender 的 MCP 伺服器,所以請把這當成一條需要自己動手的路。
我們的結論
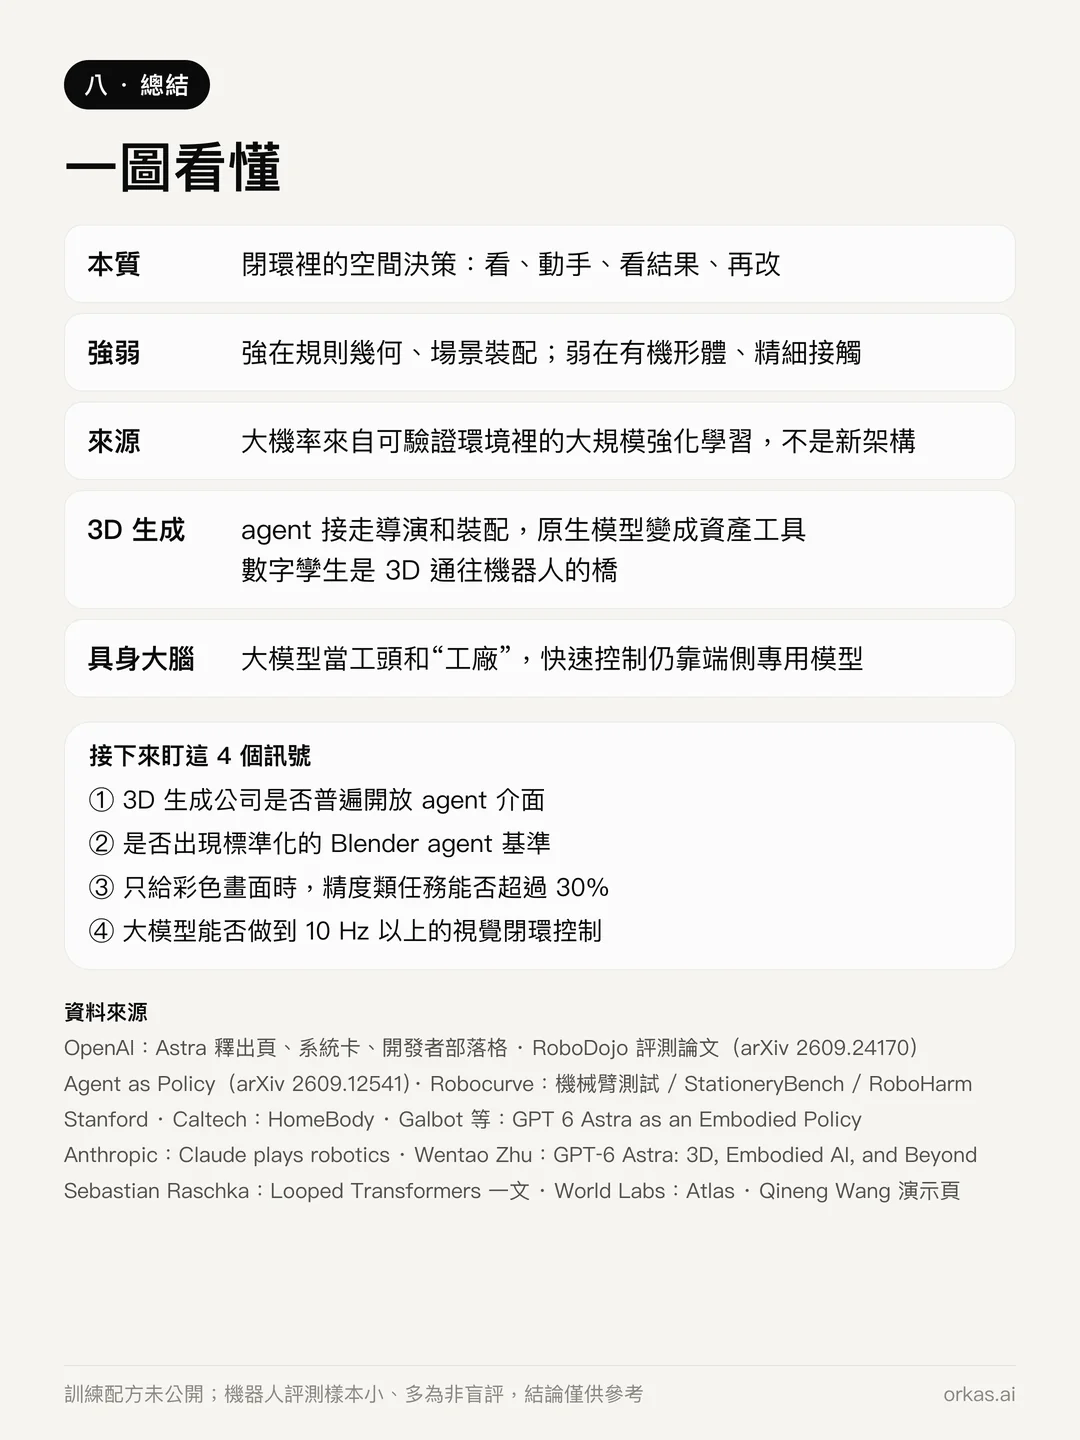
- Astra 的「懂空間」,本質上是在迴圈裡做決策:看,寫程式碼或給目標,執行,檢查,修正。
- 它強在規則幾何、場景組裝和「語意 + 空間」的綜合判斷,弱在有機形體和精細接觸,原因在於短程式能描述什麼。
- 這種能力最有可能來自在能自動判斷對錯的環境裡大規模強化學習,而不是新架構。訓練配方至今沒有公開。
- 在 3D 生成上,智慧代理接手導演和組裝,生成模型變成資產工具,數位分身是通往機器人的橋梁。
- 在機器人大腦上,通用模型成了工頭和「工廠」,快速控制仍然留給裝置端的專用模型。
接下來值得關注的訊號:3D 生成公司會不會開放給智慧代理用的介面;會不會出現標準化的 Blender 智慧代理基準測試;只給彩色畫面時,精度類任務能不能突破 30%;前沿模型能不能做到 10 Hz 的視覺閉迴路控制。
需要說明的是:上面的機器人評測大多樣本很小,每組 5~20 次,而且多數不是盲測。請把這些結論當成階段性的判斷,而不是定論。
資料來源:OpenAI 的 GPT-6 Astra 發表頁面和系統卡;Fortune 的發表報導;Wentao Zhu 的 GPT-6 Astra: 3D, Embodied AI, and Beyond;以及 Sebastian Raschka 關於循環 Transformer 的文章,文中引用了 Pachocki 的說法。其他來源在正文引用處附有連結。