
O número que domina as manchetes sobre o Kimi K3 é 2,8 biliões de parâmetros. E é o número menos interessante do relatório.
O interessante é que a arquitetura foi organizada em torno de uma pergunta que nada tem a ver com o tamanho: onde está a bloquear o fluxo de informação? A resposta tem três partes — ao longo da sequência, ao longo da profundidade, ao longo da largura — e cada uma recebe o seu próprio mecanismo.
O mesmo poder computacional, cerca de 2,5× a eficiência de escala do Kimi K2. Esse número vem das curvas da lei de escala ajustadas pela própria equipa, não de uma reprodução independente — leia-o como uma afirmação deles. Mas os mecanismos por detrás são suficientemente específicos para serem contestados, e é isso que faz valer a pena dedicar tempo ao relatório.
Esta é uma leitura atenta do relatório técnico do Kimi K3 (Moonshot AI), centrada na secção de arquitetura. Já escrevemos sobre conceção de agentes de longo horizonte; este texto fica uma camada abaixo na pilha.
Três direções, não um número
Cada camada de um transformer mistura informação de três maneiras. Entre tokens, para que a posição 900.000 possa afetar a posição 1. Entre profundidades, para que a camada 90 use o que a camada 3 detetou. Entre canais, para que as características se recombinem.
A maior parte do trabalho de aumento de escala faz avançar as três ao mesmo tempo, aumentando tudo. O K3 separa-as e dá a cada uma o seu próprio mecanismo:
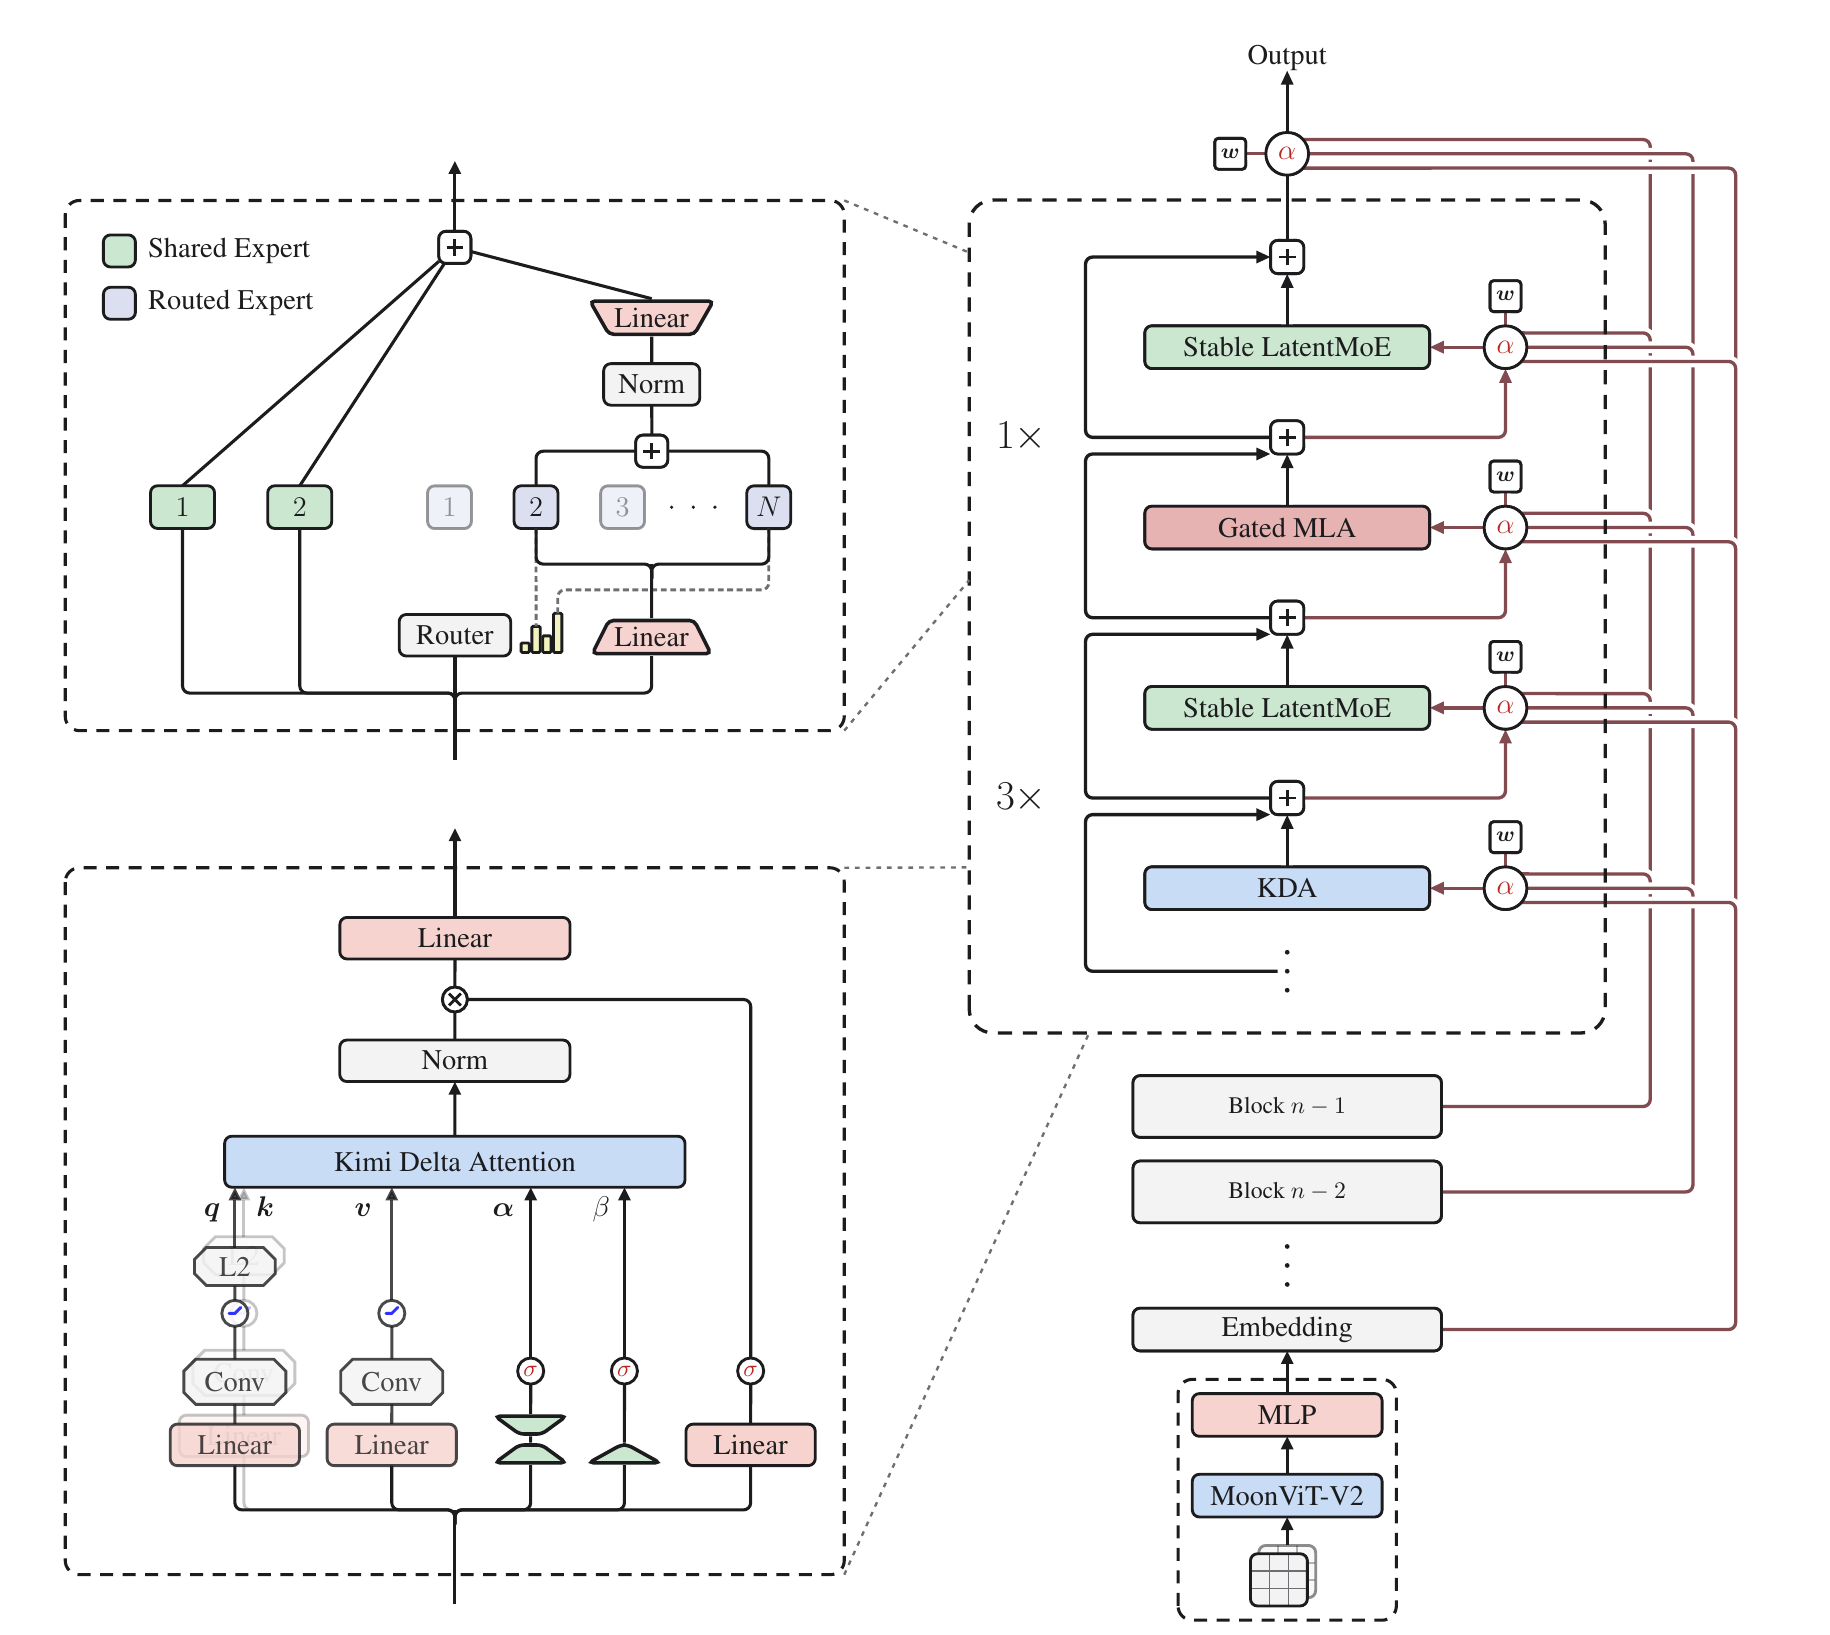
- Sequência — atenção híbrida: três camadas de Kimi Delta Attention para cada camada de Gated MLA.
- Profundidade — Attention Residuals: cada camada presta atenção às saídas de todas as camadas anteriores em vez de herdar um único estado acumulado.
- Largura — Stable LatentMoE: 896 especialistas encaminhados, 16 ativados por token.
A dimensão oculta não mudou nada. 7.168 no K2, 7.168 no K3. O que quer que tenha crescido, não foi a largura de uma camada.
Sequência: três quartos das camadas deixaram de ler tudo
A atenção padrão relê todo o prefixo a cada novo token. Com um milhão de tokens, é esse cálculo que deixa de ser viável.
O K3 divide o trabalho. Três camadas KDA mantêm um estado de tamanho fixo — mais próximo de tomar notas do que de reler a fonte — seguidas de uma camada Gated MLA que aplica atenção global completa. O padrão repete-se, com uma camada MLA extra no final para que a última camada veja sempre tudo. Em 93 camadas: 69 KDA, 24 MLA.
O tamanho fixo é o ponto central. O estado não cresce com a sequência, pelo que não ultrapassa os limites. Também tem perdas, e é por isso que surge uma camada de atenção completa a cada quatro camadas para recuperar o que as notas descartaram.
Depois vem um efeito de segunda ordem. Como o estado recorrente incorpora um decaimento — os tokens recentes ficam naturalmente mais presentes do que os antigos — a informação de posição vem por acréscimo. Por isso, o K3 não aplica nenhuma codificação posicional às suas camadas de atenção global. Sem RoPE, nada para reescalar.
Ou seja: alargar para um milhão de tokens não exigiu qualquer cirurgia à codificação posicional. Nenhum dos truques de interpolação que a área acumulou para a extensão do contexto se aplica aqui, porque não há codificação a interpolar.
Um limite inferior que apagou um caminho de código na GPU
Esta é a nossa parte favorita do relatório, e é suficientemente pequena para passar despercebida.
O estado recorrente esquece à medida que avança. Calcular isso de forma eficiente em blocos exige dividir pelo decaimento acumulado, e o decaimento acumulado é um produto de números menores do que um. Deixe o processo continuar e estará a dividir por algo arbitrariamente próximo de zero.
A geração anterior resolveu isso dividindo cada bloco em sub-blocos de 16 tokens e trabalhando no espaço logarítmico. Funcionava, mas os sub-blocos da diagonal ainda tinham de ser avaliados par de posições a par de posições — um caminho lento, tratado como caso especial, incapaz de usar os núcleos tensoriais.
A correção do K3 é uma linha de parametrização. Limite inferiormente o logaritmo do decaimento: cada passo pode esquecer até 0,67% do que transportava, e nada além disso.
Siga o raciocínio. Com esse limite, o logaritmo do decaimento acumulado num sub-bloco de 16 tokens fica dentro de (−80, 0). O recíproco é, portanto, menor do que e80 ≈ 5,5 × 1034, confortavelmente dentro do intervalo do BF16, de cerca de 3,4 × 1038. Nada transborda. Assim, os sub-blocos diagonais podem usar a mesma multiplicação densa de matrizes que todos os outros.
O caminho especial não foi otimizado. Desapareceu.
Leia a causalidade de trás para a frente e fica ainda melhor: a gama dinâmica do hardware determinou o intervalo aceitável, que determinou a constante, que determinou que a ativação tinha de ser limitada inferiormente. A aritmética escolheu a matemática, e não o contrário.
Profundidade: de corrida de estafetas a grupo de conversa
A noventa e três camadas de profundidade, o fluxo residual padrão é uma corrida de estafetas. A camada 50 recebe um estado acumulado da camada 49. O que as camadas 1 a 48 detetaram individualmente foi somado nesse estado e já não é separável.
O enquadramento do artigo é que esse é o mesmo estrangulamento que uma RNN tem no tempo — e a área já o resolveu, com atenção. Os Attention Residuals aplicam a mesma correção à profundidade: cada camada contém uma pseudoconsulta aprendível e presta atenção às saídas de todas as camadas anteriores, escolhendo o que ler.
Feito à letra, isso tem um custo computacional quadrático na profundidade e, pior, mantém a saída de cada camada ativa na memória e em trânsito com paralelismo em pipeline. Por isso, o K3 usa a variante em blocos: 93 camadas divididas em grupos de doze, somadas dentro do grupo, atenção completa entre grupos. O custo passa de por camada para por grupo, e o estado durante a inferência permanece limitado.
Largura: 896 especialistas, 16 ativados
Uma mistura de especialistas mantém um grande conjunto e ativa alguns por token. O K2 escolhia 8 de 384. O K3 escolhe 16 de 896 — uma esparsidade de 56.
Aumentar o conjunto até esse ponto faz falhar duas coisas, e o relatório é invulgarmente direto sobre ambas.
Comunicação. Num MoE convencional, cada especialista selecionado recebe o token com a largura total, pelo que o tráfego cresce com o número de especialistas selecionados. O LatentMoE desacopla os dois: os especialistas encaminhados trabalham num espaço latente compacto com metade da largura do modelo, enquanto dois especialistas partilhados com a largura total tratam daquilo de que cada token precisa. O conjunto cresce sem que o custo de rede cresça com ele.
Estabilidade. Com essa esparsidade, o ramo encaminhado torna-se uma cadeia de quase quatro multiplicações de matrizes consecutivas, e as ativações explodem. Duas correções: um RMSNorm entre a agregação dos especialistas e a projeção ascendente, e uma nova ativação, SiTU-GLU, que limita ambos os fatores de um SwiGLU com uma tanh escalada para que nenhum dispare em baixa precisão.
Equilíbrio de carga. A terceira correção é a que vale a pena aproveitar. Manter cerca de 900 especialistas com carga uniforme significa ajustar um viés por especialista a cada passo. O método padrão desloca cada viés por um incremento fixo na direção do erro, o que ou oscila ou fica para trás. O K3 resolve diretamente: execute top-(k+1) em vez de top-k, e a entrada extra é a pontuação que um token exige para admissão. Com esses limiares disponíveis, a carga que um especialista recebe sob um viés candidato é monótona, pelo que o viés que atinge a carga pretendida é simplesmente um quantil das margens. Uma passagem para a frente, sem tamanho de passo para calibrar.
À escala real, esse quantil abrange milhões de valores distribuídos por todos os processos, pelo que o estimam através de um histograma: cada processo faz as contagens dos seus intervalos, uma operação all-reduce soma tudo, e o quantil é lido a partir das contagens agregadas. As contagens somam-se, pelo que a estimativa reflete o lote inteiro independentemente de como os tokens foram divididos, ao custo de algumas centenas de intervalos por especialista.
A conta chega à camada de disponibilização de inferência
Nada disto é gratuito, e a parte honesta do relatório é a secção de infraestrutura, onde o custo se faz sentir.
Um estado recorrente de tamanho fixo tem um custo baixo de armazenamento e de transferência, mas é atualizado sequencialmente e não se soma de forma simples. As duas propriedades geram trabalho:
- Dividir uma sequência entre dispositivos. A atenção linear comum permite que cada dispositivo calcule o seu estado local a partir do zero e o some aos restantes. O KDA aplica uma transição dependente do token ao estado de entrada, pelo que a soma dá um resultado errado. A correção decompõe cada segmento numa transição acumulada e num estado iniciado do zero — duas grandezas que de facto se compõem — e recupera o estado de entrada de cada dispositivo com uma soma prefixada e uma operação all-gather de tamanho fixo.
- Reutilizar um prefixo entre pedidos. Metade das caches são páginas por token, metade é um estado fixo por pedido, e uma correspondência exige que ambos possam ser restaurados na mesma fronteira. A resposta deles é desacoplar as granularidades: hash a cada 512 tokens, alocação em blocos de 1024 a 6144, e um ponto de controlo do estado recorrente apenas num subconjunto esparso dos pontos de hash.
- Descodificação especulativa. O estado é atualizado no próprio local, pelo que um rascunho rejeitado não pode ser desfeito. Armazenam em cache as entradas projetadas — muito menores do que o próprio estado — e reconstroem-no no chip.
O padrão nos três casos é o mesmo do limite de decaimento, a funcionar na direção oposta: a arquitetura escolheu uma representação, e a representação ditou o trabalho de sistemas.
Um hábito que o artigo abandona discretamente
O K3 é nativamente multimodal, e o seu codificador de visão é treinado do zero com previsão do token seguinte. Sem inicialização SigLIP, sem pré-treino contrastivo — que é a receita padrão, inclusive no modelo anterior da própria equipa.
A razão declarada não é a qualidade. É a estabilidade: o codificador inicializado de forma contrastiva apresentou normas de gradiente persistentemente mais altas, com picos frequentes, sob otimização conjunta, enquanto o treinado do zero se manteve estável. As avaliações de visão empataram.
O empate torna a descoberta mais incisiva do que uma vitória. Se o treino do zero fosse melhor, chamar-lhe-ia uma receita melhor. Empatou — pelo que a afirmação é que, a esta escala, um passo que a área trata como obrigatório é apenas opcional.
O que isto significa se executar agentes sobre estes modelos
Construímos um cliente multiagente para computador, pelo que o que observamos é se uma execução de longo horizonte continua viável, não quem lidera uma classificação.
O número que importa não é o tamanho da janela de contexto; é quanto custa servir um milhão de tokens. Três quartos das camadas mantêm um estado de tamanho fixo, pelo que a cache que cresce com a conversa é um quarto do que seria num modelo de atenção completa com a mesma profundidade. No BrowseComp, o relatório coloca o K3 em 91,2% a cerca de US$ 2 por tarefa — aproximadamente metade do custo do resultado proprietário mais próximo e uma ordem de grandeza abaixo dos modelos Claude com esforço máximo.
Para um agente que desencadeia centenas de chamadas de ferramentas, essa relação decide se vale a pena tentar a tarefa. O trabalho de arquitetura que antes parecia investigação pura reflete-se agora diretamente na viabilidade económica de uma execução longa.
O que retiramos disto
Duas coisas, ambas transferíveis.
Primeiro, o enquadramento. Onde está a bloquear o fluxo de informação? produz um trabalho diferente de até que tamanho conseguimos crescer? — e decompõe-se, o que explica por que razão três mecanismos puderam ser desenvolvidos e medidos separadamente.
Segundo, o limite de decaimento. Uma restrição que quase não custa expressividade removeu do kernel um caminho inteiro para um caso especial. Não um caminho mais rápido — nenhum caminho. Essa troca é possível muito mais vezes do que é aproveitada, e só é visível para quem tem em conta a matemática e o hardware ao mesmo tempo.
O relatório e os pesos estão abertos no GitHub. A secção de arquitetura tem oito páginas e recompensa uma leitura cuidadosa.