
今月、2 つのリアルタイム動画モデルが 1 週間違いで登場しました。ShengShu の Vidu S2 が 9 月 15 日に公開され、PixVerse は 9 月 22 日に PixVerse R2 を発表しました。S2 はライブのデジタルキャラクターと、再生中の動画ストリームをその場で作り変えることに重点を置いています。R2 はリアルタイムの世界モデルを名乗り、WASD で場面の中を移動しながら、テキスト・参照・音声で次に起きることを変えられます。
両チームとも作り方を公開しています。S2 は arXiv 論文、R2 は PixVerse サイトの技術レポートです。私たちは 2 つを並べて読みました。骨格は同じで、5 つの設計判断で分かれ、公開している情報量は大きく異なります。本記事ではこの 3 点を扱いますが、あえて勝者は決めません。両者が同じテストで比較されたことは一度もないからです。
リアルタイムで何が変わるのか
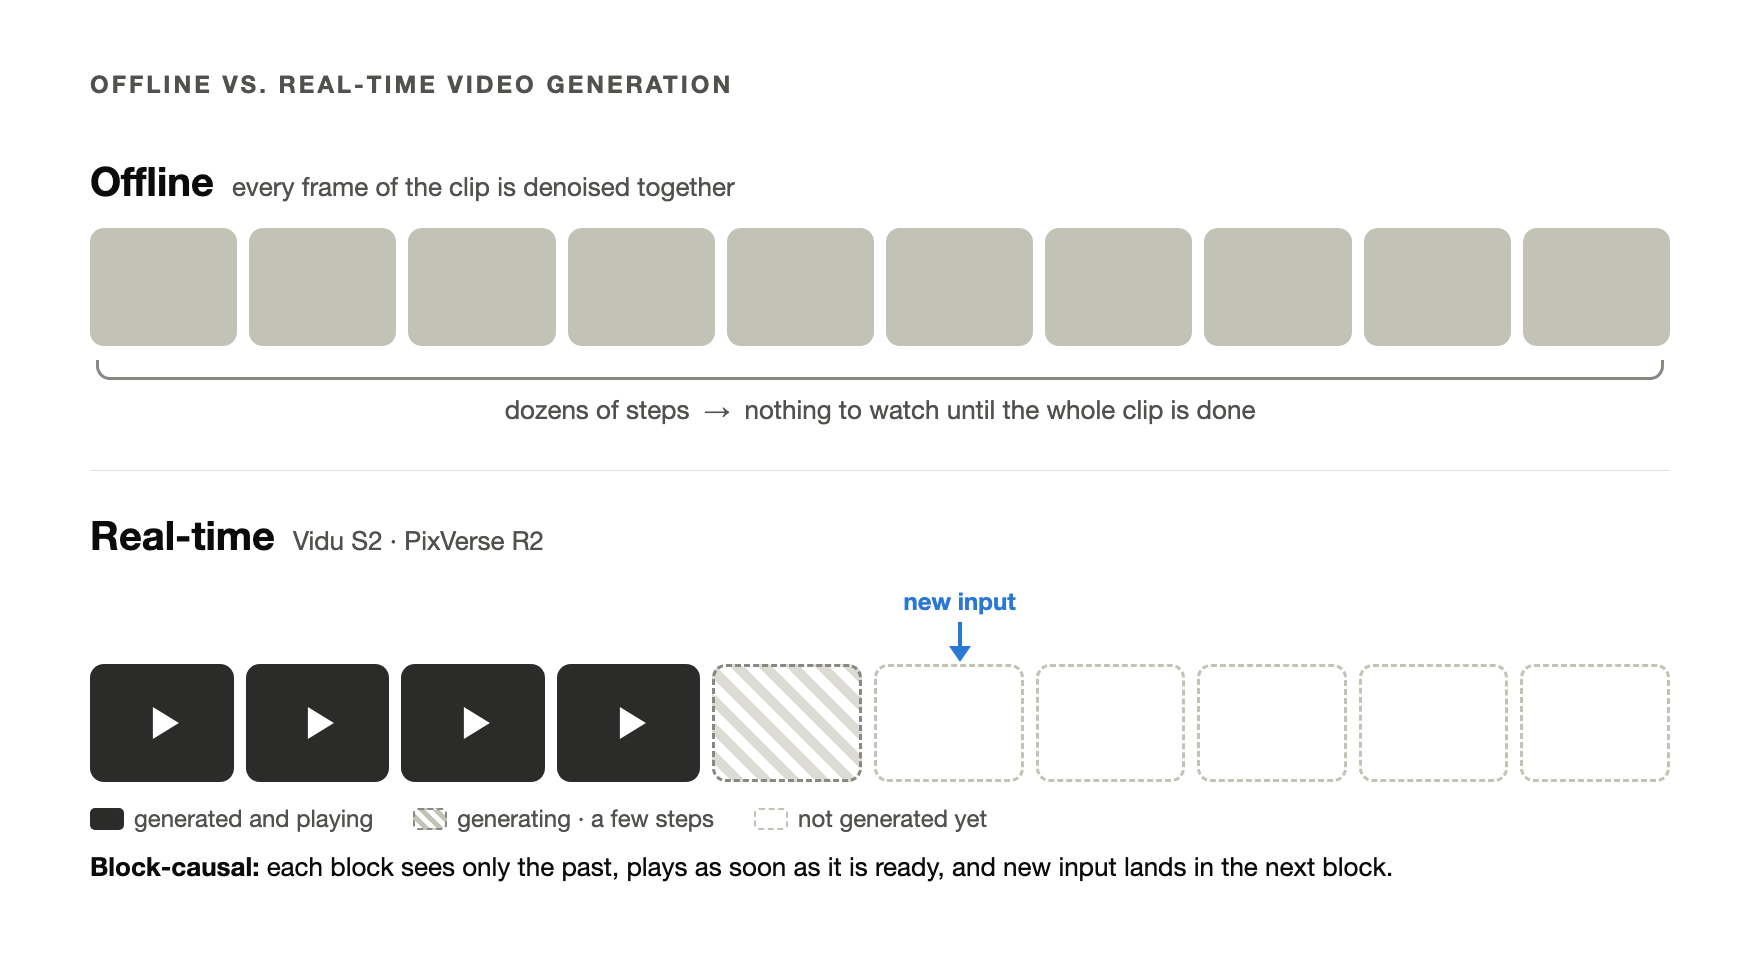
ほとんどの動画モデルはオフラインです。クリップの全フレームを数十ステップかけてまとめてノイズ除去し、全体が終わるまで何も見えません。望む内容は、生成が始まる前にプロンプトへ書いておく必要があります。
リアルタイムモデルはこれを逆にします。動画をブロック(数フレームと、同じ区間の音声)に分け、時間順に生成します。各ブロックのノイズ除去は数ステップだけで、できたそばから再生されます。ブロックは前の内容を参照できても、後の内容は見られません。これがブロック因果の意味です。新しい指示は次のブロックに反映されます。
この構造は 3 つの問題を生み、以下の設計判断のほぼすべてがそのどれかへの答えになっています。
- 誤差が積み重なる。各ブロックはモデル自身が生成したブロックを条件にするため、小さな誤りが後続すべてに引き継がれます。
- 履歴に上限が必要。ストリームはいつまでも続けられます。過去のブロックを全部残せば、新しいブロックほど高くつきます。
- 時間の予算が厳しい。毎秒 25 フレームなら、1 フレームあたり 40 ミリ秒です。
S2 と R2 は同じ骨格に行き着いています。映像と音声を一緒に生成する、ブロック因果の自己回帰型拡散モデルです。違いは、どう学習させ、どう安定させ、どう記憶させ、どう速くし、人がどう操作するかにあります。
2 つのシステム
Vidu S2(ShengShu と清華大学)は 2 つのモデルからなります。S2-Avatar は 720p・25〜42 FPS のライブのデジタルキャラクターで、S1 の 540p から向上しました。配信の途中で新しい参照画像——カップ、ジャケット、ビーチ——を渡すと、キャラクターはそれを手に取り、身に着け、あるいはその場面へ歩いて入ります。ダンスもできます。S2-Editing は入力される動画ストリームをリアルタイムに作り変えます。50 種類以上のスタイル、バーチャル試着、人物と背景の置き換えに対応し、元の動きはそのまま保たれます。論文では VR ヘッドセット向けのステレオ出力も試しています。
PixVerse R2 はインタラクティブな世界を狙った単一のモデルです。動作中に 4 種類の入力——テキスト、マルチモーダルな参照、音声、WASD などのアクション——がいつでも入り、それぞれが現在のフレームだけでなく世界の状態を更新します。PixVerse のゲームエンジンはすでに R2 上で動いており、公開デモは移動とプロンプトが中心です。
判断 1:モデルをどう学習させるか
リアルタイムモデルはゼロからは学習されません。一般的な出発点は強力なオフラインの生成事前分布で、それを因果的かつ少ステップで動くように作り変えます。2 つのレポートの意見が最もはっきり分かれるのがここです。
S2 はリレー方式です。まず双方向の音声・映像モデルを事前学習し、Diffusion-DPO で画質、表情、動き、音声と映像の同期を高めます。次にアテンションをブロック因果に切り替え、きれいな履歴とノイズを加えた履歴を混ぜて学習します(判断 2)。続いて Self-Replay Forcing で自分の出力を使って学習しながら少ステップに蒸留し、最後にストリーミング向けの選好最適化(Streaming NFT)で因果モデルを調整します。アバターと編集は別々のモデルとして学習されます。
R2 は 1 つの基盤を保ちます。Omni Causal AR は、短い動画、長い動画、マルチモーダルデータ、インタラクションの軌跡で継続的に事前学習される因果モデルです。その後 Real-Time Acceleration が同じモデルをそのままライブ用に蒸留します。学生モデルはそこから初期化され、教師モデルもそれを土台に作られます。レポートの言葉では「学び直さず、加速する」です。
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| 出発点 | Diffusion-DPO で調整した双方向モデル | 継続的に事前学習した因果モデル |
| リアルタイムへの道筋 | ブロック因果への適応 → Self-Replay Forcing → ストリーミング選好最適化 | 同じモデルを直接蒸留 |
| モデル | アバターと編集で別モデル | すべての入力に 1 つのモデル |
R2 のレポートは一般的な手法を 5 段階のリレーとして描き、引き継ぎのたびに能力が少しずつ失われると主張しています。率直に読めば、S2 のパイプラインはこの多段階の形をしており、主な改良は最後の段階にあります。どちらのチームも 2 つの道筋を比較した実験は公開しておらず、どちらがよりスケールするかはまだわかりません。
判断 2:ストリームのドリフトを抑える
ドリフトはストリーミング動画の代表的な失敗です。色が少しずつずれ、顔がだんだん別人になり、最後には画面が崩れます。学習ではきれいな履歴を見せるのに、推論では自分の不完全な出力しか見られないことが原因です。
両チームの出発点は同じ対策です。きれいな正解の履歴を条件にして品質を守る Teacher Forcing と、ランダムな強さのノイズを加えた履歴を条件にする Diffusion Forcing を混ぜます。ノイズは細部を消しますが、レイアウトと動きは残すので、モデルは過去のピクセルを一つひとつ信じるのではなく、構造に頼ることを学びます。
とはいえ、ノイズを加えた本物の履歴は、モデル自身の誤りと同じではありません。そこで両チームとも、もう 1 層を加えています。
S2:Self-Replay Forcing。まずモデルが推論時とまったく同じように長い区間を生成します(勾配は保持しません)。その軌跡の一部をブロックごとにノイズを加え直し、勾配ありの因果パス 1 回で再生して、DMD 蒸留損失と知覚損失で学習します。再生されたブロックは 1 つの計算グラフにあるため、勾配がブロックの境界を越えて流れます。つまり、あるブロックが次のブロックにどう影響するかを学べ、しかも元の生成全体をさかのぼって逆伝播する必要はありません。
R2:Error Bank。生成中に現れた代表的な失敗状態を保存し、学習時に通常の履歴と一緒に再生します。こうして、ずれがすでに世界に入り込んだ後から立て直すことを学びます。PixVerse の社内段階評価では、長期の輝度ドリフト指標が 0.201 から 0.129 へ 35.8% 下がり、29 本の長いシーケンスのうち 20 本で改善、動きのない 5 サンプルすべてで余計な動きが減りました。
2 つは競合ではなく補完関係です。Self-Replay Forcing はいまのモデルが間違えるところを学習し、Error Bank は覚えておく価値のある失敗を繰り返し練習します。
判断 3:上限のある記憶
どちらも最初の数ブロックをアンカー(シンク)として常に残し、直近のブロックをスライディングウィンドウで保持して、残りは捨てます。これで新しいブロックのコストがストリームの長さに応じて増えません。さらにどちらも、位置の座標を学習時に見た範囲に収めています。S1 では RoPE の再配置、R2 では相対時間 RoPE と呼ばれ、長いセッションでも位置が分布の外へ出ません。
S2 は S1 の TwinCache をもとにしています。TwinCache では過去の各ブロックを、ノイズありとノイズなしの 2 通りでキャッシュします。ノイズ除去の途中のステップはノイズありのほうを読み、大まかな動きだけを伝えて、アーティファクトの蓄積を防ぐローパスフィルタのように働きます。最後のステップはノイズなしのほうを読んで細部を戻します。S2 はこれを 2 つの段階に分け、バックボーンは高ノイズのキャッシュを、Refiner は低ノイズの高解像度キャッシュを読みます。
R2 は記憶を時間のスケールで分けています。Sink Memory はアイデンティティ、環境、スタイル、世界のルールを、Rolling History は直近の動き、ポーズ、カメラを保持し、Object KV Cache は後でも重要になる物体レベルの状態を圧縮して残します。
この分け方はそれぞれの製品を映しています。デジタルキャラクターは同じ人物であり続ける必要があります。世界はさらに、そこで起きたこと——置いた物、下した選択——も覚えていなければなりません。
判断 4:速さはどこから来るのか
どちらもスパースアテンションと少ステップ蒸留を使いますが、力を入れる場所が違います。
S2 はシステムエンジニアリングに頼り、その内容を詳しく書いています。アテンションは層ごとに SageAttention、SpargeAttention、スパース線形アテンションから選び、最も影響を受けにくい層に最も積極的な近似を割り当てます。線形層はブロック単位の W8A8 行列積で動きます。隣り合う演算子は Triton/CUDA カーネルに融合し、CUDA Graphs で再生します。複数 GPU では Ulysses 方式のコンテキスト並列を使い、GPU 間の通信も量子化します。編集パイプラインでは VAE エンコーダー、バックボーン、Refiner、デコーダーが共通のタイムラインで GPU を共有します。解像度は、低解像度のバックボーンと 1 ステップの潜在空間 Refiner で 720p まで上げます。
R2 はモデル側に頼ります。ブロックスパースアテンションは学習の中で身につけられ、スパース率は 90% を超えます。蒸留は Decoupled DMD に従い、制御信号に従うことと教師の分布に合わせることを別々の目的として最適化し、さらに DMD2 由来の敵対的な項でリアルさを保ちます。解像度はピラミッド構造で、1〜2 つの低解像度段階でレイアウト、動き、カメラを決め、最後の高解像度段階でテクスチャを加えます。レポートには R2 の出力解像度とフレームレートは書かれていません。
判断 5:人がどう操作するか
S2 はモデルを VLM エージェントで包んでいます。エージェントは各参照画像を、手に持つ物・背景・服装のいずれかに分類し、セグメントごとにアイデンティティ、表情、視線、ポーズ、動作、手に持つ物を記述したプロンプトを書きます。ユーザーが変更を求めていない部分はそのまま残します。生成後はフレームを順に確認し、動作が完了したか、途中までか、失敗したかを判断して、次のプロンプトを書きます。アクセサリーの着脱では動作と終了後の状態の両方をプロンプトに書くので、かぶり直した帽子はそのままかぶったままです。編集モードでは、フレーム整列アテンションにより各出力フレームが同じ時刻の元フレームだけを参照するため、動きとタイミングが入力と正確に一致します。
R2 は 1 つの入力インターフェースをモデルに組み込んでいます。テキスト、参照、音声、アクション、そしてエージェントが生成する制御が、すべて同じ動作中の世界に入ります。ブロックの長さは、上限の範囲内で、いま有効な制御に合わせて変わります。キー入力には短いブロックで素早く応答し、ひとまとまりの出来事や音声の区間には長いブロックで一貫性を保ちます。モデルの上では、PixVerse のゲームエンジンがエージェント層を加え、ゲームのルールの状態と生成された場面を同期させています。
それぞれのレポートが公開していること
数字を比べる前に、何が公開されているかを比べます。
| Vidu S2 | PixVerse R2 | |
|---|---|---|
| 形式 | arXiv 論文 | PixVerse サイトの技術記事 |
| 解像度とフレームレート | 720p、25〜42 FPS | 記載なし |
| パラメータ数とエンドツーエンドの遅延 | 記載なし | 記載なし |
| 公開ベンチマーク | アバター 1 件、編集 4 件 | なし(社内評価のみ) |
| 重み | 非公開(API あり) | 非公開 |
StreamAV-Bench では、S2 は自らの評価(14 システム)で、報告された 9 指標すべてで 1 位です。音声と映像の整合は 0.353(他の最高値は 0.272)、同期誤差は 0.617(他の最高値は 0.648)。差が小数第 3 位にとどまる指標もあり、被写体の一貫性は 0.998 対 0.997 です。R2 が公開している数字は、ドリフトの 35.8% 削減と、90% を超えるアテンションのスパース率です。レポートはこのスパース率でも社内の 4 つの品質指標が保たれたとしていますが、スコアは示していません。
直接の比較はありません。S2 の論文が比較しているのは前世代の PixVerse R1 で、R2 はその後に公開されました。
エージェントで動画を作る人にとっての意味
私たちはエージェントが作業をこなすデスクトップアプリを作っており、動画はユーザーが任せる仕事の 1 つです。今回のレポートから持ち帰れることが 2 つあります。
1 つ目は、ライブと完成品の境目がはっきりしてきたことです。リアルタイムモデルは反応し続ける体験——キャラクター、ゲーム、再生しながら作り変えるストリーム——のために作られています。一方、クリエイターの仕事の多くは今もファイルとして仕上がります。Orkas では、VideoStudio が素材と要望から確認できる編集結果を作ります。ショットを生成する必要があるときはオフラインのモデルを使い、Orkas が提供する動画生成か、ご自身のキーで Seedance 2.0、Hailuo 2.3、Vidu Q3 Pro、Kling 3.0 Turbo、Veo 3.1、Runway Gen-4.5 を使えます。S2 と R2 はいずれも、現時点では Orkas の中では動いていません。
2 つ目は、S2 の制御層がエージェントのループそのものだということです。プロンプトを書き、生成し、フレームを見て、次に何をするか決める。リアルタイムかどうかにかかわらず、生成モデルと一緒に働くエージェントはみな同じ形をしています。そして結果の多くは、重みだけでなくこのループで決まります。
私たちが受け取ったこと
骨格は固まりました。ブロック因果の自己回帰型拡散、映像と音声の同時生成、きれいな履歴とノイズのある履歴の併用、シンクとウィンドウ、DMD 系の蒸留、スパースアテンション、まず低解像度から。S2 と R2 を分けるのは力の使いどころです。的を絞った修正のリレーか、一度だけ蒸留する 1 つの基盤か。オンポリシーの再生か、失敗のバンクか。システムエンジニアリングか、学習されたスパース性か。
どちらも全文を読む価値があります。学習と推論基盤の詳細なら Vidu S2 の論文、学び直さずにリアルタイムモデルをスケールさせるという主張なら PixVerse R2 のレポートです。