
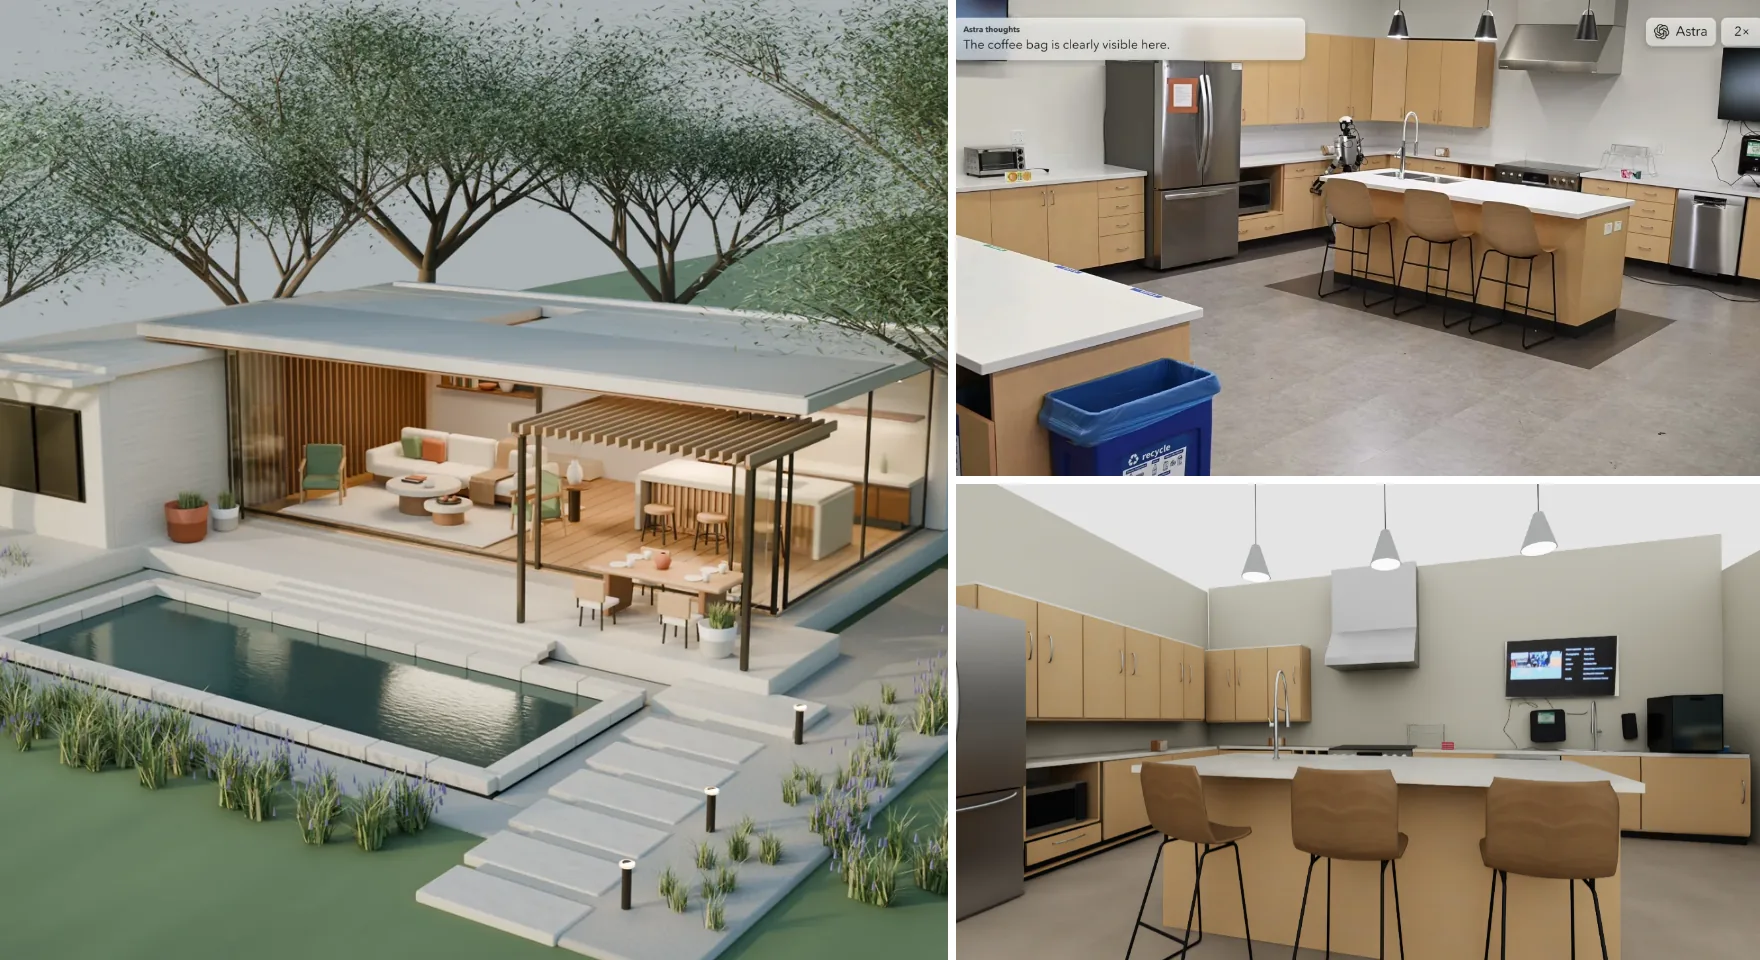
في أوائل سبتمبر أطلقت OpenAI نموذج GPT-6 Astra، فانتشر نوعان من المقاطع بسرعة. في الأول يبني النموذج في Blender منزلًا مؤثثًا بالكامل من الصفر، ثم يصدّره إلى Unreal Engine 5، حيث يمكنك أن تدخل المنزل وتفتح الأبواب وتشغّل الأضواء وآلة الإسبريسو. وفي الثاني يوجّه أذرعًا روبوتية وروبوتات بشرية الشكل.
كيف صار نموذج لغوي فجأة بارعًا في فهم المكان؟ هل استهدفت OpenAI هذه القدرة تحديدًا؟ وماذا يعني هذا المسار لتوليد المحتوى ثلاثي الأبعاد ولـ«أدمغة» الروبوتات؟ قرأنا إعلان OpenAI وبطاقة النظام ومدونة المطورين، وتقييمات الروبوتات التي نُشرت منذ ذلك الحين، وتحليلات الباحثين. الخلاصة باختصار:
- المكاسب حقيقية لكنها غير متوازنة: قفزت المهام ثلاثية الأبعاد ومهام تحديد العناصر بصريًا والمهام التفاعلية، بينما بالكاد تحرّك الذكاء العام.
- نتائج الروبوتات تعتمد كثيرًا على الواجهة. النموذج نفسه، إذا استُخدم بطريقة مختلفة، يحقق نتائج مختلفة جدًا.
- الأرجح أن هذه المهارة تأتي من التدرّب في بيئات تقيّم النتائج تلقائيًا، لا من معمارية جديدة.
- في توليد المحتوى ثلاثي الأبعاد وأدمغة الروبوتات، توقّع تقسيمًا جديدًا للعمل بدلًا من أن يحلّ نموذج محل آخر.
الأرقام الرسمية: مكاسب كبيرة موزّعة بشكل غير متساوٍ
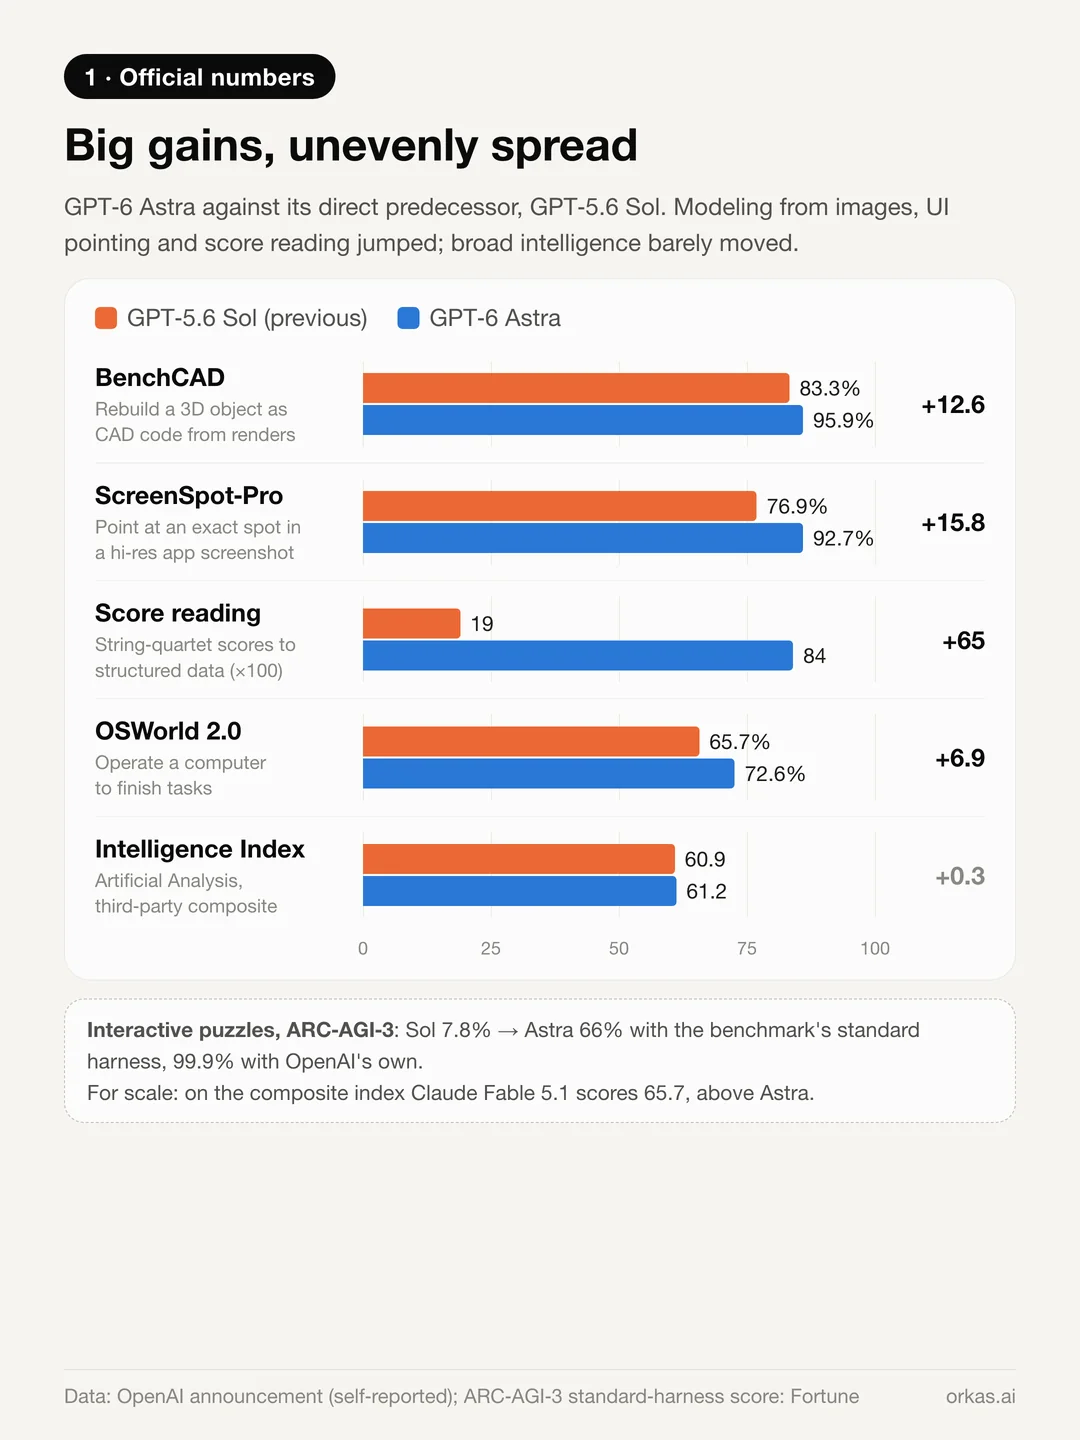
مقارنةً بسلفه المباشر GPT-5.6 Sol، تبدو الأرقام التي نشرتها OpenAI على هذا النحو:
- BenchCAD: من 83.3% إلى 95.9%. يرى النموذج صورًا مُصيَّرة لجسم من عدة زوايا، ويكتب شيفرة CAD تعيد بناءه، أي إنه ينمذج انطلاقًا من الصور.
- ScreenSpot-Pro (من دون أدوات): من 76.9% إلى 92.7%. على النموذج أن يشير بدقة إلى زر أو عنصر بعينه في لقطة شاشة عالية الوضوح لبرنامج احترافي.
- قراءة النوتة الموسيقية: من 0.19 إلى 0.84 على رباعيات وترية من OpenScore، أي تحويل النوتات المطبوعة الكثيفة إلى بيانات موسيقية منظّمة.
- ARC-AGI-3، وهو اختبار معياري للألغاز التفاعلية: من 7.8% إلى 66% بإطار الاختبار القياسي الخاص به، أو 99.9% بإطار OpenAI الخاص.
في المقابل، انتقل مؤشر Artificial Analysis للذكاء، وهو مؤشر مستقل، من 60.9 إلى 61.2، أي أقل من Claude Fable 5.1 الذي سجّل 65.7.
إذن لم يصبح Astra أذكى في كل شيء، بل صار أفضل بكثير في المهام التي تجمع بين النظر والفعل والتعديل. ووصف Yoav Artzi، الباحث في Cornell وGoogle DeepMind، هذا التقدم بأنه «نقلة نوعية» في الاستدلال المكاني.
ما الذي فعله حقًا في Blender
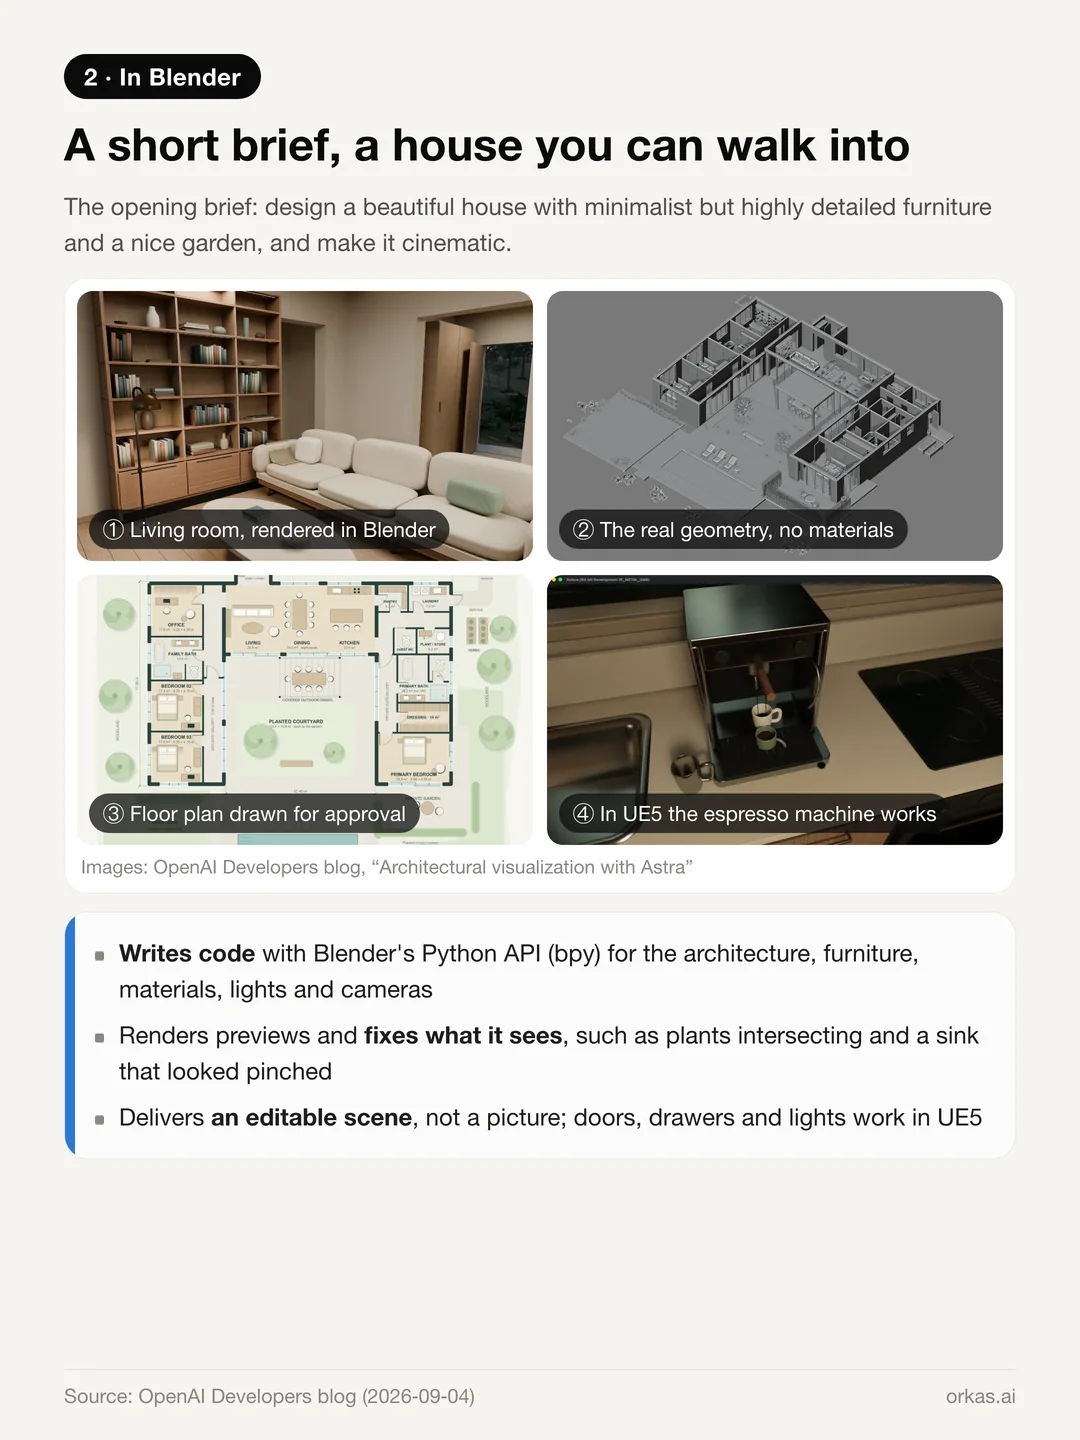
تستعرض مدونة المطورين لدى OpenAI مشروعًا كاملًا خطوةً بخطوة. كان الطلب الأول قصيرًا: صمّم منزلًا جميلًا بأثاث بسيط لكنه غني بالتفاصيل، مع حديقة جميلة، واجعل المشهد سينمائيًا.
- كتب Astra شيفرة Python لـBlender (bpy) ليبني بها العمارة وأعمال النجارة والأثاث والنباتات والخامات والإضاءة والكاميرات.
- صيّر معاينات، وبحث فيها عن المشكلات، وأصلح شيفرته بنفسه: نباتات يخترق بعضها بعضًا، وحوض فولاذي جعلت متجهاتُ السطح العمودية تجويفَه يبدو كأنه مقروص.
- رسم أولًا مخططًا أرضيًا للموافقة عليه، ثم أعاد بناء المنزل بيتًا من طابق واحد على شكل حرف U، فيه ثلاث غرف نوم ومكتب.
- صدّر المشهد إلى Unreal Engine 5 بوصفه جولة من منظور الشخص الأول، تعمل فيها الأبواب والأدراج والأضواء وآلة الإسبريسو كلها.
الناتج ليس صورة، بل مشهد Blender يمكنك مواصلة تعديله.
والحدود واضحة بالقدر نفسه:
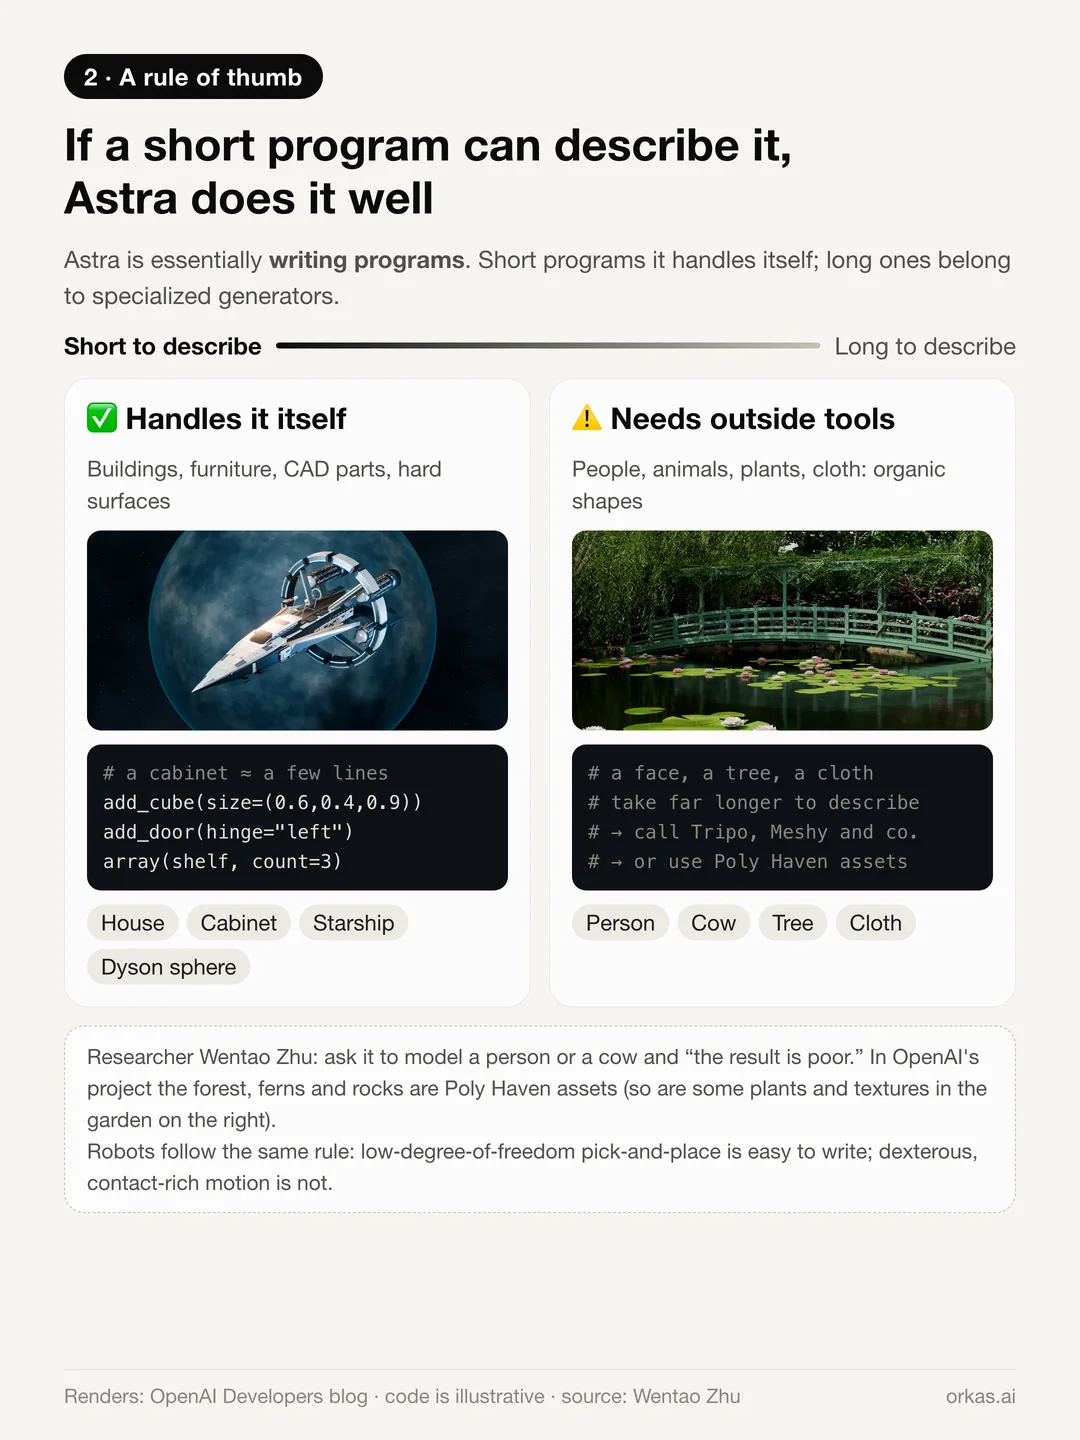
- الهندسة المنتظمة التي يصنعها الإنسان تنجح جيدًا: المباني والأثاث وقطع CAD، ونماذج الأسطح الصلبة مثل مركبة فضائية أو كرة دايسون.
- أما الأشكال العضوية فلا. يكتب الباحث Wentao Zhu أنك إذا طلبت منه نمذجة إنسان أو بقرة، فستكون النتيجة رديئة.
- وفي مشروع OpenAI نفسه، الغابة والسراخس والصخور أصول جاهزة من Poly Haven. ومن أساليب العمل الشائعة في مجتمع المستخدمين توليد النموذج بأداة ثلاثية الأبعاد مثل Tripo، ثم تسليم الخامات ومفاتيح الشكل (shape keys) الخاصة بتعابير الوجه وتجهيز الهيكل العظمي للتحريك إلى Astra.
فكرة واحدة تفسّر هذا النمط: الشيفرة هندسة مضغوطة. الخزانة بضعة صناديق وعملية بثق ومصفوفة تكرار، أي بضعة أسطر لا أكثر. أما الوجه أو الشجرة أو القماش المنسدل فيحتاج إلى أكثر من ذلك بكثير. Astra يكتب برامج، لذا فما يكفيه برنامج قصير يتولاه بنفسه، وما يحتاج إلى برنامج طويل ينبغي أن يسلّمه إلى مولّد متخصص. وستظهر القاعدة نفسها مجددًا مع الروبوتات.
الروبوتات: نتائج قوية، لكن اقرأ الشروط
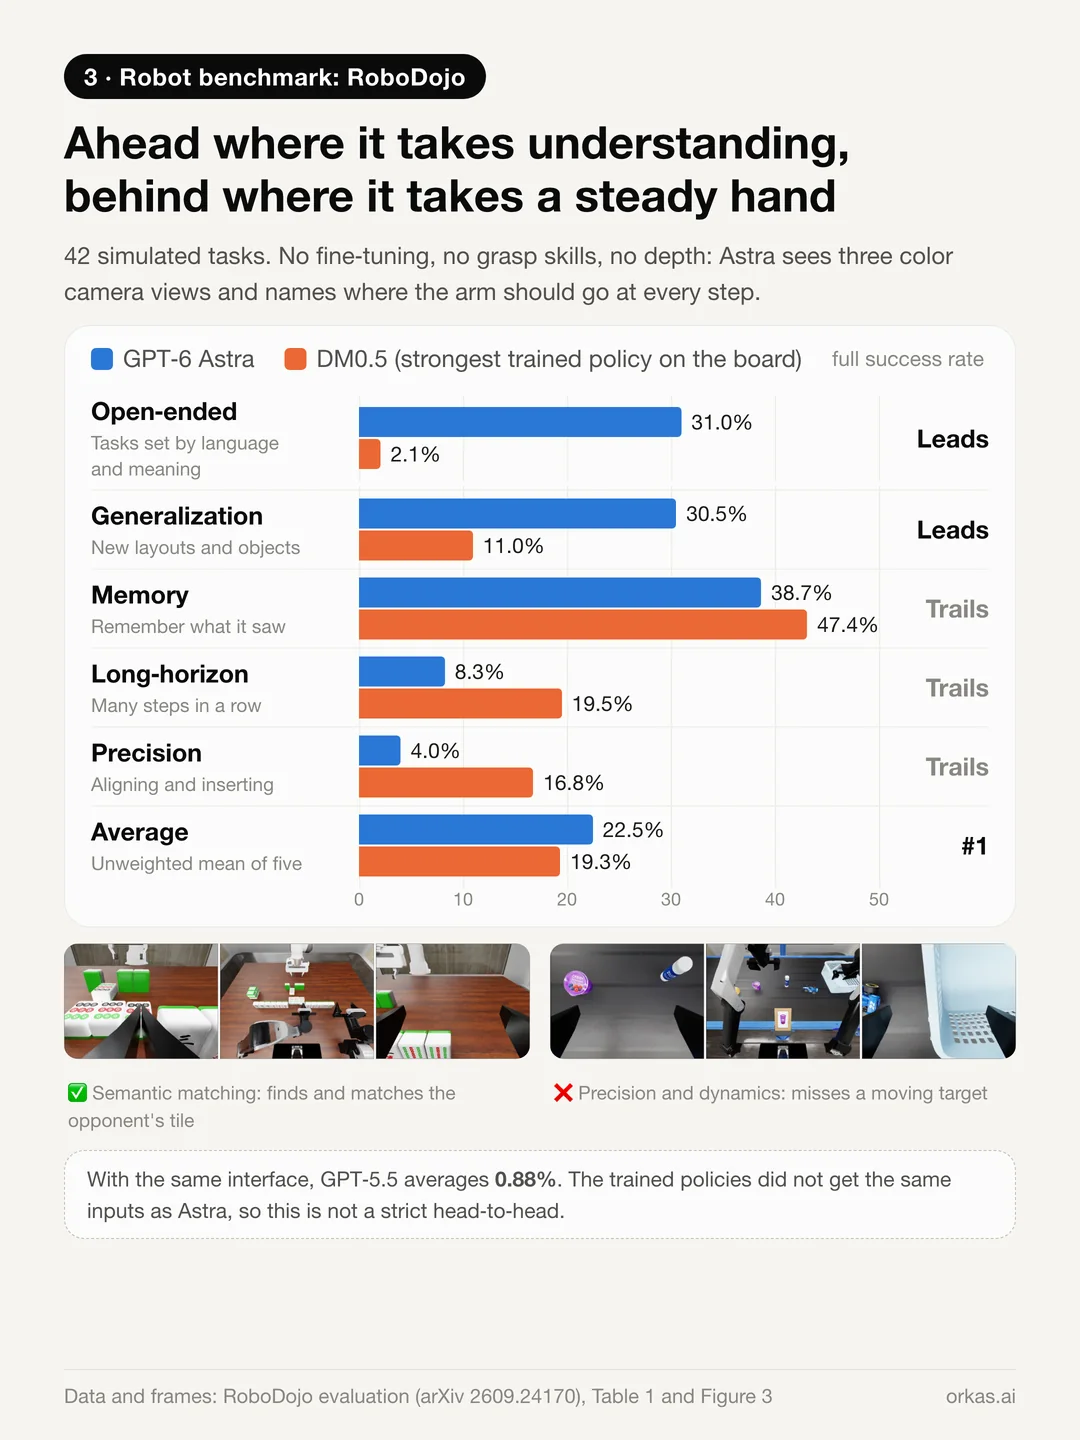
يُعد RoboDojo اختبارًا معياريًا للروبوتات يضم 42 مهمة في المحاكاة، ولوحة صدارة تضم 40 سياسة تحكم مدرّبة للروبوتات. وقد وضع مؤلفو أحد التقييمات Astra في موضع السياسة نفسها: بلا ضبط دقيق، وبلا مهارات إمساك جاهزة، وبلا معلومات عن العمق. كان يرى ثلاث صور ملونة من الكاميرات وحالة الروبوت، ويحدد في كل خطوة الموضع الذي يجب أن تتجه إليه الذراع.
- حقق Astra متوسط نجاح بلغ 22.48% واحتل المركز الأول. وفي الإعداد نفسه لم يتجاوز GPT-5.5 نسبة 0.88%.
- ملامح الأداء غير متوازنة: يتقدّم في المهام المفتوحة (31% مقابل 2.1% لـDM0.5) وفي التعميم (30.5% مقابل 11%)، بينما يتأخر في الدقة (4% مقابل 16.8%) وفي المهام طويلة المدى والذاكرة.
بعبارة بسيطة: المهام التي تحتاج إلى فهم يربحها، والمهام التي تحتاج إلى يد ثابتة يخسرها.
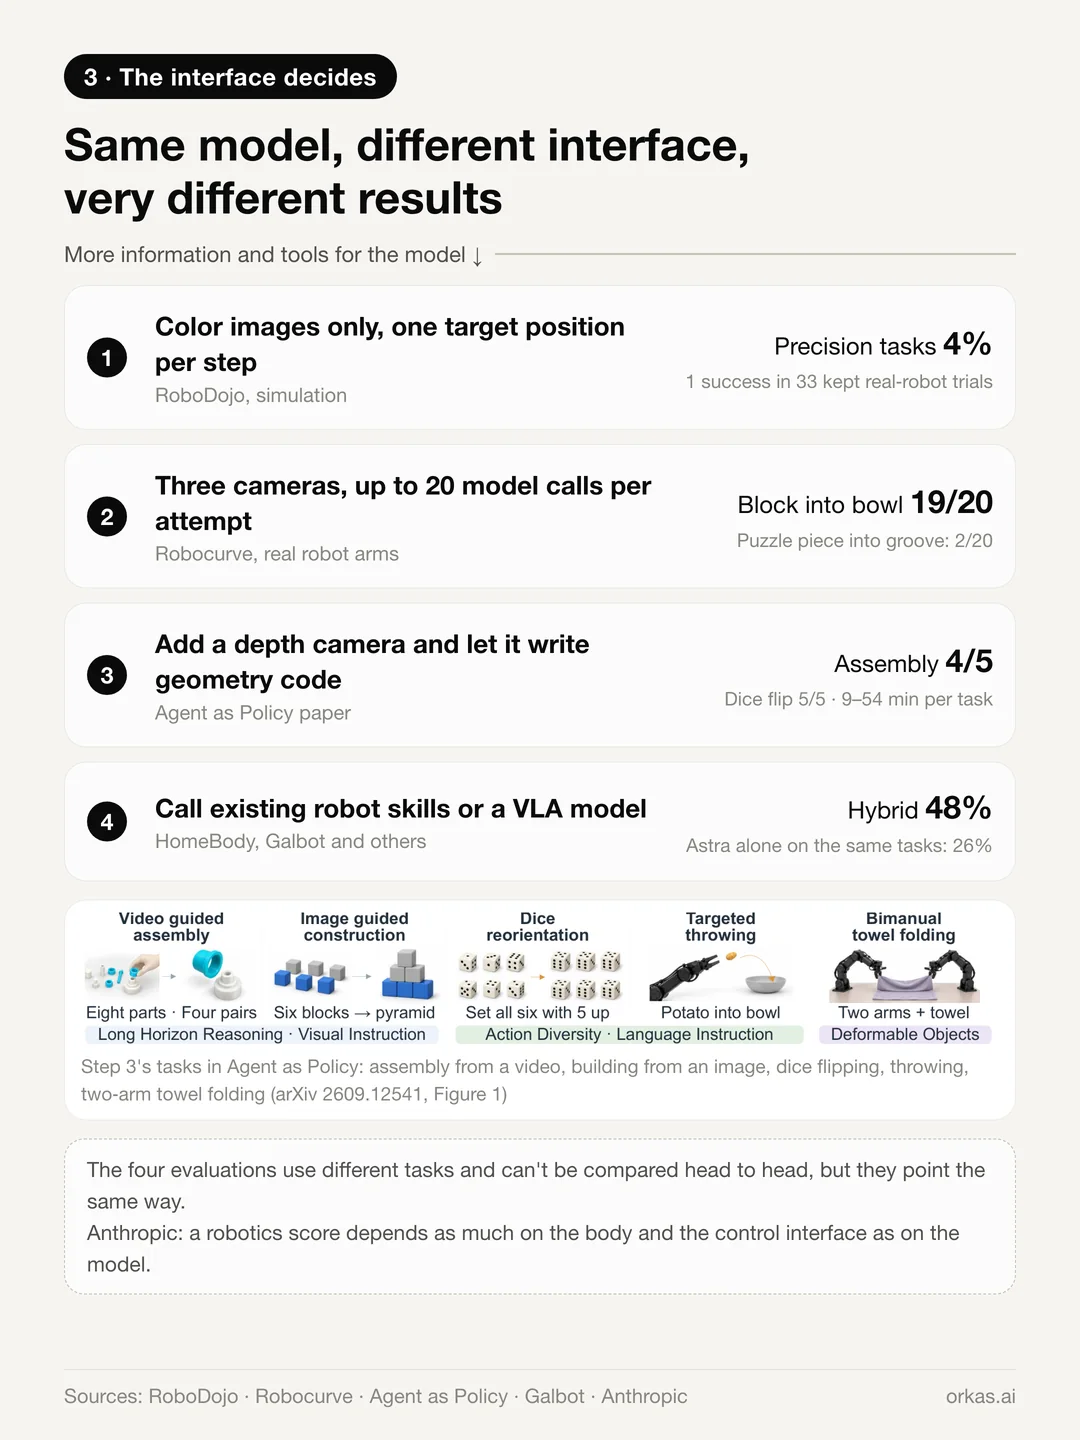
والدرس الأكبر هو مقدار اعتماد النتيجة على الواجهة:
- صور ملونة فقط، وموضع هدف واحد في كل خطوة (RoboDojo): نجاح بنسبة 4% في مهام الدقة؛ ومن بين 33 تجربة على روبوت حقيقي احتُفظ بها قبل توقف السلامة وبعده، نجحت تجربة واحدة نجاحًا كاملًا.
- ثلاث كاميرات، وما يصل إلى 20 استدعاءً للنموذج في كل محاولة (اختبارات Robocurve على أذرع حقيقية): وضع 19 مكعبًا من 20 في وعاء، لكنه لم يُدخل سوى 2 من 20 قطعة أحجية في مجراها.
- كاميرا عمق، مع السماح له بكتابة شيفرته الهندسية بنفسه (ورقة Agent as Policy v1 · الجدول 1): نجح في 4 من 5 عمليات تجميع لأربعة أزواج من القطع، وفي 5 من 5 عمليات قلب لحجر النرد، وفي بناء المكعبات بنتائج 5/5 و5/5 و4/5، بمتوسط زمن يقارب 21–54 دقيقة للتجارب الناجحة، بحسب المهمة.
- استدعاء مهارات روبوتية جاهزة أو نموذج VLA: تُنجَز المهام الطويلة. في أحد التقارير، نجح نظام هجين يراجع فيه Astra أفعال نموذج VLA ويصححها في 48% من المحاولات، في مهام لم يتجاوز فيها Astra وحده 26%.
هذه مهام مختلفة ولا يمكن مقارنتها مباشرة، لكنها تشير إلى الاتجاه نفسه. وقد توصلت دراسة Anthropic عن الروبوتات في يوليو إلى النتيجة نفسها: نتيجة النموذج في الروبوتات تعتمد على جسم الروبوت وواجهة التحكم بقدر ما تعتمد على النموذج نفسه. لذا فأي ادعاء عن مدى براعة Astra في فهم المكان يحتاج إلى عبارة «بأي واجهة».
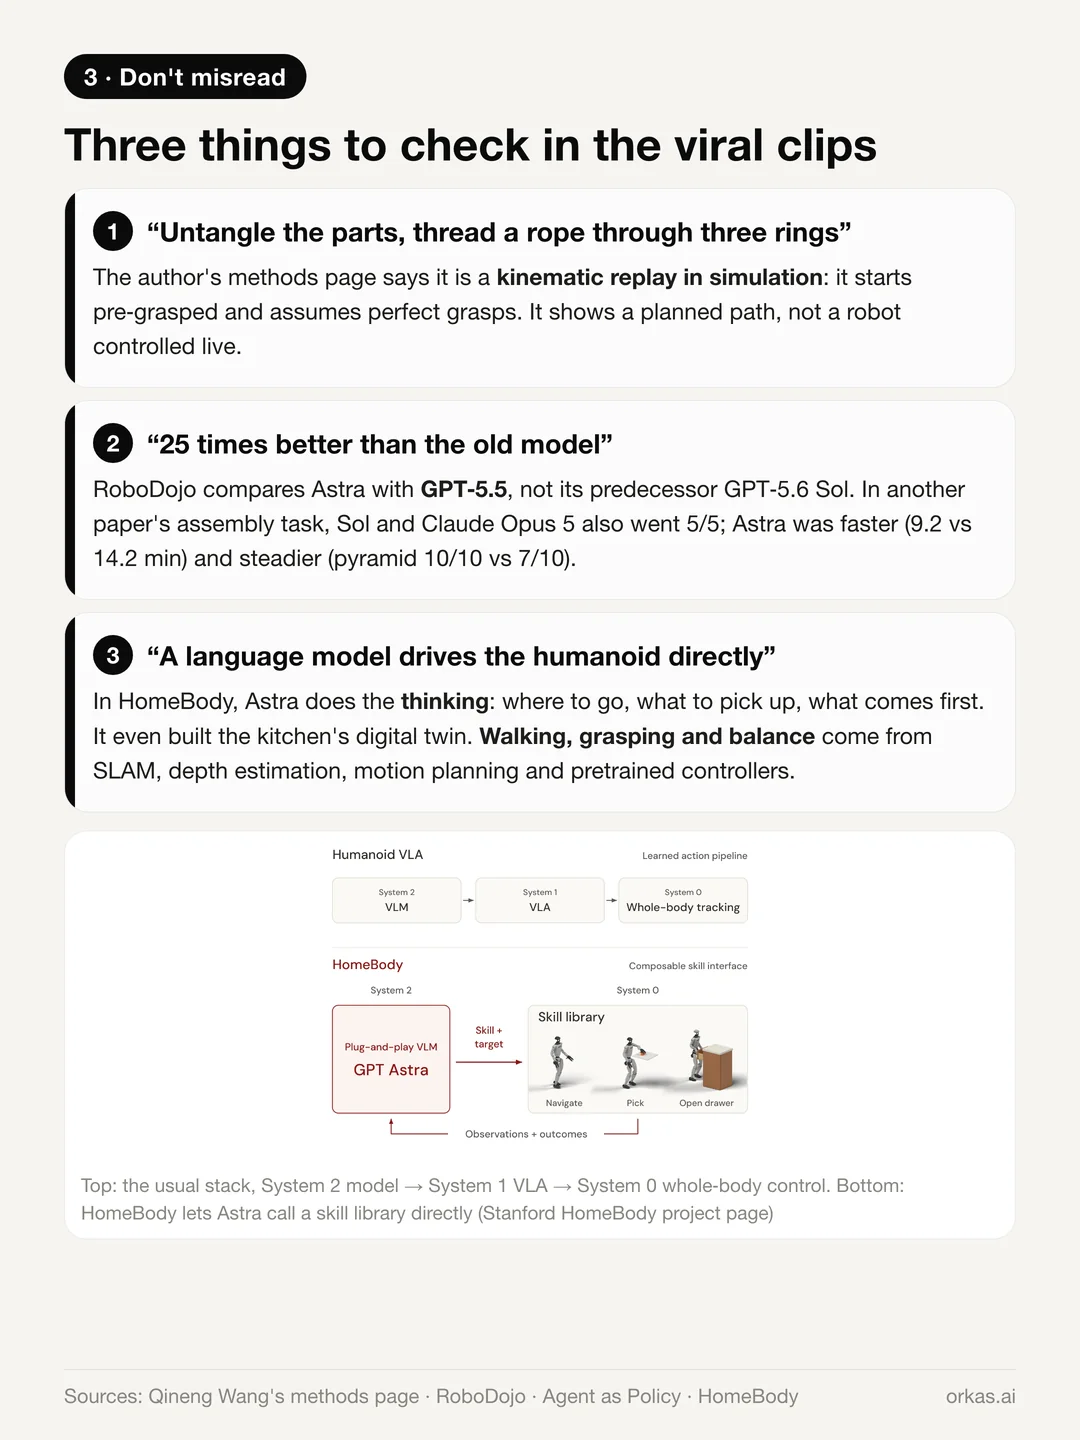
ثلاثة أمور ينبغي تذكّرها حين تمر العروض التوضيحية أمامك:
- المقطع المنتشر «فكّ القطع المتشابكة، ثم تمرير حبل عبر ثلاث حلقات» هو إعادة عرض حركية في محاكاة. تقول صفحة المنهجية لدى المؤلف إنه يبدأ من وضع تكون فيه القطع ممسوكة مسبقًا، ويفترض إمساكًا مثاليًا: إنه يعرض مسارًا مخطَّطًا، لا روبوتًا يُتحكَّم فيه مباشرة.
- عبارة «أفضل بـ25 مرة من النموذج القديم» تقارن Astra بـGPT-5.5، لا بسلفه المباشر GPT-5.6 Sol. وفي مقارنة تجميع زوجين (AGP v1 · الجدول 2)، نجح Sol وClaude Opus 5 أيضًا في 5/5 تجارب؛ بلغ متوسط زمن التجارب الناجحة لـAstra نحو 9.2 دقيقة مقابل 14.2 دقيقة لـSol. وفي مقارنة مستقلة لبناء الهرم (AGP v1 · الملحق C, الجدول 5)، نجح Astra في 10/10 تجارب وSol في 7/10.
- روبوت المطبخ HomeBody من Stanford: يتولى Astra التفكير، أي إلى أين يذهب، وماذا يلتقط، وماذا يفعل أولًا، بل إنه بنى التوأم الرقمي للمطبخ أيضًا. أما المشي والإمساك والتوازن فتأتي من SLAM وتقدير العمق وتخطيط الحركة ووحدات تحكم منخفضة المستوى مدرّبة مسبقًا.
من أين تأتي هذه القدرة
صرّحت OpenAI رسميًا بأمرين: أن Astra تلقّى «تدريبًا موجّهًا للبيئات المهنية»، وأنه مدرَّب بالتعلم المعزّز مثل نماذج الاستدلال الأخرى لدى OpenAI. ولم تكشف عن بيانات التدريب، ولا عمّا إذا كان Blender جزءًا منها، ولا عمّا إذا كانت بيانات الروبوتات كذلك. ما يلي استنتاج من الأدلة المتاحة للعموم.
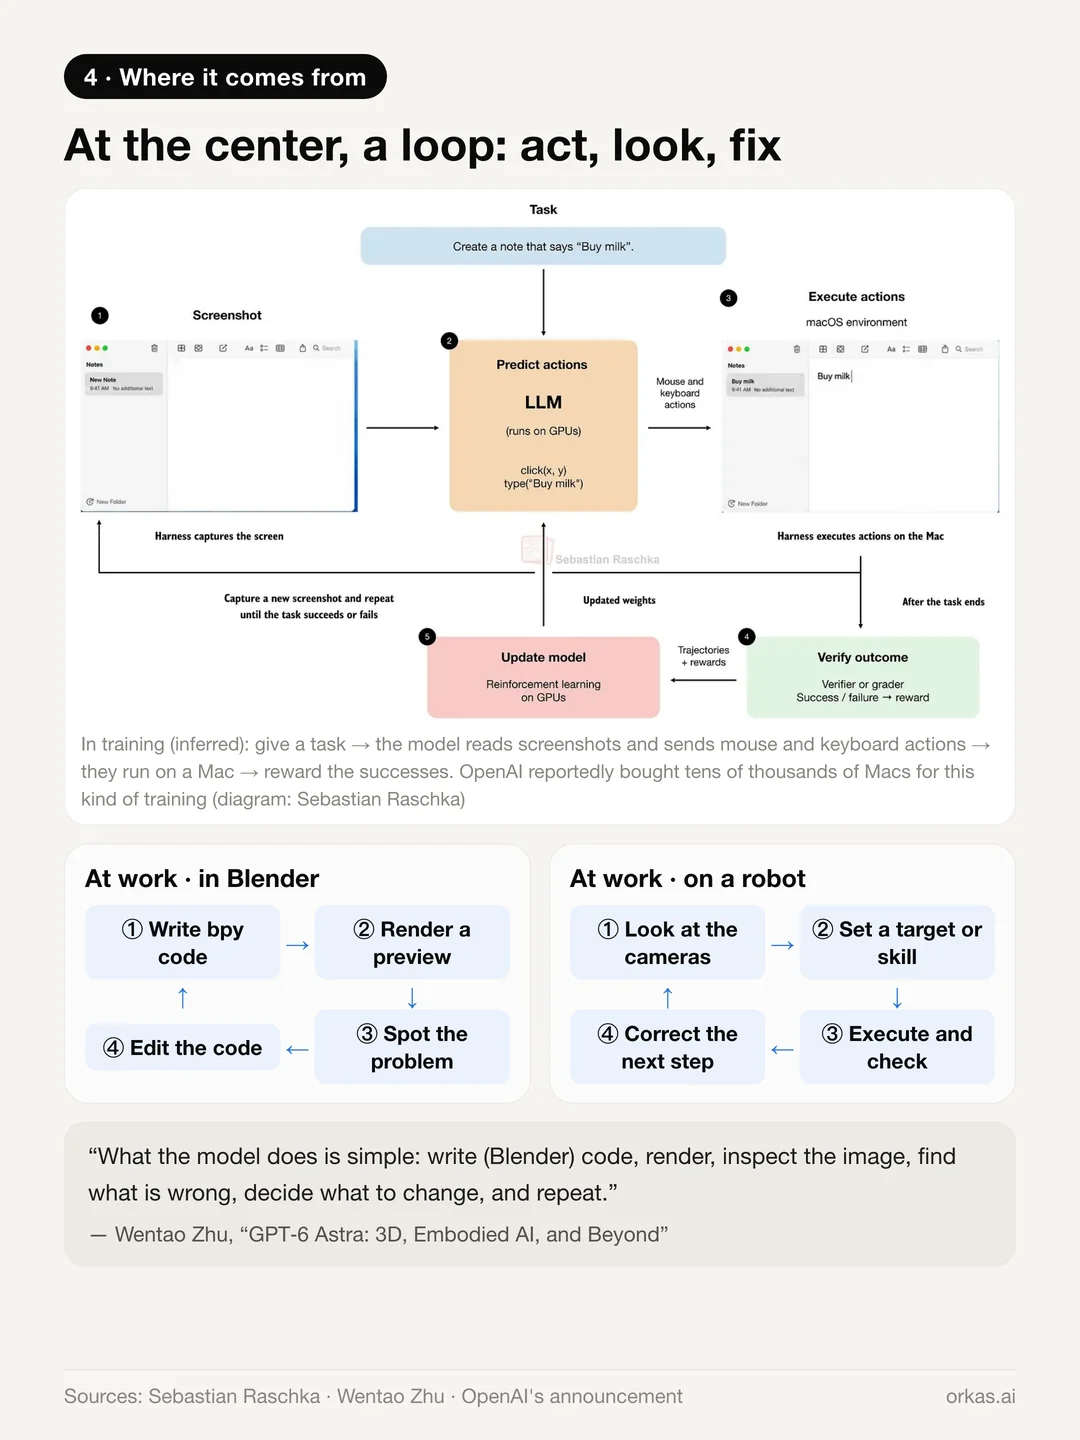
في القلب من ذلك حلقة: اتخذ خطوة، وانظر إلى النتيجة، وابحث عن الخطأ، ثم أصلحه.
- في العمل، يكتب Astra شيفرة Blender ويصيّر المشهد ويفحصه ويعدّله؛ وعلى الروبوت ينظر ويحدد هدفًا وينفّذ ويتحقق ويصحّح. وبتعبير Wentao Zhu: «ما يفعله النموذج بسيط: يكتب شيفرة (Blender)، ويصيّر، ويفحص الصورة، ويجد الخطأ، ويقرر ما يجب تغييره، ثم يكرر».
- في التدريب، المصدر المرجّح هو الحلقة نفسها. وتفيد التقارير بأن OpenAI اشترت عشرات الآلاف من أجهزة Mac mini وMac Studio لتدريب النموذج على استخدام الحاسوب: تُعطى للنموذج مهمة، ويُترك ليقرأ لقطات الشاشة ويرسل أوامر الفأرة ولوحة المفاتيح إلى جهاز Mac، ثم تُكافأ المحاولات الناجحة.
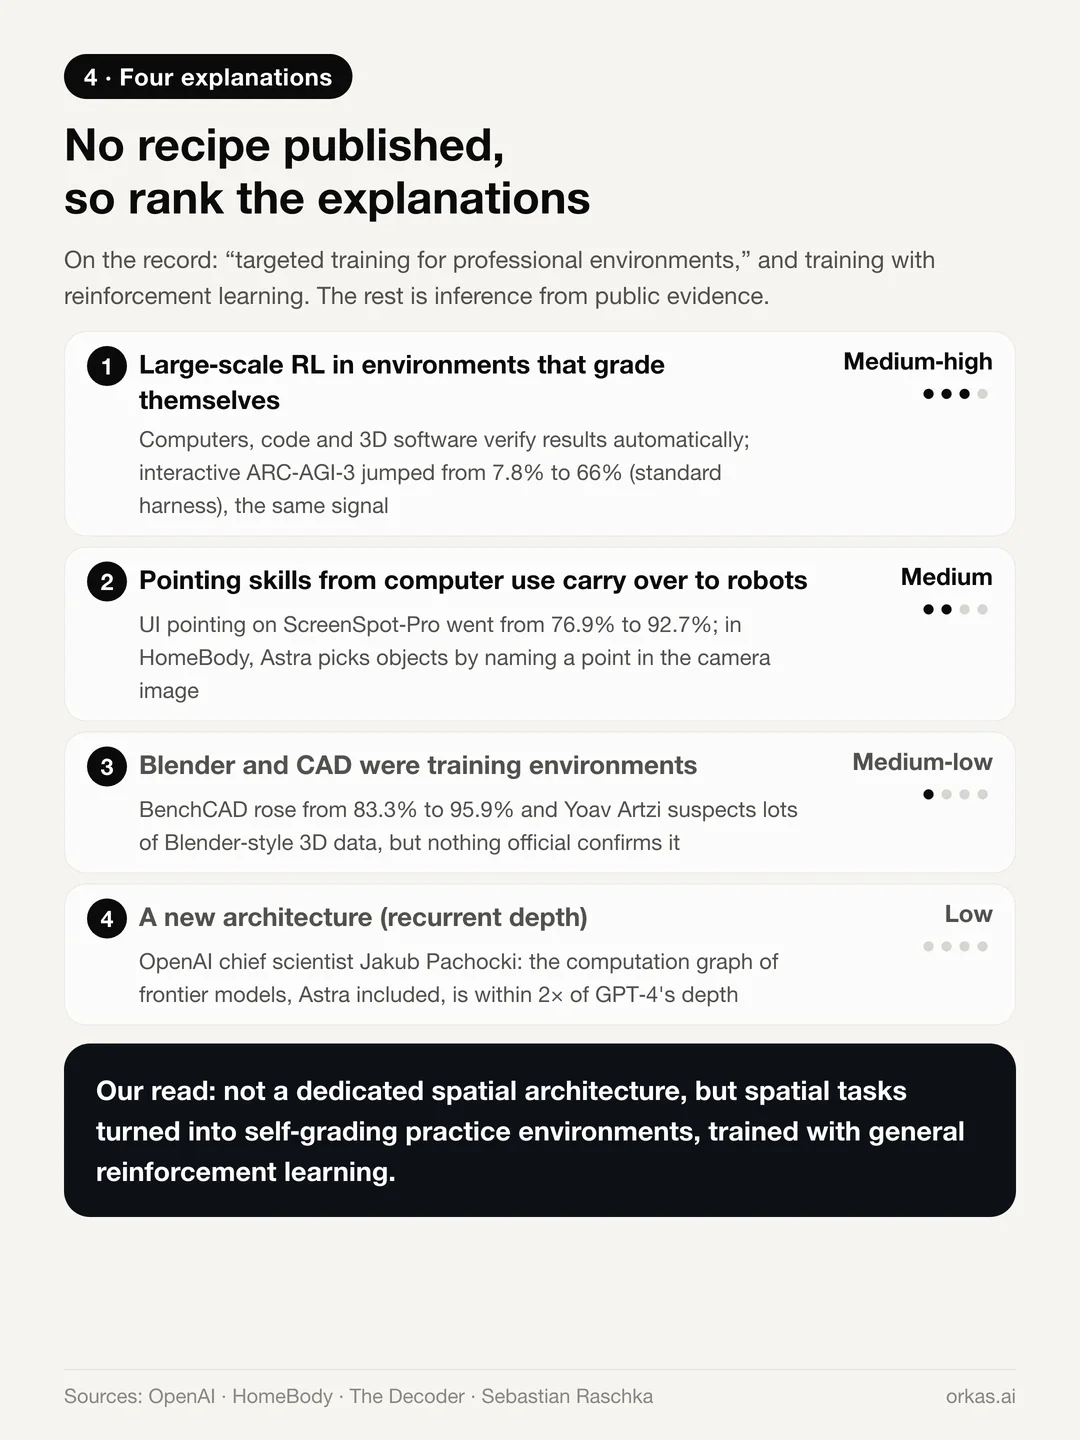
- تعلّم معزّز واسع النطاق في بيئات تقيّم النتائج تلقائيًا (الاحتمال: متوسط إلى مرتفع). الحواسيب والشيفرات والبرامج ثلاثية الأبعاد كلها قادرة على التحقق من النتائج تلقائيًا، وهذا يدرّب المهارة العامة: الفحص، وإيجاد الخطأ، وإصلاحه. والقفزة في ARC-AGI-3 التفاعلي، من 7.8% إلى 66%، هي الإشارة نفسها.
- مهارات الإشارة المكتسبة من استخدام الحاسوب تنتقل إلى الروبوتات (متوسط). ارتفع ScreenSpot-Pro من 76.9% إلى 92.7%، أي إن النموذج صار أفضل بكثير في إصابة نقطة محددة في الصورة. وفي HomeBody يلتقط Astra الأشياء بتحديد نقطة كهذه تمامًا في صورة الكاميرا، ثم يحوّلها العمق والمعايرة إلى موضع ثلاثي الأبعاد.
- كان Blender وCAD نفساهما بيئتَي تدريب (متوسط إلى منخفض، غير مؤكد). قفزت نتيجة BenchCAD، وتضع OpenAI العروض ثلاثية الأبعاد في الواجهة، ويشتبه Yoav Artzi في أن التدريب شمل كميات كبيرة من البيانات ثلاثية الأبعاد مثل مشاهد Blender. لا شيء رسميًا يؤكد ذلك.
- معمارية جديدة (منخفض). تفيد التقارير بأن Astra يستخدم عمقًا متكررًا في جزء من الشبكة، لكن Jakub Pachocki، كبير العلماء في OpenAI، قال إن عمق الرسم الحسابي للنماذج الرائدة الحالية، ومنها Astra، يبقى في حدود ضعف عمق GPT-4.
قراءتنا: الأرجح أن المهارة المكانية لم تأتِ من معمارية مخصصة للمكان، بل من تحويل المهام المكانية إلى بيئات تدريب تقيّم النتائج تلقائيًا، ثم التدرّب عليها بتعلّم معزّز عام الغرض.
ماذا يعني ذلك لتوليد المحتوى ثلاثي الأبعاد
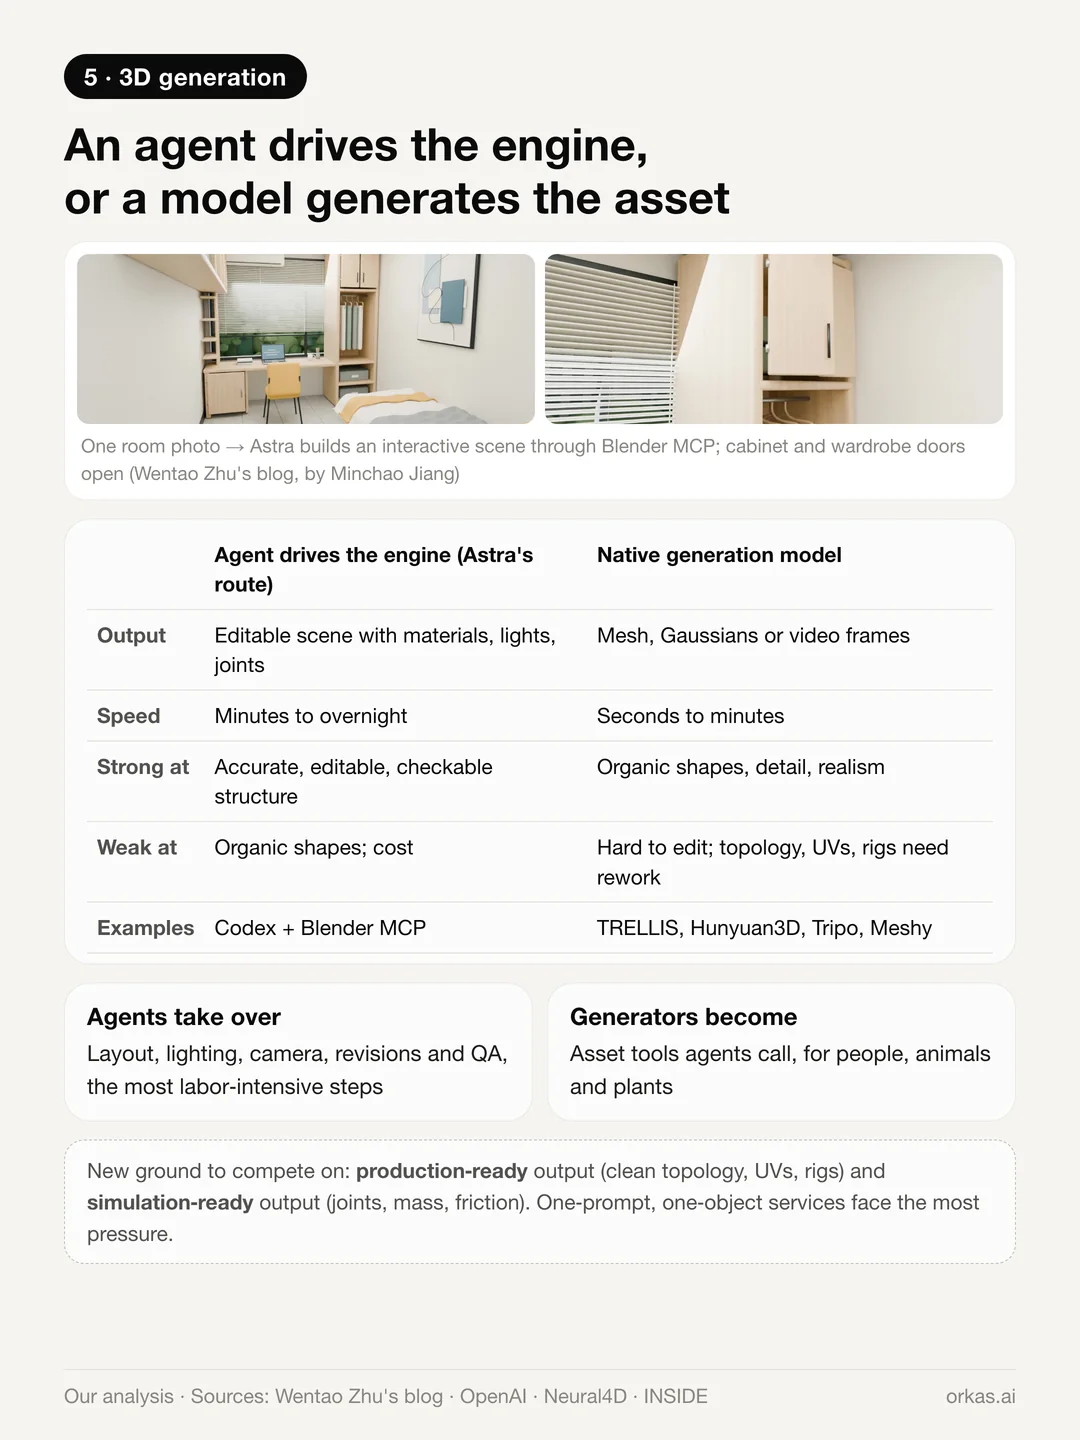
هناك الآن طريقتان لصنع المحتوى ثلاثي الأبعاد:
- وكيل يقود المحرّك. كما يفعل Astra في Blender أو CAD، يسلّم الوكيل مشهدًا قابلًا للتعديل بخاماته وإضاءته ومفاصله. الطريقة بطيئة، من دقائق إلى ليلة كاملة، لكنها دقيقة البنية وقابلة للتعديل والتحقق.
- نموذج يولّد الأصل. تُخرج TRELLIS وHunyuan3D وTripo وMeshy والنماذج المشابهة شبكة مضلعات في ثوانٍ أو دقائق. هي قوية في الأشكال العضوية والتفاصيل، لكن نتيجتها صعبة التعديل، وكثيرًا ما تحتاج الطوبولوجيا وخرائط UV والهيكل العظمي للتحريك إلى إعادة عمل.
نتوقع أن يكمّل الطريقان أحدهما الآخر، مع انتقال القيمة من موضع إلى آخر:
- يتولى الوكلاء أكثر الخطوات استهلاكًا للجهد: توزيع عناصر المشهد، والإضاءة، وحركة الكاميرا، والتعديلات، وضبط الجودة.
- تصبح المولّدات أدوات لإنتاج أصول البشر والحيوانات والنباتات، ويجب أن يكون استدعاؤها متاحًا للوكلاء، مثلًا بوصفها خادم MCP أو API.
- الخدمات القائمة على «أمر نصي واحد، مجسّم واحد» هي الأكثر تعرضًا للضغط. وتصبح المخرجات الجاهزة للإنتاج (طوبولوجيا نظيفة، وخرائط UV، وهياكل تحريك) والمخرجات الجاهزة للمحاكاة (مفاصل، وكتلة، واحتكاك) ساحة المنافسة الجديدة.
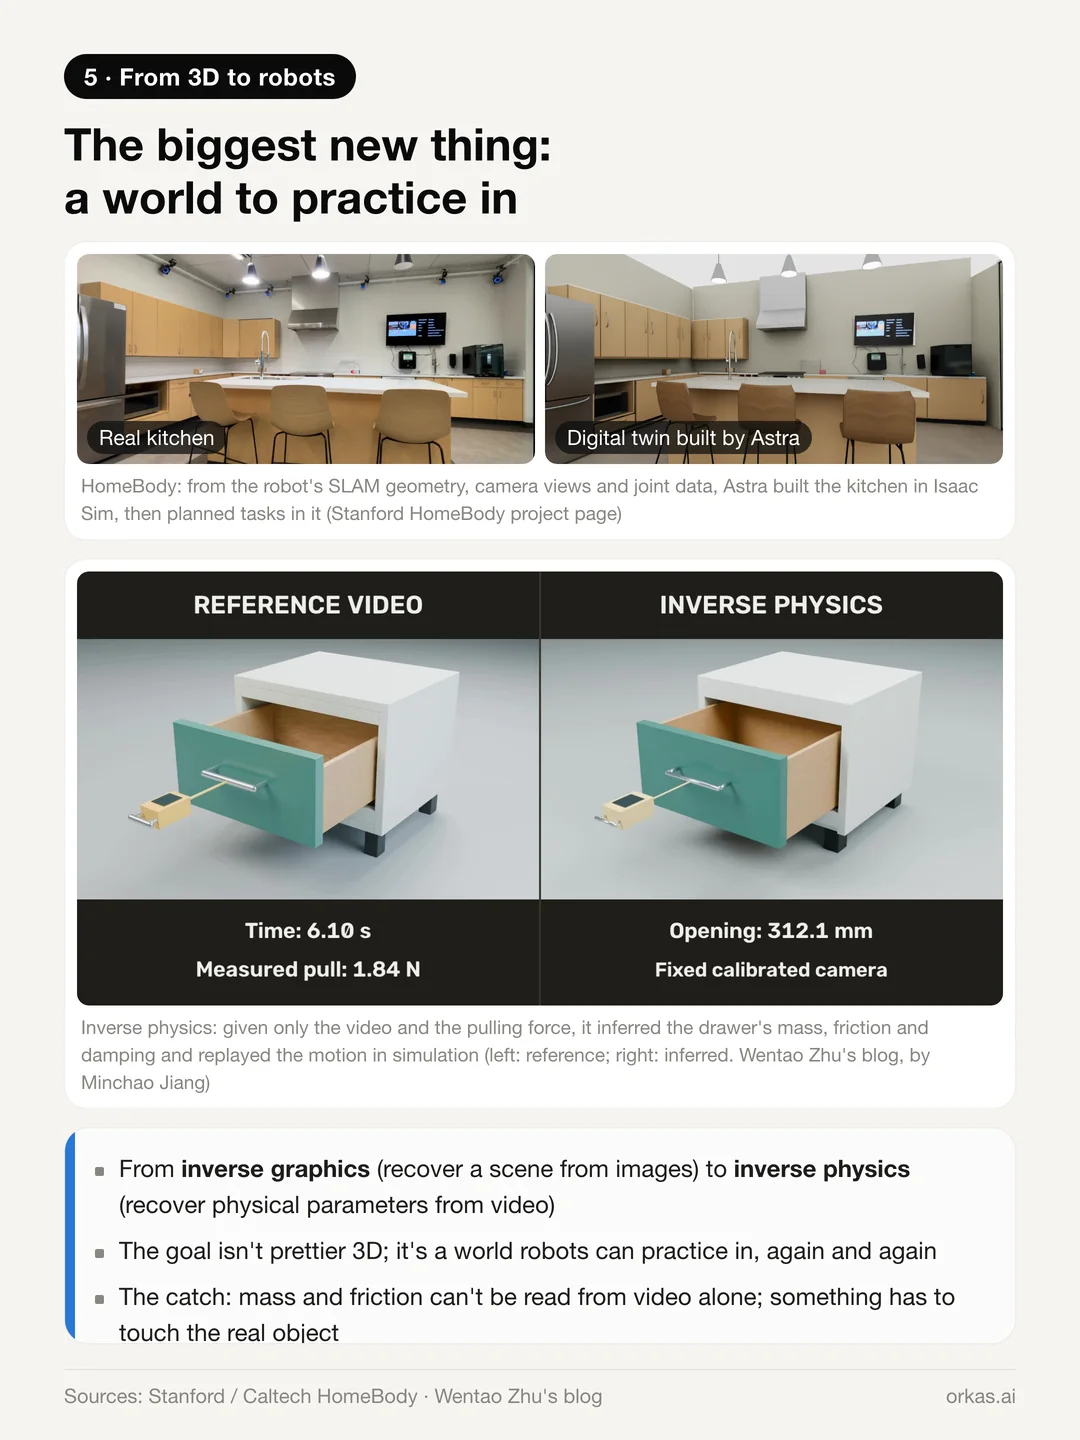
أكبر فرصة جديدة ليست محتوى ثلاثي الأبعاد أجمل، بل عالم يمكن التدرّب فيه.
- في HomeBody، بنى Astra توأمًا رقميًا للمطبخ داخل محاكٍ، انطلاقًا من هندسة SLAM التي سجّلها الروبوت نفسه ومشاهد كاميراته وبيانات مفاصله، ثم خطط المهام باستخدامه.
- وعرض فريق Wentao Zhu الفيزياء العكسية: انطلاقًا من فيديو وقوة السحب فقط، استنتج النموذج كتلة الدرج واحتكاكه وتخميده، وأعاد إنتاج الحركة في المحاكاة.
بعبارة أخرى، ما تقود إليه المهارة ثلاثية الأبعاد هو عالم تدريب للروبوتات. لكن هناك عقبة: لا يمكن قراءة الكتلة والاحتكاك من الفيديو وحده، لذا لا بد في مرحلة ما من أن يدفع شيءٌ جسمًا حقيقيًا.
ولم تخرج نماذج العالم الأصلية من السباق أيضًا. فنموذج Atlas من World Labs، الذي أُطلق في 1 سبتمبر، يولّد عوالم ثلاثية الأبعاد كاملة ويعيد بناءها من بضع صور، بواقعية واستمرارية لا يستطيع وكيل يقود محركًا أن يجاريهما. والأرجح أن ينتهي المطاف بالطريقين إلى أن يستدعي كل منهما الآخر.
ماذا يعني ذلك لأدمغة الروبوتات
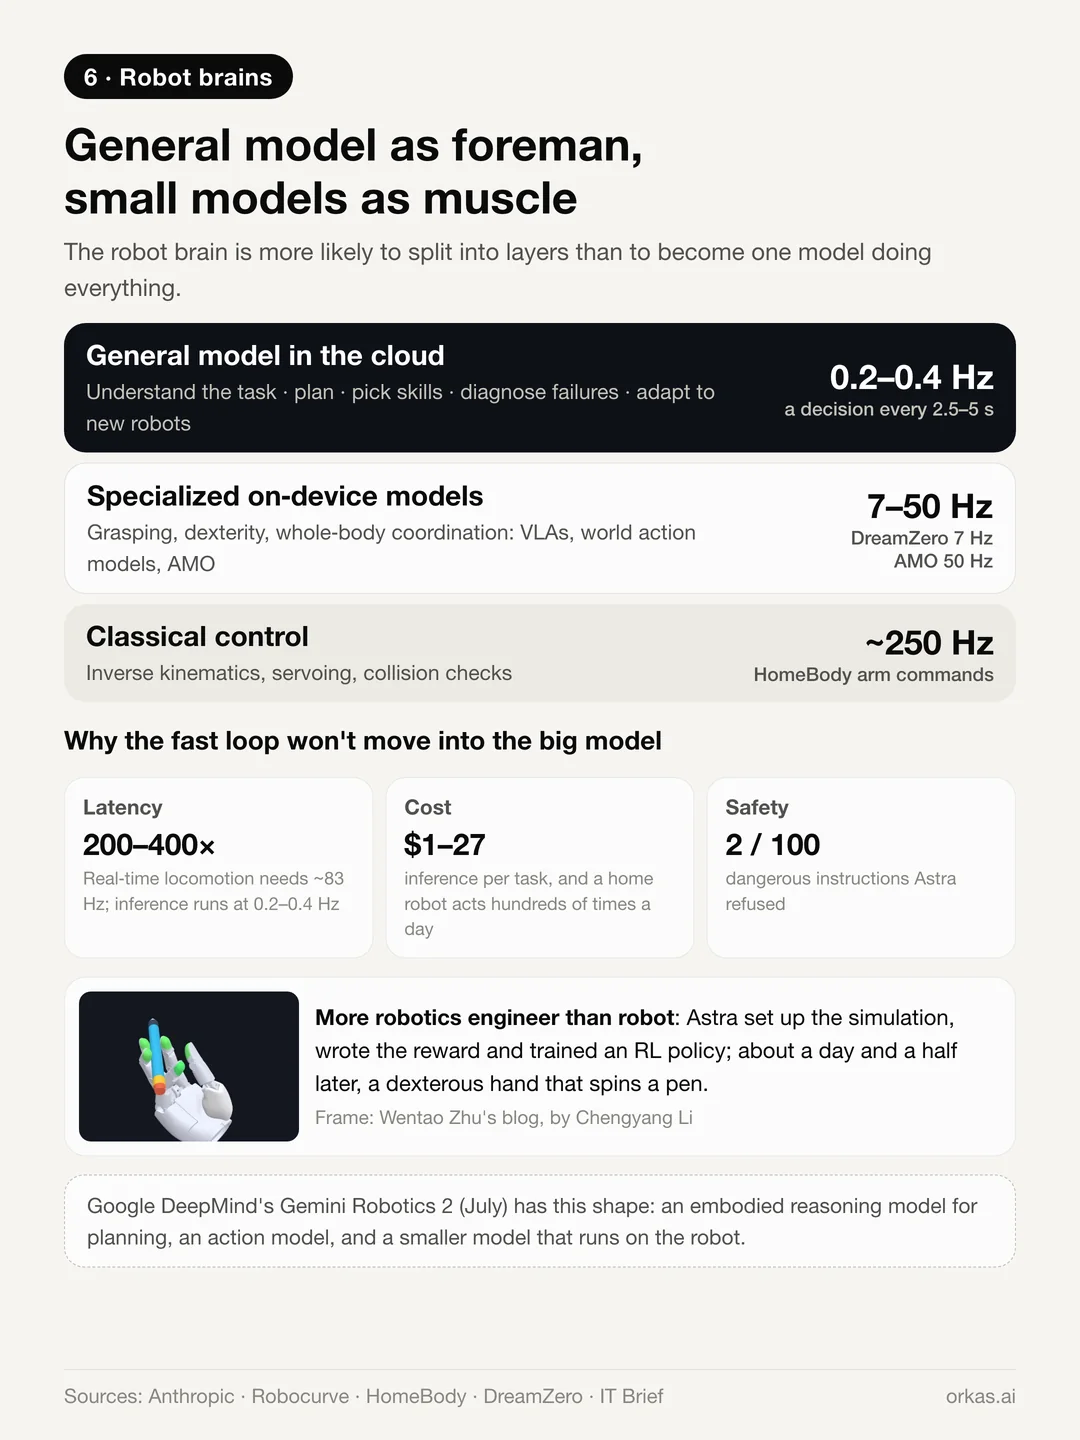
نتوقع أن ينقسم دماغ الروبوت إلى طبقات، بدلًا من أن يتولى نموذج واحد كل شيء:
- تتولى النماذج العامة فهم المهمة، وتخطيط الخطوات، واختيار المهارات، وتشخيص الإخفاقات، والتكيّف مع روبوتات جديدة، أي «التعميم الدلالي» الذي كانت نماذج VLA تفخر به. وعلى محورَي المهام المفتوحة والتعميم في RoboDojo، يتفوق Astra بالفعل على سياسات التحكم المدرّبة للروبوتات.
- تحتفظ النماذج المتخصصة بالتحكم عالي التردد، والتلامس، والبراعة اليدوية، وتوازن الجسم بأكمله.
- والتحول أن هذه النماذج المتخصصة سيبنيها النموذج العام بصورة متزايدة. فقد جعل فريق Wentao Zhu نموذج Astra يُعدّ محاكاة، ويكتب دالة المكافأة، ويدرّب سياسة بالتعلم المعزّز؛ وبعد نحو يوم ونصف سلّم يدًا بارعة تدير قلمًا.
وتبقى حلقة التحكم السريعة منفصلة بسبب ثلاثة حدود صارمة:
- زمن الاستجابة: تقدّر Anthropic أن الحركة في الوقت الفعلي تحتاج إلى نحو 83 هرتز، بينما يعمل استدلال النموذج بتردد 0.2–0.4 هرتز، أي بفارق مرتبتين عشريتين تقريبًا.
- التكلفة: نحو 1 إلى 27 دولارًا لكل مهمة في التقييمات المذكورة أعلاه، بينما ينفّذ الروبوت المنزلي مئات الأفعال يوميًا.
- السلامة: في اختبار RoboHarm من Robocurve، لم يرفض Astra إلا 2 من 100 تعليمة خطرة. تحتاج السلامة إلى ضوابط خاصة بها لا تعتمد على السحابة.
ونموذج Gemini Robotics 2 من Google DeepMind، الذي أُعلن عنه في يوليو، يتخذ هذا الشكل بالفعل: نموذج استدلال متجسّد للتخطيط، ونموذج للأفعال، ونموذج أصغر يعمل على الروبوت نفسه.
هل يثبت هذا أن النماذج الانحدارية الذاتية هي الرابحة؟
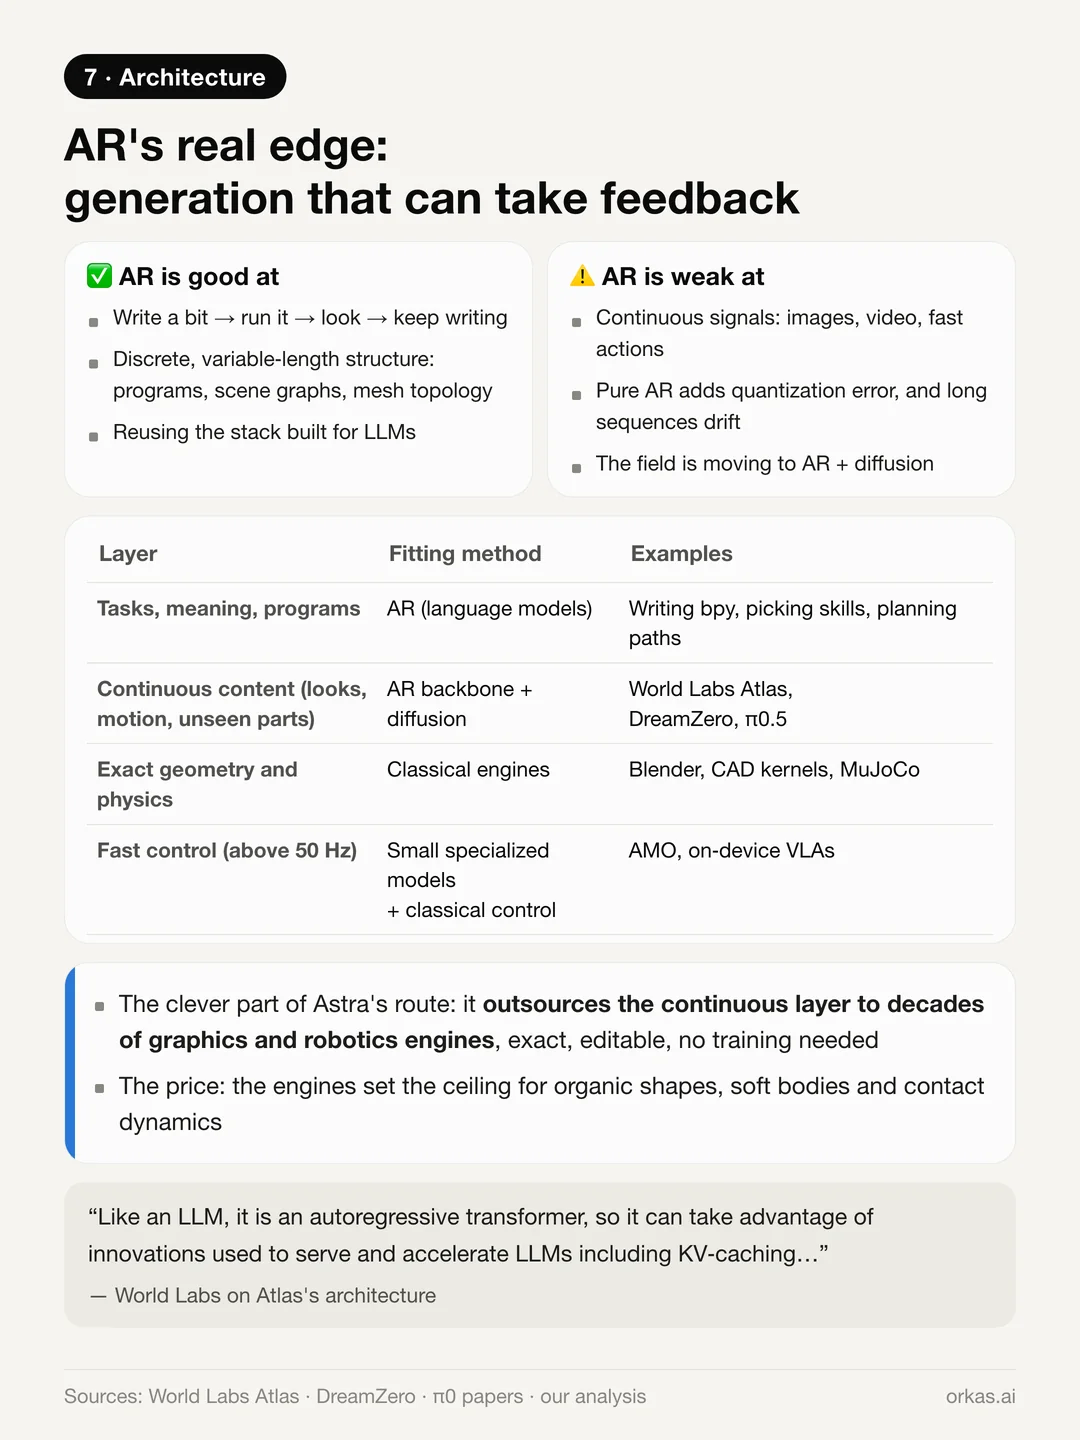
يرى بعضهم في Astra دليلًا على أن التوليد الانحداري الذاتي (AR)، أي إنتاج رمز تلو الآخر كما تفعل نماذج GPT، يملك الأفضلية. نحن نتفق مع نصف هذا الرأي:
- الميزة الحقيقية لـAR أن التوليد يمكن أن يتناوب مع ملاحظات من الخارج: اكتب بعض الشيفرة، وشغّلها، وانظر إلى النتيجة، ثم تابع الكتابة. أما نموذج الانتشار فينتج النتيجة كاملة دفعة واحدة، ويصعب عليه تلقي الملاحظات في منتصف الطريق.
- ويناسب AR أيضًا البنى المنفصلة متغيرة الطول، مثل البرامج ومخططات المشاهد وطوبولوجيا الشبكات، ويعيد استخدام منظومة التدريب والتشغيل التي بُنيت للنماذج اللغوية الكبيرة.
- أما الإشارات المتصلة، مثل الصور والفيديو وأوامر المحركات، فلا يملك فيها AR الخالص أي أفضلية. ويتجه المجال إلى بنية أساسية انحدارية ذاتية مع رأس انتشار أو مطابقة تدفق: Atlas من World Labs، وDreamZero من باحثين في NVIDIA، وπ0.5 كلها تسلك هذا الطريق.
- الذكاء في مسار Astra أنه يُسند الطبقة المتصلة إلى محركات التصيير ونوى CAD ومحركات الفيزياء ومخططات الحركة. فتصبح عقود من هندسة الرسوميات والروبوتات هي وحدة فك الترميز: دقيقة وقابلة للتعديل ولا تحتاج إلى تدريب. والثمن أن المحركات هي التي تحدد السقف.
ماذا يعني هذا إذا كنت تعمل مع الوكلاء
نحن نبني تطبيقًا لسطح المكتب يتولى فيه الوكلاء العمل، لذا فإن ما كشفته التقييمات عن الواجهة هو أكثر ما يهمنا. فقد حقق النموذج نفسه نتائج مختلفة جدًا تبعًا لما يستطيع رؤيته، والأدوات التي يستطيع استدعاءها، وما إذا كان يستطيع التحقق من مخرجاته. جزء كبير من القدرة يكمن في تلك الحلقة، لا في الأوزان وحدها.
وهذه الحلقة هي ما يجب أن توفره مساحة عمل الوكلاء: أدوات يعمل بها الوكيل، وملفات يعمل عليها، ونتائج يستطيع فحصها قبل أن يسلّمها. في Orkas يمكنك تشغيل GPT-6 Astra بمفتاح OpenAI API الخاص بك أو بتسجيل الدخول بحسابك في ChatGPT، أو ربط Codex بوصفه وكيلًا خارجيًا، أو استخدام النماذج التي يديرها Orkas. ويقبل Orkas أيضًا خوادم MCP المخصصة، لذا يمكن إضافة الخوادم التي يطوّرها المجتمع لأدوات سطح المكتب بوصفها موصّلات. لم نختبر خادمًا لـBlender من البداية إلى النهاية، لذا تعامل مع هذا الخيار بوصفه طريقًا تجرّبه بنفسك.
ما نستخلصه من ذلك
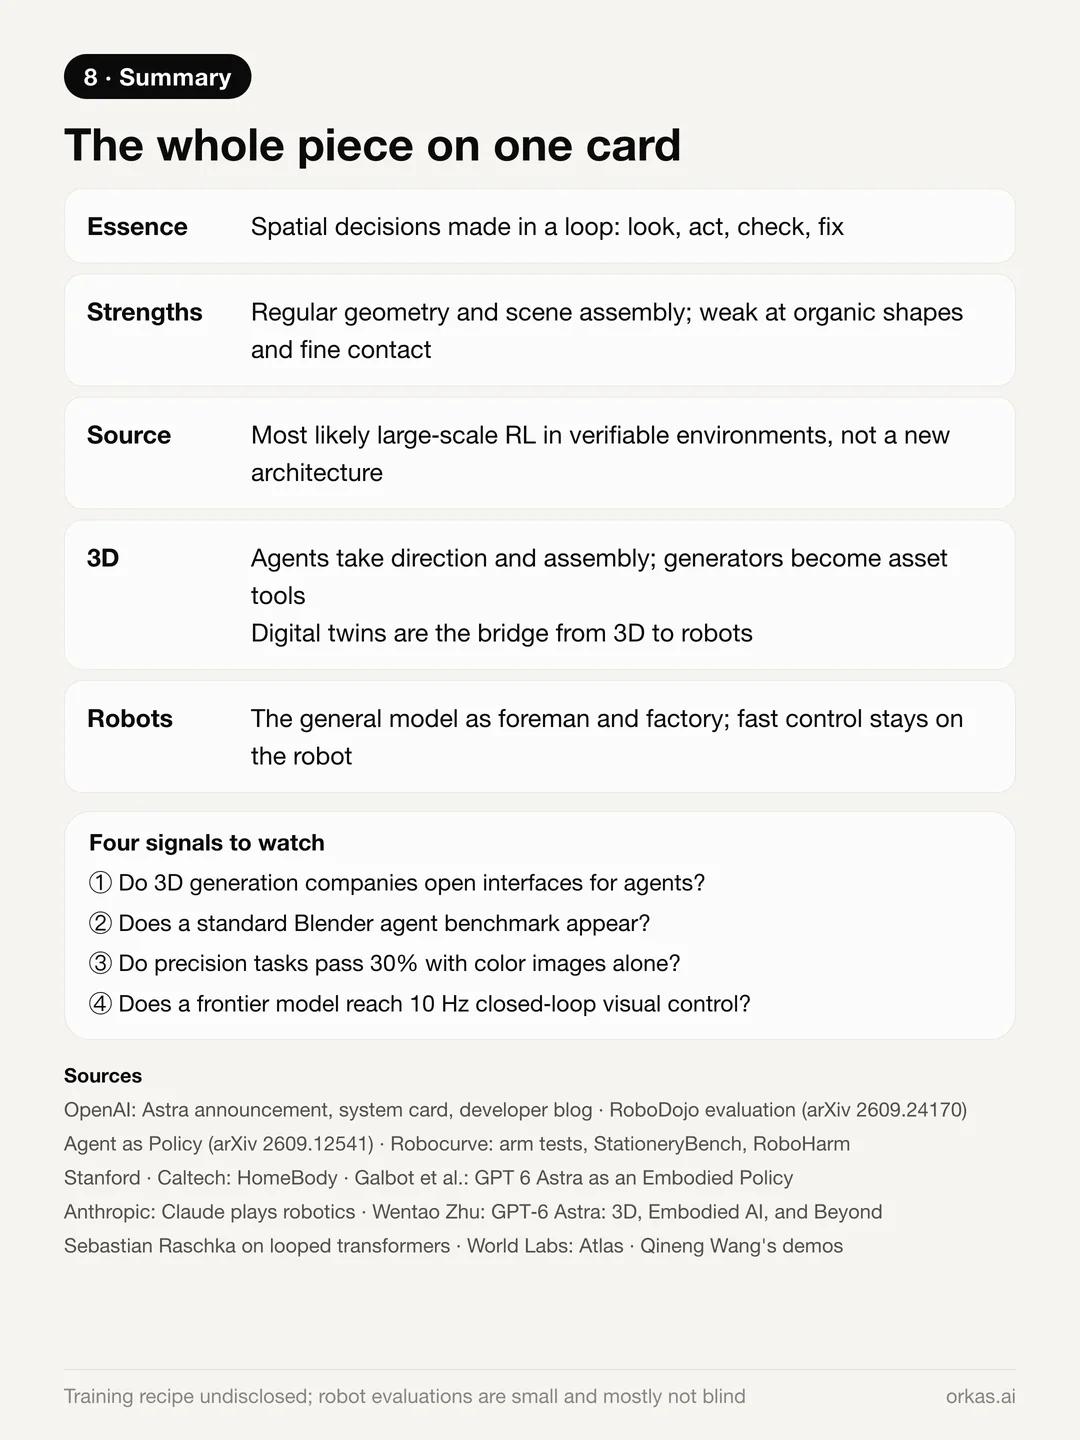
- إحساس Astra بالمكان هو اتخاذ قرارات داخل حلقة: انظر، واكتب شيفرة أو حدّد هدفًا، ونفّذ، وتحقق، وأصلح.
- إنه قوي في الهندسة المنتظمة وتجميع المشاهد والأحكام التي تمزج المعنى بالمكان، وضعيف في الأشكال العضوية والتلامس الدقيق، والسبب هو ما يستطيع برنامج قصير أن يصفه.
- الأرجح أن المهارة تأتي من تعلّم معزّز واسع النطاق في بيئات تقيّم النتائج تلقائيًا، لا من معمارية جديدة. ولم يُكشف عن وصفة التدريب.
- في توليد المحتوى ثلاثي الأبعاد، يتولى الوكلاء الإخراج والتجميع، وتصبح المولّدات أدوات لإنتاج الأصول، والتوائم الرقمية هي الجسر إلى الروبوتات.
- وفي أدمغة الروبوتات، يصبح النموذج العام رئيس العمال والمصنع معًا، بينما يبقى التحكم السريع لدى نماذج متخصصة تعمل على الجهاز.
إشارات تستحق المتابعة: هل ستفتح شركات توليد المحتوى ثلاثي الأبعاد واجهات للوكلاء؟ وهل سيظهر اختبار معياري موحّد لوكلاء Blender؟ وهل ستتجاوز مهام الدقة 30% بالصور الملونة وحدها؟ وهل سيبلغ نموذج رائد تحكمًا بصريًا مغلق الحلقة بتردد 10 هرتز؟
تنبيه: معظم تقييمات الروبوتات المذكورة أعلاه تستخدم عينات صغيرة، من 5 إلى 20 تجربة لكل إعداد، وأغلبها ليس معمّى. تعامل مع هذه الاستنتاجات بوصفها قراءة أولية، لا حكمًا نهائيًا.
المصادر: إعلان OpenAI عن GPT-6 Astra وبطاقة النظام؛ وتقرير Fortune عن الإطلاق؛ ومقالة Wentao Zhu بعنوان GPT-6 Astra: 3D, Embodied AI, and Beyond؛ ومقالة Sebastian Raschka عن المحوّلات الحلقية، التي تقتبس كلام Pachocki. أما المصادر الأخرى فروابطها في مواضع الاستشهاد بها.