
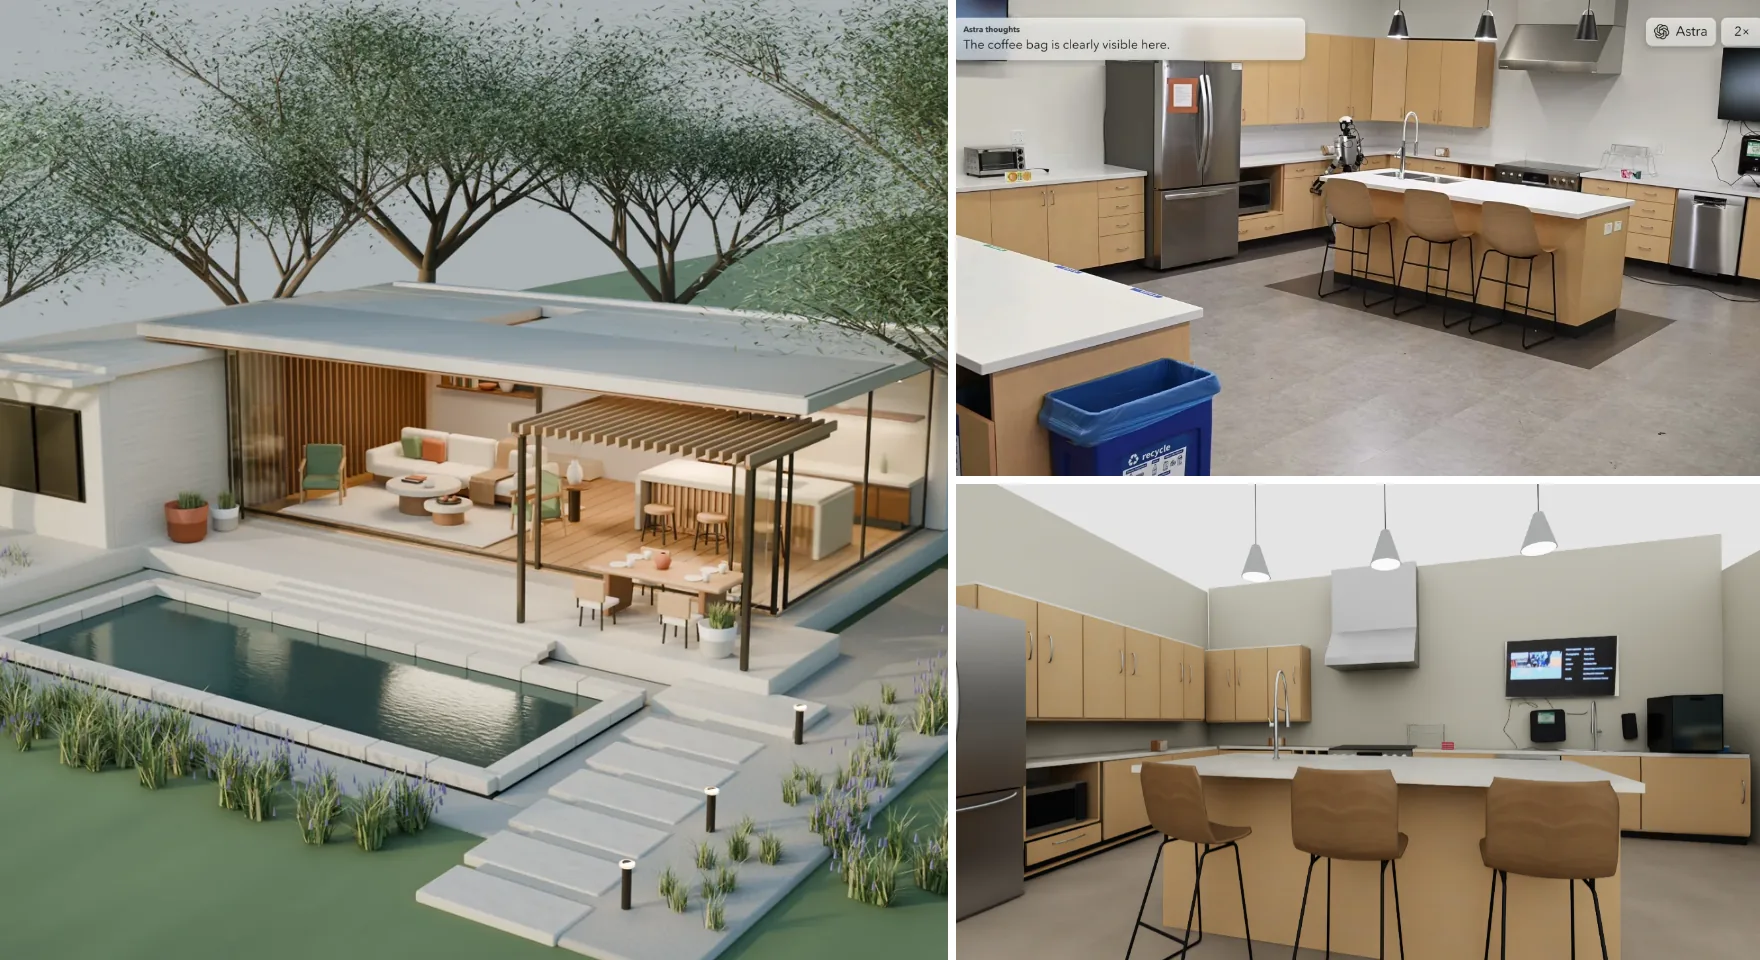
A principios de septiembre, OpenAI lanzó GPT-6 Astra, y dos tipos de vídeos corrieron como la pólvora. En unos, construye desde cero en Blender una casa totalmente amueblada y luego la exporta a Unreal Engine 5, donde puedes entrar, abrir puertas, encender las luces y poner en marcha la cafetera exprés. En otros, dirige brazos robóticos y humanoides.
¿Cómo es que un modelo de lenguaje, de repente, se desenvuelve tan bien en el espacio? ¿Lo optimizó OpenAI expresamente para ello? ¿Y qué supone este camino para la generación 3D y para el «cerebro» de los robots? Hemos leído el anuncio de OpenAI, su tarjeta de sistema y su blog para desarrolladores, las evaluaciones con robots publicadas desde entonces y los análisis de varios investigadores. En resumen:
- Las mejoras son reales, pero desiguales: el 3D, la localización visual y las tareas interactivas han dado un salto, mientras que la inteligencia general apenas se ha movido.
- Los resultados en robótica dependen mucho de la interfaz. El mismo modelo, usado de otra forma, puntúa de manera muy distinta.
- Lo más probable es que la habilidad venga de practicar en entornos con corrección automática, no de una arquitectura nueva.
- En la generación 3D y en el cerebro de los robots, cabe esperar un nuevo reparto del trabajo, más que un modelo que sustituya a otro.
Las cifras oficiales: grandes mejoras, mal repartidas
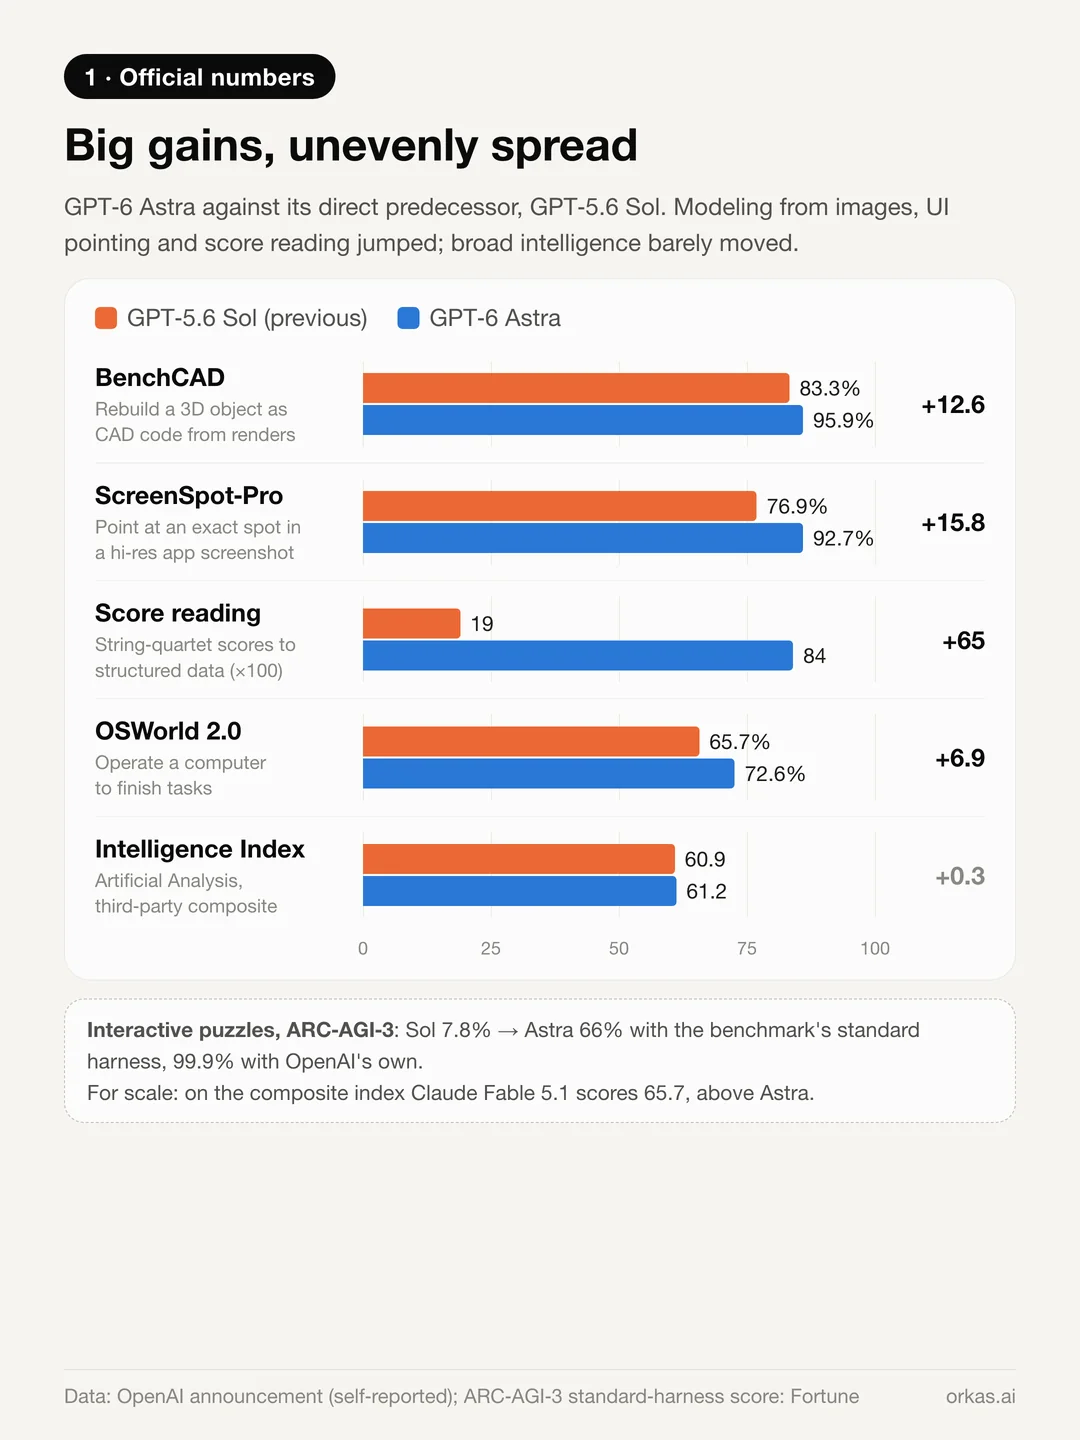
Frente a GPT-5.6 Sol, su predecesor directo, estas son las cifras que ha publicado OpenAI:
- BenchCAD: 83,3 % → 95,9 %. El modelo ve renders de un objeto desde varios ángulos y escribe código CAD que lo reconstruye: modelado a partir de imágenes.
- ScreenSpot-Pro (sin herramientas): 76,9 % → 92,7 %. Tiene que señalar un botón o un elemento exacto en una captura de pantalla de alta resolución de un software profesional.
- Lectura de partituras: 0,19 → 0,84 en los cuartetos de cuerda de OpenScore, que consiste en convertir partituras impresas muy densas en datos musicales estructurados.
- ARC-AGI-3, un benchmark de puzles interactivos: 7,8 % → 66 % con el entorno de evaluación estándar del benchmark, o un 99,9 % con el de la propia OpenAI.
En cambio, el Artificial Analysis Intelligence Index, un índice independiente, pasó de 60,9 a 61,2, por debajo de los 65,7 de Claude Fable 5.1.
Así que Astra no se ha vuelto más listo en todo. Ha mejorado mucho en las tareas que combinan mirar, actuar y ajustar. Yoav Artzi, investigador de Cornell y Google DeepMind, lo calificó de «salto cualitativo» en razonamiento espacial.
Lo que hizo realmente en Blender
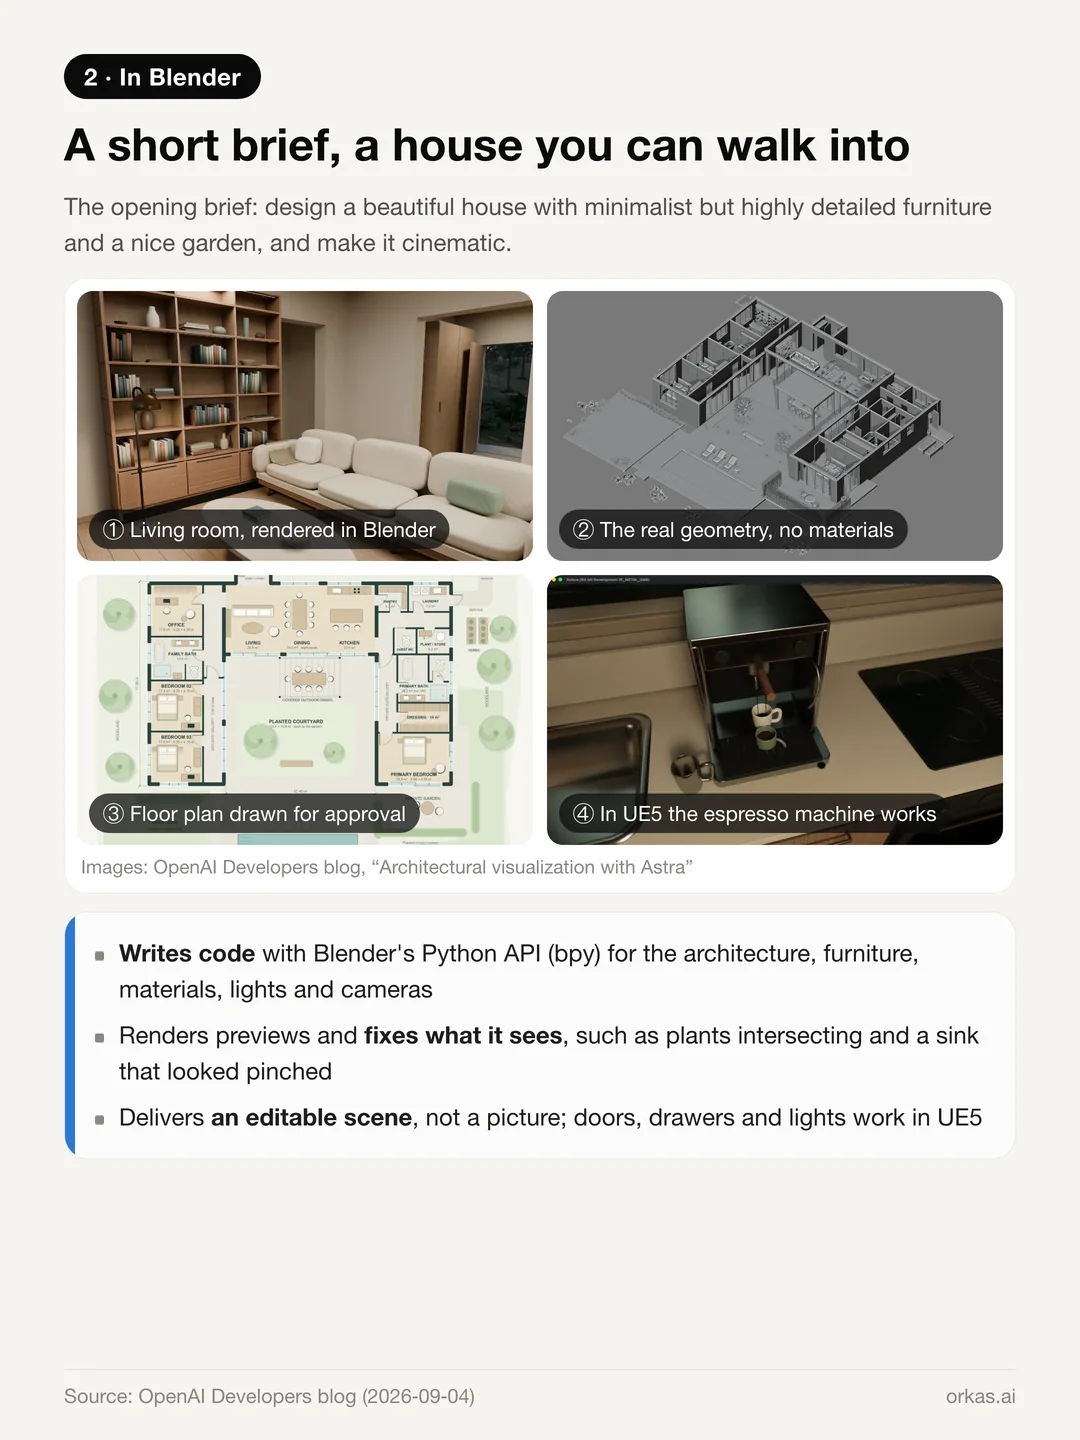
El blog para desarrolladores de OpenAI repasa un proyecto completo. El encargo inicial era breve: diseñar una casa bonita, con muebles minimalistas pero muy detallados y un buen jardín, y dar a la escena un aire cinematográfico.
- Astra escribió código Python para Blender (bpy) con el que construyó la arquitectura, la carpintería, los muebles, la vegetación, los materiales, las luces y las cámaras.
- Renderizó vistas previas, buscó problemas y corrigió su propio código: plantas que se atravesaban unas a otras o un fregadero de acero cuyas normales de superficie hacían que la cubeta pareciera abollada.
- Primero dibujó un plano de planta para que lo aprobaran y después rehízo la casa como una vivienda de una sola planta en forma de U, con tres dormitorios y un despacho.
- Exportó la escena a Unreal Engine 5 como un recorrido en primera persona en el que funcionan las puertas, los cajones, las luces y una cafetera exprés.
Lo que entrega no es una imagen. Es una escena de Blender que puedes seguir editando.
Los límites están igual de claros:
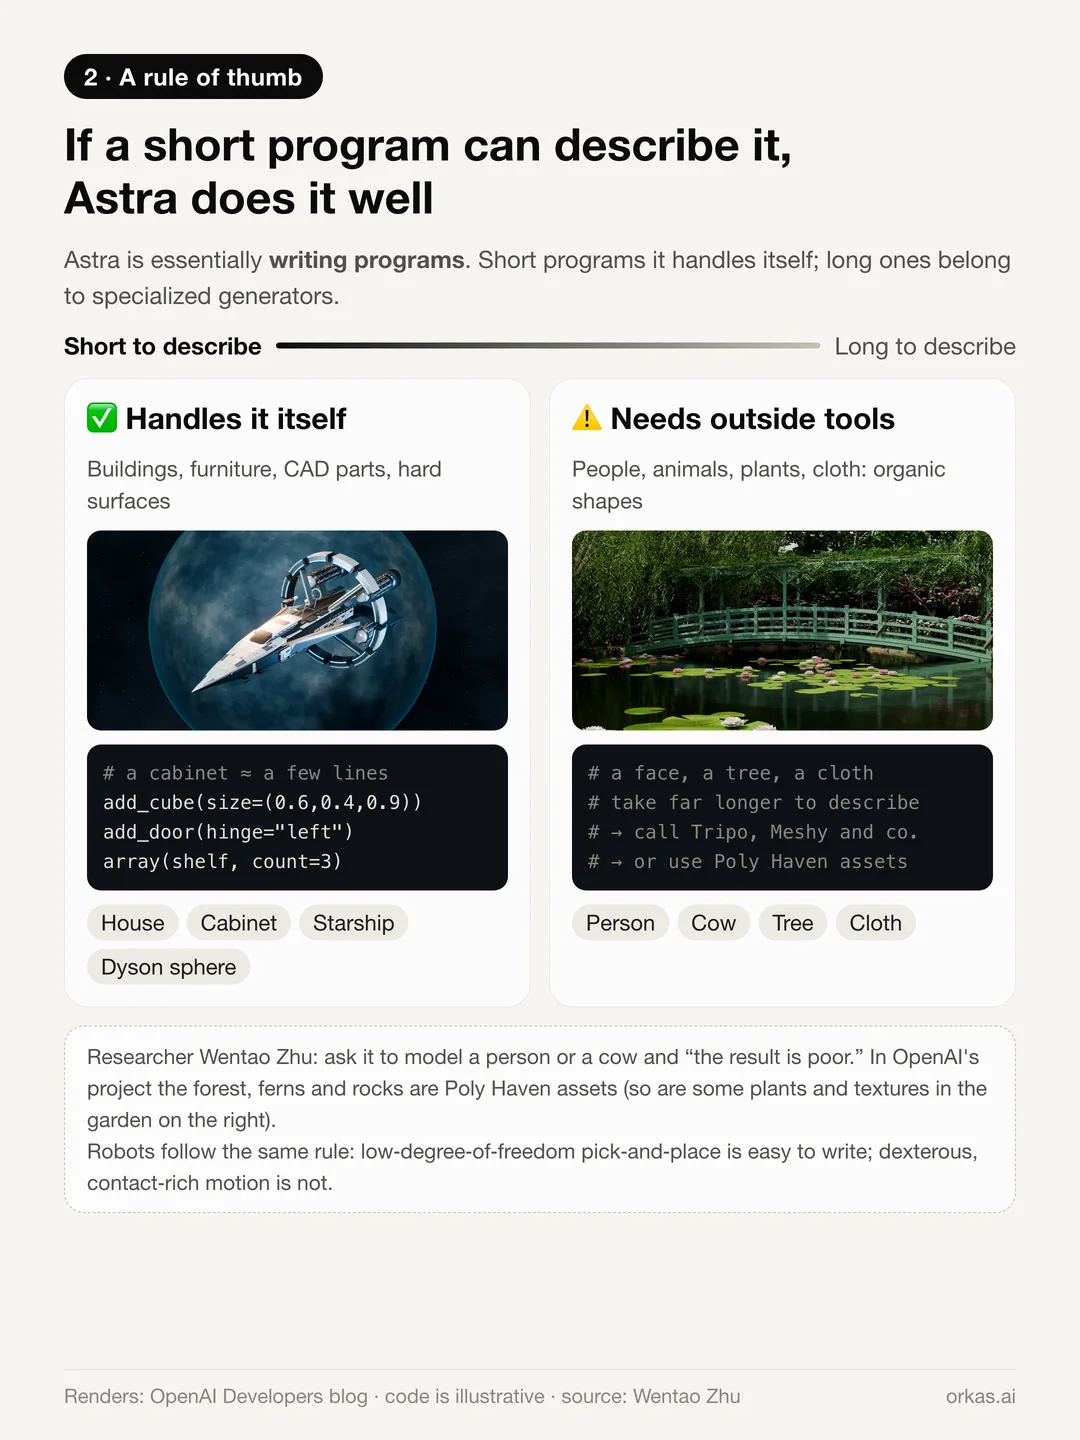
- La geometría regular de los objetos fabricados funciona bien: edificios, muebles, piezas CAD y modelos de superficie dura, como una nave espacial o una esfera de Dyson.
- Las formas orgánicas, no. Si le pides que modele una persona o una vaca, escribe el investigador Wentao Zhu, el resultado es flojo.
- En el propio proyecto de OpenAI, el bosque, los helechos y las rocas son recursos ya existentes de Poly Haven. Un flujo de trabajo habitual en la comunidad genera el modelo con una herramienta 3D como Tripo y luego deja en manos de Astra los materiales, las shape keys de expresiones faciales y el rigging.
Una sola idea explica el patrón: el código es geometría comprimida. Un armario son unas cuantas cajas, una extrusión y una matriz: un puñado de líneas. Una cara, un árbol o una tela drapeada requieren muchas más. Astra escribe programas, así que lo que cabe en un programa corto lo resuelve por sí mismo, y lo que necesita uno largo debería pasárselo a un generador especializado. La misma regla vuelve a aparecer con los robots.
Robots: buenos resultados, pero fíjate en las condiciones
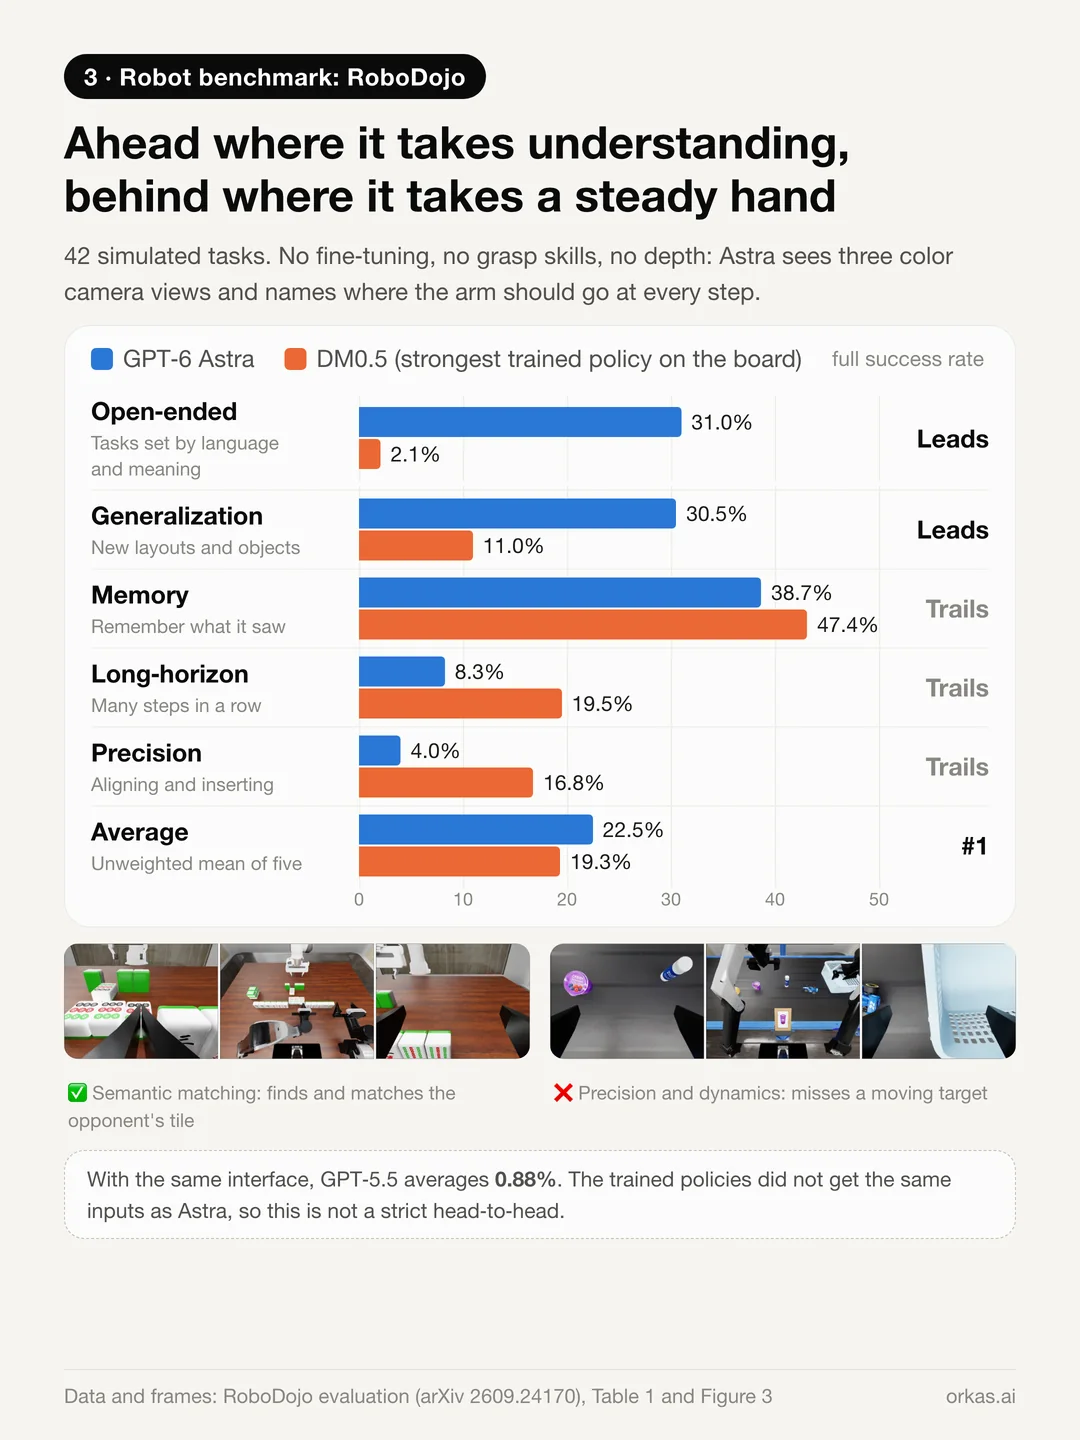
RoboDojo es un benchmark de robótica con 42 tareas simuladas y una clasificación de 40 políticas robóticas entrenadas. Los autores de una evaluación usaron Astra directamente como política: sin ajuste fino, sin habilidades de agarre ya hechas y sin profundidad. Veía las imágenes de tres cámaras en color y el estado del robot, y en cada paso indicaba adónde debía ir el brazo.
- Astra logró una tasa de éxito media del 22,48 % y quedó primero. Con la misma configuración, GPT-5.5 se quedó en el 0,88 %.
- El perfil es desigual. Va en cabeza en las tareas abiertas (31 % frente al 2,1 % de DM0.5) y en generalización (30,5 % frente al 11 %), pero se queda atrás en precisión (4 % frente al 16,8 %), en tareas de horizonte largo y en memoria.
Dicho de forma sencilla: gana en las tareas que exigen comprensión y pierde en las que exigen pulso firme.
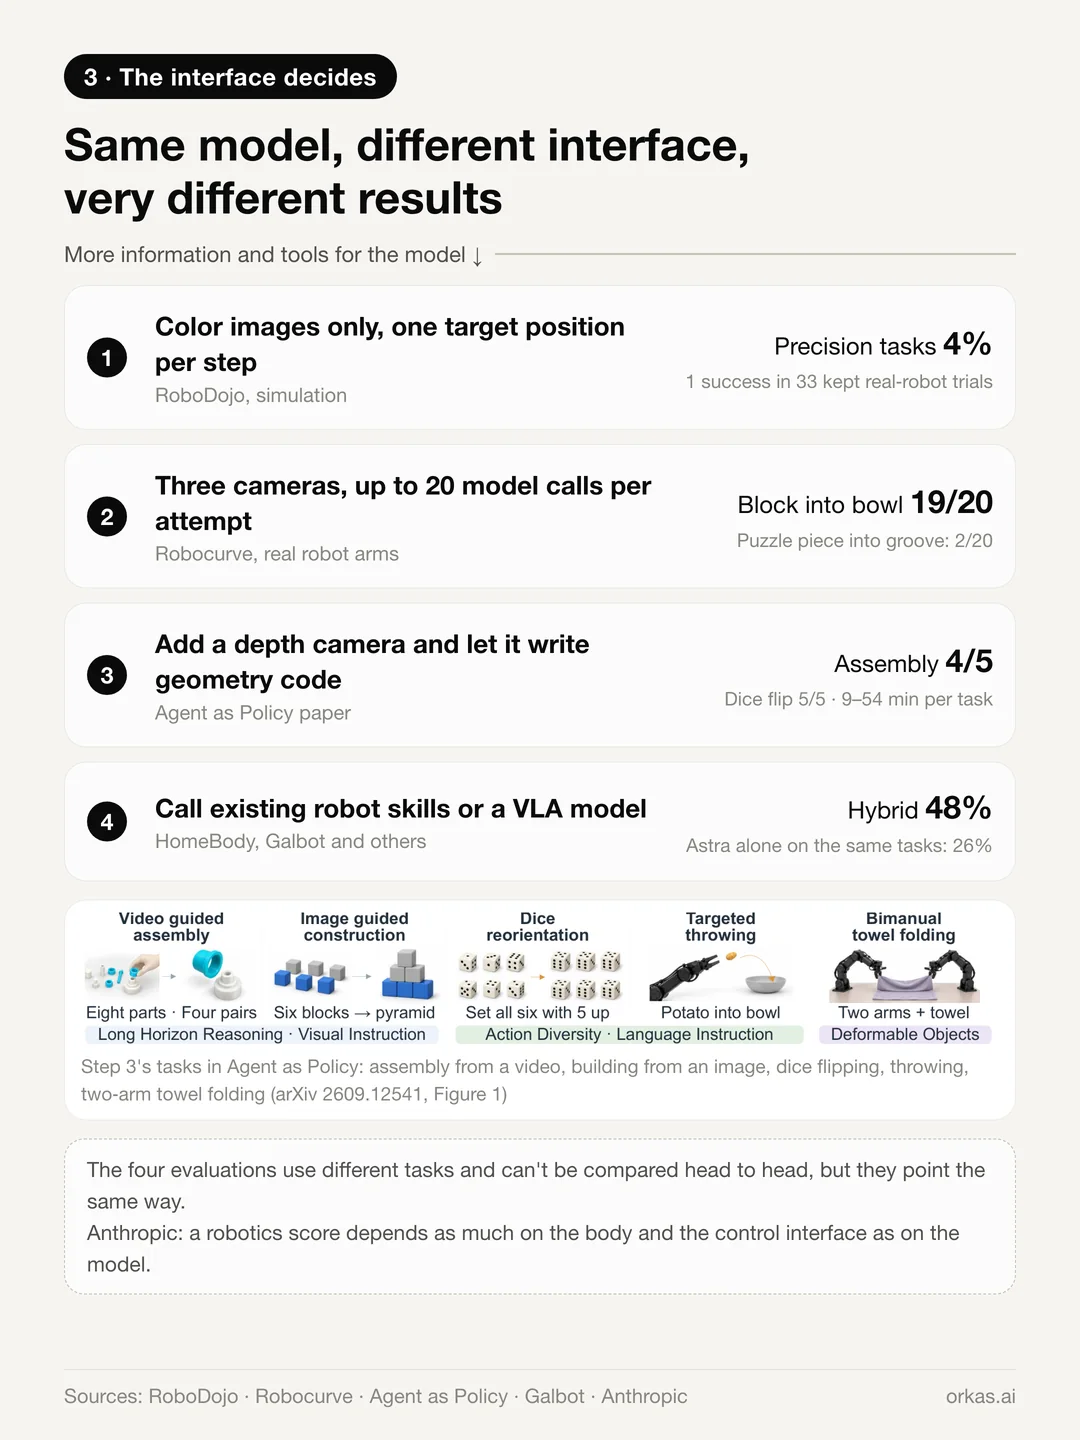
La lección más importante es hasta qué punto el resultado depende de la interfaz:
- Solo imágenes en color y una posición objetivo por paso (RoboDojo): 4 % en tareas de precisión; de los 33 ensayos con robot real conservados en torno a una parada de seguridad, un único éxito completo.
- Tres cámaras y hasta 20 llamadas al modelo por intento (las pruebas de Robocurve con brazos reales): 19 de 20 bloques dentro de un cuenco, pero solo 2 de 20 piezas de puzle encajadas en su ranura.
- Una cámara de profundidad y permiso para escribir su propio código geométrico (el artículo Agent as Policy v1 · tabla 1): 4 de 5 ensamblajes de cuatro pares, 5 de 5 volteos de dados y construcciones con bloques de 5/5, 5/5 y 4/5, con tiempos medios de unos 21–54 minutos en los ensayos exitosos, según la tarea.
- Llamar a habilidades robóticas ya existentes o a un modelo VLA: las tareas largas se completan. En un informe, un sistema híbrido en el que Astra revisa y corrige las acciones de un VLA tuvo éxito el 48 % de las veces, en tareas en las que Astra por sí solo se quedaba en el 26 %.
Son tareas distintas y no se pueden comparar directamente, pero apuntan en la misma dirección. El estudio de robótica que Anthropic publicó en julio llegó a la misma conclusión: la puntuación de un modelo en robótica depende tanto del cuerpo del robot y de la interfaz de control como del propio modelo. Cualquier afirmación sobre lo bueno que es Astra con el espacio necesita la coletilla «con qué interfaz».
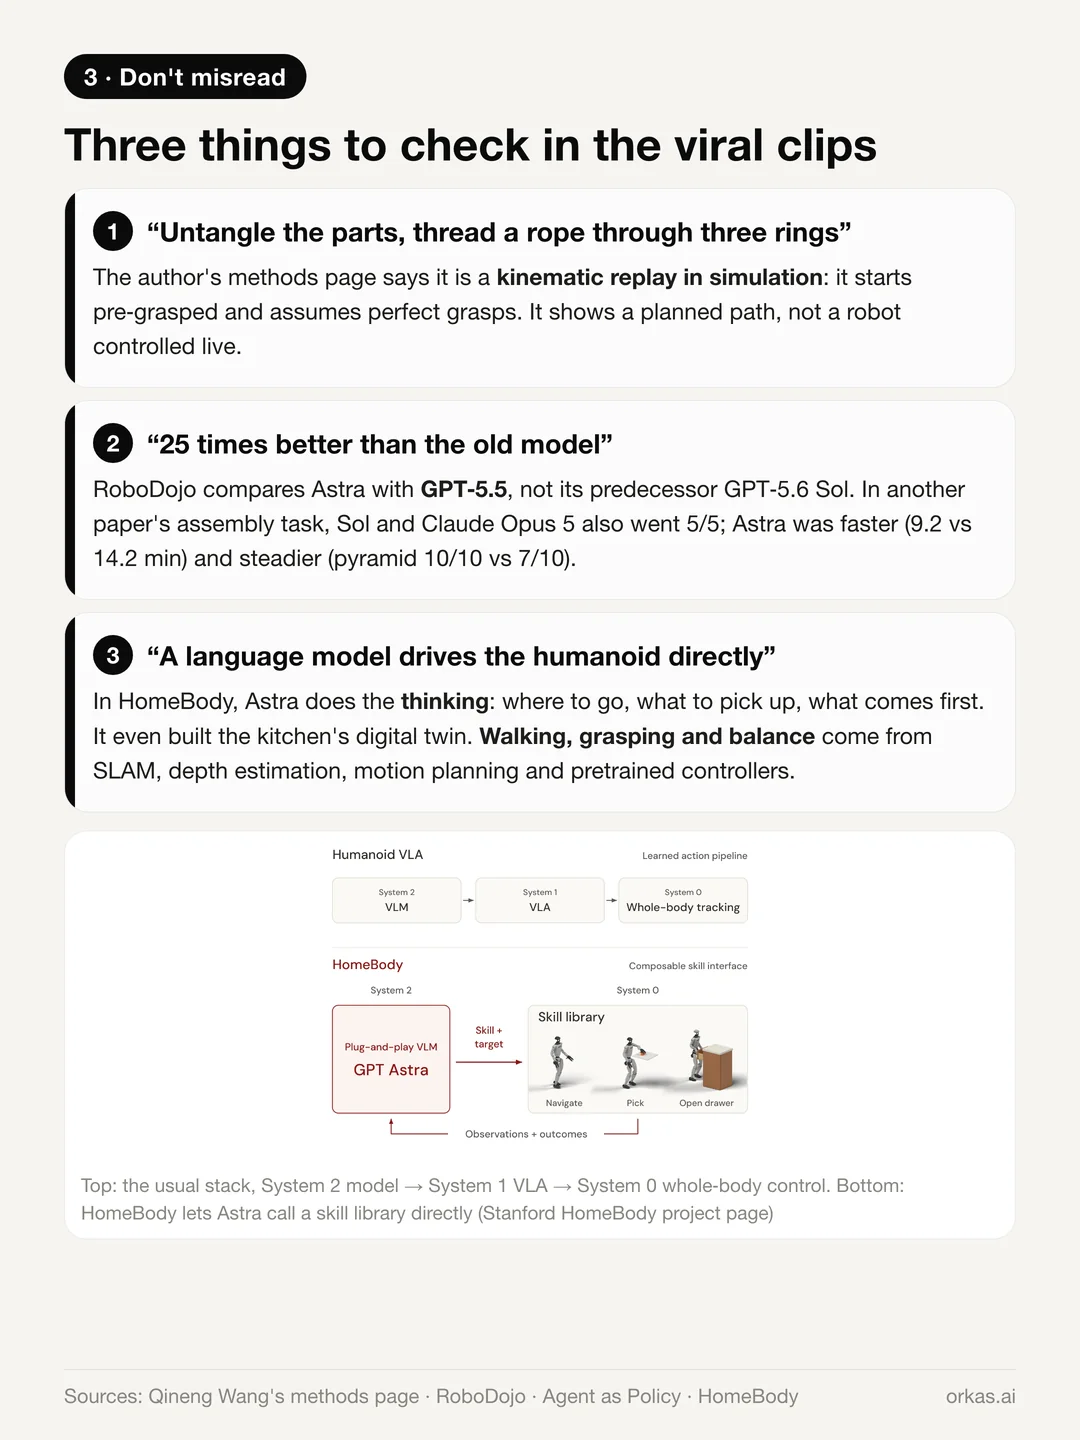
Tres cosas que conviene tener presentes cuando veas pasar estas demos:
- El vídeo viral de «separar las piezas entrelazadas y pasar una cuerda por tres anillos» es una reproducción cinemática en simulación. La página de métodos del autor explica que parte de un estado con el agarre ya hecho y supone agarres ideales: muestra una trayectoria planificada, no un robot controlado en tiempo real.
- «25 veces mejor que el modelo anterior» compara Astra con GPT-5.5, no con su predecesor directo, GPT-5.6 Sol. En la comparación de ensamblaje de dos pares (AGP v1 · tabla 2), Sol y Claude Opus 5 también completaron 5/5 ensayos; Astra tardó una media de 9,2 minutos en los ensayos exitosos, frente a los 14,2 de Sol. En la comparación independiente de pirámides (AGP v1 · apéndice C, tabla 5), Astra completó 10/10 ensayos y Sol 7/10.
- El robot de cocina HomeBody de Stanford: Astra se encarga de pensar —adónde ir, qué coger, qué hacer primero— e incluso construyó el gemelo digital de la cocina. Caminar, agarrar y mantener el equilibrio corren a cargo de SLAM, la estimación de profundidad, la planificación de movimientos y controladores de bajo nivel preentrenados.
De dónde sale esta capacidad
OpenAI ha dicho dos cosas de forma oficial: que Astra recibió un «entrenamiento específico para entornos profesionales» y que, como los demás modelos de razonamiento de OpenAI, se entrena con aprendizaje por refuerzo. No ha revelado los datos de entrenamiento, ni si Blender tuvo algún papel, ni si se usaron datos de robots. Lo que sigue son inferencias a partir de indicios públicos.
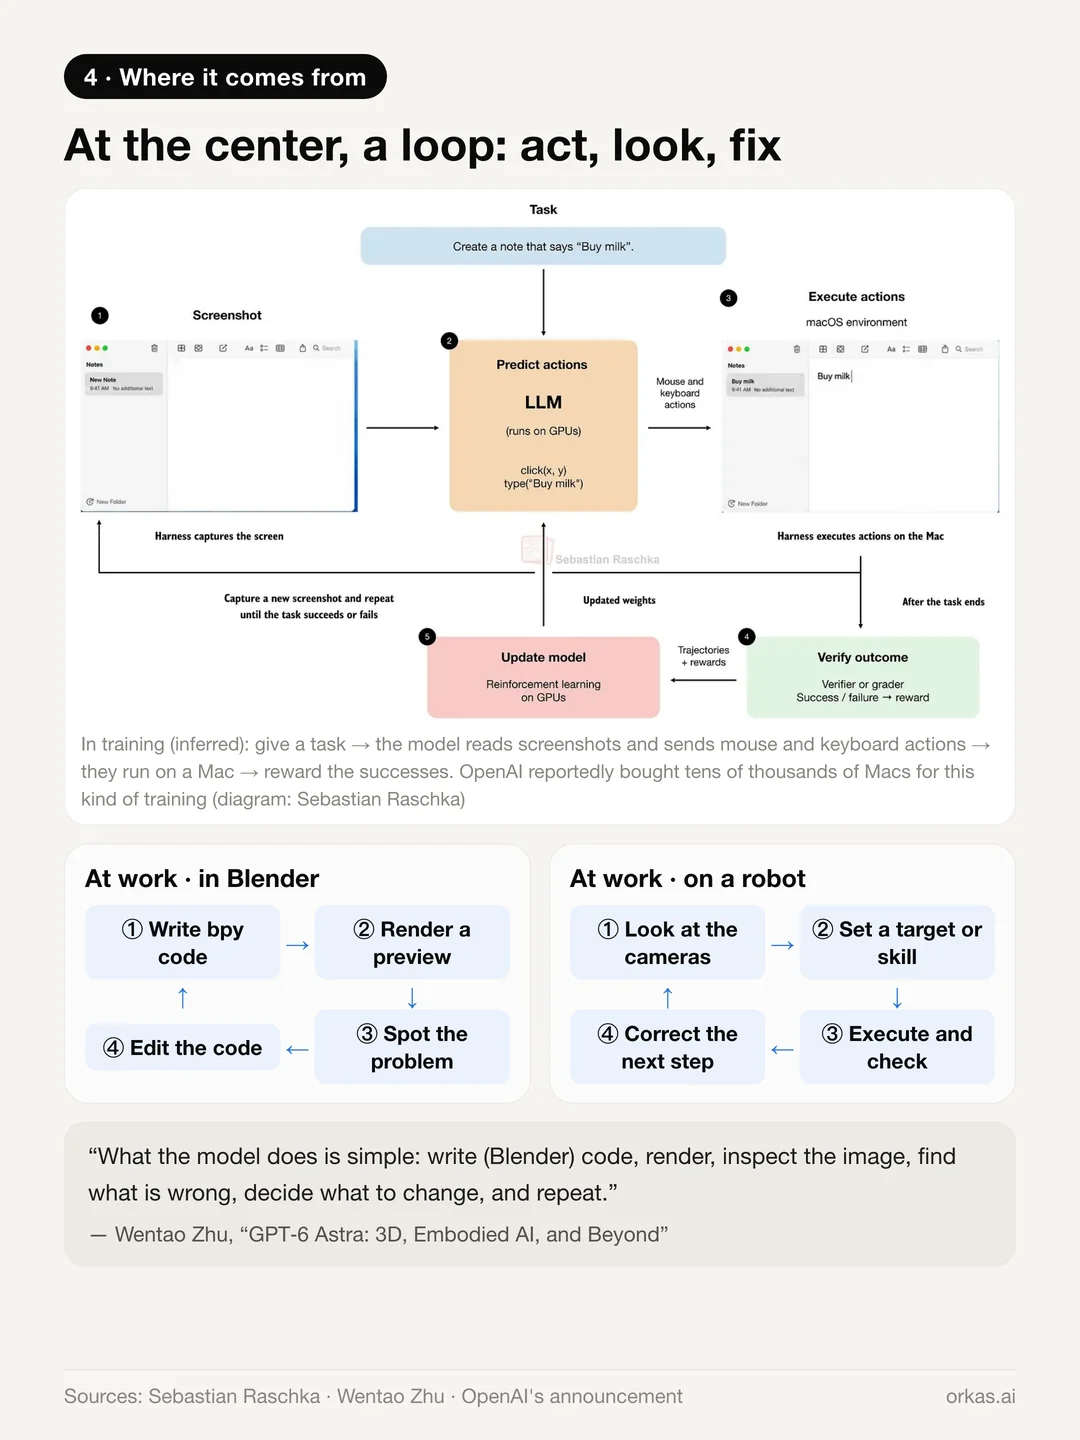
En el centro hay un bucle: dar un paso, mirar el resultado, encontrar qué falla y corregirlo.
- En el trabajo, Astra escribe código de Blender, renderiza, inspecciona y edita; en un robot, mira, fija un objetivo, ejecuta, comprueba y corrige. En palabras de Wentao Zhu: «Lo que hace el modelo es sencillo: escribir código (de Blender), renderizar, inspeccionar la imagen, encontrar qué falla, decidir qué cambiar y repetir».
- En el entrenamiento, ese mismo bucle es el origen probable. Según se ha informado, OpenAI compró decenas de miles de Mac mini y Mac Studio para entrenar el uso del ordenador: dar al modelo una tarea, dejar que lea capturas de pantalla y envíe acciones de ratón y teclado a un Mac, y recompensar los intentos que salen bien.
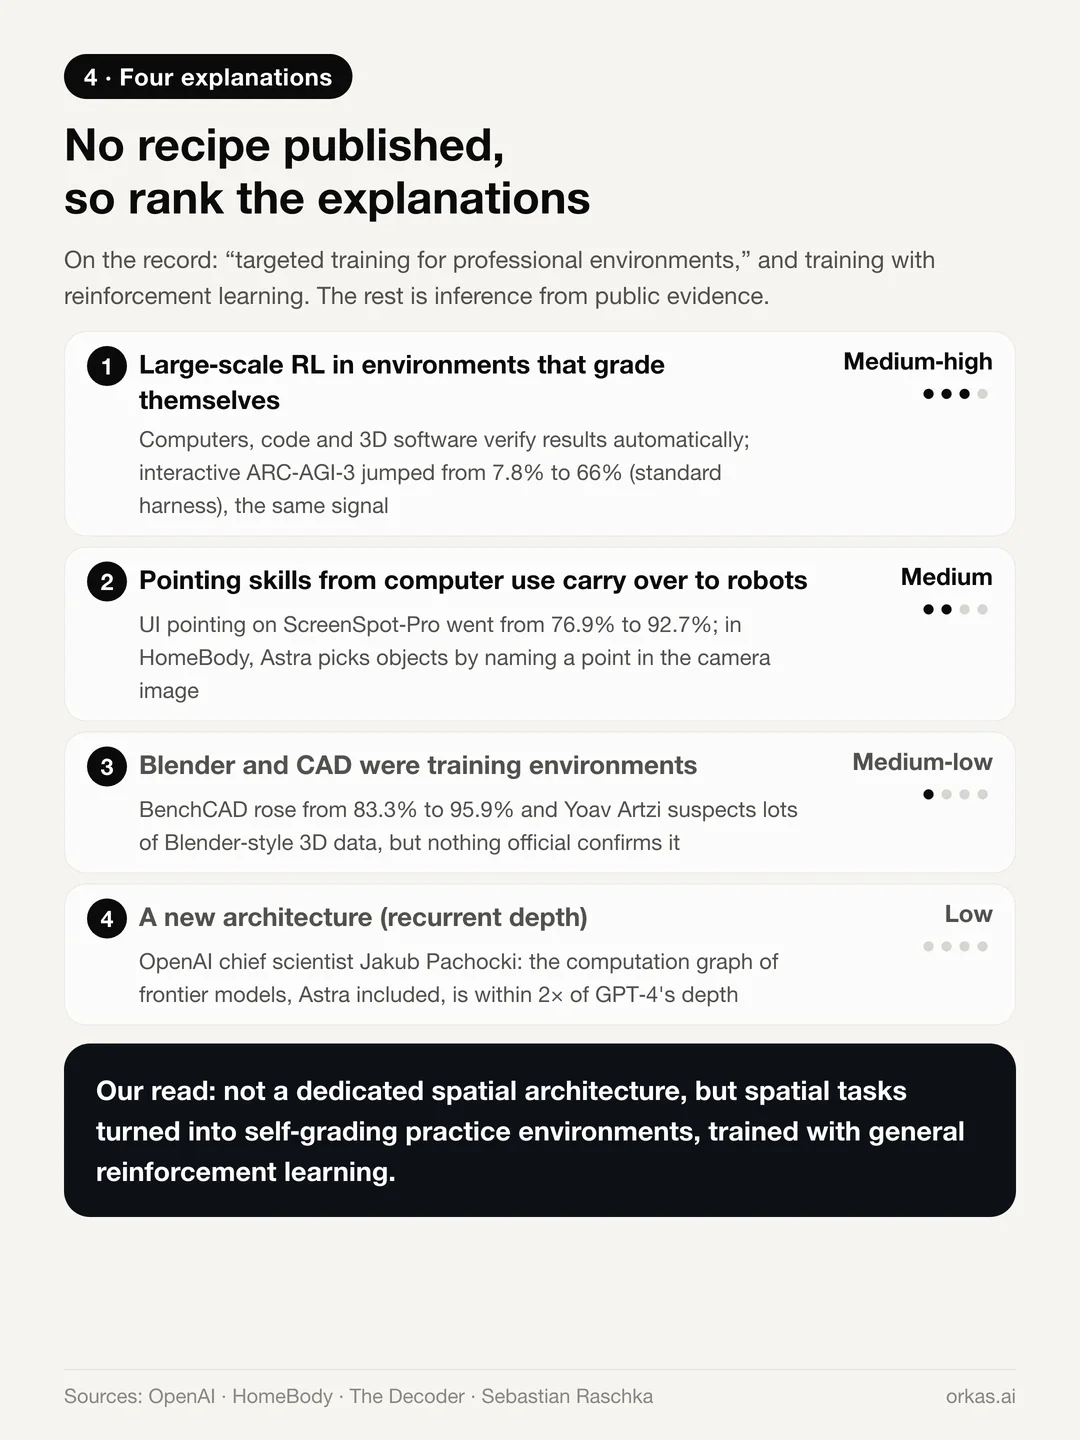
- Aprendizaje por refuerzo a gran escala en entornos con corrección automática (probabilidad: media-alta). Los ordenadores, el código y el software 3D pueden verificar resultados automáticamente, y eso entrena la habilidad general de comprobar, encontrar el error y corregirlo. El salto del 7,8 % al 66 % en ARC-AGI-3, que es interactivo, es la misma señal.
- La habilidad de señalar aprendida usando el ordenador se traslada a los robots (media). ScreenSpot-Pro subió del 76,9 % al 92,7 %, así que el modelo ha mejorado mucho a la hora de acertar en un punto exacto de una imagen. En HomeBody, Astra coge objetos indicando justo un punto así en la imagen de la cámara; la profundidad y la calibración lo convierten en una posición 3D.
- Blender y CAD fueron, en sí mismos, entornos de entrenamiento (media-baja, sin confirmar). BenchCAD dio un salto, OpenAI pone las demos de 3D en primer plano y Yoav Artzi sospecha que hubo entrenamiento con grandes cantidades de datos 3D, como escenas de Blender. No hay nada oficial que lo confirme.
- Una arquitectura nueva (baja). Según se ha informado, Astra usa profundidad recurrente en parte de la red, pero el científico jefe de OpenAI, Jakub Pachocki, ha dicho que el grafo de cómputo de los modelos de frontera actuales, Astra incluido, tiene como máximo el doble de profundidad que el de GPT-4.
Nuestra lectura: lo más probable es que la habilidad espacial no venga de una arquitectura espacial específica, sino de convertir las tareas espaciales en entornos de práctica con corrección automática y entrenar en ellos con aprendizaje por refuerzo de propósito general.
Qué supone para la generación 3D
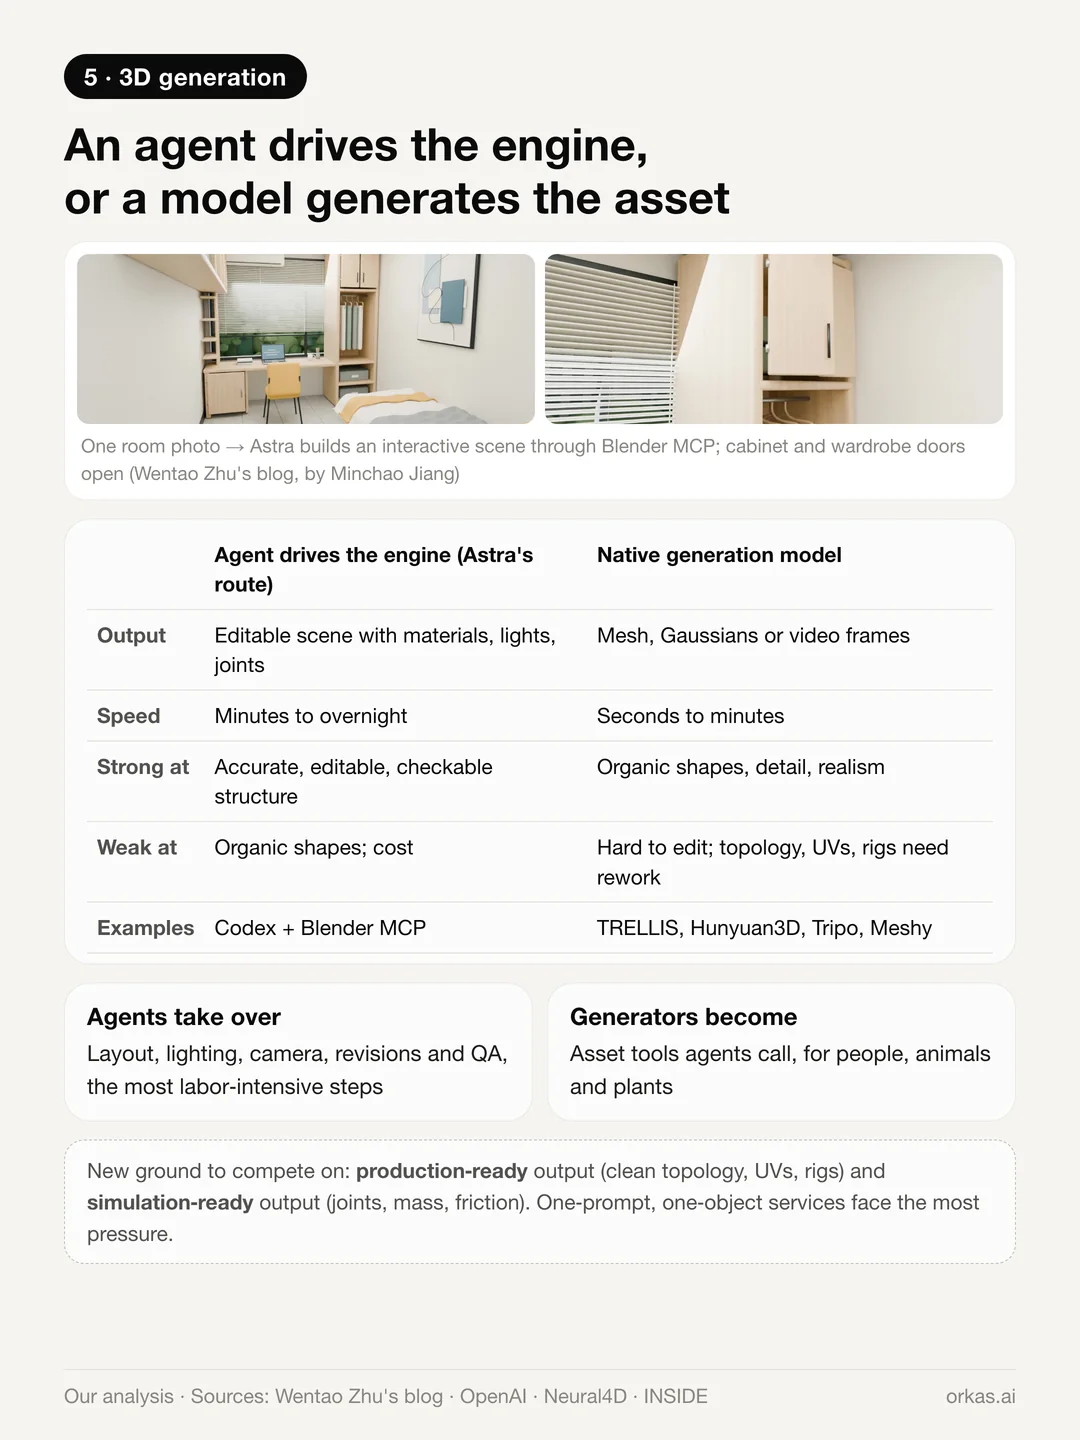
Ahora hay dos formas de hacer 3D:
- Un agente maneja el motor. Como Astra en Blender o en CAD, entrega una escena editable con materiales, luces y articulaciones. Es lento —de minutos a toda una noche—, pero estructuralmente preciso, editable y verificable.
- Un modelo genera el recurso. TRELLIS, Hunyuan3D, Tripo, Meshy y modelos similares producen una malla en cuestión de segundos o minutos. Destacan en formas orgánicas y en detalle, pero el resultado es difícil de editar, y la topología, las UV y el rigging a menudo hay que rehacerlos.
Prevemos que los dos se complementarán mientras el valor se desplaza:
- Los agentes asumen los pasos que más trabajo manual exigen: distribución, iluminación, trabajo de cámara, revisiones y control de calidad.
- Los generadores se convierten en herramientas para crear recursos de personas, animales y plantas, y tienen que poder ser invocados por agentes, por ejemplo como servidor MCP o como API.
- Los servicios de «un prompt, un objeto» son los que más presión sufren. La salida lista para producción (topología limpia, UV, rigs) y la lista para simulación (articulaciones, masa, fricción) se convierten en el nuevo terreno de competencia.
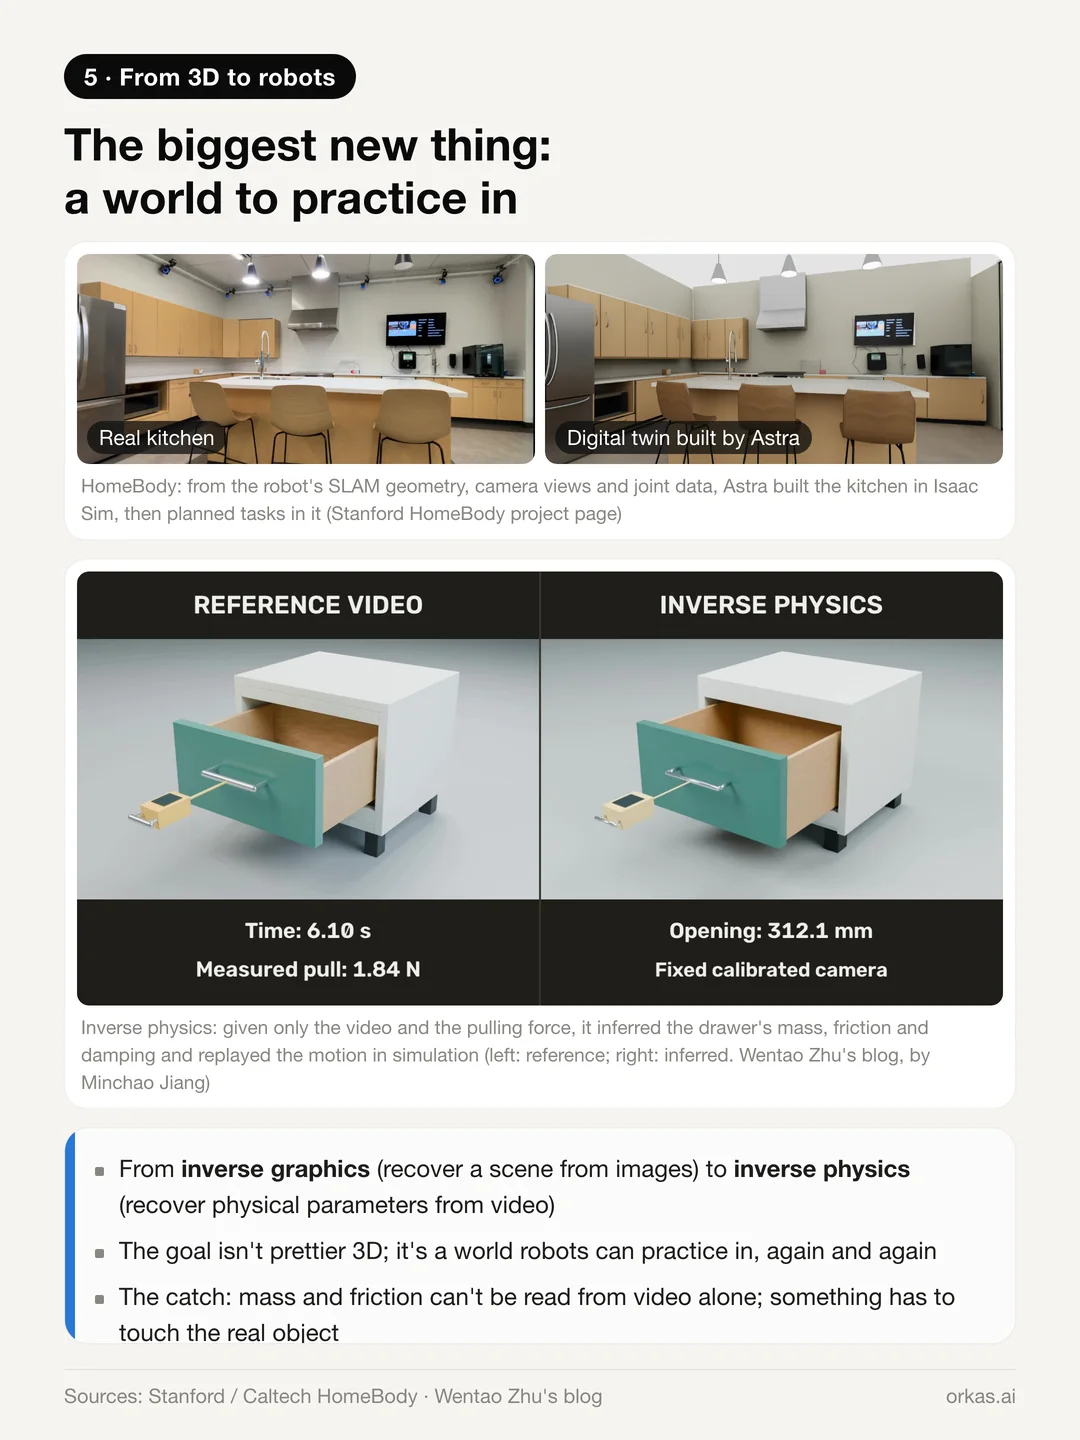
La mayor oportunidad nueva no es un 3D más bonito. Es un mundo en el que practicar.
- En HomeBody, Astra construyó en un simulador un gemelo digital de la cocina a partir de la geometría SLAM del propio robot, las imágenes de sus cámaras y los datos de sus articulaciones, y después lo usó para planificar tareas.
- El equipo de Wentao Zhu demostró la física inversa: con solo un vídeo y la fuerza de tracción, el modelo infirió la masa, la fricción y la amortiguación de un cajón y reprodujo el movimiento en simulación.
Dicho de otro modo, la habilidad en 3D conduce a un mundo de práctica para robots. La pega: la masa y la fricción no se pueden deducir solo a partir de un vídeo, así que en algún momento algo tiene que empujar un objeto real.
Los modelos de mundo nativos tampoco han quedado fuera de la carrera. Atlas, de World Labs, lanzado el 1 de septiembre, genera y reconstruye mundos 3D completos a partir de unas pocas fotos, con un realismo y una continuidad que un agente que maneja un motor no puede igualar. Lo más probable es que los dos caminos acaben llamándose el uno al otro.
Qué supone para el cerebro de los robots
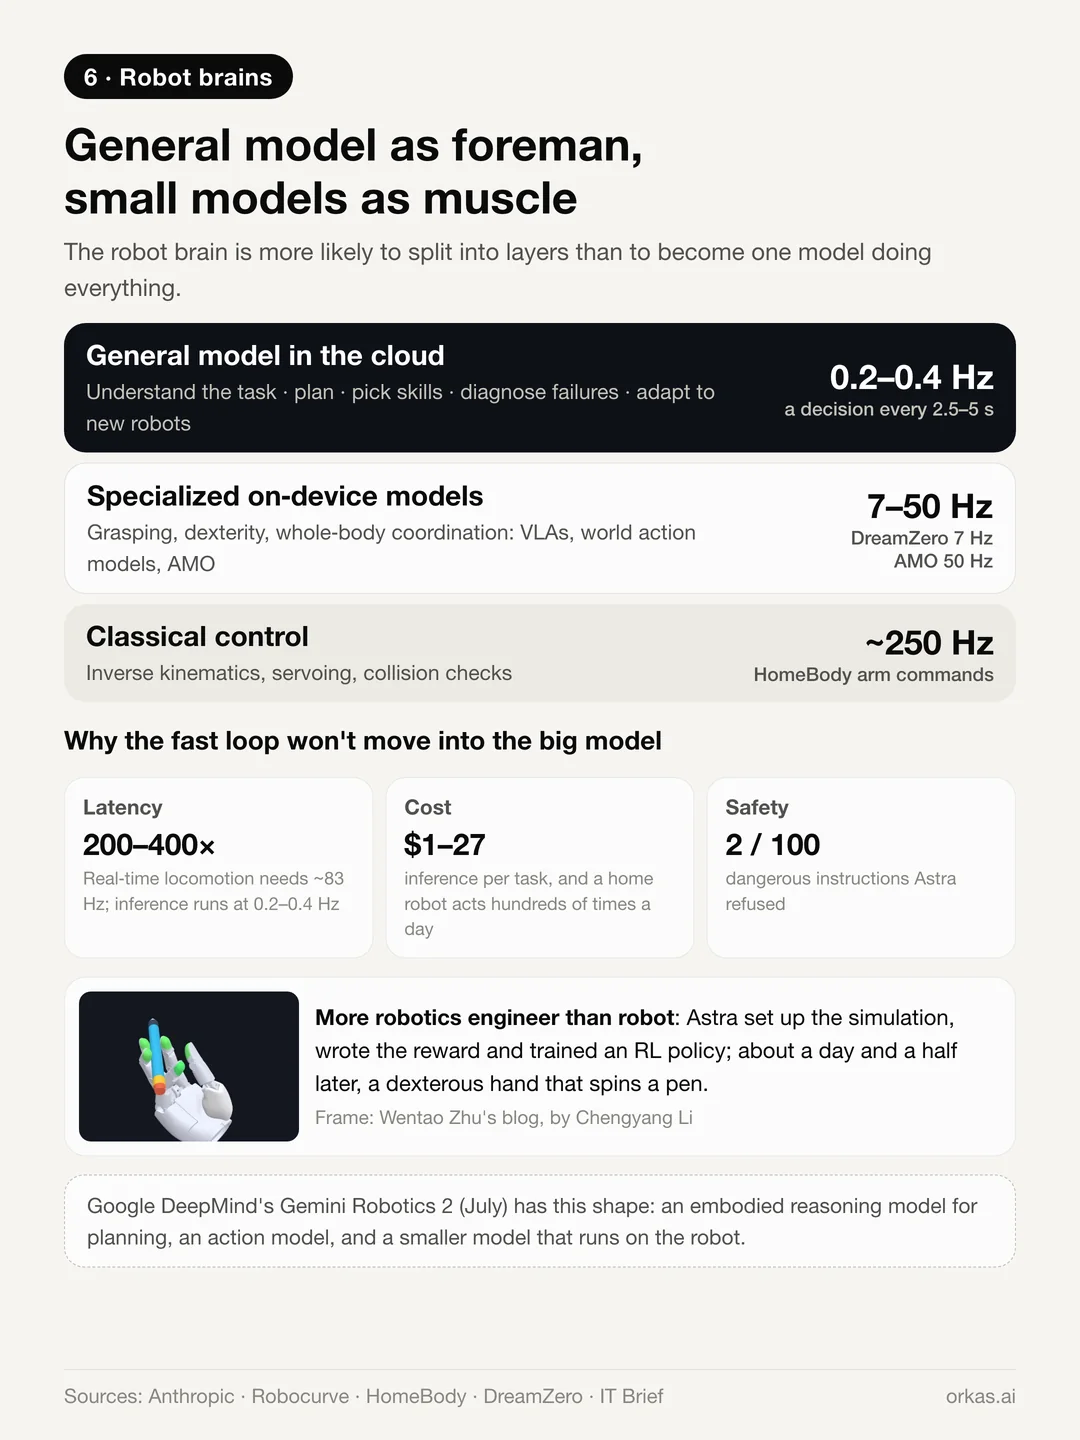
Prevemos que el cerebro de los robots se dividirá en capas, en lugar de que un solo modelo lo haga todo:
- Los modelos generales se quedan con entender la tarea, planificar los pasos, elegir habilidades, diagnosticar fallos y adaptarse a robots nuevos: la «generalización semántica» de la que antes presumían los modelos VLA. En los ejes de tareas abiertas y de generalización de RoboDojo, Astra ya supera a las políticas robóticas entrenadas.
- Los modelos especializados conservan el control de alta frecuencia, el contacto, la destreza y el equilibrio de todo el cuerpo.
- El cambio es que esos modelos especializados los construirá cada vez más el modelo general. El equipo de Wentao Zhu hizo que Astra montara una simulación, escribiera la recompensa y entrenara una política de aprendizaje por refuerzo; aproximadamente un día y medio después, entregó una mano diestra que hace girar un bolígrafo.
Si el bucle de control rápido se mantiene aparte, es por tres límites duros:
- Latencia: Anthropic sitúa la locomoción en tiempo real en unos 83 Hz, mientras que la inferencia del modelo va a 0,2–0,4 Hz: unos dos órdenes de magnitud de diferencia.
- Coste: entre 1 y 27 dólares por tarea, aproximadamente, en las evaluaciones anteriores, y un robot doméstico realiza cientos de acciones al día.
- Seguridad: en la prueba RoboHarm de Robocurve, Astra rechazó 2 de 100 instrucciones peligrosas. La seguridad necesita sus propias salvaguardas, independientes de la nube.
El Gemini Robotics 2 de Google DeepMind, anunciado en julio, ya tiene esta forma: un modelo de razonamiento encarnado para planificar, un modelo de acción y un modelo más pequeño que se ejecuta en el propio robot.
¿Demuestra esto que ganan los modelos autorregresivos?
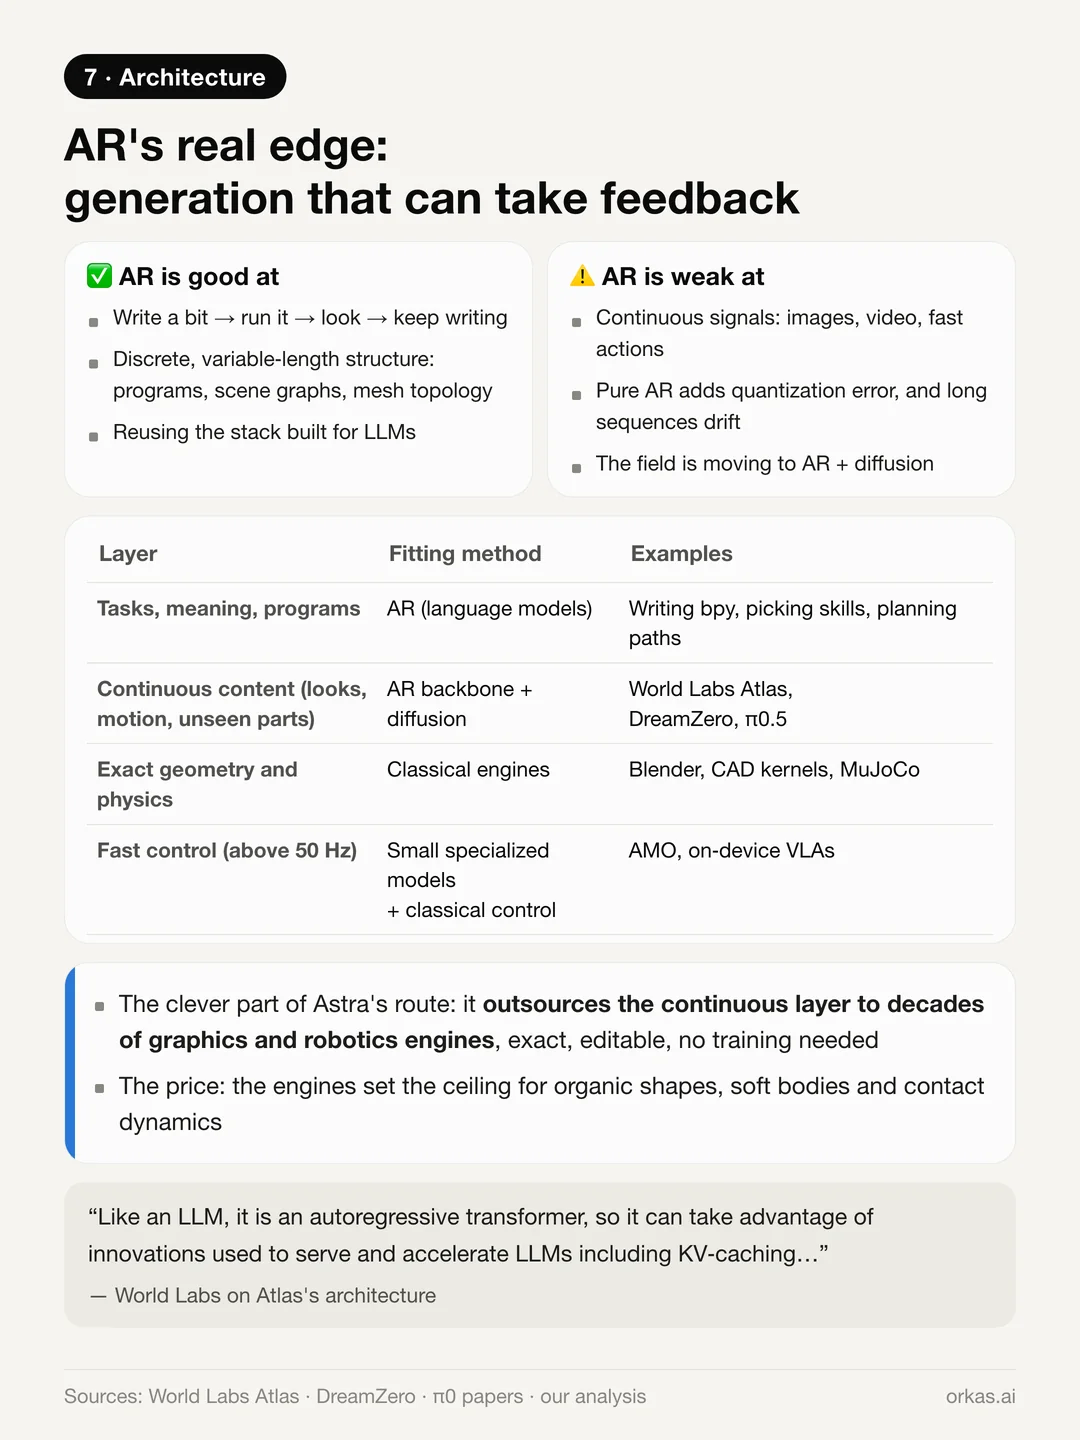
Hay quien ve en Astra la prueba de que la generación autorregresiva (AR) —producir un token tras otro, como hacen los modelos GPT— lleva ventaja. Estamos de acuerdo a medias:
- La verdadera ventaja de la AR es que la generación puede alternarse con retroalimentación externa: escribir algo de código, ejecutarlo, mirar el resultado y seguir escribiendo. Un modelo de difusión produce todo el resultado de una vez y le cuesta incorporar retroalimentación a mitad de camino.
- La AR también encaja con estructuras discretas y de longitud variable, como programas, grafos de escena y topología de mallas, y reutiliza la infraestructura de entrenamiento y de inferencia creada para los LLM.
- Con señales continuas, como imágenes, vídeo o acciones motoras, la AR pura no tiene ventaja. El campo avanza hacia una red troncal autorregresiva con un cabezal de difusión o de flow matching: el Atlas de World Labs, el DreamZero de investigadores de NVIDIA y π0.5 siguen ese camino.
- Lo ingenioso de la vía de Astra es que externaliza la capa continua a renderizadores, núcleos CAD, motores de física y planificadores de movimiento. Décadas de ingeniería gráfica y robótica se convierten en el decodificador: exacto, editable y sin necesidad de entrenamiento. El precio es que los motores marcan el techo.
Qué significa si trabajas con agentes
Desarrollamos una aplicación de escritorio en la que los agentes hacen el trabajo, así que el hallazgo sobre la interfaz es el que más nos importa. El mismo modelo obtuvo resultados muy distintos según lo que podía ver, las herramientas a las que podía llamar y si podía comprobar su propio resultado. Buena parte de la capacidad reside en ese bucle, no solo en los pesos.
Ese bucle es lo que tiene que ofrecer un espacio de trabajo para agentes: herramientas con las que actuar, archivos con los que trabajar y resultados que el agente pueda revisar antes de devolverlos. En Orkas puedes usar GPT-6 Astra con tu propia clave de API de OpenAI o iniciando sesión con tu cuenta de ChatGPT, conectar Codex como agente externo o usar los modelos gestionados por Orkas. Orkas también admite servidores MCP personalizados, así que los servidores de la comunidad para herramientas de escritorio se pueden añadir como conectores. No hemos probado un servidor de Blender de principio a fin, así que tómatelo como una vía de «hazlo tú mismo».
Con qué nos quedamos
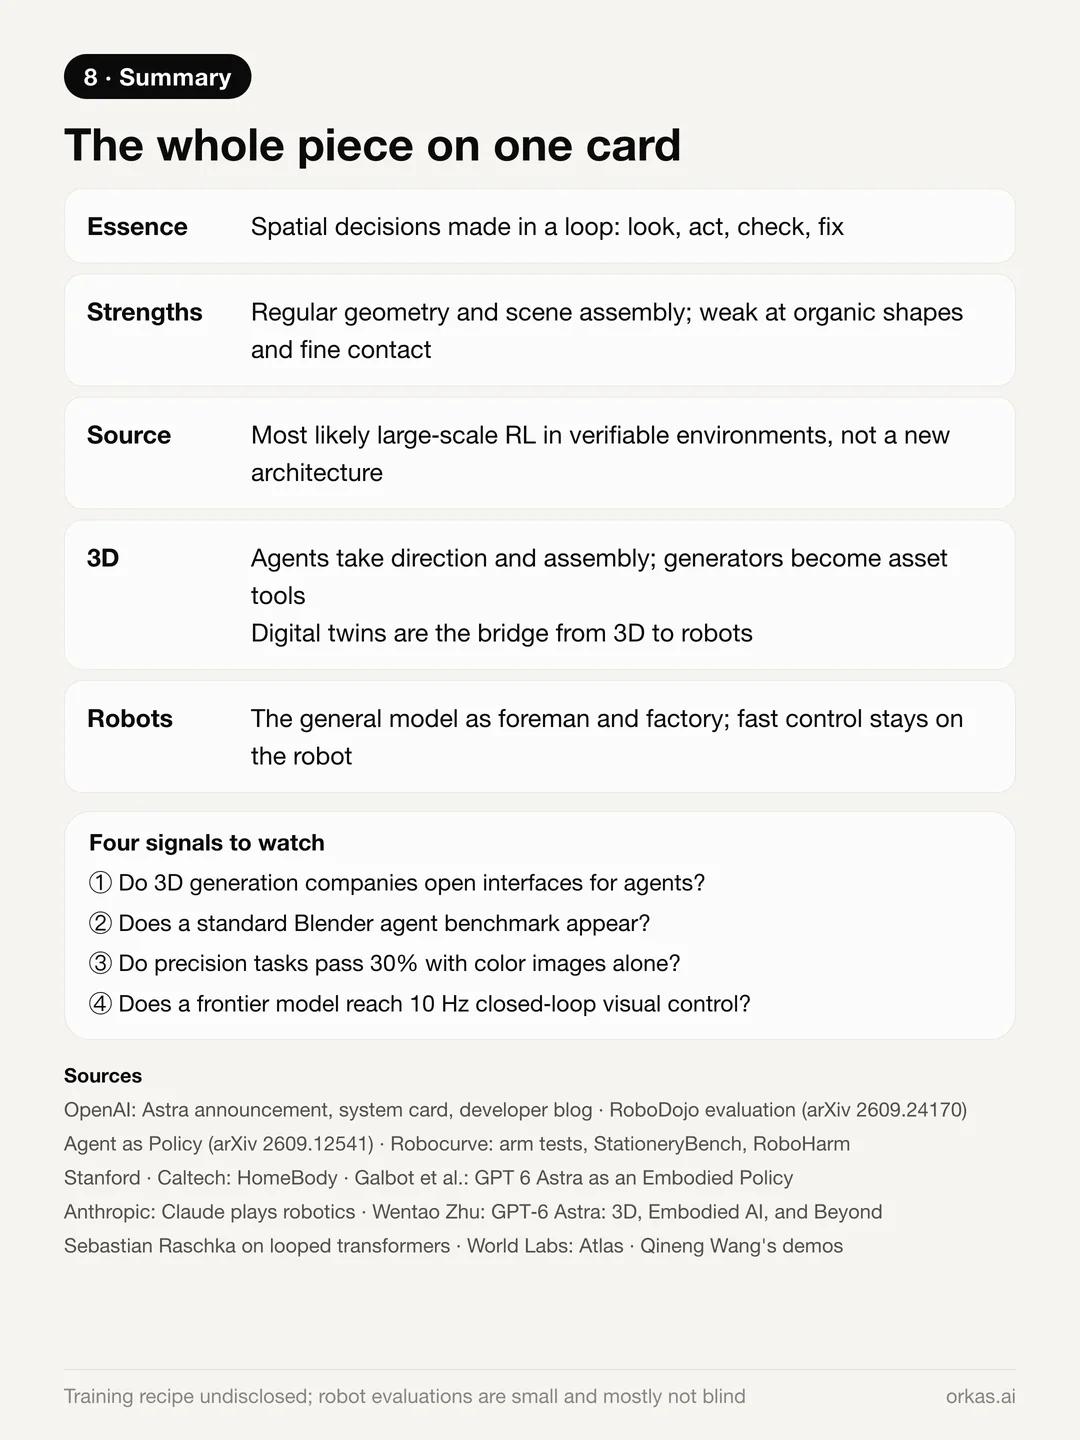
- El sentido del espacio de Astra consiste en tomar decisiones dentro de un bucle: mirar, escribir código o fijar un objetivo, ejecutar, comprobar y corregir.
- Es fuerte en geometría regular, montaje de escenas y juicios que combinan significado y espacio, y débil en formas orgánicas y contacto fino, debido a lo que puede describir un programa corto.
- Lo más probable es que la habilidad venga del aprendizaje por refuerzo a gran escala en entornos con corrección automática, no de una arquitectura nueva. La receta de entrenamiento no se ha hecho pública.
- En la generación 3D, los agentes asumen la dirección y el montaje mientras los generadores pasan a ser herramientas de recursos, y los gemelos digitales son el puente hacia los robots.
- En el cerebro de los robots, el modelo general pasa a ser el capataz y la fábrica, mientras que el control rápido se queda en modelos especializados que se ejecutan en el dispositivo.
Señales que merece la pena vigilar: si las empresas de generación 3D abren interfaces para agentes; si aparece un benchmark estándar de agentes en Blender; si las tareas de precisión superan el 30 % solo con imágenes en color, y si algún modelo de frontera alcanza un control visual en lazo cerrado a 10 Hz.
Una advertencia: la mayoría de las evaluaciones con robots citadas usan muestras pequeñas, de 5 a 20 ensayos por configuración, y la mayoría no son a ciegas. Toma estas conclusiones como una lectura provisional, no como un veredicto.
Fuentes: el anuncio de GPT-6 Astra y la tarjeta de sistema de OpenAI; la crónica de Fortune sobre el lanzamiento; el texto de Wentao Zhu GPT-6 Astra: 3D, Embodied AI, and Beyond, y el ensayo sobre los transformers en bucle de Sebastian Raschka, que cita a Pachocki. El resto de fuentes están enlazadas donde se citan.