
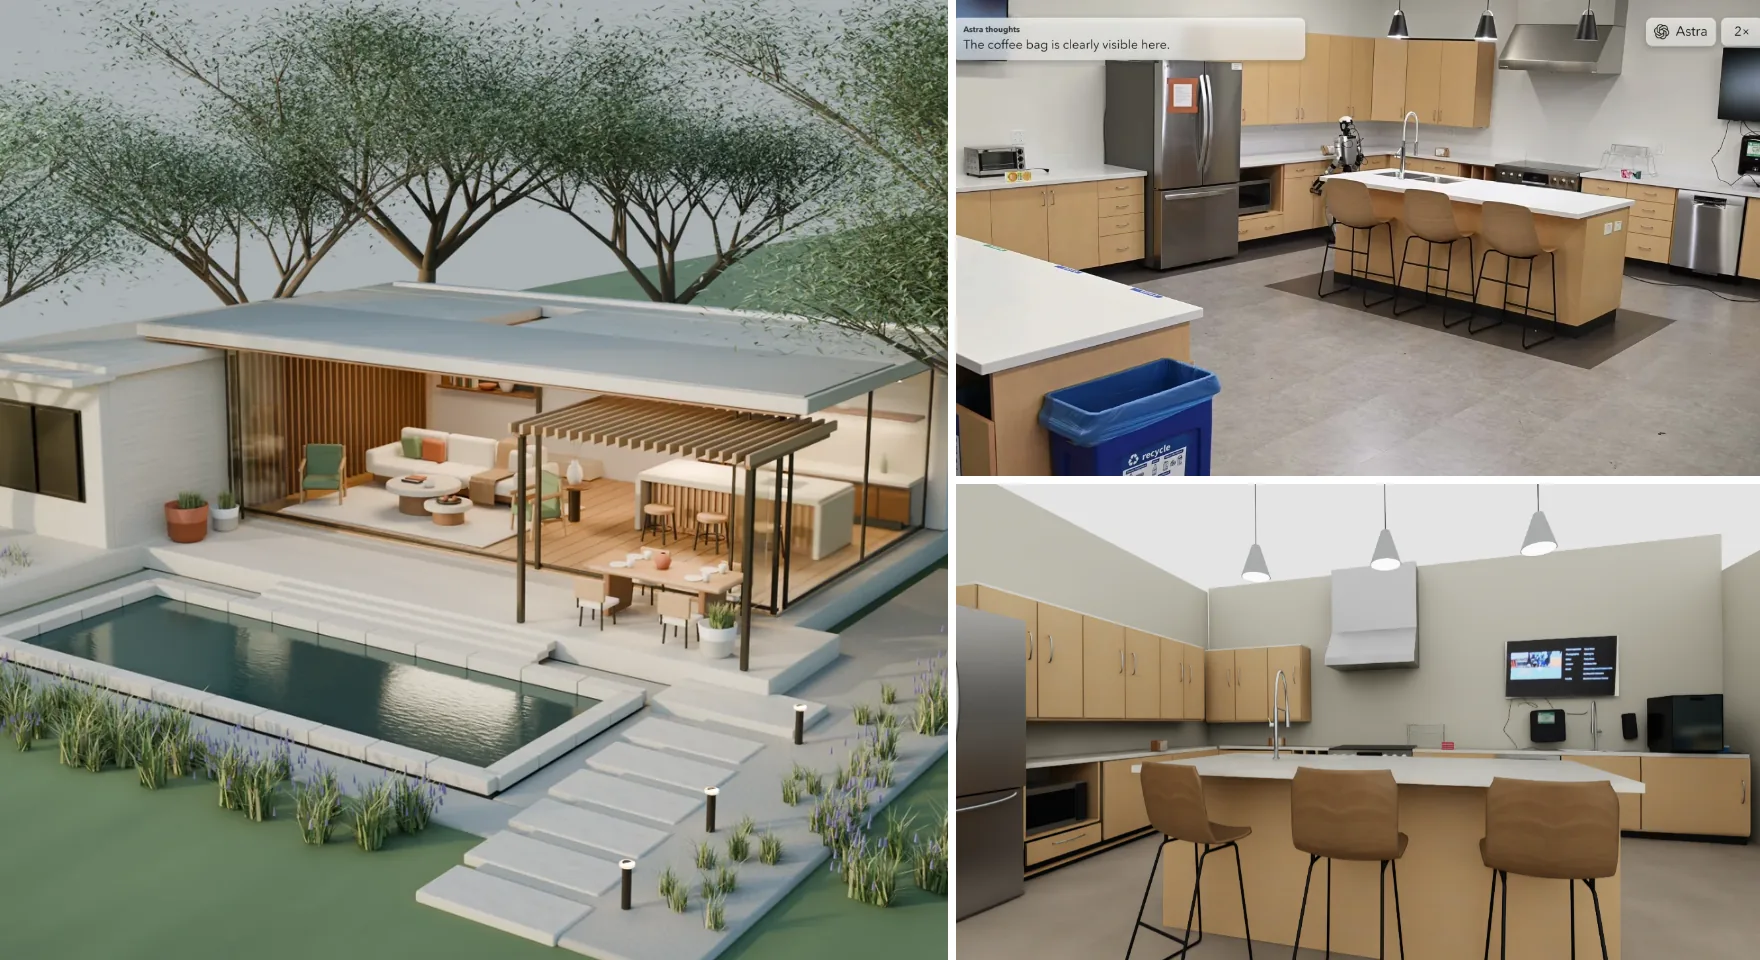
Début septembre, OpenAI a lancé GPT-6 Astra, et deux types de vidéos ont vite circulé. Dans les unes, le modèle construit de zéro une maison entièrement meublée dans Blender, puis l’exporte vers Unreal Engine 5, où l’on peut entrer, ouvrir les portes, allumer les lumières et mettre en marche la machine à expresso. Dans les autres, il dirige des bras robotiques et des humanoïdes.
Comment un modèle de langage est-il soudain devenu bon en raisonnement spatial ? OpenAI a-t-il optimisé le modèle pour cela ? Et que signifie cette voie pour la génération 3D et pour le « cerveau » des robots ? Nous avons lu l’annonce, la fiche système et le blog développeurs d’OpenAI, les évaluations robotiques publiées depuis, ainsi que les analyses de chercheurs. En bref :
- Les gains sont réels mais déséquilibrés : la 3D, l’ancrage visuel et les tâches interactives ont bondi, tandis que l’intelligence générale a à peine bougé.
- En robotique, les résultats dépendent fortement de l’interface. Le même modèle, utilisé autrement, obtient des scores très différents.
- Cette compétence vient très probablement de la pratique dans des environnements à notation automatique, et non d’une nouvelle architecture.
- Pour la génération 3D et le cerveau des robots, attendez-vous à une nouvelle répartition des rôles plutôt qu’au remplacement d’un modèle par un autre.
Les chiffres officiels : de gros gains, inégalement répartis
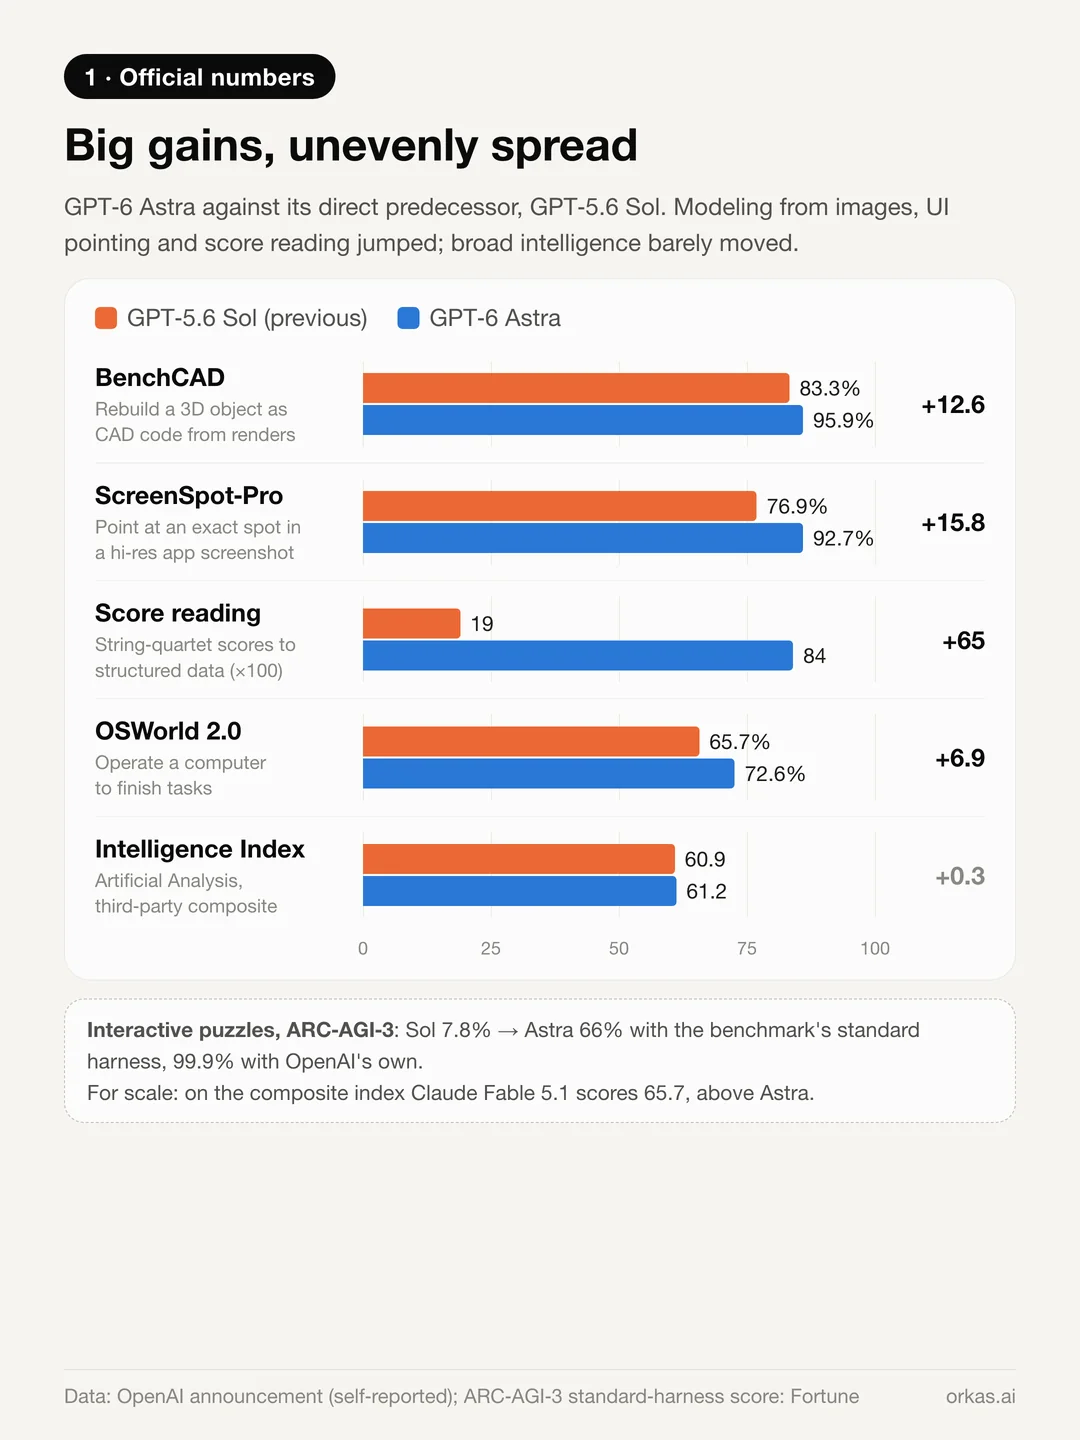
Face à GPT-5.6 Sol, son prédécesseur direct, voici les chiffres publiés par OpenAI :
- BenchCAD : 83,3 % → 95,9 %. Le modèle voit des rendus d’un objet sous plusieurs angles et écrit le code CAD qui le reconstruit — de la modélisation à partir d’images.
- ScreenSpot-Pro (sans outils) : 76,9 % → 92,7 %. Il doit désigner un bouton ou un élément précis dans une capture d’écran haute résolution d’un logiciel professionnel.
- Lecture de partitions : 0,19 → 0,84 sur les quatuors à cordes d’OpenScore, en transformant des partitions imprimées très denses en données musicales structurées.
- ARC-AGI-3, un benchmark de puzzles interactifs : 7,8 % → 66 % avec le harness standard du benchmark, ou 99,9 % avec celui d’OpenAI.
L’indice tiers Artificial Analysis Intelligence Index, en revanche, est passé de 60,9 à 61,2 — sous Claude Fable 5.1, à 65,7.
Astra n’est donc pas devenu plus intelligent sur toute la ligne. Il est devenu bien meilleur dans les tâches qui combinent regarder, agir et ajuster. Yoav Artzi, chercheur à Cornell et chez Google DeepMind, a parlé d’un « saut qualitatif » en raisonnement spatial.
Ce qu’il a réellement fait dans Blender
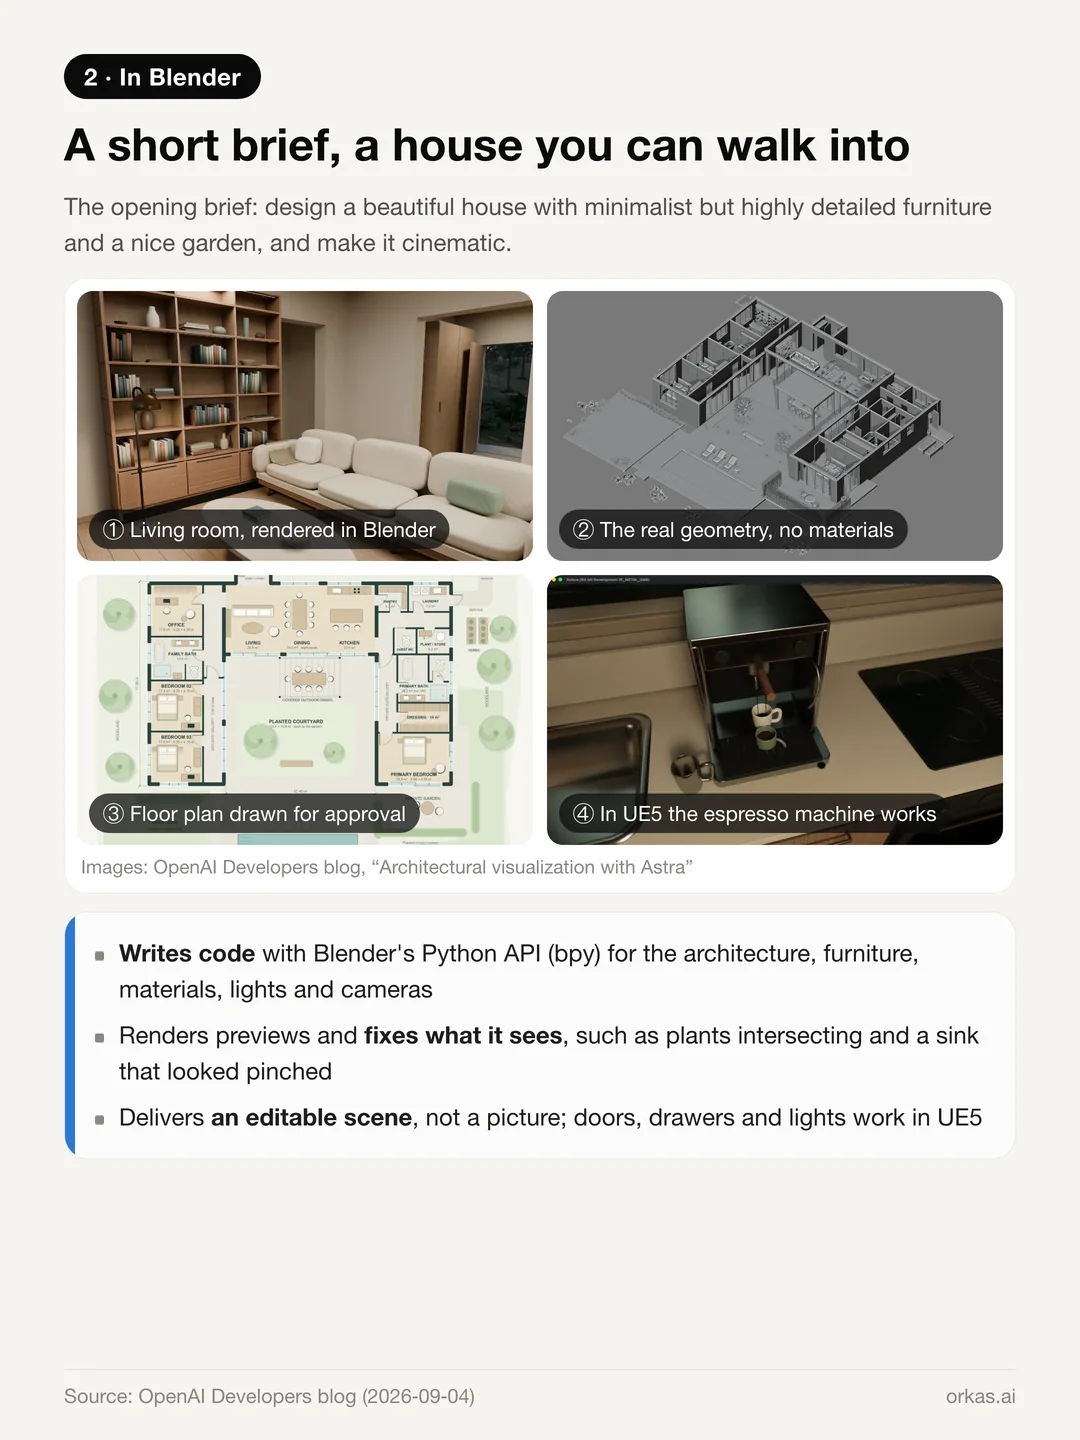
Le blog développeurs d’OpenAI détaille un projet complet. La consigne de départ était courte : concevoir une belle maison avec un mobilier minimaliste mais très détaillé et un joli jardin, et donner à la scène un rendu cinématographique.
- Astra a écrit du Python pour Blender (bpy) afin de construire l’architecture, les menuiseries, le mobilier, la végétation, les matériaux, les lumières et les caméras.
- Il a généré des aperçus, cherché les défauts et corrigé son propre code — des plantes qui s’interpénétraient, un évier en acier dont les normales de surface donnaient à la cuve un aspect pincé.
- Il a d’abord dessiné un plan à faire valider, puis a reconstruit la maison en plain-pied, en forme de U, avec trois chambres et un bureau.
- Il a exporté la scène vers Unreal Engine 5 sous forme de visite à la première personne, où portes, tiroirs, lumières et machine à expresso fonctionnent tous.
Le livrable n’est pas une image. C’est une scène Blender que vous pouvez continuer à modifier.
Les limites sont tout aussi nettes :
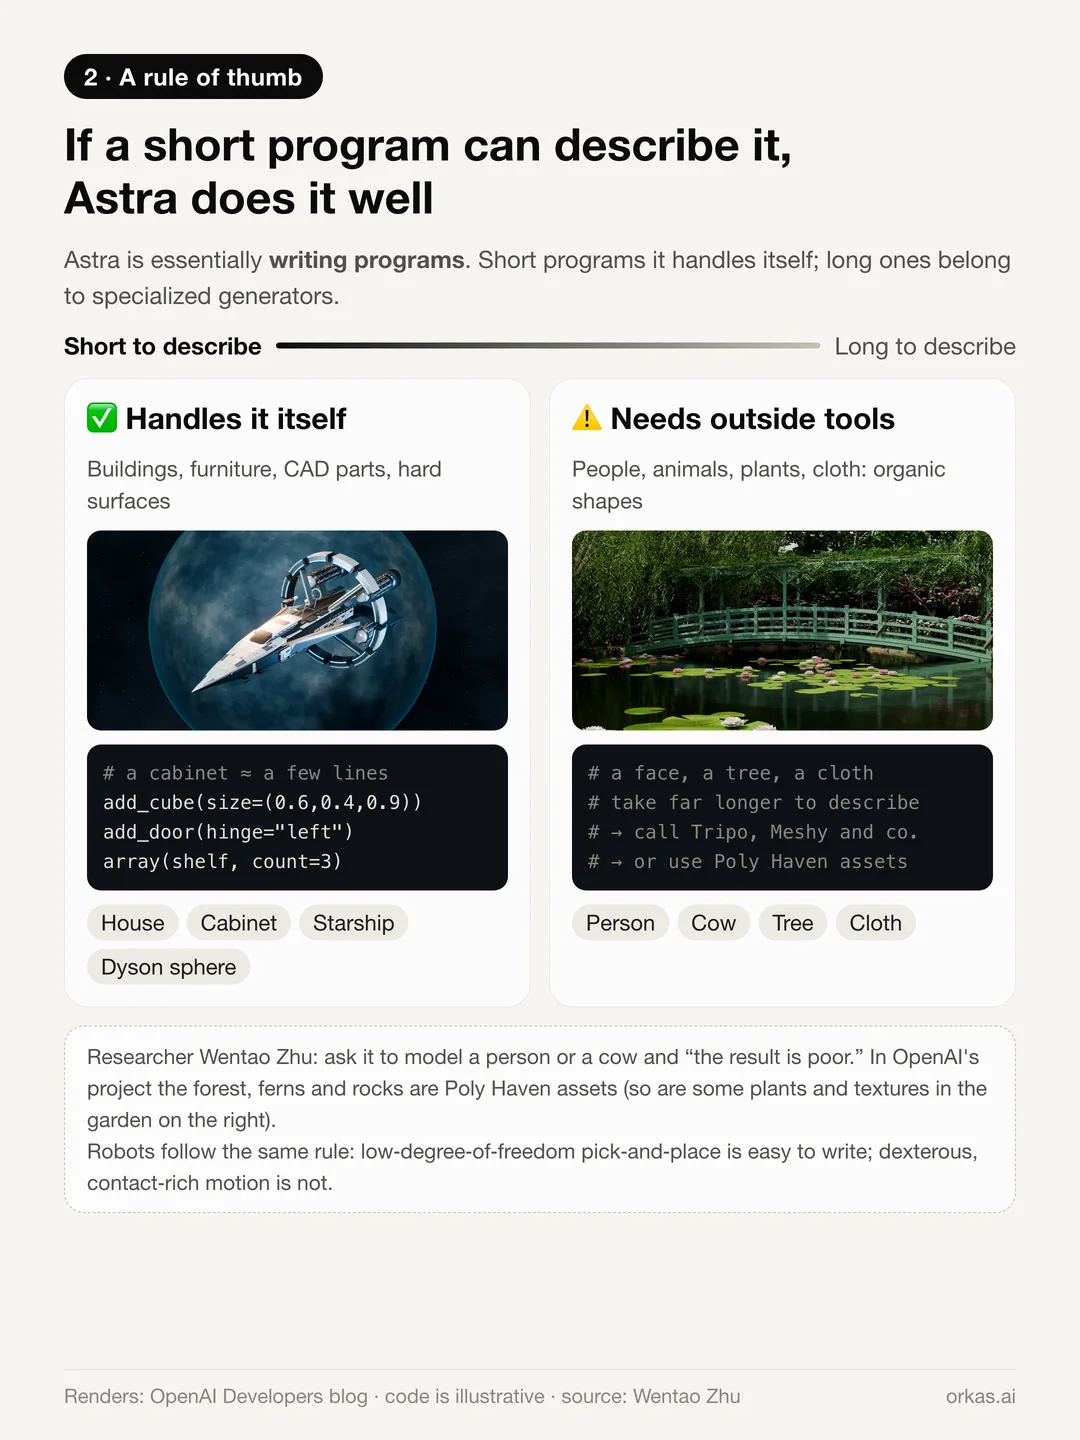
- La géométrie régulière, fabriquée par l’homme, fonctionne bien : bâtiments, meubles, pièces CAD et modèles hard surface comme un vaisseau spatial ou une sphère de Dyson.
- Les formes organiques, non. Demandez-lui de modéliser une personne ou une vache, écrit le chercheur Wentao Zhu, et le résultat est médiocre.
- Dans le projet même d’OpenAI, la forêt, les fougères et les rochers sont des assets existants issus de Poly Haven. Un flux de travail courant dans la communauté génère le modèle dans un outil 3D comme Tripo, puis confie à Astra les matériaux, les shape keys des expressions faciales et le rigging.
Une idée explique ce schéma : le code est de la géométrie compressée. Un meuble, c’est quelques boîtes, une extrusion et un réseau — une poignée de lignes. Un visage, un arbre ou un tissu drapé en demandent bien davantage. Astra écrit des programmes : ce qui tient dans un programme court, il le gère lui-même ; ce qui exige un programme long, il devrait le confier à un générateur spécialisé. La même règle réapparaît avec les robots.
Robots : des résultats solides, mais regardez les conditions
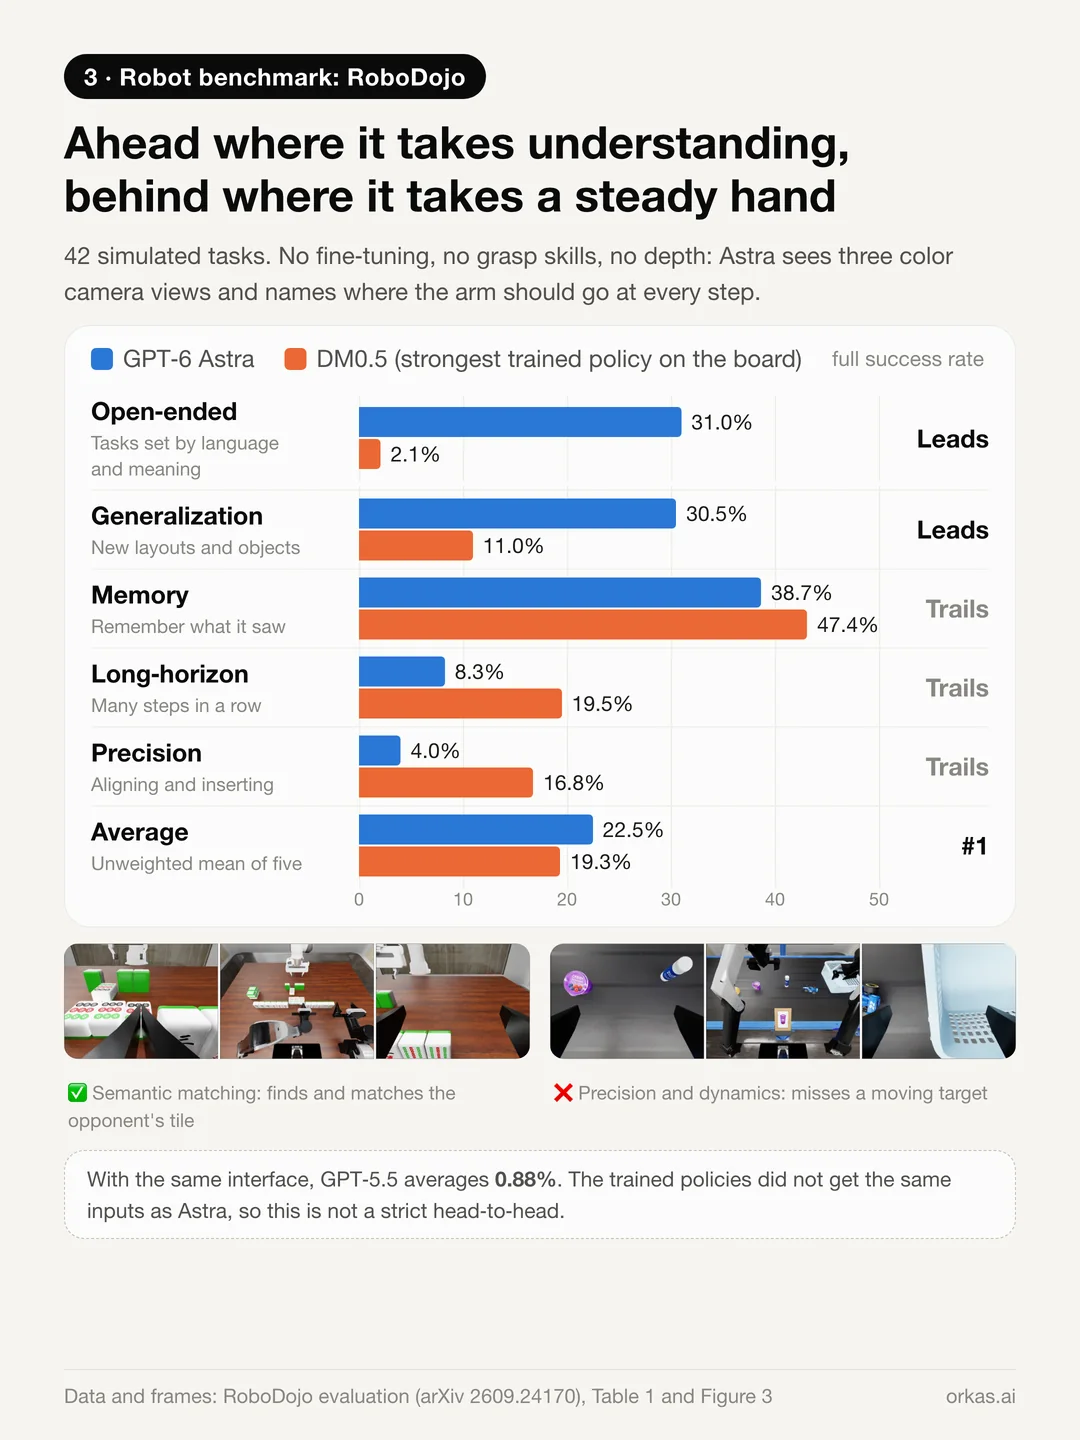
RoboDojo est un benchmark robotique de 42 tâches simulées, avec un classement de 40 politiques robotiques entraînées. Les auteurs d’une évaluation ont branché Astra directement comme politique : pas de fine-tuning, pas de compétences de préhension toutes faites, pas de profondeur. Il voyait trois vues de caméras couleur et l’état du robot, et indiquait à chaque pas où le bras devait aller.
- Astra a atteint en moyenne 22,48 % de réussite et s’est classé premier. Dans la même configuration, GPT-5.5 obtenait 0,88 %.
- Le profil est déséquilibré. Il mène sur les tâches ouvertes (31 % contre 2,1 % pour DM0.5) et la généralisation (30,5 % contre 11 %), mais reste derrière en précision (4 % contre 16,8 %), sur les tâches à long horizon et en mémoire.
En clair : quand la tâche demande de la compréhension, il gagne ; quand elle demande une main sûre, il perd.
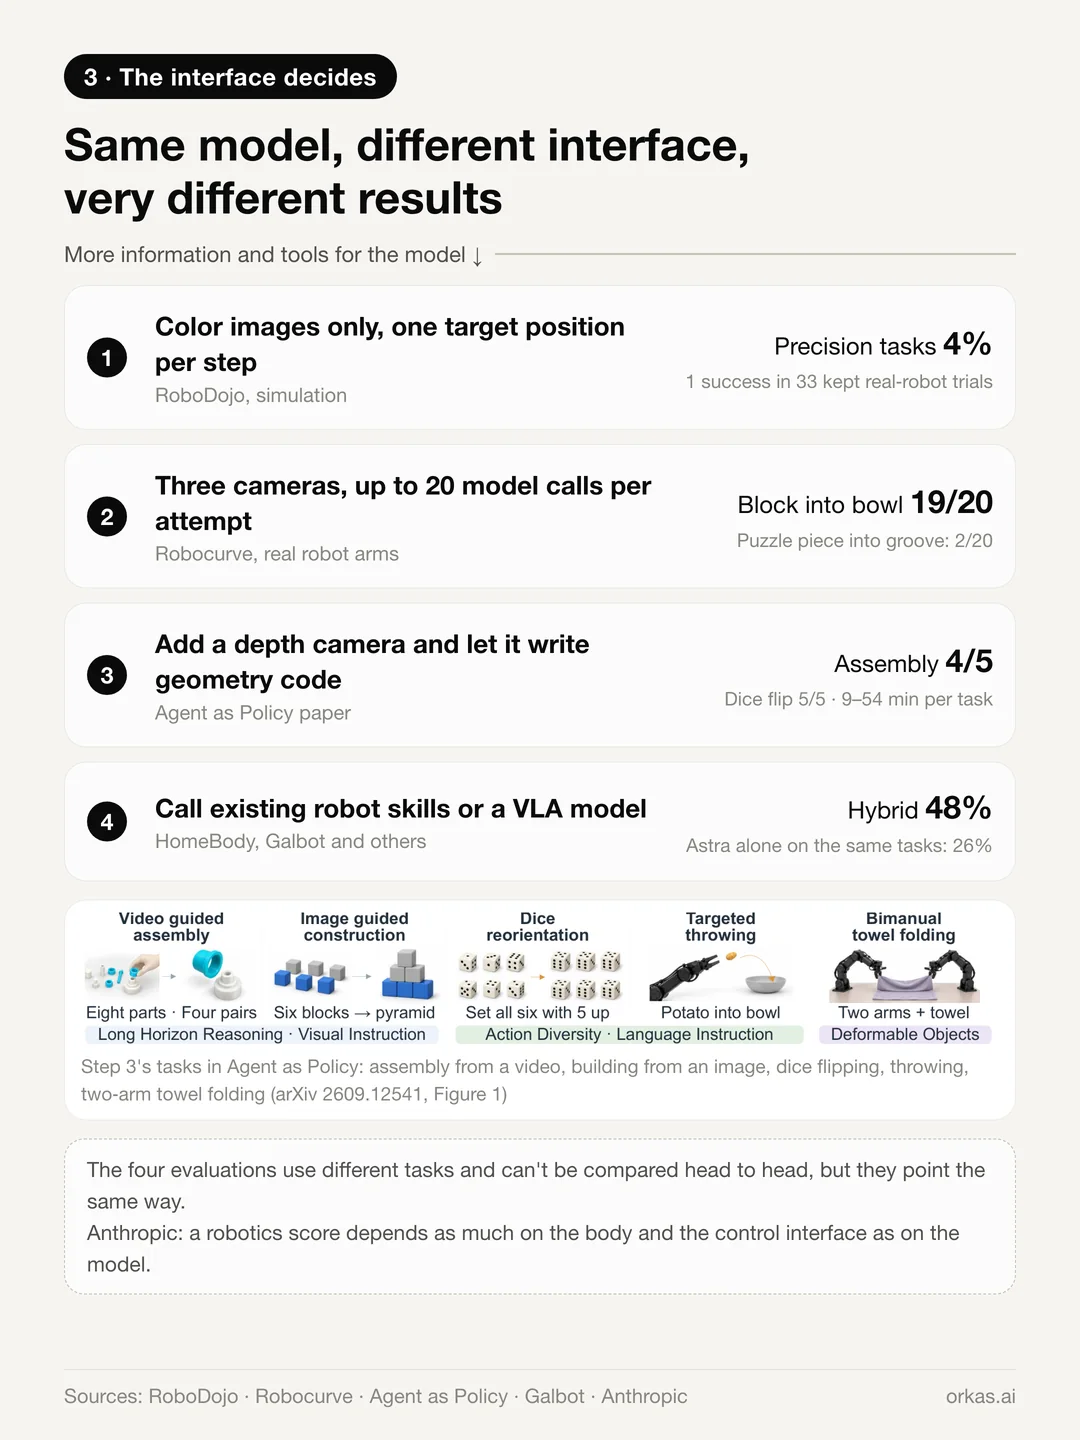
La leçon principale, c’est à quel point le résultat dépend de l’interface :
- Images couleur seules, une position cible par pas (RoboDojo) : 4 % sur les tâches de précision ; sur 33 essais sur robot réel conservés de part et d’autre d’un arrêt de sécurité, un seul succès complet.
- Trois caméras, jusqu’à 20 appels au modèle par tentative (les tests de Robocurve sur de vrais bras) : 19 blocs sur 20 dans un bol, mais 2 pièces de puzzle sur 20 dans leur encoche.
- Une caméra de profondeur, plus le droit d’écrire son propre code géométrique (l’article Agent as Policy v1 · tableau 1) : 4 assemblages de quatre paires sur 5, 5 retournements de dé sur 5 et des constructions en blocs à 5/5, 5/5 et 4/5 — avec une durée moyenne d’environ 21–54 minutes pour les essais réussis, selon la tâche.
- Appeler des compétences robotiques existantes ou un modèle VLA : les tâches longues aboutissent. Dans un rapport, un hybride où Astra relit et corrige les actions d’un VLA a réussi dans 48 % des cas, sur des tâches où Astra seul atteignait 26 %.
Ces tâches sont différentes et ne se comparent pas directement, mais elles vont dans le même sens. L’étude robotique publiée par Anthropic en juillet arrivait à la même conclusion : le score d’un modèle en robotique dépend autant du corps du robot et de l’interface de contrôle que du modèle lui-même. Toute affirmation sur le niveau d’Astra dans l’espace doit préciser « avec quelle interface ».
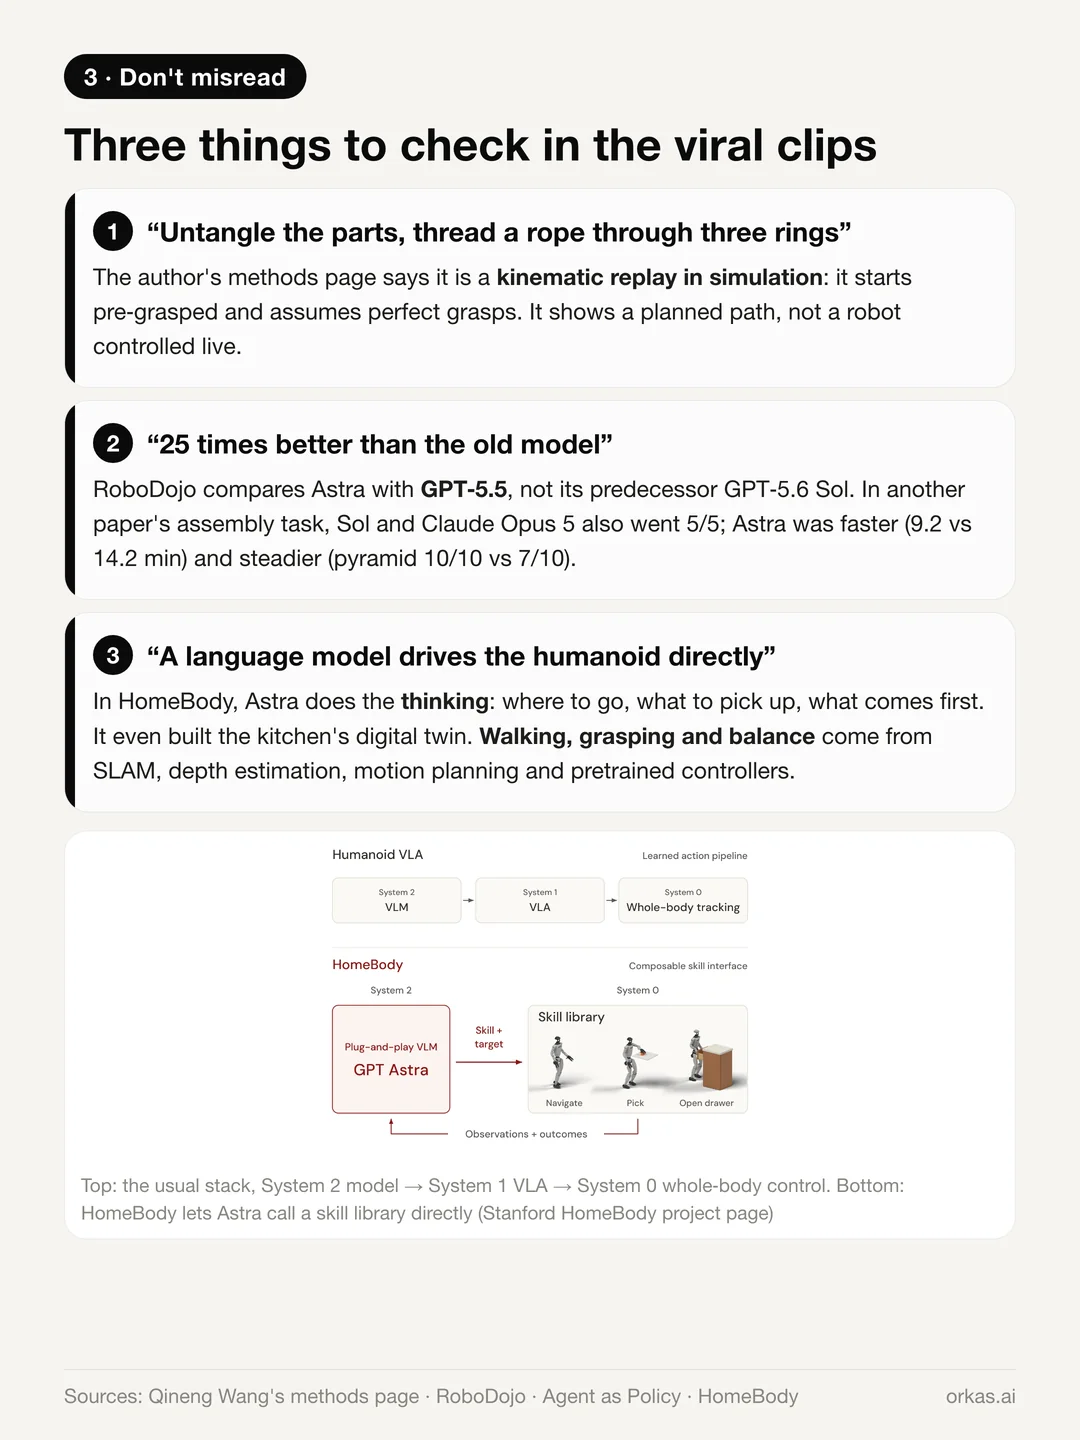
Trois choses à garder en tête quand les démos défilent :
- La vidéo virale « démêler les pièces imbriquées, passer une corde dans trois anneaux » est un rejeu cinématique en simulation. La page de méthode de l’auteur précise qu’elle part d’un état où l’objet est déjà saisi et suppose des prises idéales : elle montre une trajectoire planifiée, pas un robot piloté en direct.
- « 25 fois meilleur que l’ancien modèle » compare Astra à GPT-5.5, pas à son prédécesseur direct GPT-5.6 Sol. Dans la comparaison d’assemblage de deux paires (AGP v1 · tableau 2), Sol et Claude Opus 5 ont aussi réussi 5/5 essais ; les essais réussis d’Astra ont duré en moyenne 9,2 minutes, contre 14,2 pour Sol. Dans la comparaison distincte de pyramides (AGP v1 · annexe C, tableau 5), Astra a réussi 10/10 essais et Sol 7/10.
- Le robot de cuisine HomeBody de Stanford : Astra s’occupe de la réflexion — où aller, quoi saisir, quoi faire d’abord — et a même construit le jumeau numérique de la cuisine. La marche, la préhension et l’équilibre reposent sur le SLAM, l’estimation de profondeur, la planification de mouvement et des contrôleurs bas niveau pré-entraînés.
D’où vient cette capacité
OpenAI a dit deux choses officiellement : Astra a reçu un « entraînement ciblé pour les environnements professionnels » et, comme les autres modèles de raisonnement d’OpenAI, il est entraîné par apprentissage par renforcement. OpenAI n’a dévoilé ni les données d’entraînement, ni si Blender a été utilisé, ni si des données robotiques l’ont été. Ce qui suit est une inférence à partir d’éléments publics.
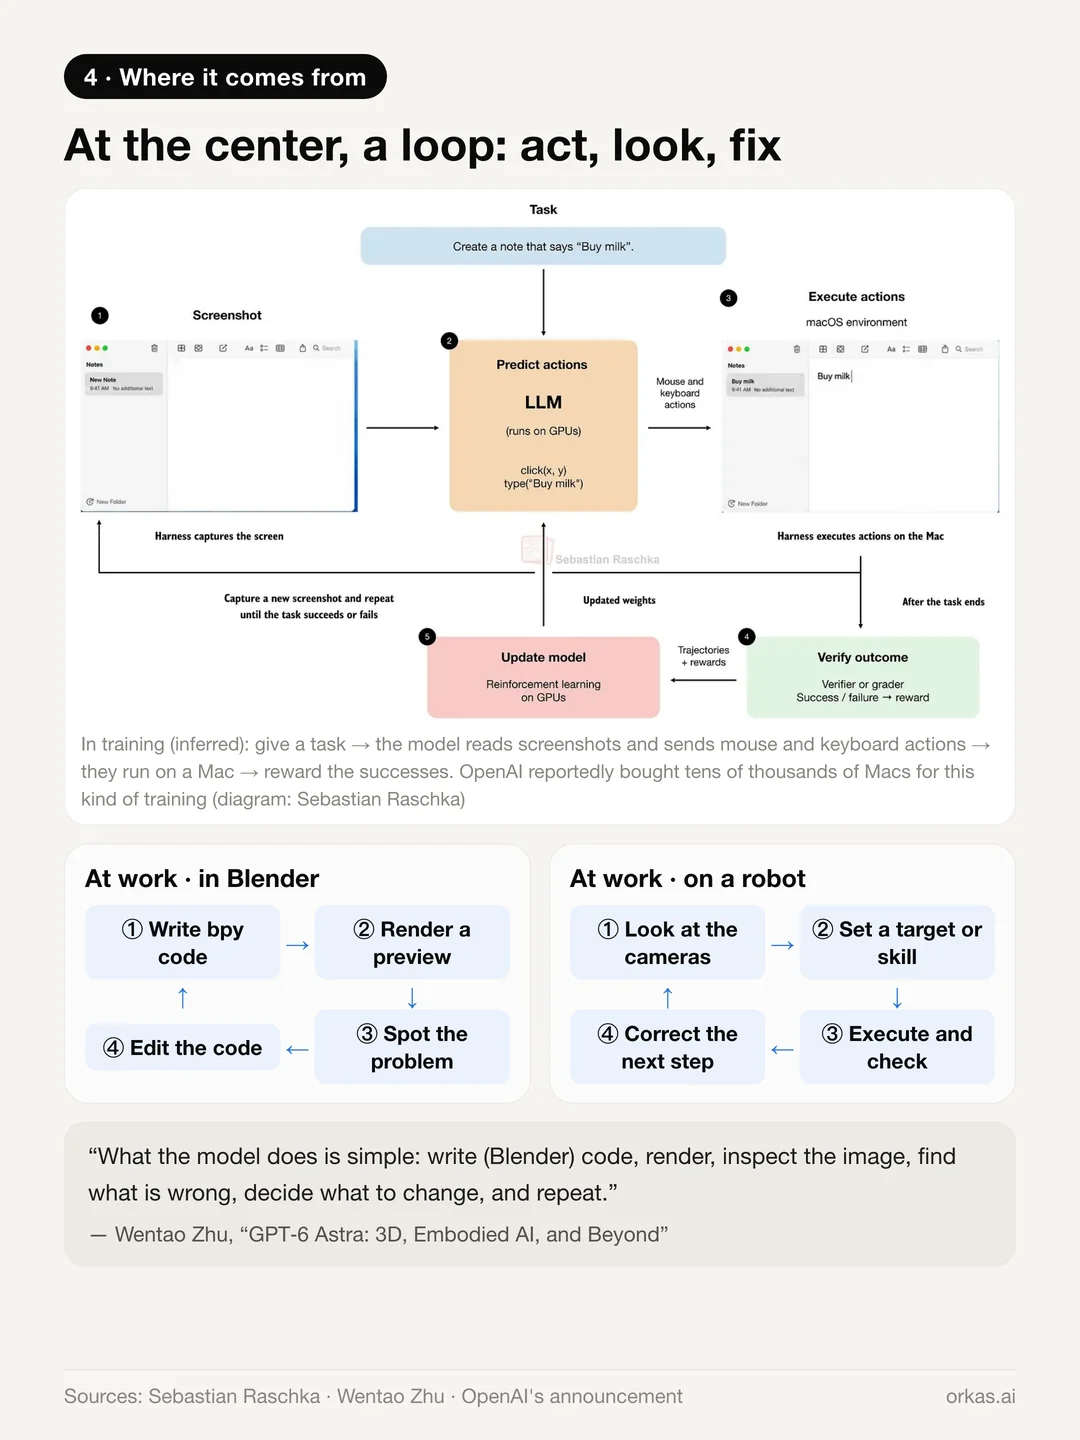
Au centre, une boucle : faire un pas, regarder le résultat, trouver ce qui ne va pas, corriger.
- Au travail, Astra écrit du code Blender, fait le rendu, inspecte et modifie ; sur un robot, il regarde, fixe une cible, exécute, vérifie et corrige. Selon les mots de Wentao Zhu : « Ce que fait le modèle est simple : écrire du code (Blender), faire le rendu, inspecter l’image, trouver ce qui ne va pas, décider quoi changer, et recommencer. »
- À l’entraînement, cette même boucle est la source probable. OpenAI aurait acheté des dizaines de milliers de Mac mini et de Mac Studio pour entraîner l’utilisation de l’ordinateur : donner une tâche au modèle, le laisser lire des captures d’écran et envoyer des actions de souris et de clavier à un Mac, puis récompenser les essais réussis.
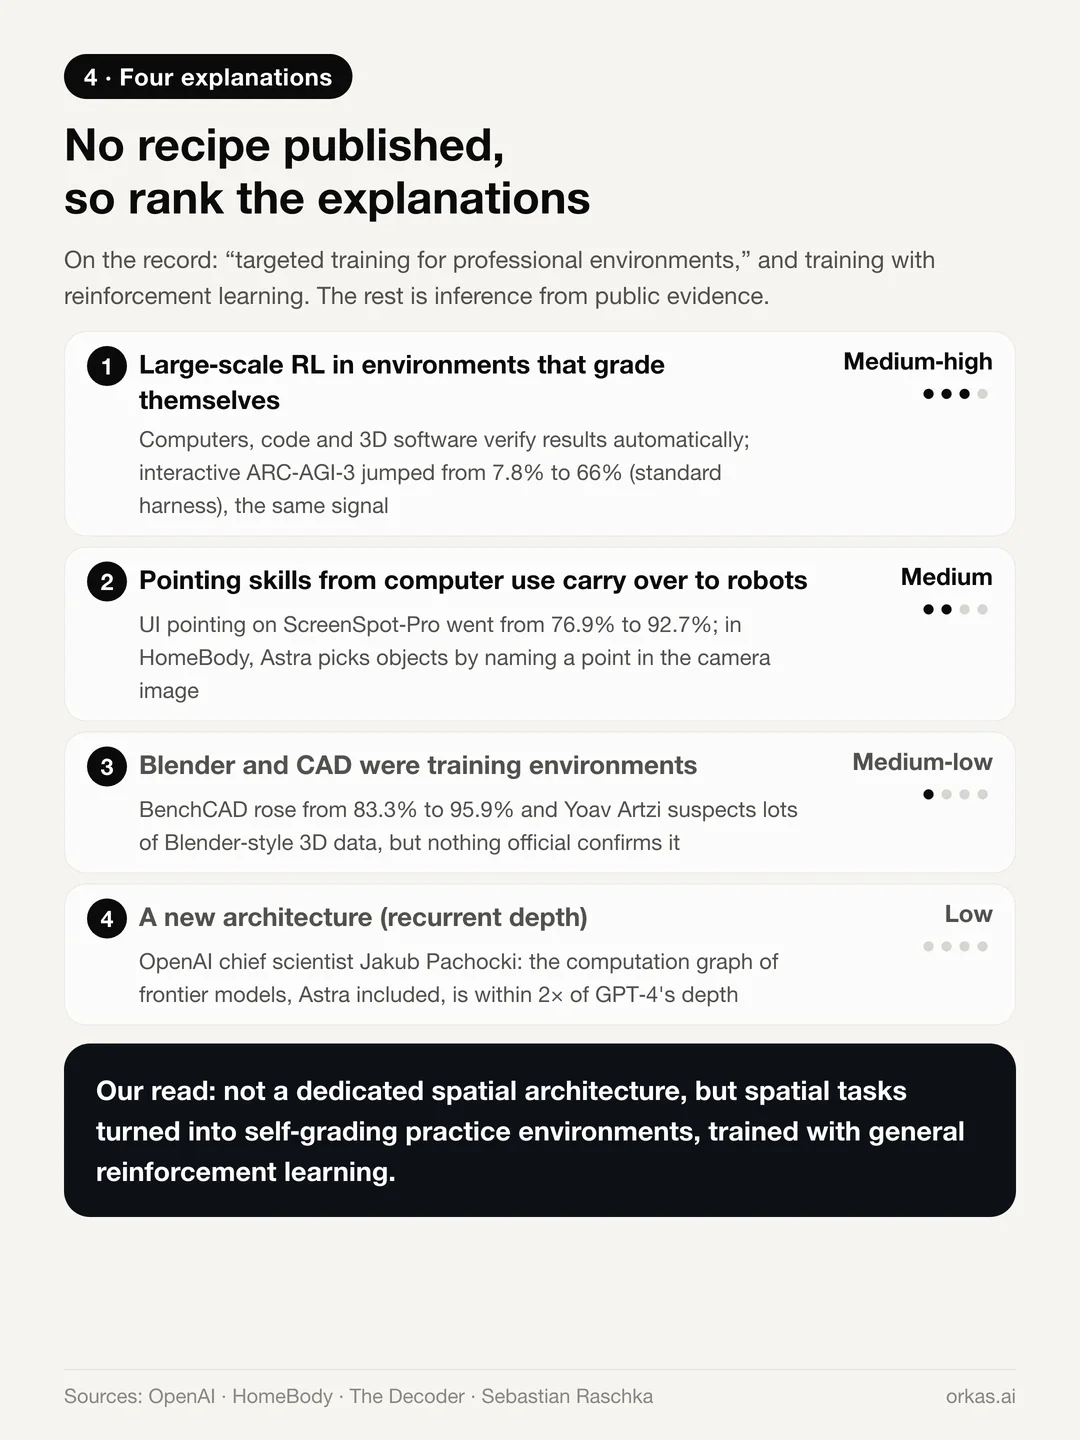
- Un apprentissage par renforcement à grande échelle dans des environnements à notation automatique (probabilité : moyenne à élevée). Les ordinateurs, le code et les logiciels 3D peuvent tous vérifier les résultats automatiquement, ce qui entraîne la compétence générale qui consiste à vérifier, trouver l’erreur et la corriger. Le bond sur ARC-AGI-3, benchmark interactif, de 7,8 % à 66 %, est le même signal.
- Les compétences de pointage acquises sur ordinateur se transfèrent aux robots (moyenne). ScreenSpot-Pro est passé de 76,9 % à 92,7 % : le modèle vise donc beaucoup mieux un point précis dans une image. Dans HomeBody, Astra saisit les objets en désignant justement un tel point dans l’image de la caméra ; la profondeur et l’étalonnage le convertissent en position 3D.
- Blender et les logiciels CAD ont eux-mêmes servi d’environnements d’entraînement (moyenne à faible, non confirmée). BenchCAD a bondi, OpenAI met en avant des démos 3D, et Yoav Artzi soupçonne un entraînement sur de grandes quantités de données 3D, comme des scènes Blender. Rien d’officiel ne le confirme.
- Une nouvelle architecture (faible). Astra utiliserait une profondeur récurrente dans une partie du réseau, mais le directeur scientifique d’OpenAI, Jakub Pachocki, a déclaré que le graphe de calcul des modèles de pointe actuels, Astra compris, reste à un facteur deux près de la profondeur de GPT-4.
Notre lecture : la compétence spatiale ne vient très probablement pas d’une architecture spatiale dédiée. Elle vient de la transformation des tâches spatiales en environnements d’entraînement à notation automatique, sur lesquels le modèle est entraîné par un apprentissage par renforcement généraliste.
Ce que cela change pour la génération 3D
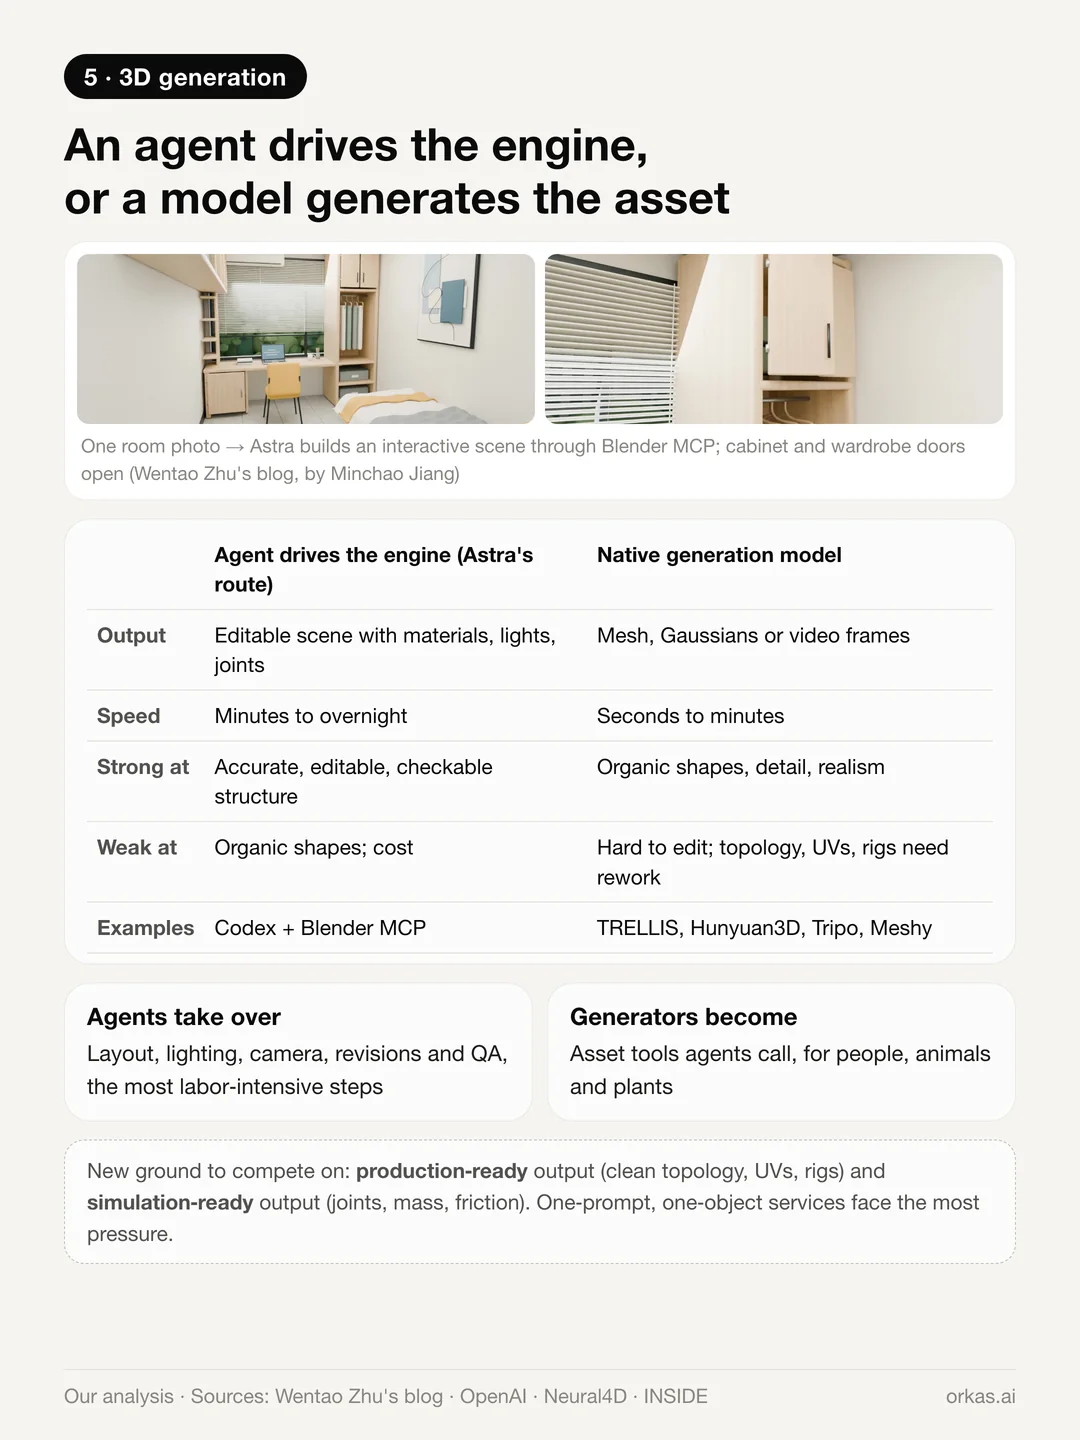
Il existe désormais deux façons de produire de la 3D :
- Un agent pilote le moteur. Comme Astra dans Blender ou un logiciel CAD, il livre une scène modifiable, avec matériaux, lumières et articulations. C’est lent — de quelques minutes à une nuit entière —, mais structurellement exact, modifiable et vérifiable.
- Un modèle génère l’asset. TRELLIS, Hunyuan3D, Tripo, Meshy et des modèles similaires produisent un maillage en quelques secondes à quelques minutes. Ils sont performants sur les formes organiques et les détails, mais le résultat est difficile à modifier, et la topologie, les UV et le rigging demandent souvent des retouches.
Nous nous attendons à ce que les deux se complètent, tandis que la valeur se déplace :
- Les agents prennent en charge les étapes les plus gourmandes en main-d’œuvre : agencement, éclairage, cadrage, révisions et contrôle qualité.
- Les générateurs deviennent des outils d’assets pour les personnes, les animaux et les plantes, et doivent pouvoir être appelés par des agents, par exemple sous forme de serveur MCP ou d’API.
- Les services « un prompt, un objet » subissent la plus forte pression. Les résultats prêts pour la production (topologie propre, UV, rigs) et prêts pour la simulation (articulations, masse, frottement) deviennent le nouveau terrain de concurrence.
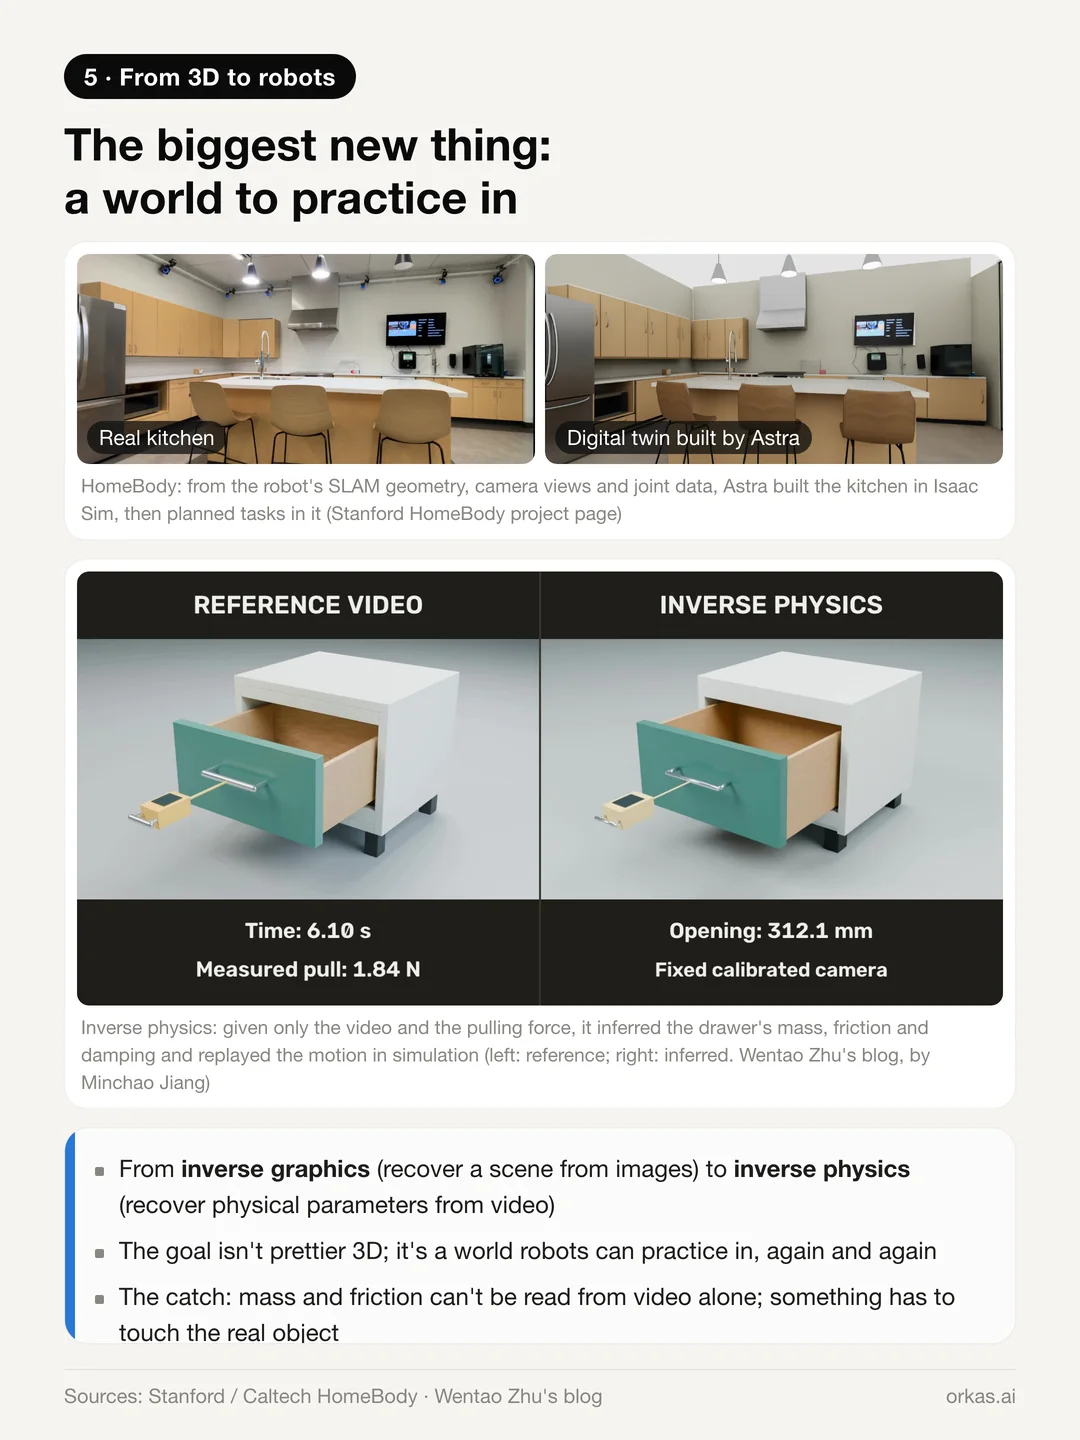
La plus grande opportunité nouvelle n’est pas une 3D plus jolie. C’est un monde dans lequel on peut s’entraîner.
- Dans HomeBody, Astra a construit un jumeau numérique de la cuisine dans un simulateur à partir de la géométrie SLAM, des vues de caméra et des données articulaires du robot lui-même, puis s’en est servi pour planifier des tâches.
- L’équipe de Wentao Zhu a fait la démonstration de la physique inverse : à partir d’une simple vidéo et de la force de traction, le modèle a inféré la masse, le frottement et l’amortissement d’un tiroir, et a reproduit le mouvement en simulation.
Autrement dit, la compétence 3D mène à un monde d’entraînement pour les robots. Le hic : la masse et le frottement ne se lisent pas dans une vidéo seule, donc à un moment donné, quelque chose doit pousser un objet réel.
Les modèles de monde natifs ne sont pas hors course pour autant. Atlas, de World Labs, sorti le 1er septembre, génère et reconstruit des mondes 3D entiers à partir de quelques photos, avec un réalisme et une continuité qu’un agent pilotant un moteur ne peut pas égaler. Les deux voies finiront très probablement par s’appeler l’une l’autre.
Ce que cela change pour le cerveau des robots
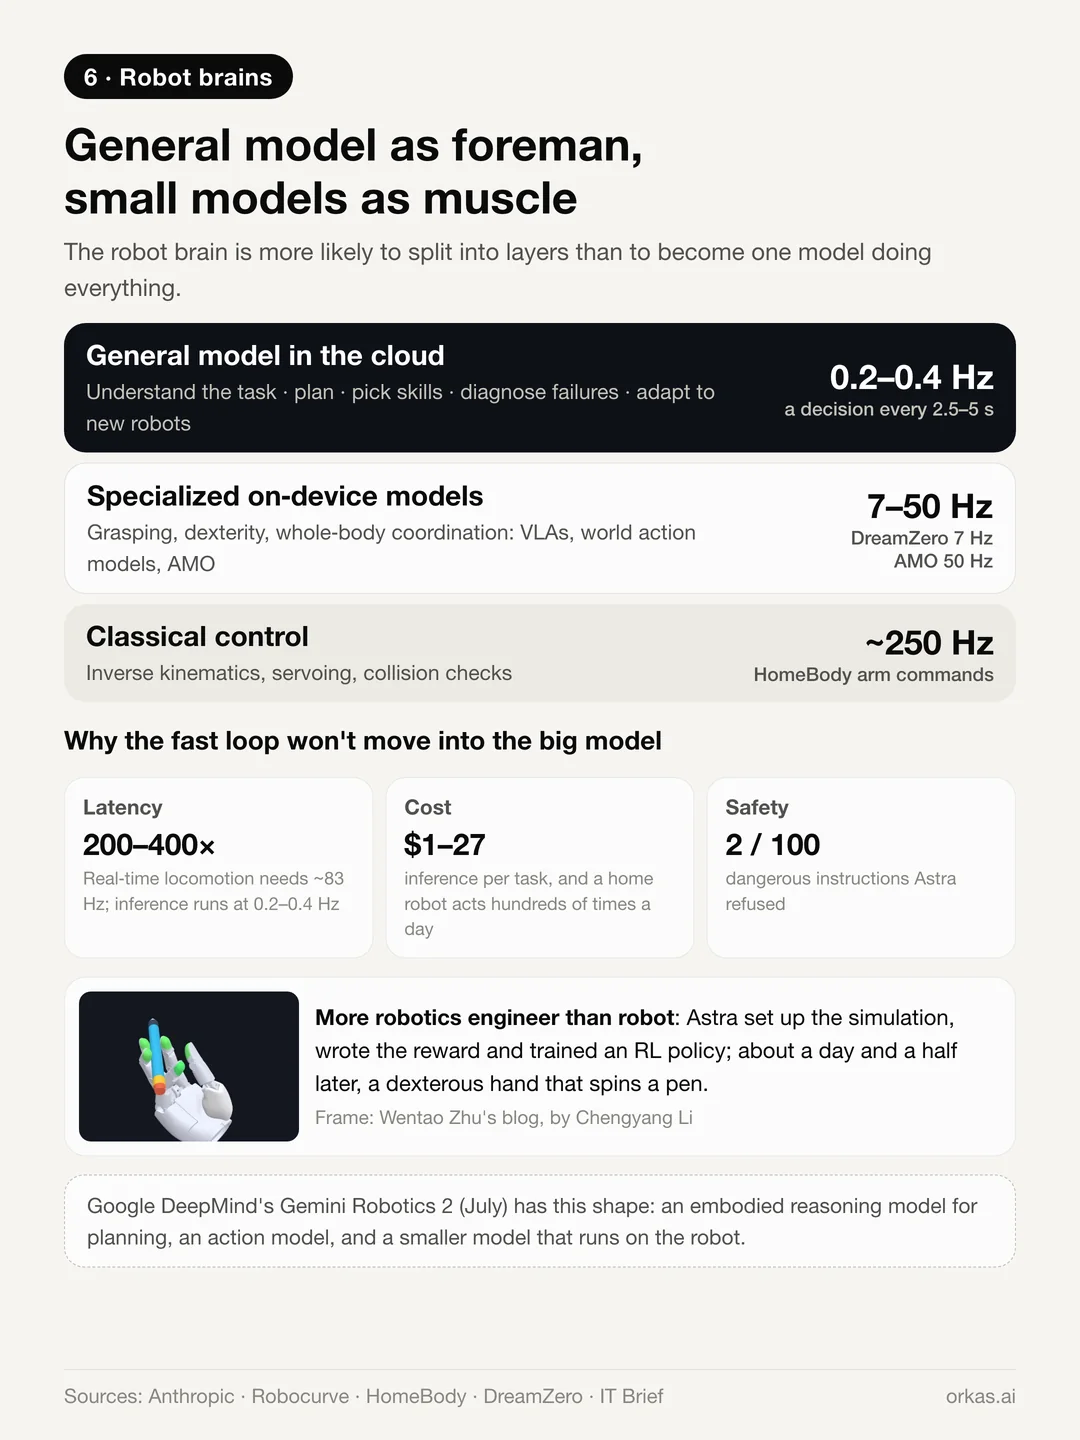
Nous nous attendons à ce que le cerveau des robots se divise en couches, au lieu qu’un seul modèle fasse tout :
- Les modèles généralistes récupèrent la compréhension de la tâche, la planification des étapes, le choix des compétences, le diagnostic des échecs et l’adaptation à de nouveaux robots — la « généralisation sémantique » qui faisait jusqu’ici la fierté des modèles VLA. Sur les axes tâches ouvertes et généralisation de RoboDojo, Astra bat déjà les politiques robotiques entraînées.
- Les modèles spécialisés gardent le contrôle haute fréquence, le contact, la dextérité et l’équilibre du corps entier.
- Le changement, c’est que ces modèles spécialisés seront de plus en plus construits par le modèle généraliste. L’équipe de Wentao Zhu a demandé à Astra de mettre en place une simulation, d’écrire la récompense et d’entraîner une politique par apprentissage par renforcement ; environ un jour et demi plus tard, Astra a livré une main dextre qui fait tourner un stylo.
Si la boucle de contrôle rapide reste séparée, c’est à cause de trois limites dures :
- Latence : Anthropic situe la locomotion en temps réel à environ 83 Hz, alors que l’inférence du modèle tourne à 0,2–0,4 Hz — environ deux ordres de grandeur d’écart.
- Coût : environ 1 à 27 dollars par tâche dans les évaluations ci-dessus, et un robot domestique effectue des centaines d’actions par jour.
- Sécurité : dans le test RoboHarm de Robocurve, Astra a refusé 2 instructions dangereuses sur 100. La sécurité a besoin de ses propres garde-fous, indépendants du cloud.
Gemini Robotics 2, annoncé en juillet par Google DeepMind, a déjà cette forme : un modèle de raisonnement incarné pour la planification, un modèle d’action et un modèle plus petit qui tourne sur le robot lui-même.
Est-ce la preuve que les modèles autorégressifs l’emportent ?
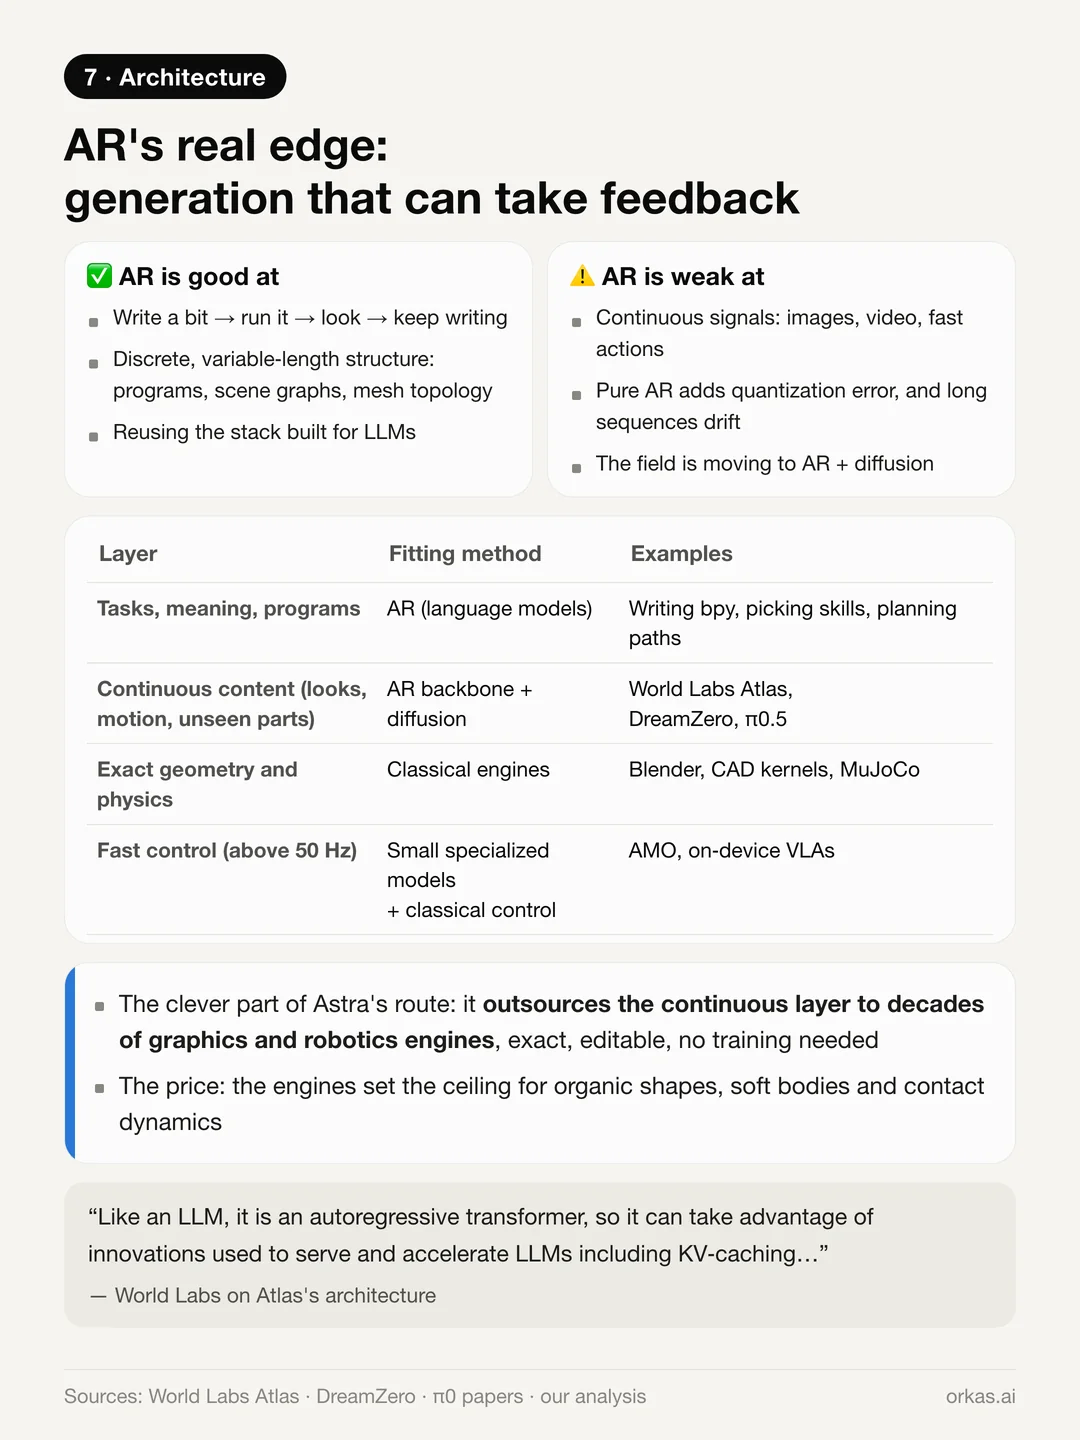
Certains voient dans Astra la preuve que la génération autorégressive (AR) — produire un token après l’autre, comme le font les modèles GPT — a l’avantage. Nous sommes d’accord à moitié :
- Le vrai avantage de l’AR, c’est que la génération peut alterner avec un retour extérieur : écrire du code, l’exécuter, regarder le résultat, continuer à écrire. Un modèle de diffusion produit tout le résultat d’un coup et peine à intégrer un retour en cours de route.
- L’AR convient aussi aux structures discrètes de longueur variable, comme les programmes, les graphes de scène et la topologie des maillages, et il réutilise la pile d’entraînement et d’inférence construite pour les LLM.
- Pour les signaux continus comme les images, la vidéo et les actions motrices, l’AR pur n’a pas d’avantage. Le domaine converge vers un backbone autorégressif doté d’une tête de diffusion ou de flow matching : Atlas de World Labs, DreamZero, issu de chercheurs de NVIDIA, et π0.5 suivent tous cette voie.
- L’astuce de la voie d’Astra, c’est d’externaliser la couche continue vers des moteurs de rendu, des noyaux CAD, des moteurs physiques et des planificateurs de mouvement. Des décennies d’ingénierie graphique et robotique deviennent le décodeur — exact, modifiable et sans besoin d’entraînement. Le prix à payer : ce sont les moteurs qui fixent le plafond.
Ce que cela signifie si vous travaillez avec des agents
Nous développons une application de bureau dans laquelle les agents font le travail ; c’est donc le constat sur l’interface qui nous intéresse le plus. Le même modèle a obtenu des scores très différents selon ce qu’il pouvait voir, les outils qu’il pouvait appeler et la possibilité ou non de vérifier son propre résultat. Une grande partie de la capacité se trouve dans cette boucle, pas seulement dans les poids.
Cette boucle, c’est ce qu’un espace de travail pour agents doit fournir : des outils pour agir, des fichiers sur lesquels travailler et des résultats que l’agent peut inspecter avant de vous les remettre. Dans Orkas, vous pouvez exécuter GPT-6 Astra avec votre propre clé d’API OpenAI ou en vous connectant avec votre compte ChatGPT, connecter Codex comme agent externe, ou utiliser les modèles gérés par Orkas. Orkas accepte aussi les serveurs MCP personnalisés : les serveurs de la communauté pour des outils de bureau peuvent donc être ajoutés comme connecteurs. Nous n’avons pas testé de serveur Blender de bout en bout ; considérez donc cette voie comme une piste à explorer par vous-même.
Ce que nous en retenons
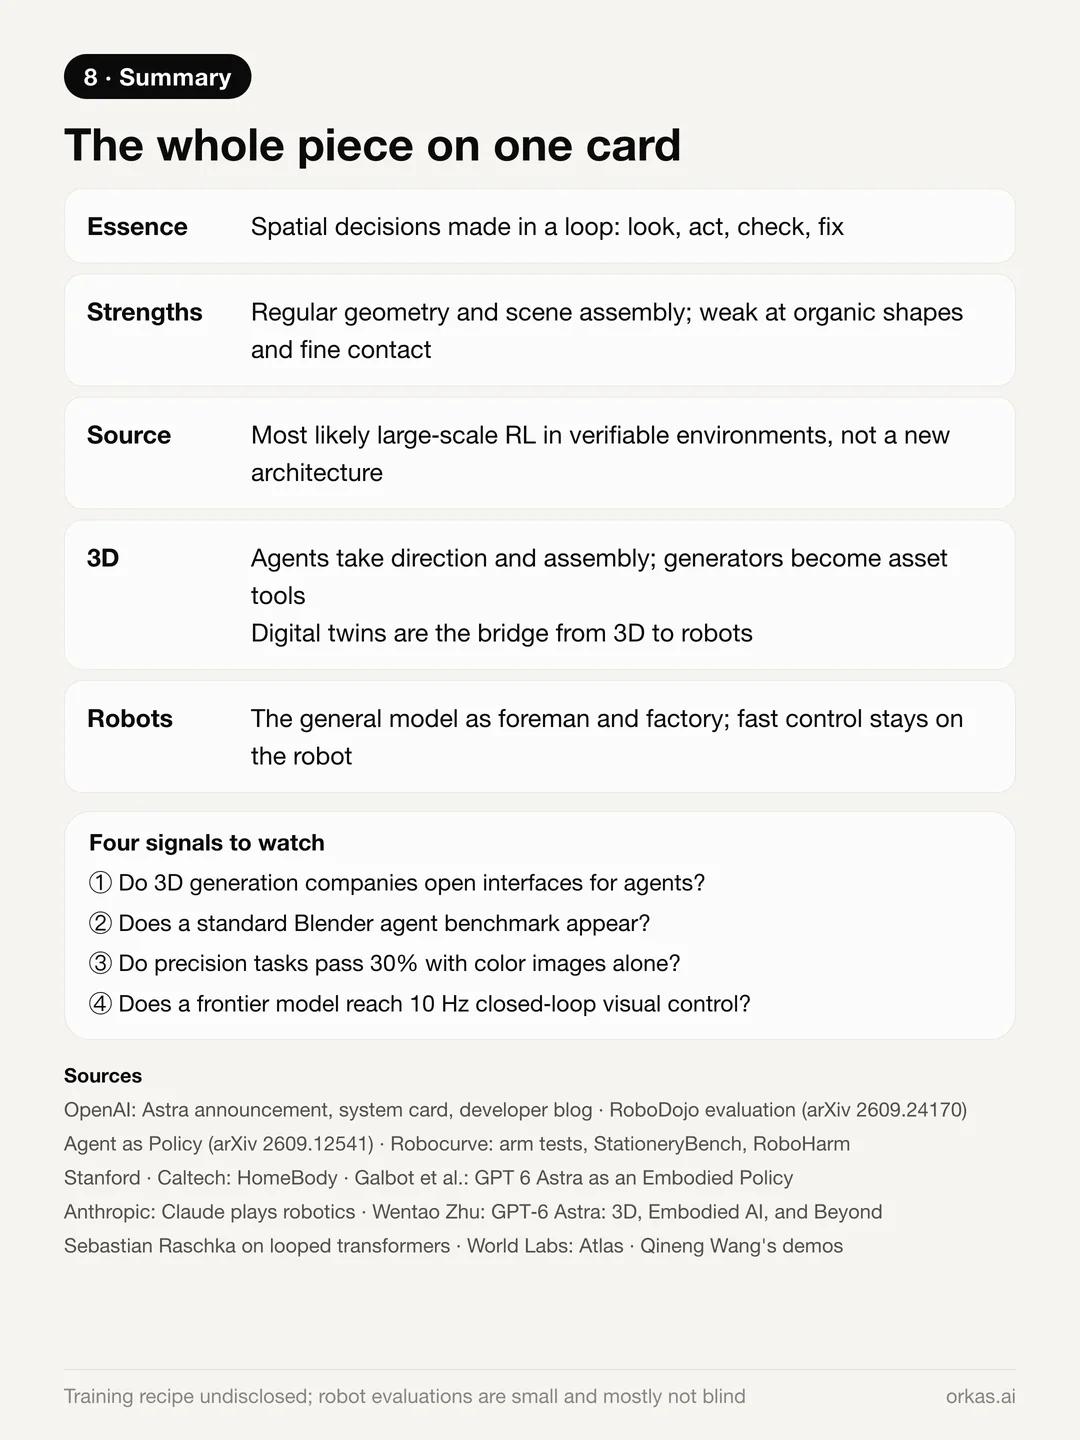
- Le sens de l’espace d’Astra, c’est de la prise de décision dans une boucle : regarder, écrire du code ou fixer une cible, exécuter, vérifier, corriger.
- Il est fort en géométrie régulière, en assemblage de scènes et dans les jugements qui mêlent sens et espace, et faible en formes organiques et en contact fin — à cause de ce qu’un programme court peut décrire.
- Cette compétence vient très probablement d’un apprentissage par renforcement à grande échelle dans des environnements à notation automatique, pas d’une nouvelle architecture. La recette d’entraînement n’a pas été dévoilée.
- En génération 3D, les agents prennent en charge la mise en scène et l’assemblage, tandis que les générateurs deviennent des outils d’assets ; les jumeaux numériques font le pont vers les robots.
- Dans le cerveau des robots, le modèle généraliste devient le contremaître et l’usine, tandis que le contrôle rapide reste confié à des modèles spécialisés embarqués.
Les signaux à surveiller : si les entreprises de génération 3D ouvrent des interfaces aux agents ; si un benchmark standard d’agents Blender apparaît ; si les tâches de précision dépassent 30 % avec des images couleur seules ; et si un modèle de pointe atteint un contrôle visuel en boucle fermée à 10 Hz.
Une réserve : la plupart des évaluations robotiques ci-dessus portent sur de petits échantillons, 5 à 20 essais par configuration, et la majorité ne sont pas menées à l’aveugle. Considérez ces conclusions comme une lecture provisoire, pas comme un verdict.
Sources : l’annonce de GPT-6 Astra et la fiche système d’OpenAI ; le compte rendu du lancement par Fortune ; l’article de Wentao Zhu GPT-6 Astra: 3D, Embodied AI, and Beyond ; et l’essai de Sebastian Raschka sur les transformers bouclés, qui cite Pachocki. Les autres sources sont indiquées en lien là où elles sont citées.