
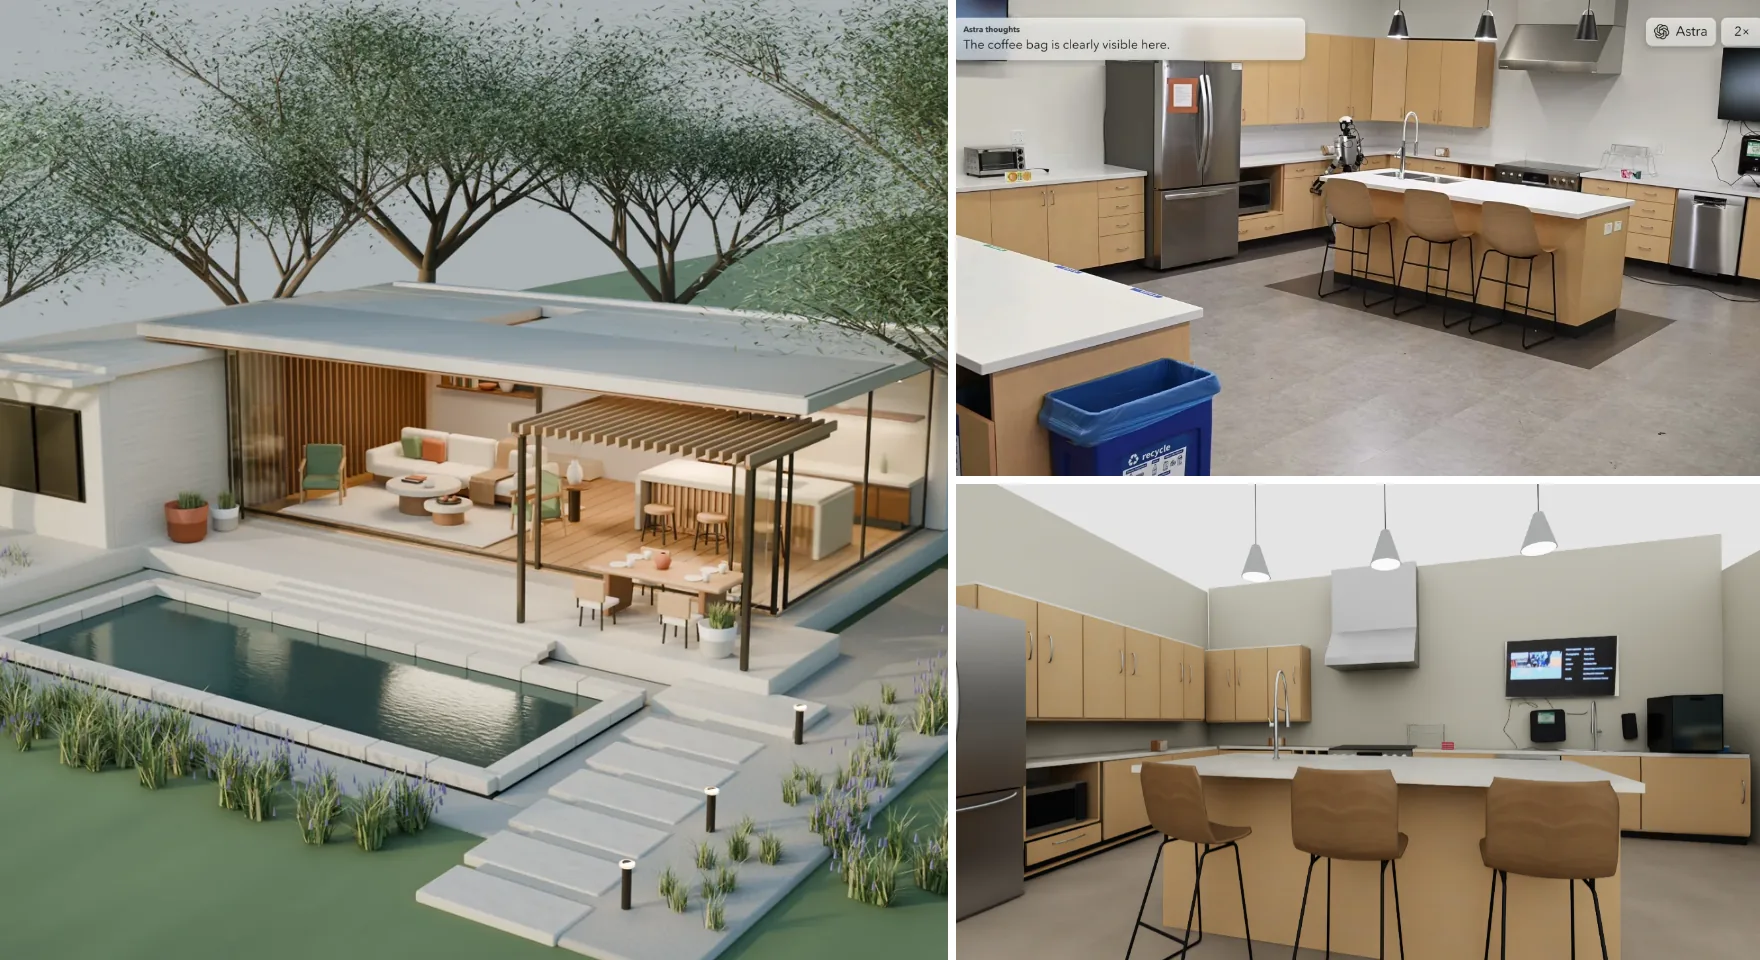
सितंबर की शुरुआत में OpenAI ने GPT-6 Astra रिलीज़ किया, और दो तरह के क्लिप तेज़ी से फैले। एक में यह Blender में शुरू से फ़र्नीचर से पूरी तरह सजा एक घर बनाता है, फिर उसे Unreal Engine 5 में एक्सपोर्ट करता है, जहाँ आप अंदर जा सकते हैं, दरवाज़े खोल सकते हैं, लाइटें जला सकते हैं और एस्प्रेसो मशीन चला सकते हैं। दूसरे में यह रोबोटिक आर्म और ह्यूमनॉइड रोबोटों को निर्देश देता है।
एक भाषा मॉडल अचानक स्पेस को इतनी अच्छी तरह कैसे समझने लगा? क्या OpenAI ने ख़ास तौर पर इसी के लिए ऑप्टिमाइज़ किया? और 3D जनरेशन व रोबोटों के “दिमाग़” के लिए इस रास्ते का क्या मतलब है? हमने OpenAI की घोषणा, सिस्टम कार्ड और डेवलपर ब्लॉग पढ़े, उसके बाद प्रकाशित रोबोट मूल्यांकन देखे, और शोधकर्ताओं के विश्लेषण भी। संक्षेप में:
- बढ़त असली है, पर एकतरफ़ा: 3D, विज़ुअल ग्राउंडिंग और इंटरैक्टिव टास्क में बड़ी छलांग लगी, जबकि समग्र बुद्धिमत्ता लगभग जस की तस रही।
- रोबोट पर नतीजे इंटरफ़ेस पर बहुत निर्भर करते हैं। एक ही मॉडल को अलग तरीके से इस्तेमाल करें, तो स्कोर बहुत अलग आते हैं।
- सबसे ज़्यादा संभावना यही है कि यह क्षमता ऐसे एनवायरनमेंट में अभ्यास से आई है जो अपने आप सही-ग़लत जाँच लेते हैं, किसी नए आर्किटेक्चर से नहीं।
- 3D जनरेशन और रोबोटों के दिमाग़ में एक मॉडल के दूसरे की जगह लेने के बजाय काम के नए बँटवारे की उम्मीद रखिए।
आधिकारिक आँकड़े: बढ़त बड़ी, पर बराबर नहीं बँटी
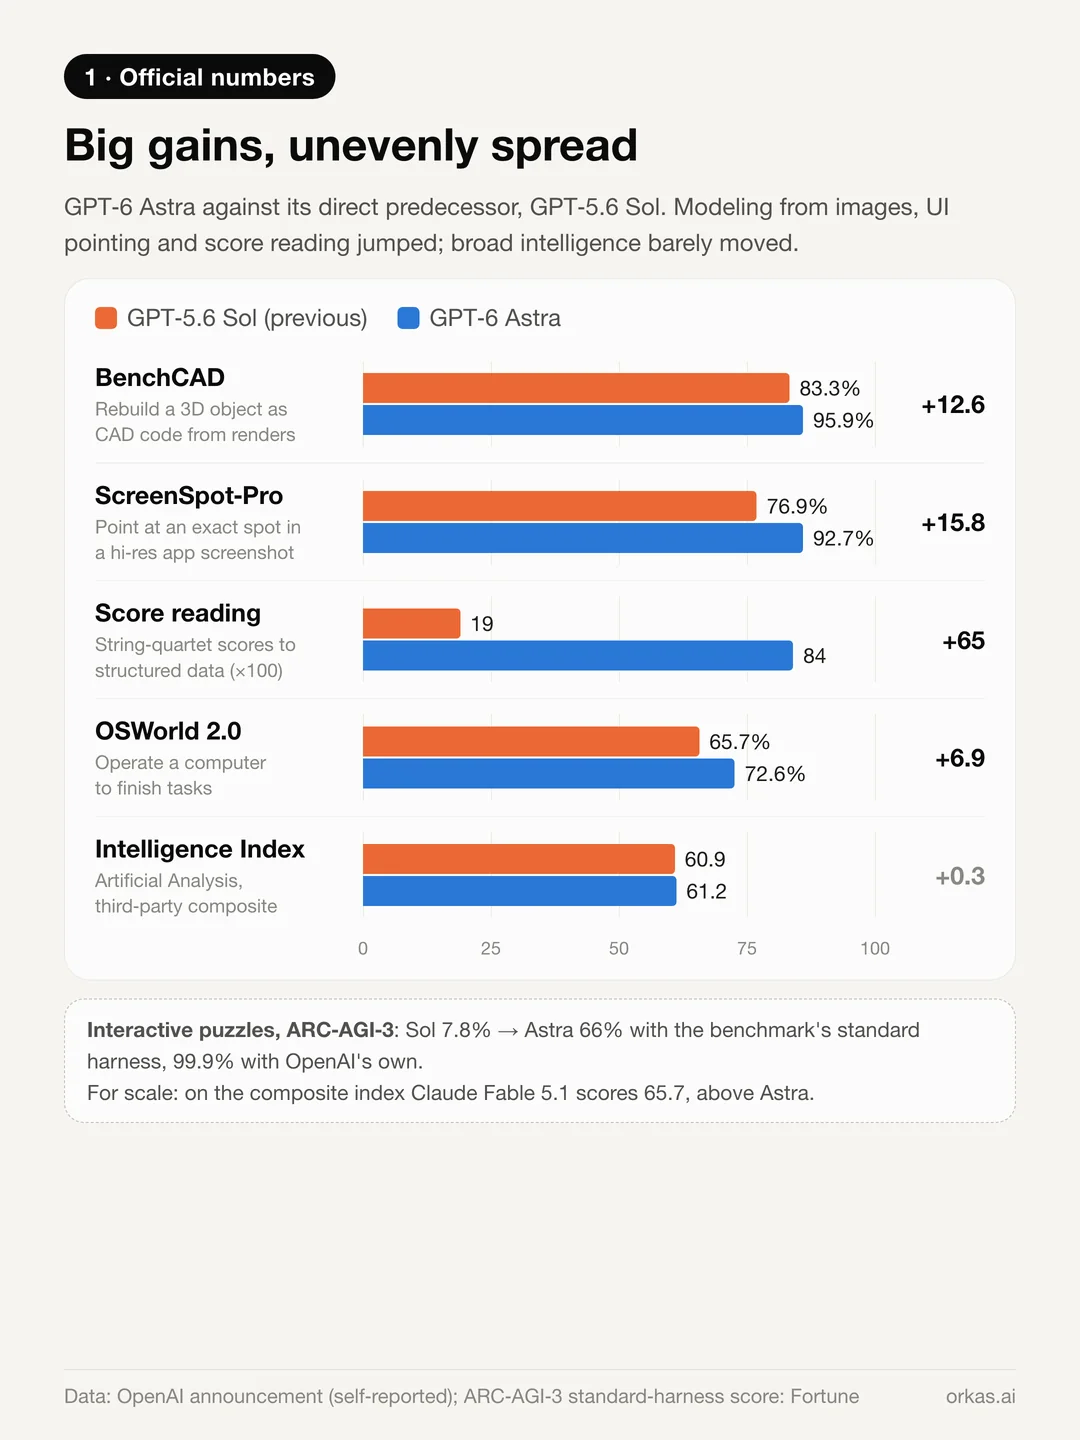
अपने सीधे पिछले मॉडल GPT-5.6 Sol के मुक़ाबले OpenAI के प्रकाशित आँकड़े कुछ ऐसे हैं:
- BenchCAD: 83.3% → 95.9%। मॉडल किसी वस्तु के कई कोणों से बने रेंडर देखता है और ऐसा CAD कोड लिखता है जो उसे फिर से बना दे — यानी तस्वीरों से मॉडलिंग।
- ScreenSpot-Pro (बिना टूल के): 76.9% → 92.7%। प्रोफ़ेशनल सॉफ़्टवेयर के हाई-रिज़ॉल्यूशन स्क्रीनशॉट में उसे किसी ख़ास बटन या एलिमेंट पर ठीक-ठीक इशारा करना होता है।
- म्यूज़िक स्कोर पढ़ना: OpenScore के स्ट्रिंग क्वार्टेट पर 0.19 → 0.84, यानी घने छपे स्कोर को स्ट्रक्चर्ड म्यूज़िक डेटा में बदलना।
- ARC-AGI-3, एक इंटरैक्टिव पहेली बेंचमार्क: बेंचमार्क के अपने स्टैंडर्ड हार्नेस के साथ 7.8% → 66%, या OpenAI के अपने हार्नेस के साथ 99.9%।
इसके उलट, तीसरे पक्ष का Artificial Analysis इंटेलिजेंस इंडेक्स 60.9 से 61.2 पर पहुँचा — 65.7 वाले Claude Fable 5.1 से नीचे।
यानी Astra हर मोर्चे पर ज़्यादा समझदार नहीं हुआ। वह उन टास्क में कहीं बेहतर हुआ है जिनमें देखना, करना और फिर सुधारना एक साथ आते हैं। Cornell और Google DeepMind के शोधकर्ता Yoav Artzi ने इसे स्पेशियल रीज़निंग में “बड़ी छलांग” बताया।
Blender में इसने असल में क्या किया
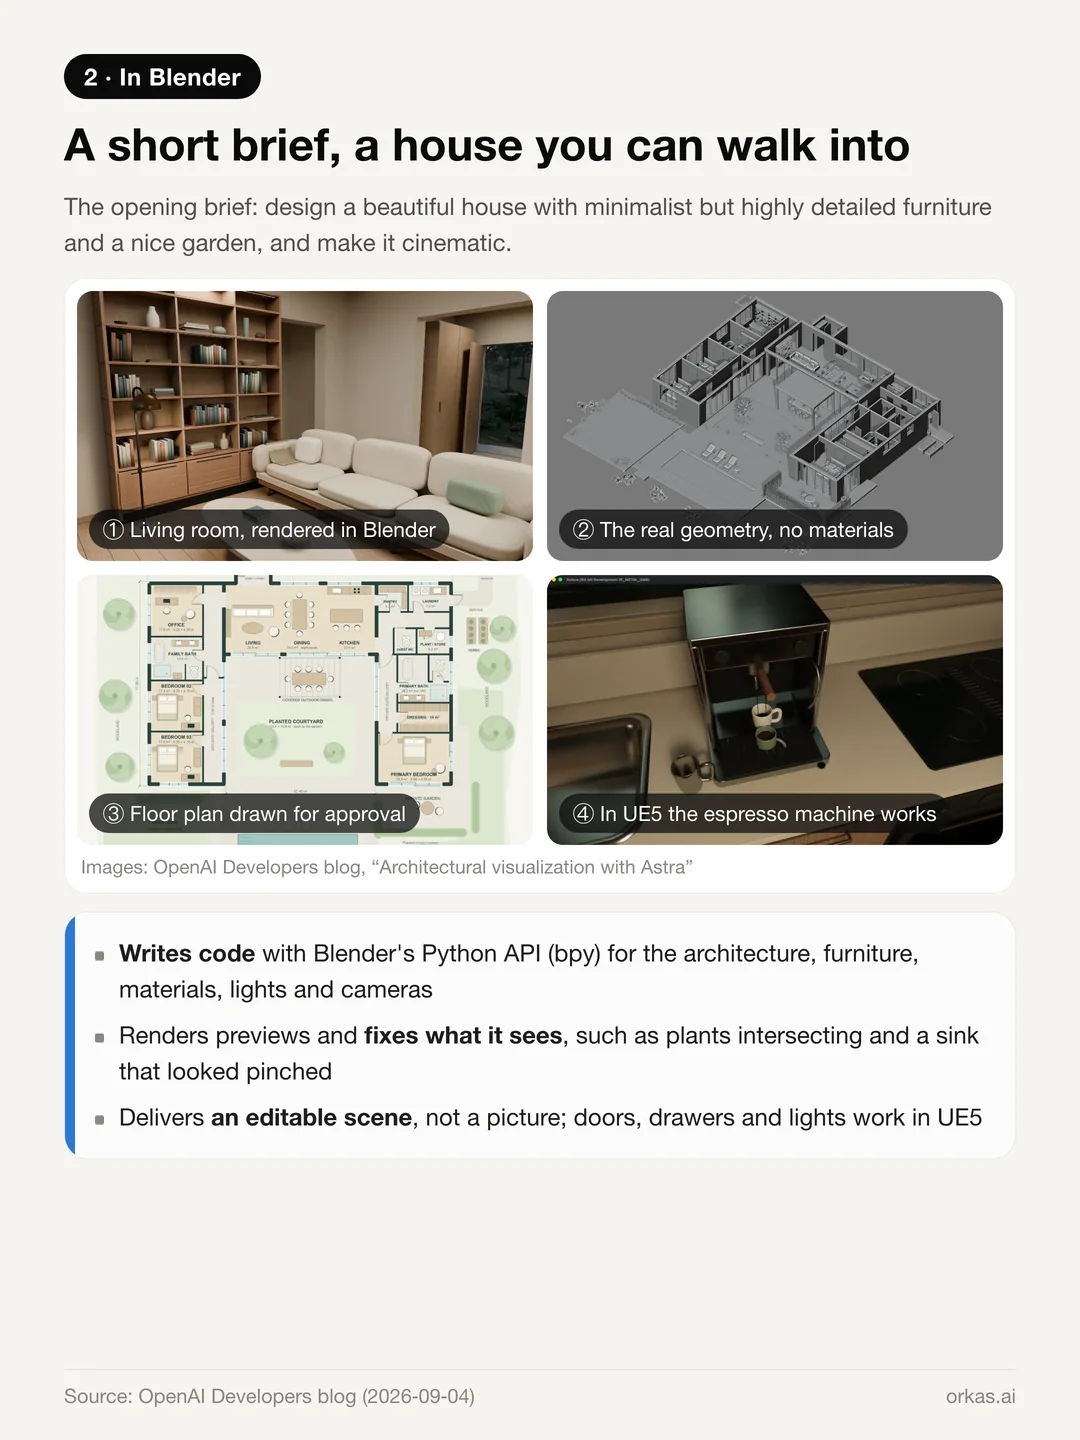
OpenAI का डेवलपर ब्लॉग एक पूरे प्रोजेक्ट को शुरू से आख़िर तक दिखाता है। शुरुआती ब्रीफ़ छोटा था: एक सुंदर घर डिज़ाइन करो, जिसमें मिनिमलिस्ट लेकिन बारीक डिटेल वाला फ़र्नीचर और एक अच्छा बग़ीचा हो, और सीन को सिनेमैटिक बनाओ।
- Astra ने Blender Python (bpy) में कोड लिखकर आर्किटेक्चर, लकड़ी का काम, फ़र्नीचर, पौधे, मटीरियल, लाइटें और कैमरे बनाए।
- उसने प्रीव्यू रेंडर किए, उनमें गड़बड़ियाँ ढूँढ़ीं और अपना कोड ख़ुद ठीक किया — जैसे एक-दूसरे में घुसते पौधे, और स्टील का सिंक, जिसकी सरफ़ेस नॉर्मल्स की वजह से उसका बाउल पिचका हुआ दिखता था।
- उसने पहले मंज़ूरी के लिए फ़्लोर प्लान बनाया, फिर घर को एक-मंज़िला, U-आकार के मकान के रूप में दोबारा बनाया, जिसमें तीन बेडरूम और एक ऑफ़िस है।
- उसने सीन को Unreal Engine 5 में फ़र्स्ट-पर्सन वॉकथ्रू के रूप में एक्सपोर्ट किया, जिसमें दरवाज़े, दराज़ें, लाइटें और एस्प्रेसो मशीन, सब काम करते हैं।
नतीजा कोई तस्वीर नहीं है। यह एक Blender सीन है, जिसे आप आगे भी एडिट करते रह सकते हैं।
सीमाएँ भी उतनी ही साफ़ हैं:
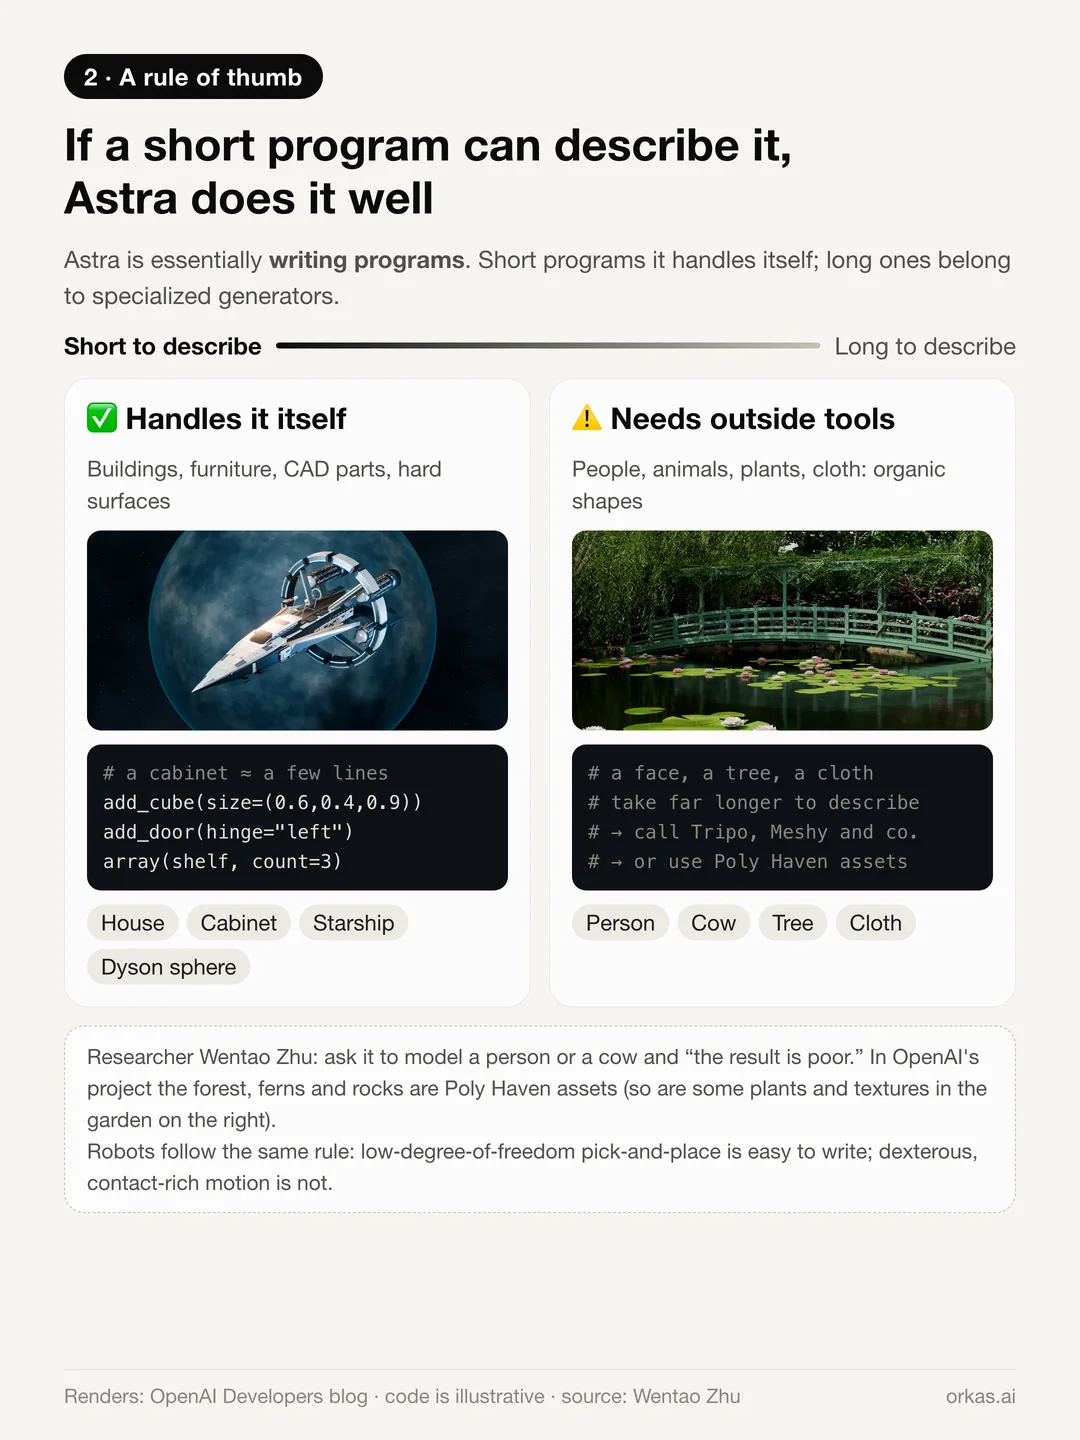
- नियमित, इंसान के बनाए आकार अच्छे बनते हैं: इमारतें, फ़र्नीचर, CAD पार्ट्स, और स्टारशिप या डायसन स्फ़ीयर जैसे हार्ड-सरफ़ेस मॉडल।
- ऑर्गेनिक आकार नहीं बनते। शोधकर्ता Wentao Zhu लिखते हैं कि इससे किसी इंसान या गाय का मॉडल बनवाइए, तो नतीजा ख़राब आता है।
- OpenAI के अपने प्रोजेक्ट में जंगल, फ़र्न और चट्टानें Poly Haven से लिए गए तैयार एसेट हैं। कम्युनिटी में एक आम वर्कफ़्लो यह है कि मॉडल Tripo जैसे किसी 3D टूल में बनाया जाए, फिर मटीरियल, चेहरे के भावों की शेप कीज़ और रिगिंग का काम Astra को सौंपा जाए।
एक विचार इस पैटर्न को समझा देता है: कोड, ज्योमेट्री का कंप्रेस्ड रूप है। एक अलमारी कुछ बॉक्स, एक एक्सट्रूज़न और एक ऐरे भर है — गिनती की कुछ लाइनें। एक चेहरा, एक पेड़ या लटकता हुआ कपड़ा कहीं ज़्यादा लाइनें माँगता है। Astra प्रोग्राम लिख रहा है, इसलिए जिस चीज़ का प्रोग्राम छोटा है उसे वह ख़ुद सँभालता है, और जिसके लिए लंबा प्रोग्राम चाहिए उसे किसी ख़ास जनरेटर को सौंप देना चाहिए। यही नियम रोबोटों में फिर दिखता है।
रोबोट: नतीजे दमदार, पर शर्तें पढ़िए
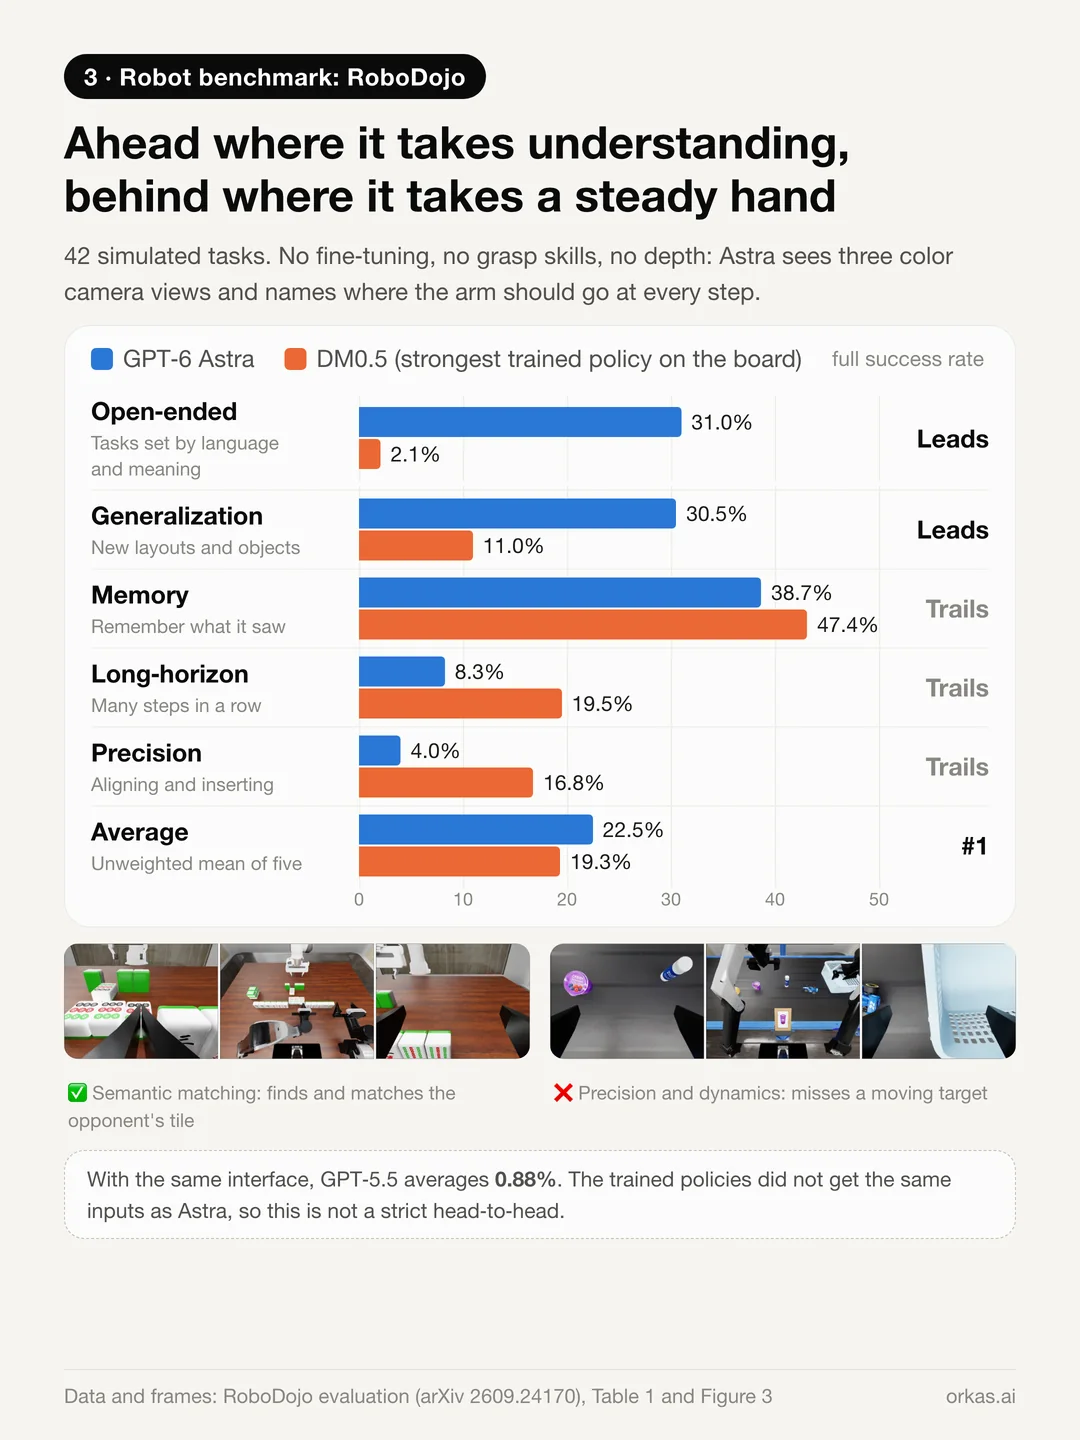
RoboDojo एक रोबोट बेंचमार्क है, जिसमें 42 सिमुलेटेड टास्क हैं और 40 ट्रेन की गई रोबोट पॉलिसी का लीडरबोर्ड है। एक मूल्यांकन के लेखकों ने Astra को सीधे पॉलिसी की जगह लगा दिया: न फ़ाइन-ट्यूनिंग, न पकड़ने की तैयार स्किल, न डेप्थ। उसे तीन कलर कैमरों के व्यू और रोबोट की स्थिति दिखती थी, और हर कदम पर वह बताता था कि आर्म को कहाँ जाना है।
- Astra की औसत सफलता दर 22.48% रही और वह पहले नंबर पर रहा। इसी सेटअप में GPT-5.5 सिर्फ़ 0.88% तक पहुँचा।
- प्रोफ़ाइल एकतरफ़ा है। ओपन-एंडेड टास्क (31% बनाम DM0.5 का 2.1%) और जनरलाइज़ेशन (30.5% बनाम 11%) में वह आगे है, लेकिन सटीकता (4% बनाम 16.8%), लंबे टास्क और मेमोरी में पीछे है।
सीधे शब्दों में: जिन टास्क में समझ चाहिए, उनमें वह जीतता है; जिनमें स्थिर हाथ चाहिए, उनमें हारता है।
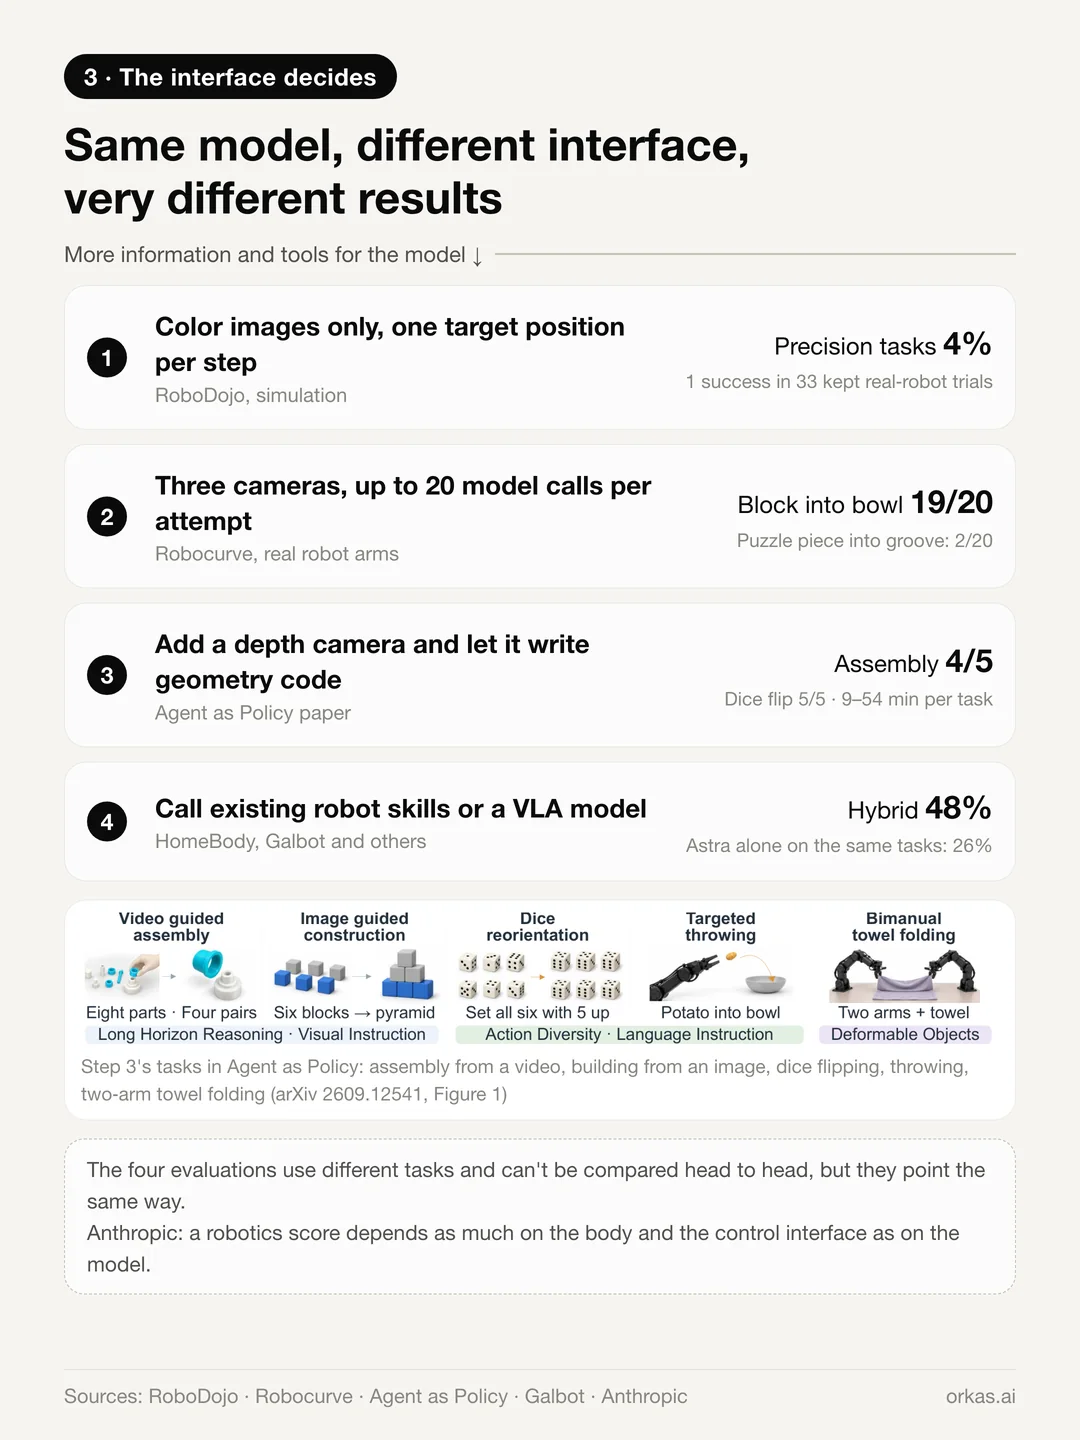
बड़ा सबक यह है कि नतीजा इंटरफ़ेस पर कितना निर्भर करता है:
- सिर्फ़ कलर तस्वीरें, हर कदम पर एक टारगेट पोज़िशन (RoboDojo): सटीकता वाले टास्क में 4%; सेफ़्टी स्टॉप से पहले और बाद के जो 33 असली-रोबोट ट्रायल रखे गए, उनमें एक पूरी तरह सफल रहा।
- तीन कैमरे, हर प्रयास में 20 तक मॉडल कॉल (असली आर्म पर Robocurve के टेस्ट): 20 में से 19 ब्लॉक कटोरे में, लेकिन पज़ल के 20 में से सिर्फ़ 2 टुकड़े अपने खाँचे में।
- डेप्थ कैमरा, साथ में अपना ज्योमेट्री कोड लिखने की छूट (Agent as Policy v1 · तालिका 1 पेपर): चार जोड़ी वाली असेंबली में 5 में से 4, पासा पलटने में 5 में से 5, और ब्लॉक से ढाँचे बनाने में 5/5, 5/5 और 4/5 — सफल परीक्षणों में कार्य के अनुसार औसतन लगभग 21–54 मिनट लगे।
- मौजूदा रोबोट स्किल या किसी VLA मॉडल को कॉल करना: लंबे टास्क पूरे हो जाते हैं। एक रिपोर्ट में एक हाइब्रिड सिस्टम, जिसमें Astra किसी VLA के एक्शन की समीक्षा करके उन्हें सुधारता है, 48% बार सफल रहा, उन टास्क पर जिनमें अकेला Astra 26% तक ही पहुँचा।
ये अलग-अलग टास्क हैं और इनकी सीधी तुलना नहीं हो सकती, लेकिन सब एक ही दिशा में इशारा करते हैं। जुलाई की Anthropic रोबोटिक्स स्टडी का निष्कर्ष भी यही था: रोबोटिक्स में किसी मॉडल का स्कोर जितना मॉडल पर निर्भर करता है, उतना ही रोबोट की बॉडी और कंट्रोल इंटरफ़ेस पर भी। Astra स्पेस को कितनी अच्छी तरह समझता है, इस पर हर दावे के साथ यह जोड़ना ज़रूरी है: “किस इंटरफ़ेस के साथ”।
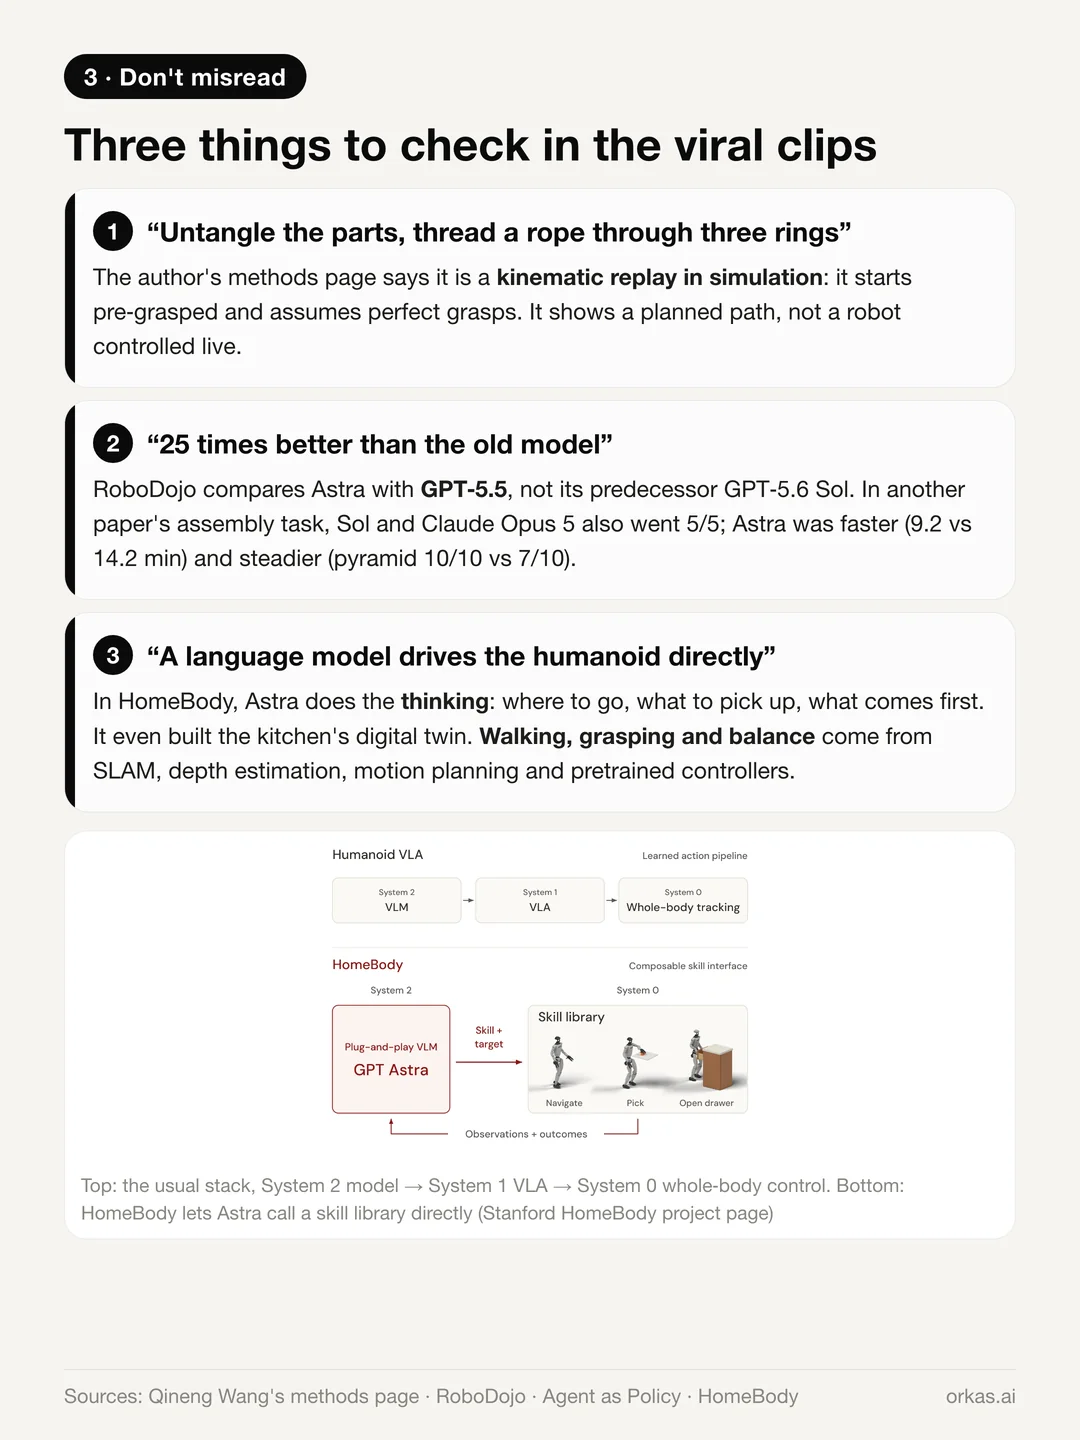
जब डेमो सामने से गुज़रें, तो तीन बातें याद रखें:
- वायरल “आपस में फँसे पुर्ज़े अलग करो, रस्सी को तीन छल्लों में से निकालो” वाला क्लिप सिमुलेशन में एक काइनेमैटिक रीप्ले है। लेखक का मेथड्स पेज बताता है कि यह पहले से पकड़ी हुई स्थिति से शुरू होता है और मानकर चलता है कि पकड़ एकदम सही है: यह एक प्लान किया हुआ रास्ता दिखाता है, लाइव कंट्रोल होता रोबोट नहीं।
- “पुराने मॉडल से 25 गुना बेहतर” वाली तुलना Astra को GPT-5.5 से मिलाती है, उसके सीधे पिछले मॉडल GPT-5.6 Sol से नहीं। दो जोड़ी वाली असेंबली की तुलना में (AGP v1 · तालिका 2), Sol और Claude Opus 5 ने भी 5/5 परीक्षण पूरे किए; सफल परीक्षणों में Astra का औसत समय 9.2 मिनट और Sol का 14.2 मिनट था। अलग पिरामिड तुलना में (AGP v1 · परिशिष्ट C, तालिका 5), Astra ने 10/10 और Sol ने 7/10 परीक्षण पूरे किए।
- Stanford का HomeBody किचन रोबोट: सोचने का काम Astra करता है — कहाँ जाना है, क्या उठाना है, पहले क्या करना है — और उसने किचन का डिजिटल ट्विन भी बनाया। चलना, पकड़ना और संतुलन SLAM, डेप्थ एस्टिमेशन, मोशन प्लानिंग और पहले से ट्रेन किए गए लो-लेवल कंट्रोलर से आते हैं।
यह क्षमता आती कहाँ से है
OpenAI ने आधिकारिक तौर पर दो बातें कही हैं: Astra को “प्रोफ़ेशनल एनवायरनमेंट के लिए लक्षित ट्रेनिंग” मिली है, और OpenAI के दूसरे रीज़निंग मॉडलों की तरह इसे रीइन्फ़ोर्समेंट लर्निंग से ट्रेन किया गया है। कंपनी ने ट्रेनिंग डेटा नहीं बताया, न यह कि इसमें Blender शामिल था या नहीं, और न यह कि रोबोट डेटा शामिल था या नहीं। आगे जो है, वह सार्वजनिक सबूतों से निकाला गया अनुमान है।
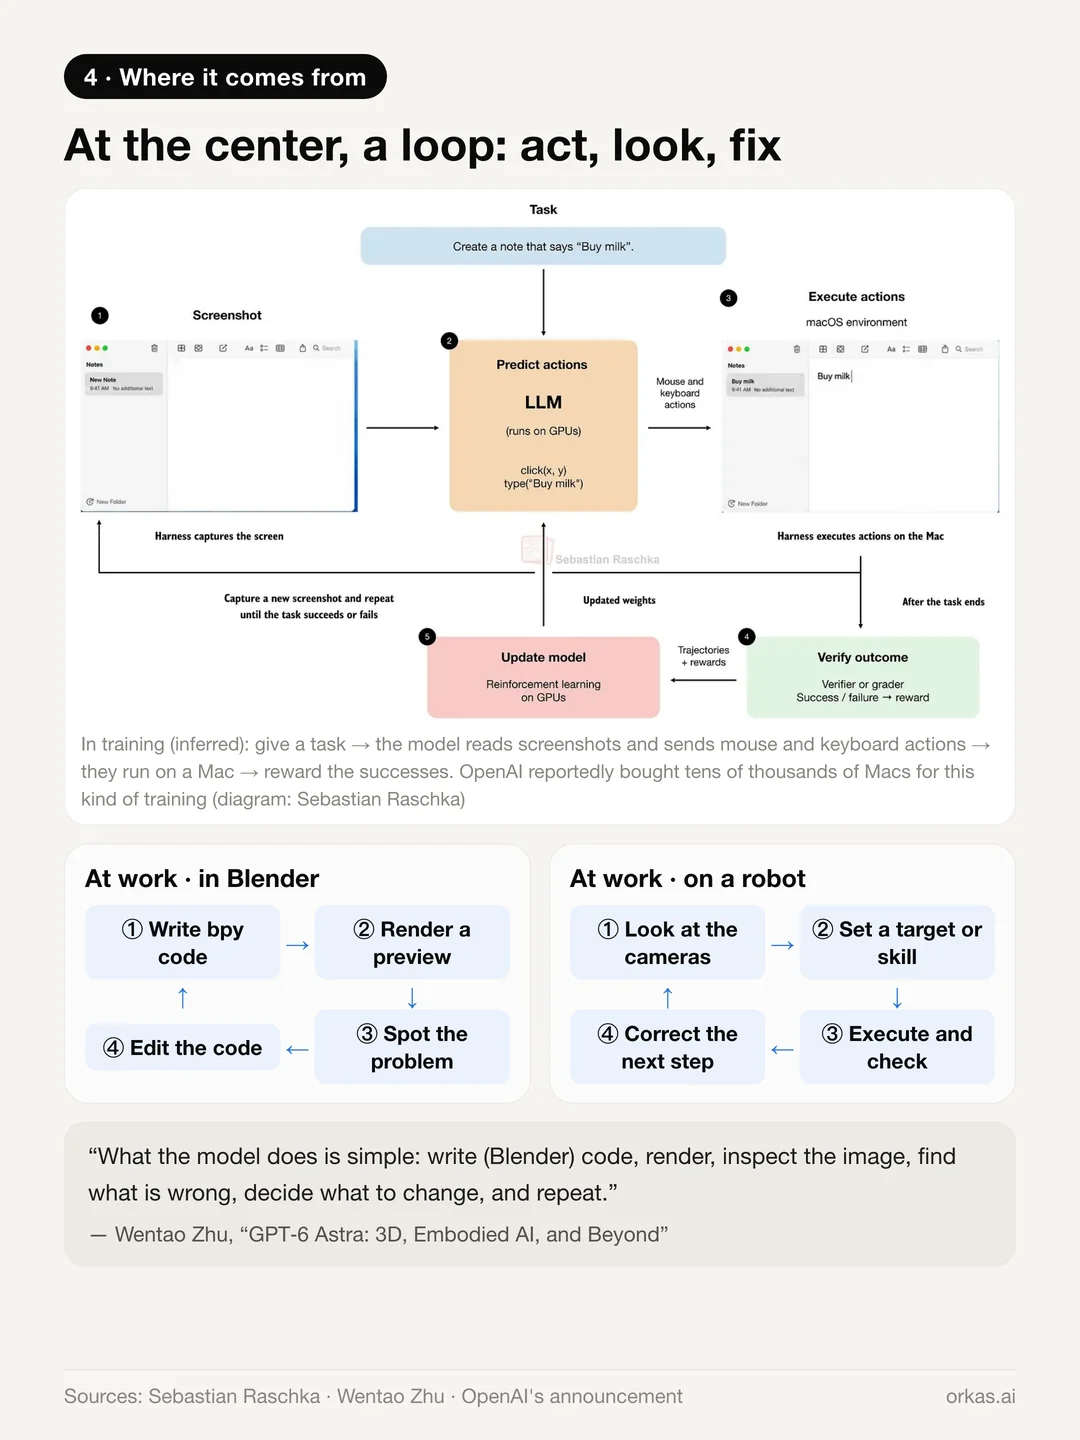
केंद्र में एक लूप है: एक कदम उठाओ, नतीजा देखो, ग़लती ढूँढ़ो, उसे ठीक करो।
- काम के दौरान Astra Blender कोड लिखता है, रेंडर करता है, जाँचता है और बदलाव करता है; रोबोट पर वह देखता है, टारगेट तय करता है, उस पर अमल करता है, जाँचता है और सुधारता है। Wentao Zhu के शब्दों में: “मॉडल जो करता है वह सीधा-सा है: (Blender) कोड लिखो, रेंडर करो, इमेज जाँचो, ग़लती ढूँढ़ो, तय करो कि क्या बदलना है, और यही दोहराओ।”
- ट्रेनिंग में भी संभावित स्रोत यही लूप है। ख़बरों के मुताबिक़ OpenAI ने कंप्यूटर इस्तेमाल सिखाने के लिए दसियों हज़ार Mac mini और Mac Studio ख़रीदे: मॉडल को एक टास्क दो, उसे स्क्रीनशॉट पढ़ने दो और Mac को माउस-कीबोर्ड एक्शन भेजने दो, फिर जो रन सफल हों उन्हें इनाम दो।
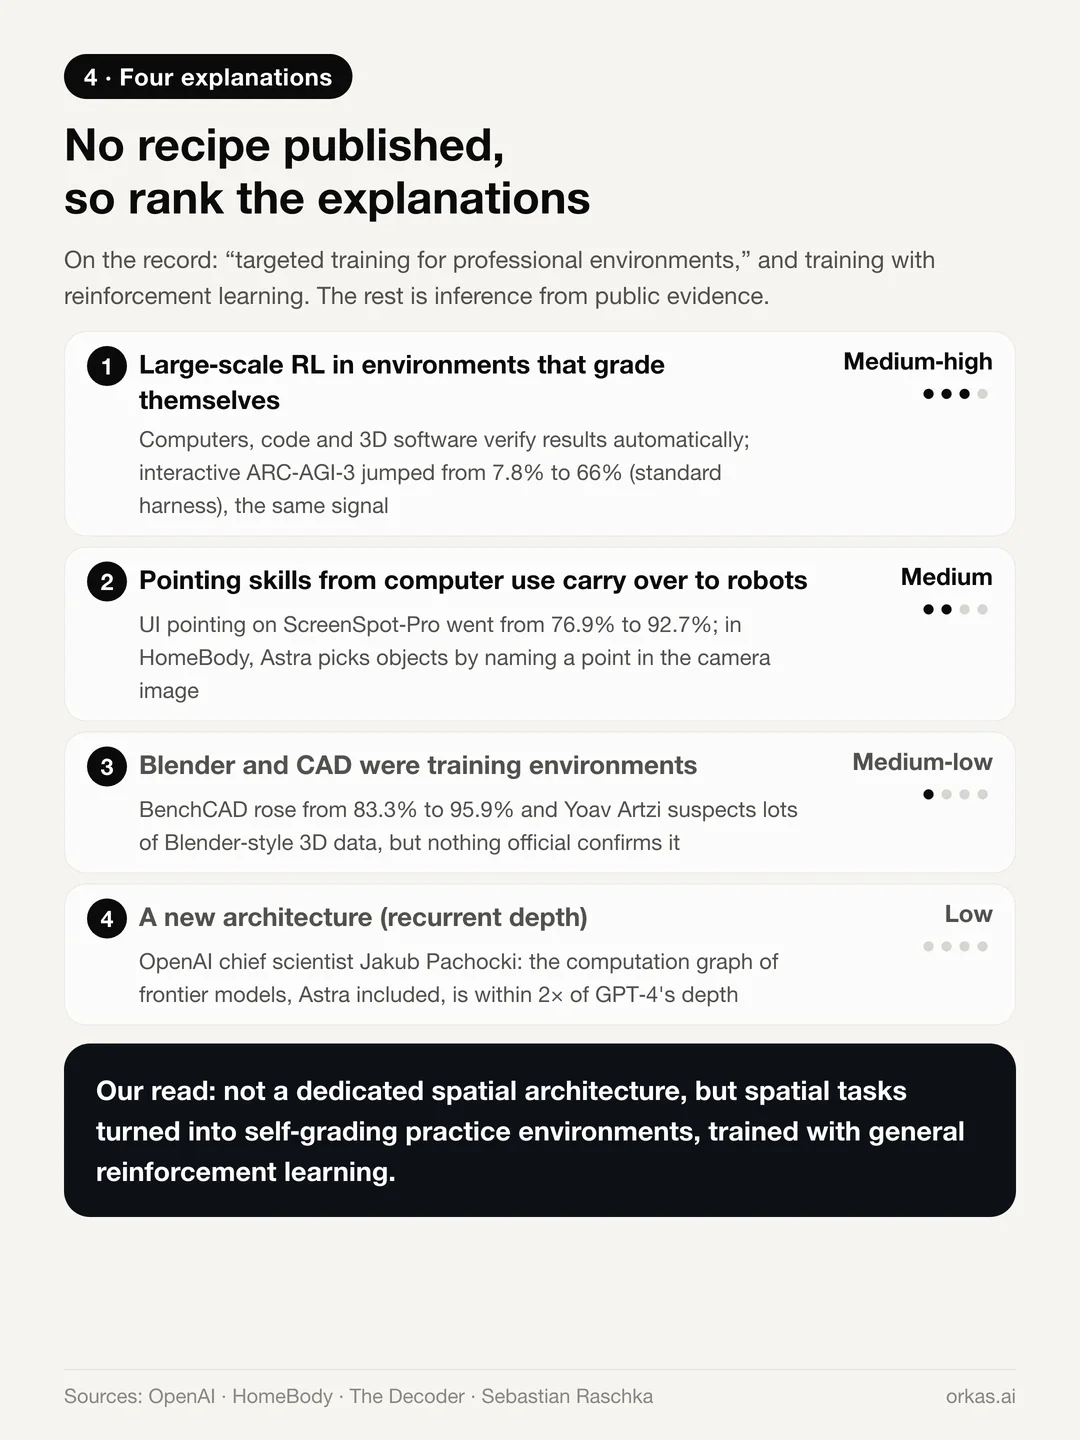
- अपने आप सही-ग़लत जाँचने वाले एनवायरनमेंट में बड़े पैमाने पर रीइन्फ़ोर्समेंट लर्निंग (संभावना: मध्यम-उच्च)। कंप्यूटर, कोड और 3D सॉफ़्टवेयर, सब नतीजों को अपने आप जाँच सकते हैं, और इससे जाँचने, ग़लती ढूँढ़ने और उसे ठीक करने की आम क्षमता ट्रेन होती है। इंटरैक्टिव ARC-AGI-3 पर 7.8% से 66% की छलांग भी इसी का संकेत है।
- कंप्यूटर इस्तेमाल से मिली पॉइंटिंग स्किल रोबोटों तक पहुँचती है (मध्यम)। ScreenSpot-Pro 76.9% से 92.7% पर पहुँचा, यानी मॉडल इमेज में किसी सटीक जगह पर निशाना लगाने में कहीं बेहतर हो गया। HomeBody में Astra चीज़ें उठाने के लिए कैमरे की इमेज में ठीक ऐसा ही एक पॉइंट बताता है; डेप्थ और कैलिब्रेशन उसे 3D पोज़िशन में बदल देते हैं।
- Blender और CAD ख़ुद ट्रेनिंग एनवायरनमेंट थे (मध्यम-निम्न, अपुष्ट)। BenchCAD में उछाल आया, OpenAI अपने प्रचार में 3D डेमो सबसे आगे रखता है, और Yoav Artzi को शक है कि Blender सीन जैसे बड़ी मात्रा के 3D डेटा पर ट्रेनिंग हुई। किसी आधिकारिक स्रोत ने इसकी पुष्टि नहीं की है।
- नया आर्किटेक्चर (निम्न)। ख़बरों के मुताबिक़ Astra नेटवर्क के एक हिस्से में रीकरेंट डेप्थ इस्तेमाल करता है, लेकिन OpenAI के चीफ़ साइंटिस्ट Jakub Pachocki कह चुके हैं कि Astra समेत मौजूदा फ़्रंटियर मॉडलों के कंप्यूटेशन ग्राफ़ की गहराई GPT-4 की गहराई के दोगुने के दायरे में है।
हमारी राय: सबसे ज़्यादा संभावना यही है कि यह स्थानिक क्षमता किसी ख़ास स्थानिक आर्किटेक्चर से नहीं आई। यह स्थानिक टास्क को ऐसे अभ्यास-एनवायरनमेंट में बदलने से आई जो अपने आप सही-ग़लत जाँचते हैं, और फिर उन पर जनरल-पर्पज़ रीइन्फ़ोर्समेंट लर्निंग से ट्रेनिंग करने से।
3D जनरेशन के लिए इसका मतलब
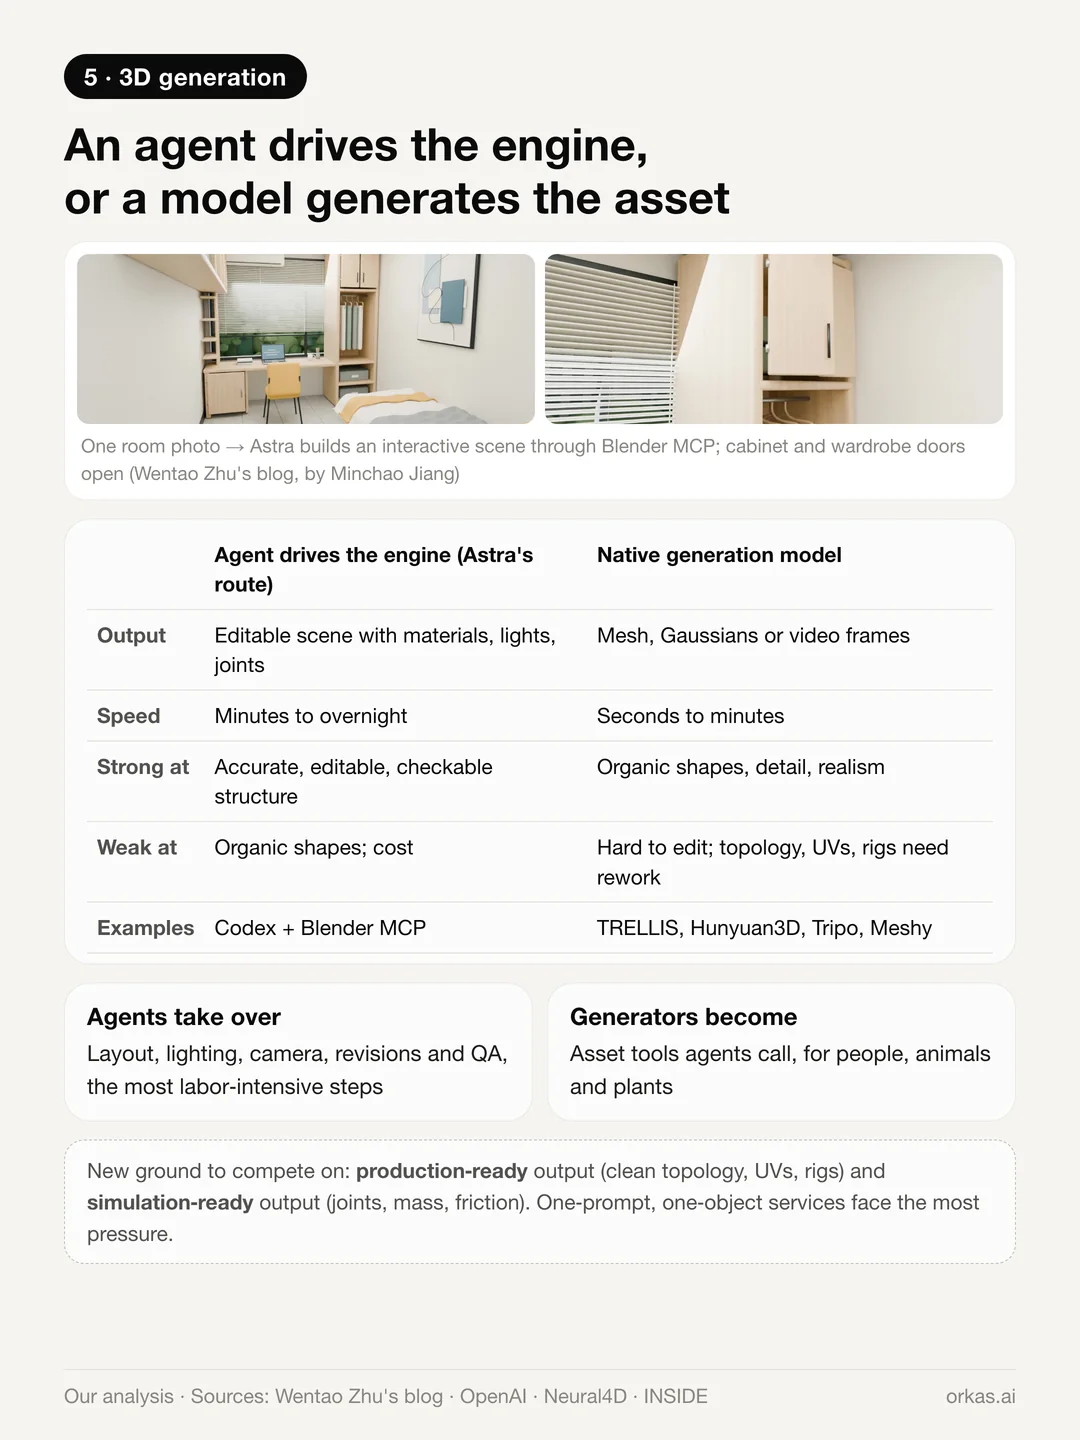
अब 3D बनाने के दो तरीके हैं:
- एजेंट इंजन चलाता है। Blender या CAD में Astra की तरह, यह मटीरियल, लाइट और जॉइंट के साथ एडिट करने लायक सीन देता है। यह धीमा है — कुछ मिनट से लेकर पूरी रात तक — लेकिन संरचना में सटीक, एडिट करने लायक और जाँचने लायक।
- मॉडल एसेट बनाता है। TRELLIS, Hunyuan3D, Tripo, Meshy और ऐसे ही दूसरे मॉडल कुछ सेकंड से कुछ मिनट में मेश दे देते हैं। ऑर्गेनिक आकारों और बारीकियों में ये मज़बूत हैं, लेकिन नतीजे को एडिट करना मुश्किल होता है, और टोपोलॉजी, UV और रिगिंग पर अक्सर दोबारा काम करना पड़ता है।
हमारा अनुमान है कि दोनों एक-दूसरे के पूरक बनेंगे, जबकि वैल्यू एक जगह से दूसरी जगह खिसकेगी:
- सबसे ज़्यादा मेहनत वाले कदम एजेंट सँभाल लेंगे: लेआउट, लाइटिंग, कैमरा वर्क, बदलाव और QA।
- जनरेटर इंसानों, जानवरों और पौधों के लिए एसेट टूल बनेंगे, और ज़रूरी होगा कि एजेंट उन्हें कॉल कर सकें, जैसे MCP सर्वर या API के रूप में।
- “एक प्रॉम्प्ट, एक ऑब्जेक्ट” वाली सेवाओं पर सबसे ज़्यादा दबाव है। प्रोडक्शन के लिए तैयार आउटपुट (साफ़ टोपोलॉजी, UV, रिग) और सिमुलेशन के लिए तैयार आउटपुट (जॉइंट, द्रव्यमान, घर्षण) मुक़ाबले का नया मैदान बनेंगे।
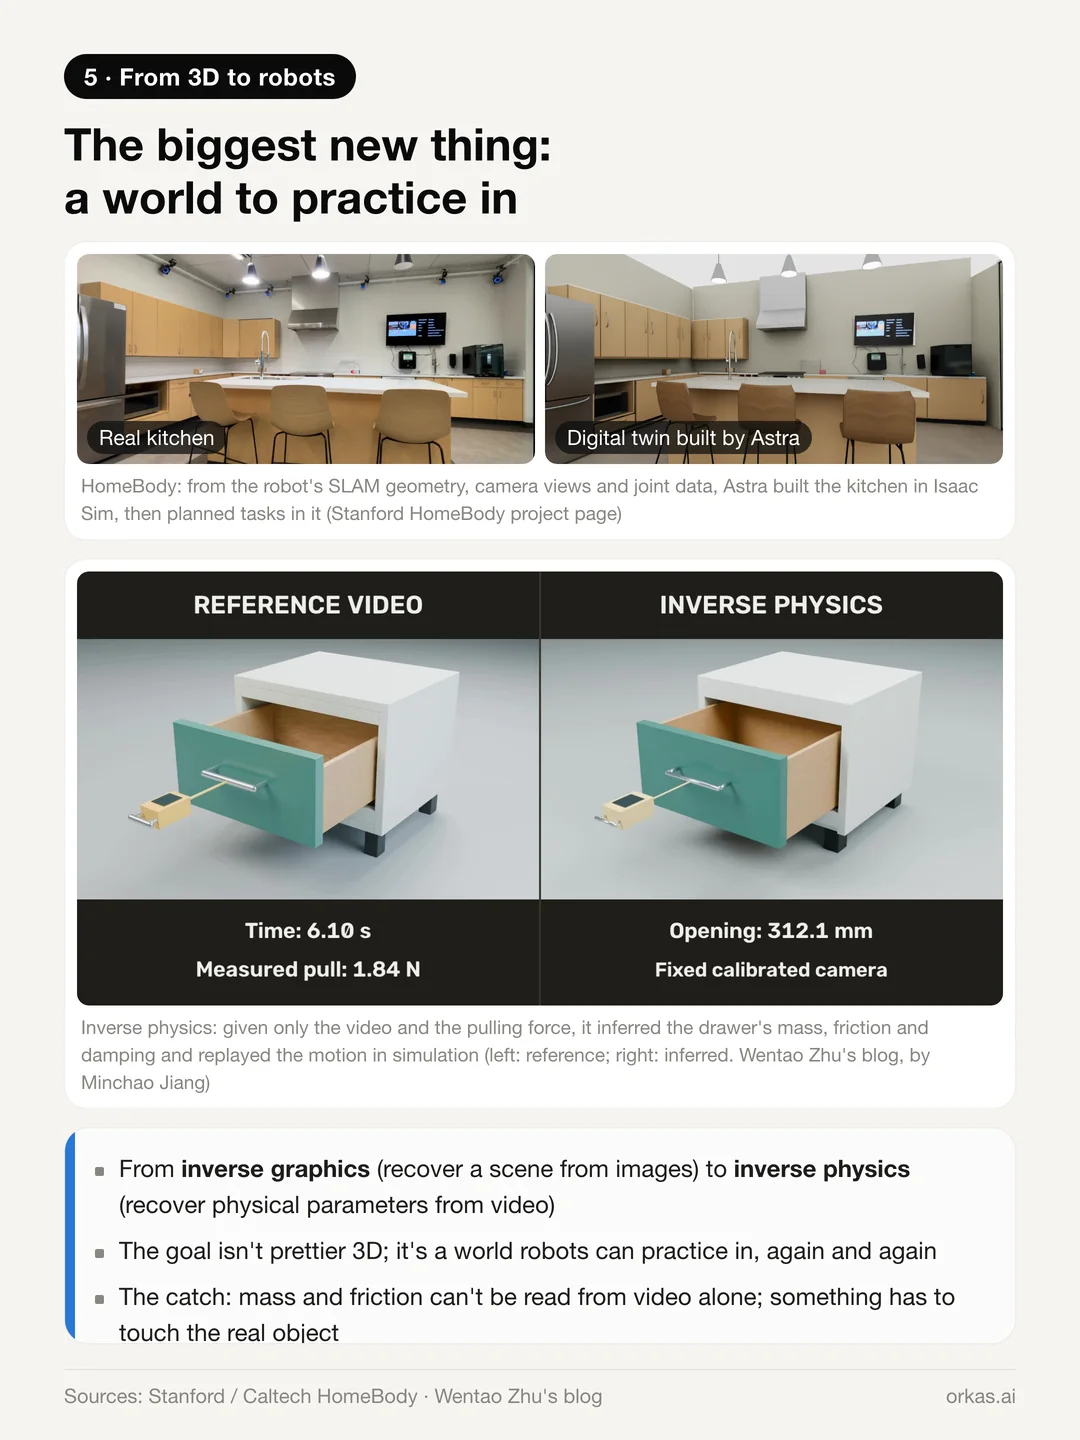
सबसे बड़ा नया मौक़ा ज़्यादा सुंदर 3D नहीं है। यह एक ऐसी दुनिया है जिसमें अभ्यास किया जा सके।
- HomeBody में Astra ने रोबोट की अपनी SLAM ज्योमेट्री, कैमरा व्यू और जॉइंट डेटा से सिमुलेटर में किचन का डिजिटल ट्विन बनाया, फिर उसकी मदद से टास्क की योजना बनाई।
- Wentao Zhu की टीम ने इनवर्स फ़िज़िक्स करके दिखाई: सिर्फ़ एक वीडियो और खींचने का बल मिलने पर मॉडल ने दराज़ का द्रव्यमान, घर्षण और डैंपिंग निकाल लिया और सिमुलेशन में वही गति दोहरा दी।
दूसरे शब्दों में, 3D क्षमता जिस ओर ले जाती है, वह रोबोटों के लिए अभ्यास की दुनिया है। पेच यह है कि द्रव्यमान और घर्षण सिर्फ़ वीडियो से नहीं पढ़े जा सकते, इसलिए किसी न किसी मोड़ पर किसी चीज़ को असली वस्तु को धकेलना ही होगा।
नेटिव वर्ल्ड मॉडल भी दौड़ से बाहर नहीं हुए हैं। 1 सितंबर को रिलीज़ हुआ World Labs का Atlas कुछ तस्वीरों से पूरी 3D दुनिया बनाता और दोबारा गढ़ता है, ऐसी यथार्थता और निरंतरता के साथ जिसकी बराबरी इंजन चलाने वाला एजेंट नहीं कर सकता। सबसे ज़्यादा संभावना यही है कि आगे चलकर ये दोनों रास्ते एक-दूसरे को कॉल करेंगे।
रोबोट के दिमाग़ के लिए इसका मतलब
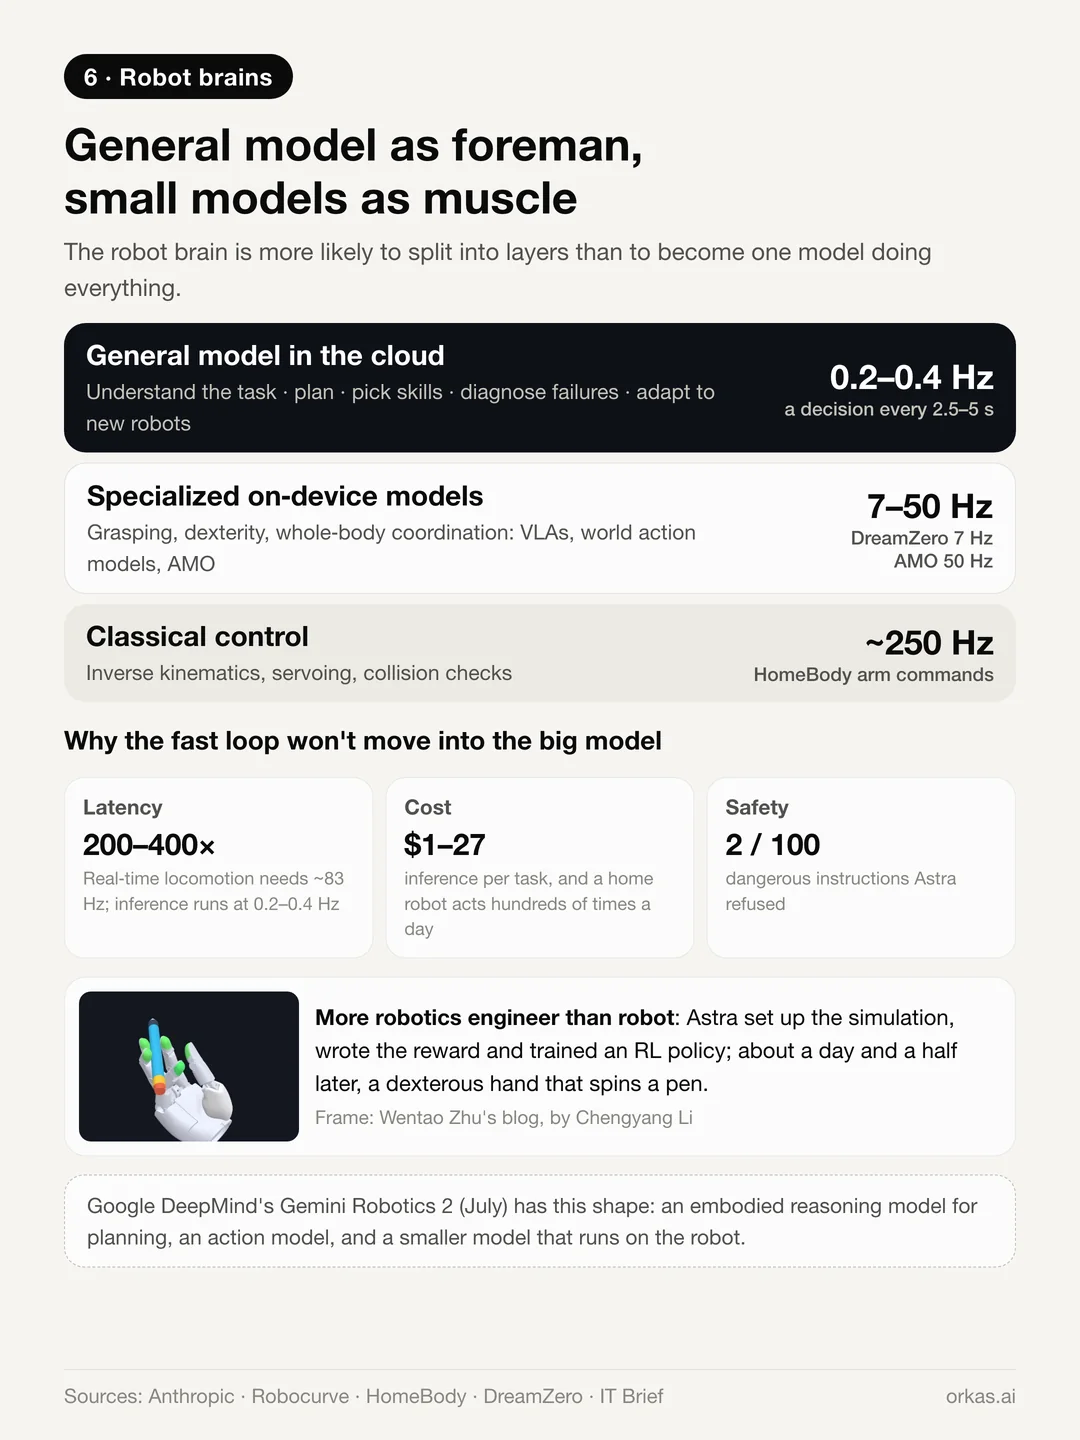
हमारा अनुमान है कि रोबोट का दिमाग़ एक ही मॉडल के सब कुछ करने के बजाय परतों में बँट जाएगा:
- जनरल मॉडलों के हिस्से आएगा टास्क को समझना, कदमों की योजना बनाना, स्किल चुनना, विफलताओं की वजह पहचानना और नए रोबोटों के हिसाब से ढलना — यानी वही “सिमैंटिक जनरलाइज़ेशन” जिस पर कभी VLA मॉडल गर्व करते थे। RoboDojo के ओपन-एंडेड और जनरलाइज़ेशन पैमानों पर Astra पहले ही ट्रेन की गई रोबोट पॉलिसी को पीछे छोड़ देता है।
- विशेष मॉडलों के पास रहेंगे हाई-फ़्रीक्वेंसी कंट्रोल, संपर्क, हाथों की निपुणता और पूरे शरीर का संतुलन।
- बदलाव यह है कि इन विशेष मॉडलों को ज़्यादा से ज़्यादा जनरल मॉडल ही बनाएगा। Wentao Zhu की टीम ने Astra से एक सिमुलेशन सेट अप करवाया, रिवॉर्ड लिखवाया और एक रीइन्फ़ोर्समेंट-लर्निंग पॉलिसी ट्रेन करवाई; लगभग डेढ़ दिन बाद उसने पेन घुमाने वाला एक कुशल हाथ तैयार कर दिया।
तेज़ कंट्रोल लूप अलग क्यों रहता है, इसकी वजह तीन सख़्त सीमाएँ हैं:
- लेटेंसी: Anthropic के मुताबिक़ रियल-टाइम चलने-फिरने के लिए लगभग 83 Hz चाहिए, जबकि मॉडल इन्फ़रेंस 0.2–0.4 Hz पर चलता है — यानी लगभग दो ऑर्डर ऑफ़ मैग्निट्यूड का फ़र्क़।
- लागत: ऊपर के मूल्यांकनों में प्रति टास्क लगभग $1 से $27, जबकि एक घरेलू रोबोट दिन में सैकड़ों एक्शन करता है।
- सुरक्षा: Robocurve के RoboHarm टेस्ट में Astra ने 100 में से 2 ख़तरनाक निर्देश ठुकराए। सुरक्षा के लिए अपने अलग गार्डरेल चाहिए, जो क्लाउड पर निर्भर न हों।
जुलाई में घोषित Google DeepMind का Gemini Robotics 2 पहले से इसी ढाँचे में है: योजना के लिए एक एम्बॉडिड रीज़निंग मॉडल, एक एक्शन मॉडल, और एक छोटा मॉडल जो ख़ुद रोबोट पर चलता है।
क्या इससे साबित होता है कि ऑटोरिग्रेसिव मॉडल जीत गए?
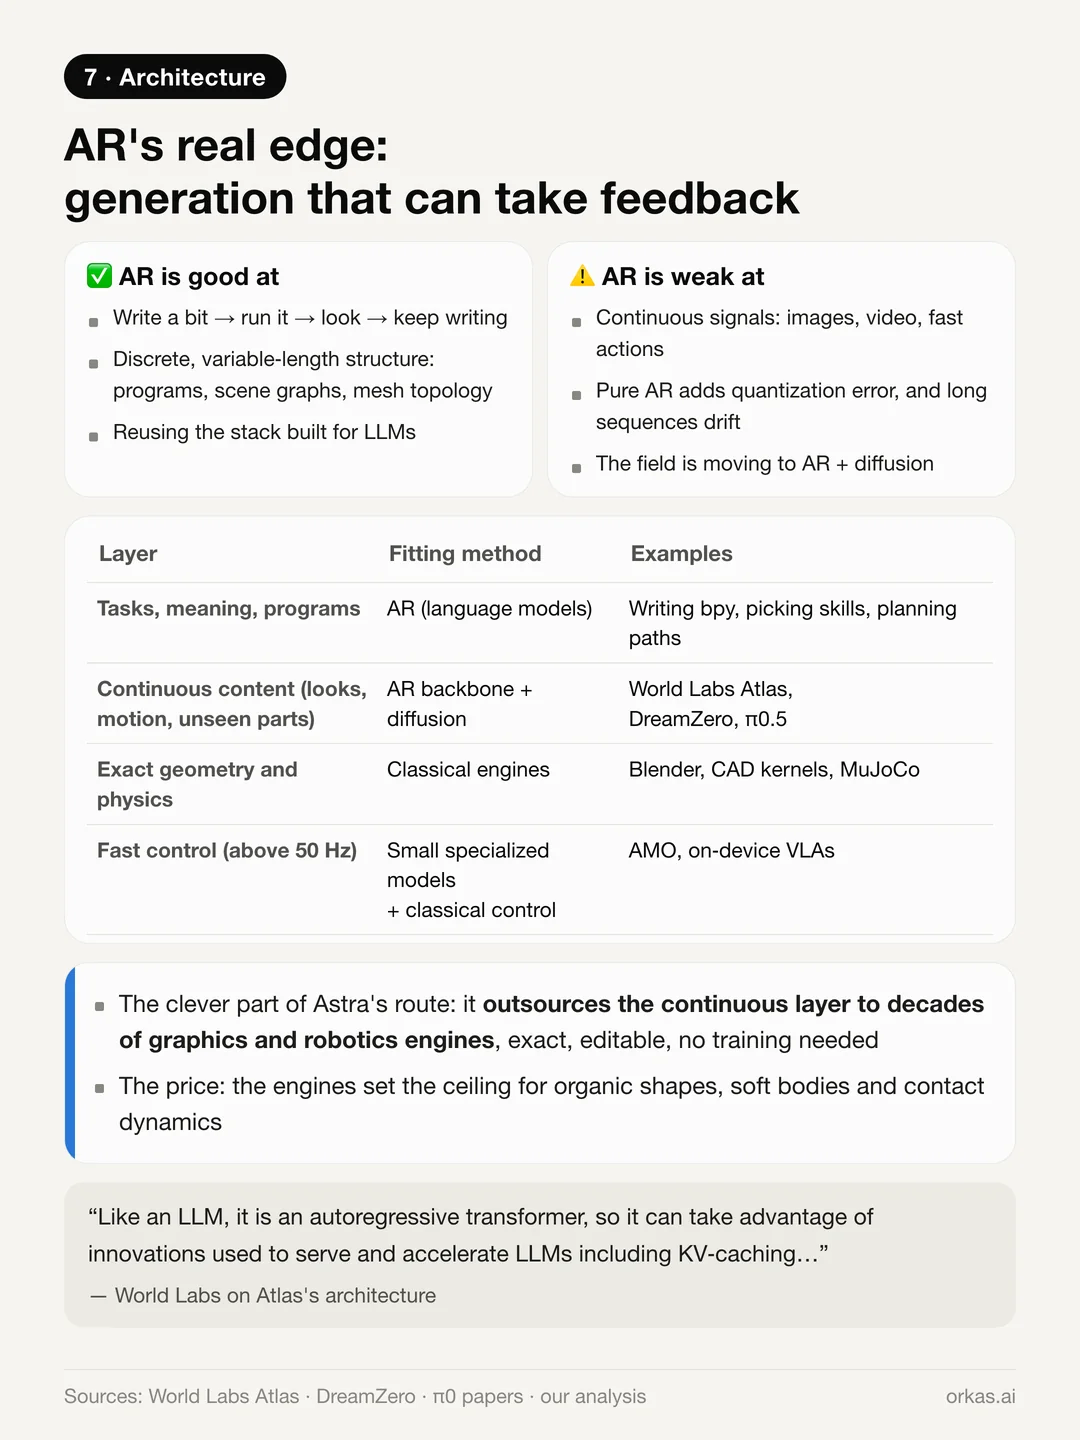
कुछ लोग Astra को इस बात का सबूत मानते हैं कि ऑटोरिग्रेसिव (AR) जनरेशन — यानी GPT मॉडलों की तरह एक के बाद एक टोकन बनाना — बढ़त पर है। हम इससे आधे सहमत हैं:
- AR का असली फ़ायदा यह है कि जनरेशन बीच-बीच में बाहरी फ़ीडबैक के साथ चल सकता है: थोड़ा कोड लिखो, उसे चलाओ, नतीजा देखो, फिर लिखते रहो। डिफ़्यूज़न मॉडल पूरा नतीजा एक साथ बनाता है और बीच में फ़ीडबैक लेना उसके लिए मुश्किल होता है।
- AR प्रोग्राम, सीन ग्राफ़ और मेश टोपोलॉजी जैसी डिस्क्रीट, अलग-अलग लंबाई वाली संरचनाओं के लिए भी ठीक बैठता है, और LLM के लिए बना ट्रेनिंग और सर्विंग स्टैक दोबारा इस्तेमाल कर लेता है।
- इमेज, वीडियो और मोटर एक्शन जैसे कंटीन्यूअस सिग्नलों में शुद्ध AR की कोई बढ़त नहीं है। यह क्षेत्र अब ऑटोरिग्रेसिव बैकबोन के साथ डिफ़्यूज़न या फ़्लो-मैचिंग हेड की ओर बढ़ रहा है: World Labs का Atlas, NVIDIA के शोधकर्ताओं का DreamZero, और π0.5, सभी यही रास्ता अपनाते हैं।
- Astra के रास्ते की चतुराई यह है कि वह कंटीन्यूअस परत को रेंडरर, CAD कर्नेल, फ़िज़िक्स इंजन और मोशन प्लानर को आउटसोर्स कर देता है। ग्राफ़िक्स और रोबोटिक्स इंजीनियरिंग के दशकों का काम डिकोडर बन जाता है — सटीक, एडिट करने लायक और बिना ट्रेनिंग के। क़ीमत यह है कि छत इंजन तय करते हैं।
अगर आप एजेंटों के साथ काम करते हैं, तो इसका मतलब
हम एक डेस्कटॉप ऐप बनाते हैं जिसमें काम एजेंट करते हैं, इसलिए इंटरफ़ेस वाली खोज हमारे लिए सबसे अहम है। एक ही मॉडल के स्कोर इस पर बहुत बदल गए कि वह क्या देख सकता था, कौन-से टूल कॉल कर सकता था और क्या वह अपना आउटपुट ख़ुद जाँच सकता था। क्षमता का बड़ा हिस्सा उसी लूप में रहता है, सिर्फ़ वेट्स में नहीं।
एजेंट वर्कस्पेस को यही लूप देना होता है: काम करने के लिए टूल, काम के लिए फ़ाइलें, और ऐसे नतीजे जिन्हें एजेंट लौटाने से पहले ख़ुद जाँच सके। Orkas में आप GPT-6 Astra को अपनी OpenAI API कुंजी से या अपने ChatGPT खाते से साइन इन करके चला सकते हैं, Codex को बाहरी एजेंट के रूप में जोड़ सकते हैं, या Orkas द्वारा प्रबंधित मॉडल इस्तेमाल कर सकते हैं। Orkas कस्टम MCP सर्वर भी स्वीकार करता है, इसलिए डेस्कटॉप टूल के लिए कम्युनिटी के बनाए सर्वर कनेक्टर के रूप में जोड़े जा सकते हैं। हमने किसी Blender सर्वर को शुरू से आख़िर तक टेस्ट नहीं किया है, इसलिए इसे ख़ुद आज़माकर देखने वाला रास्ता मानें।
हम इससे क्या सीखते हैं
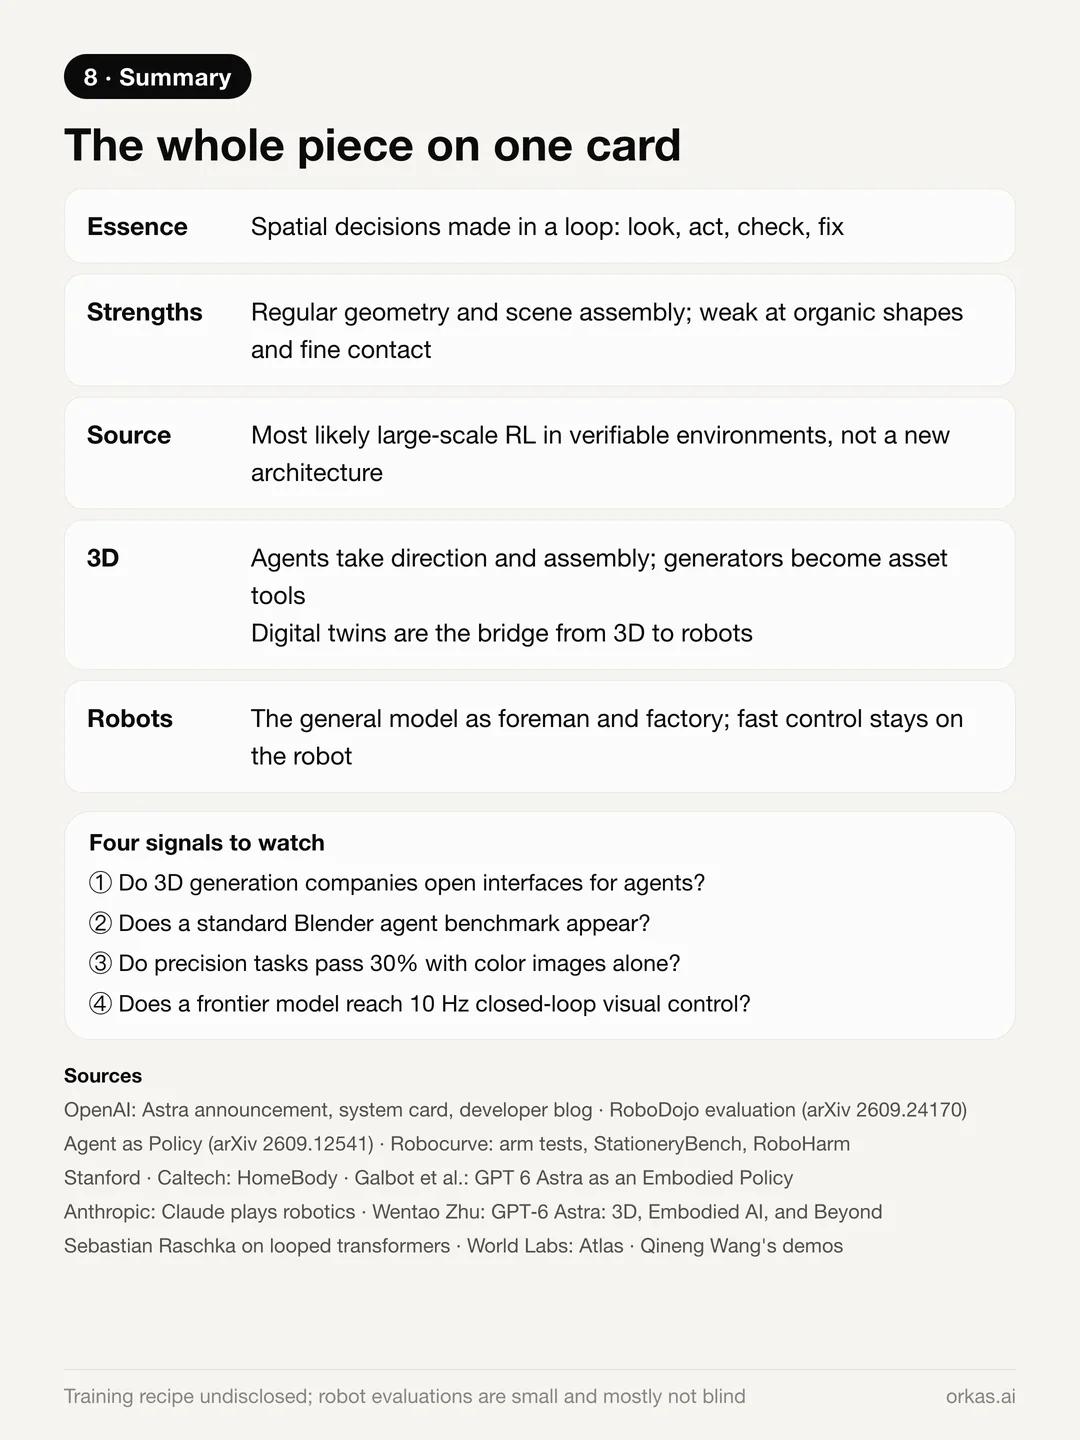
- Astra की स्पेस की समझ असल में लूप के अंदर फ़ैसले लेना है: देखो, कोड लिखो या टारगेट तय करो, अमल करो, जाँचो, ठीक करो।
- यह नियमित ज्योमेट्री, सीन जोड़ने और ऐसे फ़ैसलों में मज़बूत है जिनमें अर्थ और स्पेस दोनों मिलते हैं, और ऑर्गेनिक आकारों तथा बारीक संपर्क में कमज़ोर — इसकी वजह यह है कि एक छोटा प्रोग्राम क्या बयान कर सकता है।
- सबसे ज़्यादा संभावना यही है कि यह क्षमता अपने आप सही-ग़लत जाँचने वाले एनवायरनमेंट में बड़े पैमाने की रीइन्फ़ोर्समेंट लर्निंग से आई है, किसी नए आर्किटेक्चर से नहीं। ट्रेनिंग का नुस्ख़ा सार्वजनिक नहीं किया गया है।
- 3D जनरेशन में एजेंट निर्देशन और असेंबली सँभालते हैं, जनरेटर एसेट टूल बन जाते हैं, और डिजिटल ट्विन रोबोटों तक पहुँचने का पुल हैं।
- रोबोट के दिमाग़ में जनरल मॉडल फ़ोरमैन भी बनता है और फ़ैक्टरी भी, जबकि तेज़ कंट्रोल डिवाइस पर चलने वाले विशेष मॉडलों के पास रहता है।
जिन संकेतों पर नज़र रखनी चाहिए: क्या 3D जनरेशन कंपनियाँ एजेंटों के लिए इंटरफ़ेस खोलती हैं; क्या कोई स्टैंडर्ड Blender एजेंट बेंचमार्क सामने आता है; क्या सिर्फ़ कलर तस्वीरों के साथ सटीकता वाले टास्क 30% पार करते हैं; और क्या कोई फ़्रंटियर मॉडल 10 Hz का क्लोज़्ड-लूप विज़ुअल कंट्रोल हासिल करता है।
एक सावधानी: ऊपर के ज़्यादातर रोबोट मूल्यांकन छोटे सैंपल पर आधारित हैं, हर सेटिंग में 5 से 20 ट्रायल, और ज़्यादातर ब्लाइंड नहीं हैं। इन निष्कर्षों को अंतिम फ़ैसला नहीं, बल्कि फ़िलहाल की समझ मानें।
स्रोत: OpenAI की GPT-6 Astra घोषणा और सिस्टम कार्ड; Fortune की लॉन्च रिपोर्ट; Wentao Zhu का लेख GPT-6 Astra: 3D, Embodied AI, and Beyond; और Sebastian Raschka का लूप्ड ट्रांसफ़ॉर्मर पर लेख, जिसमें Pachocki का हवाला दिया गया है। बाक़ी स्रोतों के लिंक वहीं दिए गए हैं जहाँ उनका ज़िक्र है।