
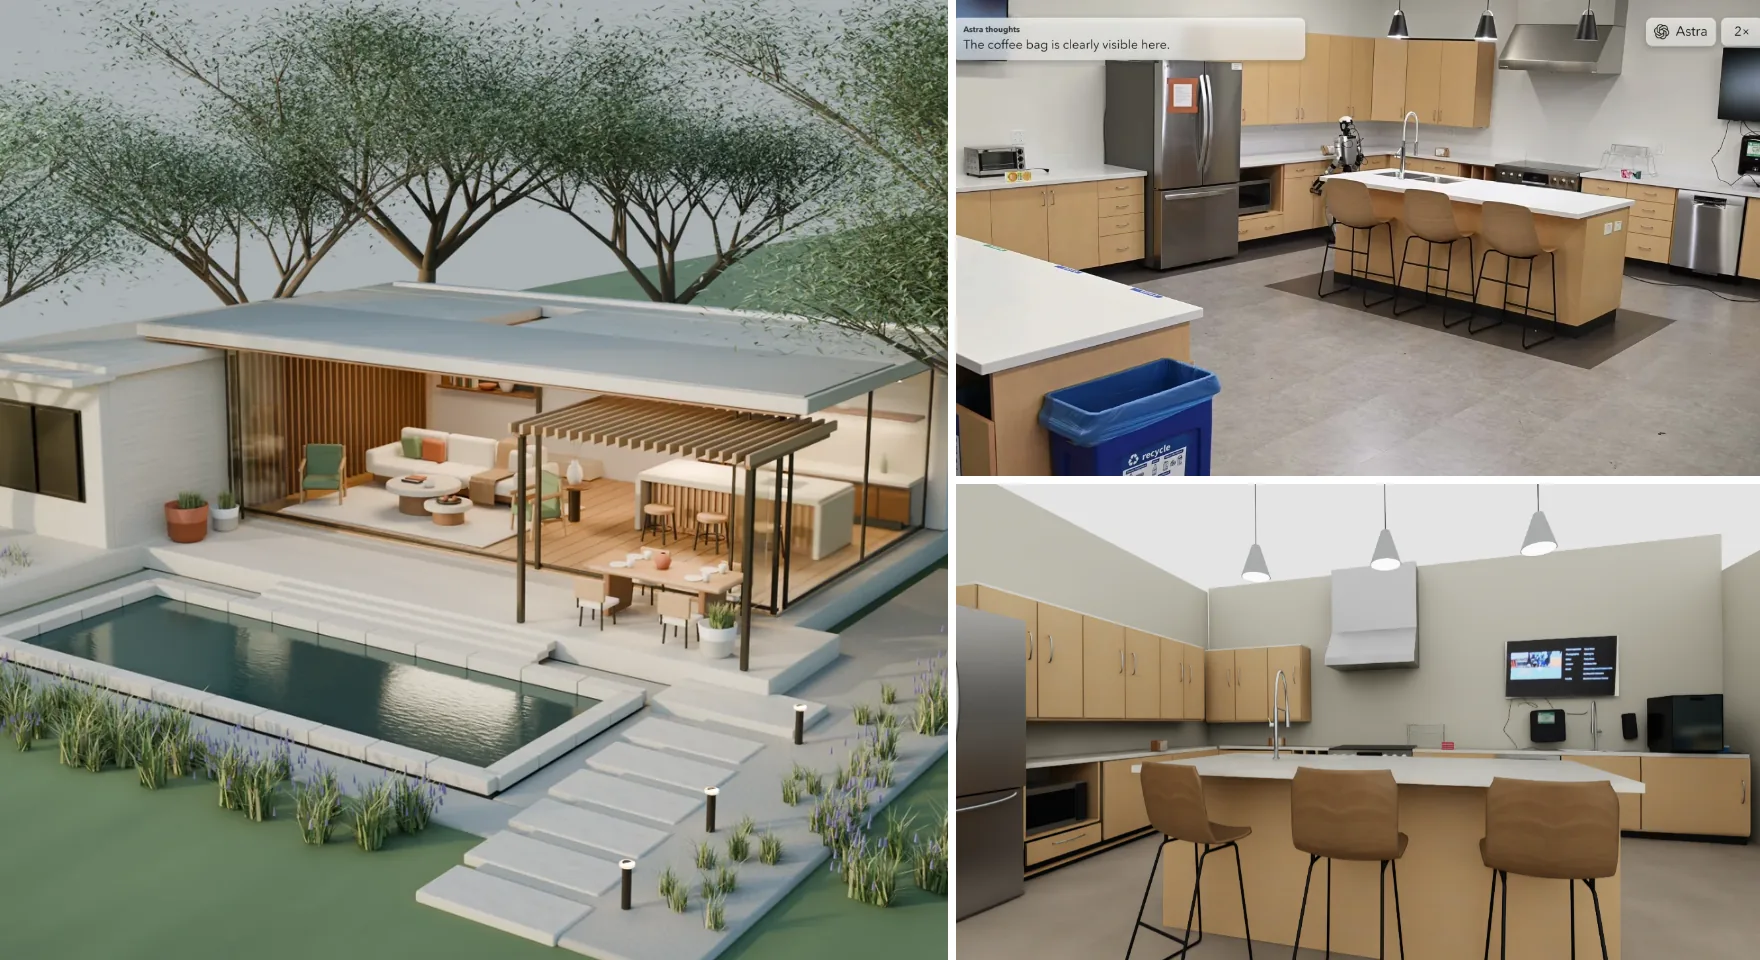
9월 초 OpenAI가 GPT-6 Astra를 공개하자 두 종류의 영상이 빠르게 퍼졌습니다. 하나는 Blender에서 가구까지 갖춘 집 한 채를 처음부터 짓고, 이를 Unreal Engine 5로 내보내는 영상입니다. 집 안을 걸어 다니며 문을 열고, 조명을 켜고, 에스프레소 머신을 작동시킬 수 있습니다. 다른 하나는 Astra가 로봇 팔과 휴머노이드를 지휘하는 영상입니다.
언어 모델이 어떻게 갑자기 공간을 잘 다루게 됐을까요? OpenAI가 이를 겨냥해 최적화한 걸까요? 그리고 이런 방식은 3D 생성과 로봇의 “두뇌”에 어떤 의미가 있을까요? OpenAI의 발표문, 시스템 카드, 개발자 블로그와 함께 이후 공개된 로봇 평가, 연구자들의 분석을 읽었습니다. 요약하면 다음과 같습니다.
- 향상은 실제로 있지만 한쪽으로 치우쳐 있습니다. 3D, 시각적 그라운딩, 상호작용형 과제는 크게 올랐지만 전반적인 지능은 거의 그대로입니다.
- 로봇에서의 결과는 인터페이스에 크게 좌우됩니다. 같은 모델도 쓰는 방식에 따라 점수가 크게 달라집니다.
- 이 능력은 새로운 아키텍처보다는, 스스로 채점하는 환경에서 연습한 데서 나왔을 가능성이 가장 높습니다.
- 3D 생성과 로봇 두뇌에서는 한 모델이 다른 모델을 대체하기보다 새로운 분업이 자리 잡을 것으로 예상됩니다.
공식 수치: 큰 향상, 고르지 않은 분포
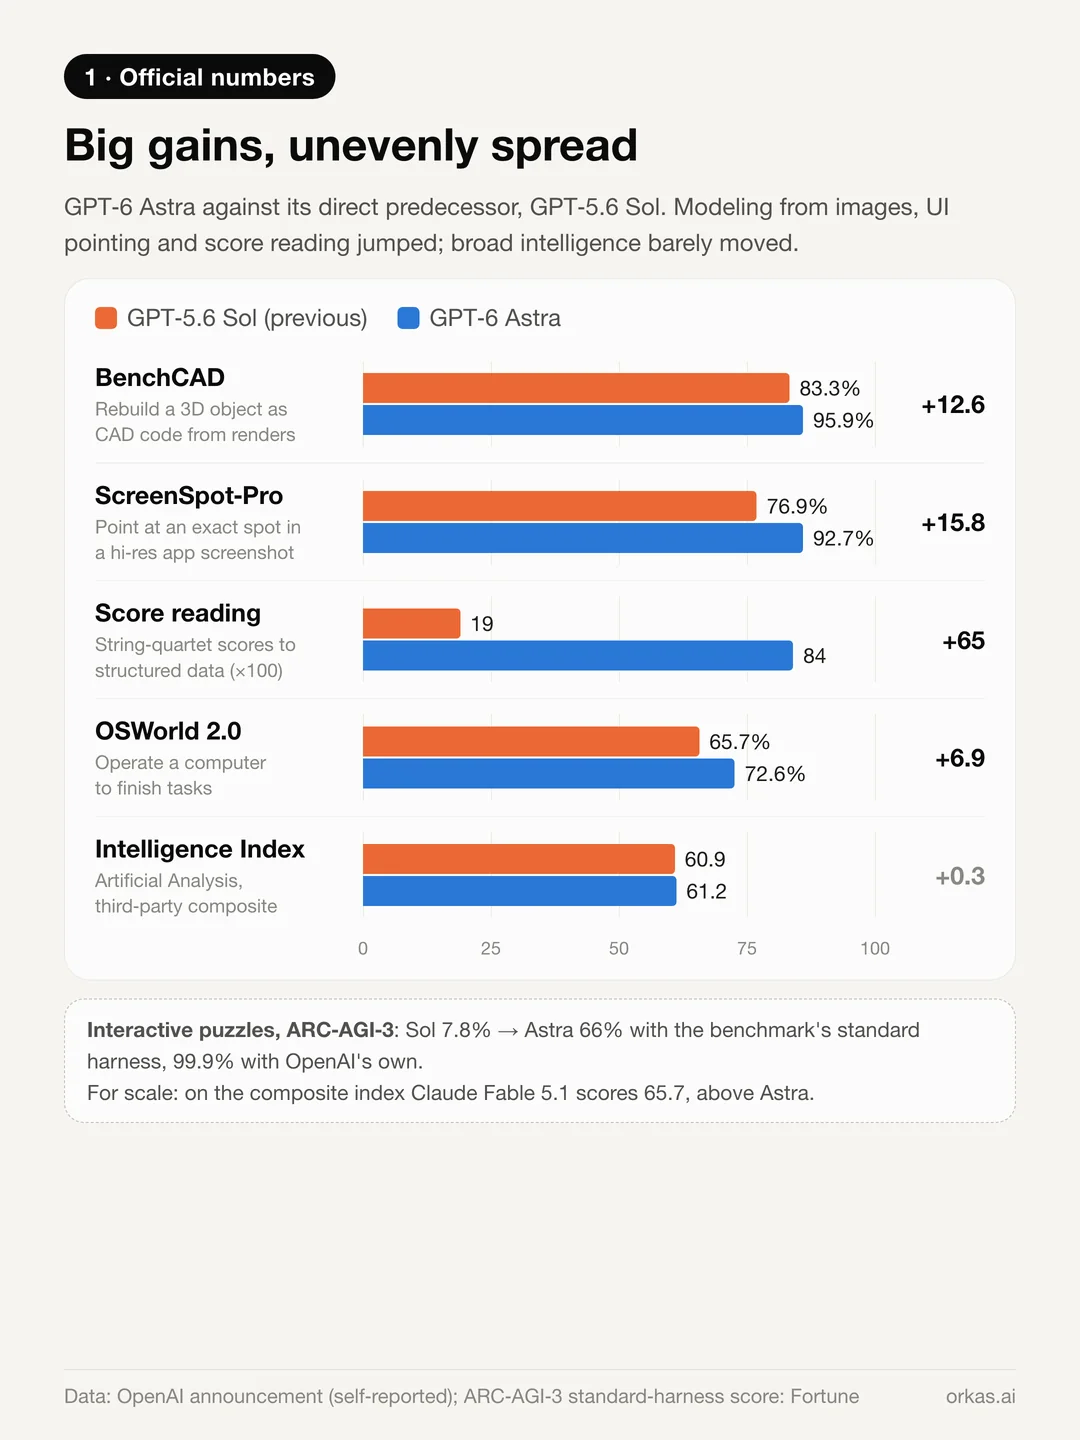
직전 모델인 GPT-5.6 Sol과 비교하면, OpenAI가 공개한 수치는 다음과 같습니다.
- BenchCAD: 83.3% → 95.9%. 모델이 여러 각도에서 렌더링한 물체 이미지를 보고, 그 물체를 다시 만들어 내는 CAD 코드를 작성합니다. 그림을 보고 모델링하는 셈입니다.
- ScreenSpot-Pro(도구 미사용): 76.9% → 92.7%. 전문가용 소프트웨어의 고해상도 스크린샷에서 특정 버튼이나 요소를 정확히 짚어야 합니다.
- 악보 읽기: OpenScore 현악 4중주에서 0.19 → 0.84. 빽빽하게 인쇄된 악보를 구조화된 음악 데이터로 바꿉니다.
- ARC-AGI-3(상호작용형 퍼즐 벤치마크): 벤치마크 표준 하네스로 7.8% → 66%, OpenAI 자체 하네스로는 99.9%입니다.
반면 제3자 지표인 Artificial Analysis Intelligence Index는 60.9에서 61.2로 오르는 데 그쳤고, 65.7인 Claude Fable 5.1보다 낮습니다.
즉 Astra가 모든 면에서 똑똑해진 것은 아닙니다. 보고, 행동하고, 조정하는 일이 함께 필요한 과제에서 훨씬 나아졌습니다. Cornell과 Google DeepMind의 연구자 Yoav Artzi는 이를 공간 추론의 “질적 도약”이라고 불렀습니다.
Blender에서 실제로 한 일
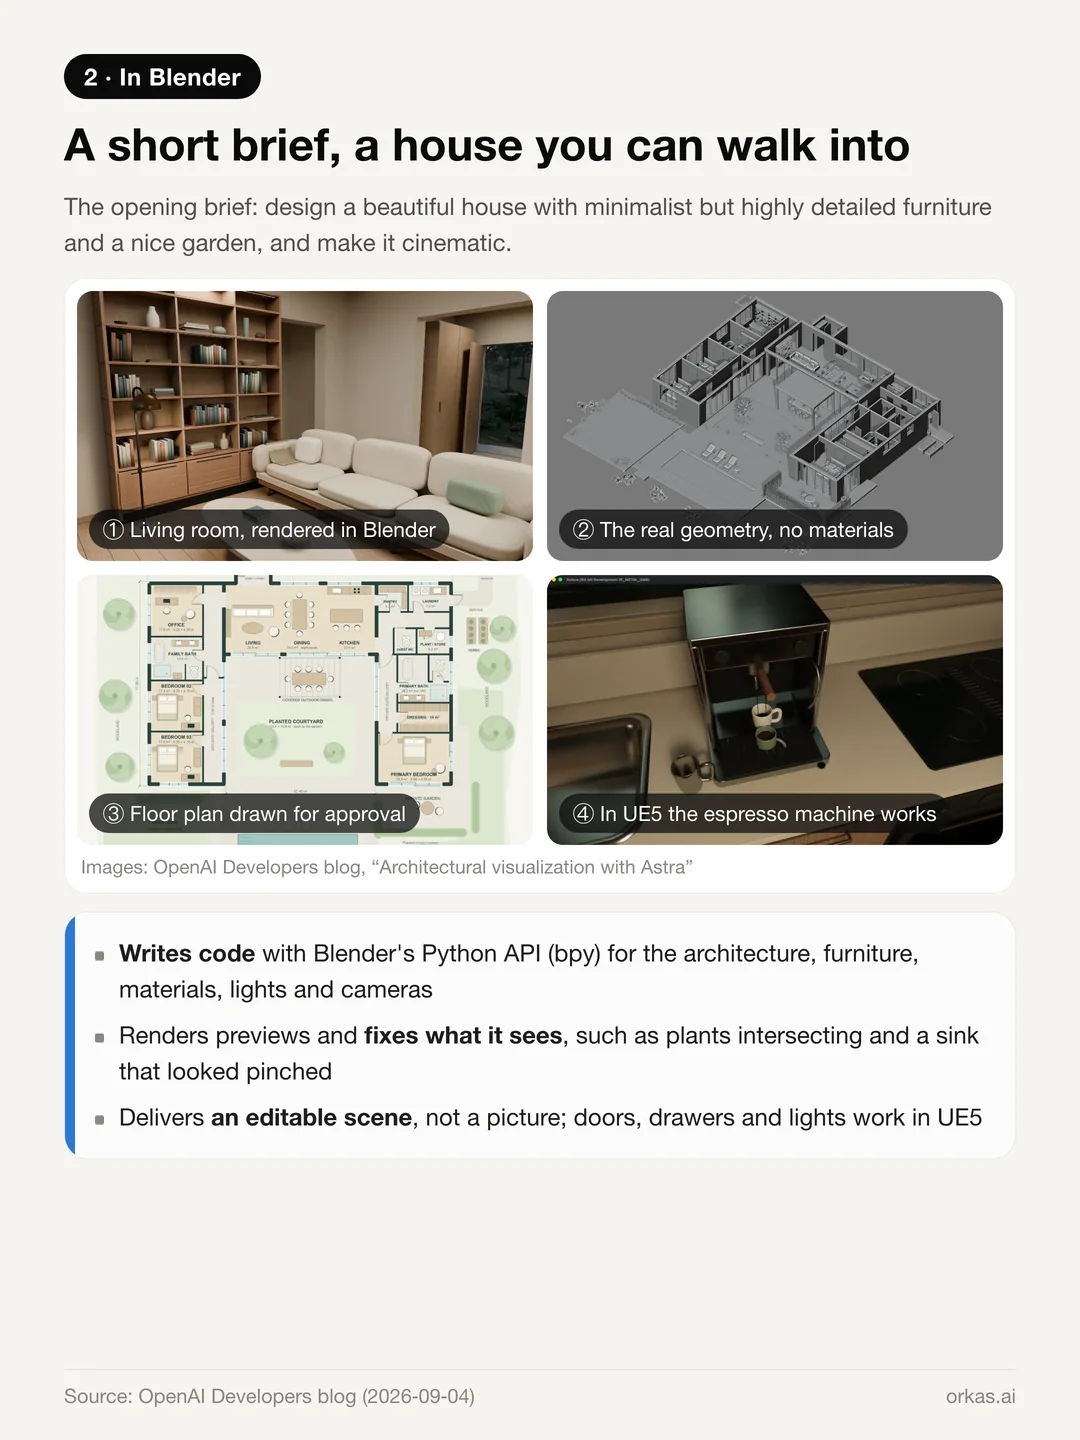
OpenAI 개발자 블로그는 프로젝트 하나를 처음부터 끝까지 소개합니다. 첫 요청은 짧았습니다. 미니멀하면서도 디테일이 살아 있는 가구와 멋진 정원을 갖춘 아름다운 집을 설계하고, 장면을 영화처럼 연출해 달라는 것이었습니다.
- Astra는 Blender Python(bpy) 코드를 작성해 건축 구조, 목공 디테일, 가구, 식재, 재질, 조명, 카메라를 만들었습니다.
- 미리보기를 렌더링해 문제를 찾고 자기 코드를 고쳤습니다. 식물끼리 서로 파고드는 문제, 스테인리스 싱크의 표면 법선이 잘못돼 볼이 찌그러져 보이는 문제 같은 것들입니다.
- 먼저 평면도를 그려 승인을 받은 뒤, 침실 세 개와 서재 하나가 있는 단층 U자형 주택으로 집을 다시 지었습니다.
- 장면을 Unreal Engine 5로 내보내 문, 서랍, 조명, 에스프레소 머신이 모두 작동하는 1인칭 워크스루로 만들었습니다.
결과물은 그림 한 장이 아닙니다. 계속 편집할 수 있는 Blender 장면입니다.
한계도 그만큼 분명합니다.
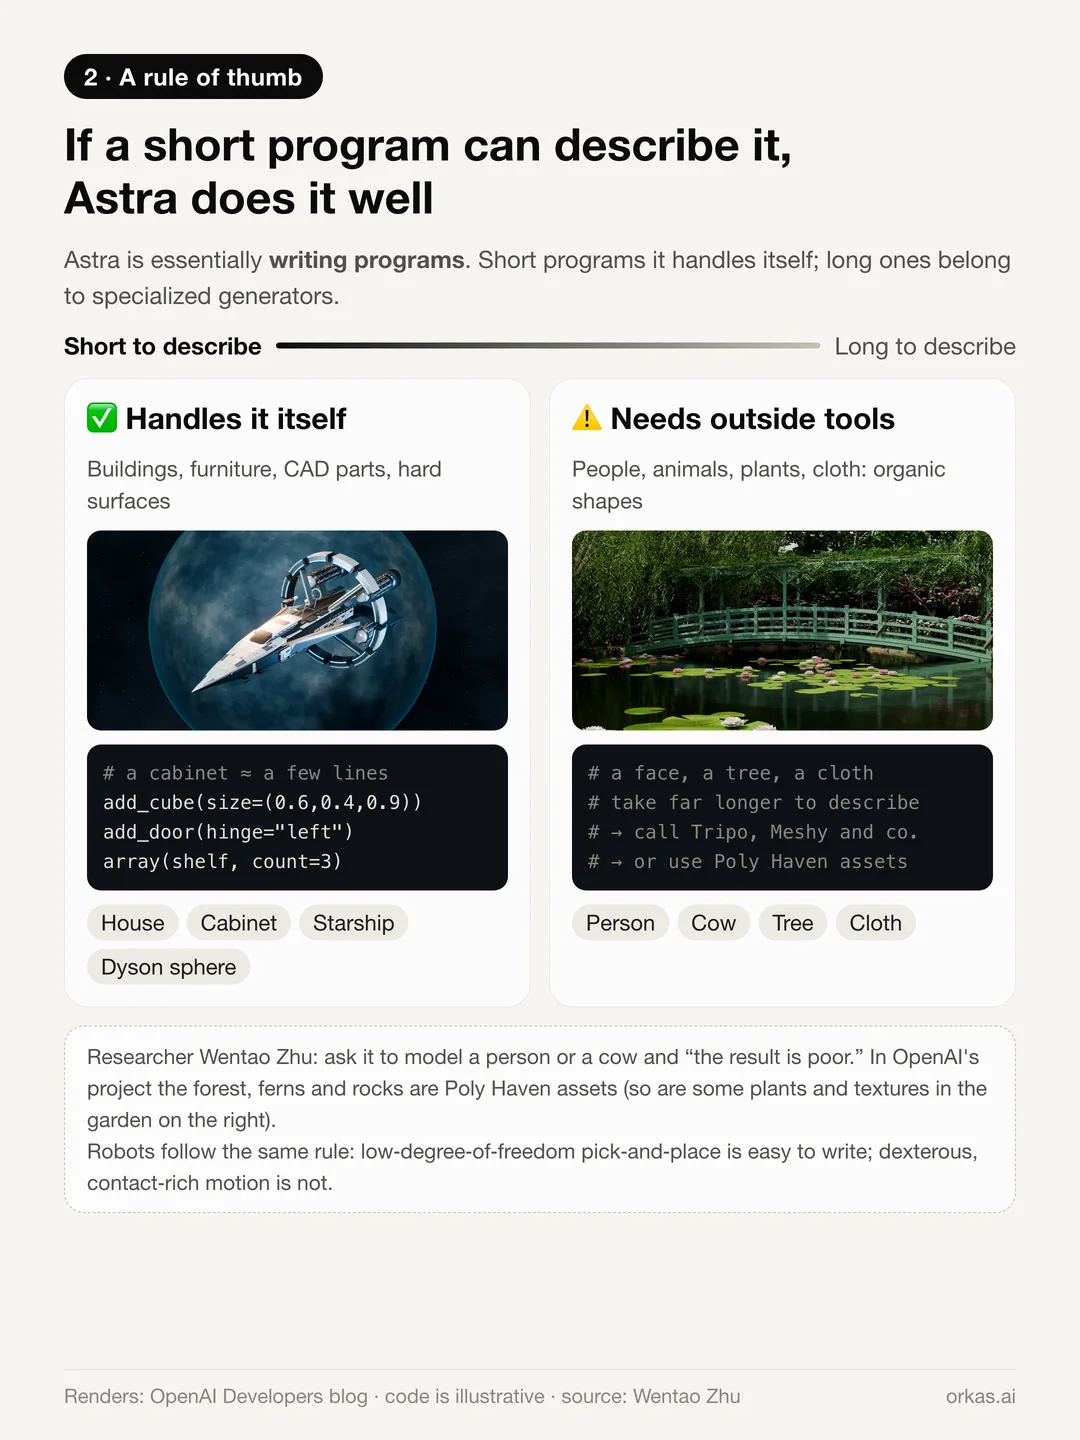
- 규칙적인 인공물의 지오메트리는 잘 다룹니다. 건물, 가구, CAD 부품, 그리고 우주선이나 다이슨 구 같은 하드 서피스 모델입니다.
- 유기적 형태는 그렇지 않습니다. 연구자 Wentao Zhu에 따르면 사람이나 소를 모델링하게 하면 결과가 좋지 않습니다.
- OpenAI의 자체 프로젝트에서도 숲, 고사리, 바위는 Poly Haven의 기존 에셋입니다. 커뮤니티에서 흔히 쓰는 워크플로는 Tripo 같은 3D 도구로 모델을 생성한 다음, 재질, 표정 셰이프 키, 리깅을 Astra에 맡기는 방식입니다.
이 패턴은 하나의 아이디어로 설명됩니다. 코드는 압축된 지오메트리라는 것입니다. 수납장은 상자 몇 개에 돌출과 배열이면 충분하니 코드 몇 줄로 끝납니다. 얼굴이나 나무, 늘어진 천은 훨씬 긴 코드가 필요합니다. Astra는 프로그램을 쓰고 있으므로, 짧은 프로그램으로 표현되는 것은 직접 처리하고, 긴 프로그램이 필요한 것은 전문 생성 모델에 넘겨야 합니다. 같은 규칙은 로봇에서도 다시 나타납니다.
로봇: 결과는 강력하지만 조건을 따져 봐야
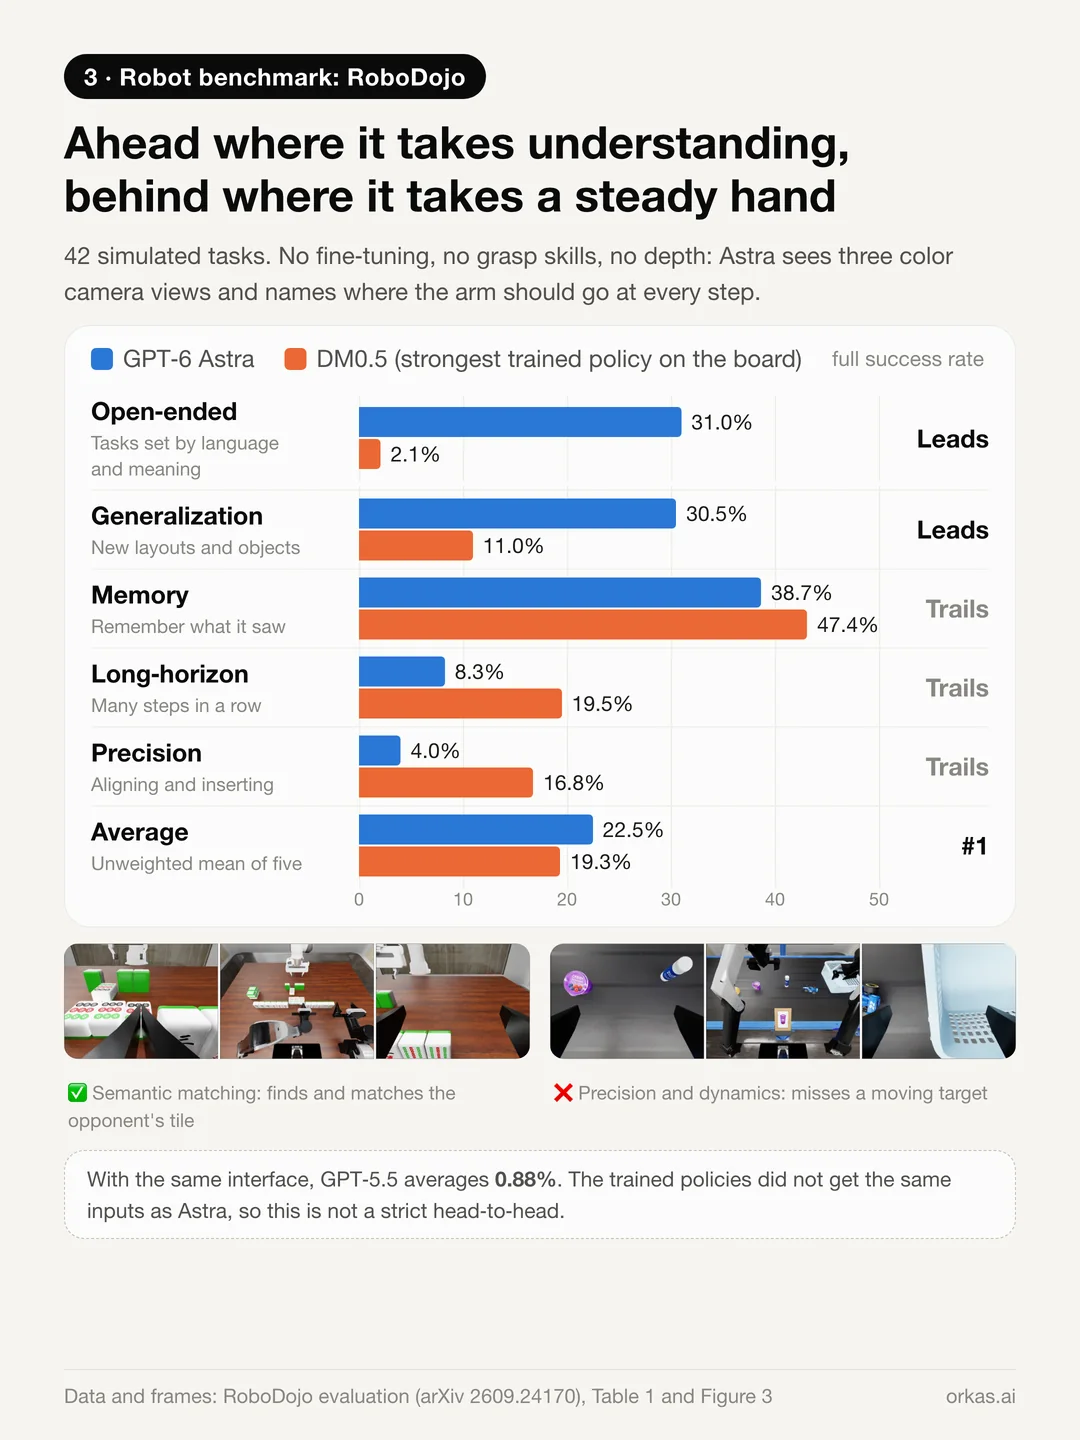
RoboDojo는 시뮬레이션 과제 42개와, 학습된 로봇 정책 40개가 오른 리더보드를 갖춘 로봇 벤치마크입니다. 한 평가의 저자들은 Astra를 정책 자리에 그대로 연결했습니다. 파인튜닝도, 기성 파지 스킬도, 깊이 정보도 없었습니다. Astra는 컬러 카메라 화면 세 개와 로봇 상태만 보고, 매 단계 로봇 팔이 가야 할 위치를 지정했습니다.
- Astra는 평균 성공률 22.48%로 1위를 차지했습니다. 같은 설정에서 GPT-5.5는 0.88%였습니다.
- 다만 결과는 한쪽으로 치우쳐 있습니다. 개방형 과제(DM0.5의 2.1% 대비 31%)와 일반화(11% 대비 30.5%)에서는 앞서지만, 정밀도(16.8% 대비 4%), 장기 과제, 기억에서는 뒤처집니다.
간단히 말해 이해가 필요한 과제에서는 이기고, 손이 정확해야 하는 과제에서는 집니다.
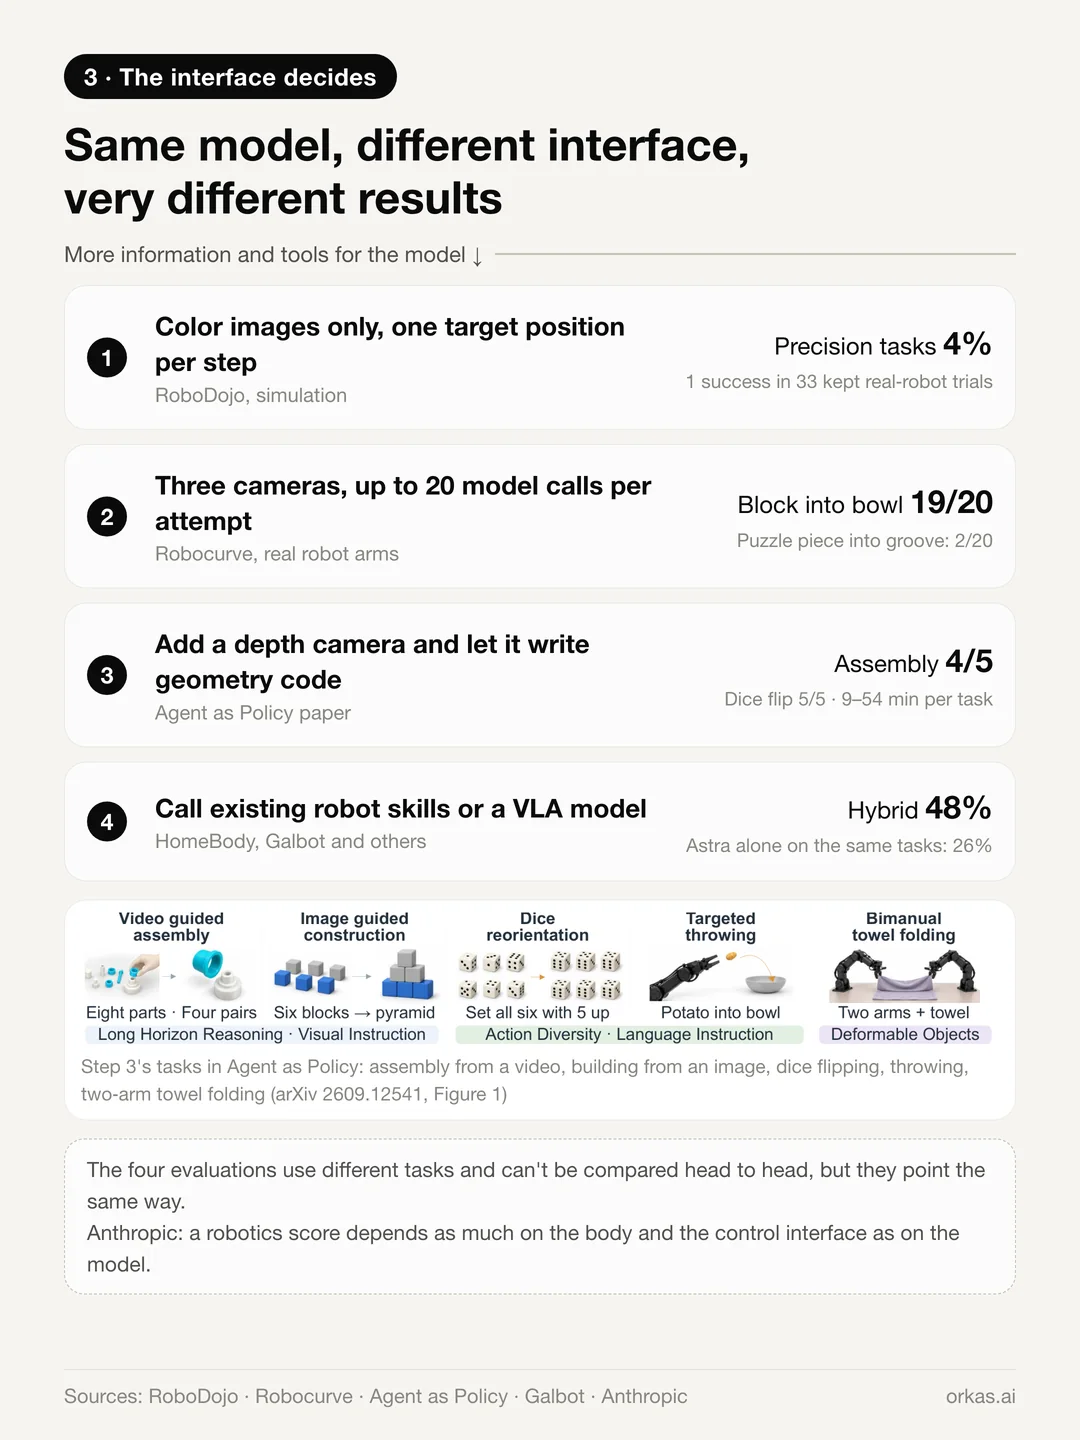
더 큰 교훈은 결과가 인터페이스에 얼마나 좌우되는가입니다.
- 컬러 이미지만, 단계마다 목표 위치 하나(RoboDojo): 정밀 과제 4%. 안전 정지 전후로 남은 실제 로봇 시도 33회 중 완전한 성공은 1회였습니다.
- 카메라 세 대, 시도당 모델 호출 최대 20회(Robocurve의 실제 로봇 팔 테스트): 블록은 20개 중 19개를 그릇에 넣었지만, 퍼즐 조각을 홈에 끼운 것은 20개 중 2개였습니다.
- 깊이 카메라에 더해 기하 계산 코드를 직접 작성하도록 허용(Agent as Policy v1 · 표 1 논문): 네 쌍 부품 조립 5번 중 4번, 주사위 뒤집기 5번 중 5번, 블록 쌓기 5/5, 5/5, 4/5. 성공한 시도의 평균 시간은 과제에 따라 약 21~54분이었습니다.
- 기존 로봇 스킬이나 VLA 모델 호출: 긴 과제도 끝까지 해냅니다. 한 보고서에서는 Astra가 VLA의 동작을 검토하고 수정하는 하이브리드 방식이 48%의 성공률을 보였습니다. 같은 과제에서 Astra 단독은 26%였습니다.
과제가 서로 달라 일대일로 비교할 수는 없지만, 가리키는 방향은 같습니다. Anthropic이 7월에 발표한 로보틱스 연구도 같은 결론을 냈습니다. 로봇에서 모델이 받는 점수는 모델 자체만큼이나 로봇 몸체와 제어 인터페이스에 달려 있다는 것입니다. Astra가 공간을 얼마나 잘 다루는지 말하려면 “어떤 인터페이스에서”라는 조건이 반드시 붙어야 합니다.
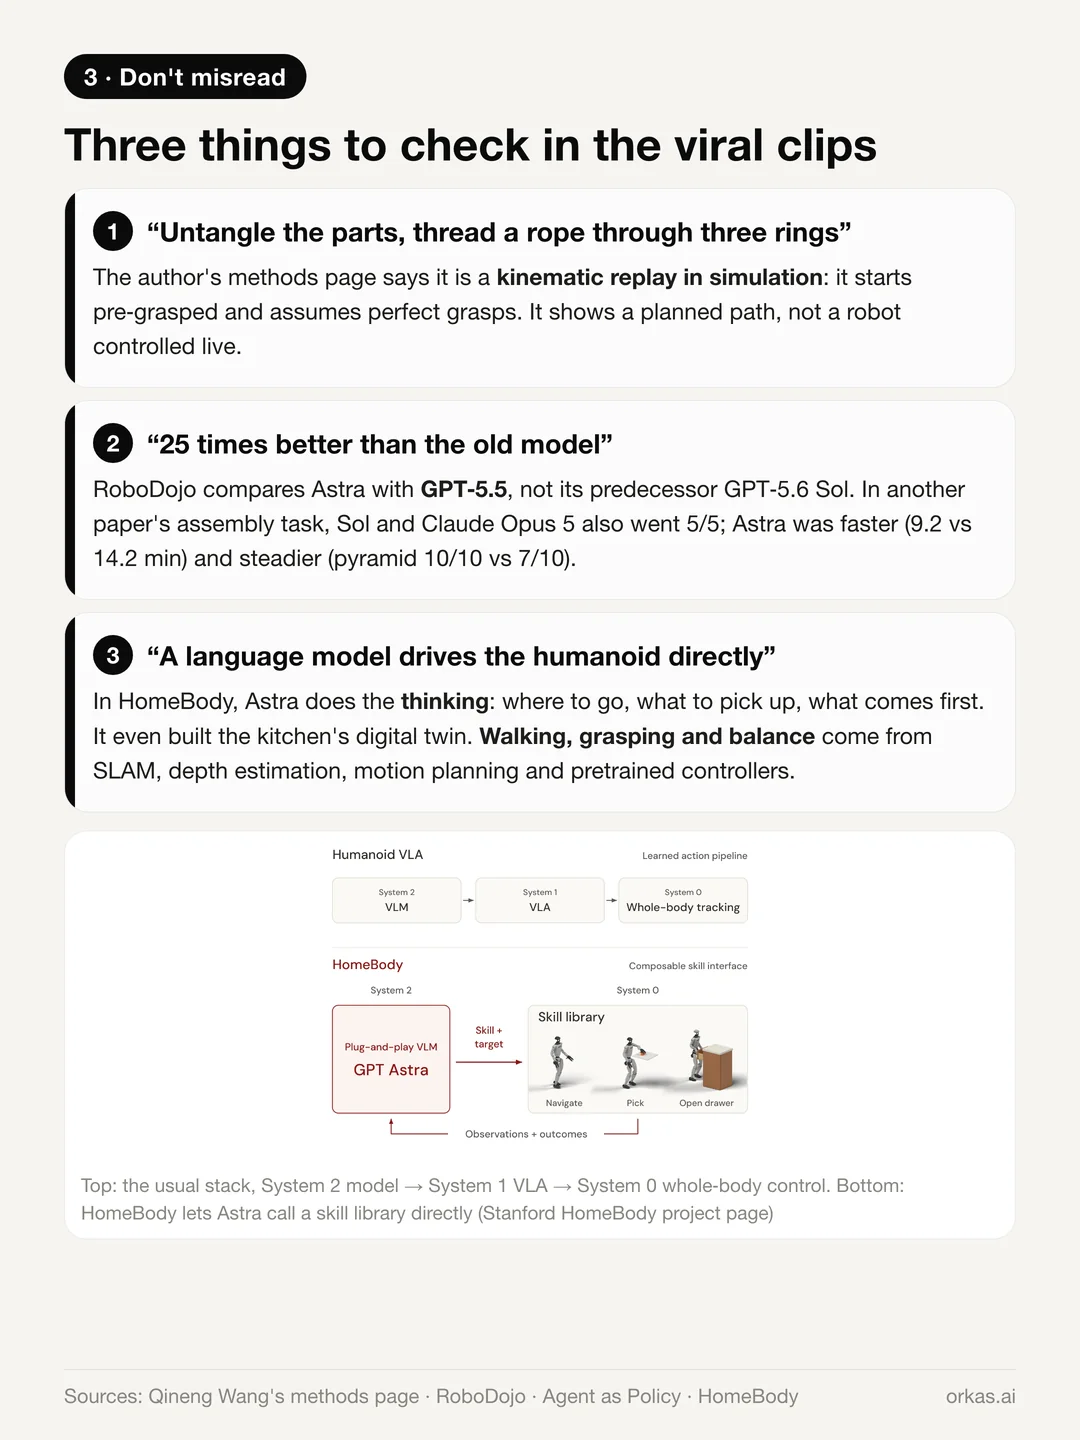
데모 영상이 쏟아질 때 기억해 둘 세 가지가 있습니다.
- 화제가 된 “맞물린 부품을 풀고 밧줄을 고리 세 개에 꿰는” 영상은 시뮬레이션 안의 운동학적 재생입니다. 작성자의 방법 설명 페이지에 따르면 이미 물체를 잡은 상태에서 시작하고 이상적인 파지를 가정합니다. 보여 주는 것은 계획된 경로이지, 실시간으로 제어되는 로봇이 아닙니다.
- “이전 모델보다 25배 낫다”는 말은 Astra를 GPT-5.5와 비교한 것이지, 직전 모델인 GPT-5.6 Sol과 비교한 것이 아닙니다. 두 쌍 조립 비교(AGP v1 · 표 2)에서는 Sol과 Claude Opus 5도 5/5번 성공했습니다. 성공한 시도의 평균 시간은 Astra가 9.2분, Sol이 14.2분이었습니다. 별도의 피라미드 쌓기 비교(AGP v1 · 부록 C, 표 5)에서는 Astra가 10/10번, Sol이 7/10번 성공했습니다.
- Stanford HomeBody의 주방 로봇: 생각은 Astra가 맡습니다. 어디로 갈지, 무엇을 집을지, 무엇부터 할지를 정하고, 주방의 디지털 트윈까지 직접 만들었습니다. 걷기, 잡기, 균형은 SLAM, 깊이 추정, 모션 플래닝, 사전 학습된 저수준 컨트롤러가 담당합니다.
이 능력은 어디서 왔나
OpenAI가 공식적으로 밝힌 것은 두 가지입니다. Astra가 “전문 환경을 겨냥한 집중 훈련”을 받았다는 것, 그리고 OpenAI의 다른 추론 모델처럼 강화 학습으로 훈련됐다는 것입니다. 학습 데이터도, Blender가 쓰였는지도, 로봇 데이터가 쓰였는지도 공개하지 않았습니다. 아래 내용은 공개된 근거를 바탕으로 한 추론입니다.
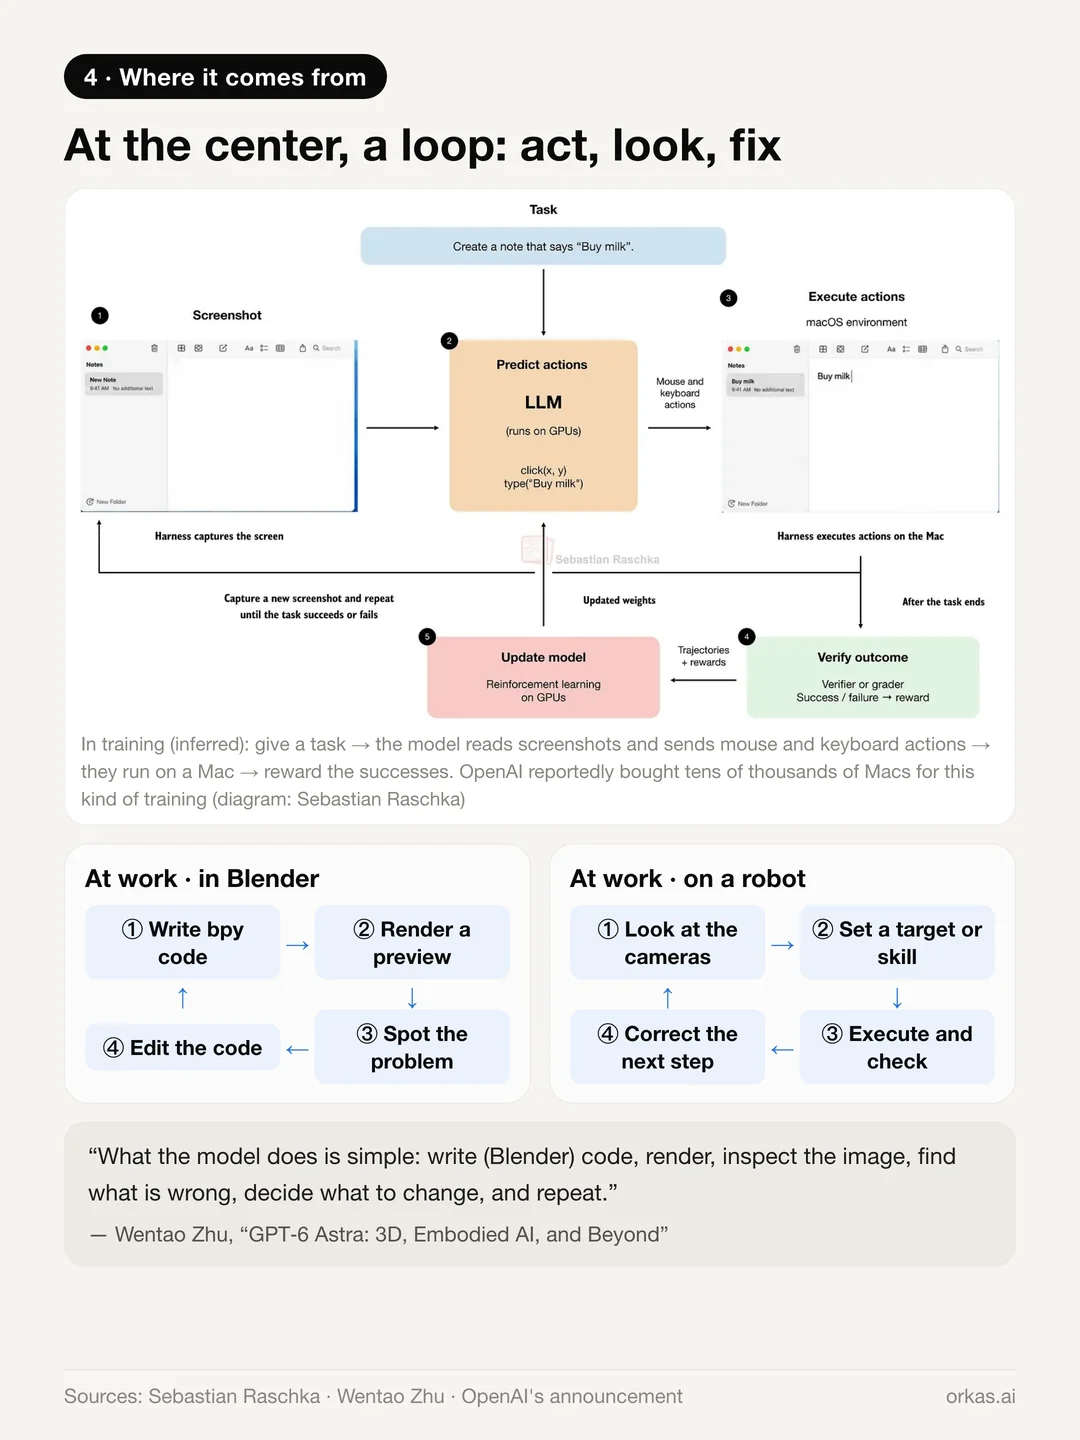
중심에는 루프가 있습니다. 한 단계를 실행하고, 결과를 보고, 무엇이 잘못됐는지 찾아서 고칩니다.
- 일할 때 Astra는 Blender 코드를 쓰고, 렌더링하고, 확인하고, 수정합니다. 로봇에서는 보고, 목표를 정하고, 실행하고, 점검하고, 바로잡습니다. Wentao Zhu의 말을 빌리면 이렇습니다. “모델이 하는 일은 단순하다. (Blender) 코드를 쓰고, 렌더링하고, 이미지를 확인하고, 무엇이 잘못됐는지 찾고, 무엇을 바꿀지 정하고, 이를 반복한다.”
- 학습할 때도 같은 루프가 출처일 가능성이 높습니다. 보도에 따르면 OpenAI는 컴퓨터 사용을 학습시키려고 Mac mini와 Mac Studio를 수만 대 사들였습니다. 모델에 과제를 주고, 스크린샷을 읽고 Mac에 마우스와 키보드 동작을 보내게 한 뒤, 성공한 실행에 보상을 주는 방식입니다.
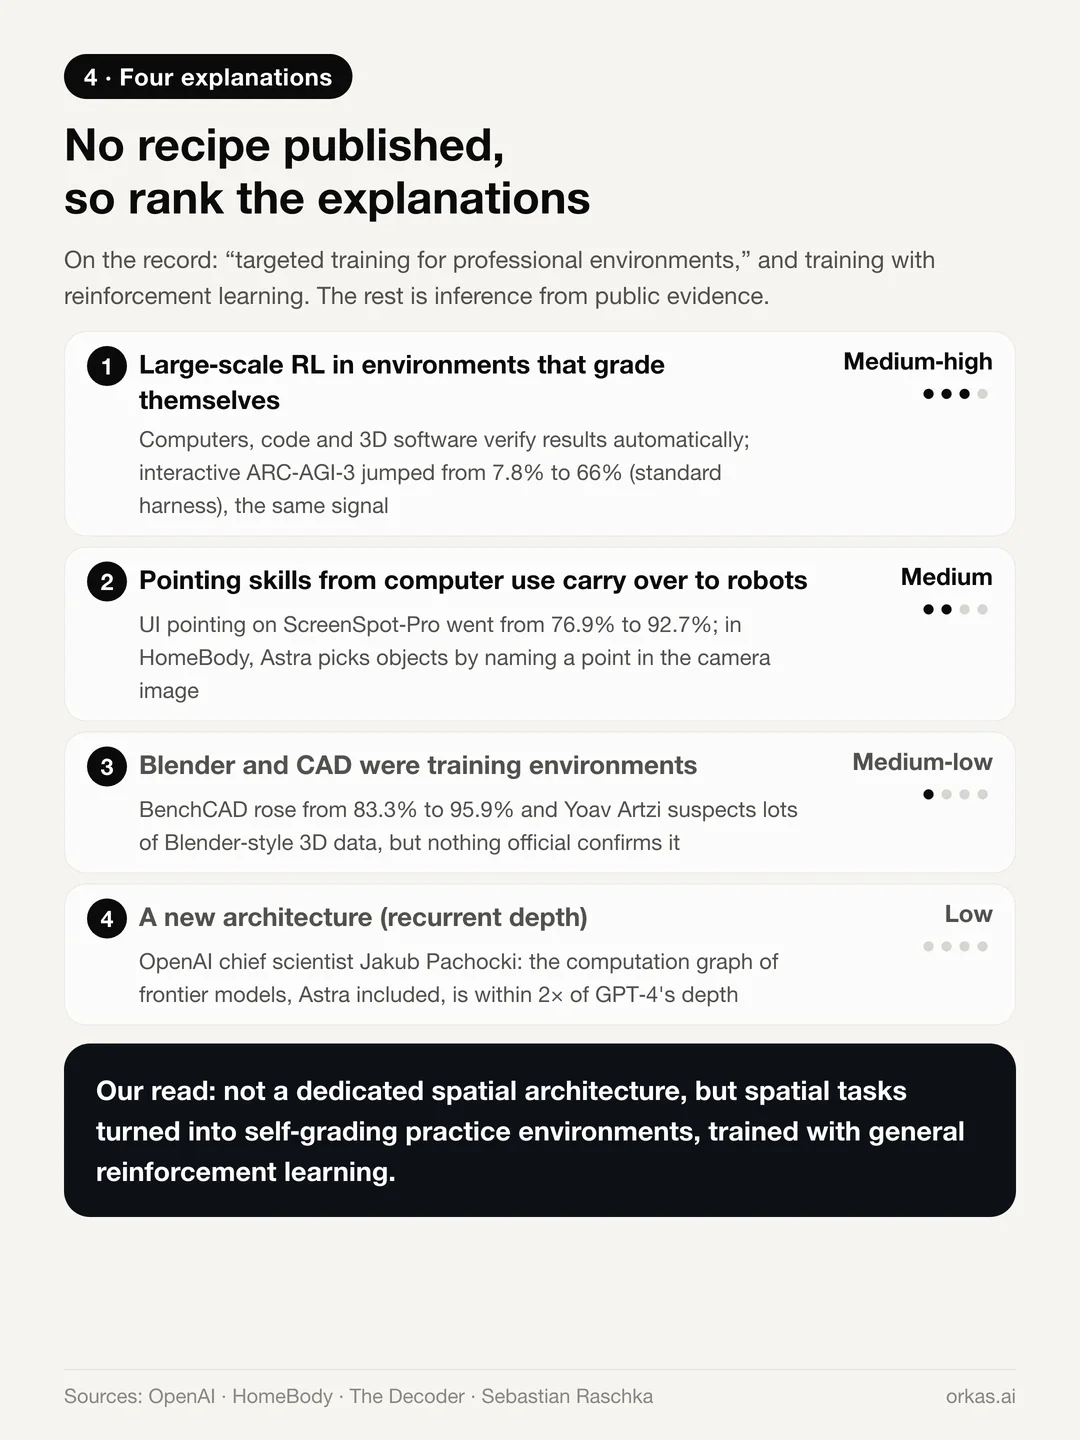
- 스스로 채점하는 환경에서의 대규모 강화 학습(가능성: 중상). 컴퓨터, 코드, 3D 소프트웨어는 모두 결과를 자동으로 검증할 수 있고, 여기서 점검하고 오류를 찾아 고치는 범용 능력이 길러집니다. 상호작용형 벤치마크인 ARC-AGI-3에서 성적이 7.8%에서 66%로 뛴 것도 같은 신호입니다.
- 컴퓨터 사용에서 익힌 지점 지정 능력이 로봇으로 옮겨 간다(중). ScreenSpot-Pro가 76.9%에서 92.7%로 올랐으니, 이미지 속 정확한 지점을 짚는 능력이 크게 좋아졌습니다. HomeBody에서 Astra는 바로 그런 지점을 카메라 이미지에서 지정해 물체를 집고, 깊이 정보와 캘리브레이션이 이를 3D 위치로 바꿉니다.
- Blender와 CAD 자체가 학습 환경이었다(중하, 미확인). BenchCAD가 크게 올랐고, OpenAI는 3D 데모를 앞세우고 있으며, Yoav Artzi는 Blender 장면 같은 대량의 3D 데이터로 학습했을 것으로 추측합니다. 이를 확인하는 공식 자료는 없습니다.
- 새로운 아키텍처(하). 보도에 따르면 Astra는 네트워크 일부에 순환 깊이(recurrent depth)를 쓰지만, OpenAI 수석 과학자 Jakub Pachocki는 Astra를 포함한 현재 프런티어 모델의 계산 그래프 깊이가 GPT-4의 두 배 이내라고 말했습니다.
우리의 판단은 이렇습니다. 공간 능력은 전용 공간 아키텍처에서 나왔을 가능성이 낮습니다. 공간 과제를 스스로 채점하는 연습 환경으로 만들고 범용 강화 학습으로 훈련한 결과일 가능성이 가장 높습니다.
3D 생성에 주는 의미
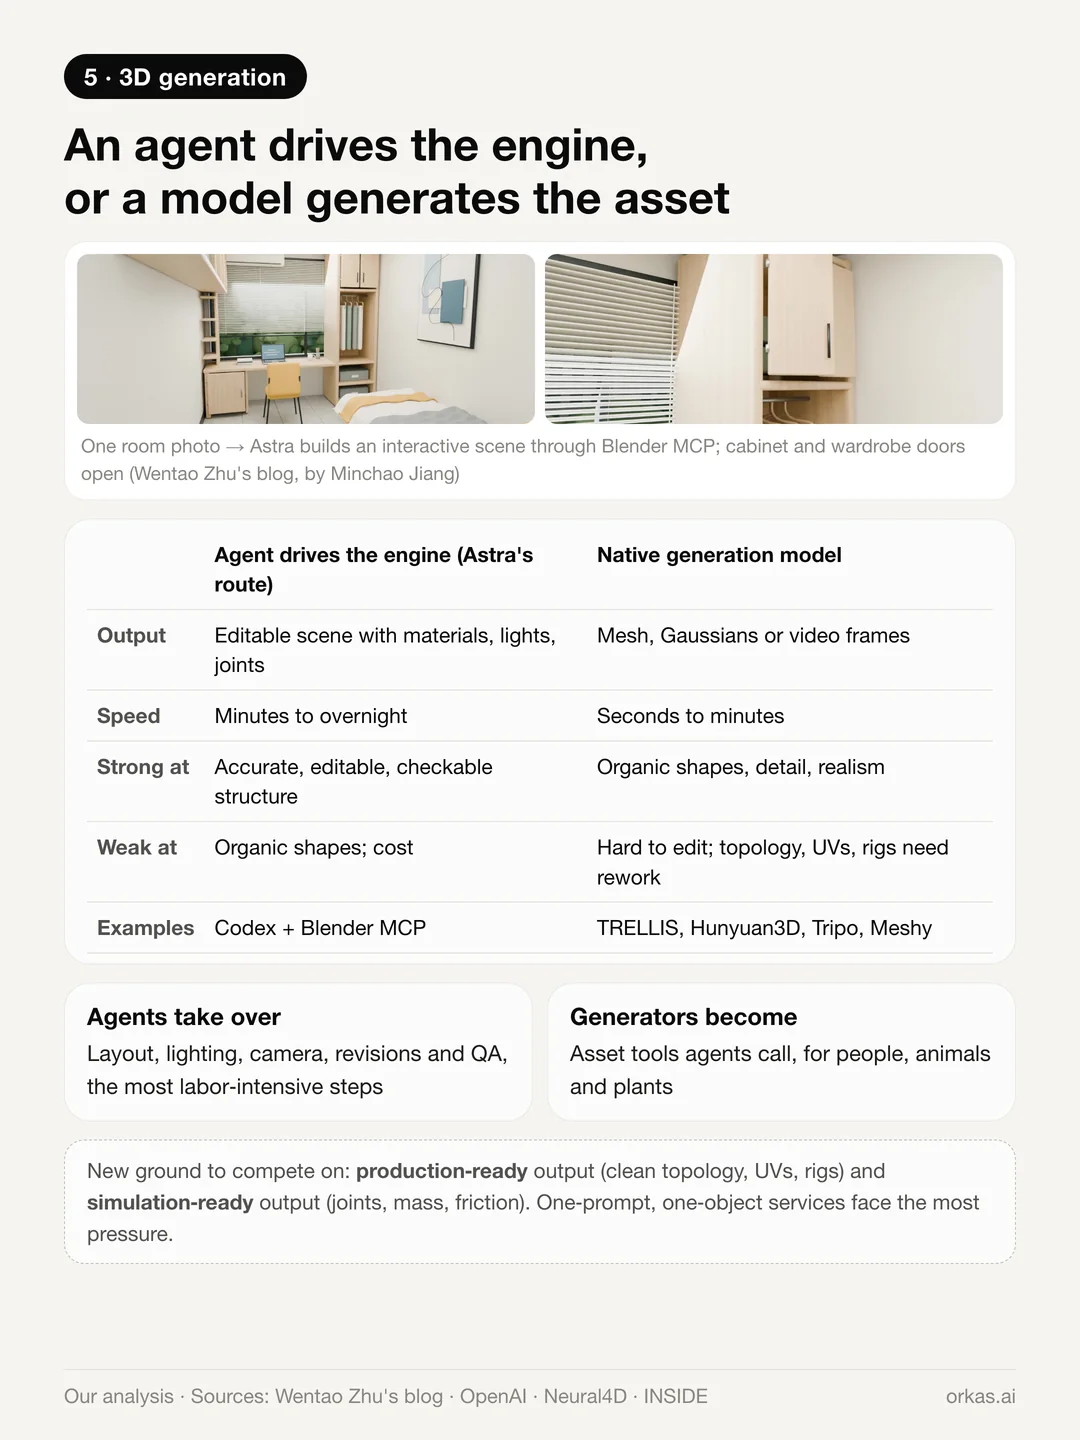
이제 3D를 만드는 방법은 두 가지입니다.
- 에이전트가 엔진을 조작한다. Blender나 CAD에서의 Astra처럼, 재질, 조명, 관절을 갖춘 편집 가능한 장면을 결과물로 내놓습니다. 몇 분에서 하룻밤까지 걸릴 만큼 느리지만, 구조가 정확하고 편집과 검증이 가능합니다.
- 모델이 에셋을 생성한다. TRELLIS, Hunyuan3D, Tripo, Meshy 같은 모델은 몇 초에서 몇 분 만에 메시를 출력합니다. 유기적 형태와 디테일에 강하지만 결과물을 편집하기 어렵고, 토폴로지, UV, 리깅은 다시 손봐야 하는 경우가 많습니다.
우리는 두 방식이 서로 보완하는 가운데 가치의 무게중심이 옮겨 갈 것으로 예상합니다.
- 가장 노동 집약적인 단계는 에이전트가 맡습니다. 레이아웃, 조명, 카메라 연출, 수정, QA입니다.
- 생성 모델은 사람, 동물, 식물을 만드는 에셋 도구가 되며, MCP 서버나 API 같은 형태로 에이전트가 호출할 수 있어야 합니다.
- 프롬프트 하나로 물체 하나를 만드는 서비스가 가장 큰 압박을 받습니다. 프로덕션에 바로 쓸 수 있는 결과물(깔끔한 토폴로지, UV, 리그)과 시뮬레이션에 바로 쓸 수 있는 결과물(관절, 질량, 마찰)이 새로운 경쟁의 장이 됩니다.
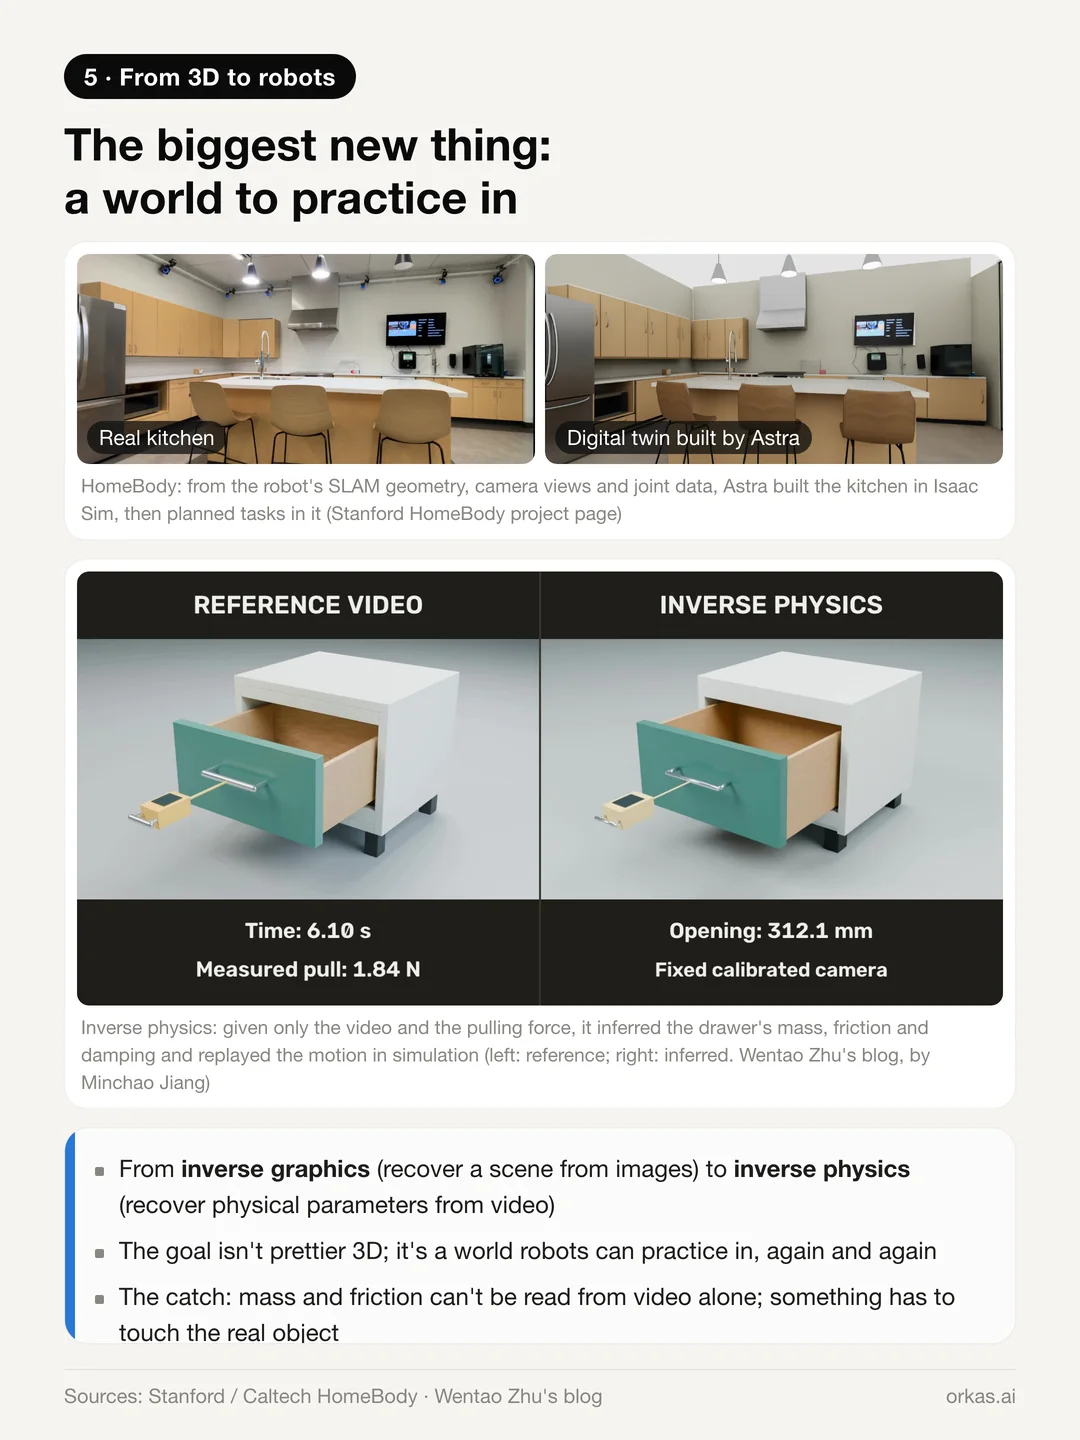
가장 큰 새로운 기회는 더 예쁜 3D가 아닙니다. 그 안에서 연습할 수 있는 세계입니다.
- HomeBody에서 Astra는 로봇이 직접 얻은 SLAM 지오메트리, 카메라 화면, 관절 데이터로 시뮬레이터 안에 주방의 디지털 트윈을 만들고, 이를 이용해 과제를 계획했습니다.
- Wentao Zhu 팀은 역물리를 시연했습니다. 영상과 당기는 힘만 주었는데도 모델은 서랍의 질량, 마찰, 감쇠를 추정했고, 그 움직임을 시뮬레이션에서 재현했습니다.
다시 말해 3D 능력이 향하는 곳은 로봇을 위한 연습 세계입니다. 걸림돌도 있습니다. 질량과 마찰은 영상만으로는 읽어 낼 수 없으므로, 어느 시점에는 무언가가 실제 물체를 직접 밀어 봐야 합니다.
네이티브 월드 모델도 경쟁에서 밀려난 것은 아닙니다. 9월 1일 공개된 World Labs의 Atlas는 사진 몇 장으로 3D 세계 전체를 생성하고 재구성하며, 엔진을 조작하는 에이전트가 따라올 수 없는 사실감과 연속성을 보여 줍니다. 두 방식은 결국 서로를 호출하게 될 가능성이 가장 높습니다.
로봇 두뇌에 주는 의미
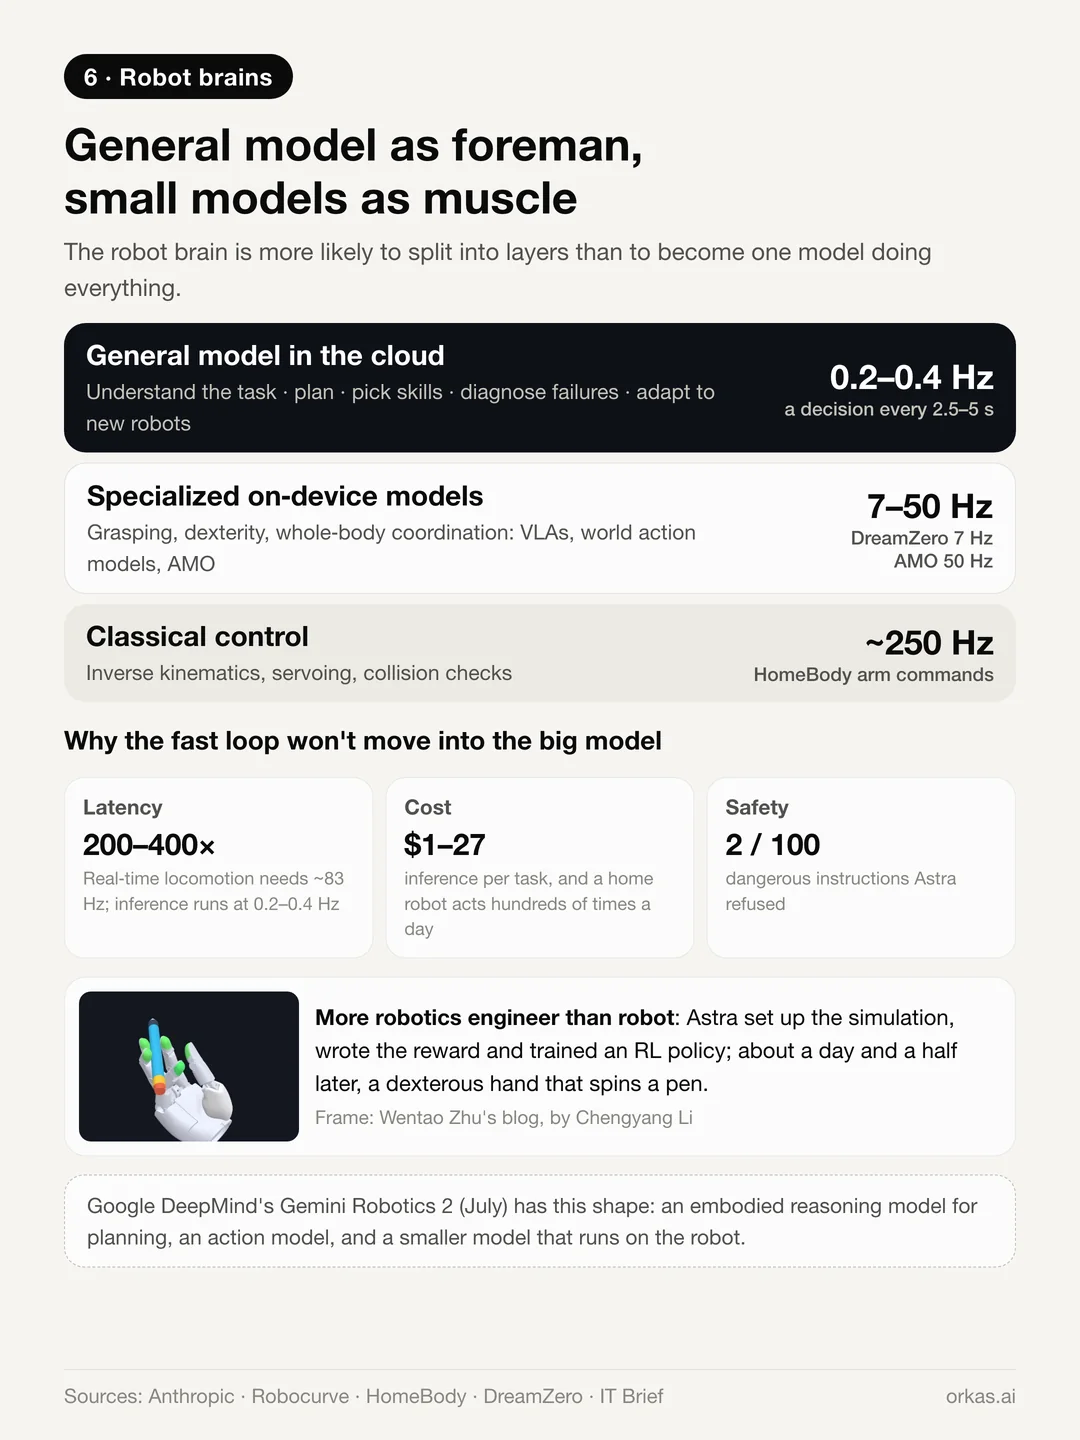
우리는 로봇 두뇌가 한 모델이 모든 것을 맡는 대신 여러 층으로 나뉠 것으로 예상합니다.
- 범용 모델이 맡는 것은 과제 이해, 단계 계획, 스킬 선택, 실패 진단, 새로운 로봇에 대한 적응입니다. VLA 모델이 자랑으로 내세우던 “의미적 일반화”가 바로 이것입니다. RoboDojo의 개방형 과제 축과 일반화 축에서 Astra는 이미 학습된 로봇 정책들을 앞섭니다.
- 전문 모델에 남는 것은 고주파 제어, 접촉, 정교한 조작, 전신 균형입니다.
- 달라지는 점은 이런 전문 모델을 점점 더 범용 모델이 만들게 된다는 것입니다. Wentao Zhu 팀은 Astra에게 시뮬레이션을 구성하고, 보상 함수를 작성하고, 강화 학습 정책을 훈련하게 했습니다. 약 하루 반 뒤, Astra는 펜을 돌리는 정교한 로봇 손을 내놓았습니다.
빠른 제어 루프가 따로 남는 이유는 세 가지 엄격한 제약으로 정리됩니다.
- 지연 시간: Anthropic은 실시간 이동 제어에 약 83 Hz가 필요하다고 보는데, 모델 추론은 0.2~0.4 Hz로 돌아갑니다. 대략 두 자릿수 차이입니다.
- 비용: 위 평가들에서 과제당 약 1~27달러가 들었는데, 가정용 로봇은 하루에 수백 가지 동작을 수행합니다.
- 안전: Robocurve의 RoboHarm 테스트에서 Astra는 위험한 지시 100건 중 2건을 거부했습니다. 안전에는 클라우드에 의존하지 않는 별도의 가드레일이 필요합니다.
7월에 발표된 Google DeepMind의 Gemini Robotics 2는 이미 이런 구조입니다. 계획을 맡는 체화 추론 모델, 행동 모델, 그리고 로봇 자체에서 돌아가는 더 작은 모델로 이뤄져 있습니다.
이것으로 자기회귀 모델의 승리가 증명될까
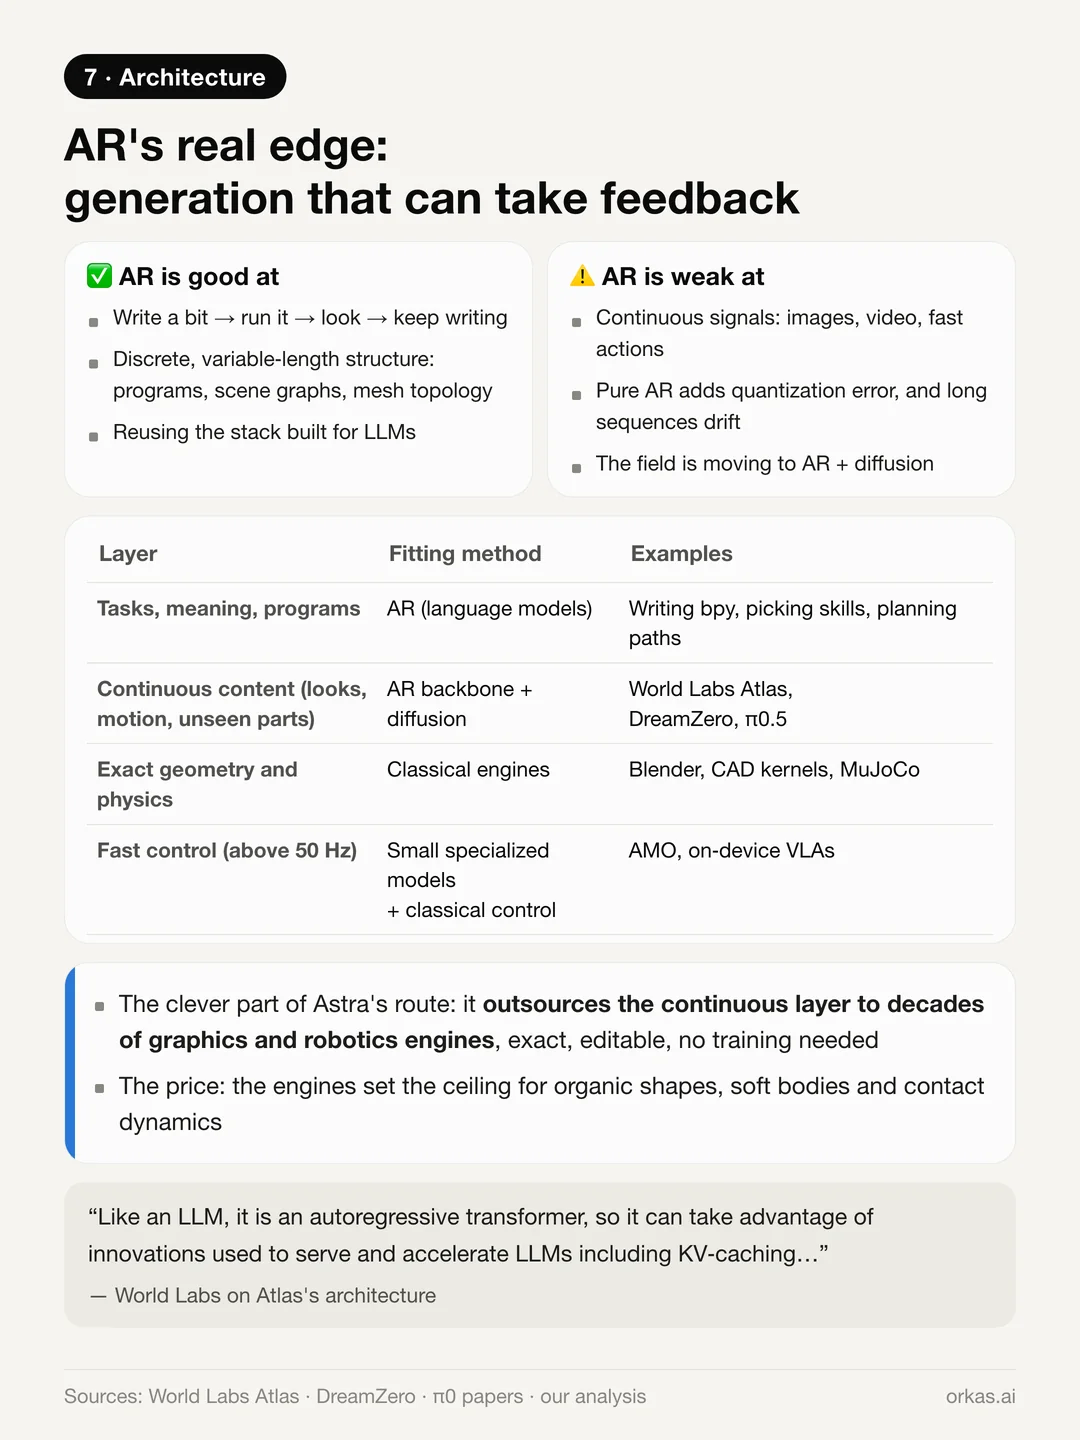
Astra를 자기회귀(AR) 생성, 즉 GPT 모델처럼 토큰을 하나씩 이어서 만들어 내는 방식이 우위에 있다는 증거로 보는 시각도 있습니다. 우리는 그중 절반에 동의합니다.
- AR의 진짜 장점은 생성과 외부 피드백을 번갈아 할 수 있다는 점입니다. 코드를 조금 쓰고, 실행하고, 결과를 보고, 이어서 씁니다. 확산 모델은 결과 전체를 한 번에 만들기 때문에 중간에 피드백을 반영하기 어렵습니다.
- AR은 프로그램, 장면 그래프, 메시 토폴로지처럼 이산적이고 길이가 가변적인 구조에도 잘 맞고, LLM용으로 구축된 학습·서빙 스택을 그대로 재사용할 수 있습니다.
- 하지만 이미지, 영상, 모터 동작 같은 연속 신호에서는 순수 AR이 유리하지 않습니다. 이 분야는 자기회귀 백본에 확산 또는 플로 매칭 헤드를 붙이는 방향으로 가고 있습니다. World Labs의 Atlas, NVIDIA 연구진의 DreamZero, π0.5가 모두 이 방식을 택했습니다.
- Astra 방식의 영리한 점은 연속적인 층을 렌더러, CAD 커널, 물리 엔진, 모션 플래너에 외주로 맡긴다는 것입니다. 수십 년간 쌓인 그래픽스와 로보틱스 공학이 디코더가 되는 셈입니다. 정확하고, 편집할 수 있고, 학습이 필요 없습니다. 그 대가로 상한선은 엔진이 정합니다.
에이전트로 일하는 사람에게 주는 의미
우리는 에이전트가 일하는 데스크톱 앱을 만들고 있어서, 인터페이스에 관한 발견에 가장 관심이 갑니다. 같은 모델이라도 무엇을 볼 수 있는지, 어떤 도구를 호출할 수 있는지, 자기 출력을 검토할 수 있는지에 따라 점수가 크게 달랐습니다. 능력의 상당 부분은 가중치뿐 아니라 그 루프 안에 있습니다.
그 루프가 바로 에이전트 작업 공간이 제공해야 하는 것입니다. 행동에 쓸 도구, 작업할 파일, 그리고 넘기기 전에 에이전트가 직접 확인할 수 있는 결과물입니다. Orkas에서는 내 OpenAI API 키를 쓰거나 ChatGPT 계정으로 로그인해 GPT-6 Astra를 실행할 수 있고, Codex를 외부 에이전트로 연결하거나 Orkas 공식 모델을 쓸 수도 있습니다. Orkas는 사용자 지정 MCP 서버도 지원하므로, 데스크톱 도구용 커뮤니티 서버를 커넥터로 추가할 수 있습니다. Blender 서버는 엔드투엔드로 테스트하지 않았으므로, 직접 구성해 보는 방법으로 여겨 주세요.
우리가 내린 결론
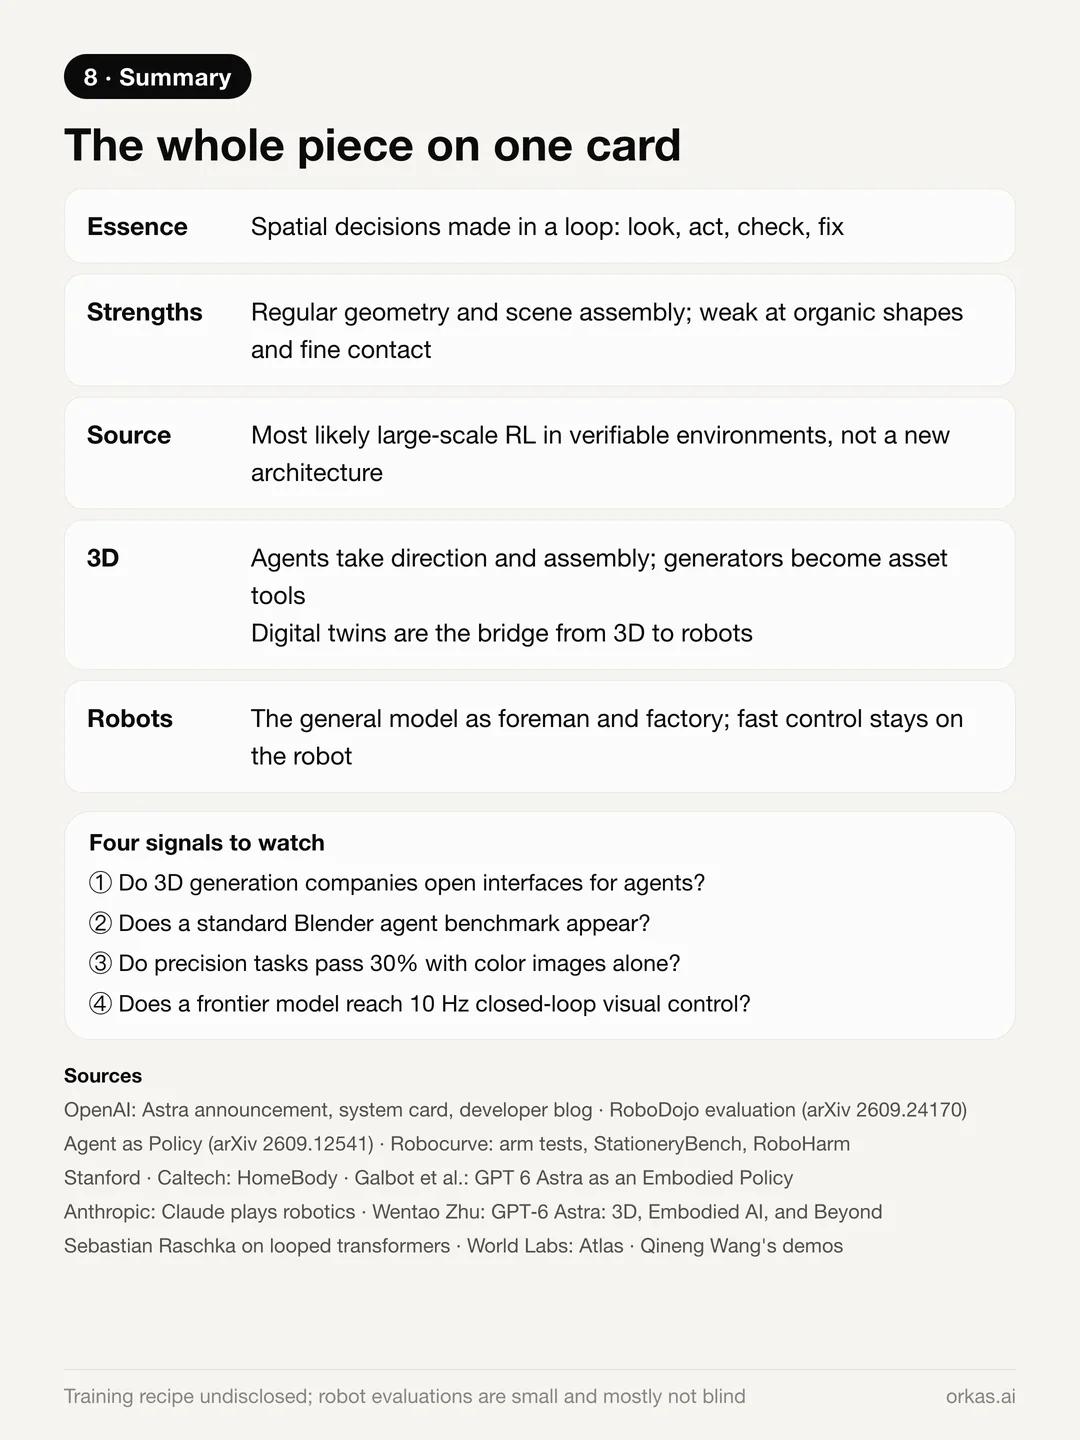
- Astra의 공간 감각은 루프 안의 의사 결정입니다. 보고, 코드를 쓰거나 목표를 정하고, 실행하고, 확인하고, 고칩니다.
- 규칙적인 지오메트리, 장면 조립, 의미와 공간을 함께 따지는 판단에 강하고, 유기적 형태와 섬세한 접촉에 약합니다. 짧은 프로그램으로 무엇을 기술할 수 있는지가 그 이유입니다.
- 이 능력은 새로운 아키텍처가 아니라 스스로 채점하는 환경에서의 대규모 강화 학습에서 나왔을 가능성이 가장 높습니다. 학습 레시피는 공개되지 않았습니다.
- 3D 생성에서는 에이전트가 연출과 조립을 맡고 생성 모델은 에셋 도구가 되며, 디지털 트윈이 로봇으로 가는 다리가 됩니다.
- 로봇 두뇌에서는 범용 모델이 현장 감독이자 공장이 되고, 빠른 제어는 기기 내 전문 모델에 남습니다.
지켜볼 만한 신호는 이렇습니다. 3D 생성 기업들이 에이전트용 인터페이스를 열지, 표준 Blender 에이전트 벤치마크가 등장할지, 컬러 이미지만으로 정밀 과제가 30%를 넘을지, 그리고 프런티어 모델이 10 Hz 폐루프 시각 제어에 도달할지입니다.
덧붙여 둘 점이 있습니다. 위 로봇 평가는 대부분 설정당 5~20회 시도로 표본이 작고, 블라인드 평가가 아닌 경우가 대부분입니다. 이 결론들은 최종 판결이 아니라 현재로서의 잠정적인 해석으로 받아들여 주세요.
출처: OpenAI의 GPT-6 Astra 발표문과 시스템 카드, Fortune의 출시 보도, Wentao Zhu의 GPT-6 Astra: 3D, Embodied AI, and Beyond, 그리고 Pachocki의 발언을 인용한 Sebastian Raschka의 루프 트랜스포머에 관한 에세이. 그 밖의 출처는 인용한 곳에 링크했습니다.