
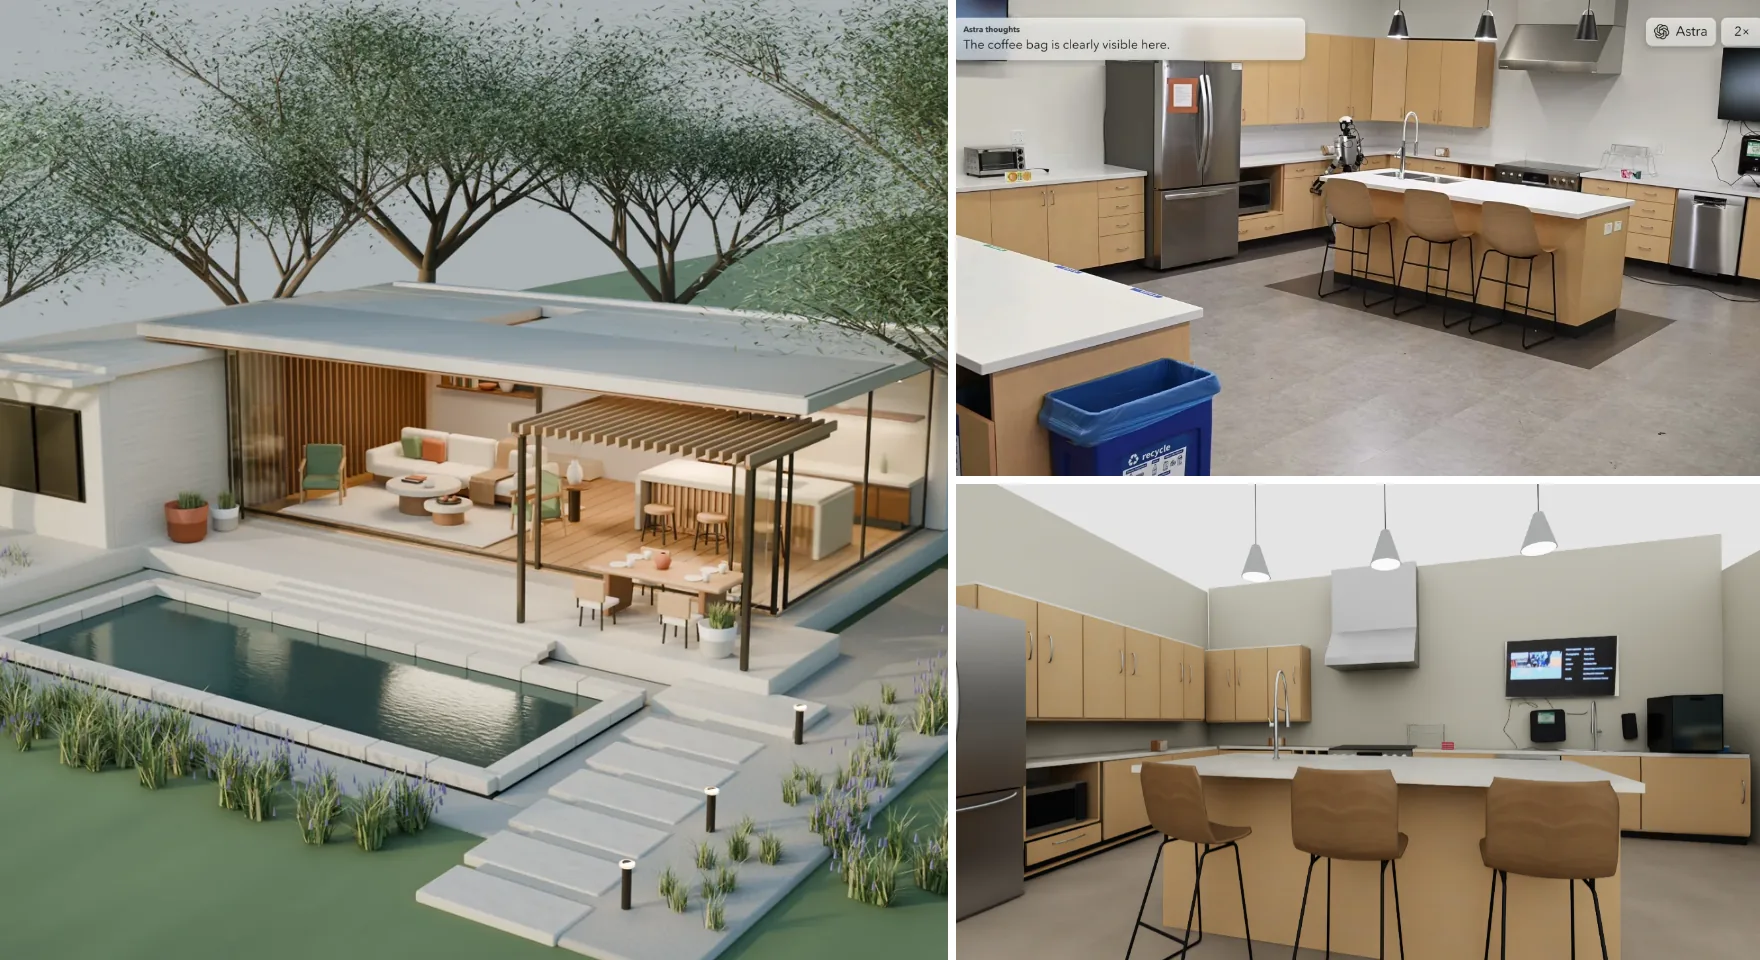
9 月初めに OpenAI が GPT-6 Astra を公開すると、2 種類の動画が一気に広まりました。ひとつは、Blender でゼロから家具付きの家を一軒まるごと建て、それを Unreal Engine 5 に書き出す動画です。家の中を歩き回り、ドアを開け、照明をつけ、エスプレッソマシンを動かせます。もうひとつは、ロボットアームやヒューマノイドに指示を出して動かす動画です。
言語モデルが、なぜ急に空間に強くなったのでしょうか。OpenAI はそこを狙って最適化したのでしょうか。そして、この路線は 3D 生成やロボットの「頭脳」にとって何を意味するのでしょうか。OpenAI の発表、システムカード、開発者ブログに加え、その後に公開されたロボット評価と研究者の分析を読みました。要点は次のとおりです。
- 伸びは本物ですが、偏っています。3D、視覚グラウンディング、インタラクティブなタスクは大きく伸びた一方、総合的な知能はほとんど変わっていません。
- ロボットでの成績は、インターフェースに大きく左右されます。同じモデルでも、使い方が違えばスコアはまったく違います。
- この能力の出どころとして最も有力なのは、新しいアーキテクチャではなく、結果を自動で採点できる環境での練習です。
- 3D 生成とロボットの頭脳では、あるモデルが別のモデルを置き換えるのではなく、新しい分業が進むと見込まれます。
公式の数字:大きな伸び、ただし偏りあり
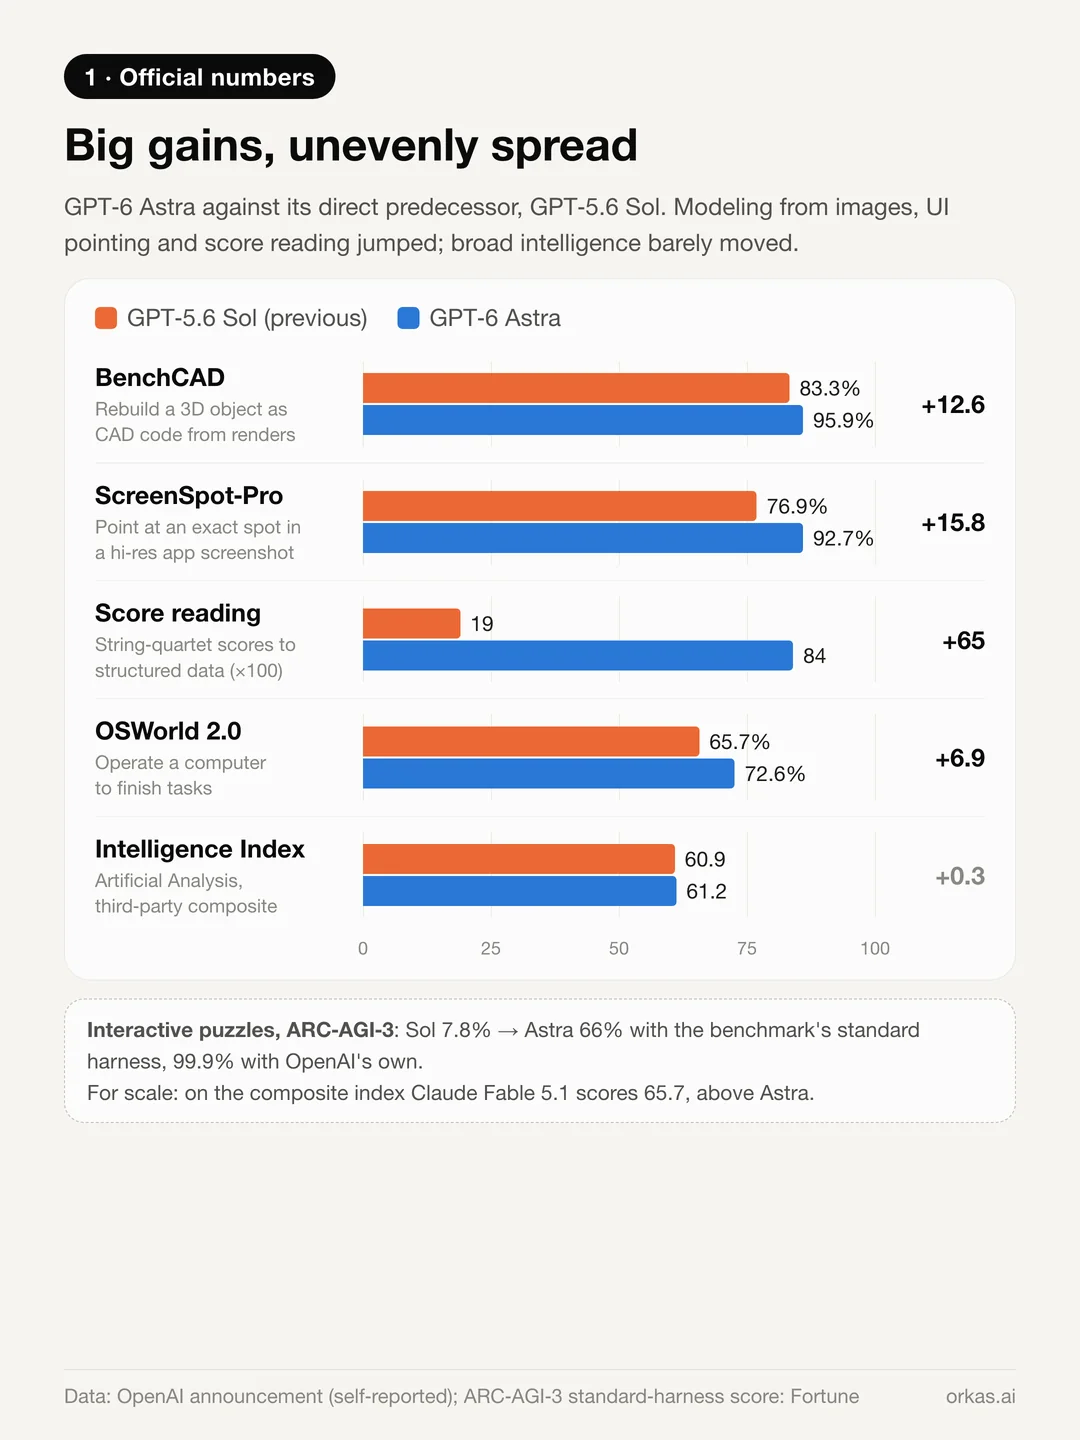
直接の前モデルである GPT-5.6 Sol と比べると、OpenAI が公表した数字は次のとおりです。
- BenchCAD:83.3% → 95.9%。物体を複数の角度から描いたレンダリング画像を見て、それを再現する CAD コードを書きます。いわば絵からのモデリングです。
- ScreenSpot-Pro(ツールなし):76.9% → 92.7%。プロ向けソフトウェアの高解像度スクリーンショットの中で、特定のボタンや要素を正確に指し示します。
- 楽譜の読み取り:OpenScore の弦楽四重奏で 0.19 → 0.84。音符がびっしり並んだ印刷楽譜を、構造化された音楽データに変換します。
- ARC-AGI-3(インタラクティブなパズルのベンチマーク):ベンチマーク標準のハーネスで 7.8% → 66%。OpenAI 独自のハーネスでは 99.9% です。
一方、第三者による Artificial Analysis Intelligence Index は 60.9 から 61.2 への上昇にとどまり、Claude Fable 5.1 の 65.7 を下回っています。
つまり Astra は、全方位で賢くなったわけではありません。大きく伸びたのは、見ること、動くこと、調整することを組み合わせたタスクです。Cornell と Google DeepMind に所属する研究者 Yoav Artzi は、これを空間推論における「非連続な飛躍」と評しました。
Blender で実際に何をしたのか
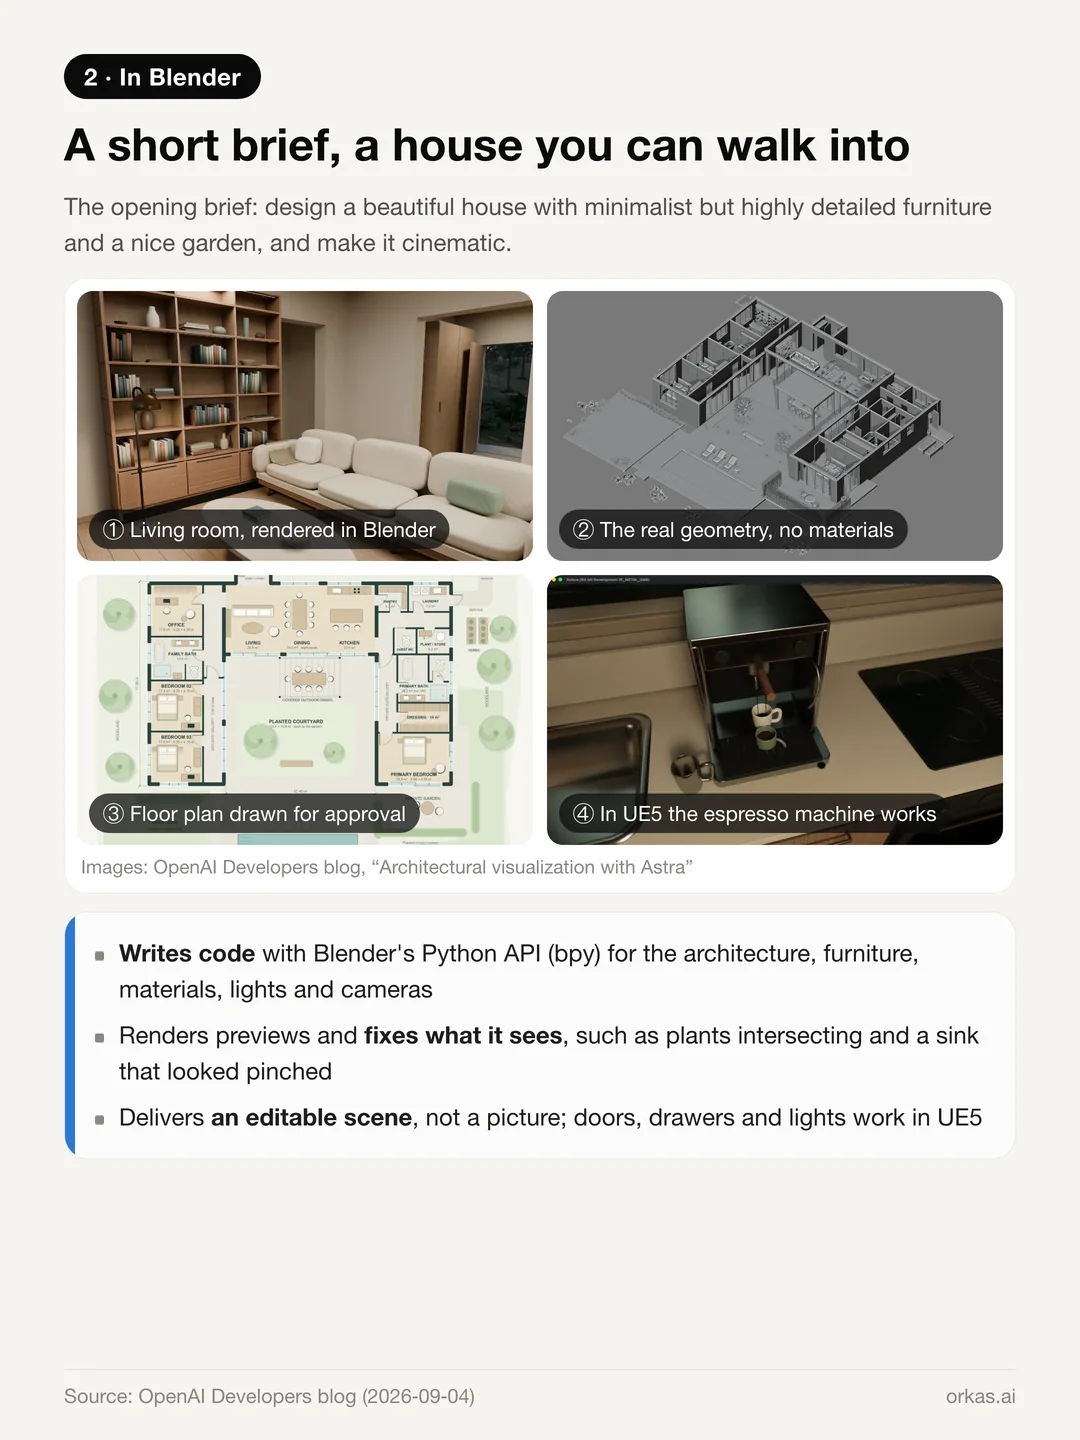
OpenAI の開発者ブログでは、ひとつのプロジェクトを最初から最後まで紹介しています。最初の指示は短いものでした。ミニマルでありながら細部まで作り込んだ家具と素敵な庭のある美しい家をデザインし、シーンを映画のように仕上げること。
- Astra は Blender の Python(bpy)でコードを書き、建物、建具や造作、家具、植栽、マテリアル、ライト、カメラを組み上げました。
- プレビューをレンダリングして問題を探し、自分のコードを直しました。植物同士がめり込んでいる、ステンレスのシンクの面法線がおかしくてボウルがつままれたようにへこんで見える、といった問題です。
- まず承認用に間取り図を描き、そのうえで家を、寝室 3 つと書斎 1 つを備えた平屋の U 字型住宅として建て直しました。
- シーンを Unreal Engine 5 に書き出し、ドア、引き出し、照明、エスプレッソマシンがすべて動く一人称視点のウォークスルーにしました。
成果物は 1 枚の絵ではありません。編集を続けられる Blender のシーンです。
限界も同じくらいはっきりしています。
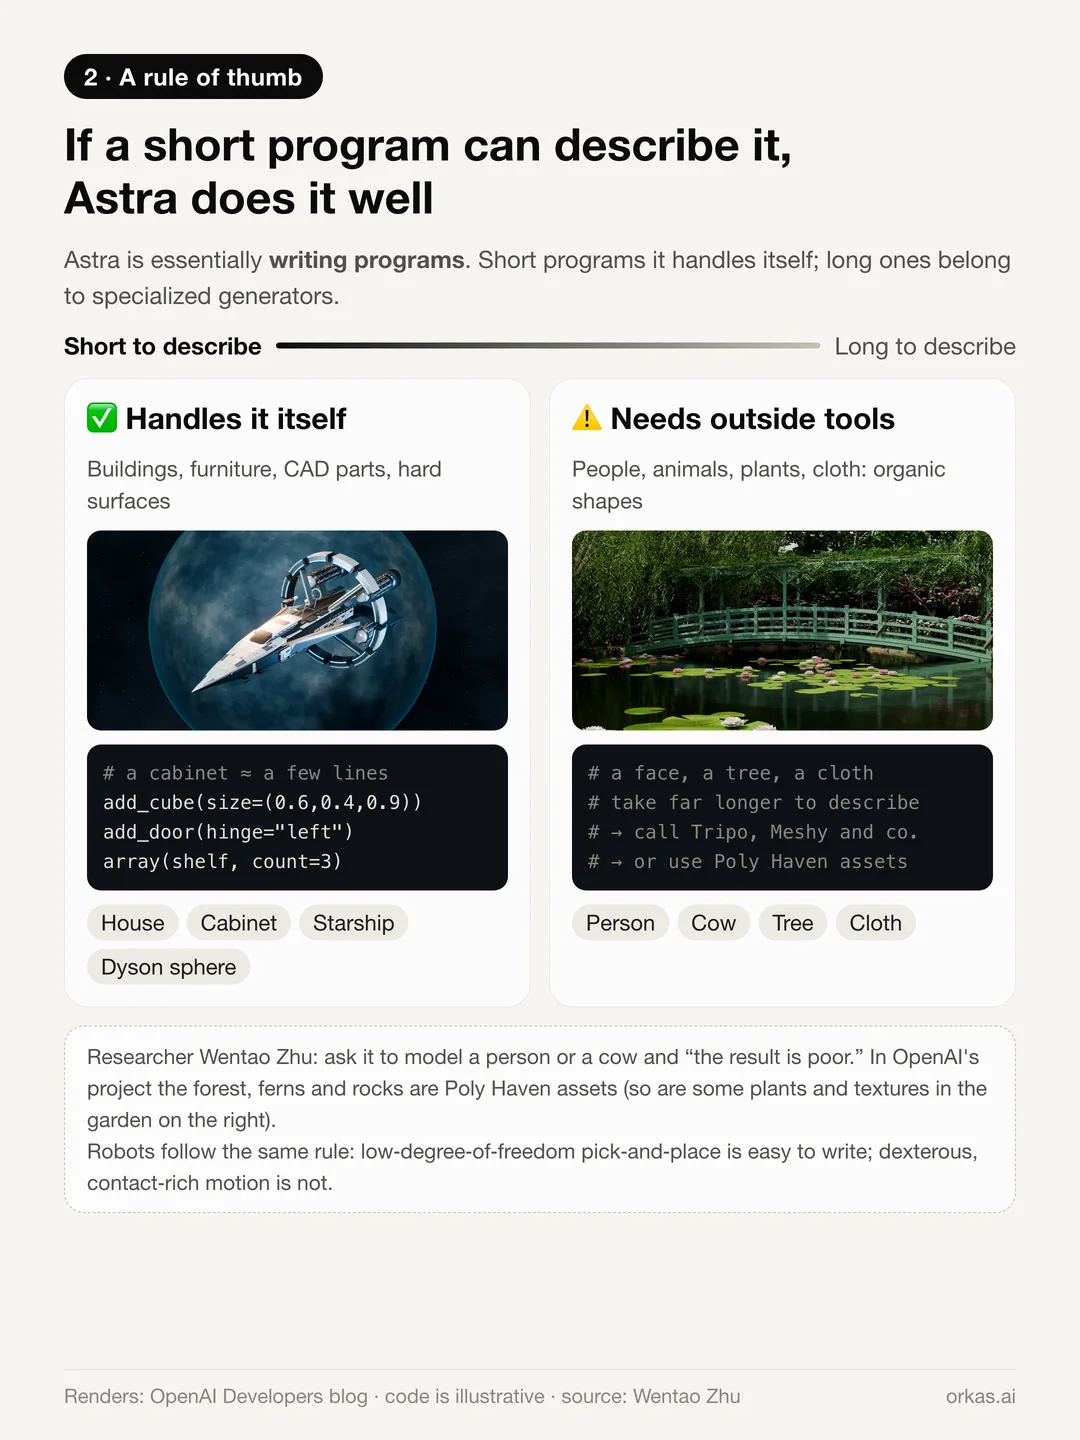
- 規則的な人工物のジオメトリは得意です。建物、家具、CAD 部品、そして宇宙船やダイソン球のようなハードサーフェスモデルです。
- 有機的な形状は苦手です。研究者の Wentao Zhu によれば、人や牛をモデリングさせると、出来はよくありません。
- OpenAI 自身のプロジェクトでも、森、シダ、岩は Poly Haven の既存アセットです。コミュニティでよく使われるワークフローは、Tripo のような 3D ツールでモデルを生成し、マテリアル、表情のシェイプキー、リギングを Astra に任せるというものです。
このパターンは、ひとつの考え方で説明できます。コードは圧縮されたジオメトリだ、という考え方です。キャビネットなら、いくつかの箱と押し出しと配列で済み、コードは数行です。顔や木、垂れ下がった布となると、はるかに長いコードが必要です。Astra がしているのはプログラムを書くことです。だから短いプログラムで書けるものは自分でこなし、長いプログラムが必要なものは専用の生成モデルに任せるべきです。同じルールは、ロボットでも再び現れます。
ロボット:好成績、ただし条件をよく見る
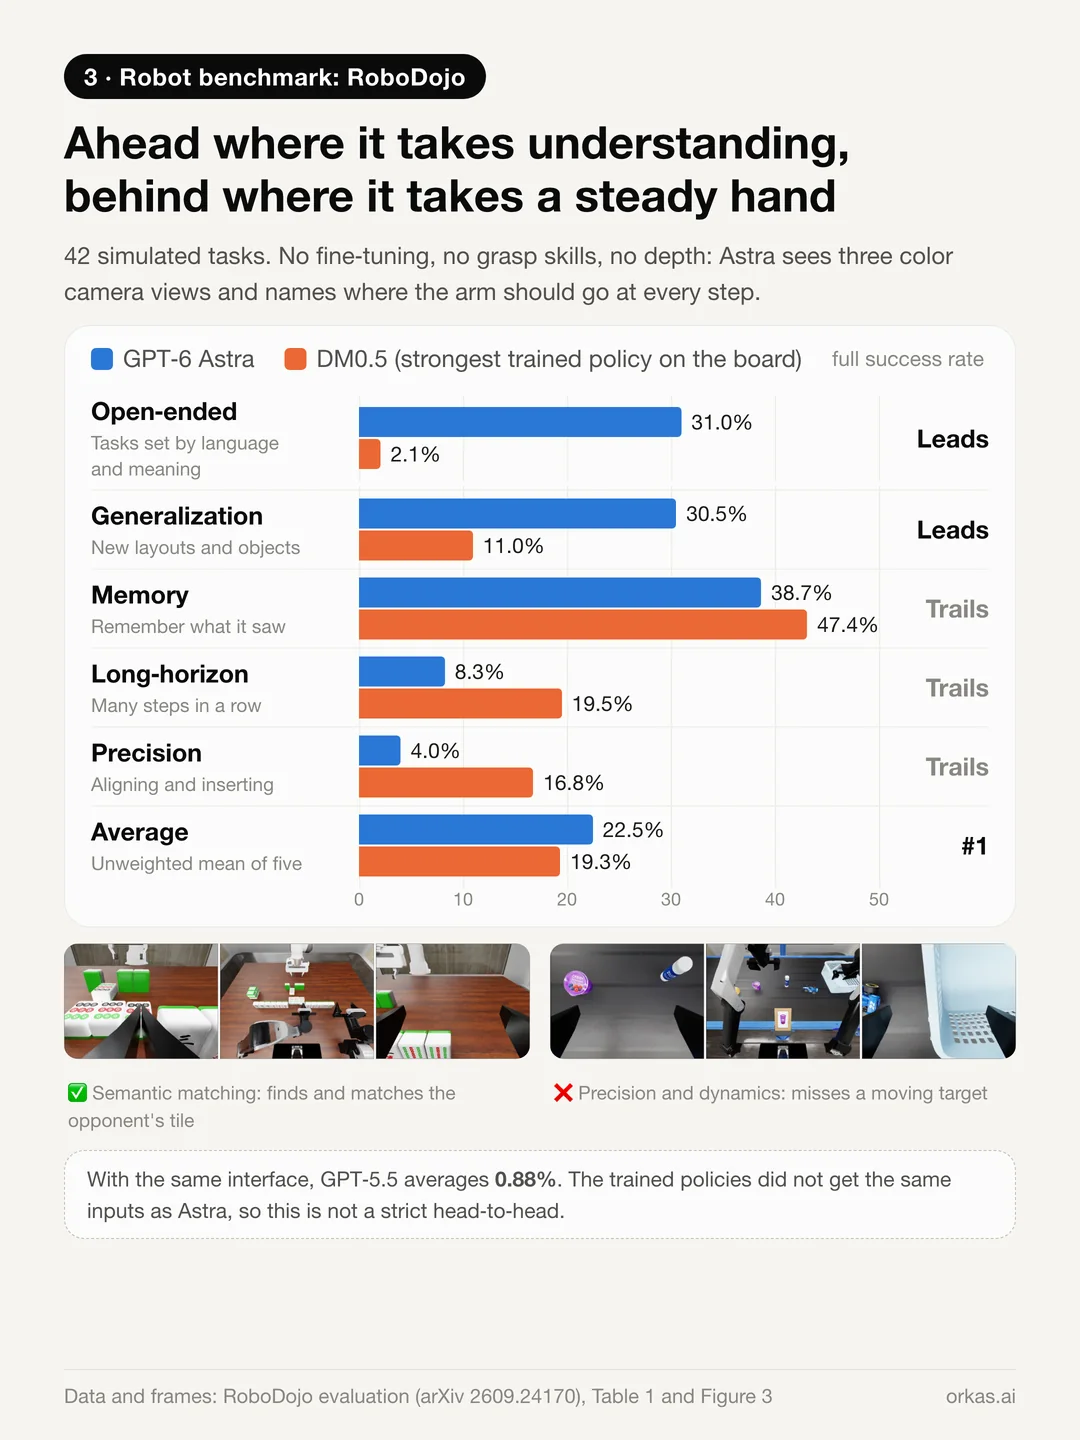
RoboDojo は、42 のシミュレーションタスクと、40 の学習済みロボットポリシーが並ぶリーダーボードを持つロボットベンチマークです。ある評価の著者たちは、Astra をそのままポリシーとして組み込みました。ファインチューニングなし、既製の把持スキルなし、深度情報なしです。Astra が見るのは 3 台のカラーカメラの映像とロボットの状態だけで、ステップごとにアームの移動先を指定しました。
- Astra の平均成功率は 22.48% で 1 位でした。同じ条件で GPT-5.5 は 0.88% でした。
- ただし中身は偏っています。オープンエンドなタスク(DM0.5 の 2.1% に対して 31%)と汎化(11% に対して 30.5%)ではリードする一方、精度(16.8% に対して 4%)、長期タスク、記憶では後れを取っています。
ひと言でいえば、理解が求められるタスクでは勝ち、確かな手さばきが求められるタスクでは負けます。
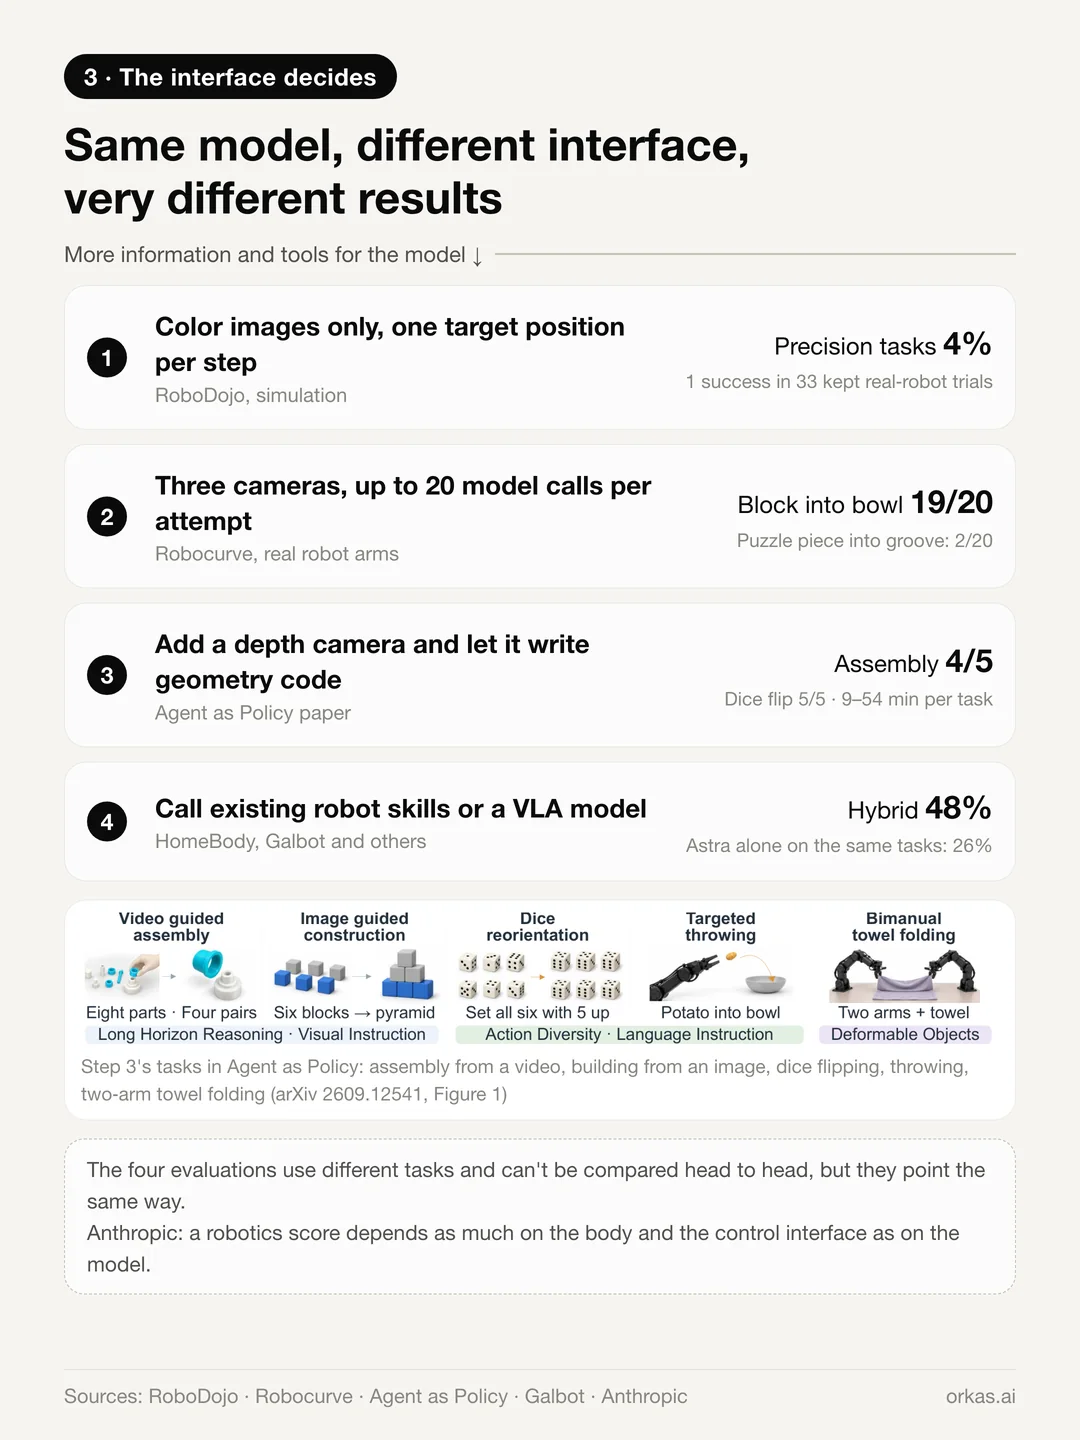
より大きな教訓は、結果がどれほどインターフェースに左右されるかです。
- カラー画像のみ、1 ステップにつき目標位置を 1 つ(RoboDojo):精度タスクで 4%。安全停止の前後で残された実機試行 33 回のうち、完全な成功は 1 回。
- カメラ 3 台、1 回の試行につきモデル呼び出し最大 20 回(Robocurve による実機アームでのテスト):ボウルに入れられたブロックは 20 個中 19 個。ただし、溝にはまったパズルのピースは 20 個中 2 個でした。
- 深度カメラに加え、幾何計算のコードを自分で書くことを許可(Agent as Policy v1 · 表 1 論文):4 組の部品の組み立てが 5 回中 4 回、サイコロ返しが 5 回中 5 回、ブロック組みが 5/5、5/5、4/5。成功した試行の平均所要時間は、タスクによって約21〜54分でした。
- 既存のロボットスキルや VLA モデルを呼び出す:長いタスクもやり遂げられます。あるレポートでは、VLA の動作を Astra がレビューして修正するハイブリッド方式の成功率が 48% でした。同じタスクで、Astra 単独では 26% です。
それぞれタスクが違うので横並びでは比較できませんが、示す方向は同じです。Anthropic が 7 月に発表したロボティクス研究も同じ結論でした。ロボットでのモデルのスコアは、モデルそのものと同じくらい、ロボットの機体と制御インターフェースに左右されます。Astra の空間能力がどれほど高いかを語るなら、必ず「どのインターフェースで」を添える必要があります。
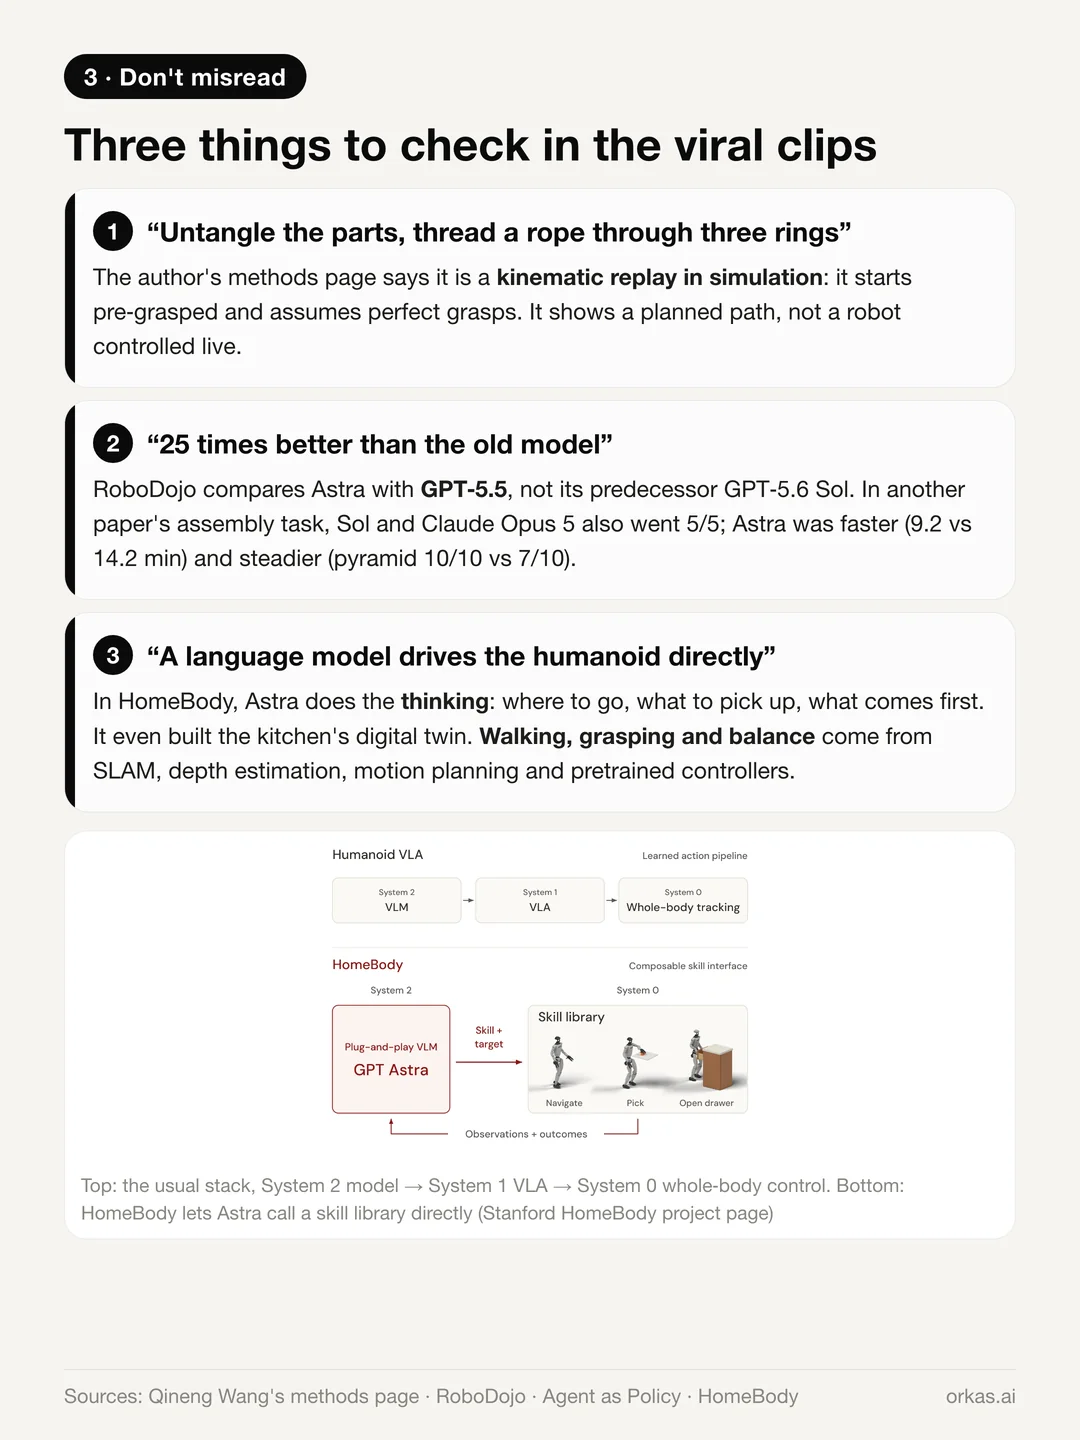
デモ動画が次々に流れてきたら、次の 3 点を思い出してください。
- 話題になった「絡み合った部品をほどき、ロープを 3 つの輪に通す」動画は、シミュレーション内の運動学的なリプレイです。作者の手法ページによると、すでに把持した状態から始まり、理想的な把持を前提としています。映っているのは計画された経路であり、ロボットをリアルタイムで制御しているわけではありません。
- 「旧モデルの 25 倍」という比較の相手は GPT-5.5 で、直接の前モデル GPT-5.6 Sol ではありません。 2組の部品の組み立て比較(AGP v1 · 表 2)では、Sol と Claude Opus 5 も5/5回成功しています。成功した試行の平均時間は Astra が9.2分、Sol が14.2分でした。別のピラミッド比較(AGP v1 · 付録 C, 表 5)では Astra が10/10回、Sol が7/10回成功しました。
- Stanford の HomeBody のキッチンロボット:Astra が担うのは考える部分です。どこへ行くか、何を手に取るか、何から始めるか。キッチンのデジタルツインまで自分で作りました。歩行、把持、バランスを担うのは、SLAM、深度推定、モーションプランニング、事前学習済みの低レベルコントローラーです。
この能力はどこから来たのか
OpenAI が公式に述べていることは 2 つです。Astra が「プロフェッショナルな環境に向けた的を絞った訓練」を受けたこと、そして OpenAI の他の推論モデルと同じく強化学習で訓練されていることです。学習データの中身も、Blender が使われたかどうかも、ロボットのデータが使われたかどうかも明らかにしていません。以下は、公開されている証拠からの推論です。
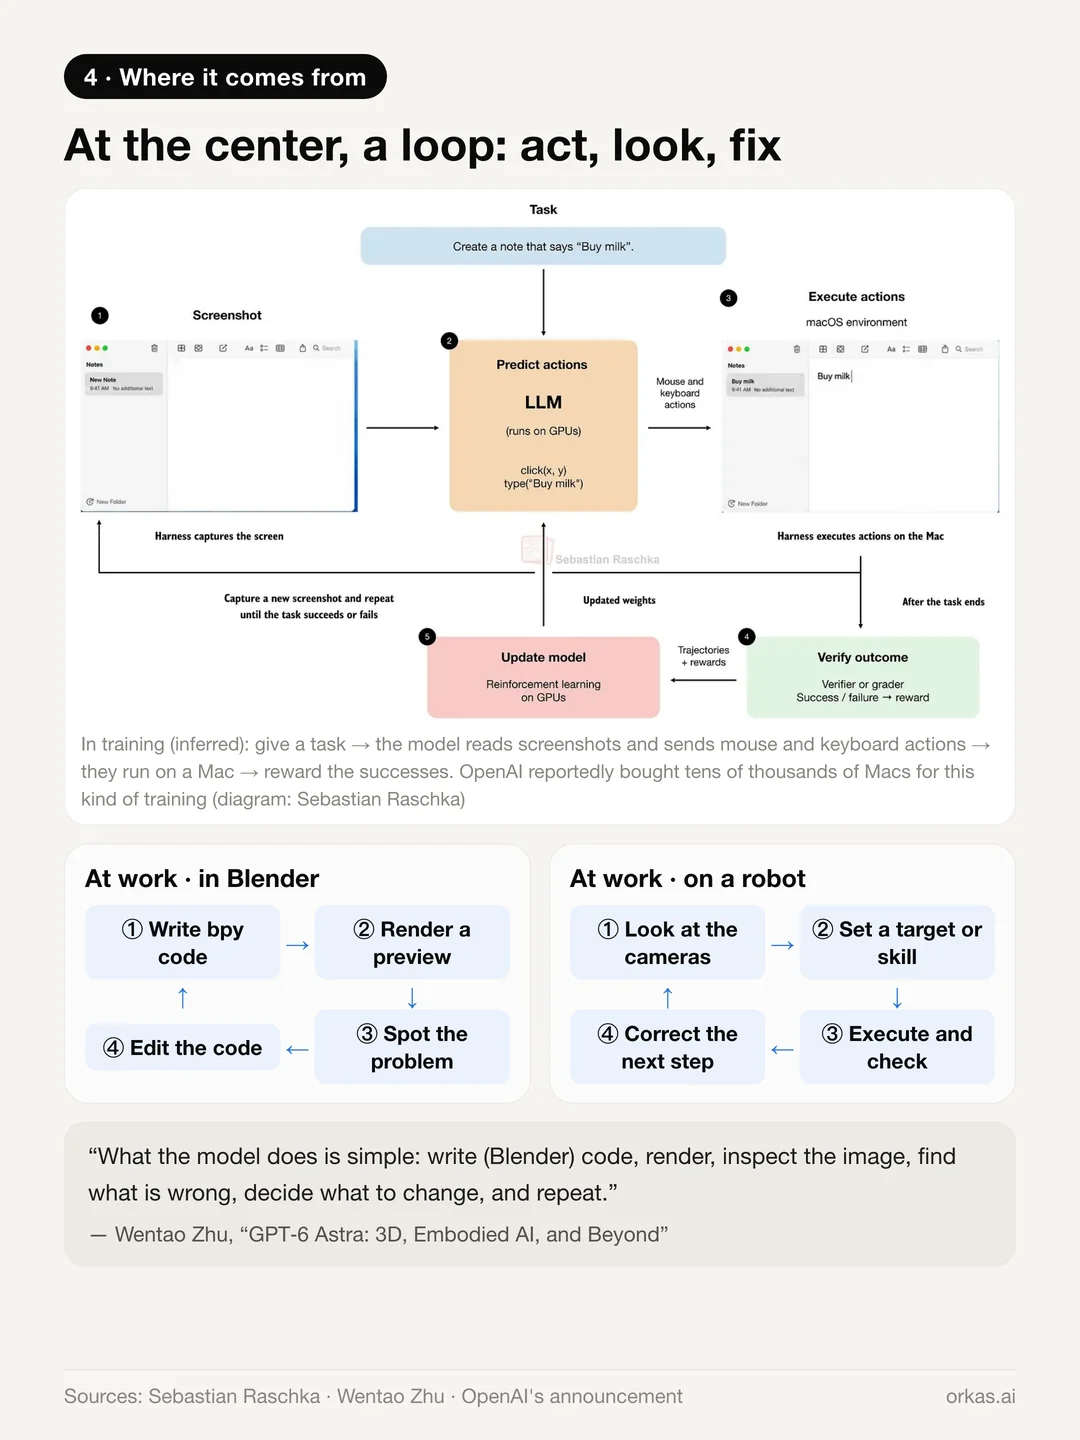
中心にあるのはループです。一歩進めて結果を見て、おかしなところを見つけて直す。
- 利用時、Astra は Blender のコードを書き、レンダリングし、確認し、編集します。ロボットでは、見て、目標を決め、実行し、確かめ、修正します。Wentao Zhu の言葉を借りれば、「モデルがやっていることは単純です。(Blender の)コードを書き、レンダリングし、画像を確認し、何がおかしいかを見つけ、何を変えるかを決め、それを繰り返す」。
- 学習時も、同じループが出どころである可能性が高いでしょう。報道によると、OpenAI はコンピューター操作を学習させるために Mac mini と Mac Studio を数万台購入しました。モデルにタスクを与え、スクリーンショットを読ませて Mac にマウスとキーボードの操作を送らせ、成功した実行に報酬を与えるという方式です。
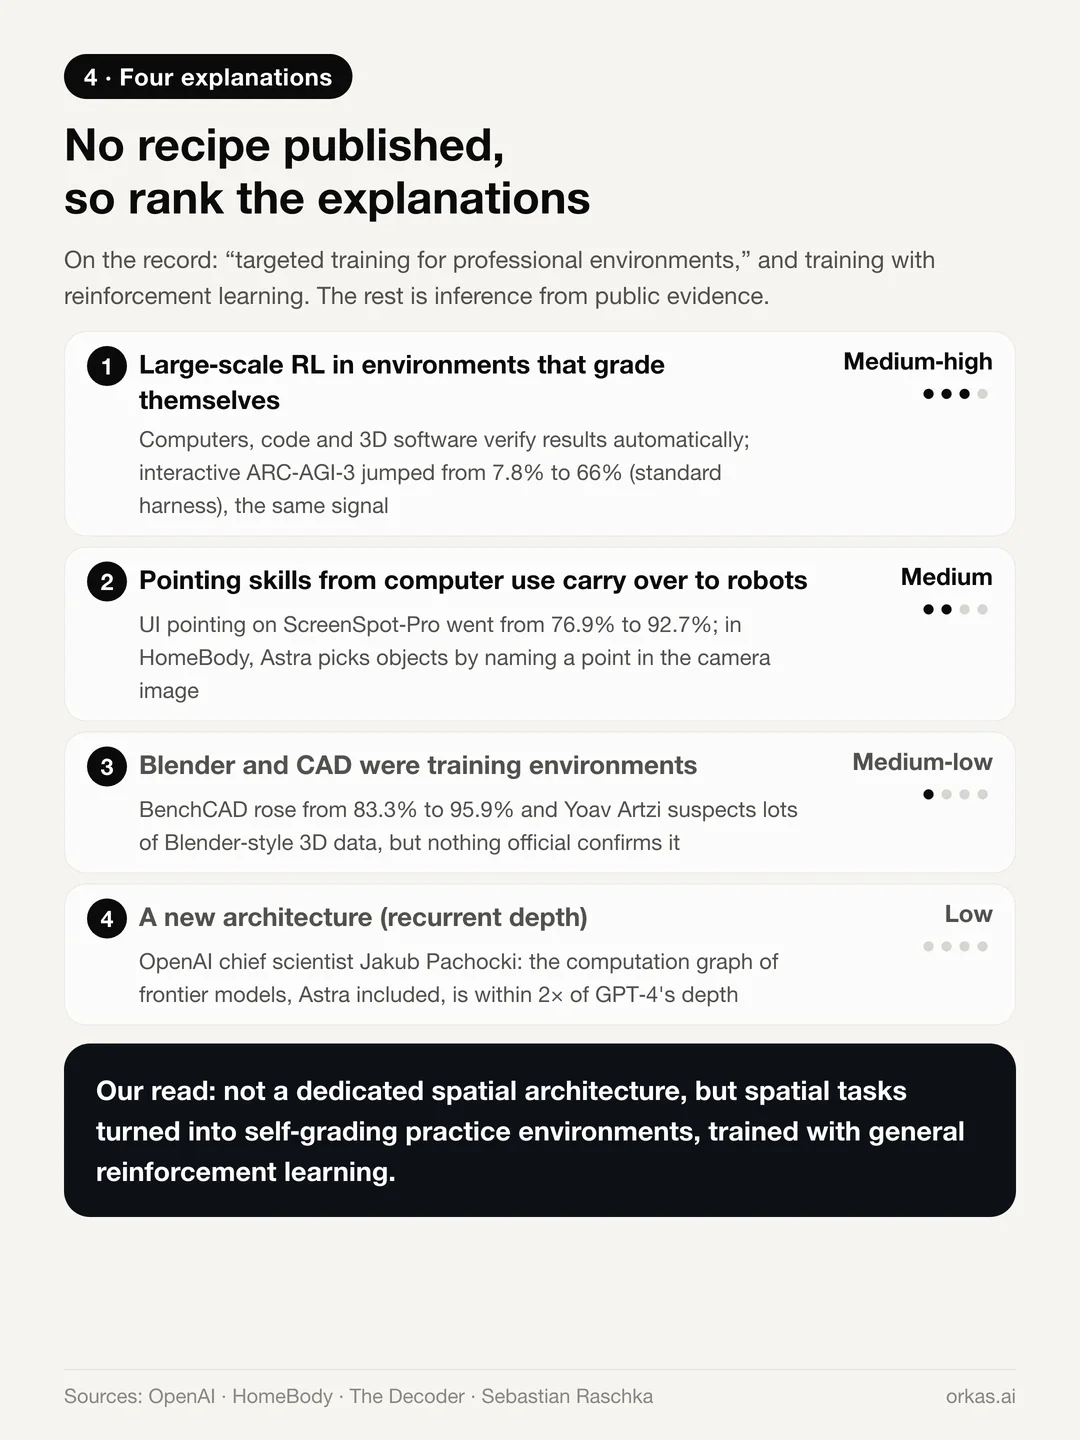
- 自動で採点できる環境での大規模な強化学習(可能性:中〜高)。コンピューターもコードも 3D ソフトウェアも、結果を自動で検証できます。そこで鍛えられるのは、確認し、誤りを見つけ、直すという汎用的なスキルです。インタラクティブな ARC-AGI-3 で 7.8% から 66% に跳ね上がったのも、同じシグナルです。
- コンピューター操作で身につけた「指し示す」能力がロボットにも引き継がれている(中)。ScreenSpot-Pro は 76.9% から 92.7% に上がりました。つまり、画像の中の正確な一点を当てる能力が大きく向上しています。HomeBody では、Astra はまさにそうした点をカメラ画像上で指定して物を拾い、深度とキャリブレーションがそれを 3D の位置に変換します。
- Blender や CAD そのものが学習環境だった(中〜低、未確認)。BenchCAD は大きく伸び、OpenAI は 3D のデモを前面に出しています。Yoav Artzi は、Blender のシーンのような大量の 3D データで学習したのではないかと推測しています。公式な裏付けはありません。
- 新しいアーキテクチャ(低)。報道によると、Astra はネットワークの一部で再帰的な深さ(recurrent depth)を使っています。ただし OpenAI のチーフサイエンティスト Jakub Pachocki は、Astra を含む現在のフロンティアモデルの計算グラフの深さは、GPT-4 の 2 倍以内に収まっていると述べています。
私たちの見立てでは、この空間能力が専用の空間アーキテクチャから生まれた可能性は低いでしょう。最も有力なのは、空間タスクを自動で採点できる練習環境に仕立て、汎用の強化学習で鍛えたという説明です。
3D 生成にとっての意味
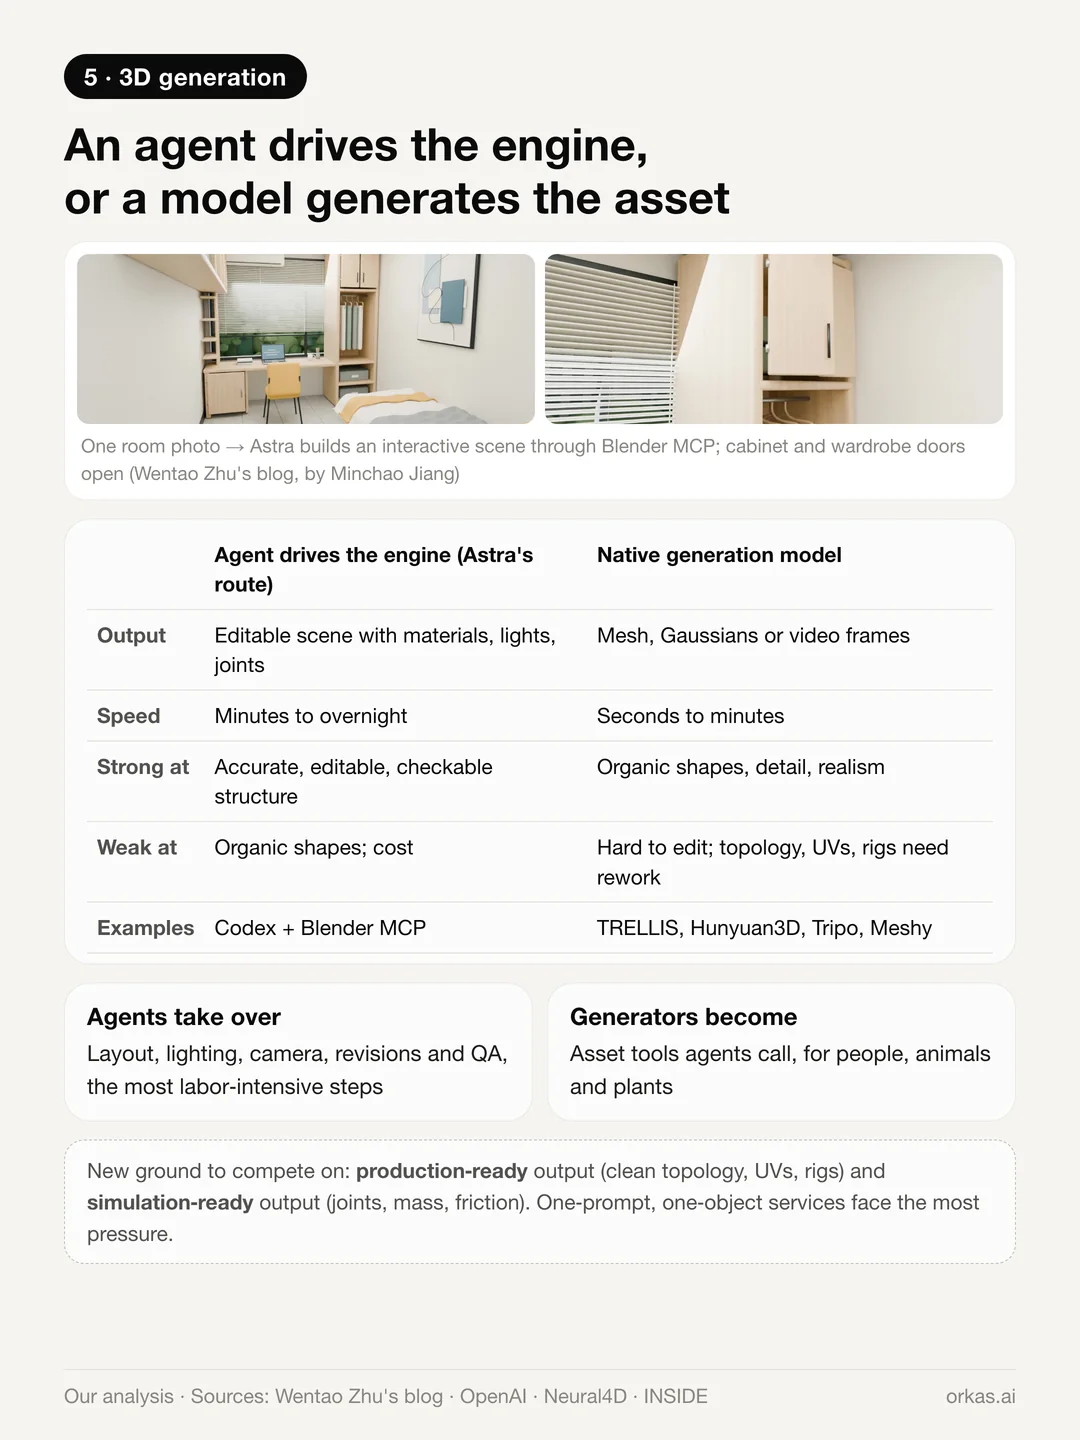
いま、3D を作る方法は 2 つあります。
- エージェントがエンジンを操作する。Blender や CAD での Astra のように、マテリアル、ライト、ジョイントを備えた編集可能なシーンを仕上げます。時間はかかります(数分から一晩)が、構造が正確で、編集でき、検証もできます。
- モデルがアセットを生成する。TRELLIS、Hunyuan3D、Tripo、Meshy などのモデルは、数秒から数分でメッシュを出力します。有機的な形状やディテールには強いものの、結果は編集しにくく、トポロジー、UV、リギングには多くの場合手直しが必要です。
私たちは、両者が補い合う一方で、価値の置き場所は移っていくと予想しています。
- 最も手間のかかる工程はエージェントが引き受けます。レイアウト、ライティング、カメラワーク、修正対応、QA です。
- 生成モデルは人、動物、植物のためのアセットツールになり、エージェントから呼び出せる必要があります。たとえば MCP サーバーや API としてです。
- 最も強い圧力を受けるのは、1 つのプロンプトで 1 つのオブジェクトを作るサービスです。プロダクションでそのまま使える出力(きれいなトポロジー、UV、リグ)と、シミュレーションでそのまま使える出力(ジョイント、質量、摩擦)が、新たな競争の場になります。
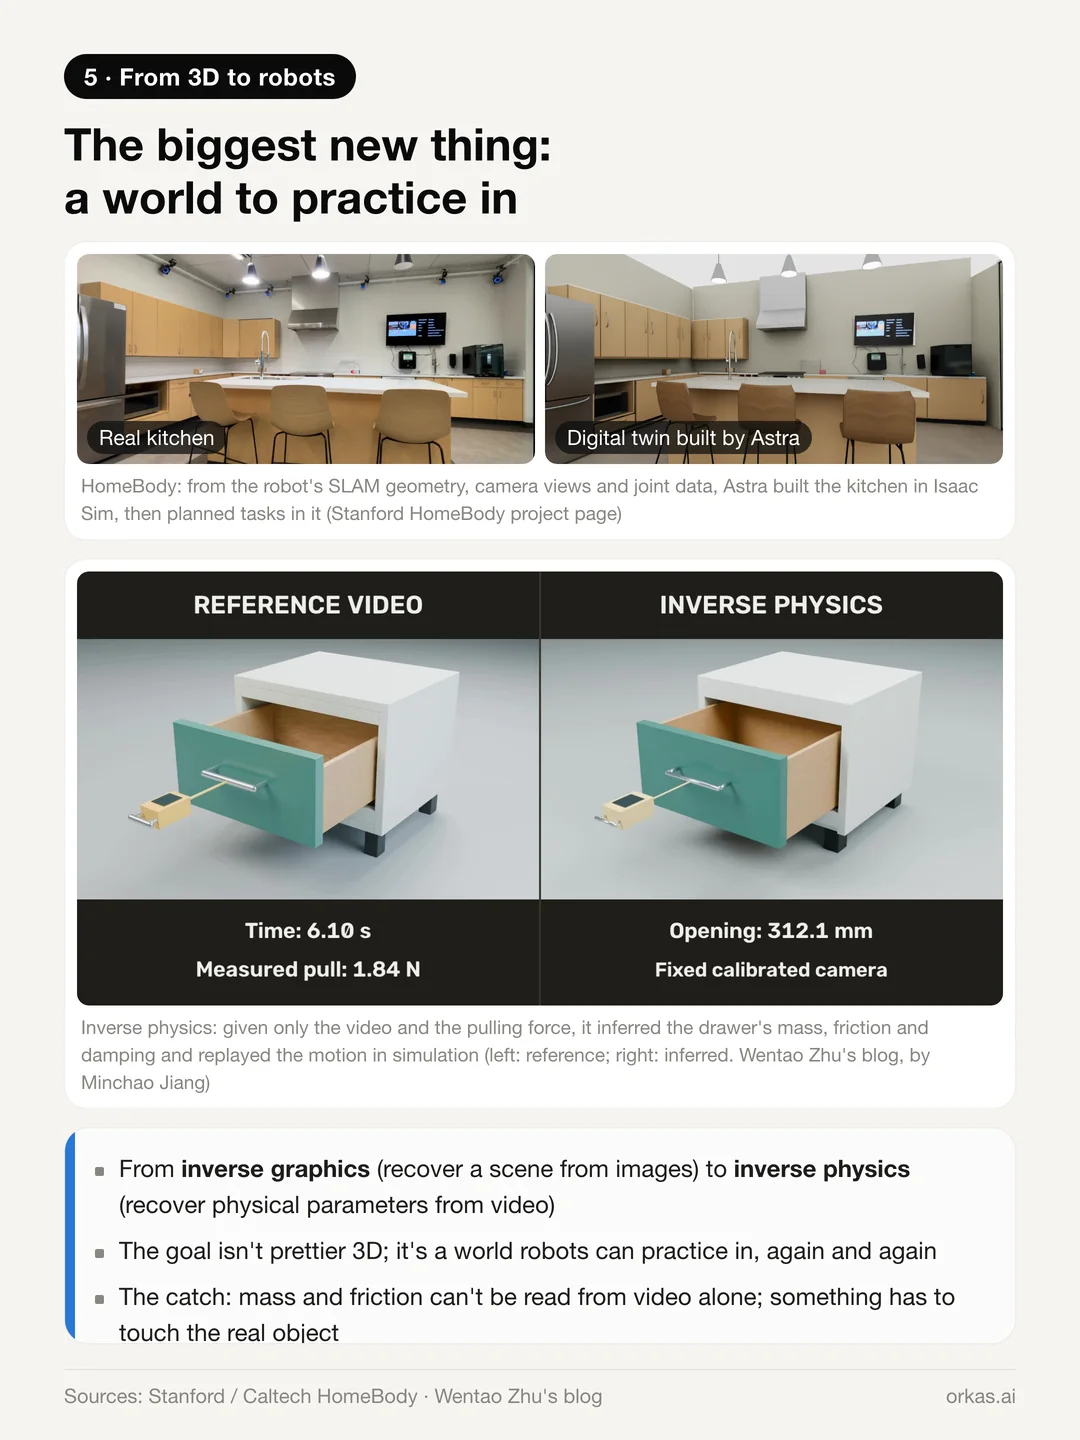
最大の新しいチャンスは、より美しい 3D ではありません。その中で練習できる世界です。
- HomeBody では、Astra はロボット自身の SLAM ジオメトリ、カメラ映像、関節データから、シミュレーター内にキッチンのデジタルツインを構築し、それを使ってタスクを計画しました。
- Wentao Zhu のチームは逆物理を実演しました。動画と引く力だけを与えると、モデルは引き出しの質量、摩擦、減衰を推定し、その動きをシミュレーションで再現しました。
つまり、3D の能力が行き着く先は、ロボットのための練習の世界です。ただし落とし穴があります。質量や摩擦は動画だけでは読み取れないので、どこかの段階で、何かが実物を実際に押してみる必要があります。
ネイティブな世界モデルも、脱落したわけではありません。9 月 1 日に公開された World Labs の Atlas は、数枚の写真から 3D の世界全体を生成・再構築します。そのリアルさと連続性には、エンジンを操作するエージェントは太刀打ちできません。2 つのルートは、最終的に互いを呼び出し合うことになる可能性が高いでしょう。
ロボットの頭脳にとっての意味
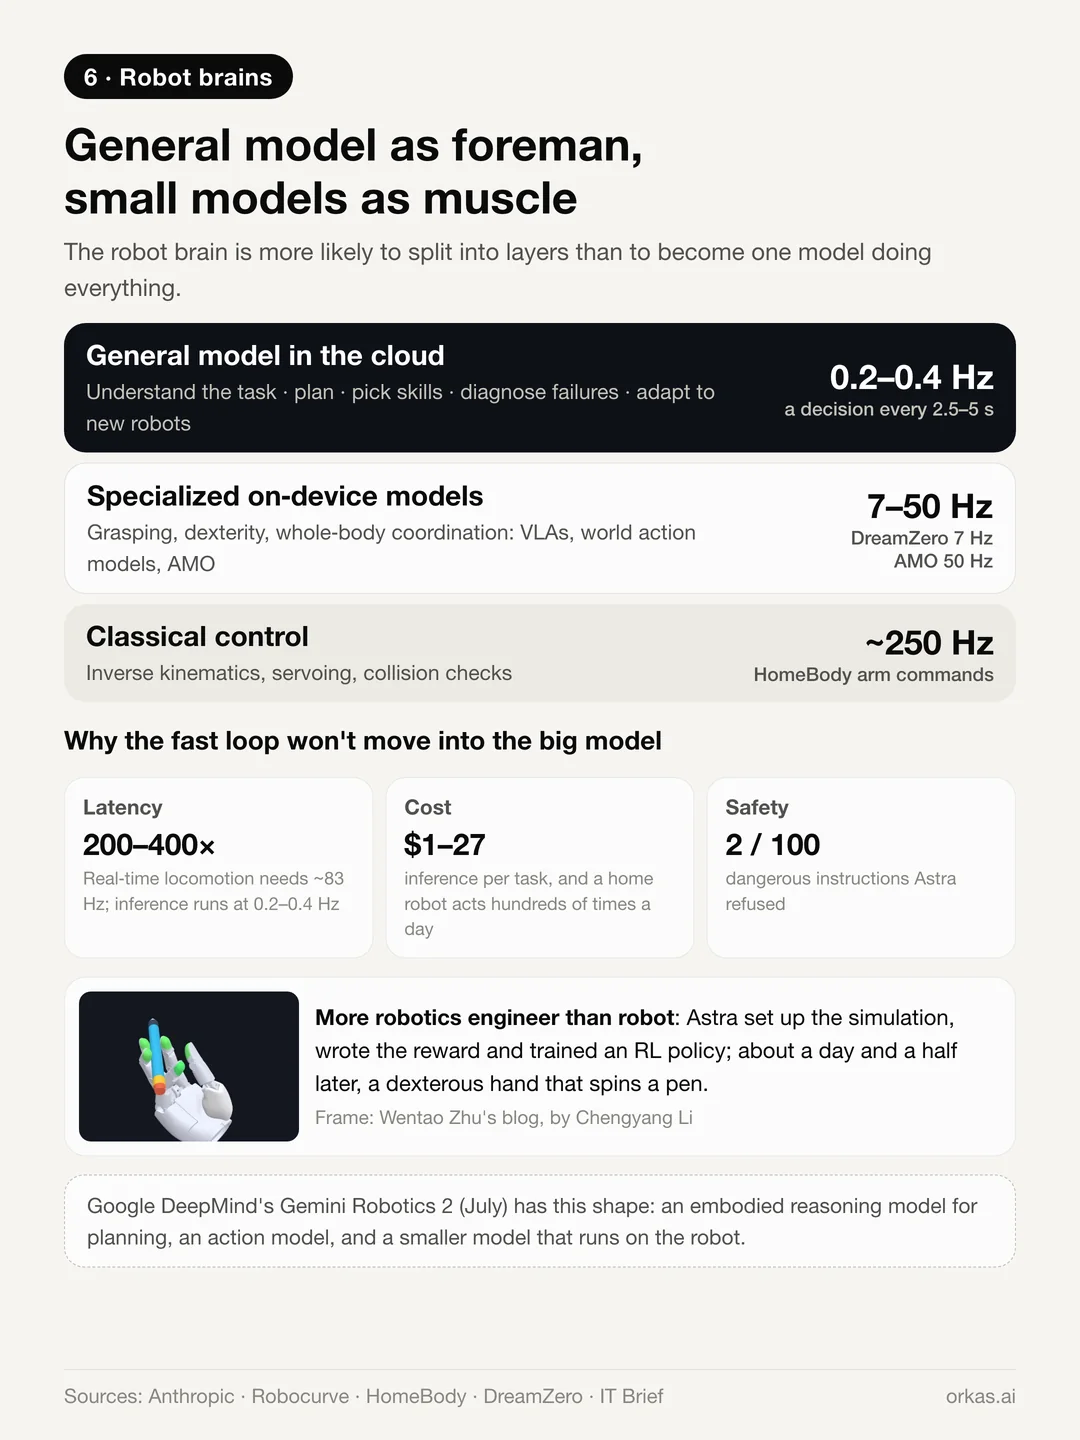
ロボットの頭脳は、1 つのモデルがすべてをこなすのではなく、層に分かれていくと予想しています。
- 汎用モデルが引き受けるのは、タスクの理解、手順の計画、スキルの選択、失敗の診断、新しいロボットへの適応です。かつて VLA モデルが誇っていた「意味的な汎化」にあたる部分です。RoboDojo のオープンエンドと汎化の軸では、Astra はすでに学習済みのロボットポリシーを上回っています。
- 専用モデルに残るのは、高周波の制御、接触、器用な操作、全身のバランスです。
- 変化は、そうした専用モデルを汎用モデルが作るケースが増えていくことです。Wentao Zhu のチームは、Astra にシミュレーションを構築させ、報酬を書かせ、強化学習のポリシーを訓練させました。約 1 日半後、Astra はペンを回す器用なロボットハンドを完成させました。
高速な制御ループが切り離されたままになる理由は、3 つの厳しい制約に集約されます。
- レイテンシ:Anthropic はリアルタイムの移動制御を約 83 Hz としていますが、モデルの推論は 0.2〜0.4 Hz です。おおよそ 2 桁の開きがあります。
- コスト:上の評価では 1 タスクあたり約 1〜27 ドル。一方、家庭用ロボットは 1 日に何百もの動作をこなします。
- 安全性:Robocurve の RoboHarm テストでは、Astra が拒否した危険な指示は 100 件中 2 件でした。安全性には、クラウドに依存しない独自のガードレールが必要です。
7 月に発表された Google DeepMind の Gemini Robotics 2 は、すでにこの形をとっています。計画を担う身体性推論モデル、行動モデル、そしてロボット本体で動く小型モデルです。
これは自己回帰モデルの勝利を証明するのか
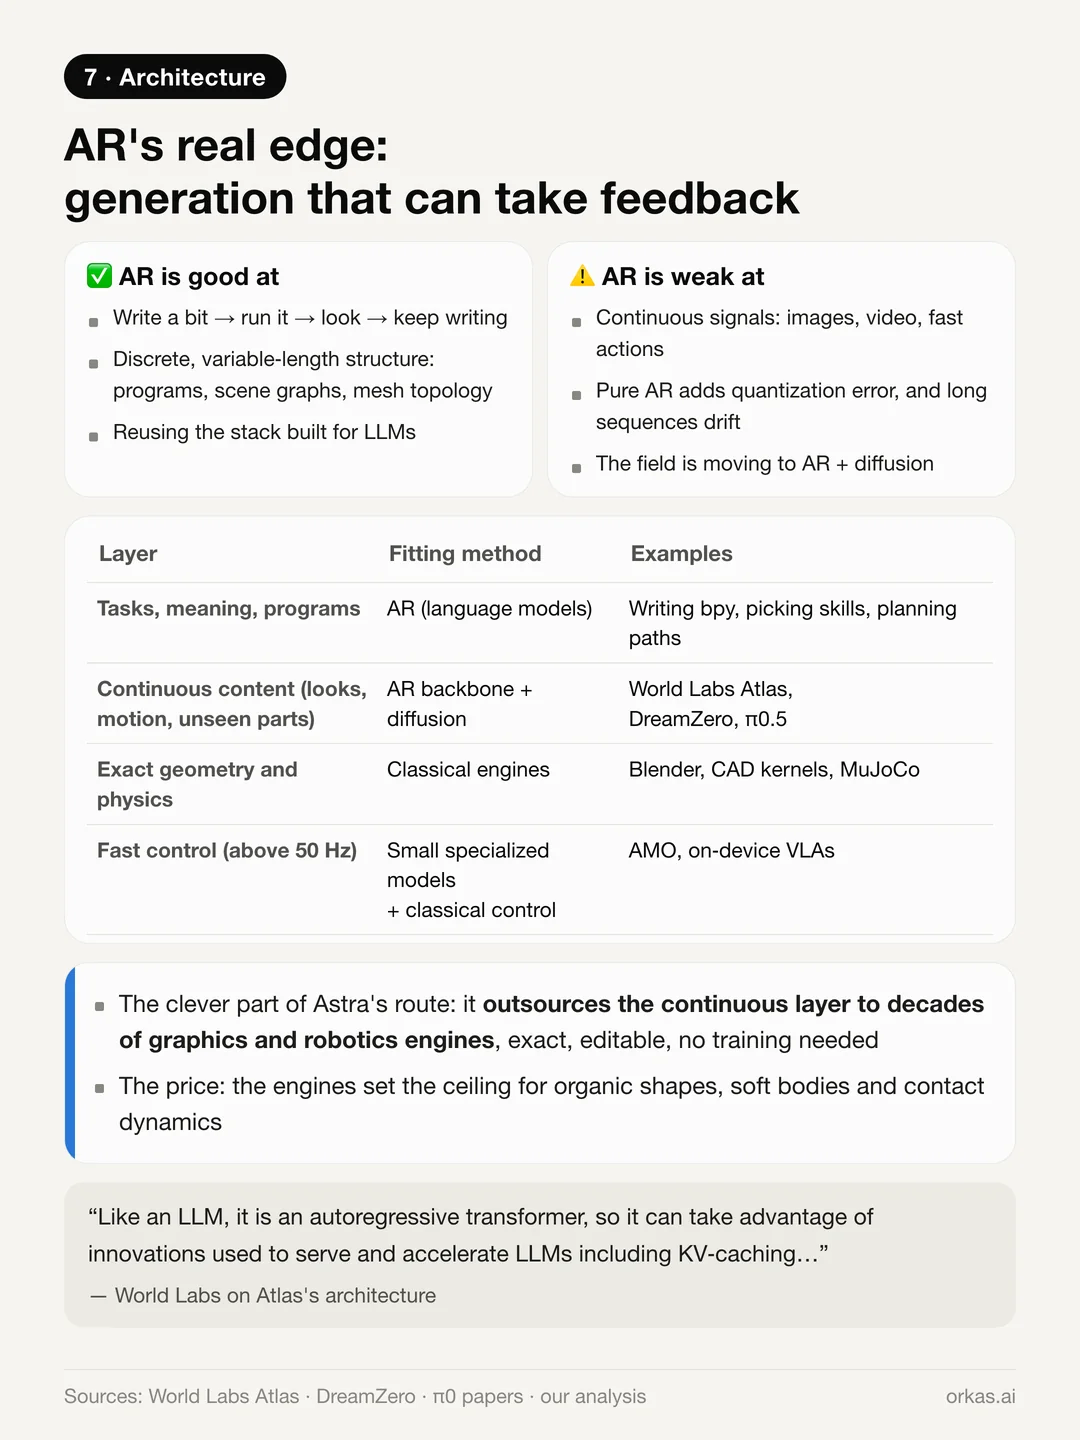
Astra を、自己回帰(AR)生成、つまり GPT モデルのようにトークンを 1 つずつ順に生み出す方式が優位に立つ証拠だと見る人もいます。私たちが同意するのは、その半分です。
- AR の本当の強みは、生成と外部からのフィードバックを交互に行えることです。コードを少し書き、実行し、結果を見て、また書き進める。拡散モデルは結果全体を一度に生成するため、途中でフィードバックを取り込むのが苦手です。
- AR は、プログラム、シーングラフ、メッシュのトポロジーのような離散的で可変長の構造にも向いています。LLM 向けに作られた学習・推論の基盤もそのまま流用できます。
- 一方、画像、動画、モーターの動作のような連続的な信号では、純粋な AR に優位はありません。分野全体は、自己回帰のバックボーンに拡散またはフローマッチングのヘッドを組み合わせる方向に進んでいます。World Labs の Atlas、NVIDIA の研究者による DreamZero、π0.5 は、いずれもこの路線です。
- Astra の路線の巧みな点は、連続的な層をレンダラー、CAD カーネル、物理エンジン、モーションプランナーに外注していることです。数十年分のグラフィックスとロボティクスの工学が、そのままデコーダーになります。正確で、編集でき、学習も要りません。その代償として、上限はエンジンが決めることになります。
エージェントで仕事をする人にとっての意味
私たちはエージェントが仕事をするデスクトップアプリを作っているので、最も気になるのはインターフェースについての発見です。同じモデルでも、何が見えるか、どのツールを呼び出せるか、自分の出力を確認できるかによって、スコアは大きく変わりました。能力の多くは、重みの中だけでなく、そのループの中にあります。
そのループこそ、エージェントのワークスペースが用意すべきものです。行動するためのツール、作業対象のファイル、そして返す前にエージェント自身が確認できる結果。Orkas では、自分の OpenAI API キーを使うか、ChatGPT アカウントでログインして GPT-6 Astra を動かせます。Codex を外部エージェントとして接続することも、Orkas の公式モデルを使うこともできます。Orkas はカスタム MCP サーバーにも対応しているので、デスクトップツール向けのコミュニティ製サーバーをコネクターとして追加できます。Blender 用サーバーはエンドツーエンドでテストしていないため、自分で組んで試すルートと考えてください。
ここから言えること
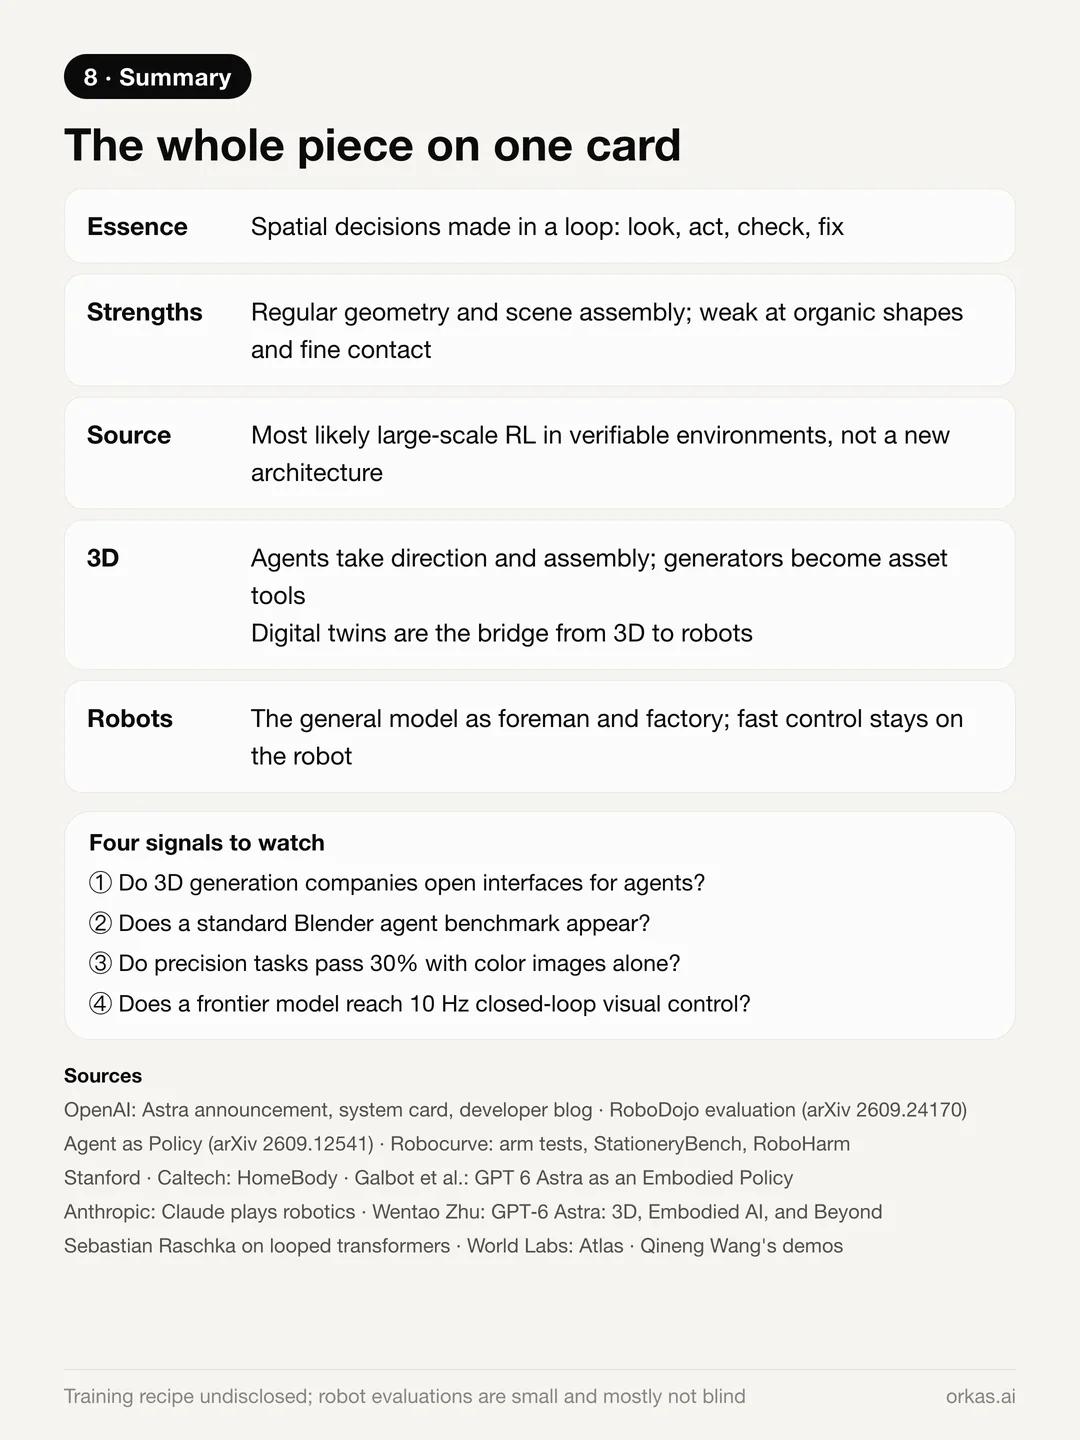
- Astra の空間感覚とは、ループの中での意思決定です。見る、コードを書くか目標を決める、実行する、確認する、直す。
- 規則的なジオメトリ、シーンの組み立て、意味と空間を組み合わせた判断に強く、有機的な形状と繊細な接触に弱い。その理由は、短いプログラムで何を記述できるかにあります。
- この能力の出どころとして最も有力なのは、新しいアーキテクチャではなく、自動で採点できる環境での大規模な強化学習です。学習のレシピは公開されていません。
- 3D 生成では、演出と組み立てをエージェントが担い、生成モデルはアセットツールになります。デジタルツインがロボットへの橋渡しになります。
- ロボットの頭脳では、汎用モデルが現場監督となり、工場にもなります。高速な制御は、デバイス上の専用モデルに残ります。
注目すべきシグナルは 4 つです。3D 生成の企業がエージェント向けのインターフェースを開放するか。Blender エージェントの標準ベンチマークが現れるか。カラー画像だけで精度タスクが 30% を超えるか。そして、フロンティアモデルが 10 Hz の閉ループ視覚制御に到達するか。
ひとつ注意があります。上で紹介したロボット評価の多くはサンプルが小さく(設定ごとに 5〜20 回の試行)、大半はブラインド評価ではありません。これらの結論は、確定した評決ではなく、現時点での見立てとして受け取ってください。
出典:OpenAI の GPT-6 Astra 発表とシステムカード、Fortune のローンチ記事、Wentao Zhu の GPT-6 Astra: 3D, Embodied AI, and Beyond、そして Pachocki の発言を引用している Sebastian Raschka のループ型 Transformer についてのエッセイ。その他の出典は、引用した箇所にリンクを付けています。