
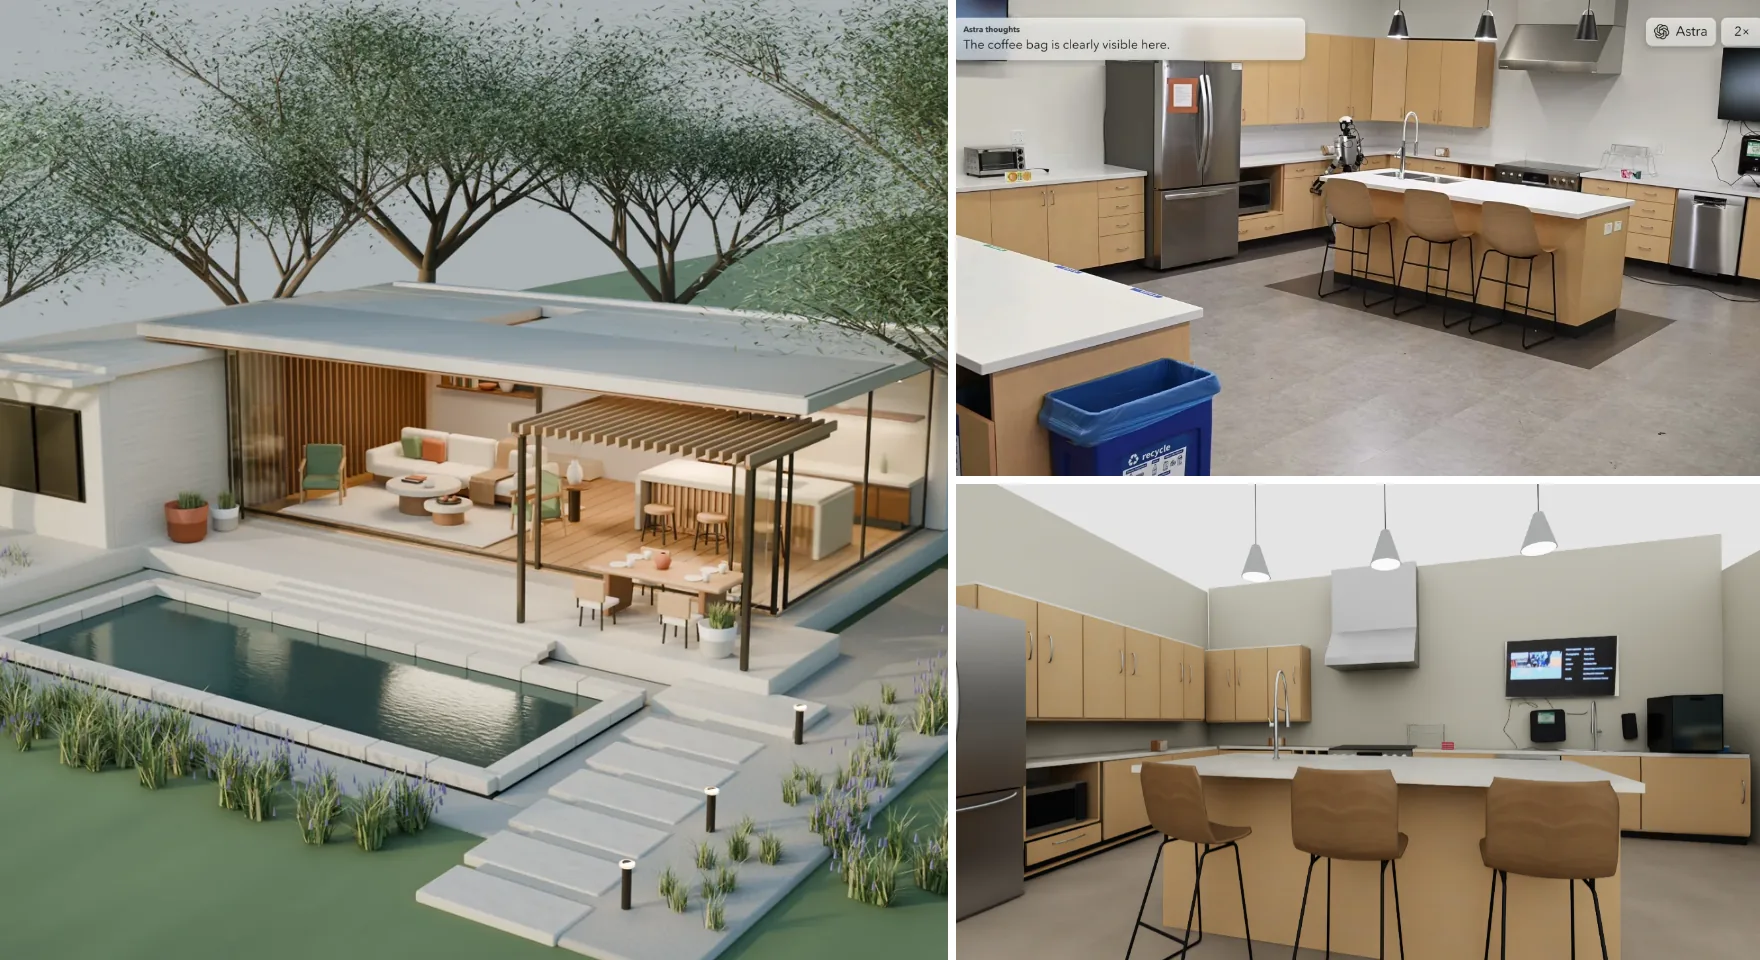
ต้นเดือนกันยายน OpenAI เปิดตัว GPT-6 Astra และมีคลิปสองแบบที่แพร่ออกไปอย่างรวดเร็ว แบบแรก มันสร้างบ้านพร้อมเฟอร์นิเจอร์ครบครันใน Blender ตั้งแต่ศูนย์ แล้วส่งออกไปยัง Unreal Engine 5 ซึ่งคุณเดินเข้าไปข้างใน เปิดประตู เปิดไฟ และใช้เครื่องชงเอสเปรสโซได้ แบบที่สอง มันสั่งการแขนกลและหุ่นยนต์ฮิวแมนนอยด์
จู่ ๆ โมเดลภาษาก็เก่งเรื่องมิติสัมพันธ์ขึ้นมาได้อย่างไร? OpenAI ปรับแต่งโมเดลเพื่อเรื่องนี้โดยเฉพาะหรือเปล่า? และแนวทางนี้มีความหมายอย่างไรต่อการสร้างงาน 3D และต่อ “สมอง” ของหุ่นยนต์? เราอ่านประกาศเปิดตัว การ์ดระบบ และบล็อกนักพัฒนาของ OpenAI ผลประเมินหุ่นยนต์ที่เผยแพร่ตามมา และบทวิเคราะห์ของนักวิจัย สรุปสั้น ๆ ได้ดังนี้:
- พัฒนาการเป็นของจริงแต่ไม่สม่ำเสมอ: งาน 3D การระบุตำแหน่งในภาพ และงานเชิงโต้ตอบพุ่งขึ้นมาก ขณะที่ความฉลาดโดยรวมแทบไม่ขยับ
- ผลด้านหุ่นยนต์ขึ้นอยู่กับอินเทอร์เฟซอย่างมาก โมเดลเดียวกันแต่ใช้งานต่างวิธี ได้คะแนนต่างกันมาก
- เป็นไปได้มากที่สุดว่าทักษะนี้มาจากการฝึกซ้อมในสภาพแวดล้อมที่ตรวจถูกผิดได้เอง ไม่ใช่จากสถาปัตยกรรมใหม่
- สำหรับการสร้าง 3D และสมองของหุ่นยนต์ ให้คาดว่าจะเกิดการแบ่งงานกันใหม่ มากกว่าที่โมเดลหนึ่งจะมาแทนที่อีกโมเดล
ตัวเลขทางการ: ก้าวกระโดดใหญ่ แต่กระจายไม่เท่ากัน
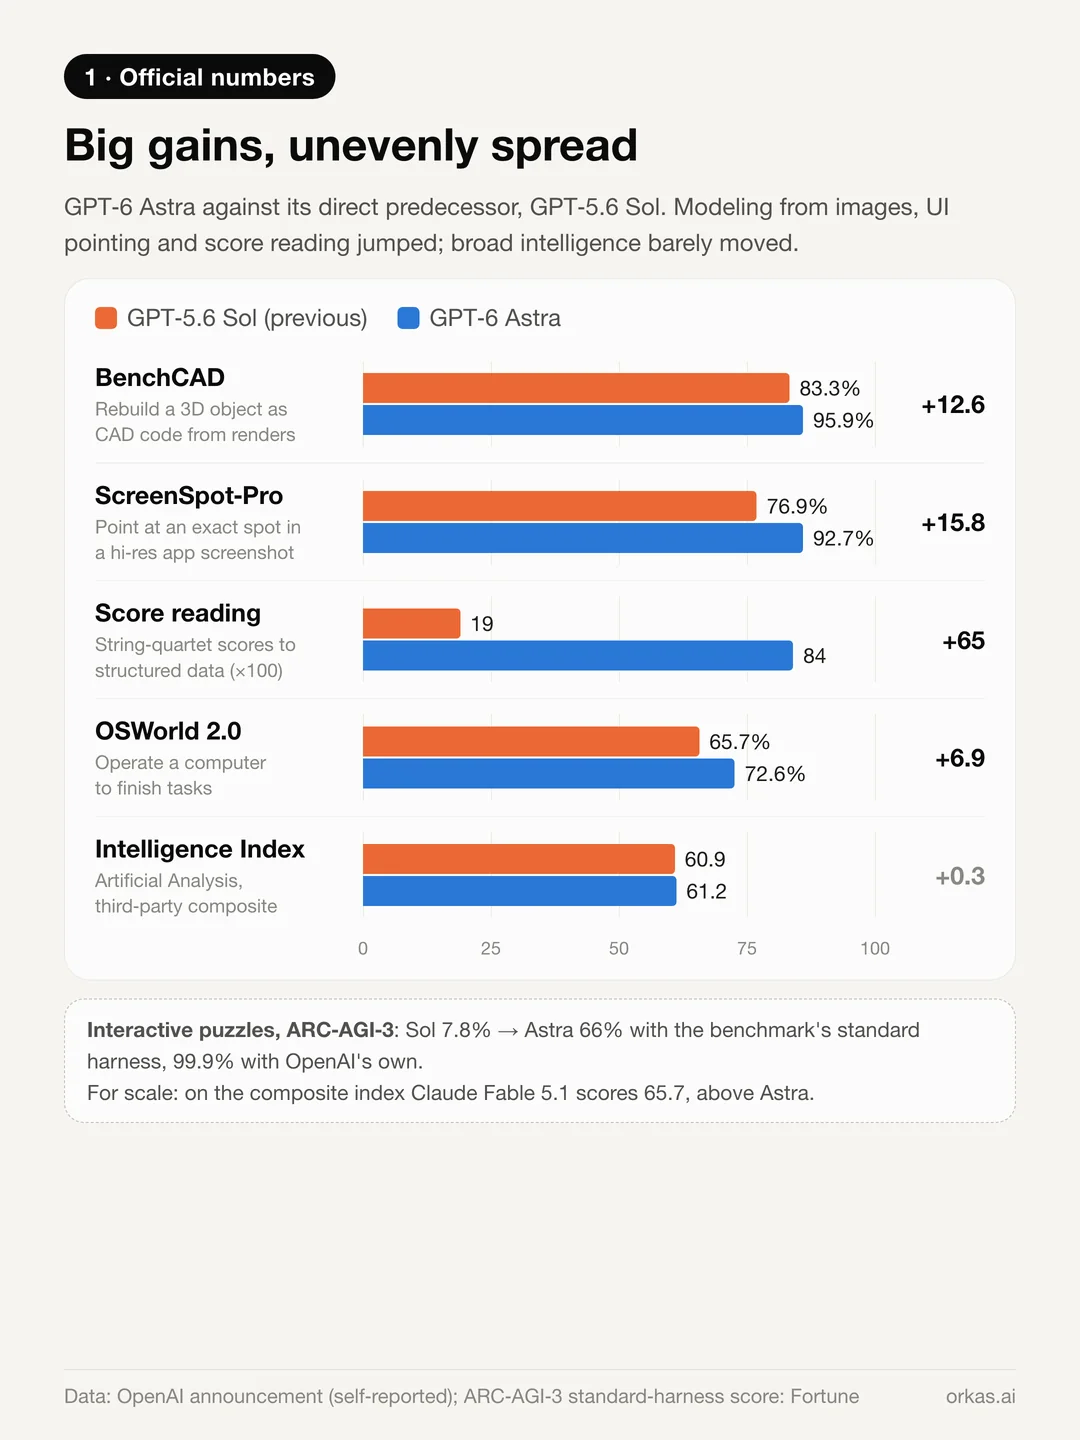
เมื่อเทียบกับ GPT-5.6 Sol ซึ่งเป็นรุ่นก่อนหน้าโดยตรง ตัวเลขที่ OpenAI เผยแพร่เป็นดังนี้:
- BenchCAD: 83.3% → 95.9% โมเดลดูภาพเรนเดอร์ของวัตถุจากหลายมุม แล้วเขียนโค้ด CAD ที่สร้างวัตถุนั้นขึ้นใหม่ หรือก็คือการขึ้นโมเดลจากภาพ
- ScreenSpot-Pro (ไม่ใช้เครื่องมือ): 76.9% → 92.7% โมเดลต้องชี้ไปที่ปุ่มหรือองค์ประกอบที่ระบุได้อย่างแม่นยำ ในภาพหน้าจอความละเอียดสูงของซอฟต์แวร์ระดับมืออาชีพ
- การอ่านโน้ตดนตรี: 0.19 → 0.84 บนบทเพลงสตริงควอร์เต็ตของ OpenScore คือการแปลงโน้ตเพลงฉบับพิมพ์ที่แน่นขนัดให้เป็นข้อมูลดนตรีที่มีโครงสร้าง
- ARC-AGI-3 เบนช์มาร์กปริศนาแบบโต้ตอบ: 7.8% → 66% เมื่อใช้ชุดทดสอบมาตรฐานของเบนช์มาร์กเอง หรือ 99.9% เมื่อใช้ชุดทดสอบของ OpenAI
ในทางกลับกัน ดัชนีความฉลาดของ Artificial Analysis ซึ่งเป็นการวัดโดยบุคคลที่สาม ขยับจาก 60.9 เป็น 61.2 ต่ำกว่า Claude Fable 5.1 ที่ได้ 65.7
ดังนั้น Astra ไม่ได้ฉลาดขึ้นในทุกด้าน แต่เก่งขึ้นมากในงานที่ผสานการมอง การลงมือ และการปรับแก้เข้าด้วยกัน Yoav Artzi นักวิจัยจาก Cornell และ Google DeepMind เรียกสิ่งนี้ว่า “ก้าวกระโดด” ของการให้เหตุผลเชิงพื้นที่
สิ่งที่มันทำจริง ๆ ใน Blender
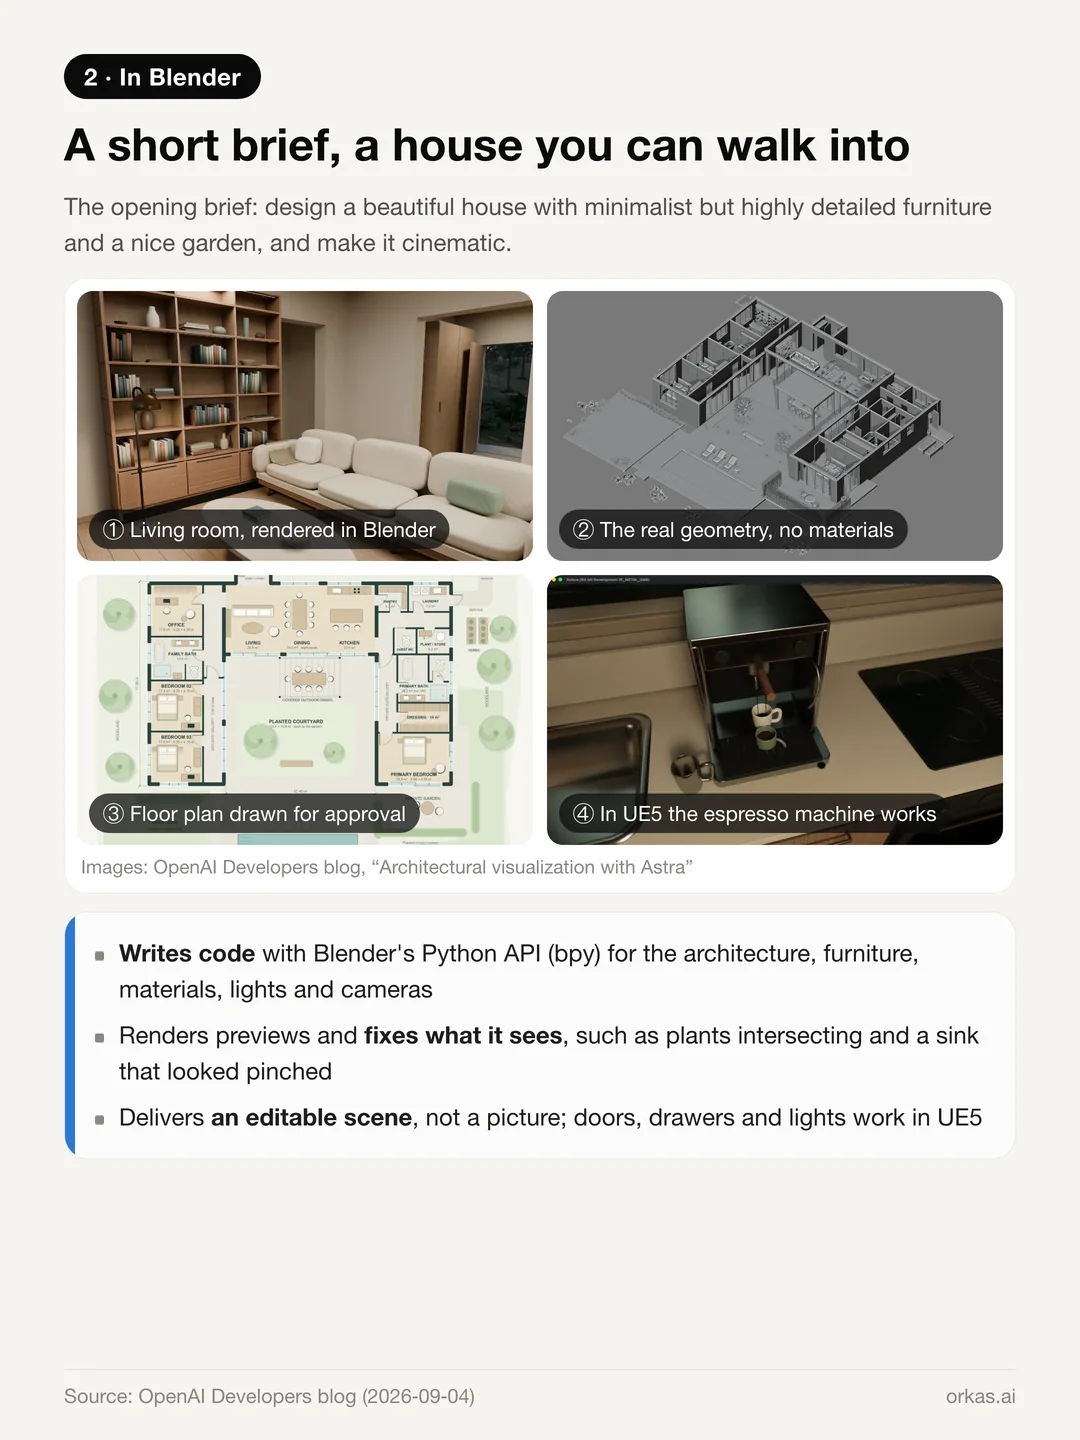
บล็อกนักพัฒนาของ OpenAI พาไล่ดูโปรเจกต์หนึ่งแบบครบทุกขั้นตอน โจทย์ตั้งต้นสั้นมาก: ออกแบบบ้านสวย ๆ ที่มีเฟอร์นิเจอร์แบบมินิมอลแต่ละเอียดมาก พร้อมสวนสวย ๆ และทำให้ฉากดูเหมือนภาพยนตร์
- Astra เขียน Blender Python (bpy) เพื่อสร้างตัวอาคาร งานไม้ เฟอร์นิเจอร์ ต้นไม้ วัสดุ แสงไฟ และกล้อง
- มันเรนเดอร์ภาพพรีวิว มองหาปัญหา แล้วแก้โค้ดของตัวเอง เช่น ต้นไม้ที่ทะลุกันเอง หรืออ่างล้างจานสเตนเลสที่นอร์มอลของพื้นผิวทำให้แอ่งอ่างดูบุบ
- มันวาดแปลนบ้านให้อนุมัติก่อน แล้วสร้างบ้านใหม่เป็นบ้านชั้นเดียวรูปตัว U มีสามห้องนอนกับห้องทำงานหนึ่งห้อง
- มันส่งออกฉากไปยัง Unreal Engine 5 เป็นการเดินชมแบบมุมมองบุคคลที่หนึ่ง ซึ่งประตู ลิ้นชัก ไฟ และเครื่องชงเอสเปรสโซใช้งานได้ทั้งหมด
สิ่งที่ได้ไม่ใช่รูปภาพ แต่เป็นฉาก Blender ที่คุณแก้ไขต่อได้เรื่อย ๆ
ข้อจำกัดก็ชัดเจนไม่แพ้กัน:
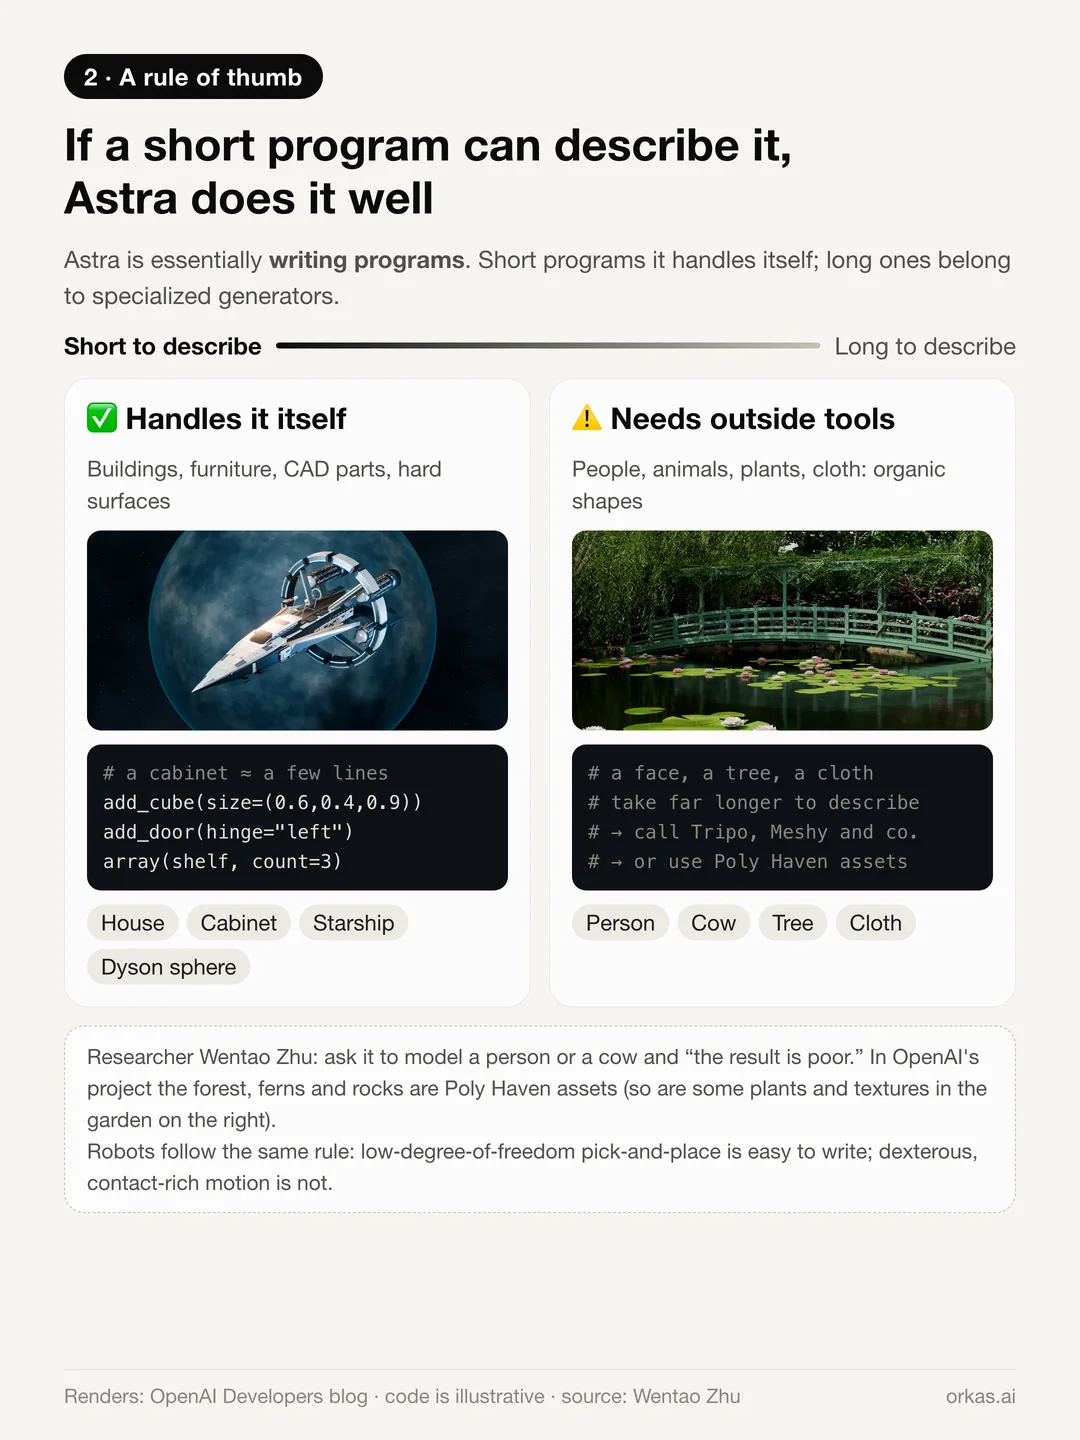
- เรขาคณิตที่เป็นระเบียบและมนุษย์สร้างขึ้นทำได้ดี: อาคาร เฟอร์นิเจอร์ ชิ้นส่วน CAD และโมเดลพื้นผิวแข็ง เช่น ยานอวกาศหรือทรงกลมไดสัน
- รูปทรงออร์แกนิกทำได้ไม่ดี Wentao Zhu นักวิจัยเขียนไว้ว่า ถ้าให้มันขึ้นโมเดลคนหรือวัว ผลที่ได้จะแย่
- ในโปรเจกต์ของ OpenAI เอง ป่า เฟิร์น และก้อนหินเป็นแอสเซ็ตสำเร็จรูปจาก Poly Haven เวิร์กโฟลว์ที่พบบ่อยในชุมชนคือสร้างโมเดลด้วยเครื่องมือ 3D อย่าง Tripo ก่อน แล้วค่อยส่งงานวัสดุ เชปคีย์สำหรับการแสดงสีหน้า และการริกกิ้งให้ Astra
แนวคิดเดียวอธิบายรูปแบบนี้ได้: โค้ดคือเรขาคณิตที่ถูกบีบอัด ตู้หนึ่งใบคือกล่องไม่กี่กล่อง การดึงขึ้นรูปหนึ่งครั้ง และการเรียงซ้ำแบบอาร์เรย์ เขียนไม่กี่บรรทัดก็พอ แต่ใบหน้า ต้นไม้ หรือผ้าที่ห้อยพลิ้วต้องใช้มากกว่านั้นมาก Astra กำลังเขียนโปรแกรม ดังนั้นสิ่งที่เขียนเป็นโปรแกรมสั้น ๆ ได้ มันจัดการเอง ส่วนสิ่งที่ต้องใช้โปรแกรมยาวก็ควรส่งต่อให้ตัวสร้างเฉพาะทาง กฎเดียวกันนี้จะกลับมาอีกครั้งกับหุ่นยนต์
หุ่นยนต์: ผลลัพธ์แข็งแกร่ง แต่ต้องอ่านเงื่อนไขให้ดี
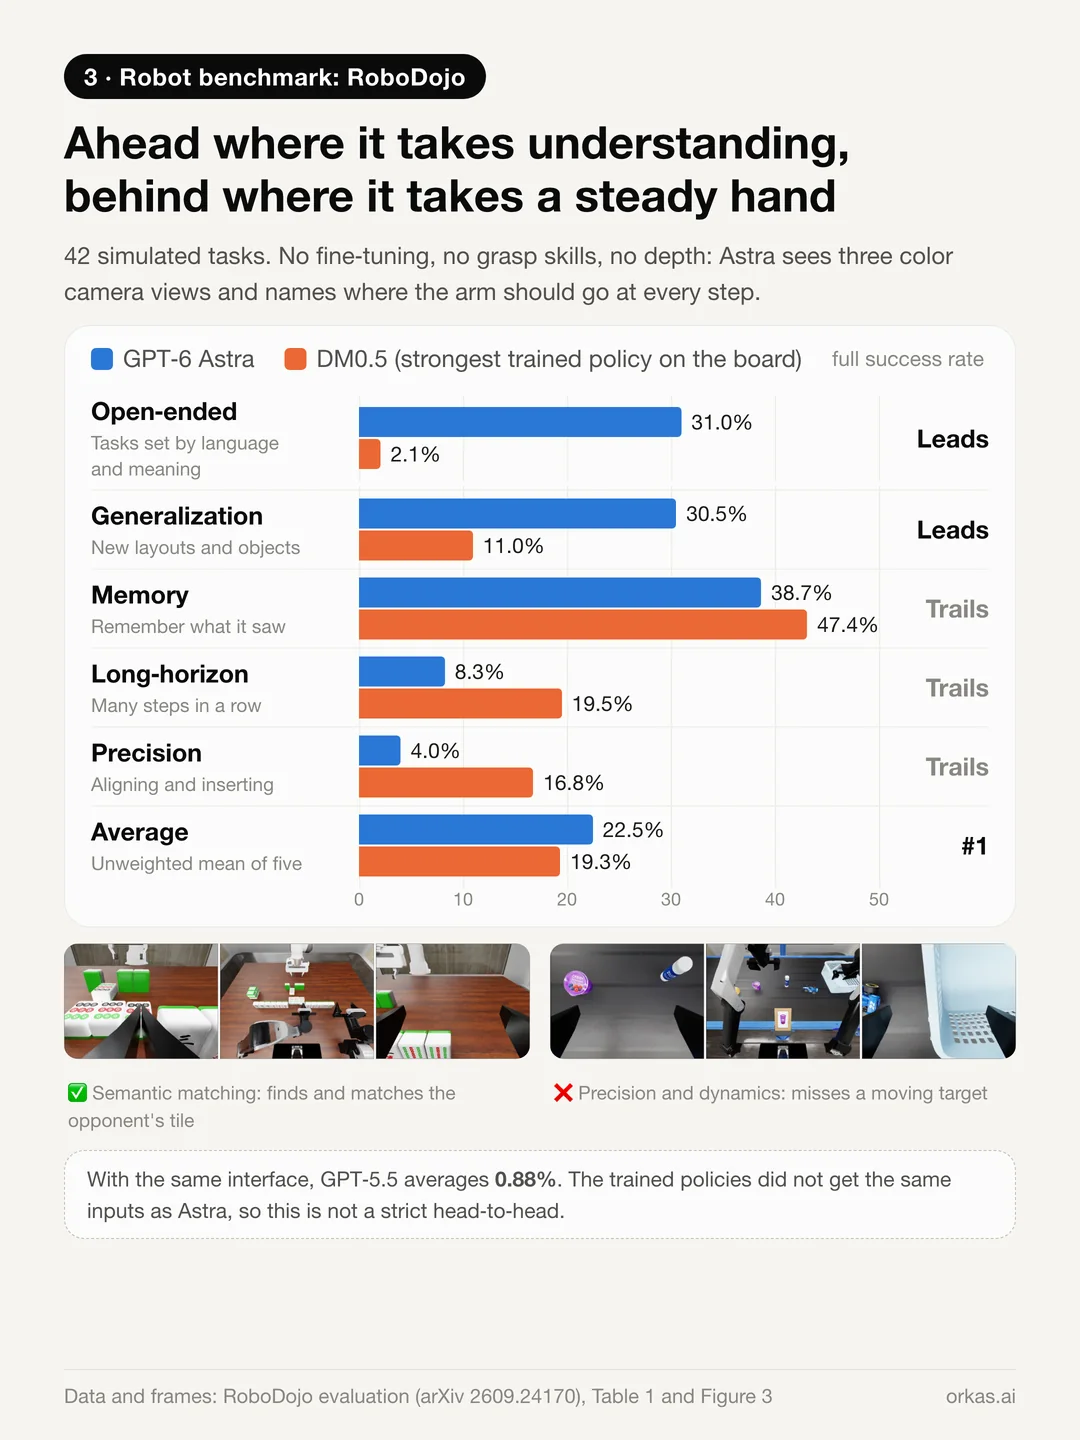
RoboDojo คือเบนช์มาร์กหุ่นยนต์ที่มีงานในการจำลอง 42 งาน และตารางอันดับของนโยบายหุ่นยนต์ที่ผ่านการฝึกมาแล้ว 40 ตัว ผู้เขียนผลประเมินชิ้นหนึ่งเสียบ Astra เข้าไปเป็นนโยบาย (policy) เองโดยตรง: ไม่มีการไฟน์จูน ไม่มีทักษะการหยิบจับสำเร็จรูป และไม่มีข้อมูลความลึก มันเห็นภาพจากกล้องสีสามมุมกับสถานะของหุ่นยนต์ แล้วระบุทุกขั้นว่าแขนควรเคลื่อนไปที่ไหน
- Astra ทำอัตราความสำเร็จเฉลี่ยได้ 22.48% และได้อันดับหนึ่ง ภายใต้การตั้งค่าเดียวกัน GPT-5.5 ทำได้ 0.88%
- แต่ภาพรวมไม่สมดุล มันนำในงานปลายเปิด (31% เทียบกับ 2.1% ของ DM0.5) และการวางนัยทั่วไป (30.5% เทียบกับ 11%) แต่ตามหลังด้านความแม่นยำ (4% เทียบกับ 16.8%) งานระยะยาว และความจำ
พูดง่าย ๆ คือ งานที่ต้องใช้ความเข้าใจ มันชนะ ส่วนงานที่ต้องใช้มือนิ่ง มันแพ้
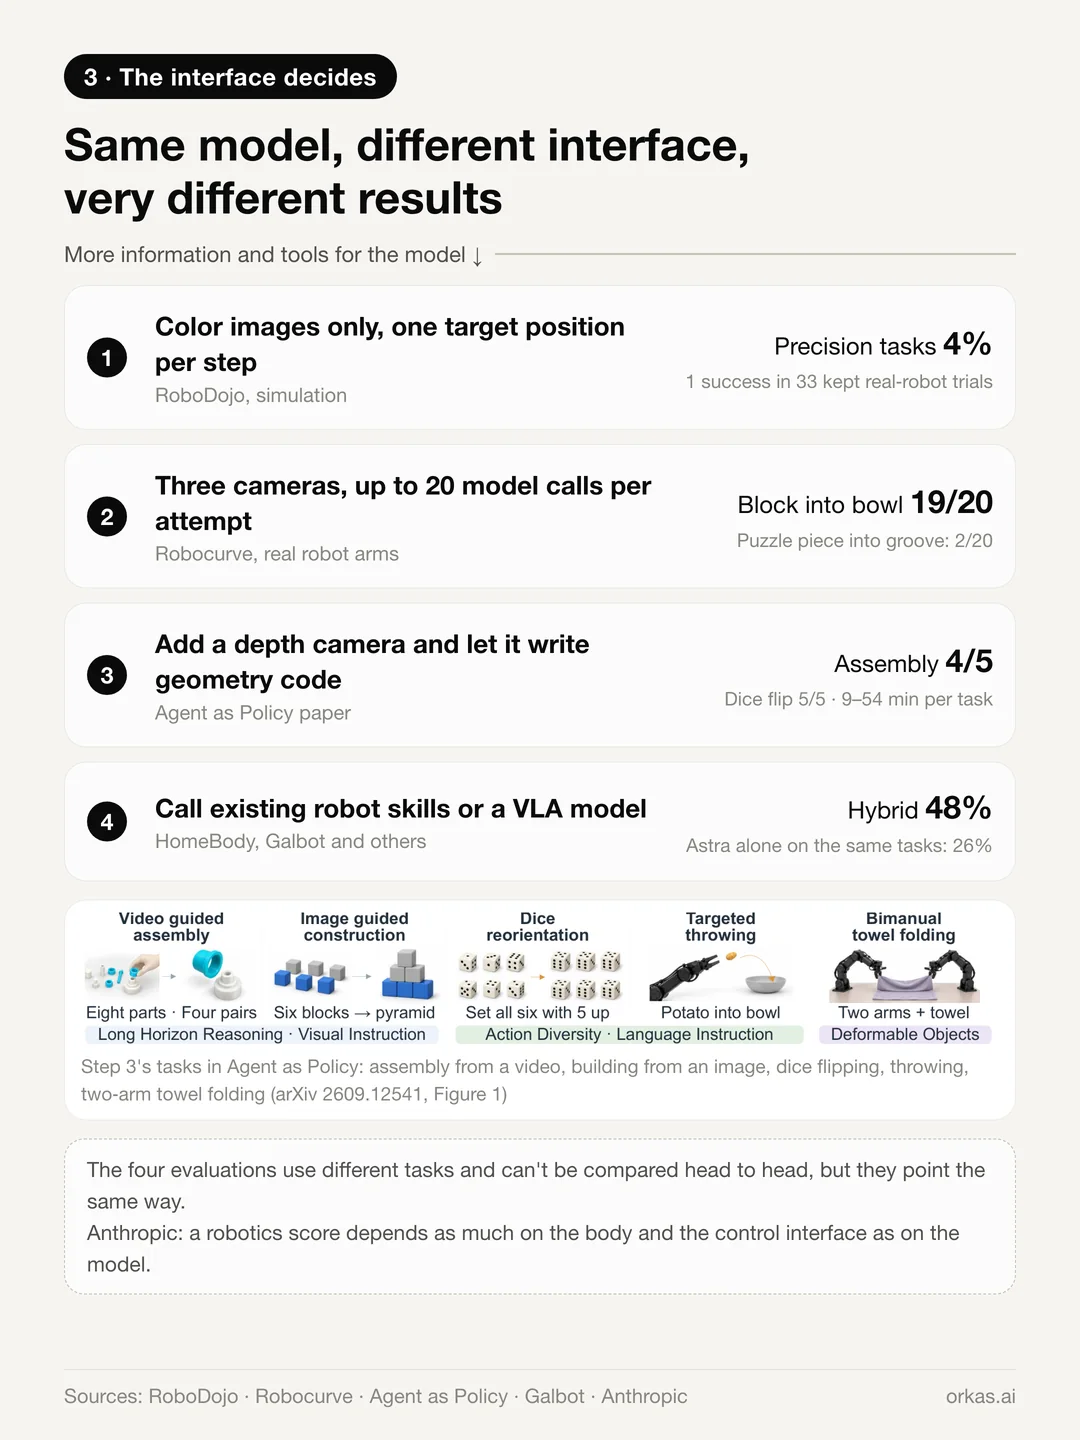
บทเรียนที่ใหญ่กว่าคือ ผลลัพธ์ขึ้นอยู่กับอินเทอร์เฟซมากแค่ไหน:
- ภาพสีอย่างเดียว ระบุตำแหน่งเป้าหมายได้หนึ่งจุดต่อขั้น (RoboDojo): 4% ในงานความแม่นยำ และจากการทดลองกับหุ่นยนต์จริง 33 ครั้งที่เก็บไว้ทั้งก่อนและหลังการหยุดเพื่อความปลอดภัย สำเร็จเต็มรูปแบบหนึ่งครั้ง
- กล้องสามตัว เรียกโมเดลได้สูงสุด 20 ครั้งต่อการลองหนึ่งครั้ง (การทดสอบของ Robocurve กับแขนกลจริง): วางบล็อกลงชามได้ 19 จาก 20 แต่ใส่ชิ้นจิ๊กซอว์ลงร่องได้แค่ 2 จาก 20
- กล้องวัดความลึก พร้อมสิทธิ์เขียนโค้ดเรขาคณิตเอง (งานวิจัย Agent as Policy v1 · ตาราง 1): ประกอบชิ้นส่วนสี่คู่สำเร็จ 4 จาก 5 พลิกลูกเต๋าสำเร็จ 5 จาก 5 และต่อบล็อกได้ 5/5, 5/5 และ 4/5 โดยการทดลองที่สำเร็จใช้เวลาเฉลี่ยประมาณ 21–54 นาที ขึ้นอยู่กับงาน
- เรียกใช้ทักษะหุ่นยนต์ที่มีอยู่แล้วหรือโมเดล VLA: งานยาว ๆ ทำได้สำเร็จ ในรายงานฉบับหนึ่ง ระบบไฮบริดที่ Astra คอยตรวจและแก้การกระทำของ VLA สำเร็จ 48% ในงานที่ Astra ทำเองเพียงลำพังได้ 26%
งานเหล่านี้ต่างกันและเทียบกันตรง ๆ ไม่ได้ แต่ชี้ไปทางเดียวกัน งานศึกษาด้านหุ่นยนต์ของ Anthropic เมื่อเดือนกรกฎาคมก็พบแบบเดียวกัน: คะแนนด้านหุ่นยนต์ของโมเดลขึ้นอยู่กับตัวหุ่นยนต์และอินเทอร์เฟซควบคุมพอ ๆ กับตัวโมเดลเอง ข้อกล่าวอ้างใด ๆ ว่า Astra เก่งเรื่องมิติสัมพันธ์แค่ไหน จึงต้องมีคำว่า “ด้วยอินเทอร์เฟซแบบไหน” กำกับไว้เสมอ
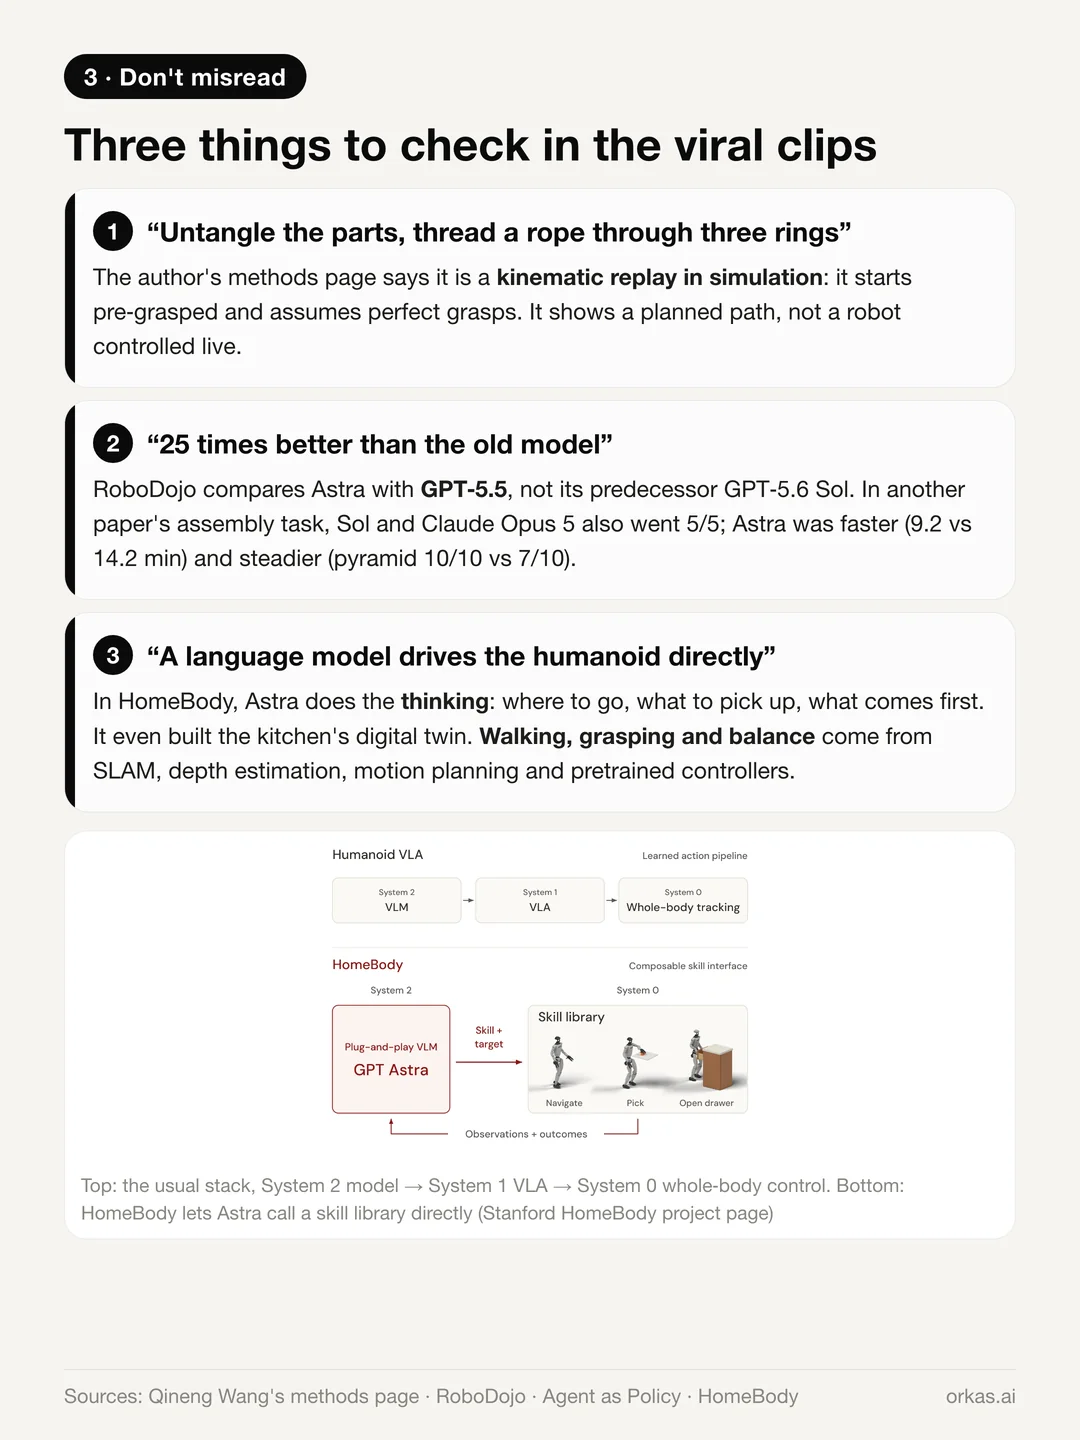
สามเรื่องที่ควรจำไว้เมื่อเดโมผ่านตา:
- คลิปไวรัล “แกะชิ้นส่วนที่ล็อกกันอยู่ แล้วร้อยเชือกผ่านห่วงสามวง” เป็นการเล่นซ้ำเชิงจลนศาสตร์ในการจำลอง หน้าอธิบายวิธีการของผู้เขียนระบุว่า มันเริ่มจากสถานะที่จับชิ้นงานไว้แล้ว และสมมติว่าการจับสมบูรณ์แบบ: สิ่งที่เห็นคือเส้นทางที่วางแผนไว้ ไม่ใช่หุ่นยนต์ที่ถูกควบคุมแบบเรียลไทม์
- “เก่งกว่าโมเดลเก่า 25 เท่า” เป็นการเทียบ Astra กับ GPT-5.5 ไม่ใช่กับ GPT-5.6 Sol ซึ่งเป็นรุ่นก่อนหน้าโดยตรง ในการเปรียบเทียบงานประกอบสองคู่ (AGP v1 · ตาราง 2) Sol และ Claude Opus 5 ก็สำเร็จ 5/5 ครั้ง โดยครั้งที่สำเร็จของ Astra ใช้เวลาเฉลี่ย 9.2 นาที เทียบกับ 14.2 นาทีของ Sol ส่วนการเปรียบเทียบต่อพีระมิดแยกต่างหาก (AGP v1 · ภาคผนวก C, ตาราง 5) Astra สำเร็จ 10/10 ครั้ง และ Sol สำเร็จ 7/10 ครั้ง
- หุ่นยนต์ครัว HomeBody ของ Stanford: Astra เป็นฝ่ายคิด ว่าจะไปที่ไหน หยิบอะไร ทำอะไรก่อน และยังสร้างดิจิทัลทวินของห้องครัวด้วย ส่วนการเดิน การหยิบจับ และการทรงตัวมาจาก SLAM การประมาณความลึก การวางแผนการเคลื่อนที่ และตัวควบคุมระดับล่างที่ฝึกไว้ล่วงหน้า
ความสามารถนี้มาจากไหน
OpenAI พูดไว้อย่างเป็นทางการสองเรื่อง: Astra ได้รับ “การฝึกแบบเจาะจงสำหรับสภาพแวดล้อมระดับมืออาชีพ” และเช่นเดียวกับโมเดลการให้เหตุผลรุ่นอื่น ๆ ของ OpenAI มันถูกฝึกด้วยการเรียนรู้แบบเสริมกำลัง OpenAI ไม่ได้เปิดเผยข้อมูลที่ใช้ฝึก ไม่ได้บอกว่าใช้ Blender หรือไม่ และไม่ได้บอกว่ามีข้อมูลหุ่นยนต์หรือไม่ เนื้อหาต่อจากนี้จึงเป็นการอนุมานจากหลักฐานสาธารณะ
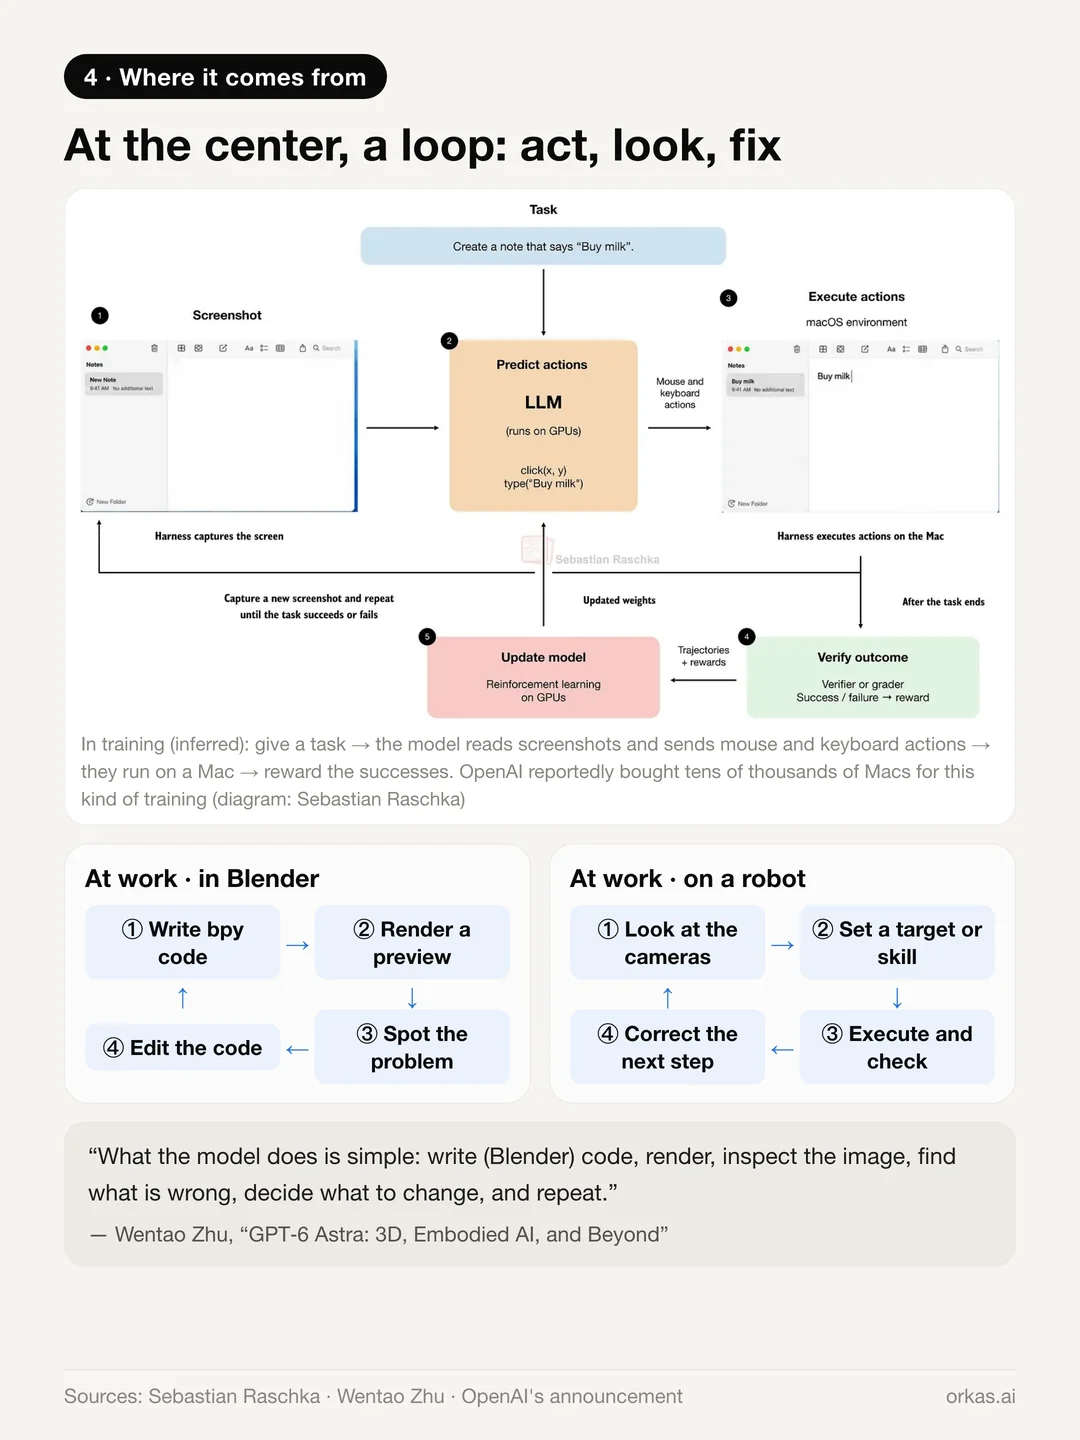
หัวใจคือลูป: ทำหนึ่งขั้น ดูผล หาว่าผิดตรงไหน แล้วแก้
- ตอนทำงาน Astra เขียนโค้ด Blender เรนเดอร์ ตรวจดู และแก้ไข บนหุ่นยนต์ มันมอง กำหนดเป้าหมาย ลงมือ ตรวจสอบ และปรับแก้ Wentao Zhu อธิบายว่า “สิ่งที่โมเดลทำนั้นเรียบง่าย: เขียนโค้ด (Blender) เรนเดอร์ ตรวจดูภาพ หาว่าผิดตรงไหน ตัดสินใจว่าจะเปลี่ยนอะไร แล้วทำซ้ำ”
- ตอนฝึก ลูปเดียวกันนี้น่าจะเป็นที่มา มีรายงานว่า OpenAI ซื้อ Mac mini และ Mac Studio หลายหมื่นเครื่องเพื่อฝึกการใช้คอมพิวเตอร์: ให้งานกับโมเดล ปล่อยให้มันอ่านภาพหน้าจอและส่งคำสั่งเมาส์กับคีย์บอร์ดไปยังเครื่อง Mac แล้วให้รางวัลกับรอบที่ทำสำเร็จ
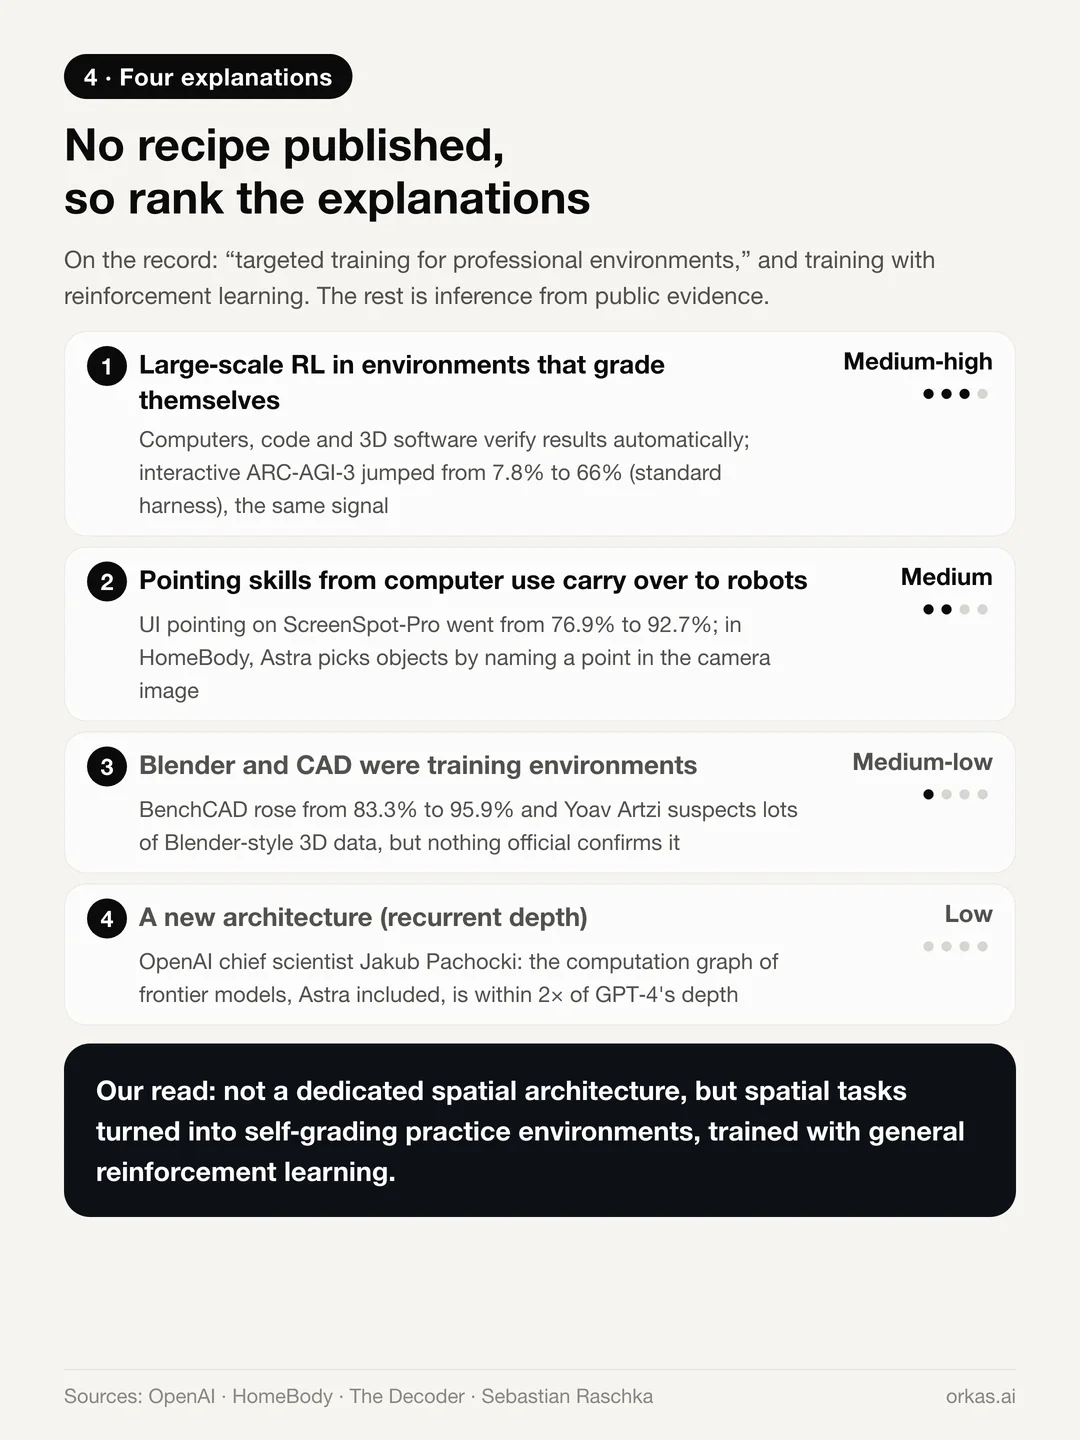
- การเรียนรู้แบบเสริมกำลังขนาดใหญ่ในสภาพแวดล้อมที่ตรวจถูกผิดได้เอง (ความเป็นไปได้: ปานกลางถึงสูง) คอมพิวเตอร์ โค้ด และซอฟต์แวร์ 3D ล้วนตรวจผลได้อัตโนมัติ ซึ่งฝึกทักษะทั่วไปในการตรวจสอบ หาข้อผิดพลาด และแก้ไข การกระโดดของ ARC-AGI-3 แบบโต้ตอบจาก 7.8% เป็น 66% ก็เป็นสัญญาณเดียวกัน
- ทักษะการชี้จากการใช้คอมพิวเตอร์ถ่ายทอดไปสู่หุ่นยนต์ (ปานกลาง) ScreenSpot-Pro เพิ่มจาก 76.9% เป็น 92.7% แปลว่าโมเดลเก่งขึ้นมากในการชี้จุดที่แม่นยำในภาพ ใน HomeBody Astra หยิบสิ่งของด้วยการระบุจุดแบบนั้นพอดีบนภาพจากกล้อง แล้วข้อมูลความลึกกับการปรับเทียบจะแปลงจุดนั้นเป็นตำแหน่ง 3 มิติ
- Blender และ CAD เองก็เป็นสภาพแวดล้อมการฝึก (ปานกลางถึงต่ำ ยังไม่ได้รับการยืนยัน) BenchCAD กระโดดขึ้น OpenAI ชูเดโม 3D เป็นจุดเด่น และ Yoav Artzi สงสัยว่ามีการฝึกด้วยข้อมูล 3D จำนวนมาก เช่น ฉาก Blender แต่ยังไม่มีแหล่งทางการใดยืนยัน
- สถาปัตยกรรมใหม่ (ต่ำ) มีรายงานว่า Astra ใช้ความลึกแบบวนซ้ำ (recurrent depth) ในบางส่วนของเครือข่าย แต่ Jakub Pachocki หัวหน้านักวิทยาศาสตร์ของ OpenAI เคยกล่าวว่า กราฟการคำนวณของโมเดลแนวหน้าปัจจุบัน รวมถึง Astra มีความลึกอยู่ในระดับไม่เกินสองเท่าของ GPT-4
มุมมองของเรา: เป็นไปได้มากที่สุดว่าทักษะเชิงพื้นที่ไม่ได้มาจากสถาปัตยกรรมที่ออกแบบมาเพื่องานเชิงพื้นที่โดยเฉพาะ แต่มาจากการเปลี่ยนงานเชิงพื้นที่ให้เป็นสนามฝึกที่ตรวจถูกผิดได้เอง แล้วฝึกบนสนามเหล่านั้นด้วยการเรียนรู้แบบเสริมกำลังที่ใช้ได้ทั่วไป
ความหมายต่อการสร้าง 3D
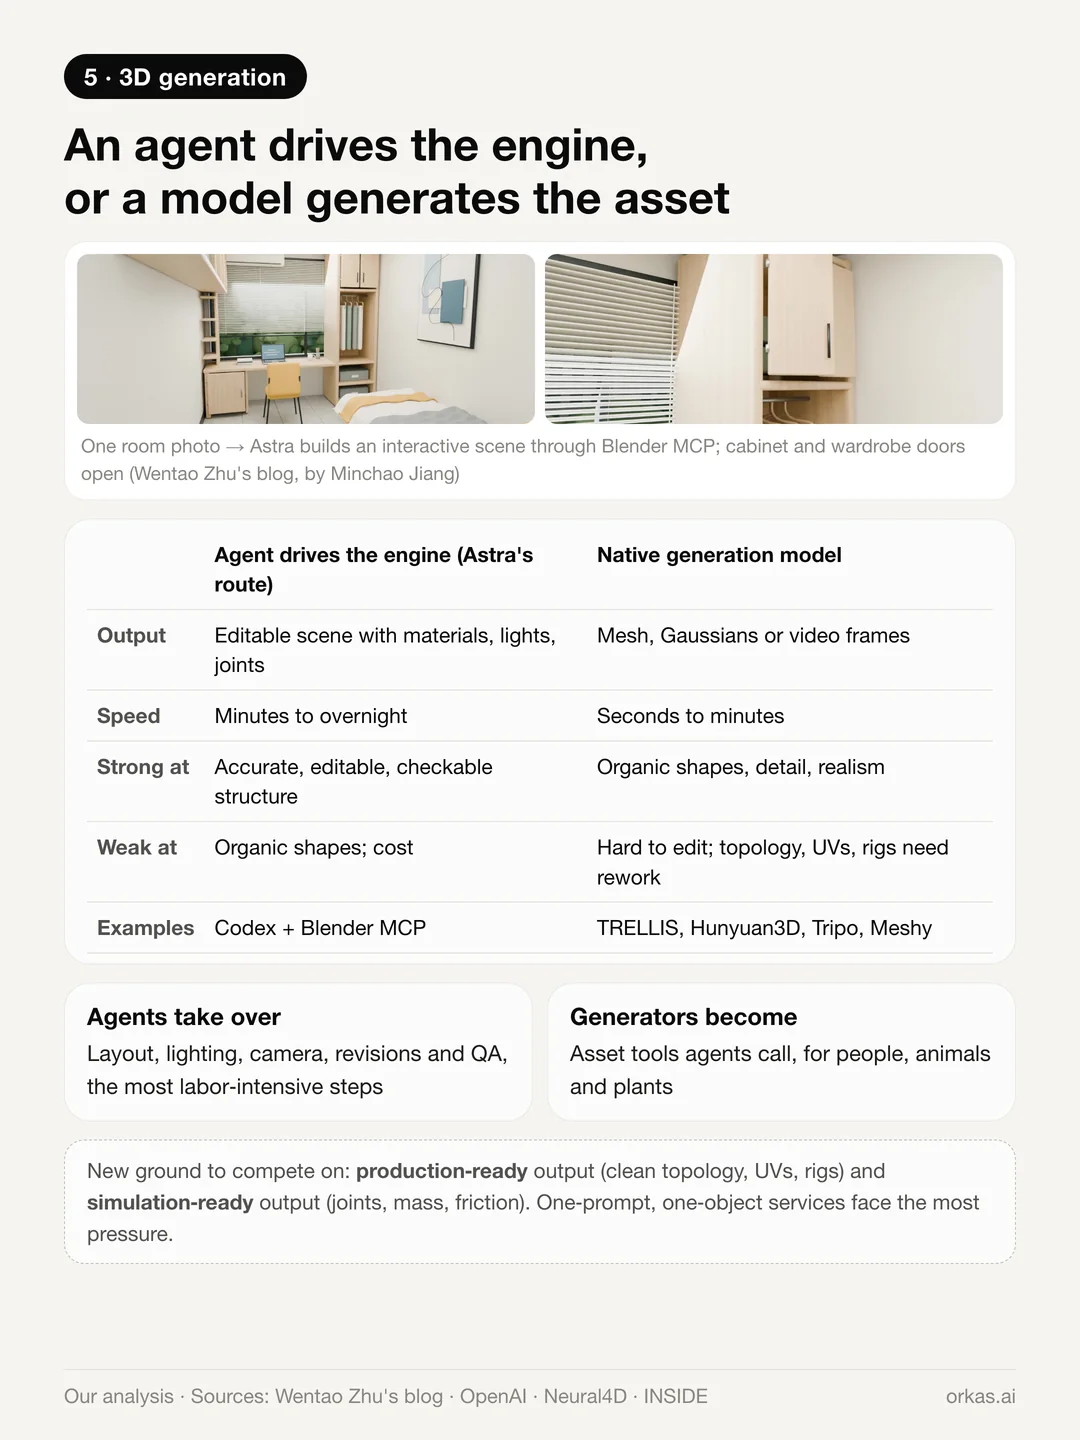
ตอนนี้การสร้าง 3D มีสองวิธี:
- เอเจนต์ควบคุมเอนจิน แบบเดียวกับ Astra ใน Blender หรือ CAD ได้ผลลัพธ์เป็นฉากที่แก้ไขได้ พร้อมวัสดุ แสงไฟ และข้อต่อ วิธีนี้ช้า ใช้เวลาตั้งแต่ไม่กี่นาทีจนถึงข้ามคืน แต่โครงสร้างแม่นยำ แก้ไขได้ และตรวจสอบได้
- โมเดลสร้างแอสเซ็ต TRELLIS, Hunyuan3D, Tripo, Meshy และโมเดลทำนองเดียวกันให้ผลเป็นเมชภายในไม่กี่วินาทีถึงไม่กี่นาที เก่งเรื่องรูปทรงออร์แกนิกและรายละเอียด แต่ผลลัพธ์แก้ไขยาก และโทโพโลยี UV และการริกกิ้งมักต้องทำใหม่
เราคาดว่าทั้งสองแนวทางจะเสริมกัน ขณะที่คุณค่าจะย้ายตำแหน่งไป:
- เอเจนต์รับช่วงขั้นตอนที่ใช้แรงงานมากที่สุด: การจัดวางฉาก การจัดแสง งานกล้อง การแก้งาน และการตรวจคุณภาพ
- ตัวสร้างกลายเป็นเครื่องมือผลิตแอสเซ็ตสำหรับคน สัตว์ และพืช และต้องเปิดให้เอเจนต์เรียกใช้ได้ เช่น ในรูปเซิร์ฟเวอร์ MCP หรือ API
- บริการแบบ “หนึ่งพรอมต์ หนึ่งวัตถุ” ถูกกดดันหนักที่สุด ผลงานที่พร้อมใช้ในงานโปรดักชัน (โทโพโลยีสะอาด UV ริก) และผลงานที่พร้อมใช้ในการจำลอง (ข้อต่อ มวล แรงเสียดทาน) จะกลายเป็นสนามแข่งขันใหม่
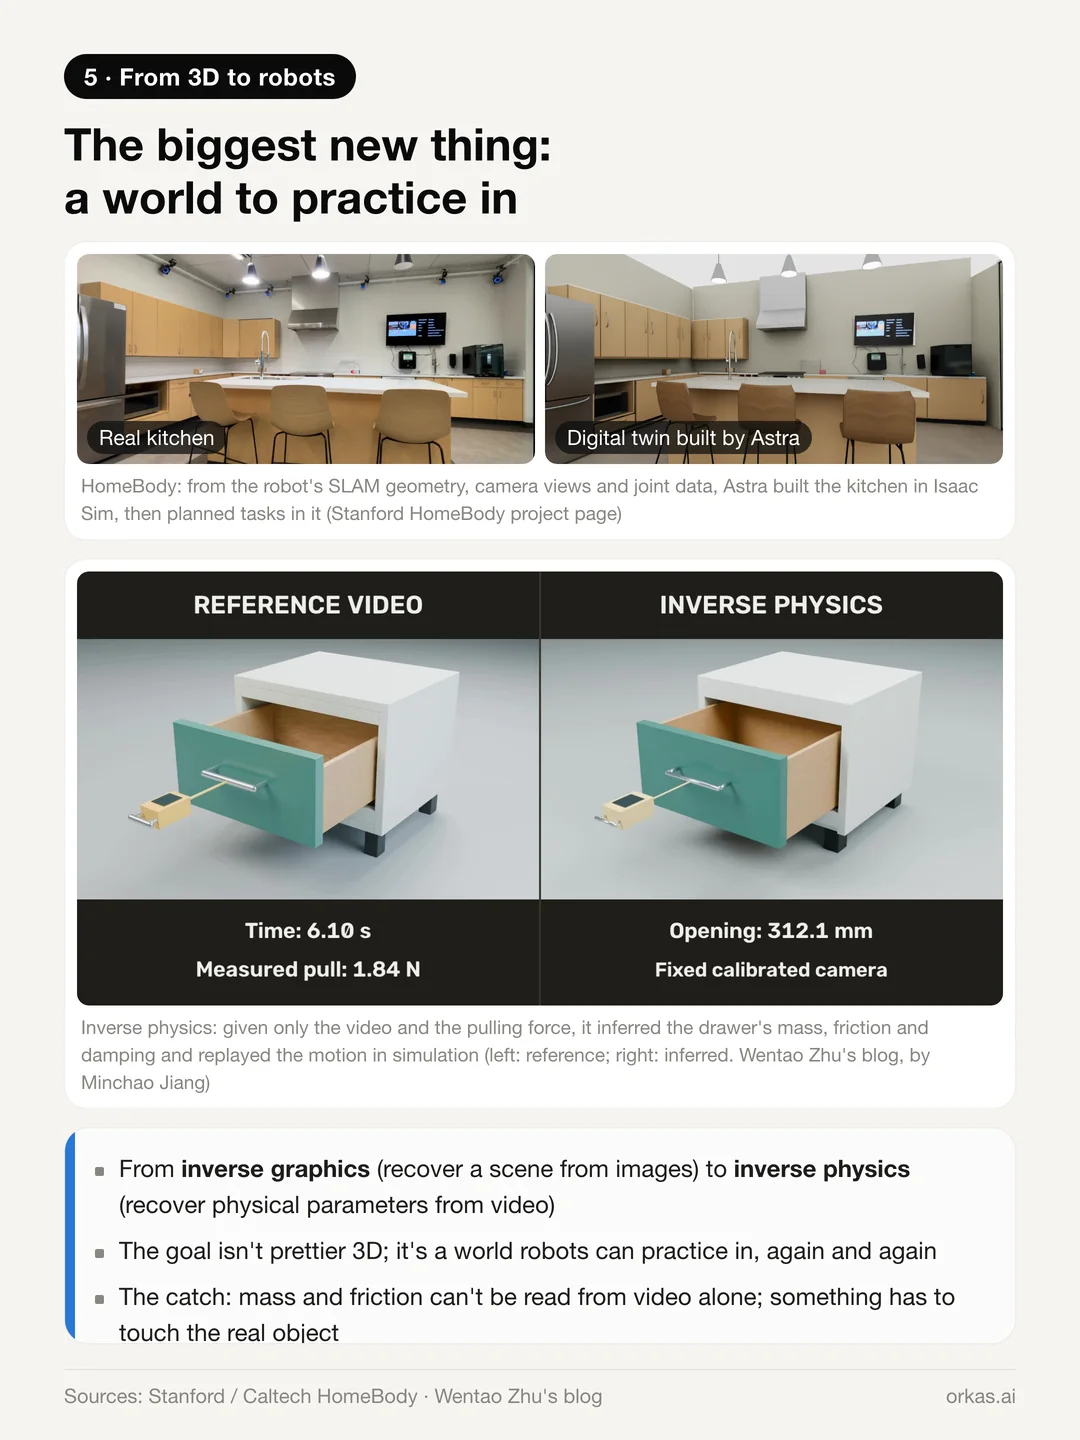
โอกาสใหม่ที่ใหญ่ที่สุดไม่ใช่ 3D ที่สวยขึ้น แต่เป็นโลกที่ใช้ฝึกซ้อมได้
- ใน HomeBody Astra สร้างดิจิทัลทวินของห้องครัวในโปรแกรมจำลอง จากเรขาคณิต SLAM ภาพจากกล้อง และข้อมูลข้อต่อที่หุ่นยนต์เก็บมาเอง แล้วใช้ดิจิทัลทวินนั้นวางแผนงาน
- ทีมของ Wentao Zhu สาธิตฟิสิกส์ย้อนกลับ: เมื่อมีเพียงวิดีโอกับแรงดึง โมเดลอนุมานมวล แรงเสียดทาน และการหน่วงของลิ้นชักได้ แล้วสร้างการเคลื่อนที่นั้นขึ้นซ้ำในโปรแกรมจำลอง
พูดอีกอย่างคือ ปลายทางของทักษะ 3D คือโลกสำหรับให้หุ่นยนต์ฝึกซ้อม แต่มีข้อติดอยู่: มวลและแรงเสียดทานอ่านจากวิดีโออย่างเดียวไม่ได้ ถึงจุดหนึ่งจึงต้องมีบางอย่างไปผลักวัตถุจริงอยู่ดี
โมเดลโลกแบบเนทีฟก็ยังไม่หลุดจากการแข่งขัน Atlas ของ World Labs ที่เปิดตัวเมื่อ 1 กันยายน สร้างและสร้างคืนโลก 3 มิติทั้งใบจากภาพถ่ายไม่กี่ภาพ ด้วยความสมจริงและความต่อเนื่องที่เอเจนต์ซึ่งควบคุมเอนจินเทียบไม่ได้ เป็นไปได้มากที่สุดว่าสุดท้ายทั้งสองเส้นทางจะเรียกใช้กันและกัน
ความหมายต่อสมองของหุ่นยนต์
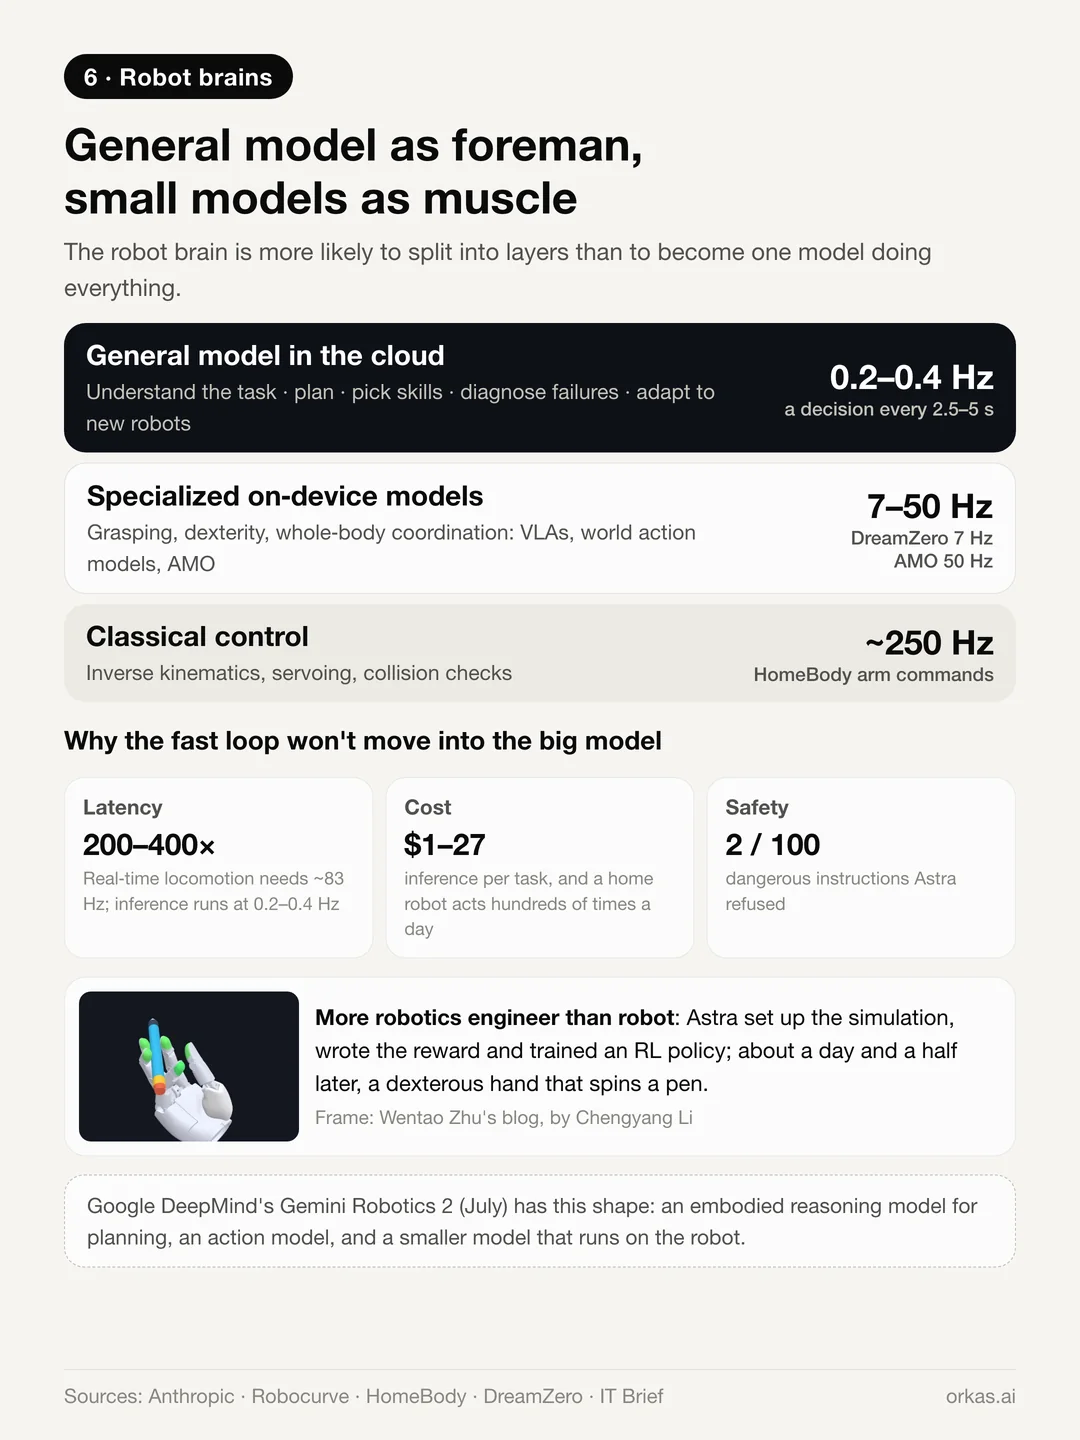
เราคาดว่าสมองของหุ่นยนต์จะแยกเป็นชั้น ๆ แทนที่จะมีโมเดลเดียวทำทุกอย่าง:
- โมเดลทั่วไปรับไป: การเข้าใจงาน การวางแผนขั้นตอน การเลือกทักษะ การวิเคราะห์สาเหตุที่ล้มเหลว และการปรับตัวเข้ากับหุ่นยนต์ตัวใหม่ ซึ่งก็คือ “การวางนัยทั่วไปเชิงความหมาย” ที่โมเดล VLA เคยภูมิใจ บนแกนงานปลายเปิดและการวางนัยทั่วไปของ RoboDojo Astra ก็ชนะนโยบายหุ่นยนต์ที่ผ่านการฝึกไปแล้ว
- โมเดลเฉพาะทางยังเก็บไว้: การควบคุมความถี่สูง การสัมผัส ความคล่องแคล่วของมือ และการทรงตัวทั้งร่าง
- ความเปลี่ยนแปลงอยู่ที่ว่า โมเดลเฉพาะทางเหล่านั้นจะถูกสร้างโดยโมเดลทั่วไปมากขึ้นเรื่อย ๆ ทีมของ Wentao Zhu ให้ Astra ตั้งค่าการจำลอง เขียนฟังก์ชันรางวัล และฝึกนโยบายด้วยการเรียนรู้แบบเสริมกำลัง ราววันครึ่งต่อมา มันก็ส่งมอบมือกลคล่องแคล่วที่ควงปากกาได้
เหตุที่ลูปควบคุมความเร็วสูงยังต้องแยกออกมา มาจากข้อจำกัดที่เลี่ยงไม่ได้สามข้อ:
- ความหน่วง: Anthropic ประเมินว่าการเคลื่อนไหวแบบเรียลไทม์ต้องใช้ราว 83 Hz ขณะที่การอนุมานของโมเดลทำงานที่ 0.2–0.4 Hz ห่างกันราวสองลำดับขนาด
- ต้นทุน: ราว $1 ถึง $27 ต่องานในผลประเมินข้างต้น ขณะที่หุ่นยนต์ในบ้านต้องทำการกระทำหลายร้อยครั้งต่อวัน
- ความปลอดภัย: ในการทดสอบ RoboHarm ของ Robocurve นั้น Astra ปฏิเสธคำสั่งอันตราย 2 จาก 100 คำสั่ง ความปลอดภัยต้องมีราวกั้นของตัวเองที่ไม่พึ่งพาคลาวด์
Gemini Robotics 2 ของ Google DeepMind ที่ประกาศเมื่อเดือนกรกฎาคม มีโครงสร้างแบบนี้แล้ว: โมเดลการให้เหตุผลเชิงกายภาพ (embodied reasoning) สำหรับวางแผน โมเดลการกระทำ และโมเดลที่เล็กกว่าซึ่งทำงานบนตัวหุ่นยนต์เอง
นี่พิสูจน์ว่าโมเดลแบบออโตรีเกรสซีฟชนะแล้วหรือ?
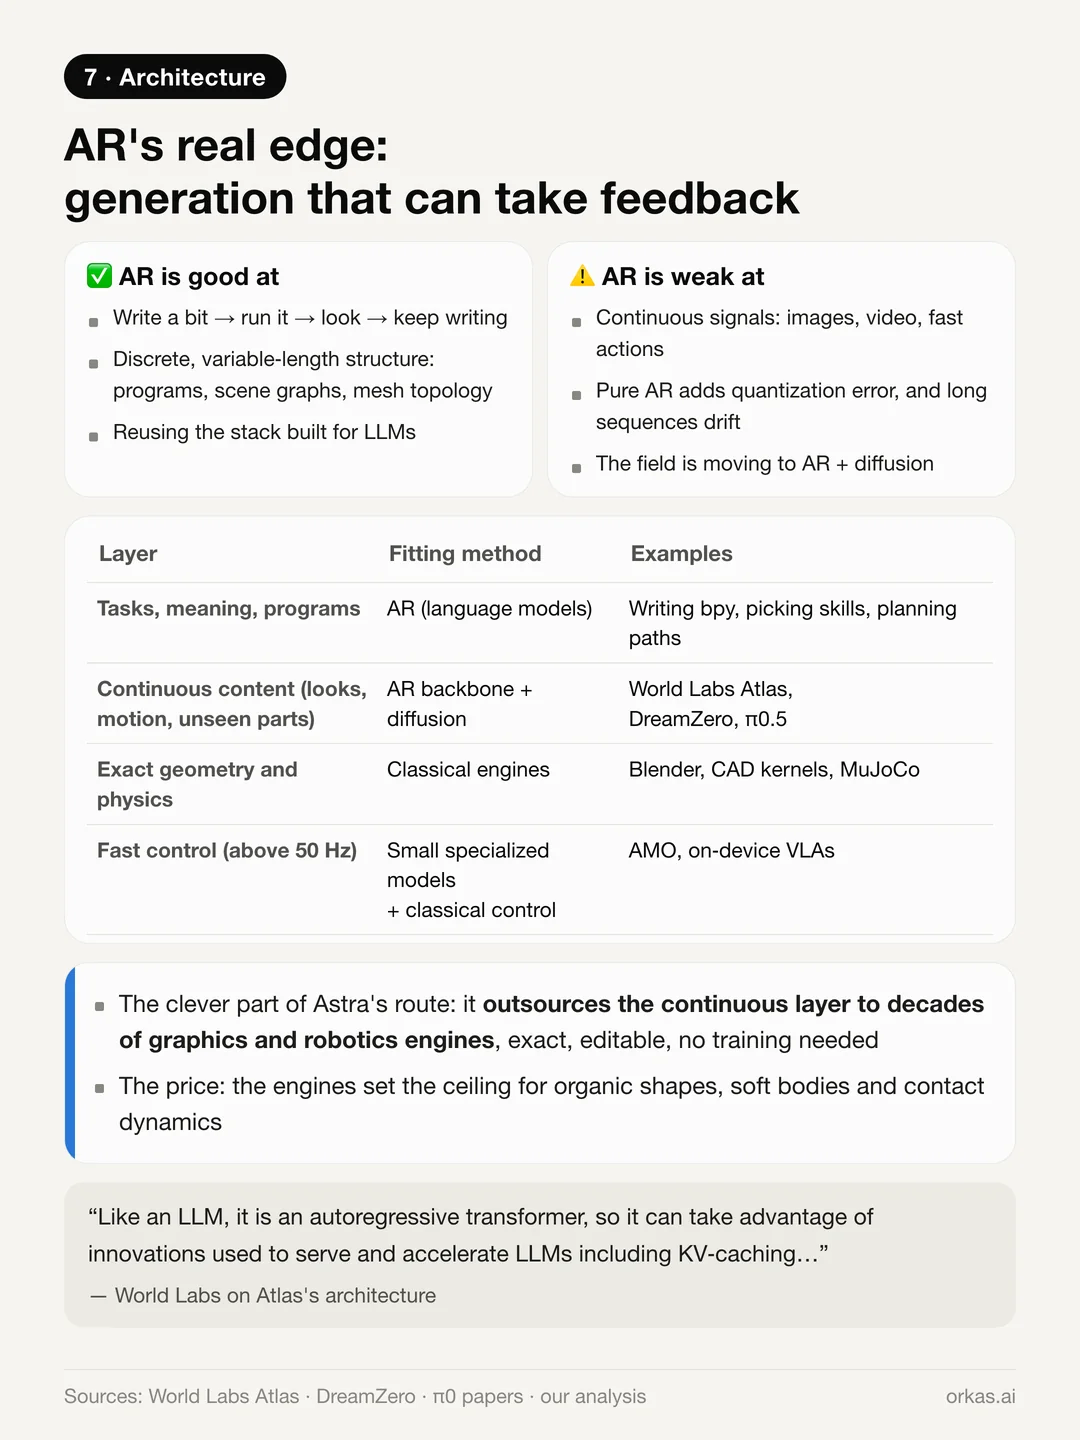
บางคนมองว่า Astra เป็นหลักฐานว่าการสร้างแบบออโตรีเกรสซีฟ (AR) ซึ่งสร้างโทเคนทีละตัวต่อกันไปแบบที่โมเดล GPT ทำ ได้เปรียบกว่า เราเห็นด้วยครึ่งหนึ่ง:
- ข้อได้เปรียบที่แท้จริงของ AR คือการสร้างผลลัพธ์สลับกับฟีดแบ็กจากภายนอกได้: เขียนโค้ดนิดหนึ่ง รัน ดูผล แล้วเขียนต่อ ส่วนโมเดลดิฟฟิวชันสร้างผลลัพธ์ทั้งหมดในคราวเดียว จึงรับฟีดแบ็กระหว่างทางได้ยาก
- AR ยังเหมาะกับโครงสร้างแบบไม่ต่อเนื่องที่ความยาวไม่ตายตัว เช่น โปรแกรม กราฟฉาก และโทโพโลยีของเมช และยังนำสแตกการฝึกและการให้บริการที่สร้างไว้สำหรับ LLM มาใช้ซ้ำได้
- สำหรับสัญญาณต่อเนื่อง เช่น ภาพ วิดีโอ และคำสั่งมอเตอร์ AR ล้วน ๆ ไม่ได้เปรียบ วงการกำลังมุ่งไปสู่แกนหลักแบบออโตรีเกรสซีฟที่มีส่วนหัวแบบดิฟฟิวชันหรือ flow matching ทั้ง Atlas ของ World Labs, DreamZero จากนักวิจัยของ NVIDIA และ π0.5 ล้วนเดินทางนี้
- ความแยบยลของแนวทาง Astra คือการยกชั้นที่เป็นข้อมูลต่อเนื่องไปให้ตัวเรนเดอร์ เคอร์เนล CAD เอนจินฟิสิกส์ และตัววางแผนการเคลื่อนที่จัดการแทน งานวิศวกรรมกราฟิกและหุ่นยนต์ที่สั่งสมมาหลายทศวรรษจึงกลายเป็นตัวถอดรหัสที่แม่นยำ แก้ไขได้ และไม่ต้องฝึก ราคาที่ต้องจ่ายคือเอนจินเป็นตัวกำหนดเพดาน
สิ่งนี้หมายถึงอะไร ถ้าคุณทำงานกับเอเจนต์
เราสร้างแอปเดสก์ท็อปที่ให้เอเจนต์ลงมือทำงาน ข้อค้นพบเรื่องอินเทอร์เฟซจึงเป็นเรื่องที่เราใส่ใจที่สุด โมเดลเดียวกันได้คะแนนต่างกันมาก ขึ้นอยู่กับว่ามันมองเห็นอะไรได้ เรียกเครื่องมืออะไรได้ และตรวจผลงานของตัวเองได้หรือไม่ ความสามารถจำนวนมากอยู่ในลูปนั้น ไม่ได้อยู่แค่ในน้ำหนักของโมเดล
ลูปนั้นคือสิ่งที่พื้นที่ทำงานของเอเจนต์ต้องมีให้: เครื่องมือสำหรับลงมือทำ ไฟล์สำหรับทำงาน และผลลัพธ์ที่เอเจนต์ตรวจดูได้ก่อนส่งกลับ ใน Orkas คุณรัน GPT-6 Astra ได้ด้วยคีย์ OpenAI API ของคุณเองหรือด้วยการลงชื่อเข้าใช้บัญชี ChatGPT เชื่อมต่อ Codex เป็นเอเจนต์ภายนอก หรือใช้โมเดลที่ Orkas จัดการให้ Orkas ยังรองรับเซิร์ฟเวอร์ MCP ที่กำหนดเอง จึงเพิ่มเซิร์ฟเวอร์ที่ชุมชนทำไว้สำหรับเครื่องมือเดสก์ท็อปเป็นตัวเชื่อมต่อได้ เรายังไม่ได้ทดสอบเซิร์ฟเวอร์ Blender แบบครบทั้งกระบวนการ จึงขอให้ถือว่าเป็นเส้นทางที่ต้องลองทำเอง
สิ่งที่เราได้จากเรื่องนี้
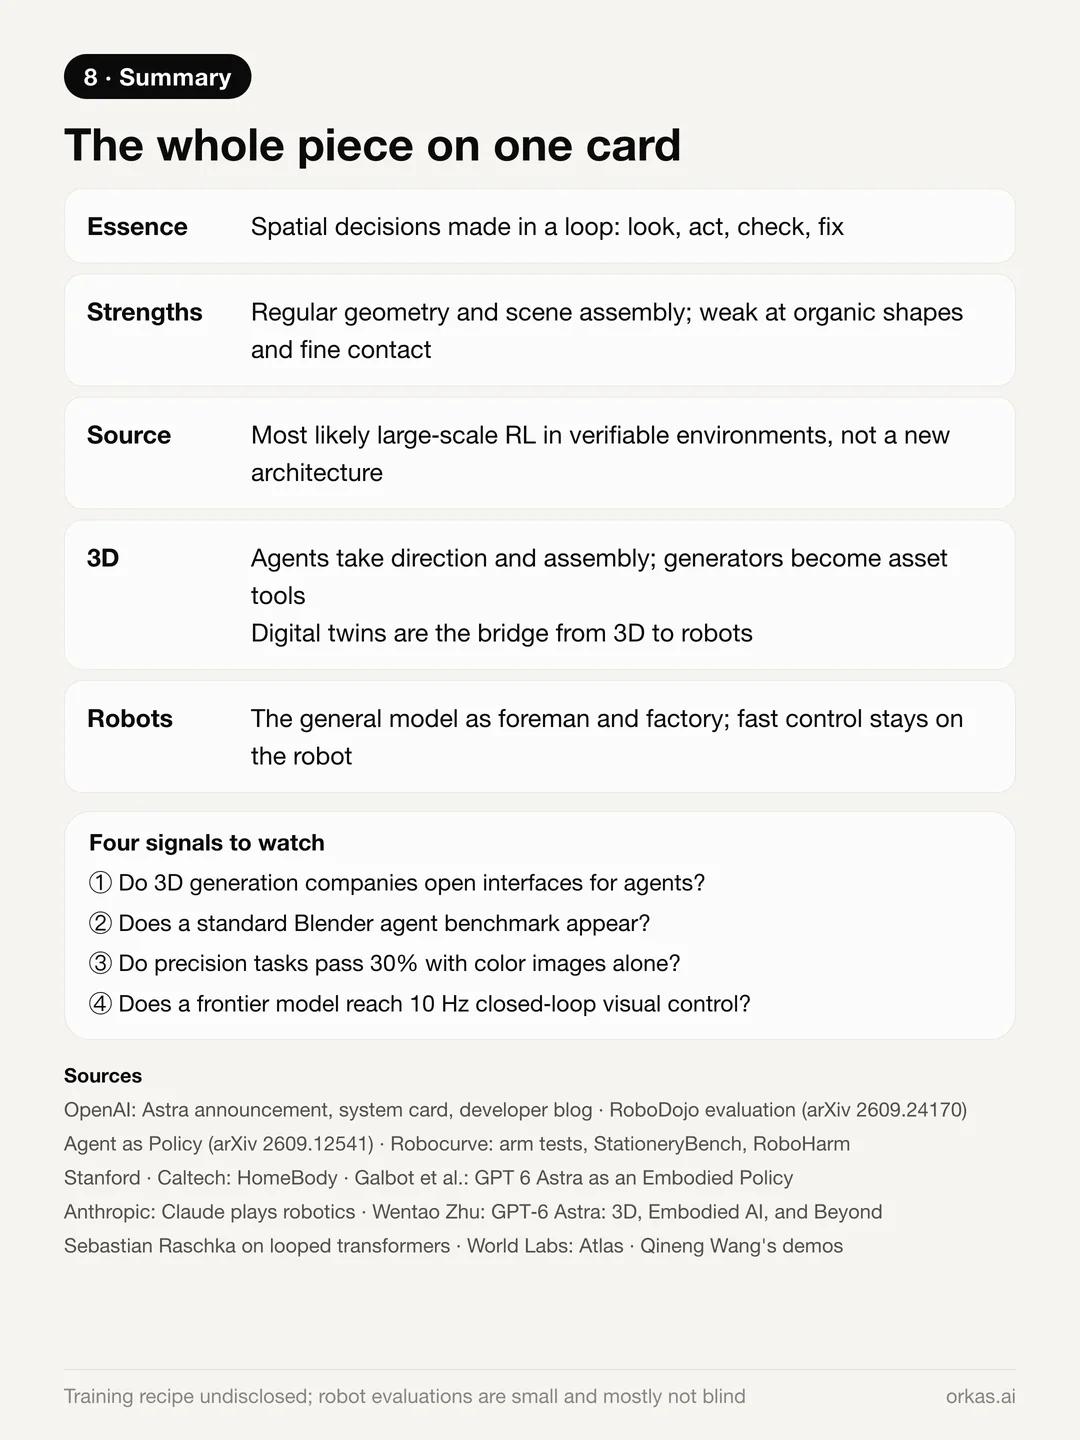
- ความเข้าใจพื้นที่ของ Astra คือการตัดสินใจภายในลูป: มอง เขียนโค้ดหรือกำหนดเป้าหมาย ลงมือ ตรวจสอบ แก้ไข
- มันเก่งเรื่องเรขาคณิตที่เป็นระเบียบ การประกอบฉาก และการตัดสินที่ผสมความหมายเข้ากับพื้นที่ แต่อ่อนเรื่องรูปทรงออร์แกนิกและการสัมผัสที่ละเอียด เพราะขึ้นอยู่กับว่าโปรแกรมสั้น ๆ อธิบายอะไรได้บ้าง
- เป็นไปได้มากที่สุดว่าทักษะนี้มาจากการเรียนรู้แบบเสริมกำลังขนาดใหญ่ในสภาพแวดล้อมที่ตรวจถูกผิดได้เอง ไม่ใช่จากสถาปัตยกรรมใหม่ ส่วนสูตรการฝึกยังไม่ถูกเปิดเผย
- ในการสร้าง 3D เอเจนต์รับหน้าที่กำกับและประกอบ ขณะที่ตัวสร้างกลายเป็นเครื่องมือผลิตแอสเซ็ต และดิจิทัลทวินคือสะพานไปสู่หุ่นยนต์
- ในสมองของหุ่นยนต์ โมเดลทั่วไปกลายเป็นทั้งหัวหน้าคนงานและโรงงาน ส่วนการควบคุมความเร็วสูงยังอยู่กับโมเดลเฉพาะทางบนอุปกรณ์
สัญญาณที่ควรจับตา: บริษัทด้านการสร้าง 3D จะเปิดอินเทอร์เฟซให้เอเจนต์หรือไม่ จะมีเบนช์มาร์กมาตรฐานสำหรับเอเจนต์ Blender เกิดขึ้นหรือไม่ งานความแม่นยำจะผ่าน 30% ด้วยภาพสีอย่างเดียวได้หรือไม่ และจะมีโมเดลแนวหน้าที่ทำการควบคุมด้วยภาพแบบวงปิดได้ที่ 10 Hz หรือไม่
ข้อควรระวัง: ผลประเมินหุ่นยนต์ส่วนใหญ่ข้างต้นใช้ตัวอย่างขนาดเล็ก 5 ถึง 20 ครั้งต่อการตั้งค่า และส่วนใหญ่ไม่ได้ทดสอบแบบปกปิด ขอให้มองข้อสรุปเหล่านี้เป็นการประเมิน ณ ตอนนี้ ไม่ใช่คำตัดสินสุดท้าย
แหล่งที่มา: ประกาศเปิดตัว GPT-6 Astra และการ์ดระบบของ OpenAI; รายงานข่าวการเปิดตัวของ Fortune; GPT-6 Astra: 3D, Embodied AI, and Beyond ของ Wentao Zhu; และบทความเรื่อง looped transformer ของ Sebastian Raschka ซึ่งอ้างคำพูดของ Pachocki แหล่งอื่น ๆ มีลิงก์อยู่ตรงจุดที่อ้างถึง